
Reflection a publié les poids de Beam le 16 octobre 2026, sous Apache 2.0. Le changement est concret : les développeurs peuvent télécharger le modèle, choisir son hébergement et adapter les logiciels qui l'entourent. La présentation du 5 octobre annonçait encore une publication ultérieure. Le communiqué de disponibilité confirme la livraison.
Dans le fil de lancement de r/LocalLLaMA, derdigga demande si A23B signifie que le modèle fonctionne sur du matériel grand public. C'est la difficulté essentielle : environ 23B paramètres sont actifs par token, mais il reste environ 501B paramètres à stocker et à servir.
L'intérêt porte sur les choix de déploiement et les outils ouverts pour agents. Cela ne désigne pas un champion universel du code. Cet article distingue les livrables des promesses, situe DeepSeek, Qwen et Mistral, et propose Tabbit Browser pour rassembler les sources. Il ne confirme aucune intégration de Beam dans Tabbit.
Points à retenir
Le 5 octobre correspond à la présentation ; le 16, à la publication des poids. Les anciens articles peuvent décrire une situation dépassée.
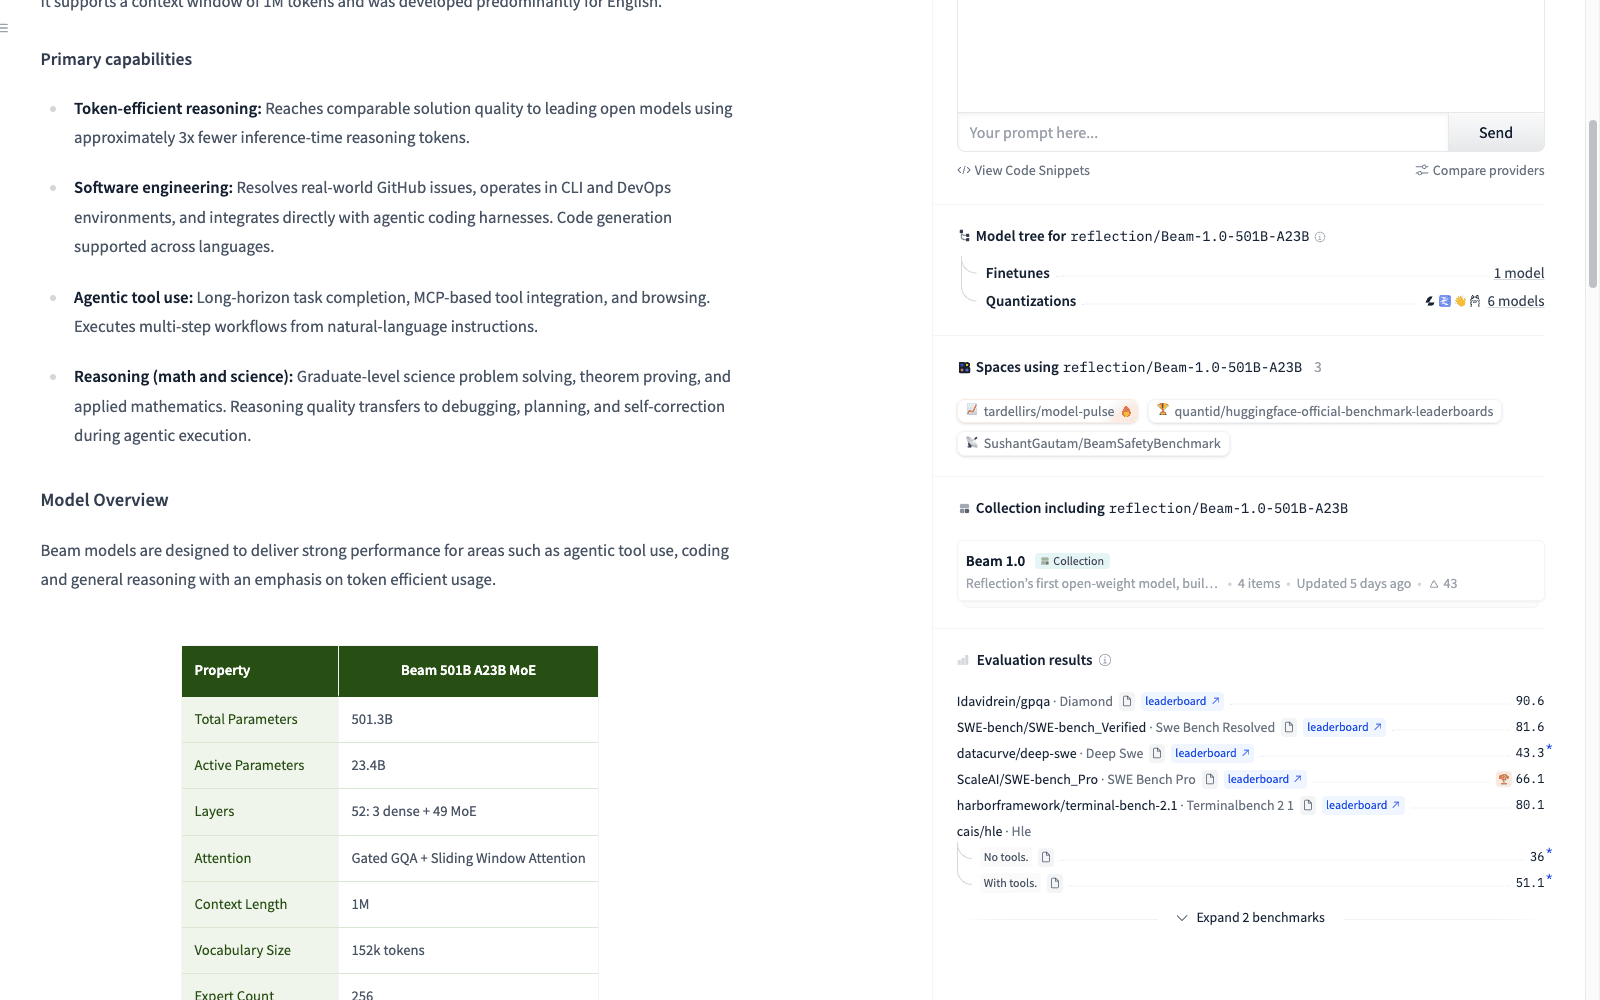
La fiche décrit un MoE textuel : 501B paramètres au total, 23B actifs et un contexte de 1M tokens.
Les poids Apache 2.0, Mirror, les intégrations d'inférence et les recettes de personnalisation permettent de contrôler davantage le système.
Le nombre de paramètres actifs influe sur le calcul ; le total, la précision, le contexte et la concurrence déterminent les ressources nécessaires.
Commencer par une tâche délimitée sur un endpoint disponible, puis décider du déploiement à partir de mesures propres.
Reflection Beam en un coup d'œil
Informations vérifiées le 21 octobre, sans benchmark de Beam réalisé pour cet article.
| Élément | Ce qui est publié ou documenté | Conséquence |
|---|---|---|
| Identité | reflection/Beam-1.0-501B-A23B | Éviter la confusion avec Apache Beam, beam search et les homonymes |
| Architecture | MoE parcimonieux ; 501.3B au total, 23.4B actifs dans la fiche détaillée | Distinguer stockage des poids et calcul par token |
| Modalités | Texte ; développement principalement orienté anglais | Tester les autres langues ; ne pas supposer une vision native |
| Contexte | 1M tokens | Capacité maximale, sans garantie de récupération parfaite |
| Formats | BF16, FP8, NVFP4 ; modèle auxiliaire DFlash2 | Compatibilité et qualité selon le format |
| Licences | Poids et dépôt Mirror sous Apache 2.0 | Consulter les fichiers et notices des composants |
| Accès | Auto-hébergement, API Reflection et partenaires | Téléchargement et inférence hébergée sont deux choix distincts |
Sources : fiche officielle, dépôt Mirror. Le guide des agents IA explique la distinction entre modèle et système d'exécution.
Ce qui a réellement été ouvert le 16 octobre
La collection officielle réunit le checkpoint principal, FP8, NVFP4 et un modèle auxiliaire de décodage spéculatif. Plusieurs formats offrent des choix de mémoire et de matériel, sans garantir des résultats identiques sur toutes les tâches.
Reflection publie aussi Mirror, son agent de code en terminal. Le dépôt contient l'agent, la CLI et les composants associés. Il peut lire et modifier des fichiers, exécuter des commandes et travailler dans des worktrees distincts. Une interface Python communique avec un cœur Rust : les équipes peuvent examiner la boucle d'exécution.
Le communiqué cite Transformers, vLLM et SGLang pour l'inférence, ainsi que des collaborations autour du fine-tuning et de l'apprentissage par renforcement. Le guide AWS décrit des endpoints gérés et des déploiements orientés Kubernetes. Ces éléments rendent possible une évaluation opérationnelle.
Il reste des limites. La fiche décrit des catégories de données, dont des contenus acquis par accords commerciaux, sans fournir une reconstruction téléchargeable du corpus complet. Le rapport technique est encore annoncé à venir, tout comme les recettes d'auto-distillation dans le communiqué. Publier les poids, décrire l'entraînement et permettre sa reproduction intégrale sont trois livrables différents. « Poids ouverts avec outils open source » est donc la formulation précise.
Pourquoi 23B actifs ne rendent pas le déploiement léger
Un MoE dirige chaque token vers certains experts. Cela réduit le calcul, mais ne dispense pas le serveur de conserver l'accès à l'ensemble des poids : les experts inutilisés peuvent servir au token suivant.
Stockage des poids ≈ paramètres totaux × octets par paramètre
Mémoire d'inférence = poids + cache KV + surcharge + buffers
Le guide Hugging Face indique environ 1 To pour BF16 et 280 Go pour NVFP4. Le second chiffre ne garantit pas qu'un service fonctionne avec exactement cette mémoire. Le contexte long et les requêtes simultanées ajoutent des besoins ; NVFP4 dépend aussi du matériel.
Déporter des poids en RAM ou sur disque change le compromis entre capacité, transferts et latence. Aucune configuration de ce type n'a été mesurée ici. Une vitesse citée sur un forum ne suffit pas à justifier un achat.
Dans le même fil, mindwip apprécie la publication de résultats à plusieurs précisions dès le lancement. Il emploie les termes informels bf16, q8 et q4 ; les formats officiels sont BF16, FP8 et NVFP4. L'enjeu est de connaître les résultats du format réellement déployable.
Comment comparer Beam à DeepSeek, Qwen et Mistral
Comparer des checkpoints nommés, pas seulement des entreprises. DeepSeek-V4.1-Flash constitue un candidat de grande taille ; son dépôt indique MIT et des entrées multimodales. Notre présentation de DeepSeek V4.1 Flash traite sa propre architecture. Ses scores ne se transfèrent pas à Beam.
Qwen3-Coder-30B-A3B-Instruct annonce 30.5B paramètres totaux, 3.3B actifs, Apache 2.0 et 256K de contexte natif. Ce checkpoint antérieur illustre une autre échelle de déploiement ; il ne représente pas le dernier modèle phare de Qwen. Qwen3.8 Max est un produit distinct.
Devstral Small 2 24B de Mistral propose des poids Apache 2.0 et une intégration documentée avec Mistral Vibe. Son plus petit nombre total de paramètres conduit à une autre décision matérielle. Sa licence ne décrit pas toutes les versions Mistral.
La question est de choisir entre un grand modèle personnalisable, un modèle de code plus petit ou un endpoint qui fonctionne déjà. Assembler des scores issus de protocoles différents masque ce choix. Pour les agents, outils, reprises, gestion du contexte et permissions comptent aussi. Le guide DeepSeek Harness et navigateur illustre cette séparation, sans prouver une intégration équivalente de Beam ou Mirror. Le guide du raisonnement agentique explique pourquoi le texte final ne suffit pas à évaluer un agent.
Une utilisation pratique de Tabbit : réunir les preuves
Annonce initiale, fiche révisée, recette d'inférence et discussion communautaire peuvent sembler contradictoires si leurs dates disparaissent. Le workflow de Tabbit permet d'utiliser des pages liées comme contexte d'analyse.
Ouvrez les deux annonces, la fiche et le guide de déploiement. Demandez un inventaire daté, une URL par ligne et des colonnes distinctes pour livrables et promesses. Les notes officielles v1.13 documentent Tabbit CLI pour des agents de code externes ; configuration et disponibilité régionale restent à vérifier.
Il s'agit d'un workflow proposé, pas d'un test de Beam dans Tabbit. Lire la fiche n'exécute pas le checkpoint et ne valide pas les scores. Gardez l'exécution du code dans un harness adapté. Le guide du navigateur agentique précise le rôle du navigateur.
Ce que la publication prouve et ce qu'il faut mesurer
Les poids et plusieurs outils sont publics. Cela ne prouve pas que Beam sera le moins cher ou le plus rapide pour votre travail. Générer moins de tokens ne garantit pas une facture totale réduite.
Coût par tâche acceptée = coût total des exécutions / tâches validéesIncluez échecs, outils, ressources inactives et revue humaine si nécessaire. Fixez révision du dépôt, tâches, harness, précision, budget de raisonnement et délai maximal. Mesurez les tests réussis, la récupération après erreur et le travail humain restant. Un pilote limité peut guider une décision sans prétendre constituer un benchmark complet.
Qui devrait essayer Beam maintenant ?
| Contrainte | Première étape raisonnable | À vérifier avant engagement |
|---|---|---|
| Contrôler un grand modèle de code | Endpoint documenté, puis pilote auto-hébergé | Qualité, capacité et responsabilité d'exploitation |
| Station de travail modeste | Petits checkpoints Qwen ou Devstral | Empreinte totale et latence acceptable |
| DeepSeek ou Qwen fonctionne déjà | Mêmes tâches et même harness avec Beam | Gain justifiant une migration |
| Personnaliser un domaine | Recettes de fine-tuning et RL disponibles | Coût de calcul, données et évaluation |
| Comprendre l'annonce | Lire communiqué et fiche ensemble | Livrables actuels et engagements futurs |
Beam mérite une évaluation parce qu'il ajoute un modèle téléchargeable et des outils d'agent inspectables. Les équipes soucieuses du déploiement et de la personnalisation disposent d'une option supplémentaire. Une migration doit suivre un pilote concluant.
Commencez par une tâche représentative, ses critères d'acceptation et votre solution actuelle comme référence. Tabbit peut aider à vérifier les sources ; pour servir 501B paramètres, commencez par le guide d'inférence et le budget matériel.

Questions fréquentes
Quand les poids de Reflection Beam ont-ils été publiés ?
Reflection a présenté Beam le 5 octobre 2026 puis publié ses poids le 16. Le second communiqué confirme Apache 2.0, Hugging Face et les intégrations de déploiement et d’agents.
Beam est-il open source ou à poids ouverts ?
Il s’agit précisément de poids Apache 2.0 avec des outils open source comme Mirror. Cela ne prouve pas la publication du corpus complet ni d’un entraînement intégralement reproductible ; le rapport technique reste annoncé à venir.
Une carte de 24 Go suffit-elle grâce aux 23B paramètres actifs ?
Les paramètres actifs décrivent le calcul par token, pas la taille totale. Hugging Face indique environ 1 To pour BF16 et 280 Go pour NVFP4 ; déporter les poids en RAM ou sur disque change les performances, sans supprimer les poids restants.
Beam est-il meilleur que DeepSeek, Qwen ou Mistral ?
Cet article ne démontre aucun gagnant universel. Comparez des checkpoints précis avec mêmes tâches, harness, précision et budget ; des modèles plus petits peuvent mieux convenir à une capacité limitée.
Est-ce le même produit qu’Apache Beam ou beam search ?
Non. Ici Beam désigne le modèle de Reflection, identifié par reflection/Beam-1.0-501B-A23B. Apache Beam traite des données et beam search est une méthode de décodage.
Peut-on sélectionner Beam dans Tabbit Browser ?
Cet article ne confirme pas sa présence dans le sélecteur de Tabbit. Tabbit peut aider à vérifier les sources ; exécuter Beam nécessite un endpoint et un harness adaptés.