
Reflection 在 2026 年 10 月 16 日正式开放了 Beam 的模型权重,采用 Apache 2.0 许可证。 这次变化很具体:开发者可以下载模型,决定在哪里部署,再修改和接入自己的工具。别把两个日期混在一起:10 月 5 日的介绍还在承诺稍后开放,10 月 16 日的公告才确认权重已经发布。
在 r/LocalLLaMA 的发布讨论里,用户 derdigga 直接问:A23B 是不是意味着消费级硬件也能运行?这是个比“又多了一个大模型”更实际的问题。Beam 每个 token 约激活 23B 参数,但需要存储和调度的仍是约 501B 参数的模型。
这次发布值得聊的是部署选择和开放的 Agent 工具。它没有直接证明 Beam 是编码能力最强的模型。下面会拆清已经开放的内容、部署成本和竞品取舍,也会用 Tabbit Browser说明如何整理发布资料;这不代表 Tabbit 已接入 Beam。
先看结论
10 月 5 日是首次介绍,10 月 16 日是权重开放。仍写着“尚未发布权重”的旧文章需要结合日期阅读。
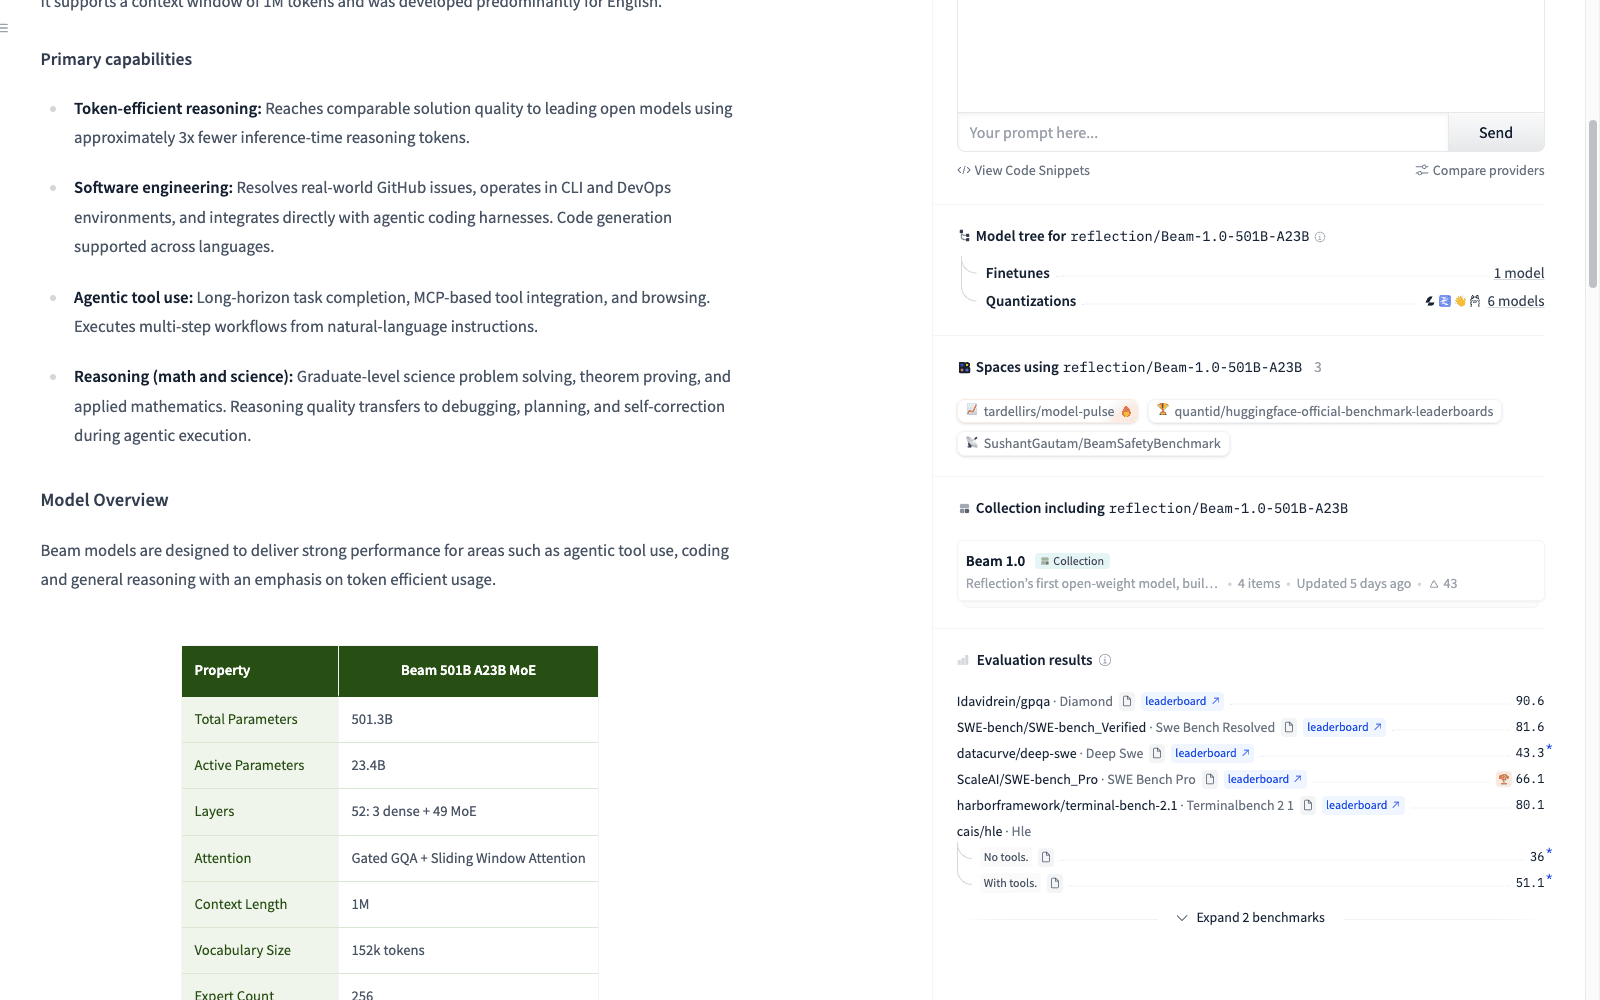
官方模型卡将 Beam 定义为文本 MoE 模型:约 501B 总参数、23B 激活参数、1M token 上下文。
Apache 2.0 权重、Mirror 源码、推理集成和定制配方,让团队有机会控制模型及其执行环境。
激活参数影响每 token 的计算量;总参数、精度、上下文和并发共同影响部署容量。
先通过可用端点做一个有明确验收标准的小任务,再决定是否投入自部署。
Reflection Beam 开放情况速览
下表是截至 10 月 21 日核对的发布事实,不是本文亲测结果。
| 项目 | 已公开或已说明的内容 | 对使用者意味着什么 |
|---|---|---|
| 名称 | reflection/Beam-1.0-501B-A23B | 避免与 Apache Beam、beam search 及其他同名产品混淆 |
| 架构 | 稀疏 MoE;模型卡详列 501.3B 总参数、23.4B 激活参数 | 分开计算权重容量和每 token 计算量 |
| 模态 | 文本;主要面向英语开发 | 中文任务需要单独测,不能默认原生支持视觉 |
| 上下文 | 1M token | 是容量上限,不保证在百万 token 中始终检索准确 |
| 格式 | BF16、FP8、NVFP4,另有 DFlash2 草稿模型 | 硬件兼容性和效果取决于具体格式 |
| 许可 | Apache 2.0 权重,Apache 2.0 的 Mirror 仓库 | 应查看实际文件和组件声明 |
| 入口 | 自部署、Reflection API、合作伙伴服务 | 下载权重与购买托管推理是两种选择 |
来源:官方模型卡、Mirror 仓库。如果不熟悉模型和执行系统的区别,可以先看 AI Agent 的基本工作方式。
10 月 16 日,具体开放了什么?
首先是权重。Beam 官方集合列出了主模型、FP8 和 NVFP4 版本,以及用于推测解码的草稿模型。多种精度给部署方提供了容量与硬件选择,不代表每种精度在所有任务上都等效。
其次是 Mirror。它是 Reflection 公开的终端编码 Agent,仓库包含 Agent、CLI 等组件。它能读写文件、执行命令,并在不同代码 worktree 中处理任务。Python 前端与 Rust Agent 核心通信。团队因此可以检查执行循环,而不必把整个 Agent 当作一个无法查看内部行为的服务。
再往下是推理与定制支持。官方发布说明列出 Transformers、vLLM、SGLang 等推理集成,也列出微调和强化学习方向的合作。AWS 的部署指南则给出了托管端点和偏 Kubernetes 的部署路线。这些资料让基础设施团队有条件开始验证。
但“开源”仍需要拆开说。模型卡说明了训练数据类别,其中包括通过商业合作获得的数据;这不等于完整语料可下载。模型卡上的技术报告仍标为即将发布,发布文中的自蒸馏配方也使用了后续推出的措辞。公开权重、说明训练过程、让别人完整复现训练,是三种不同的交付。
因此,把这次发布称为“开放权重,并配套开源工具”是准确的。把它概括成“训练的所有环节都开源了”,就超出了目前核对到的证据。
为什么只激活 23B,部署仍然很重?
MoE 会让每个 token 只经过部分专家,减少计算量。但生产服务不能因为上一个 token 没用到某些专家,就把它们从模型中永久去掉。
可以用两个公式区分:
权重存储量 ≈ 总参数量 × 每个参数的存储字节数
推理内存需求 = 权重 + KV cache + 运行时开销 + 工作缓冲区
Hugging Face 的发布指南给出的 BF16 checkpoint 约为 1TB,NVFP4 约为 280GB。后者不是“280GB 显存一定够用”的承诺:长上下文和并发请求还需要额外空间,NVFP4 的执行也有硬件条件。
把权重卸载到 CPU 内存或存储可以改变可运行的配置,同时增加传输与延迟成本。本文没有测试卸载方案,不会把社区讨论里的 tokens/s 直接当作硬件采购依据。
同一个 Reddit 原帖里,用户 mindwip 特别赞赏发布时就给出不同精度的跑分。他使用了 bf16、q8、q4 这些非正式叫法;官方格式是 BF16、FP8、NVFP4。这个评价反映了一个实际需求:部署者关心自己能运行的精度表现,而不只关心最高精度成绩。
与 DeepSeek、Qwen、Mistral 应该怎么比?
先选具体 checkpoint,再比较,不能只拿公司名互相比。DeepSeek-V4.1-Flash是一个相关的大模型候选,其仓库标注 MIT 许可证和多模态输入。DeepSeek V4.1 Flash 介绍解释的是它自己的架构和获取方式,相关成绩不能直接搬给 Beam。
Qwen 也提供更小的编码模型。例如 Qwen3-Coder-30B-A3B-Instruct标注 30.5B 总参数、3.3B 激活参数、Apache 2.0 和原生 256K 上下文。这里选择这个较早的 checkpoint,是为了说明不同部署规模的选择,不是把它当成 Qwen 当前最强模型。Qwen3.8 Max则是另一款产品。
Mistral 的 Devstral Small 2 24B也是具体的编码候选,公开了 Apache 2.0 权重和 Mistral Vibe 集成说明。它的总规模更小,对应另一种容量决策。不能由此推断 Mistral 所有模型都使用同一许可证。
所以,值得比较的是团队到底需要什么:可定制的大模型服务、更小的本地编码部署,还是已经运行稳定的托管端点。把不同模型卡上的数字拼成“最强排行榜”,往往会掩盖真正的选择条件。
Agent 还需要比较 harness,即连接模型、工具和任务状态的执行系统。工具定义、重试、上下文管理和命令权限都可能改变结果。DeepSeek Harness 浏览器集成指南可以帮助理解这一区别,但不能拿来证明 Mirror 或 Beam 已支持相同集成。Agentic Reasoning 指南进一步解释了为什么只比较最终回答不够。
用 Tabbit 整理发布证据,再决定是否试用
研究新模型时,浏览器里常同时开着早期公告、更新后的模型卡、推理配方和社区讨论。先解决这些页面之间的日期和状态冲突,比急着下载模型更有用。Tabbit 的浏览器工作流可以把相关网页作为分析上下文。
把 10 月 5 日、10 月 16 日的公告,模型卡和部署指南放在一起,要求输出一份带日期的清单:每行给来源 URL,把“已经发布”和“后续承诺”分列。官方 v1.13 日志还记录了供外部 Code Agent 使用的 Tabbit CLI;实际集成配置和不同地区的可用情况仍需检查。
这是一个建议的资料核对流程,不是 Beam 在 Tabbit 中的实测。浏览器能读公告,不代表已经运行模型或验证编码成绩。代码执行留给合适的编码 harness;浏览器在多步任务中的作用,可参考 Agentic Browser 指南。
发布证明了什么,实际评估还缺什么?
目前的证据足以证明权重和一批配套工具已公开,但不足以证明 Beam 对你的任务一定最快、最省钱。Reflection 的效率论述有其测试和计算条件。生成 token 更少,不能直接推导出端到端账单更低。
实际比较时,更有用的公式是:
每个验收通过任务的成本 = 全部运行成本 ÷ 验收通过的任务数按需要把失败尝试、工具调用、闲置基础设施和人工复核都计入。固定代码版本、任务集、harness、精度、推理预算和超时条件,再记录补丁能否通过测试、遇到工具错误能否恢复、人工还需要修多久。一轮小范围试用能支持决策,不必包装成全面评测。
哪些人现在值得试 Beam?
| 你的主要约束 | 更合理的第一步 | 投入前需要确认 |
|---|---|---|
| 希望控制大型编码模型的部署 | 先测文档中列出的端点,再试自部署 | 任务效果、容量、运维责任 |
| 只有一台普通工作站 | 先比较较小的 Qwen 或 Devstral checkpoint | 完整权重占用与可接受延迟 |
| DeepSeek 或 Qwen 已经跑得稳定 | 同任务、同 harness 加测 Beam | 改善是否值得迁移 |
| 想针对细分领域做定制 | 查看已经提供的微调、RL 配方 | 算力、数据和评估成本 |
| 只是想弄清这次新闻 | 对照发布文和模型卡 | 哪些已经交付,哪些仍在计划中 |
Beam 值得评估,因为它增加了一个可以下载的模型,以及可以检查和修改的 Agent 工具。对有部署和定制要求的团队,这意味着更多选择;是否迁移,仍应等自己的试用结果。
下一步可以很小:挑一个代表性任务,写清验收条件,与当前方案对照。需要收集和核对来源时,可以用 Tabbit 整理阅读;需要部署 501B 参数时,先看推理指南和硬件预算。

常见问题
Reflection Beam 到底是哪一天开放权重的?
2026 年 10 月 5 日是模型首次介绍,10 月 16 日才是权重正式开放。后者的官方公告确认 Hugging Face 上的 Apache 2.0 权重以及配套部署和 Agent 集成。
Beam 是开源模型,还是开放权重模型?
更准确的说法是:Beam 开放了 Apache 2.0 权重,并提供 Mirror 等开源工具。这不等于完整训练语料和端到端可复现的训练流水线都已公开。本次核对时,模型卡仍把技术报告标为即将发布。
Beam 只激活 23B 参数,24GB 显卡就能运行吗?
激活参数量描述每个 token 的计算,不代表完整权重占用。Beam 总参数约 501B,Hugging Face 的介绍给出的 BF16 权重约 1TB,NVFP4 约 280GB。卸载到内存或磁盘会改变速度与容量的取舍,不会让其余权重消失。
Beam 比 DeepSeek、Qwen、Mistral 更好吗?
本文没有建立这样的普遍结论。应锁定具体 checkpoint,在相同任务、harness、精度和预算下比较。硬件容量有限时,Qwen 和 Mistral 的较小编码模型也可能更实用。
Reflection Beam 和 Apache Beam、beam search 是一回事吗?
不是。本文的 Beam 指 Reflection 的语言模型,对应 reflection/Beam-1.0-501B-A23B 仓库。Apache Beam 是数据处理项目,beam search 是一种解码搜索方法。
能在 Tabbit 浏览器里直接选择 Beam 吗?
本文没有确认 Tabbit 的模型列表已经提供 Beam。Tabbit 可以用于阅读和核对模型发布资料;运行 Beam、执行编码任务仍需要对应的推理端点和 Agent harness。可用模型以当前客户端为准。