
Reflection 在 2026 年 10 月 16 日正式開放了 Beam 的模型權重,採用 Apache 2.0 許可證。 這次變化很具體:開發者可以下載模型,決定在哪裡部署,再修改和接入自己的工具。別把兩個日期混在一起:10 月 5 日的介紹還在承諾稍後開放,10 月 16 日的公告才確認權重已經發布。
在 r/LocalLLaMA 的釋出討論裡,使用者 derdigga 直接問:A23B 是不是意味著消費級硬體也能執行?這是個比“又多了一個大模型”更實際的問題。Beam 每個 token 約啟用 23B 引數,但需要儲存和排程的仍是約 501B 引數的模型。
這次釋出值得聊的是部署選擇和開放的 Agent 工具。它沒有直接證明 Beam 是編碼能力最強的模型。下面會拆清已經開放的內容、部署成本和競品取捨,也會用 Tabbit Browser說明如何整理釋出資料;這不代表 Tabbit 已接入 Beam。
先看結論
10 月 5 日是首次介紹,10 月 16 日是權重開放。仍寫著“尚未釋出權重”的舊文章需要結合日期閱讀。
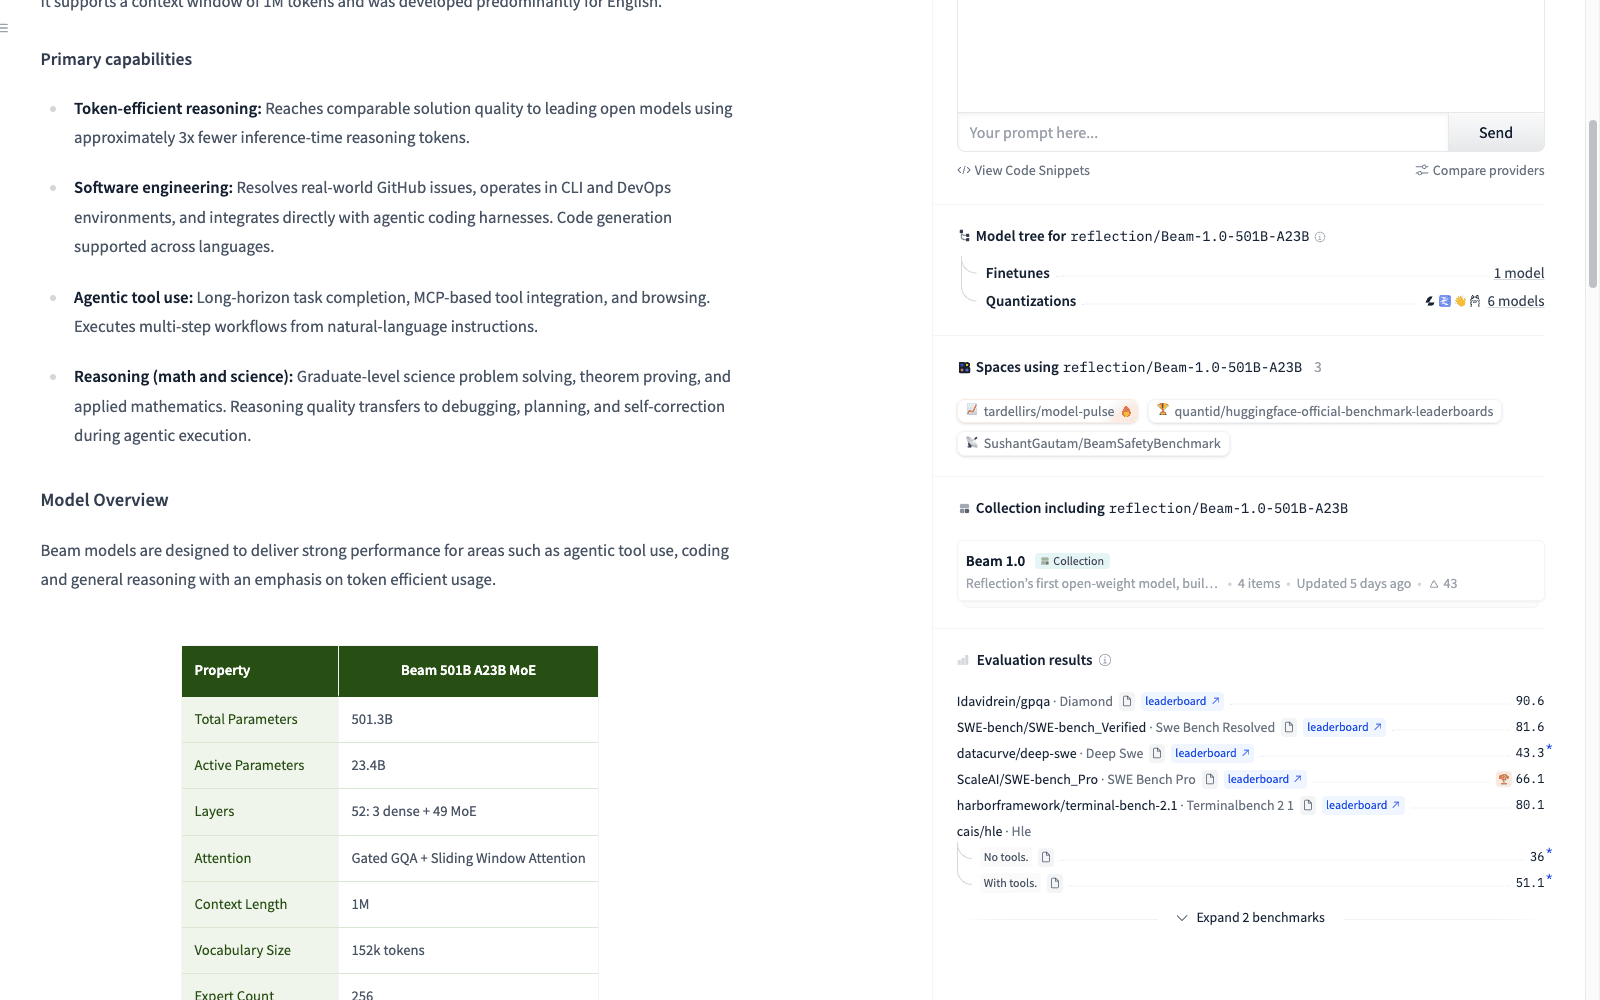
官方模型卡將 Beam 定義為文字 MoE 模型:約 501B 總引數、23B 啟用引數、1M token 上下文。
Apache 2.0 權重、Mirror 原始碼、推理整合和定製配方,讓團隊有機會控制模型及其執行環境。
啟用引數影響每 token 的計算量;總引數、精度、上下文和併發共同影響部署容量。
先透過可用端點做一個有明確驗收標準的小任務,再決定是否投入自部署。
Reflection Beam 開放情況速覽
下表是截至 10 月 21 日核對的釋出事實,不是本文親測結果。
| 專案 | 已公開或已說明的內容 | 對使用者意味著什麼 |
|---|---|---|
| 名稱 | reflection/Beam-1.0-501B-A23B | 避免與 Apache Beam、beam search 及其他同名產品混淆 |
| 架構 | 稀疏 MoE;模型卡詳列 501.3B 總引數、23.4B 啟用引數 | 分開計算權重容量和每 token 計算量 |
| 模態 | 文字;主要面向英語開發 | 中文任務需要單獨測,不能預設原生支援視覺 |
| 上下文 | 1M token | 是容量上限,不保證在百萬 token 中始終檢索準確 |
| 格式 | BF16、FP8、NVFP4,另有 DFlash2 草稿模型 | 硬體相容性和效果取決於具體格式 |
| 許可 | Apache 2.0 權重,Apache 2.0 的 Mirror 倉庫 | 應檢視實際檔案和元件宣告 |
| 入口 | 自部署、Reflection API、合作伙伴服務 | 下載權重與購買託管推理是兩種選擇 |
來源:官方模型卡、Mirror 倉庫。如果不熟悉模型和執行系統的區別,可以先看 AI Agent 的基本工作方式。
10 月 16 日,具體開放了什麼?
首先是權重。Beam 官方集合列出了主模型、FP8 和 NVFP4 版本,以及用於推測解碼的草稿模型。多種精度給部署方提供了容量與硬體選擇,不代表每種精度在所有任務上都等效。
其次是 Mirror。它是 Reflection 公開的終端編碼 Agent,倉庫包含 Agent、CLI 等元件。它能讀寫檔案、執行命令,並在不同程式碼 worktree 中處理任務。Python 前端與 Rust Agent 核心通訊。團隊因此可以檢查執行迴圈,而不必把整個 Agent 當作一個無法檢視內部行為的服務。
再往下是推理與定製支援。官方釋出說明列出 Transformers、vLLM、SGLang 等推理整合,也列出微調和強化學習方向的合作。AWS 的部署指南則給出了託管端點和偏 Kubernetes 的部署路線。這些資料讓基礎設施團隊有條件開始驗證。
但“開源”仍需要拆開說。模型卡說明了訓練資料類別,其中包括透過商業合作獲得的資料;這不等於完整語料可下載。模型卡上的技術報告仍標為即將釋出,釋出文中的自蒸餾配方也使用了後續推出的措辭。公開權重、說明訓練過程、讓別人完整復現訓練,是三種不同的交付。
因此,把這次釋出稱為“開放權重,並配套開源工具”是準確的。把它概括成“訓練的所有環節都開源了”,就超出了目前核對到的證據。
為什麼只啟用 23B,部署仍然很重?
MoE 會讓每個 token 只經過部分專家,減少計算量。但生產服務不能因為上一個 token 沒用到某些專家,就把它們從模型中永久去掉。
可以用兩個公式區分:
權重儲存量 ≈ 總引數量 × 每個引數的儲存位元組數
推理記憶體需求 = 權重 + KV cache + 執行時開銷 + 工作緩衝區
Hugging Face 的釋出指南給出的 BF16 checkpoint 約為 1TB,NVFP4 約為 280GB。後者不是“280GB 視訊記憶體一定夠用”的承諾:長上下文和併發請求還需要額外空間,NVFP4 的執行也有硬體條件。
把權重解除安裝到 CPU 記憶體或儲存可以改變可執行的配置,同時增加傳輸與延遲成本。本文沒有測試解除安裝方案,不會把社群討論裡的 tokens/s 直接當作硬體採購依據。
同一個 Reddit 原帖裡,使用者 mindwip 特別讚賞釋出時就給出不同精度的跑分。他使用了 bf16、q8、q4 這些非正式叫法;官方格式是 BF16、FP8、NVFP4。這個評價反映了一個實際需求:部署者關心自己能執行的精度表現,而不只關心最高精度成績。
與 DeepSeek、Qwen、Mistral 應該怎麼比?
先選具體 checkpoint,再比較,不能只拿公司名互相比。DeepSeek-V4.1-Flash是一個相關的大模型候選,其倉庫標註 MIT 許可證和多模態輸入。DeepSeek V4.1 Flash 介紹解釋的是它自己的架構和獲取方式,相關成績不能直接搬給 Beam。
Qwen 也提供更小的編碼模型。例如 Qwen3-Coder-30B-A3B-Instruct標註 30.5B 總引數、3.3B 啟用引數、Apache 2.0 和原生 256K 上下文。這裡選擇這個較早的 checkpoint,是為了說明不同部署規模的選擇,不是把它當成 Qwen 當前最強模型。Qwen3.8 Max則是另一款產品。
Mistral 的 Devstral Small 2 24B也是具體的編碼候選,公開了 Apache 2.0 權重和 Mistral Vibe 整合說明。它的總規模更小,對應另一種容量決策。不能由此推斷 Mistral 所有模型都使用同一許可證。
所以,值得比較的是團隊到底需要什麼:可定製的大模型服務、更小的本地編碼部署,還是已經執行穩定的託管端點。把不同模型卡上的數字拼成“最強排行榜”,往往會掩蓋真正的選擇條件。
Agent 還需要比較 harness,即連線模型、工具和任務狀態的執行系統。工具定義、重試、上下文管理和命令許可權都可能改變結果。DeepSeek Harness 瀏覽器整合指南可以幫助理解這一區別,但不能拿來證明 Mirror 或 Beam 已支援相同整合。Agentic Reasoning 指南進一步解釋了為什麼只比較最終回答不夠。
用 Tabbit 整理釋出證據,再決定是否試用
研究新模型時,瀏覽器裡常同時開著早期公告、更新後的模型卡、推理配方和社群討論。先解決這些頁面之間的日期和狀態衝突,比急著下載模型更有用。Tabbit 的瀏覽器工作流可以把相關網頁作為分析上下文。
把 10 月 5 日、10 月 16 日的公告,模型卡和部署指南放在一起,要求輸出一份帶日期的清單:每行給來源 URL,把“已經發布”和“後續承諾”分列。官方 v1.13 日誌還記錄了供外部 Code Agent 使用的 Tabbit CLI;實際整合配置和不同地區的可用情況仍需檢查。
這是一個建議的資料核對流程,不是 Beam 在 Tabbit 中的實測。瀏覽器能讀公告,不代表已經執行模型或驗證編碼成績。程式碼執行留給合適的編碼 harness;瀏覽器在多步任務中的作用,可參考 Agentic Browser 指南。
釋出證明了什麼,實際評估還缺什麼?
目前的證據足以證明權重和一批配套工具已公開,但不足以證明 Beam 對你的任務一定最快、最省錢。Reflection 的效率論述有其測試和計算條件。生成 token 更少,不能直接推匯出端到端賬單更低。
實際比較時,更有用的公式是:
每個驗收透過任務的成本 = 全部執行成本 ÷ 驗收透過的任務數按需要把失敗嘗試、工具呼叫、閒置基礎設施和人工複核都計入。固定程式碼版本、任務集、harness、精度、推理預算和超時條件,再記錄補丁能否透過測試、遇到工具錯誤能否恢復、人工還需要修多久。一輪小範圍試用能支援決策,不必包裝成全面評測。
哪些人現在值得試 Beam?
| 你的主要約束 | 更合理的第一步 | 投入前需要確認 |
|---|---|---|
| 希望控制大型編碼模型的部署 | 先測文件中列出的端點,再試自部署 | 任務效果、容量、運維責任 |
| 只有一臺普通工作站 | 先比較較小的 Qwen 或 Devstral checkpoint | 完整權重佔用與可接受延遲 |
| DeepSeek 或 Qwen 已經跑得穩定 | 同任務、同 harness 加測 Beam | 改善是否值得遷移 |
| 想針對細分領域做定製 | 檢視已經提供的微調、RL 配方 | 算力、資料和評估成本 |
| 只是想弄清這次新聞 | 對照發布文和模型卡 | 哪些已經交付,哪些仍在計劃中 |
Beam 值得評估,因為它增加了一個可以下載的模型,以及可以檢查和修改的 Agent 工具。對有部署和定製要求的團隊,這意味著更多選擇;是否遷移,仍應等自己的試用結果。
下一步可以很小:挑一個代表性任務,寫清驗收條件,與當前方案對照。需要收集和核對來源時,可以用 Tabbit 整理閱讀;需要部署 501B 引數時,先看推理指南和硬體預算。

常見問題
Reflection Beam 到底是哪一天開放權重的?
2026 年 10 月 5 日是模型首次介紹,10 月 16 日才是權重正式開放。後者的官方公告確認 Hugging Face 上的 Apache 2.0 權重以及配套部署和 Agent 整合。
Beam 是開源模型,還是開放權重模型?
更準確的說法是:Beam 開放了 Apache 2.0 權重,並提供 Mirror 等開源工具。這不等於完整訓練語料和端到端可復現的訓練流水線都已公開。本次核對時,模型卡仍把技術報告標為即將釋出。
Beam 只啟用 23B 引數,24GB 顯示卡就能執行嗎?
啟用引數量描述每個 token 的計算,不代表完整權重佔用。Beam 總引數約 501B,Hugging Face 的介紹給出的 BF16 權重約 1TB,NVFP4 約 280GB。解除安裝到記憶體或磁碟會改變速度與容量的取捨,不會讓其餘權重消失。
Beam 比 DeepSeek、Qwen、Mistral 更好嗎?
本文沒有建立這樣的普遍結論。應鎖定具體 checkpoint,在相同任務、harness、精度和預算下比較。硬體容量有限時,Qwen 和 Mistral 的較小編碼模型也可能更實用。
Reflection Beam 和 Apache Beam、beam search 是一回事嗎?
不是。本文的 Beam 指 Reflection 的語言模型,對應 reflection/Beam-1.0-501B-A23B 倉庫。Apache Beam 是資料處理專案,beam search 是一種解碼搜尋方法。
能在 Tabbit 瀏覽器裡直接選擇 Beam 嗎?
本文沒有確認 Tabbit 的模型清單已經提供 Beam。Tabbit 可以用於閱讀和核對模型釋出資料;執行 Beam、執行編碼任務仍需要對應的推理端點和 Agent harness。可用模型以當前客戶端為準。