
LongCat 2.5 はコードや視覚タスクで管理された試用に値しますが、無人の本番エージェントに任せる根拠はまだ不足しています。Tabbit の2つの小さなタスクでは表の計算と修正コードは正しかった一方、元のコードの結果を2か所誤って説明しました。
公式評価の Terminal Bench v2.1 は 2.5 が88.4、2.0 が70.8です。提供元の条件下での比較であり、自分のプロジェクトの成功確率ではありません。
要点
提供元によると総パラメータ1.6兆、トークン当たり約480億が有効です。
スコアは実行環境に依存し、独立した再現実験ではありません。
Preview には好意的な報告とツールのループ報告があり、後の版の挙動を証明しません。
11月3日時点で重みは近日公開と表示されていました。
ファイルやツールを渡す前に利用可否、プライバシー、価格を確認してください。
LongCat 2.5 の概要
| 項目 | 11月3日時点の確認 | 証明されないこと |
|---|---|---|
| モデル | 総1.6T、トークン当たり約48B有効 | 実際の遅延や費用 |
| エージェント | 公式表で2.0から改善 | 本番での成功率 |
| 視覚 | 視覚入力をトークンで表現 | 生成ページの正確さ |
| 重み | GitHub と Hugging Face は近日公開 | 公開日やライセンス |
| Tabbit | テストアカウントで2つのチャット | 別アカウントの枠 |
前世代は LongCat 2.0 の概要、モデルとクライアントの違いは エージェント型ブラウザの説明を参照してください。
ランキングより先に:Tabbit で2つの実験
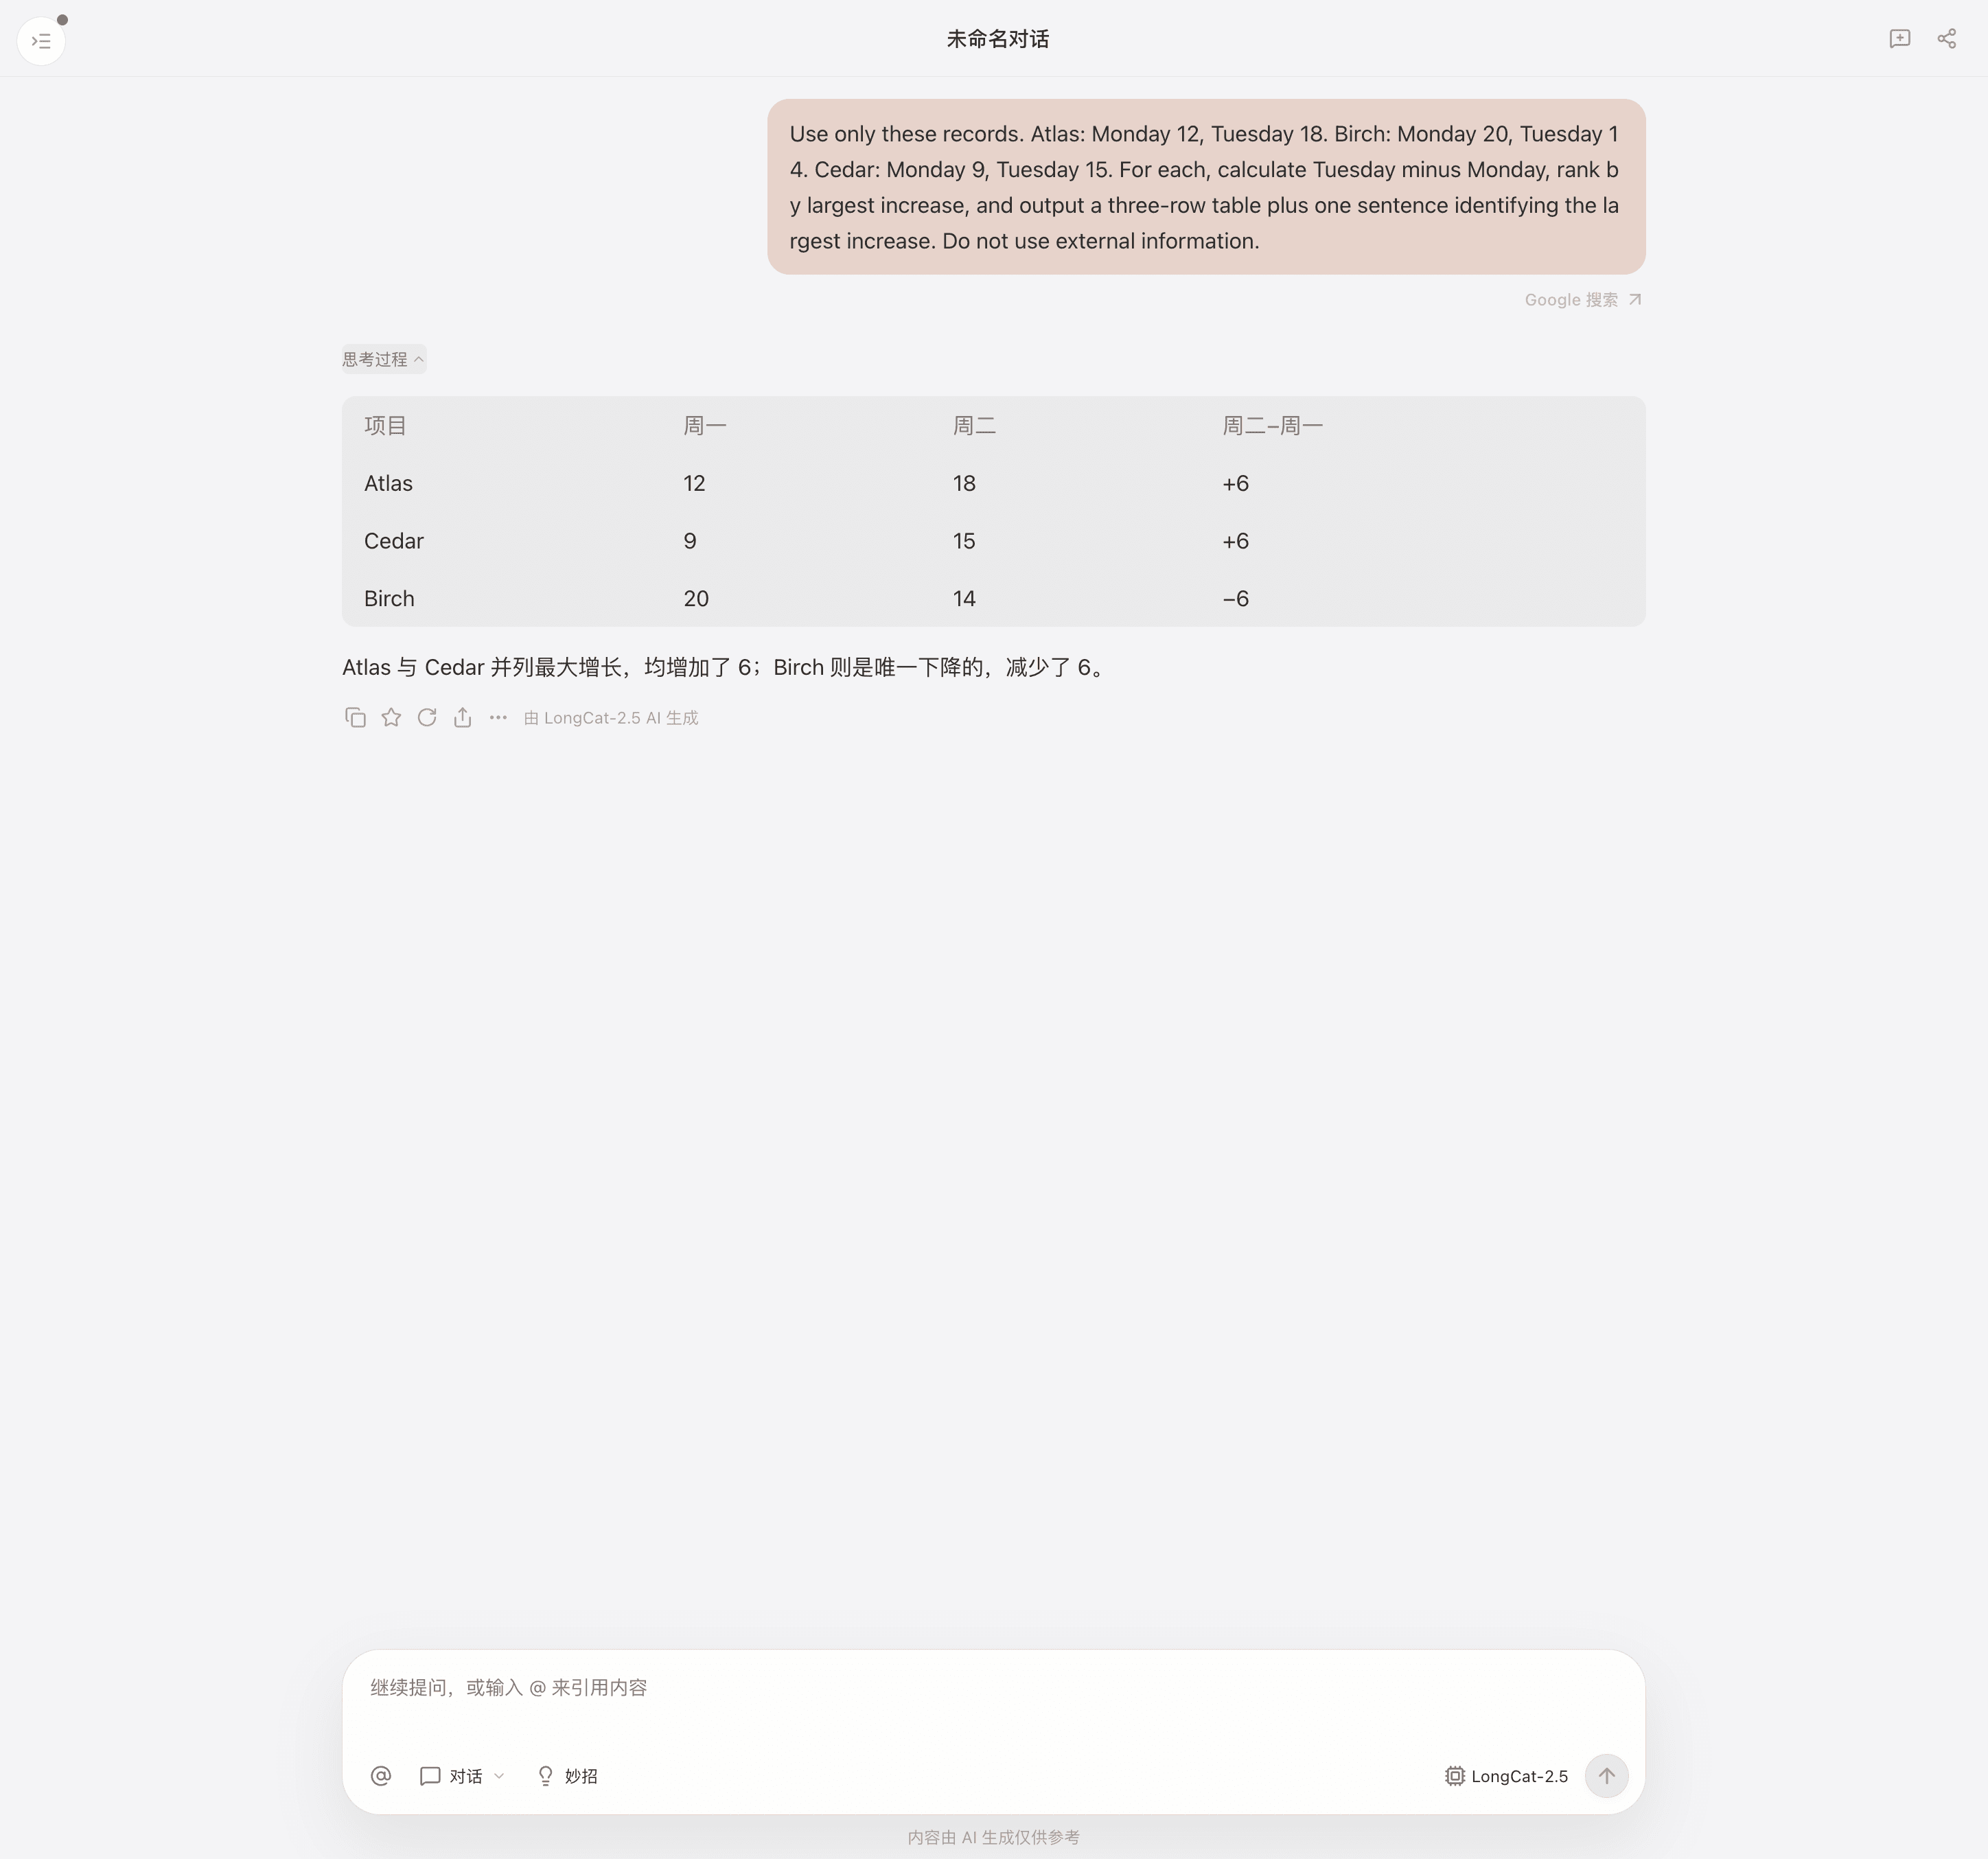
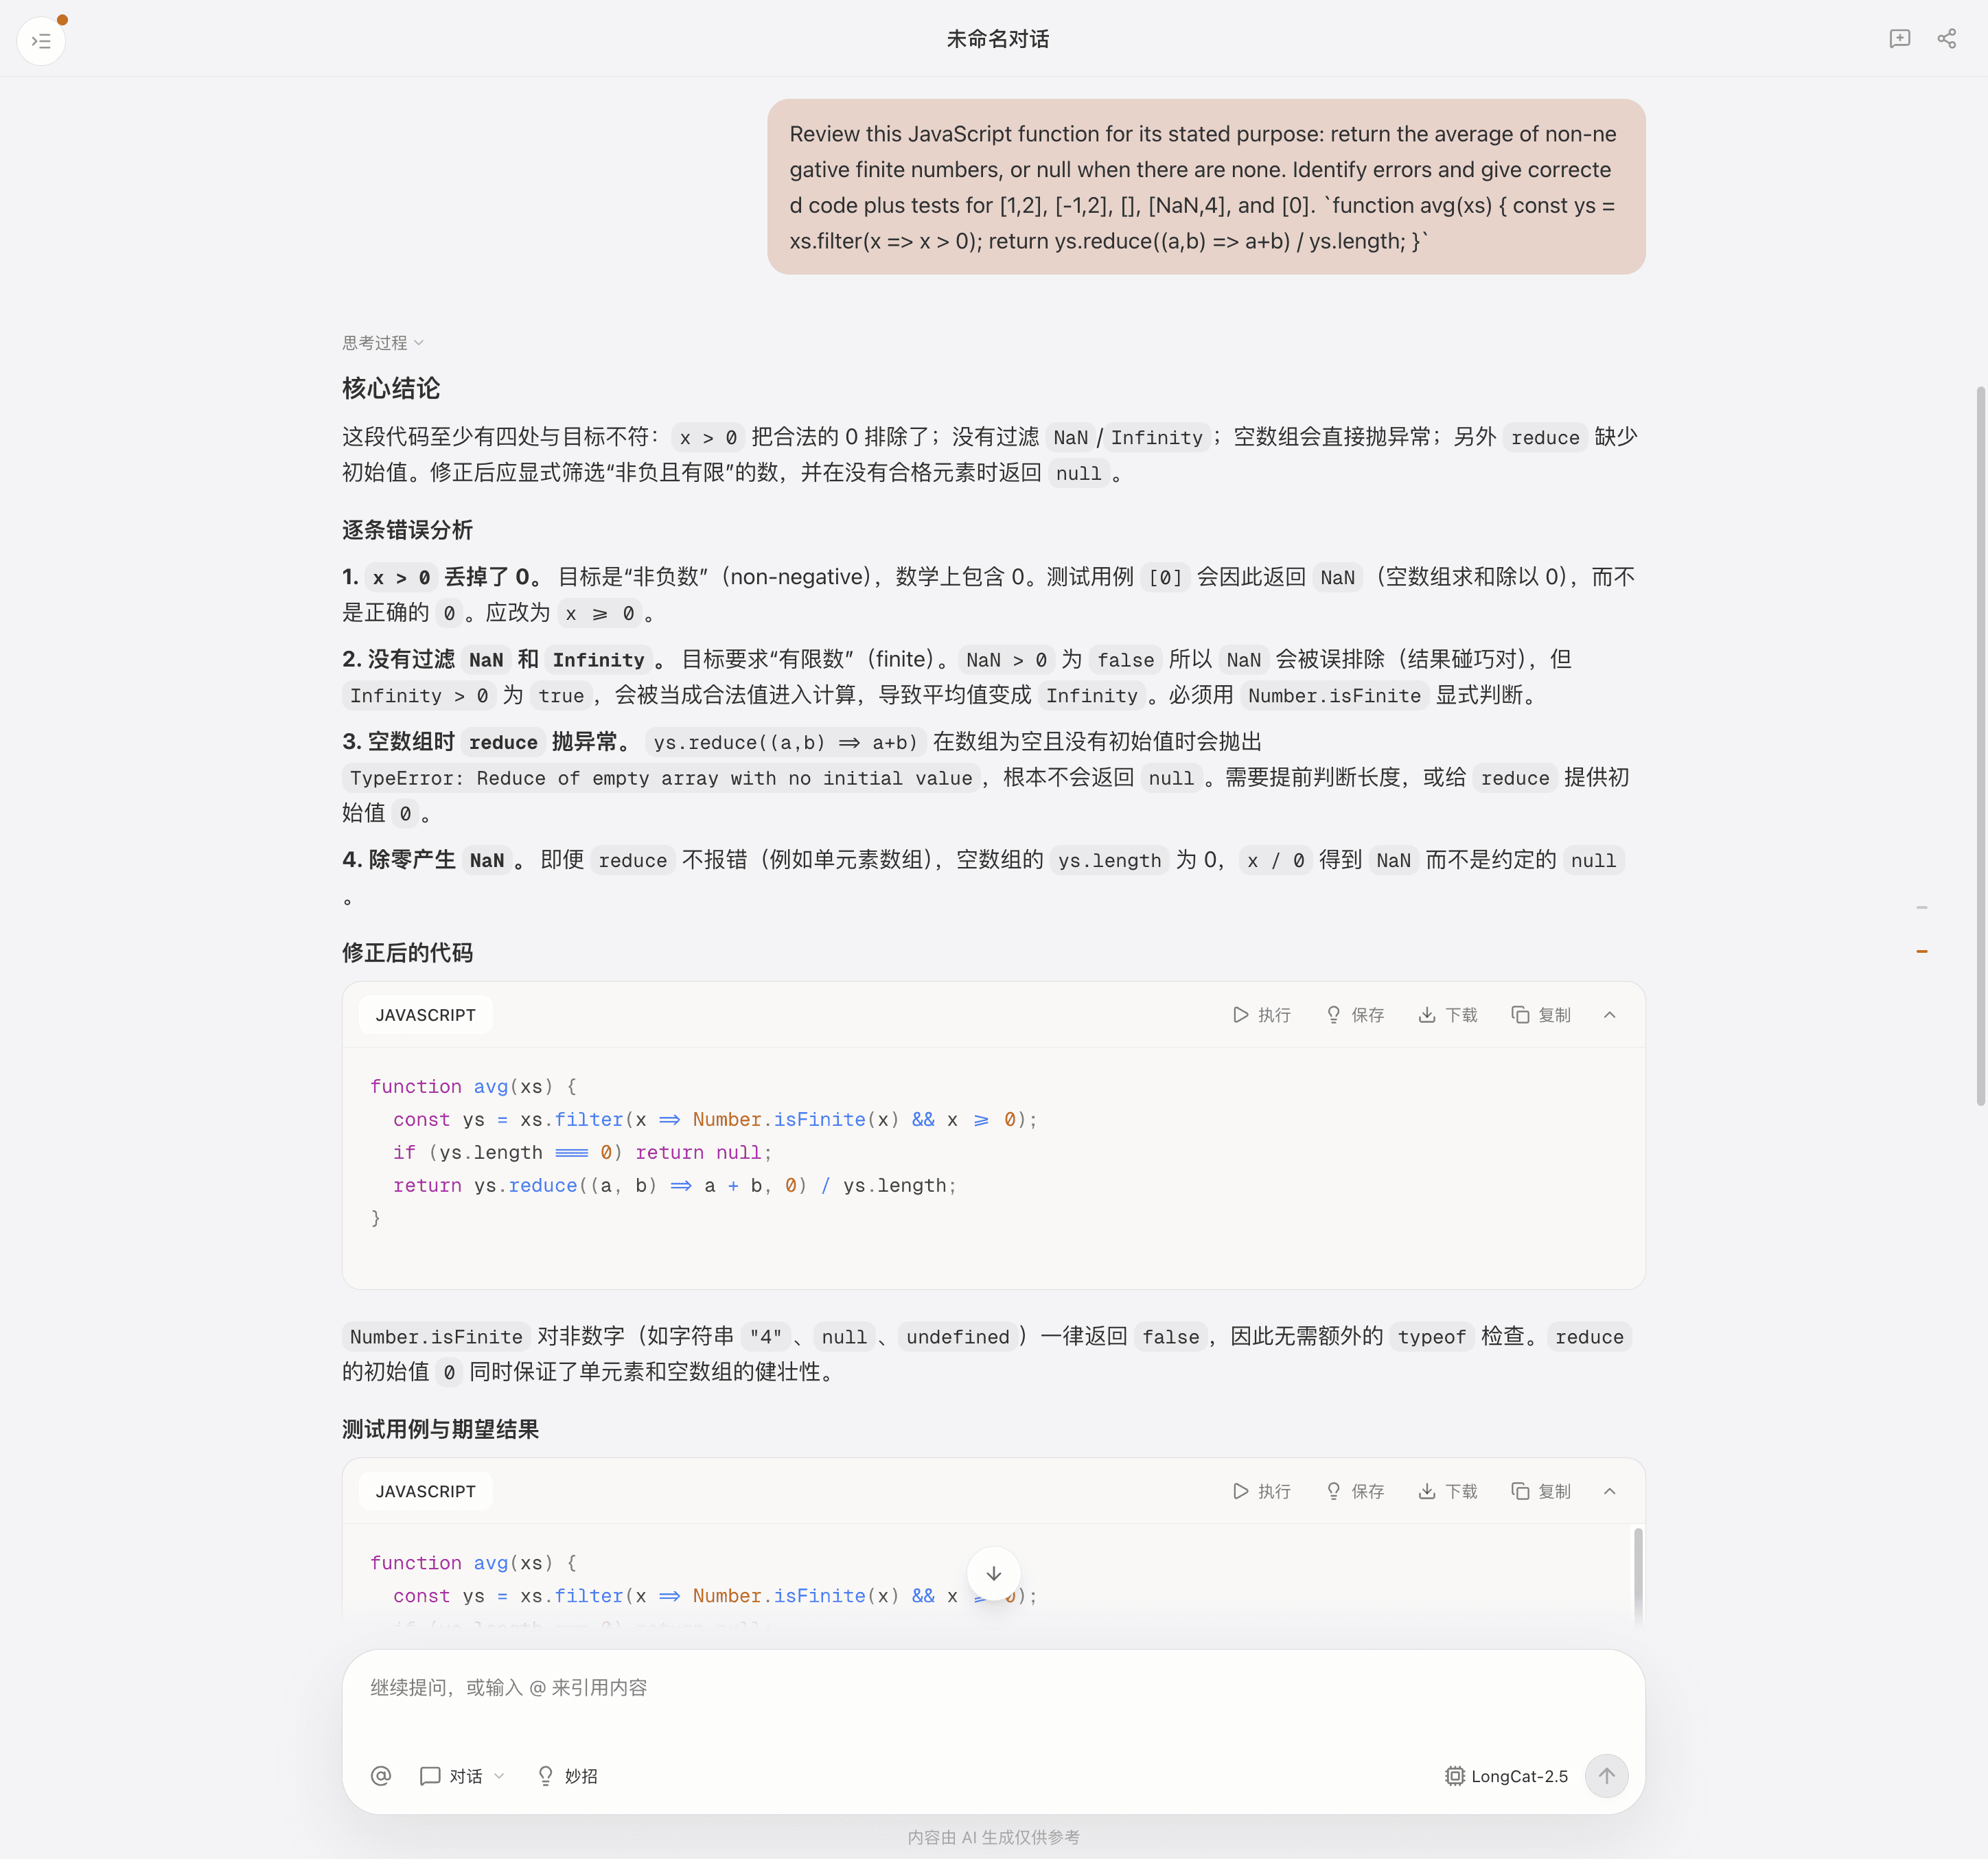
11月3日、Tabbit Browser Dev のテストアカウントで LongCat-2.5 を選び、書き込みツールを使わずチャットしました。事前に基準を定め、同一会話で各タスクを1回実施。モデルのスナップショット、提供経路、推論設定、トークン、費用は不明です。成功率や他アカウントの可用性は推定できません。
架空の3組の数値から +6、+6、−6 を正しく計算し、同率を示しました。英語の入力は出力言語を指定しておらず、中国語環境での回答は中国語でした。
JavaScript 関数のレビューでは、非負の有限数を抽出し空なら null を返す修正を提案しました。ローカル実行で指定5ケースは期待どおりでした。一方、元のコードについて [NaN, 4] は NaN ではなく 4、[0] は NaN ではなく TypeError なのに、どちらも誤って説明しました。テストコードは提示しましたが、モデル自身が実行した証拠はありません。リポジトリの自律編集は試していません。
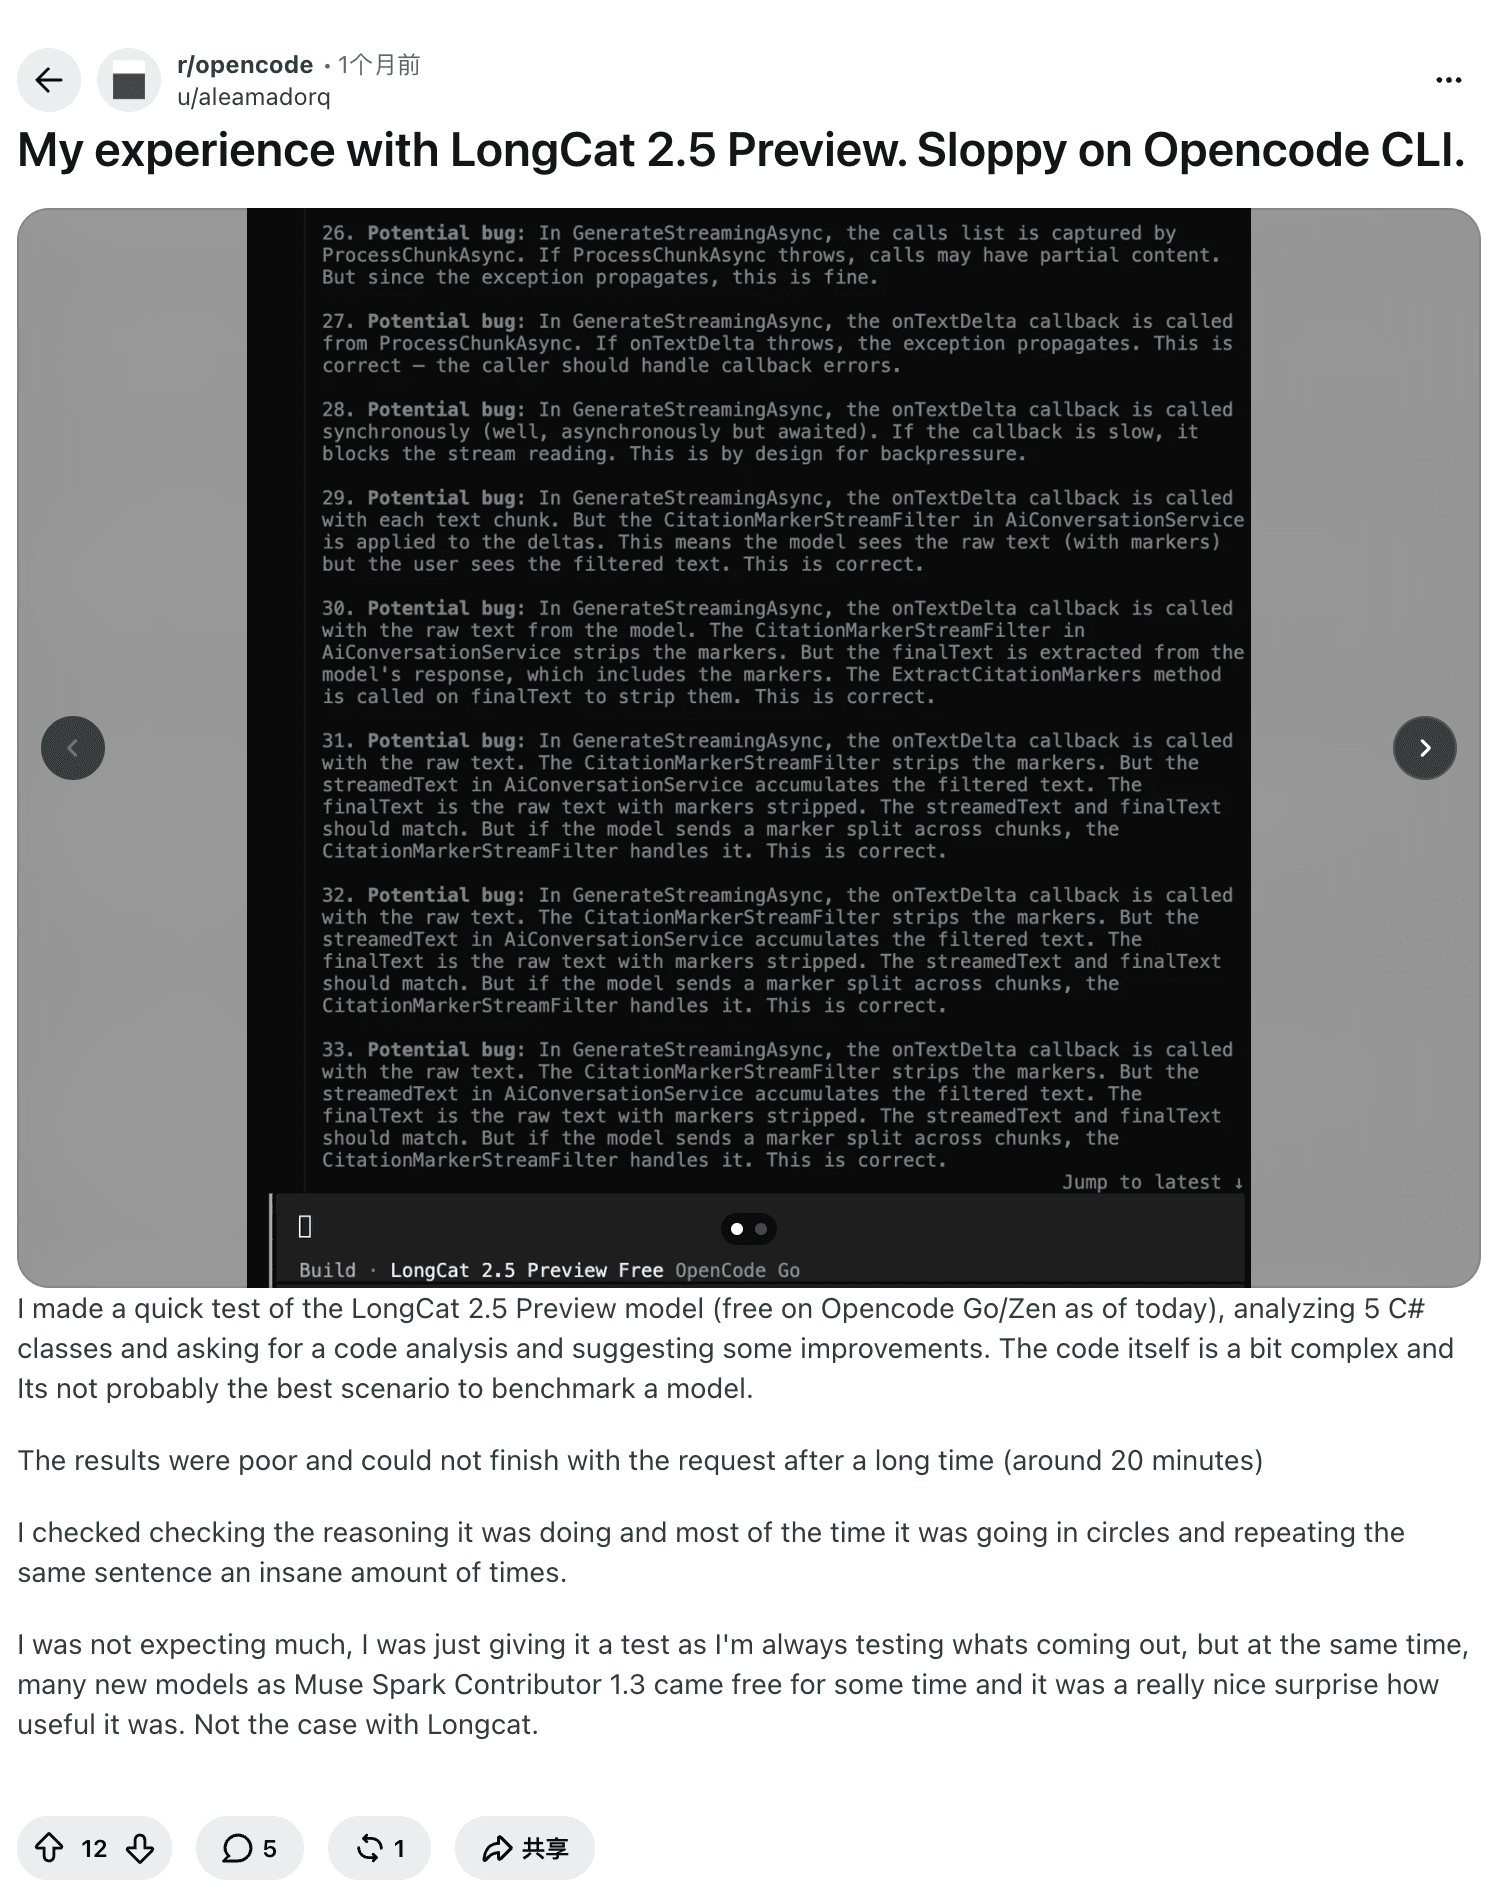
コミュニティの声:Preview と11月版を区別する
Reddit の投稿者は OpenCode の Preview が5つの C# クラスの分析でループし、約20分で完了しなかったと報告しました。入力と設定の全体は未公開です。別の Preview 実験は89問を3回ずつ実行し pass@1 48.7%、pass@3 64.0% と報告し、1問で端末側の継続的な失敗を記載しています。後のモデルの公式値と直接比較はできません。
DEV の体験談は複数プロジェクトで Preview の文脈把握とツール連携を評価していますが、完全な入力や管理されたログは公開していません。
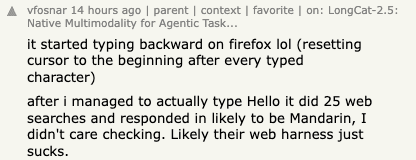
Hacker News の InsideOutSanta は自転車に乗るペリカンの画像を評価しましたが、全設定は不明です。vfosnar は Firefox での入力問題と繰り返し検索を報告し、クライアント側の問題と推測しました。swiftcoder は Preview で簡単なコード作業をしたと述べていますが詳細はありません。いずれも個人の体験です。
TOKRACE の評価は Claude Code を使う11月版の15の創作タスクを記録しました。本棚の寸法は正しかった一方、減速機は140ミリを140メートルとし指定動画も未提出。グラフは年、単位、出典を作り出しました。第三者の設定下での結果です。
公式ベンチマークと条件
| 公式テスト | 2.5 | 2.0 | 対象 |
|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 端末エージェント |
| Terminal Bench v4.0 | 38.5 | 3.0 | 別バージョンのテスト |
| BrowseComp | 91.9 | 79.9 | 検索と調査 |
| AutomationBench public v1.0.6 | 51.8 | 15.8 | 公開600問 |
| Vision2Web | 78.6 | 未報告 | 画像からウェブ |
公式資料、2026年11月3日確認。特記がなければ thinking 有効、temperature 1、top-p 0.95。Terminal v2.1 は Claude Code v2.1.280、最大512K、3回の平均です。BrowseComp は独自ハーネス、2ツール、最大1,024ターン。Vision2Web は別の Claude Code と256Kを使用。競合の値は外部資料と提供元測定が混在します。v2.1 と v4.0 を混比せず、費用や実務成功率に直結させないでください。
試す価値のある3つの用途
複数段階のコード作業
端末タスクの公表上の改善は、テスト付きの小さな課題を試す理由になります。
公開情報の調査
BrowseComp は公開情報の調査の参考であり、ログイン先での動作保証ではありません。
視覚入力
画像入力からページを試せますが、表示、アクセシビリティ、コードの検証が必要です。 自動化ガイドは手順を扱い、モデル品質の証明ではありません。
3つの制約
クライアントで結果が変わる
クライアントはツール選択やループに影響します。
重みは未公開
回数を制限し、Tabbit の実践ガイドも参考に変更を確認してください。
価格とデータの条件
2.5 の重みは近日公開の表示でした。 公式料金は11月3日時点で100万トークン当たり未キャッシュ入力2元、キャッシュ入力0.04元、出力8元の期間限定価格。 保存・データ所在地の条件は要確認で、API、購読、Tabbit は別です。 DeepSeek V4 Flash の料金も参照できます。
Tabbit での確認方法
公開記事を開き、出典付きの主張を5つ求め、各出典を確認します。モデル、日付、入力、回答、修正を記録し、条件を確認するまで私的文書を渡さないでください。選択肢はアカウントごとに異なります。DeepSeek Harness ガイドでクライアントの役割を確認し、DeepSeek V4.1 Flashとは同一条件で比較します。複数モデル調査の整理も参考になります。
 Tabbit Browser
ダウンロードだけではモデルは実行されません。選択画面とアカウント条件を先に確認してください。
用途別の判断
| 用途 | 判断 | 理由 |
|---|---|---|
| テスト付き公開コード | 使い捨てブランチで試す | 変更とロジックを確認。 |
| 視覚プロトタイプ | スクリーンショットで試す | 表示とアクセシビリティを検証。 |
| 機密データ | 条件確認まで待つ | ポリシーは提供元による。 |
| ローカル運用が必須 | 重みとライセンスを待つ | リンクは近日公開だった。 |
| 無人の本番エージェント | 準備完了と決めつけない | 2回のチャットは長期信頼性を示さない。 |
実際に使うクライアントと提供元で同じ検証可能なタスクを実行し、版、設定、再試行、費用、修正を残してください。1回の結果は信頼率ではありません。

よくある質問
LongCat 2.5 は試す価値がありますか?
コードや視覚タスクを管理された条件で試す候補です。小さな2つの実験は長時間エージェントの信頼性を証明せず、コードの元の動作について2か所の誤説明がありました。
2.5 Preview との違いは?
LongCat は Preview の後、2026年11月1日に 2.5 を発表しました。Preview の体験は11月版の直接の実測ではありません。
モデルの重みは公開されていますか?
11月3日時点で公式の GitHub と Hugging Face のリンクは近日公開と表示されていました。自前運用前に実際のファイルとライセンスを確認してください。
プログラミングに使えますか?
提供元は Claude Code を使い3回の平均で Terminal Bench v2.1 の88.4を報告しています。自分の環境でテストと変更レビューを行ってください。
Tabbit で使えますか?
2026年11月3日、Tabbit Browser Dev のテストアカウントでは LongCat-2.5 を選択できました。利用可否や条件はアカウントとエディションにより異なります。
価格はいくらですか?
公式ページには100万トークン当たり未キャッシュ入力2元、キャッシュ入力0.04元、出力8元の期間限定価格が表示されていました。価格は変わり、API と Tabbit の条件は別です。