
O LongCat 2.5 merece um teste controlado para código e trabalho visual, mas ainda não há base para um agente de produção sem supervisão. Em duas tarefas no Tabbit, ele calculou uma tabela e propôs uma correção útil, mas descreveu incorretamente dois resultados do código original.
A avaliação oficial informa 88,4 no Terminal Bench v2.1 contra 70,8 do 2.0. A comparação depende do ambiente da fornecedora e não é a chance de sucesso no seu projeto.
Pontos principais
A fornecedora descreve 1,6 trilhão de parâmetros totais e cerca de 48 bilhões ativos por token.
Os resultados dependem do ambiente e não são reprodução independente.
Relatos sobre o Preview incluem elogios e loops de ferramentas; não comprovam o comportamento da versão posterior.
Os pesos ainda eram anunciados para breve em 3 de novembro.
Confira disponibilidade, privacidade e preço antes de liberar arquivos ou ferramentas.
LongCat 2.5 em resumo
| Aspecto | Verificado em 3 de novembro | O que não demonstra |
|---|---|---|
| Modelo | 1,6T totais e cerca de 48B ativos por token | Latência ou custo real |
| Agentes | Melhora sobre 2.0 na tabela oficial | Taxa de sucesso em produção |
| Visão | Entrada visual representada por tokens | Fidelidade de qualquer página |
| Pesos | GitHub e Hugging Face: em breve | Data ou licença |
| Tabbit | Duas tarefas de chat em conta de teste | Cota de outras contas |
Veja a visão geral do LongCat 2.0 e o guia de navegador com agentes para separar modelo e cliente.
Dois testes no Tabbit antes dos rankings
Em 3 de novembro escolhemos LongCat-2.5 no Tabbit Browser Dev, em modo de chat e sem ferramentas de escrita. Os critérios foram definidos antes; cada tarefa rodou uma vez na mesma conversa. Snapshot do modelo, provedor, nível de raciocínio, tokens e custo são desconhecidos. Não é possível inferir taxa de sucesso ou disponibilidade geral.
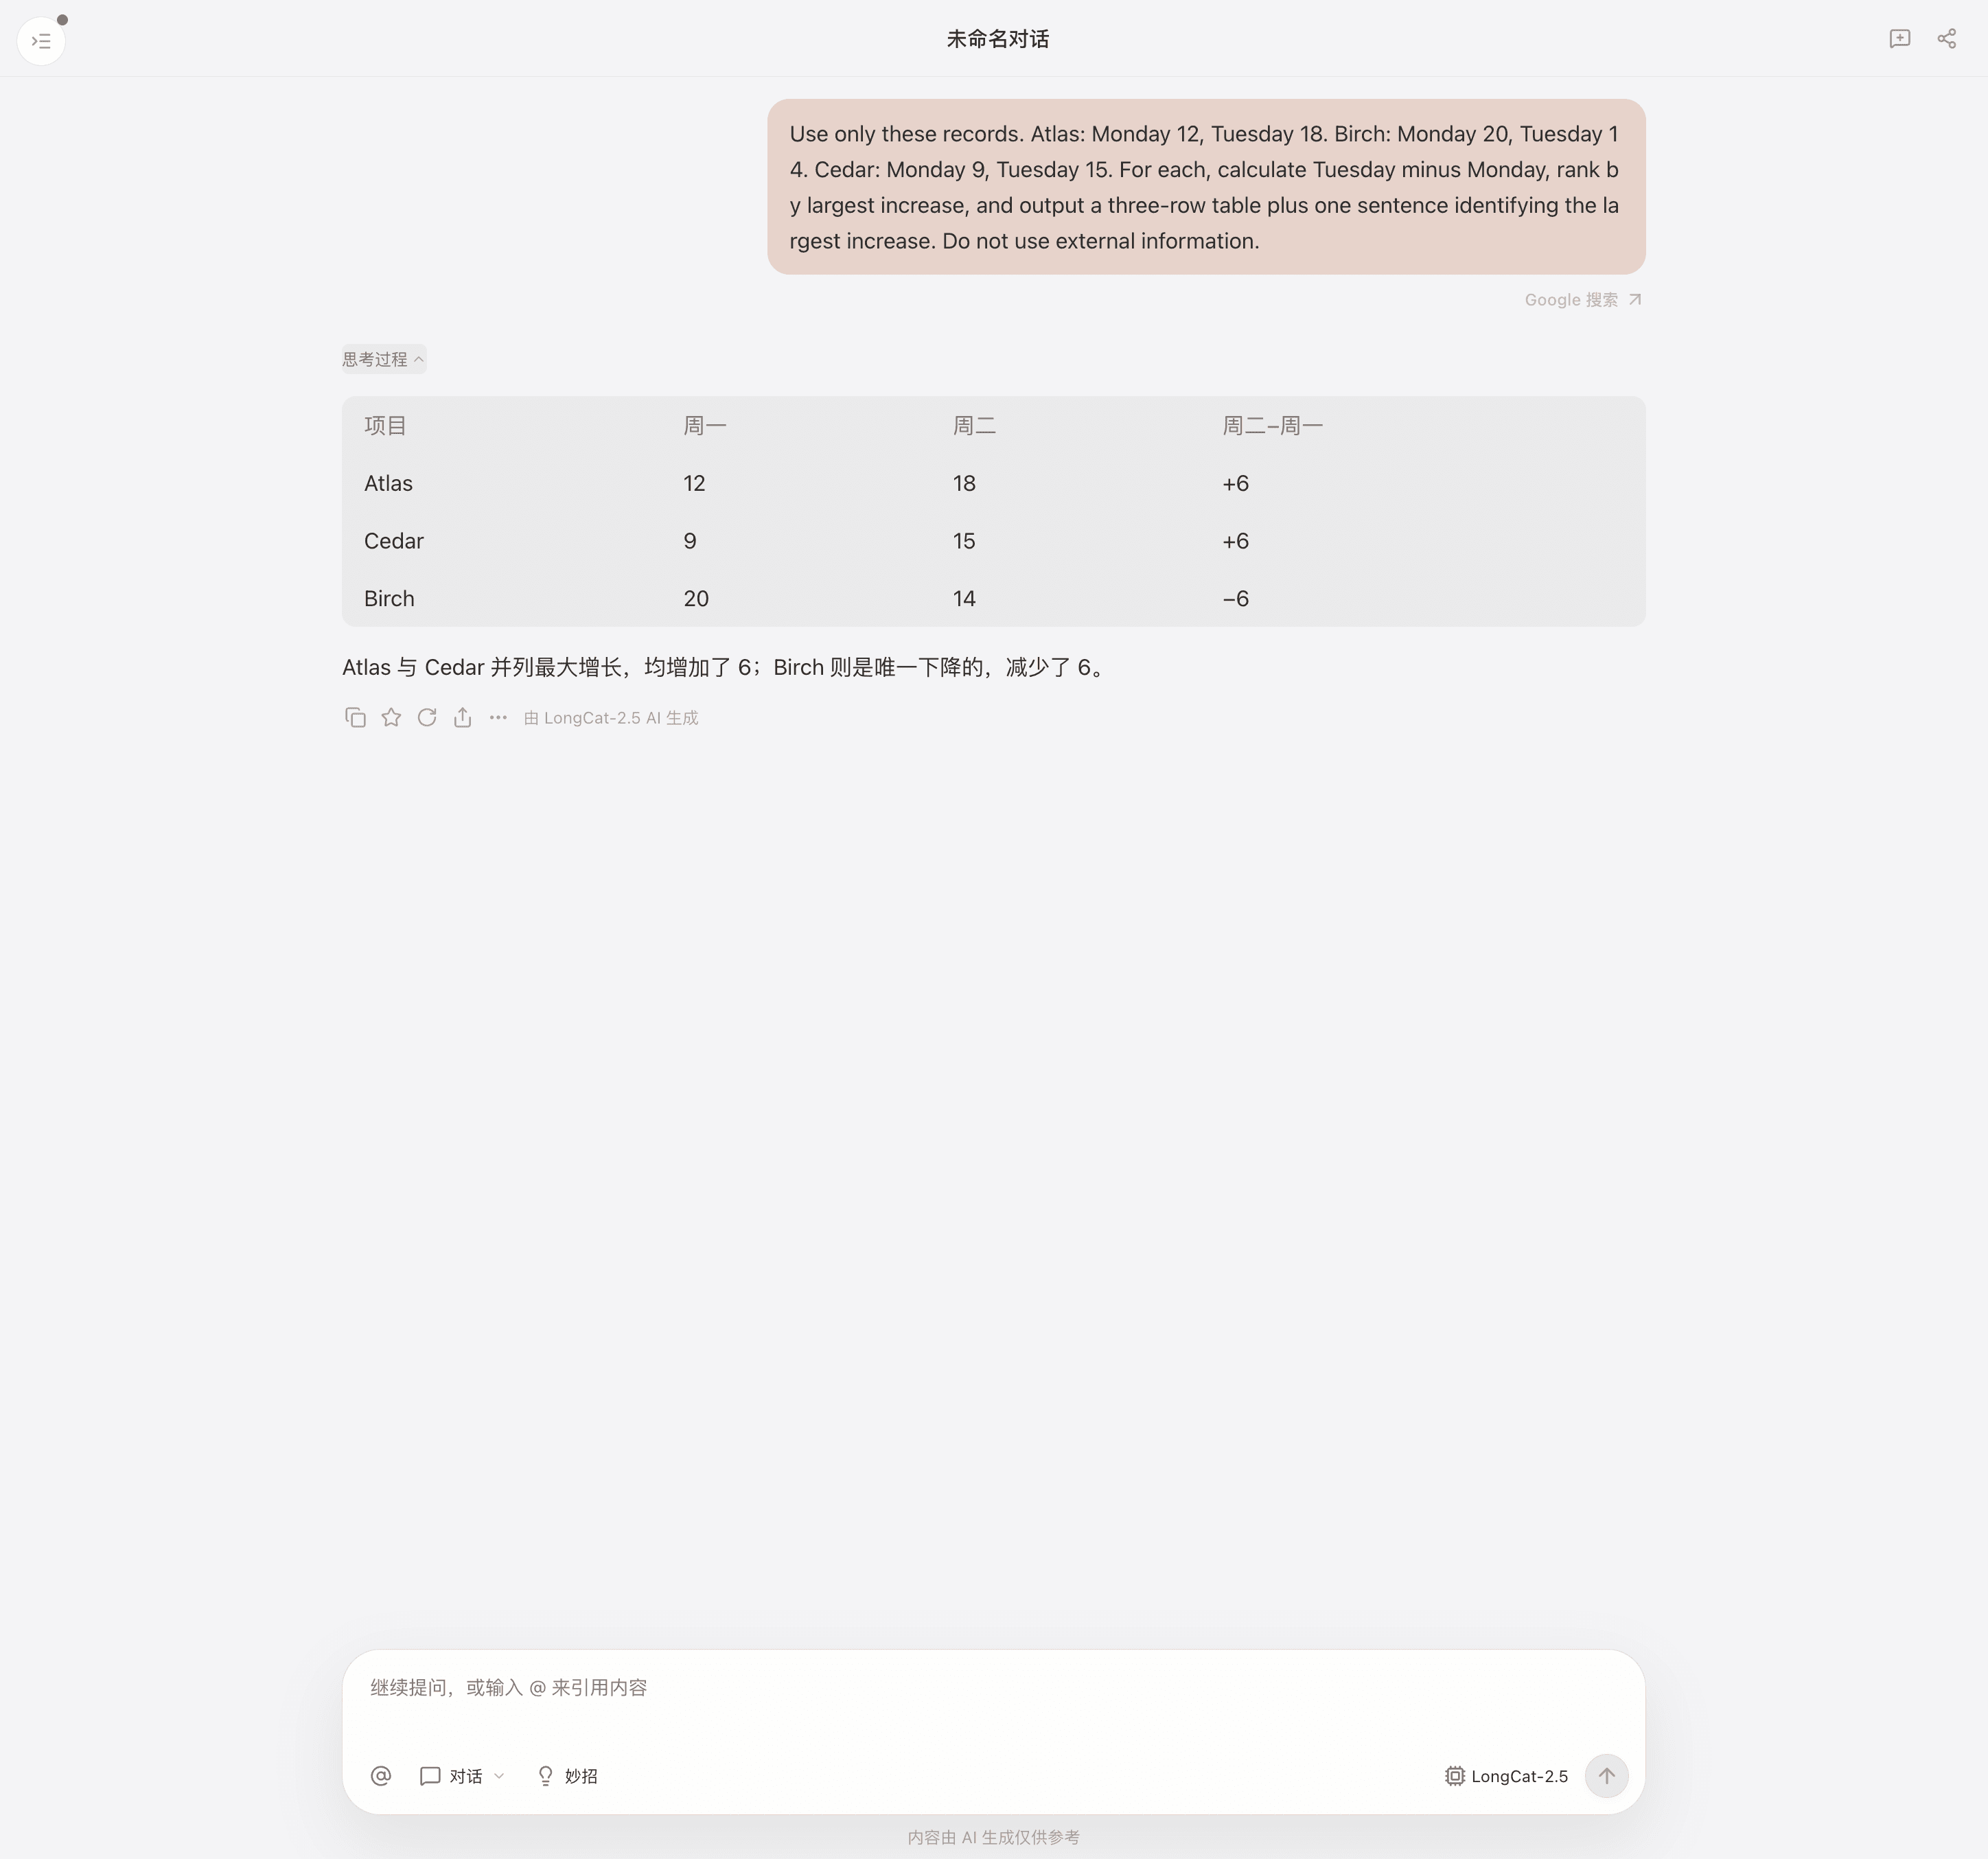
Com três conjuntos de números fictícios, o modelo calculou +6, +6 e −6 e identificou o empate. Respondeu em chinês num ambiente em chinês; o pedido em inglês não exigia idioma de saída.
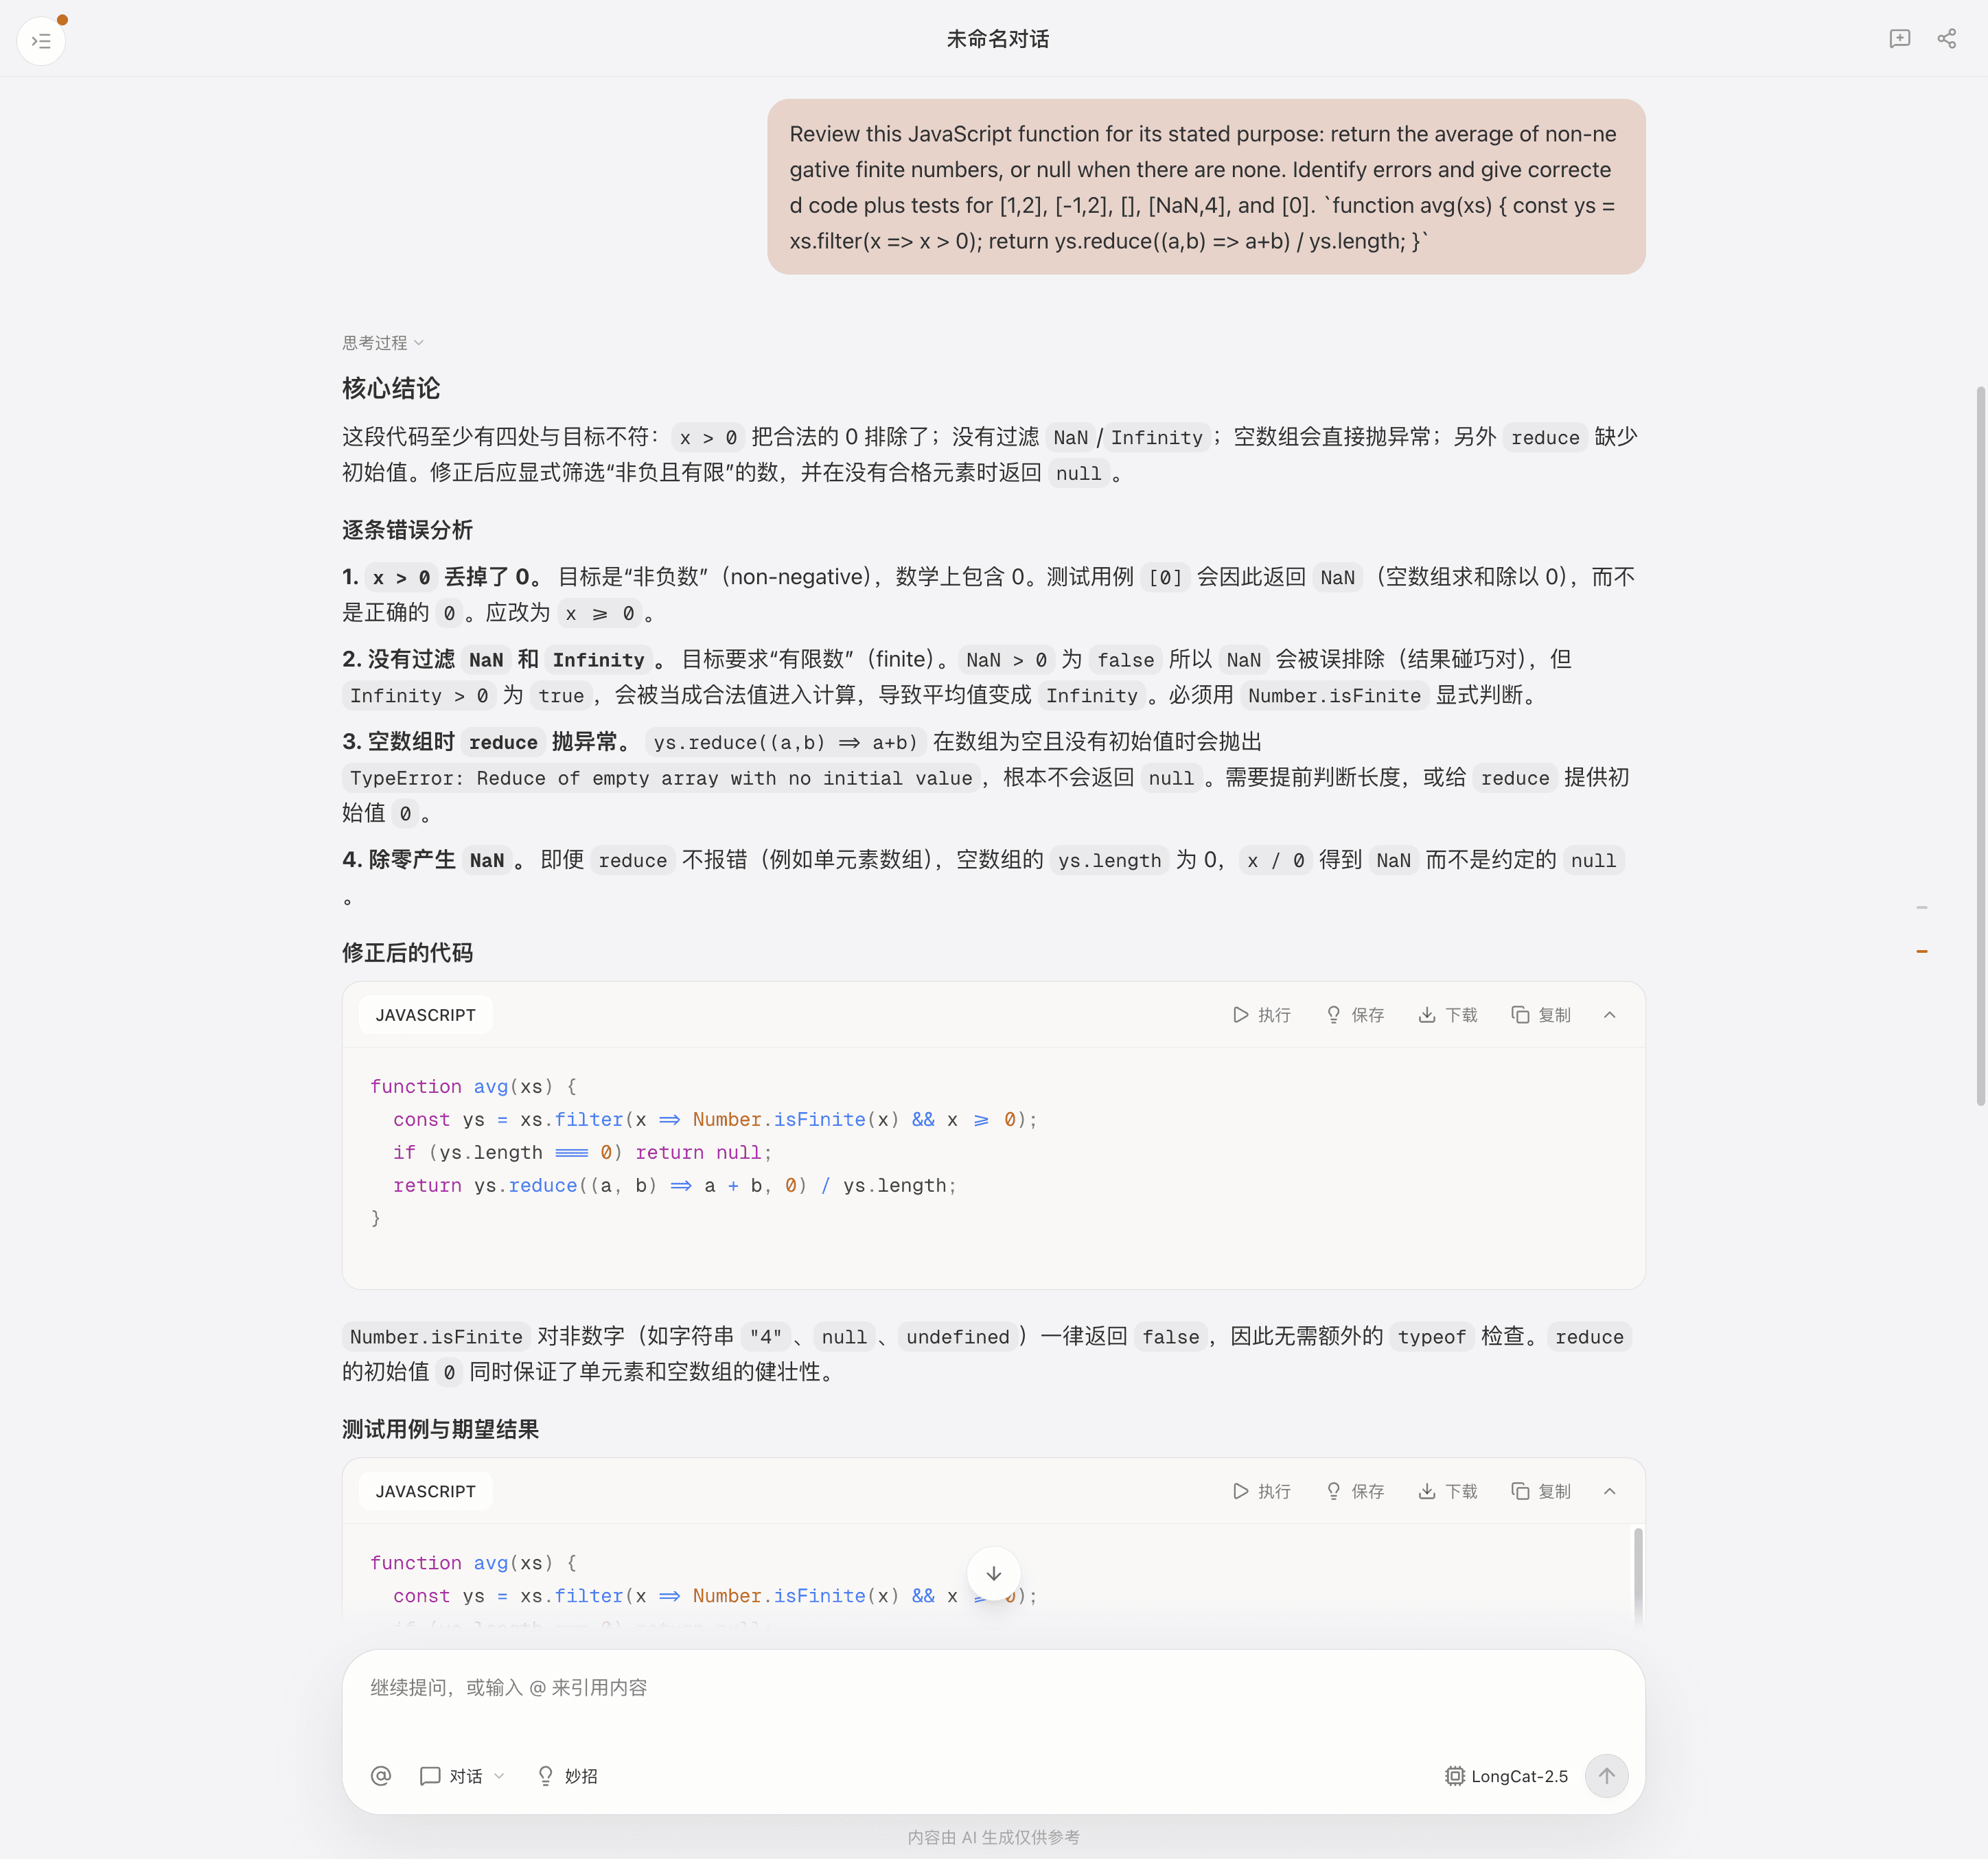
Na revisão de uma função JavaScript, a correção filtrou números finitos não negativos e retornou null para uma lista vazia. Executada localmente, produziu os cinco resultados esperados. Mas a explicação do código original errou duas vezes: [NaN, 4] retorna 4, não NaN; [0] lança TypeError, não NaN. O modelo sugeriu testes sem demonstrar que os executou. Não testamos edição autônoma de repositórios.
Relatos: Preview e versão de novembro
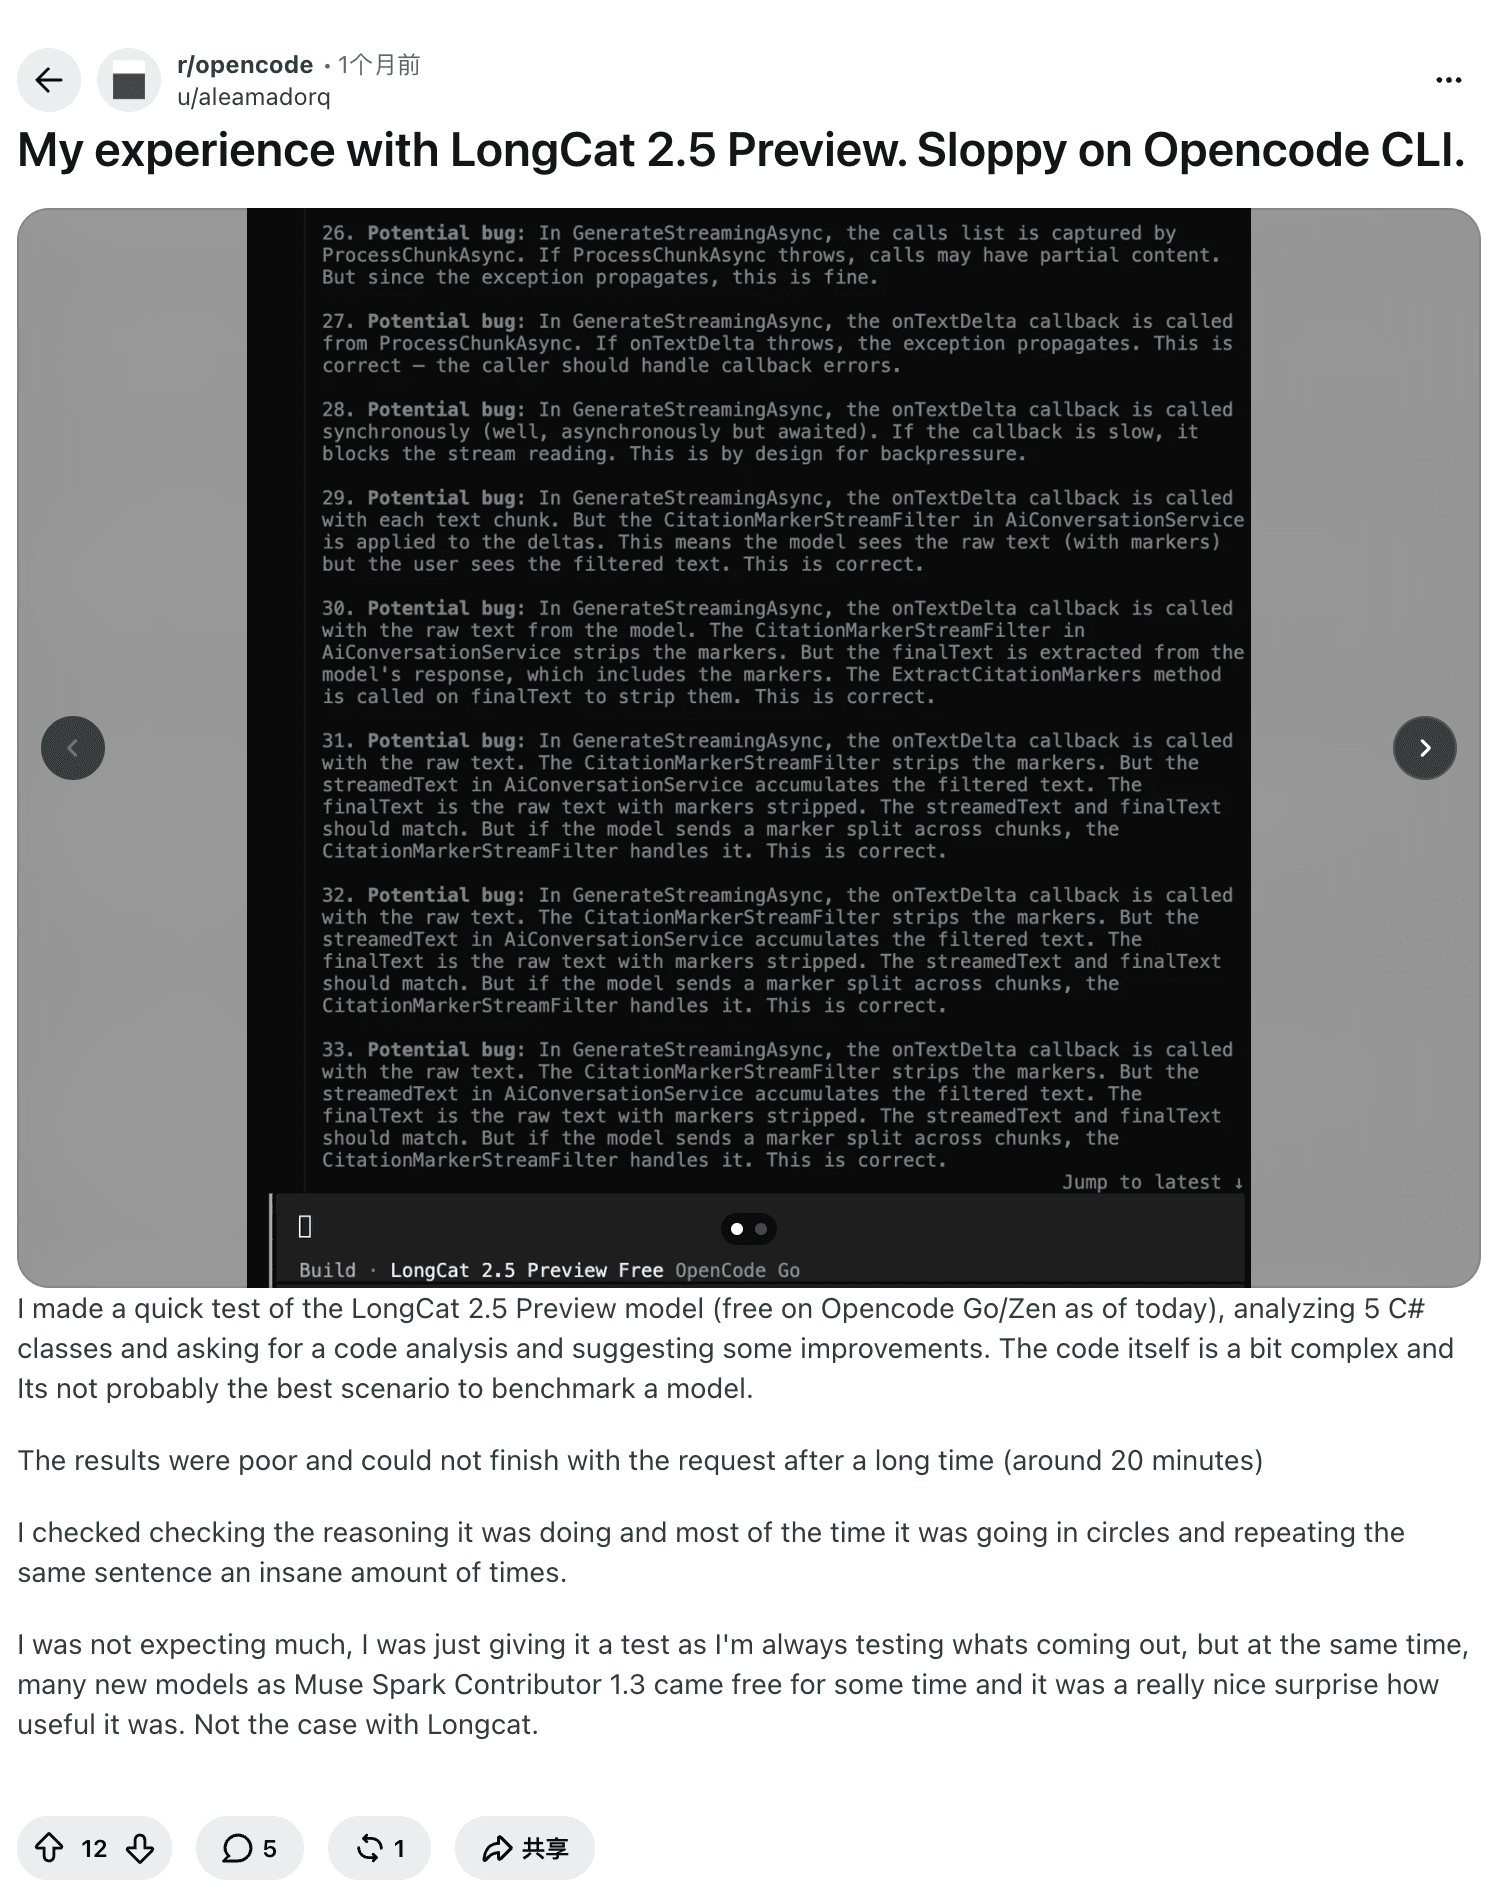
Um usuário do Reddit diz que o Preview entrou em loop ao analisar cinco classes C# no OpenCode e não terminou em cerca de 20 minutos; entrada e configuração completas não foram publicadas. Outro teste do Preview informa 48,7% pass@1 e 64,0% pass@3 em 89 tarefas repetidas três vezes, com falha persistente do dispositivo em uma tarefa. Não é comparável diretamente ao resultado oficial da versão posterior.
Um relato no DEV prefere a compreensão de contexto e a coordenação de ferramentas do Preview em vários projetos, sem publicar prompts completos ou registros controlados.
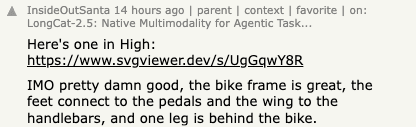
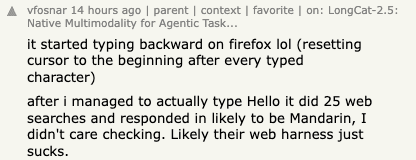
No Hacker News, InsideOutSanta elogiou uma imagem de pelicano numa bicicleta, sem detalhar toda a configuração. vfosnar relatou problemas de digitação no Firefox e buscas repetidas, atribuindo-os provisoriamente ao cliente. swiftcoder relatou tarefas simples de código com Preview, sem detalhes. São experiências individuais.
A avaliação da TOKRACE descreve 15 tarefas criativas com a versão de novembro no Claude Code: uma estante respeitou as dimensões; um redutor usou 140 metros em vez de 140 milímetros e não entregou o vídeo solicitado; um gráfico inventou ano, unidades e fonte. Os resultados de terceiros dependem da configuração usada.
Testes oficiais e condições
| Teste oficial | 2.5 | 2.0 | Tarefa |
|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | Agente de terminal |
| Terminal Bench v4.0 | 38.5 | 3.0 | Outra versão do teste |
| BrowseComp | 91.9 | 79.9 | Busca e pesquisa |
| AutomationBench public v1.0.6 | 51.8 | 15.8 | 600 tarefas públicas |
| Vision2Web | 78.6 | Não informado | Imagem para web |
Fonte oficial, consultada em 3 de novembro de 2026. Salvo indicação contrária: thinking ativado, temperatura 1 e top-p 0,95. Terminal v2.1 usou Claude Code v2.1.280, sequência máxima de 512K e média de três execuções. BrowseComp usou harness próprio, duas ferramentas e até 1.024 rodadas; Vision2Web usou outra versão do Claude Code e 256K. Os resultados dos rivais misturam fontes externas e medições da fornecedora. Não compare v2.1 com v4.0 nem infira custo ou sucesso real.
Três usos para experimentar
Código em várias etapas
A melhora de terminal justifica testar uma tarefa pequena com testes.
Pesquisa em fontes públicas
BrowseComp indica interesse em pesquisa pública, sem garantir uso em sites autenticados.
Entrada visual
A entrada visual permite experimentar uma página a partir de captura, mas renderização, acessibilidade e código precisam de verificação. O guia de automação descreve o fluxo, não a qualidade do modelo.
Três limites
O cliente muda o resultado
O cliente afeta ferramentas e loops: limite chamadas e revise arquivos, conforme estas práticas do Tabbit.
Pesos pendentes
Os pesos de 2.5 ainda eram anunciados para breve.
Preço e dados
A página oficial de preços mostrava em 3 de novembro ¥2/¥0,04/¥8 por milhão de tokens de entrada sem cache, em cache e saída, em promoção temporária. Confirme retenção e residência de dados; API, assinatura e Tabbit são distintos. Veja também os preços do DeepSeek V4 Flash.
Um teste prático no Tabbit
Abra um artigo público, peça cinco afirmações com fontes e confira cada uma. Registre modelo, data, prompt, resposta e correções; revise as condições antes de usar documentos privados. O seletor varia por conta. O guia do DeepSeek Harness explica o papel do cliente; compare o DeepSeek V4.1 Flash com as mesmas tarefas. Para guardar ensaios, veja pesquisa com vários modelos.
 Tabbit Browser
Baixar o navegador não executa o modelo; confira antes o seletor e as condições da conta.
Recomendação por tarefa
| Tarefa | Decisão | Motivo |
|---|---|---|
| Código público com testes | Testar em branch descartável | Revisar lógica e alterações. |
| Protótipo visual | Testar com uma captura | Verificar renderização e acessibilidade. |
| Dados sensíveis | Aguardar termos verificados | A política depende do provedor. |
| Hospedagem local obrigatória | Aguardar pesos e licença | Os links ainda estavam pendentes. |
| Agente autônomo em produção | Não presumir que está pronto | Duas conversas não provam confiabilidade prolongada. |
Execute a mesma tarefa verificável no cliente e no provedor pretendidos; registre versão, ajustes, tentativas, custo e correções. Um resultado não é uma taxa de confiabilidade.

Perguntas frequentes
Vale a pena testar o LongCat 2.5?
Sim, em tarefas controladas de código ou trabalho visual. Duas tarefas pequenas não demonstram confiabilidade em agentes longos, e uma resposta explicou incorretamente dois resultados do código original.
Qual é a diferença para o 2.5 Preview?
A LongCat apresentou o 2.5 em 1º de novembro de 2026, após uma versão Preview. Relatos sobre o Preview não são testes diretos da versão de novembro.
Os pesos estão disponíveis?
Em 3 de novembro, os links oficiais do GitHub e Hugging Face ainda informavam lançamento em breve. Confira os arquivos e a licença antes de planejar hospedagem própria.
Ele é bom para programar?
A fornecedora informa 88,4 no Terminal Bench v2.1 com Claude Code, média de três execuções. Valide o resultado com testes e revisão no seu ambiente.
Posso usá-lo no Tabbit?
Uma conta de teste do Tabbit Browser Dev oferecia LongCat-2.5 em 3 de novembro de 2026. Disponibilidade e condições podem variar conforme a conta e a edição.
Quanto custa?
A página oficial mostrava uma promoção por milhão de tokens: ¥2 de entrada sem cache, ¥0,04 em cache e ¥8 de saída. Os preços podem mudar e a cobrança da API é separada das condições do Tabbit.