
LongCat 2.5 mérite un essai contrôlé pour le code et les tâches visuelles, sans justifier encore un agent de production autonome. Dans deux tâches Tabbit, il a correctement calculé un tableau et proposé une correction utile, mais expliqué à tort deux résultats du code initial.
L’évaluation officielle annonce 88,4 sur Terminal Bench v2.1 contre 70,8 pour 2.0. Ces résultats dépendent du protocole du fournisseur et ne sont pas une probabilité de réussite sur votre projet.
À retenir
Le fournisseur décrit 1,6 billion de paramètres au total et environ 48 milliards actifs par token.
Les scores dépendent du banc de test et ne sont pas une reproduction indépendante.
Les retours Preview mêlent appréciations et boucles d’outils ; ils ne prouvent pas le comportement de la nouvelle version.
Les poids étaient encore annoncés comme prochains le 3 novembre.
Vérifiez disponibilité, confidentialité et tarif avant de donner accès à des fichiers ou outils.
LongCat 2.5 en bref
| Aspect | Constat au 3 novembre | Ce que cela ne prouve pas |
|---|---|---|
| Modèle | 1,6T au total, environ 48B actifs par token | Latence ou coût réel |
| Agents | Progression face à 2.0 dans le tableau officiel | Réussite en production |
| Vision | Entrée visuelle convertie en tokens | Fidélité de toute page générée |
| Poids | GitHub et Hugging Face : bientôt | Date ou licence |
| Tabbit | Deux tâches de chat sur un compte de test | Quota des autres comptes |
Voir la présentation de LongCat 2.0 et le guide du navigateur agentique pour distinguer modèle et client.
Deux essais Tabbit avant les classements
Le 3 novembre, nous avons choisi LongCat-2.5 dans Tabbit Browser Dev, en mode chat, sans outil d’écriture. Critères définis avant essai ; une exécution par tâche dans la même conversation. Instantané du modèle, fournisseur, réglage de raisonnement, tokens et coût inconnus. Aucun taux de réussite ni disponibilité générale ne peut en être déduit.
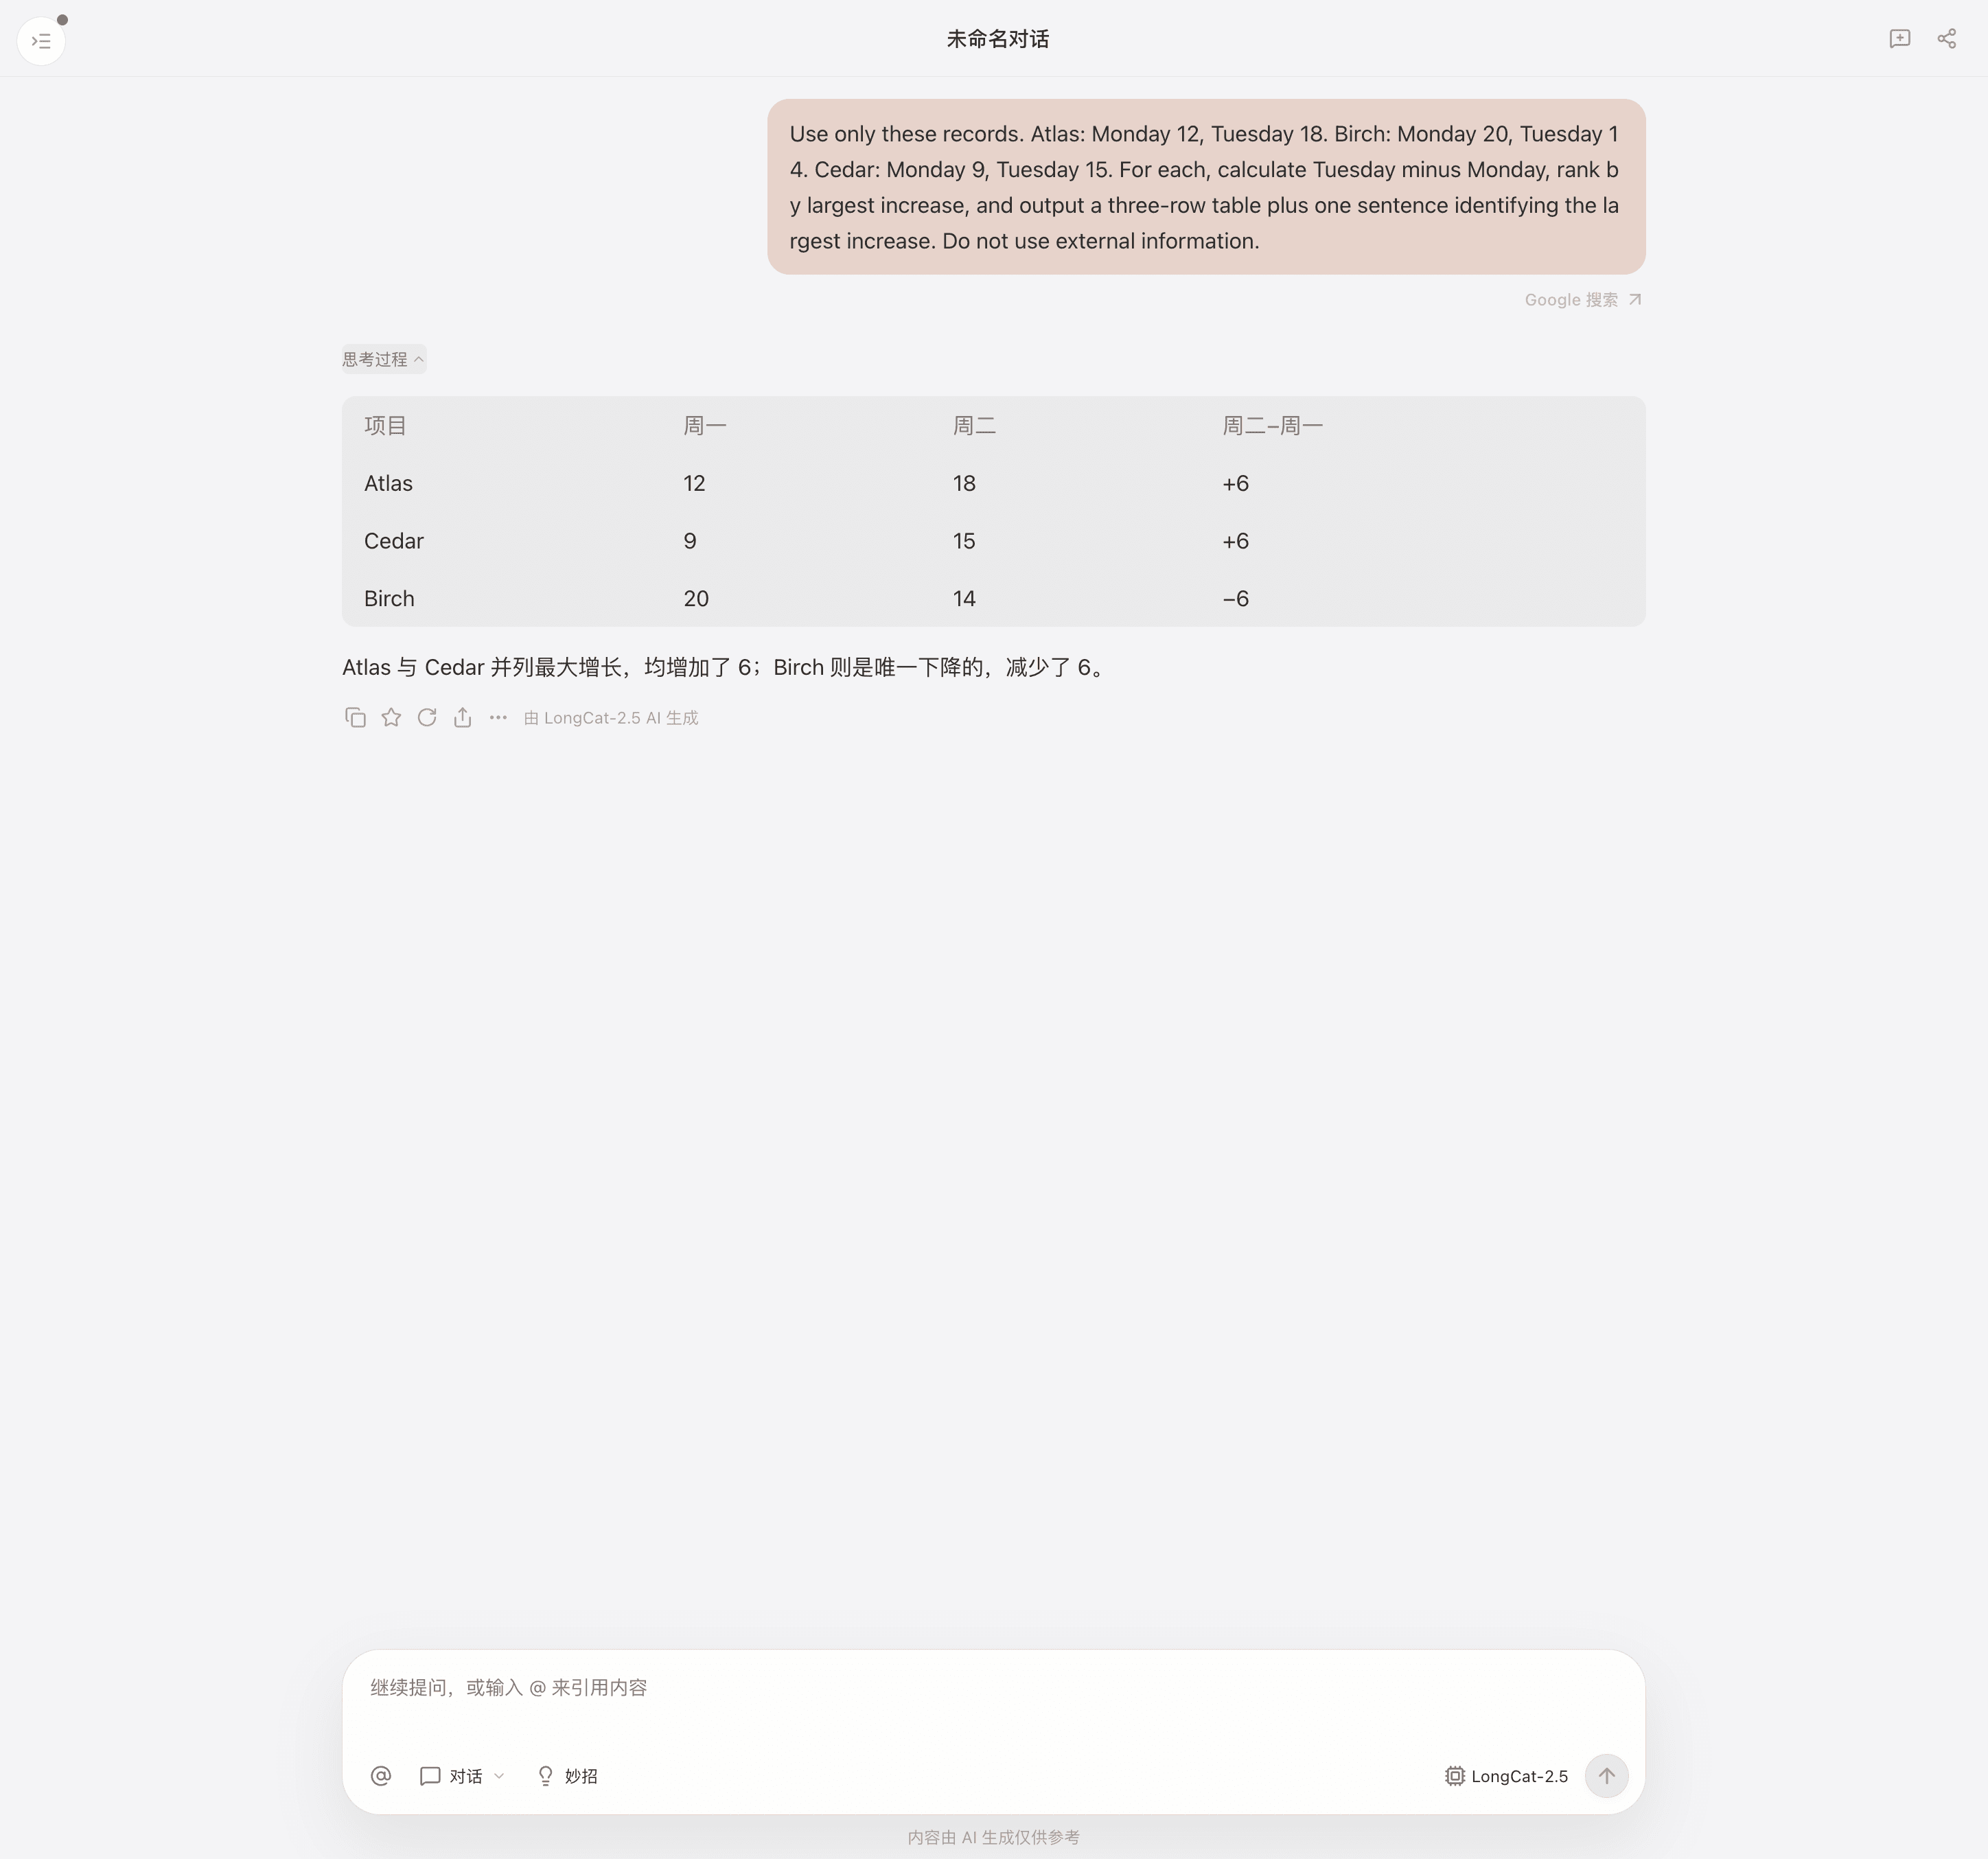
Sur trois séries de nombres fictifs, il a calculé +6, +6 et −6 et identifié l’égalité. La réponse était en chinois dans un environnement chinois ; la demande anglaise ne précisait pas la langue de sortie.
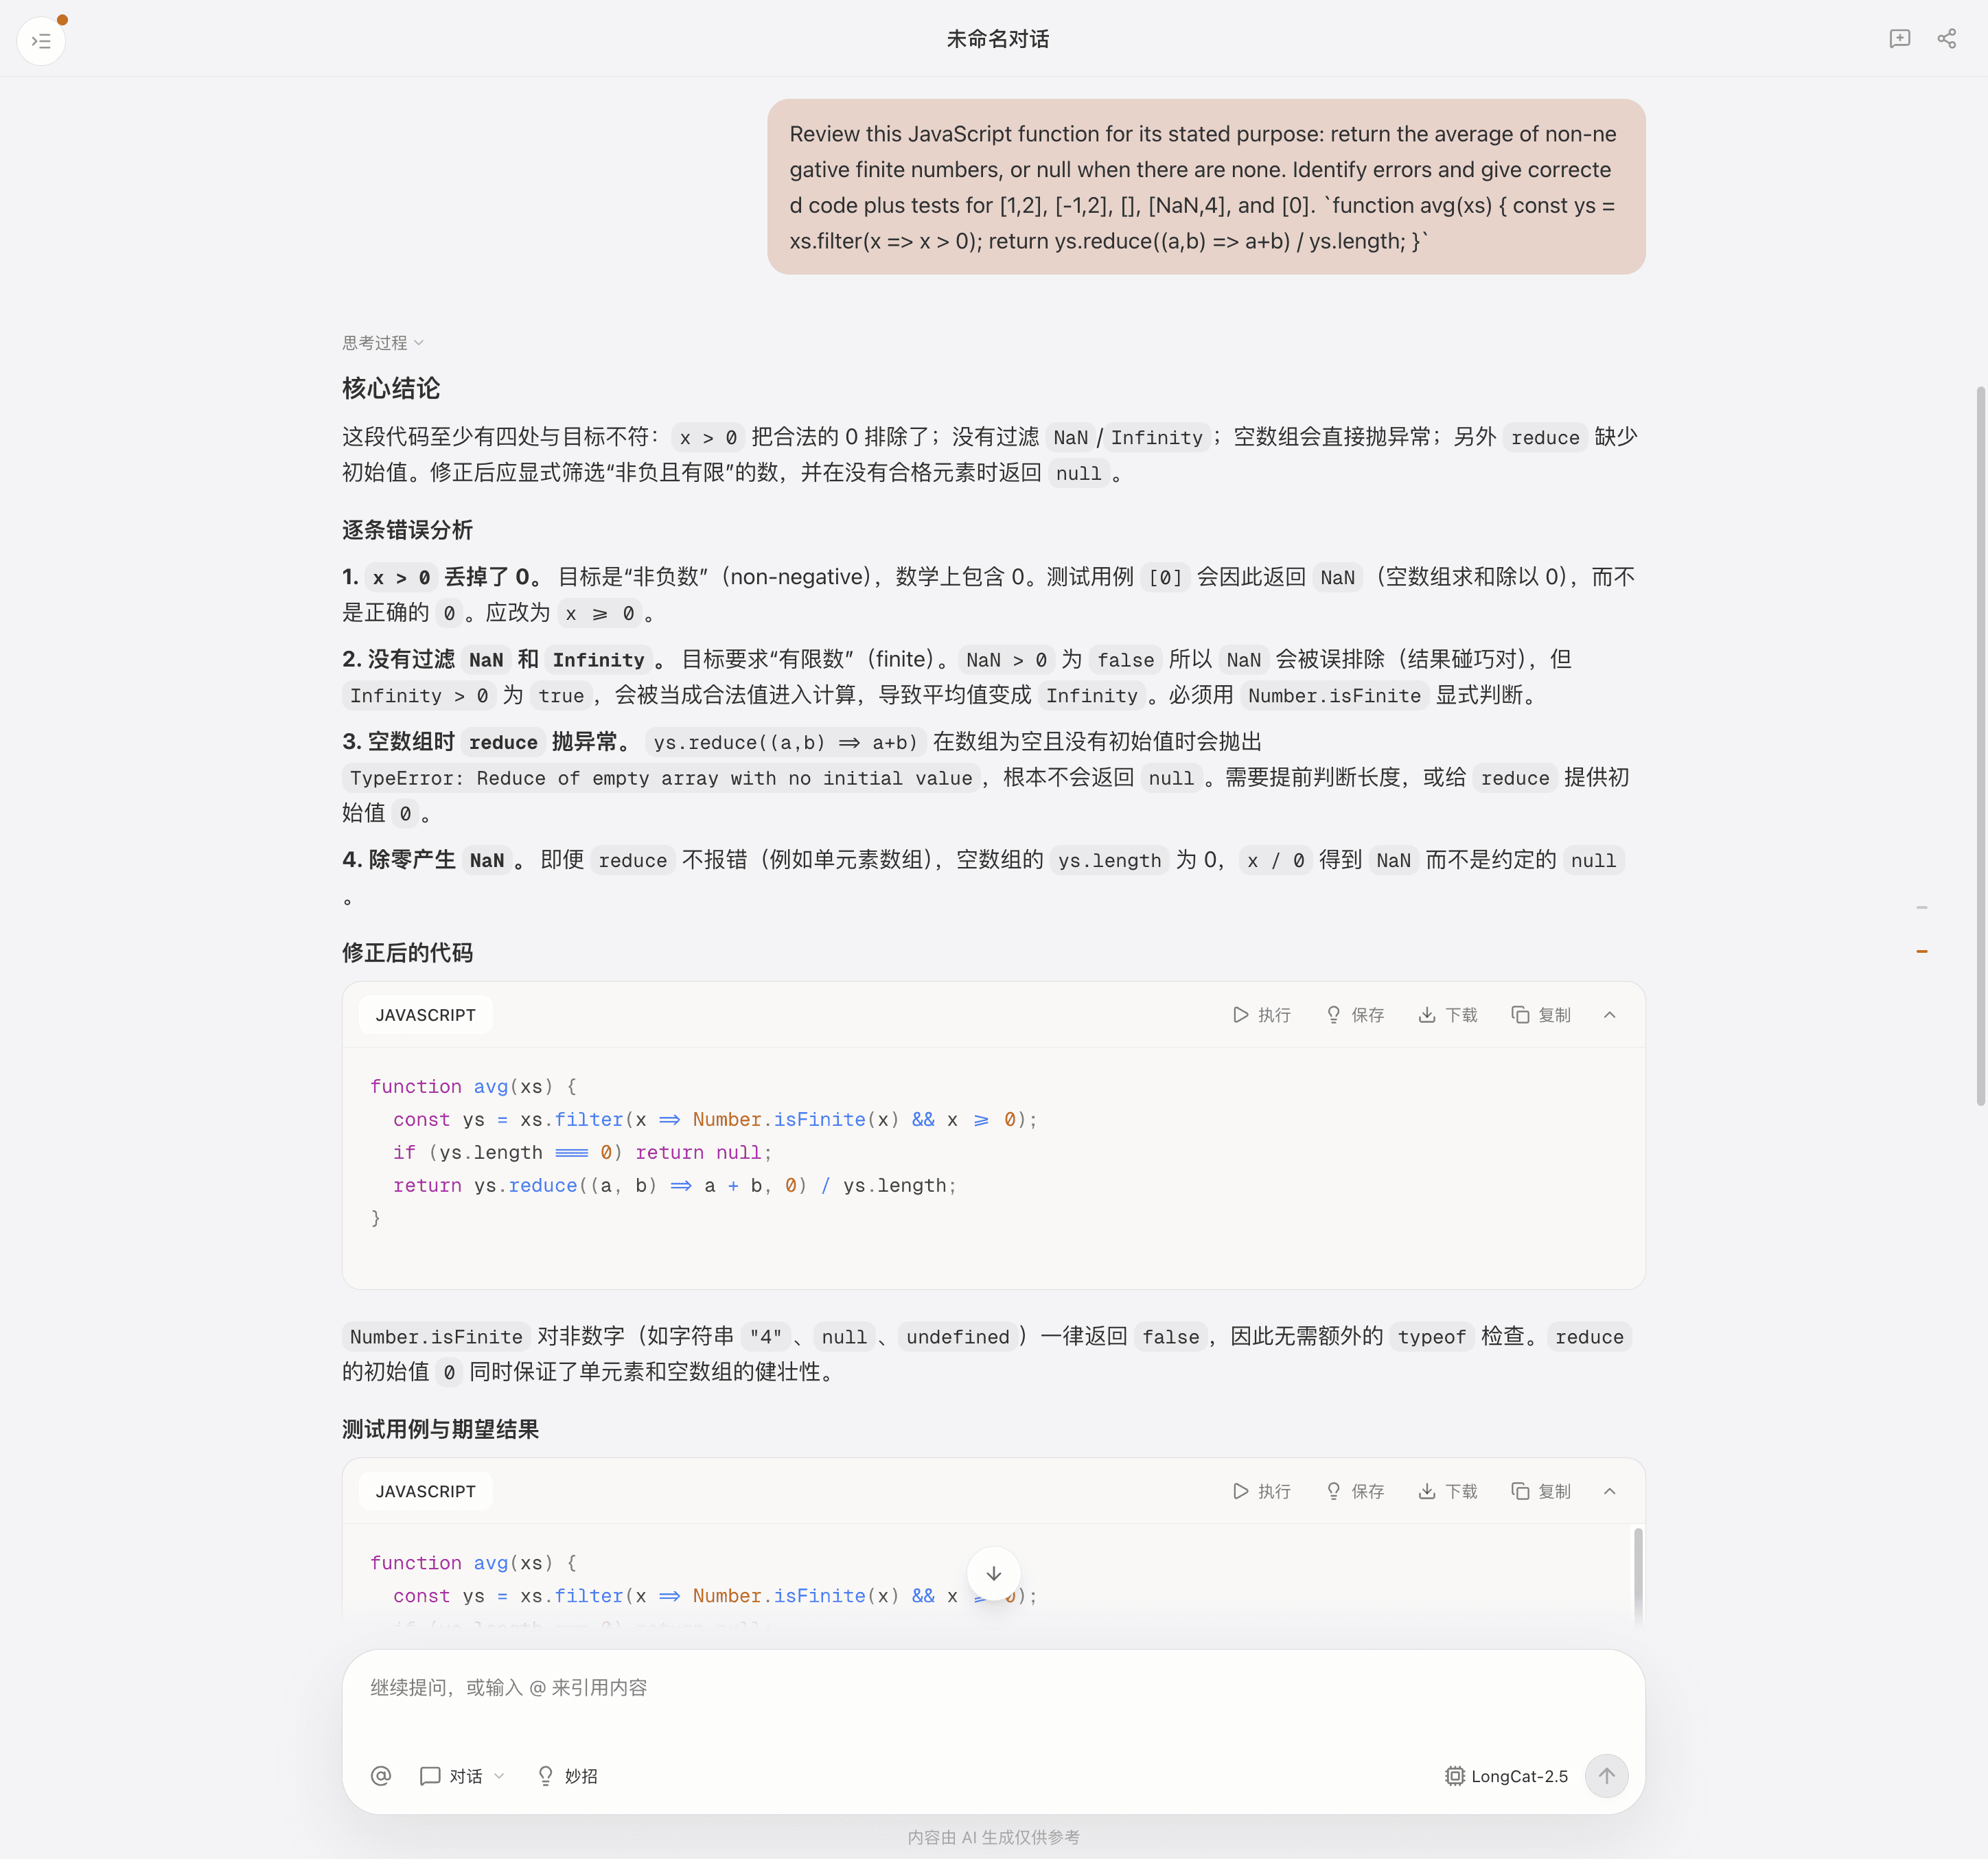
Pour une fonction JavaScript, la correction filtrait les nombres finis non négatifs et renvoyait null si la liste était vide. Son exécution locale a donné les cinq résultats attendus. Mais l’explication du code initial était fausse deux fois : [NaN, 4] renvoie 4, pas NaN ; [0] déclenche TypeError, pas NaN. Le modèle a proposé des tests sans montrer leur exécution. Nous n’avons pas testé la modification autonome d’un dépôt.
Retours : distinguer Preview et version de novembre
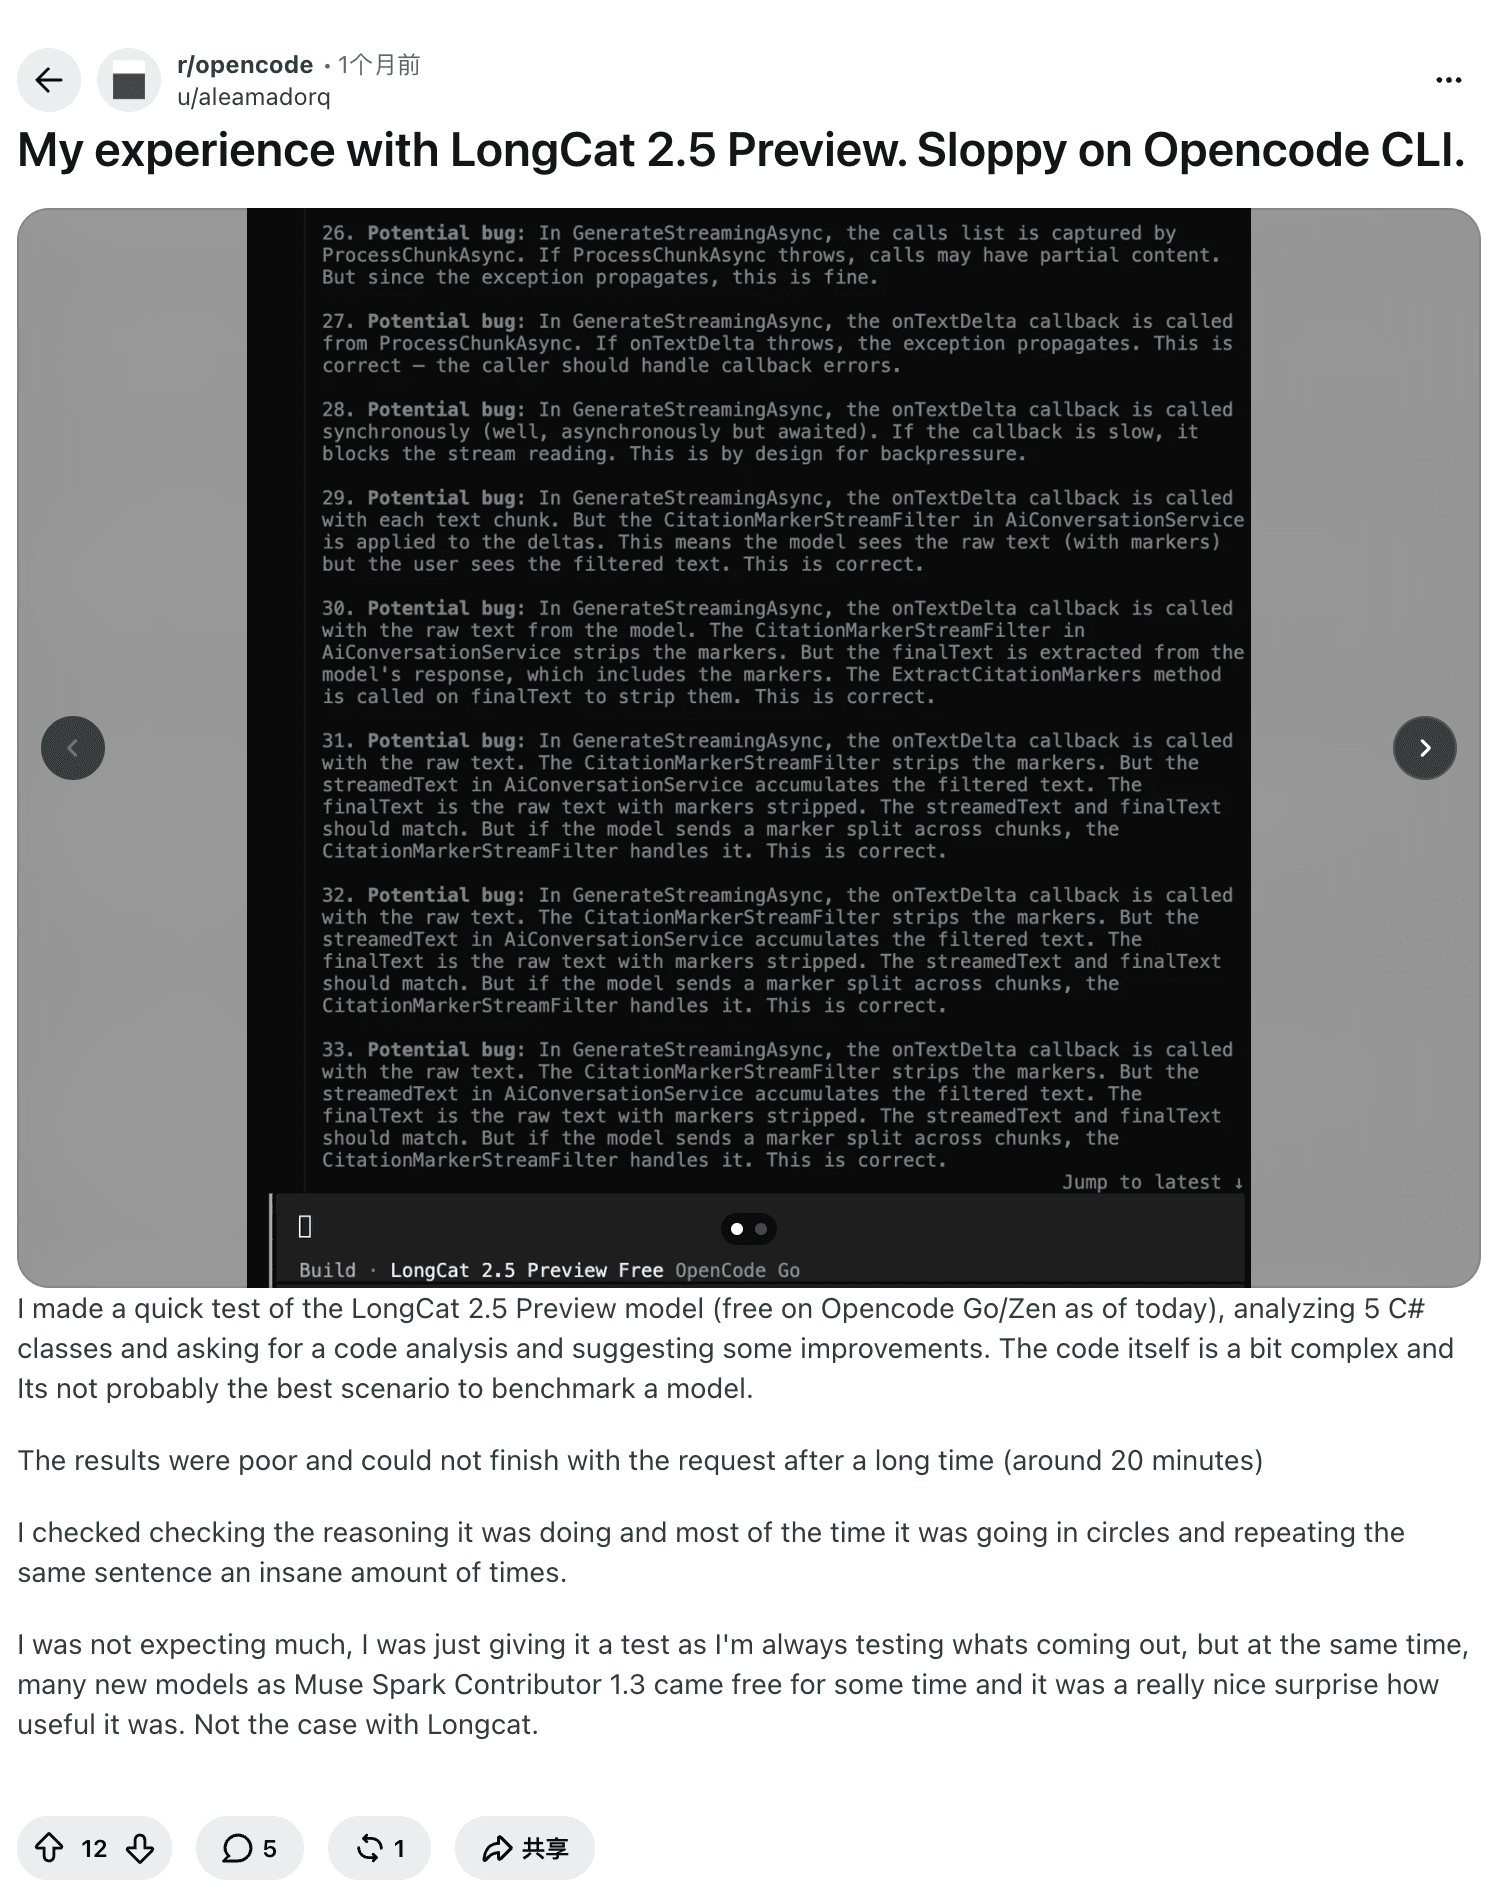
Un utilisateur Reddit indique que Preview a tourné en boucle sur cinq classes C# dans OpenCode sans finir en vingt minutes ; entrée et configuration complètes manquent. Un autre essai Preview rapporte 48,7 % pass@1 et 64,0 % pass@3 sur 89 tâches, trois fois chacune, avec une panne persistante sur une tâche. Les conditions diffèrent de celles de la version ultérieure : comparaison directe impossible.
Un témoignage sur DEV préfère la gestion du contexte et des outils de Preview sur plusieurs projets, sans publier les prompts complets ni de journaux contrôlés.
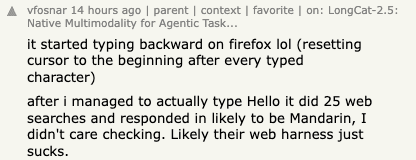
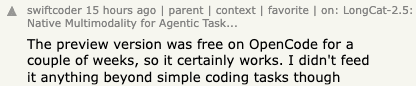
Sur Hacker News, InsideOutSanta apprécie une image de pélican à vélo sans détailler tout le protocole. vfosnar rapporte une saisie défectueuse sous Firefox et des recherches répétées, qu’il attribue prudemment au client. swiftcoder décrit une utilisation simple de Preview en code, sans détails. Ce sont des expériences individuelles.
L’évaluation TOKRACE présente 15 tâches créatives avec la version de novembre dans Claude Code : une étagère respecte les dimensions ; un réducteur utilise 140 mètres au lieu de 140 millimètres et ne livre pas la vidéo demandée ; un graphique invente année, unités et source. Ces résultats tiers dépendent de leur configuration.
Benchmarks officiels et conditions
| Test officiel | 2.5 | 2.0 | Tâche |
|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | Agent de terminal |
| Terminal Bench v4.0 | 38.5 | 3.0 | Autre version du test |
| BrowseComp | 91.9 | 79.9 | Recherche et navigation |
| AutomationBench public v1.0.6 | 51.8 | 15.8 | 600 tâches publiques |
| Vision2Web | 78.6 | Non publié | Image vers web |
Source officielle, consultée le 3 novembre 2026. Sauf indication contraire : thinking actif, température 1 et top-p 0,95. Terminal v2.1 utilise Claude Code v2.1.280, 512K de séquence maximale et la moyenne de trois essais. BrowseComp utilise un harness interne, deux outils et 1 024 tours au maximum ; Vision2Web emploie une autre version de Claude Code et 256K. Les scores concurrents mêlent sources externes et mesures du fournisseur. Ne comparez pas v2.1 à v4.0 et n’en déduisez ni coût ni réussite réelle.
Trois usages à essayer
Code en plusieurs étapes
Le progrès annoncé sur terminal justifie un essai borné avec tests.
Recherche sur des sources publiques
BrowseComp donne une piste pour la recherche publique, sans garantir le comportement sur un site connecté.
Entrée visuelle
L’entrée visuelle permet d’essayer une page depuis une capture, mais le rendu, l’accessibilité et le code doivent être vérifiés. Le guide d’automatisation décrit le flux, pas la qualité du modèle.
Trois limites
Le client change le résultat
Le client influe sur les outils et les boucles : limitez les appels et relisez les fichiers, selon ces bonnes pratiques Tabbit.
Poids en attente
Les poids 2.5 restaient annoncés comme prochains.
Prix et données
La page tarifaire officielle indiquait le 3 novembre ¥2/¥0,04/¥8 par million de tokens pour l’entrée sans cache, en cache et la sortie, en promotion temporaire. Vérifiez conservation et résidence des données ; API, abonnement et Tabbit sont distincts. Voir aussi les prix de DeepSeek V4 Flash.
Un essai pratique dans Tabbit
Ouvrez un article public, demandez cinq affirmations avec leurs sources et vérifiez-les. Notez modèle, date, prompt, réponse et corrections ; attendez les conditions applicables avant les documents privés. Le sélecteur dépend du compte. Le guide DeepSeek Harness explique le rôle du client ; comparez DeepSeek V4.1 Flash avec les mêmes tâches. Pour conserver les essais : recherche multimodèle.
 Tabbit Browser
Le téléchargement ne lance pas le modèle ; vérifiez le sélecteur et les conditions du compte.
Verdict selon la tâche
| Tâche | Choix | Raison |
|---|---|---|
| Code public avec tests | Essayer sur une branche jetable | Relire logique et modifications. |
| Prototype visuel | Essayer avec une capture | Vérifier rendu et accessibilité. |
| Données sensibles | Attendre les conditions vérifiées | La politique dépend du fournisseur. |
| Déploiement local obligatoire | Attendre poids et licence | Les liens étaient encore en attente. |
| Agent autonome en production | Ne pas supposer qu’il est prêt | Deux chats ne prouvent pas la fiabilité longue. |
Exécutez la même tâche vérifiable dans le client et chez le fournisseur prévus ; consignez version, réglages, reprises, coût et corrections. Un résultat n’est pas un taux de fiabilité.

Questions fréquentes
LongCat 2.5 vaut-il un essai ?
Oui, pour un essai contrôlé de code ou de travail visuel. Deux petites tâches ne prouvent pas la fiabilité d’un agent long et une réponse expliquait mal deux résultats du code initial.
Quelle différence avec 2.5 Preview ?
LongCat a présenté la version 2.5 le 1er novembre 2026 après une version Preview. Les retours sur Preview ne constituent pas des tests directs de la version de novembre.
Les poids sont-ils disponibles ?
Le 3 novembre, les liens officiels GitHub et Hugging Face annonçaient encore une sortie prochaine. Vérifiez les fichiers et leur licence avant un déploiement local.
Est-il adapté au code ?
Le fournisseur annonce 88,4 sur Terminal Bench v2.1 avec Claude Code, moyenne de trois exécutions. Validez avec vos tests et une revue des modifications.
Peut-on l’utiliser dans Tabbit ?
Un compte de test Tabbit Browser Dev proposait LongCat-2.5 le 3 novembre 2026. La disponibilité et les conditions peuvent varier selon le compte et l’édition.
Quel est son prix ?
La page officielle affichait une promotion par million de tokens : ¥2 en entrée sans cache, ¥0,04 en cache et ¥8 en sortie. Ces tarifs peuvent changer et sont distincts des conditions Tabbit.