
LongCat 2.5 值得在代码和视觉任务中做可控试用,但现有证据不足以证明它适合无人值守的生产任务。11 月正式版刚发布,早期 Preview 的反馈不能直接代表正式版。
官方评测中,LongCat 2.5 的 Terminal Bench v2.1 成绩为 88.4,2.0 为 70.8。这说明厂商设定的测试条件下有提升,不代表你的项目成功率。我们在 Tabbit Browser 测试版中做了两项小任务:算术表格正确,代码修复也通过指定用例,但对原代码的两处解释有误。
关键结论
官方称模型总参数 1.6 万亿,每 token 激活约 480 亿,面向长程 Agent 和视觉任务。
官方跑分取决于测试框架,不能当作独立复现或实际项目的成功率。
Preview 用户既报告过上下文处理较好,也遇到工具循环;版本和运行环境不同。
11 月 3 日官方 GitHub 与 Hugging Face 入口仍标注即将推出。
账号可用性、数据条款和费用应分开核对,私有代码与写入权限尤其如此。
一览:哪些信息能用于决策
| 项目 | 2026-11-03 核查结果 | 不能据此推断 |
|---|---|---|
| 模型 | 官方称总参数 1.6T、活跃约 48B | 你的延迟或硬件费用 |
| Agent | 官方多个代码及检索基准高于 2.0 | 独立验证的生产成功率 |
| 视觉 | 官方介绍了文本与视觉 token 联合处理 | 任意截图转网页都准确 |
| 权重 | 官方入口显示即将推出 | 具体发布时间与许可 |
| Tabbit | 测试账号选中 LongCat-2.5 并完成两次对话 | 其他账号的可用性与额度 |
上一代的部署与费用问题可参考 LongCat 2.0 总览。Agent 浏览器介绍解释了模型之外的客户端与工具层。
先看两项 Tabbit 实测
2026 年 11 月 3 日,我们在 Tabbit Browser Dev 测试账号选择 LongCat-2.5,事先写好输入和验收标准。两项任务均为同一对话中的单次文本测试,没有授予写入工具权限;模型快照、服务商路由、推理档位、token 和费用均未知。结果不能用于推算成功率、速度或其他账号的可用性。
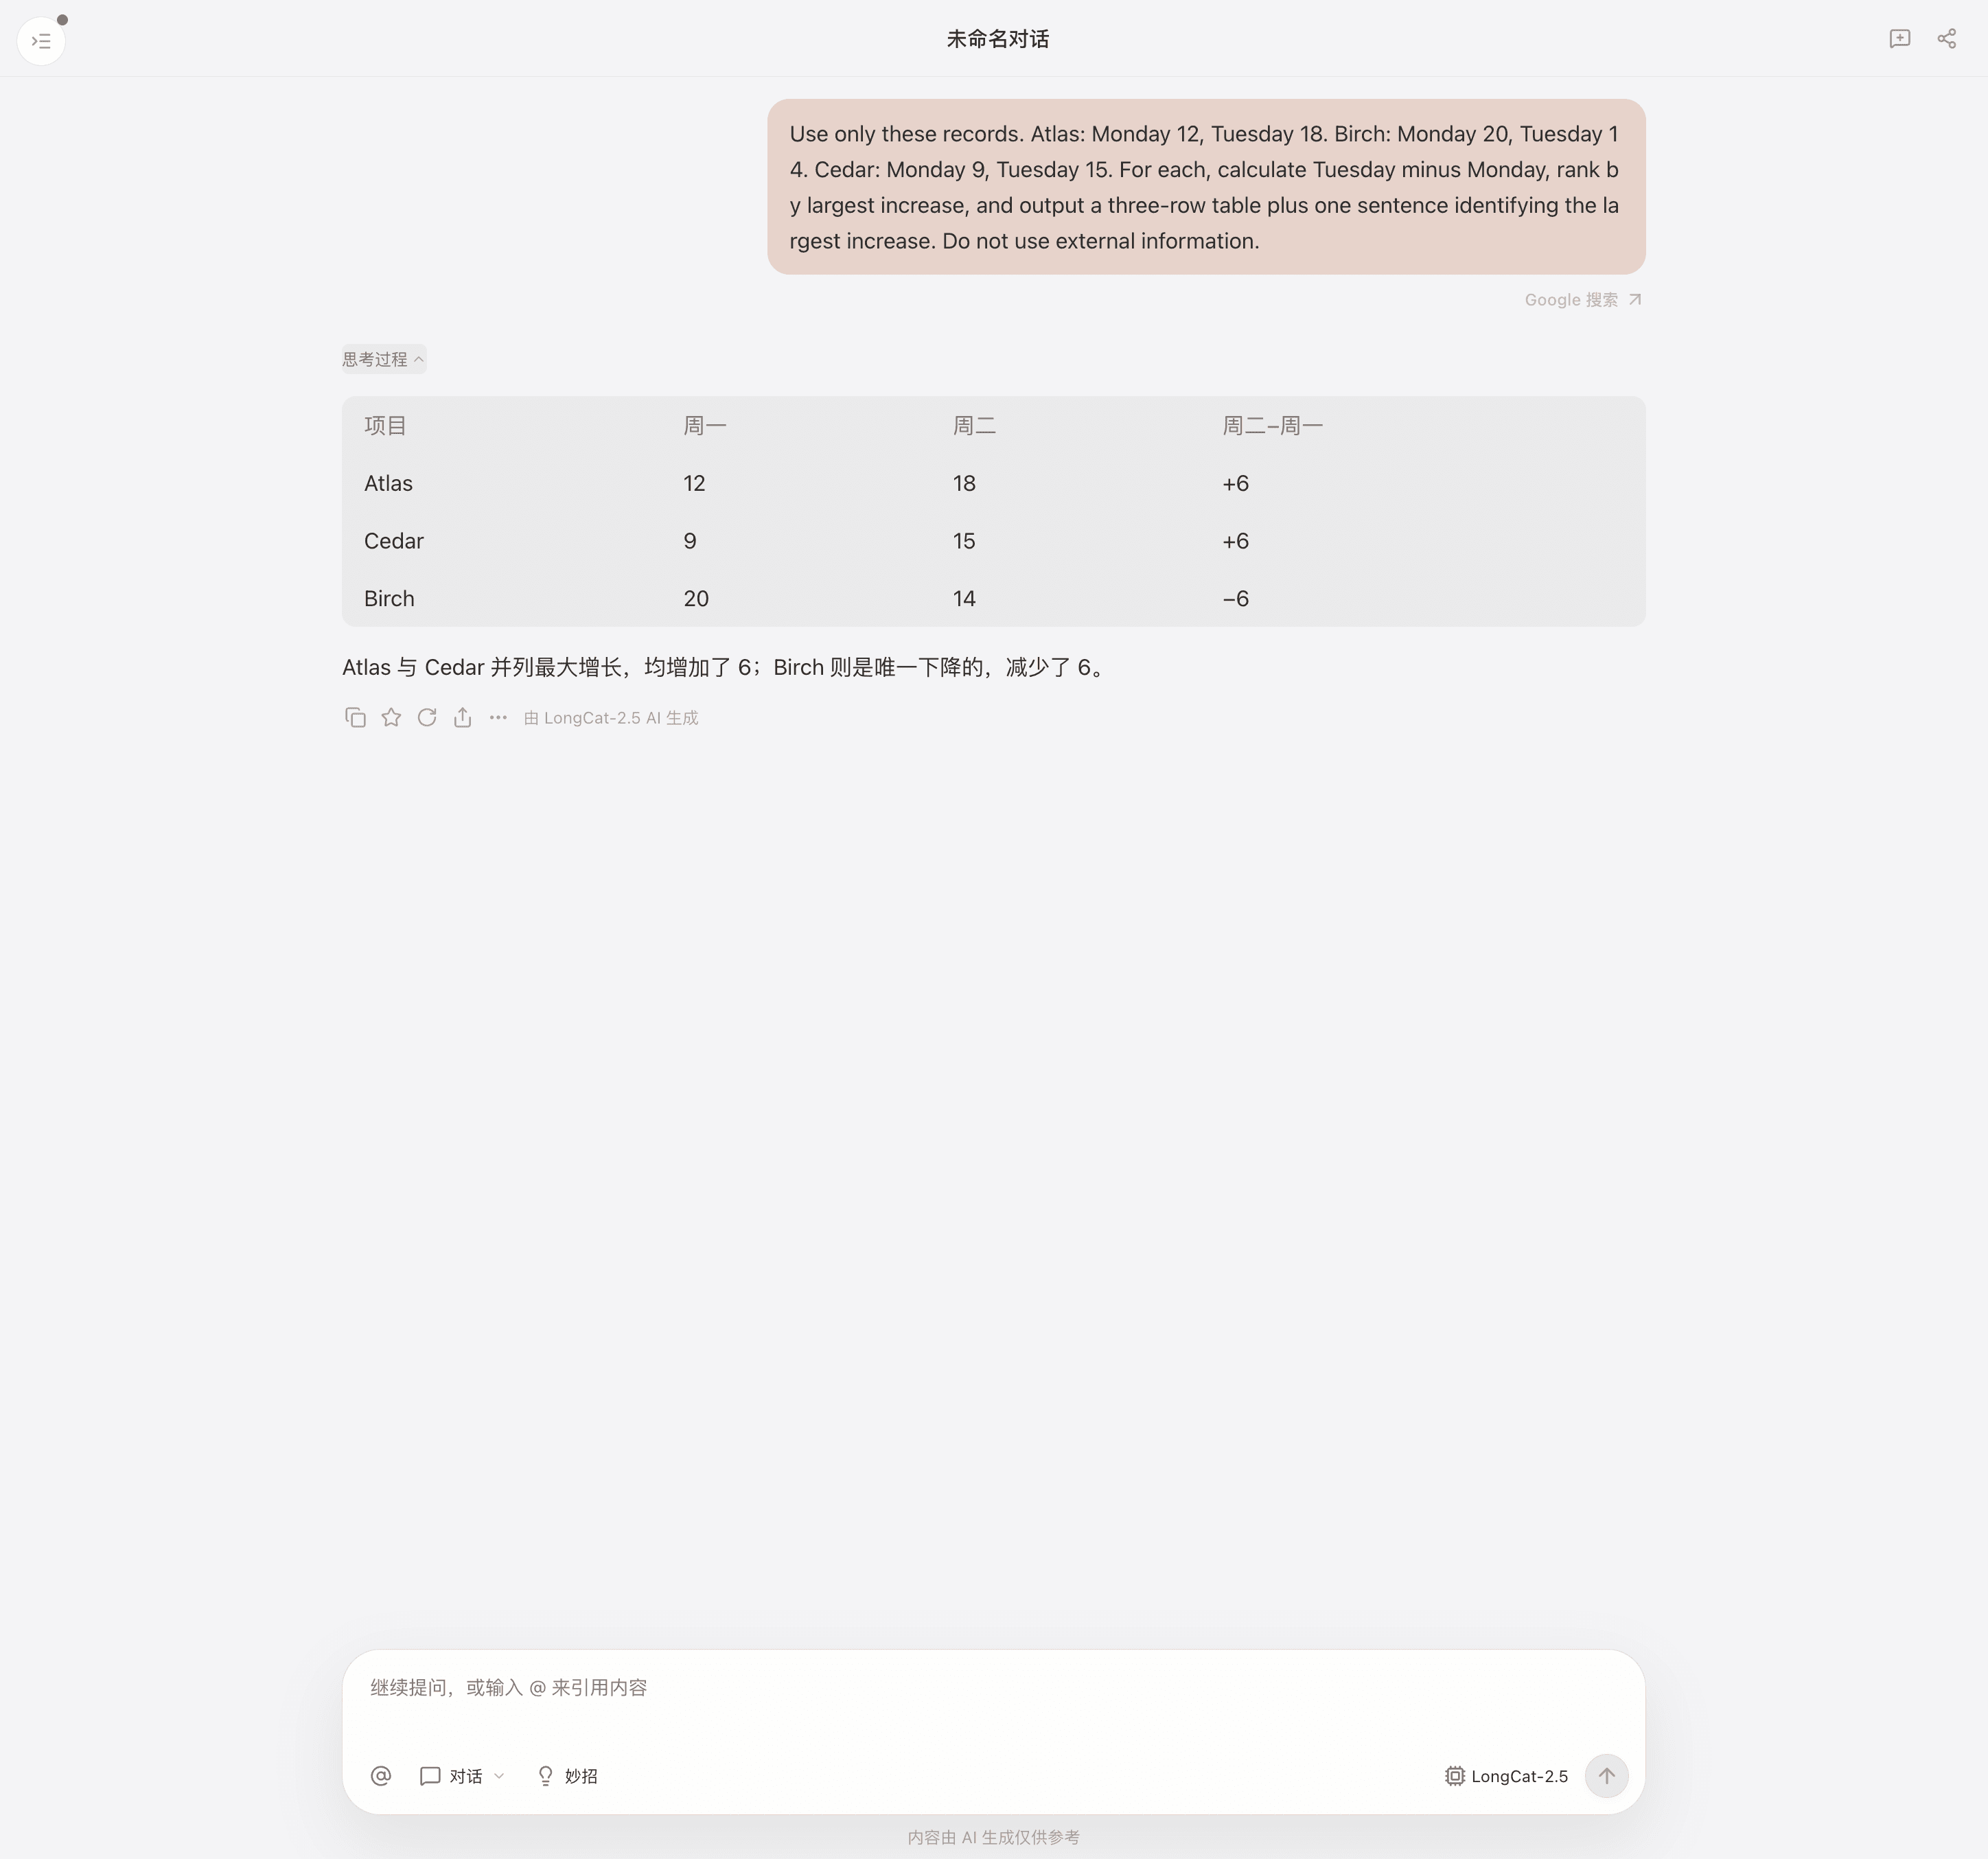
第一项使用三组合成数字。模型正确算出 +6、+6、−6,并指出前两项并列。输入是英文,输出为中文;测试环境为中文,提示词没有指定回复语言。
第二项要求检查 JavaScript 求平均函数。模型给出的修复正确筛选非负有限数、处理空数组;我们在本地执行后,五项指定用例得到预期结果。但它对原函数的两处判断错误:[NaN, 4] 实际返回 4,不是 NaN;[0] 实际抛出 TypeError,也不是 NaN。回答给出了测试代码,但没有证据表明模型自行执行了它。
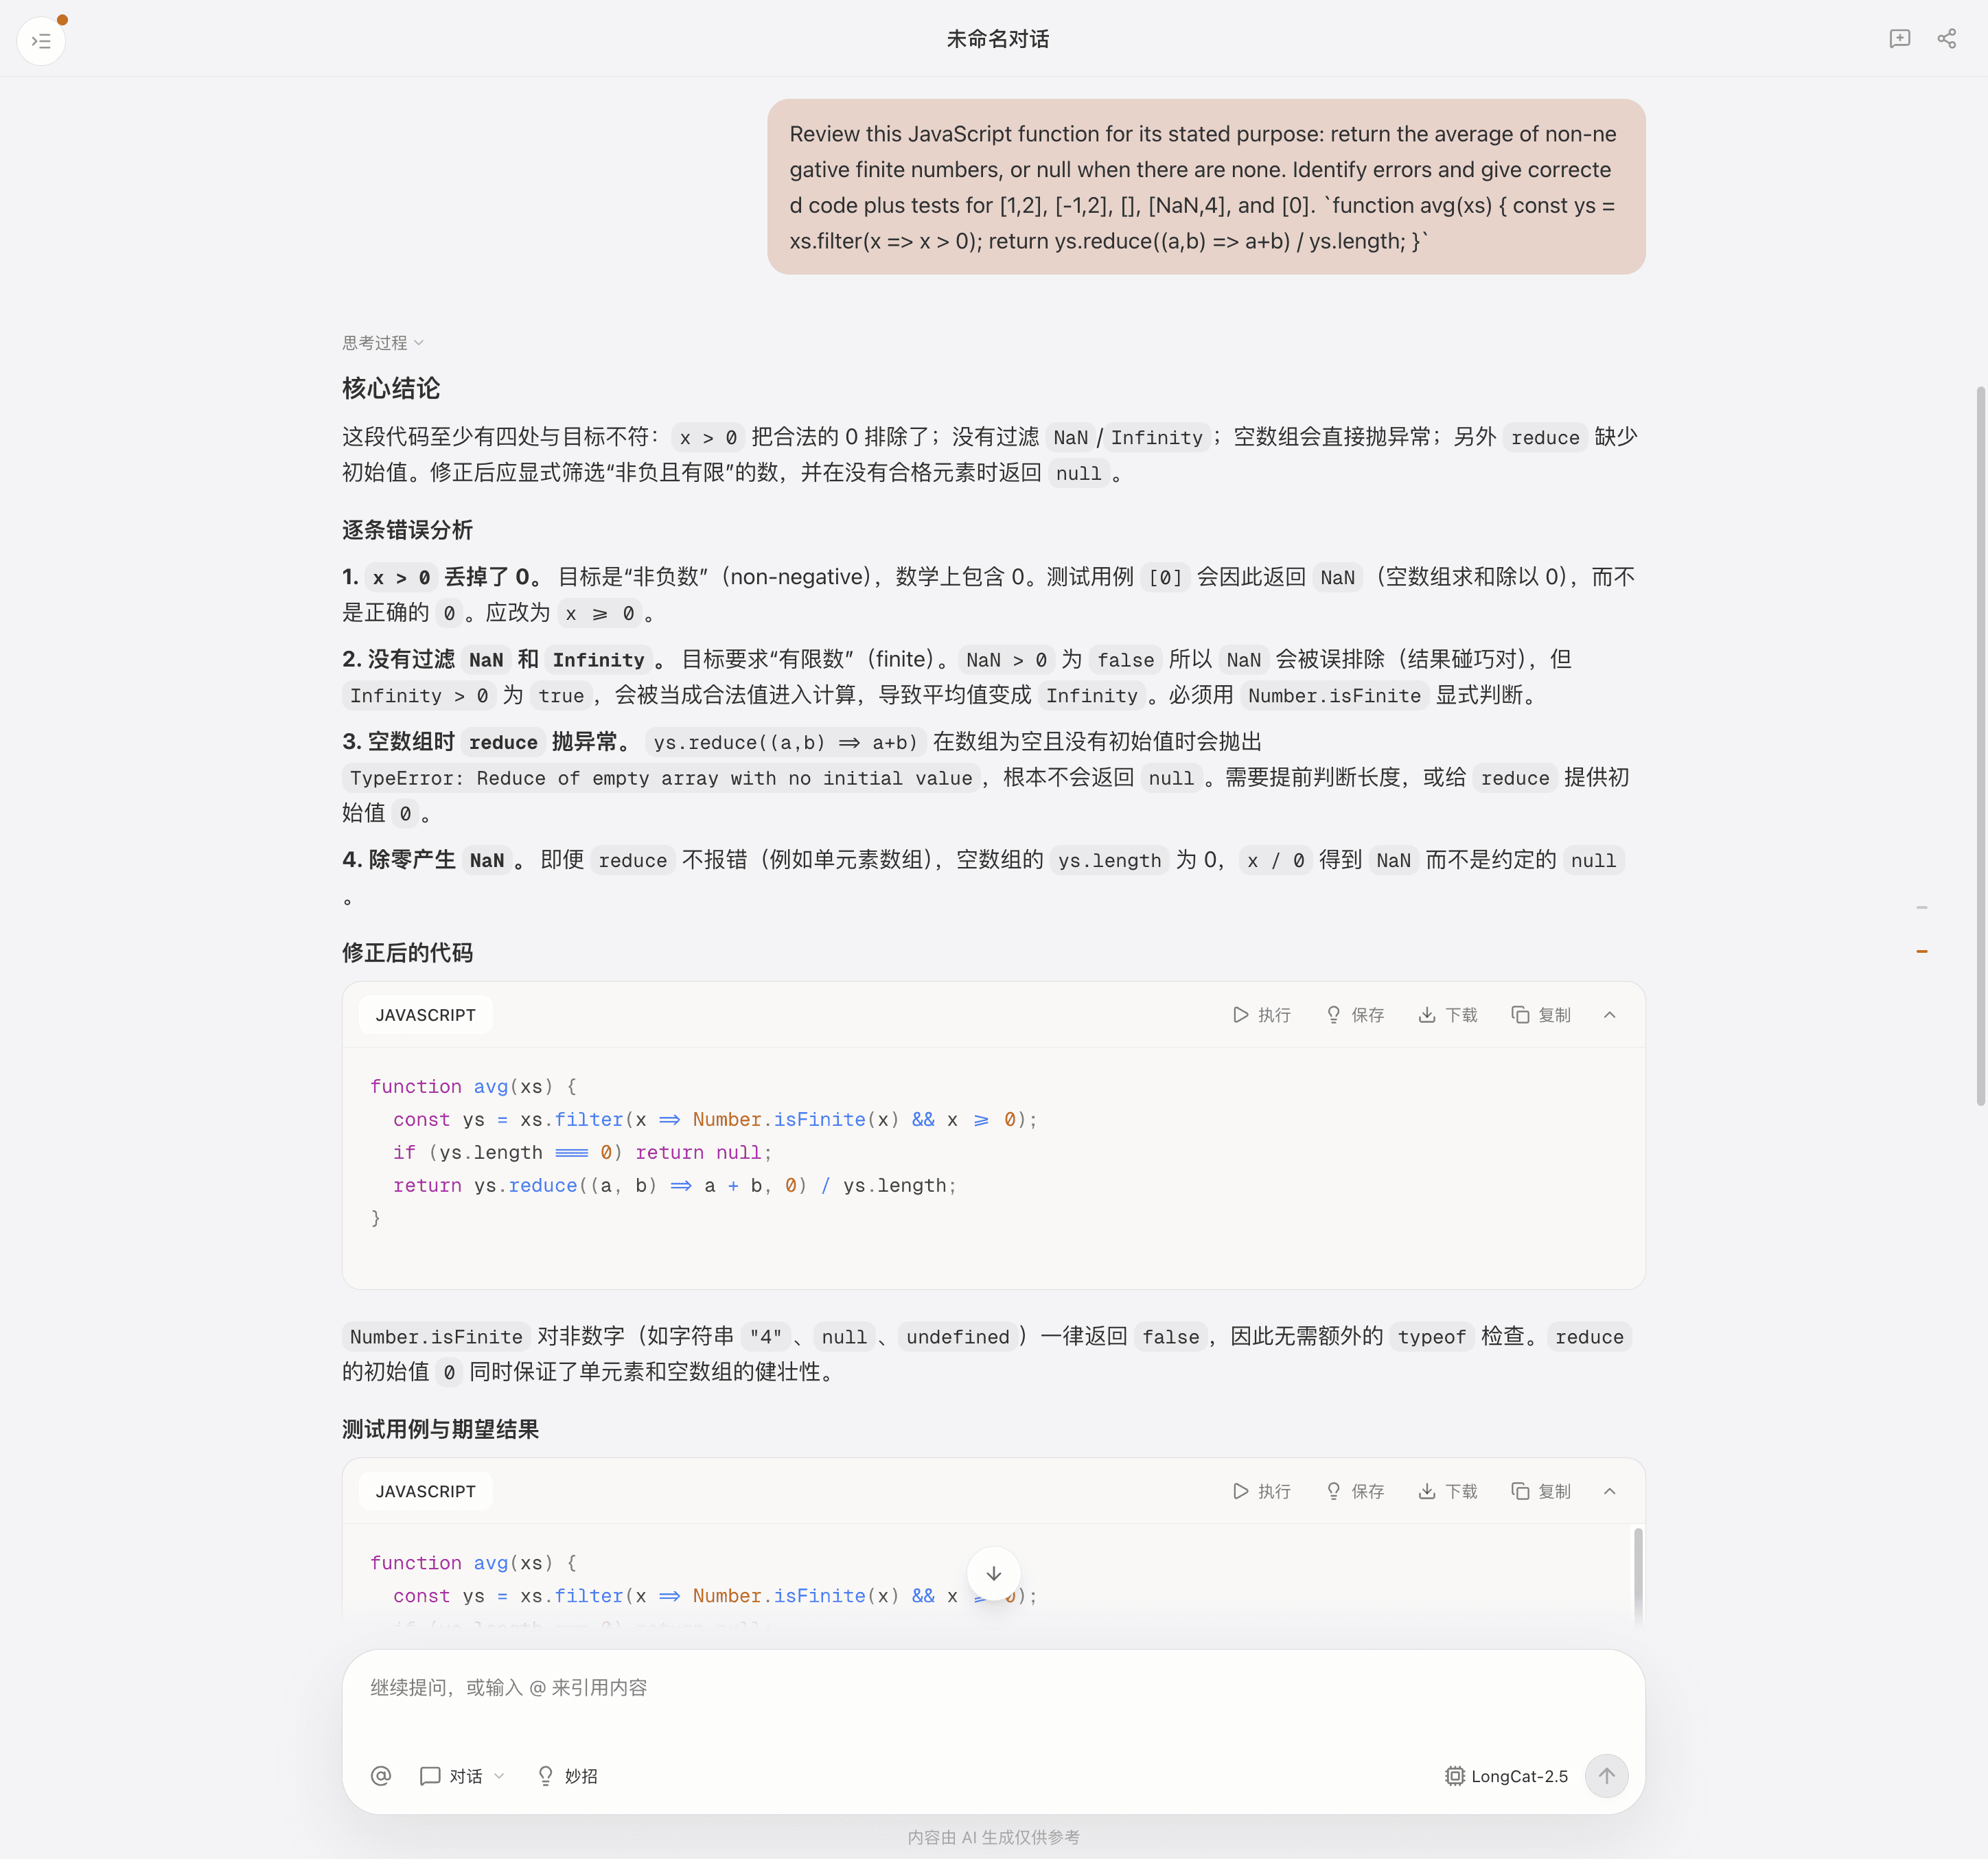
这两项测试支持的结论很窄:可以让模型起草修复,但仍要运行代码并检查解释;它们没有测试自主修改仓库或长程浏览器任务。多模型调研组织方法可用于保存相同任务的输入和输出。
社区怎么说:区分 Preview 与正式版
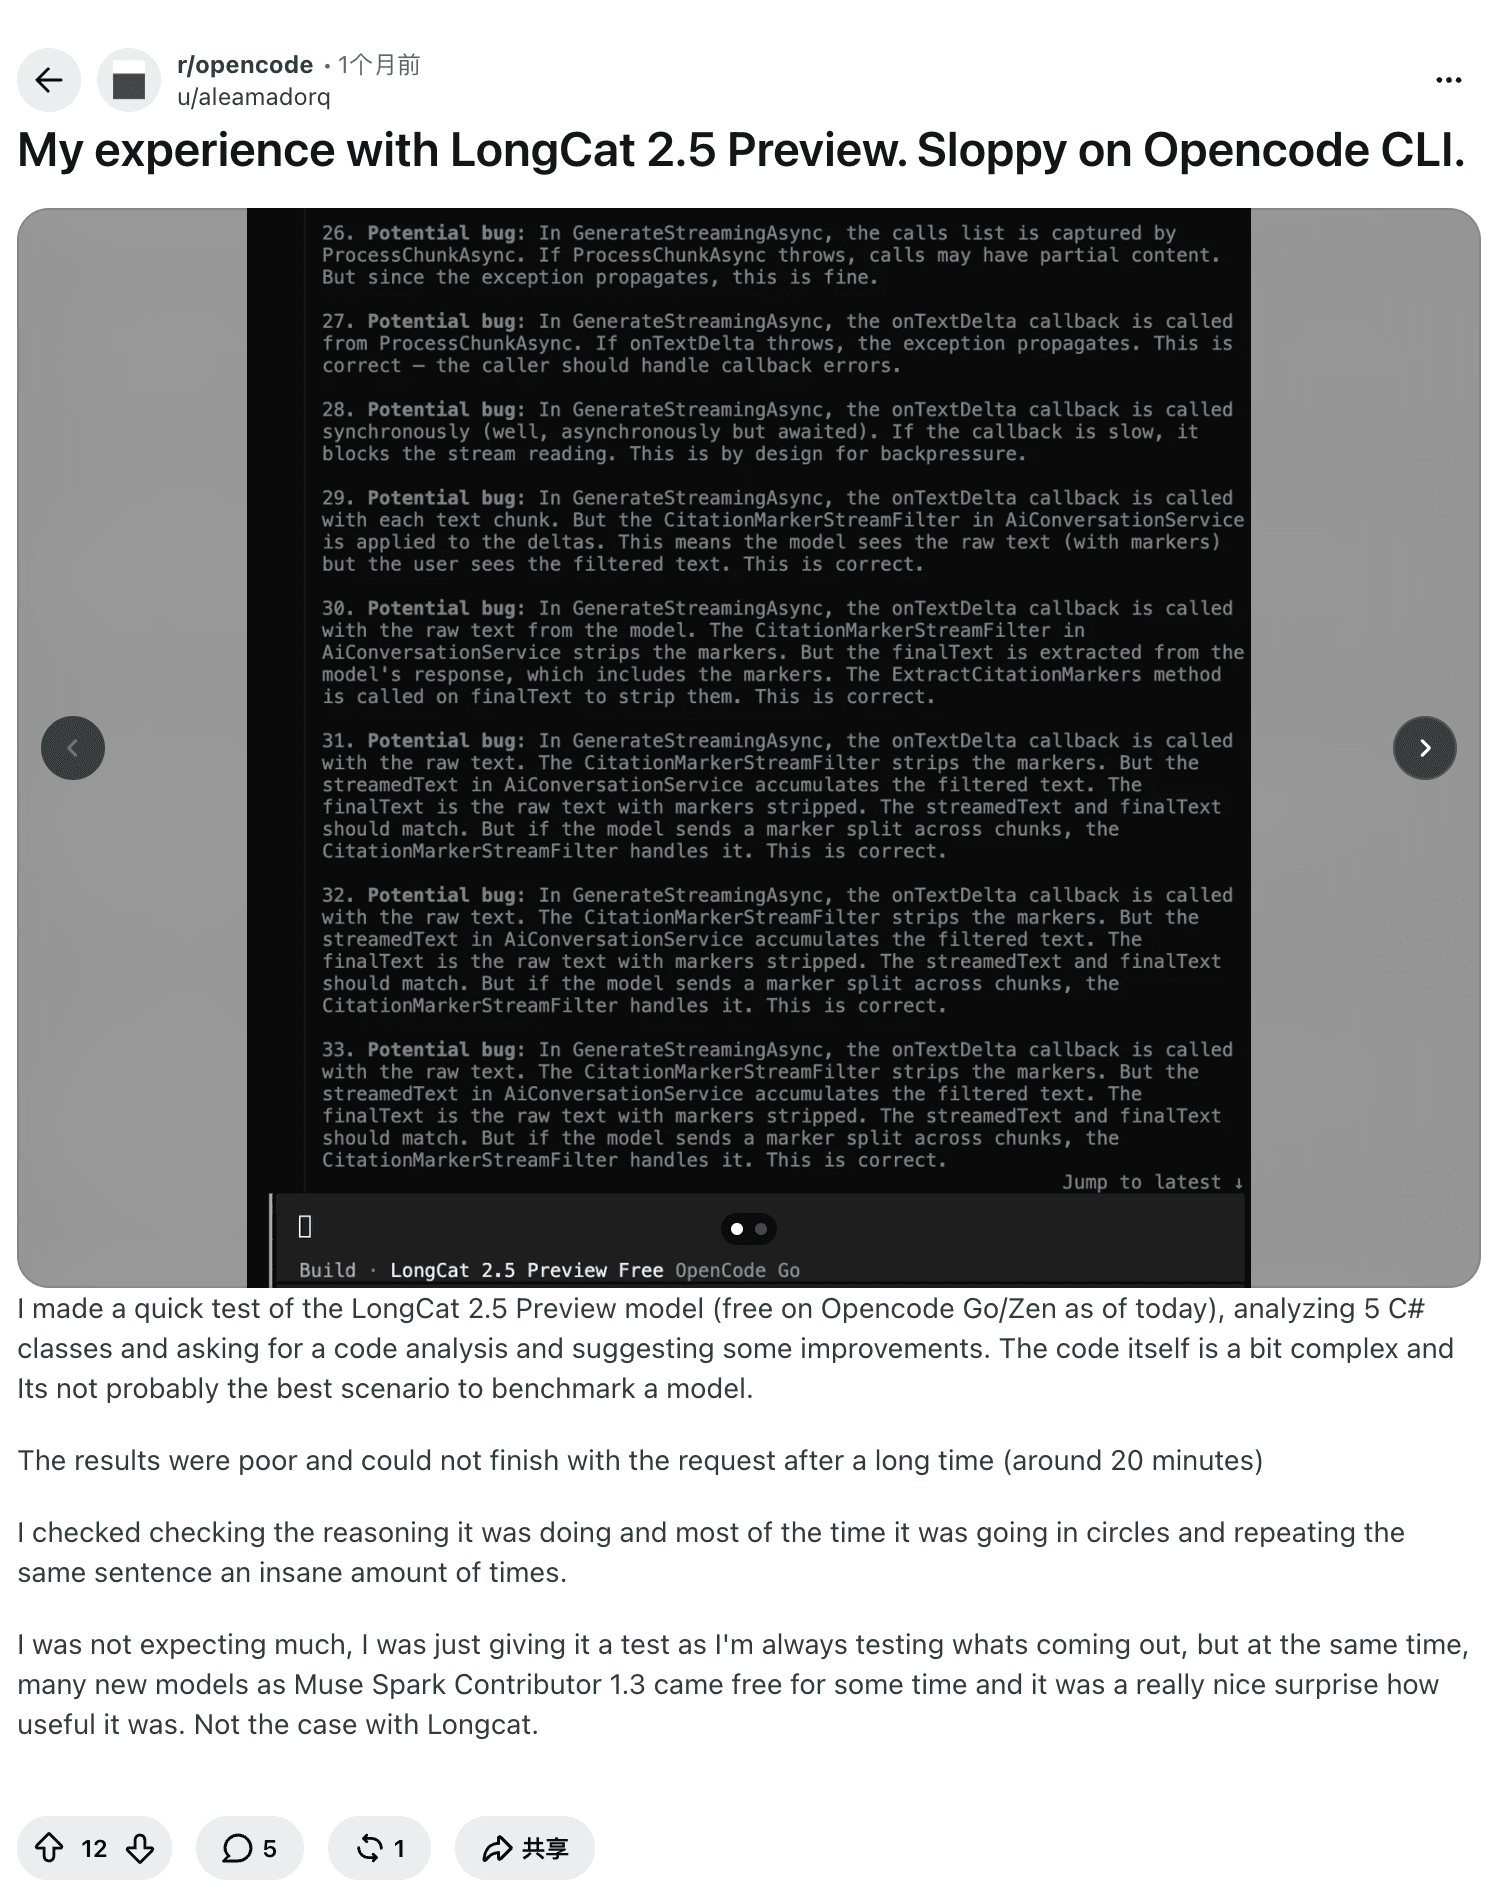
Reddit 作者用 OpenCode 的 Preview 分析五个 C# 类,称约 20 分钟仍未完成并反复循环。原帖没有完整输入、服务端配置或重复测试,不能推断正式版出现同样问题。
另一位 Reddit 用户报告对 Preview 的 Terminal Bench v2.1 测试:89 题各运行三次,pass@1 为 48.7%、pass@3 为 64.0%;其本机在一道任务上持续失败。模型版本、环境和框架不等同于官方 88.4 的测试,不能直接比较。DEV 作者则更认可 Preview 在多个项目中的上下文和工具编排,但没有完整提示词和受控日志。
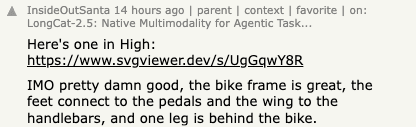
Hacker News 用户在正式版讨论中展示了一只骑车鹈鹕并给予正面评价,评论未公开完整提示词与客户端设置。另一位用户报告 Firefox 输入问题及简单问候触发多次搜索,并推测可能是网页客户端问题;无法分离模型与客户端的影响。
第三位 Hacker News 用户称 Preview 在 OpenCode 中完成了简单代码任务,未提供任务细节,也未测试后来的正式版。
TOKRACE 的 11 月 2 日测评使用 Claude Code 调用正式版,记录了 15 个创意任务:书架尺寸符合要求;行星减速器把 140 毫米做成 140 米,还缺少指定视频;季度图表编造了年份、单位和来源。这是第三方在其设置下的结果,并非我们的 Tabbit 实测。
官方基准与口径
| 官方报告的测试 | LongCat 2.5 | LongCat 2.0 | 任务 |
|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 终端 Agent |
| Terminal Bench v4.0 | 38.5 | 3.0 | 不同版本的终端测试 |
| BrowseComp | 91.9 | 79.9 | 搜索和浏览研究 |
| AutomationBench public v1.0.6 | 51.8 | 15.8 | 600 道公开自动化题 |
| Vision2Web | 78.6 | 未报告 | 视觉转网页 |
来源:LongCat 发布页,核查于 2026 年 11 月 3 日。除另有说明外,2.5 开启 thinking,temperature 为 1、top-p 为 0.95。Terminal Bench v2.1 使用 Claude Code v2.1.280、512K 最大序列,三次运行取平均;BrowseComp 使用自研框架、两种工具,最多 1,024 轮;Vision2Web 使用不同版本的 Claude Code 和 256K 序列。
竞品带星号的成绩取自公开报告,其余由厂商自测并标为仅供参考。测试版本、任务和框架不同;v2.1 应与 v2.1 比较,不能与 v4.0 分数混比。表格没有给出完整的耗时、成本和真实项目结果分布。
三个值得试用的方向
多步骤代码任务
官方描述了长轨迹、合成任务和 Agent 失败轨迹训练,并报告终端基准有所提升。有测试套件的团队可以在一次性分支上试一个有明确验收标准的问题,但仍须检查无关代码是否被改动。
检索与研究
BrowseComp 使用明确的搜索与浏览框架,适合用作试验线索。真实浏览器工作可能涉及登录、动态页面与额外权限,未必包含在该评测中。先用公开资料并逐条核验引用;浏览器自动化指南介绍的是工作流,不是模型质量证明。
视觉输入
官方称模型以离散 token 处理视觉信号,并报告 Vision2Web 结果。可以试着让它根据截图修改页面,但仍要检查像素、可访问性和代码能否运行,不能把跑分当作这些结果的保证。
三个限制
工具框架会改变结果
Agent 可能选错工具、重复命令或修改范围外文件。Preview 的案例只能提示应检查这些失败方式,不能估计正式版的发生概率。设置时间或工具调用上限,逐项检查变更;也可参考 Tabbit 使用实践。
2.5 权重尚待确认
核查时,官方发布页仍将 GitHub 和 Hugging Face 标为即将推出。2.0 的开放权重不能证明 2.5 已可下载或使用相同许可;自托管前应确认实际文件和条款。
价格与数据处理分别核对
LongCat 官方价格页在 11 月 3 日显示限时价格:每百万 token 未缓存输入 2 元、缓存输入 0.04 元、输出 8 元。价格和币种展示可能变化,以平台账单为准。数据保留、训练和驻留条款尚未完整核实;API 计费、订阅和 Tabbit 账号条款是不同问题。DeepSeek V4 Flash 价格指南可作为另一种计费结构的参考。
在 Tabbit 中试一个可复核的任务
上述两项只测试了文本对话。下一步可打开公开技术文章,要求列出五条带来源的事实,再逐条核对原文;记录模型名、日期、输入、输出和人工修正。在确认账号与服务商条款前,不要提供私有文档或写入权限。
我们的测试账号中有 LongCat-2.5,其他账号可能不同。DeepSeek Harness 指南说明客户端与工具会怎样影响流程;如需比较 DeepSeek V4.1 Flash,应使用相同任务和条件。
 Tabbit Browser
下载不会自动运行模型,请先检查模型选择器和账号条款。
按工作负载给结论
| 工作负载 | 建议 | 原因 |
|---|---|---|
| 有测试套件、可复核的公开代码任务 | 在一次性分支试用 | 官方成绩值得试,但需检查改动与逻辑。 |
| 根据截图制作网页原型 | 用小任务试用 | 视觉能力相关,需检查渲染与可访问性。 |
| 敏感仓库或受监管文档 | 等待数据条款确认 | 保留与访问规则取决于实际服务商及客户端。 |
| 必须本地部署 | 等待权重和许可 | 核查时官方入口仍显示即将推出。 |
| 无人值守生产 Agent | 不要假定已经可用 | 两项简单对话无法证明长任务可靠性。 |
下一步是在实际使用的客户端和服务商中运行同一个可检查的小任务,并记录版本、设置、重试、费用和人工修正。一次成功只是一个例子,不是可靠性估计。

常见问题
LongCat 2.5 值得用吗?
它值得用于可控的代码或视觉任务试用,但上线前应以自己的任务验证。两项 Tabbit 对话测试中,一项计算正确,另一项给出的代码修复可用,但对原代码结果的两处解释有误。
LongCat 2.5 和 2.5 Preview 有什么区别?
LongCat 在 2026 年 11 月 1 日发布了 2.5,此前还有 Preview 版本。明确针对 Preview 的反馈不能直接视为对 11 月版本的测试。
LongCat 2.5 开源了吗?
2026 年 11 月 3 日核查时,官方发布页的 GitHub 和 Hugging Face 入口仍标注即将推出。自行部署前应重新确认权重是否发布及其许可。
LongCat 2.5 适合编程吗?
官方使用 Claude Code 对 Terminal Bench v2.1 的三次运行取平均,报告 88.4 分。这个厂商成绩不能保证你的仓库、客户端和服务商有相同表现,应先用小任务和测试验证。
Tabbit 能使用 LongCat 2.5 吗?
2026 年 11 月 3 日的 Tabbit Browser Dev 测试账号中可以选择 LongCat-2.5,我们用它完成了两项对话任务。不同账号和版本的可用性、额度与条款可能不同,请以实际选择器为准。
LongCat 2.5 多少钱?
2026 年 11 月 3 日官方价格页显示限时优惠:每百万 token 未缓存输入 2 元、缓存输入 0.04 元、输出 8 元。价格可能变化,API 账单与 Tabbit 账号条款应分别确认。