
ChatGPT、Claude、Gemini を使った調査は、チャットの外に共通の調査要件を置き、主張ごとの出典台帳で整理します。元のレポートは別々に保存し、判断を左右する根拠を確認してから最終提案を書きます。
学術調査についての Reddit の議論では、提供元を変えても研究を続けられるよう、PDF、ノート、検証済みの結果をチャットの外に保管するという助言がありました。別のサイトへ移動しても会話の記憶が自動共有されるわけではありません。
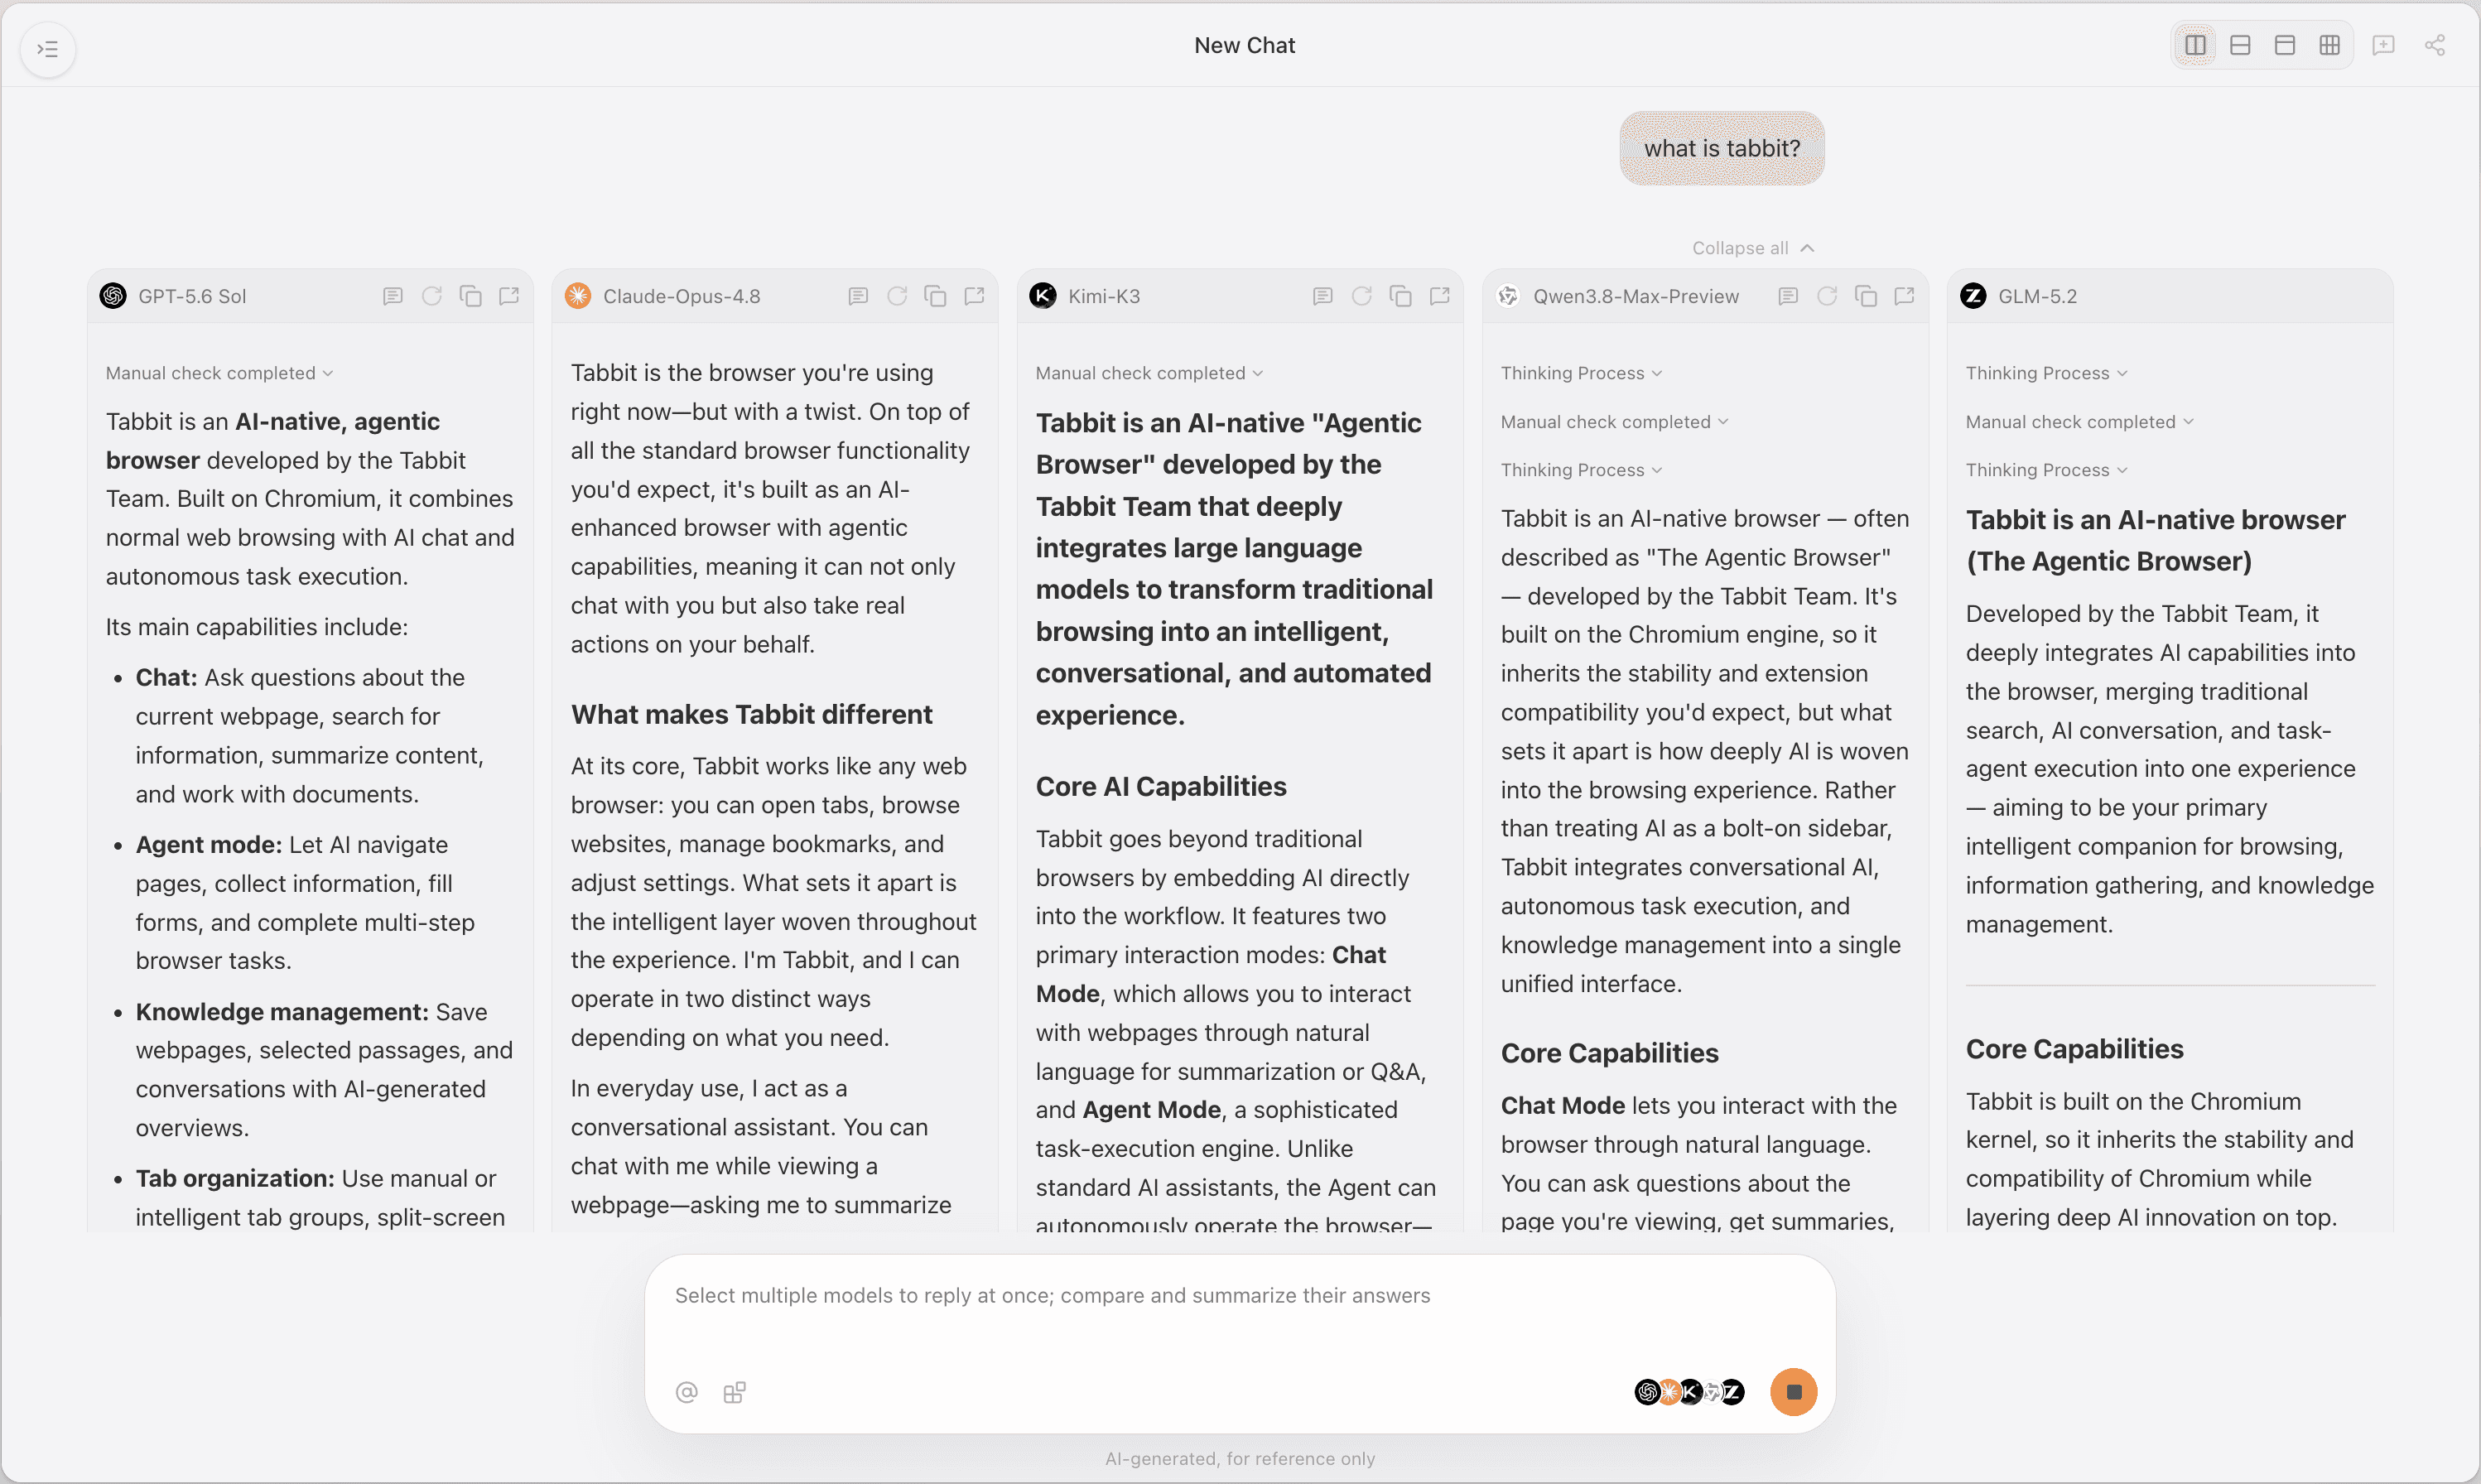
Tabbit Browser は、内蔵の複数モデル回答で説明を比較する方法と、Agent Mode でブラウザ作業を支援する方法を提供します。両者の権限と成果物を区別して使います。
要点
調査要件、出典、最終判断を一つの会話履歴に依存させない。
比較実験では質問と入力資料をそろえる。
Tabbit 内のモデルは各社サイトの調査機能を引き継がない。
ログイン、利用枠、計画、完了状態を各サイトで確認する。
同意したモデル数ではなく、独立した根拠を数える。
調査方法の比較
| 方法 | 比較するもの | 必要なアクセス | 保存するもの |
|---|---|---|---|
| Tabbit の複数モデル回答 | 選択した内蔵モデルの回答 | 対応プランと利用可能モデル | 要件の版と各回答 |
| 三つの公式サイトで調査 | 各サイトの調査レポート | 個別のアカウント、機能、利用枠 | 会話、モード、元レポート、出典 |
| 主担当とレビュー担当 | 根拠付きレポートと批評 | 選んだツールの権限 | 証拠とレビューを別々に保存 |
| 手作業のウェブ調査 | 原典と自分の分析 | ページの閲覧権限 | 出典台帳と日付付きノート |
Tabbit で GPT 系モデルが回答しても、ChatGPT Deep Research が動いた証拠にはなりません。Claude と Gemini も同じです。深い調査の用途では、通常の会話との違いを説明しています。
1. チャットを開く前に要件を書く
例えば「五人のデザインチーム向けに三つのツールの書き出し形式とゲスト権限を比較する」と範囲を絞ります。地域、基準日、対象外、成果物、採用できる出典を明記します。次は手順の例であり、実際の製品比較ではありません。
Research brief v1
Decision: Compare Tools A, B, and C for a five-person design team.
Region: Singapore. Evidence cutoff: 2026-10-29.
Check guest permissions, export formats, and account requirements.
Prioritize official documentation. For each important claim,
provide the original URL, visible date, and supporting passage.
Separate facts, interpretation, and unknowns.
Deliver a comparison, unresolved questions, and a recommendation.
Do not purchase, start trials, or contact vendors.
文書、ファイル、変更可能な会話タイトルに同じ識別子を使います。あるツールがファイルを読めない場合は、全ツールに同じ抜粋を渡すか、入力条件の違いを記録します。全文とタイトルだけの入力は公平な比較になりません。
プロファイル、ワークスペース、タブグループは役割が異なります。タブをまとめてもサイトのアカウントや記憶は統合されません。
2. 独立比較か分担かを決める
独立比較では、まず各ツールに同じ要件を渡し、他の結論を見せません。調査を終えることが目的なら、一つで調べ、別のツールで論理を点検する方法もあります。
三サービスの調査機能を比較する議論で Jackson_Rob は、ChatGPT と Gemini に質問し、Claude で抜けを探す方法を提案しています。個人の選好であり、普遍的なモデル順位ではありません。
役割は仕事と実際の権限で決めます。承認済みの社内資料を読めるツールと公開ウェブだけのツールでは根拠が異なります。複数モデル回答は論点整理や説明の比較に向き、サイト固有の調査は検索、計画、レポート作成を含みます。Agent の推論と調査も参考になります。
3. 各サイトの調査権限を確認する
アカウント所有者が想定したアカウントでログインします。Tabbit の会員権限と三社サイトの契約は別です。
OpenAI の文書には、ツールメニューや /Deepresearch、計画の確認、出典付きレポートが説明されています。残り利用枠は製品内の表示を確認します。
Claude の公式文書では、有料プランとウェブ検索の有効化が必要です。ウェブ版の案内は + から Research。有効なコネクターを調べ、使う資料の違いを記録します。このモードを使わない回答は通常のチャットとして扱います。
Gemini の公式ガイドにはログインと年齢の条件もあります。ホームページを開くだけでは利用資格を確認できません。利用枠の案内を確認し、実際のアカウントで利用可能か調べます。機能がなければ障害として記録し、通常回答を調査レポートと呼ばないでください。
本記事では三つのアカウント画面と、三サイトでの調査全体を実測していません。公式資料に基づく提案手順であり、無人完了を保証するものではありません。
4. 各実行を記録し、原文を残す
提供元、表示モデル、モード、要件の版、会話 URL、開始時刻、状態を記録します。状態は未開始、要対応、実行中、完了、失敗などに統一します。タブが開いたことや導入文が出たことを完了としません。
最初の回答は編集せず保管し、追加質問は改訂として残します。サイトで提供される書き出し形式を使うか、会話のリンクと本文を自分のノートにコピーします。非公開の会話リンクを同僚が読めるとは限りません。
小規模なら Markdown と添付フォルダーで十分です。履歴やブックマークの検索はページを探す助けになりますが、唯一の保管先にはしません。
5. 主張ごとの出典台帳で検証する
主張 ID、原典 URL、発行者、表示日付、確認日、裏付ける箇所、検証状態を記録します。同じ文書には同じ出典 ID を使います。
二つの回答がゲストの書き出しを認め、別の回答が管理者限定としたら、プラン、役割、形式を先に確認します。条件の違いかもしれません。次は製品の検証結果ではなく記録例です。
C-01 | Guest can export project data
ChatGPT: yes, S-01
Claude: administrator only, S-02
Gemini: unclear, S-01
Check plan, role, and export format.
Status: unresolved
原典を開いてから、確認済み、反証あり、未解決を付けます。三レポートが同じページを引用しても、根拠は一つです。
Andrej Karpathy は LLM Council の X 投稿でモデル同士の評価を紹介し、その順位が自分の判断に合うか疑問も述べています。個人の実験であり、この手順の性能測定ではありません。人による確認を残す理由になります。確認待ちページは多すぎるタブの整理も参考にしてください。
Tabbit でこの手順を実行する
要件、レポート、出典がブラウザ内に分散しているとき、Tabbit は反復操作を減らし、比較対象を見える形で残すのに役立ちます。研究者向けページでは関連する使い方を説明しています。
モデル選択画面を開き、プランが対応していれば複数を選びます。同じ短い要件を送り、ラベル付きの回答を比較します。国際版の会員ページでは、既定のブラウザに設定して利用する Standard に同時回答を記載しています。国内版ページにも記載があります。地域と現行モデルを確認し、固定の組み合わせを前提にしないでください。
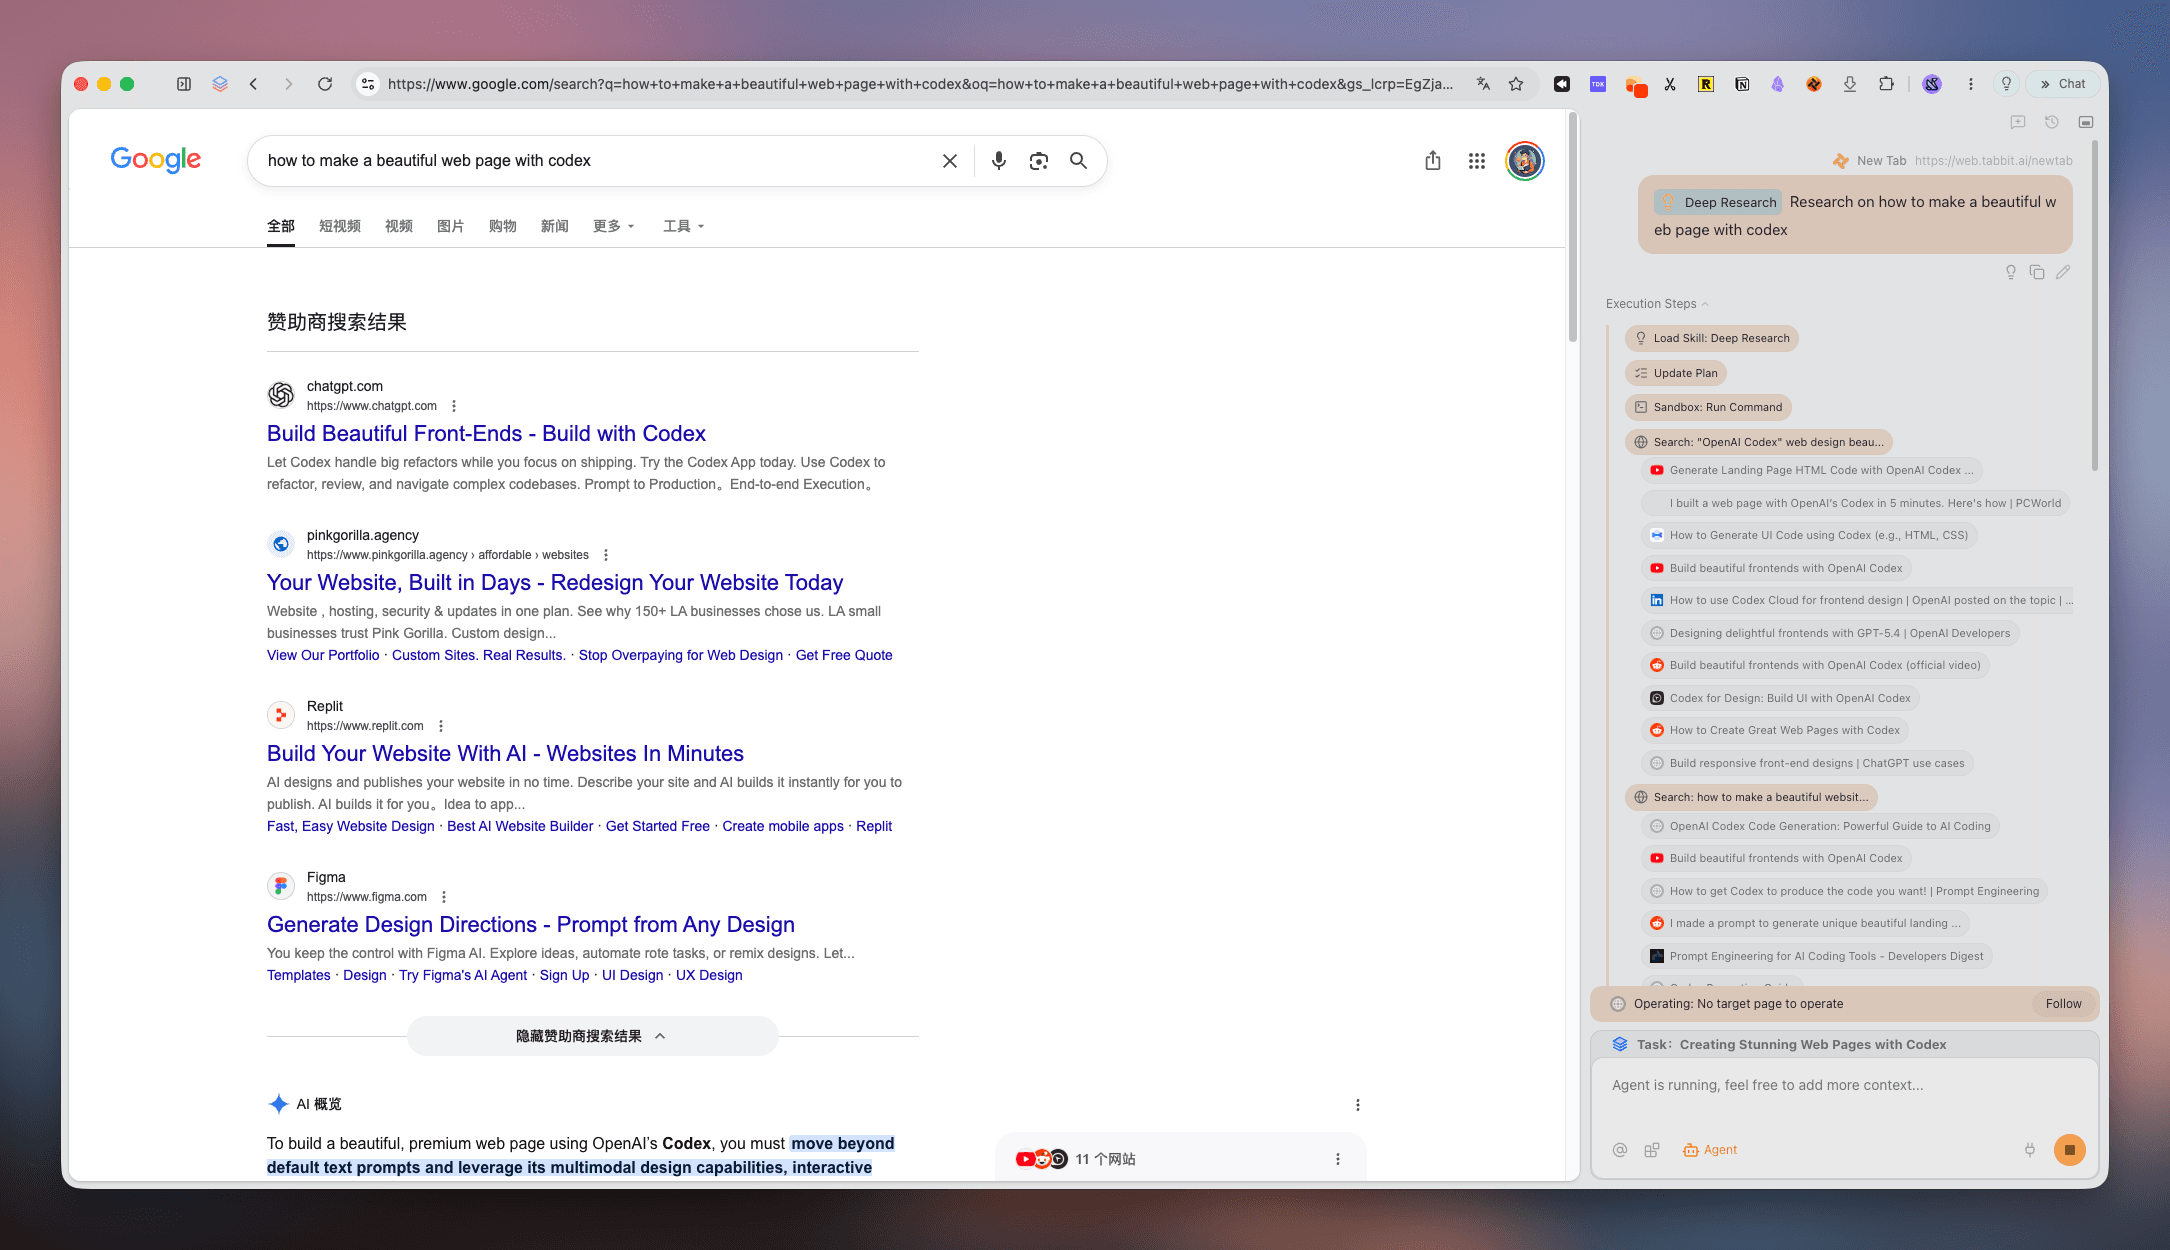
サイト固有の研究には Agent Mode で操作を指示します。複数のページを開いたまま各社サーバーの調査を待つことはできますが、Agent の画面操作は順番に進む場合があります。三ページを開くことと同時開始・完了は別です。ブラウザ自動化の説明も参照してください。
Open https://chatgpt.com/, https://claude.ai/, and https://gemini.google.com/
in separate tabs. First report login state, research mode, and visible quota.
Stop on login, CAPTCHA, payment, permission, or quota blocks.
Do not buy subscriptions or change settings.
Where eligible, select native research and use brief v1.
Show proposed plans and scope changes before starting.
After I approve the plans, start eligible jobs and record conversation URLs.
Track completion separately. Collect original reports and source URLs.
Do not share private files, merge reports yet, or publish results.これは提案テンプレートであり、三サイトでの実測済み手順ではありません。操作できない部分は手動で済ませてから続けます。@ で Tabbit にページやファイルを渡す場合は、添付される文脈を確認します。タブを開くだけでは会話履歴は共有されません。Tabbit の製品紹介も参考になります。
6. 不明点を残した統合メモを書く
検証した台帳と元レポートを渡し、重要な主張の横に出典を付け、事実、解釈、未解決事項を分けるよう求めます。記憶で空欄を埋めさせません。
Using brief v1, the source register, and original reports, write a memo.
Cite source IDs beside important claims.
Separate verified facts, interpretation, and unresolved questions.
Preserve conflicts about dates, plans, roles, regions, and definitions.
Do not treat model agreement as independent verification.
If evidence is insufficient, state what must be checked next.共有前に結論を支える原典を開き、条件が残っているか確認します。別モデルのレビューは抜けの発見に役立ちますが、原文確認の代わりにはなりません。ブラウザでの調査整理も補足になります。
必要十分な小さな手順を選ぶ
| 状況 | 最初に使う方法 | 別のツールを加える条件 |
|---|---|---|
| 単純な事実確認 | 検索と原典 | 根拠が食い違う |
| 未知のテーマ整理 | 利用可能な複数モデル回答 | 出典付きの調査が必要 |
| 重要な比較判断 | 一つの調査と検証 | レビューで仮定を点検できる |
| 提供元の調査比較 | 同一要件で三サイト実行 | 権限があり手間に見合う |
| アクセス失敗 | 障害を記録 | 所有者が解決する |
小さな疑問に三つの長いレポートは不要かもしれません。まず根拠付きの回答を一つ作り、判断への影響に応じてレビューを加えます。最終的に残すのは検証可能な台帳と判断メモです。反復操作が負担なら、限定した Tabbit Agent の仕事から試し、状態を確認してから範囲を広げてください。

よくある質問
Tabbit で三つの深い調査を同時に実行できますか?
Agent Mode はブラウザ上の作業を支援しますが、各サイトのアカウント、調査機能の利用権限、残り利用枠が必要です。三つのタブを開いても調査開始の証明にはなりません。本記事では三サイトでの調査を最後まで実測していません。
複数モデル回答は公式サイトの利用と同じですか?
同じではありません。Tabbit 内で利用可能なモデルを使う機能です。各サイトの調査ツール、契約、会話履歴、コネクターは自動的に引き継ぎません。
ツール間で文脈をそろえるには?
チャットの外に版番号付きの調査要件を保存します。範囲、基準日、資料、出典条件をそろえ、変更も記録してください。
どの権限を確認すべきですか?
Claude Research は現在、有料プランと有効なウェブ検索が必要です。ChatGPT と Gemini の利用可否や枠はアカウントとプランによります。Tabbit の地域別会員権限は別に確認します。
モデルが同意すれば事実と判断できますか?
できません。同じページや誤りを繰り返している可能性があります。原典を開き、その条件も含めて主張を裏付けているか確認します。
調査終了時に何を残しますか?
調査要件の版、提供元、モード、会話 URL、元のレポートと出典を保存します。検証済みの結論、未解決の相違、アクセス失敗も残すと再開できます。