
LongCat 2.5 merece una prueba controlada para código y trabajo visual, pero aún no hay base para confiarle un agente de producción sin supervisión. En dos tareas de Tabbit, calculó una tabla correctamente y propuso una corrección de código útil, aunque describió mal dos resultados del programa original.
La evaluación oficial indica 88,4 en Terminal Bench v2.1 frente a 70,8 de LongCat 2.0. Es una comparación bajo las condiciones del proveedor, no la probabilidad de éxito en tu proyecto.
Conclusiones clave
El proveedor describe 1,6 billones de parámetros totales y unos 48.000 millones activos por token.
Las puntuaciones dependen del entorno y no son una reproducción independiente.
Los informes sobre Preview incluyen comentarios positivos y bucles de herramientas; no deben atribuirse a la versión posterior.
Los pesos seguían marcados como próximos el 3 de noviembre.
Comprueba disponibilidad, privacidad y precio de tu proveedor antes de dar acceso a archivos o herramientas.
LongCat 2.5 de un vistazo
| Aspecto | Dato verificado el 3 de noviembre | Lo que no demuestra |
|---|---|---|
| Modelo | 1,6T totales y unos 48B activos por token | Latencia o coste de tu instalación |
| Agentes | Mejoras frente a 2.0 en la tabla del proveedor | Tasa de éxito en producción |
| Visión | Entrada visual representada mediante tokens | Fidelidad de cualquier página generada |
| Pesos | GitHub y Hugging Face: próximamente | Fecha o licencia |
| Tabbit | Dos tareas de chat en una cuenta de prueba | Cuota de otras cuentas |
Consulta la guía de LongCat 2.0 para la generación anterior y la explicación del navegador agéntico para separar modelo y cliente.
Dos pruebas en Tabbit antes de la clasificación
El 3 de noviembre elegimos LongCat-2.5 en Tabbit Browser Dev, en modo chat y sin herramientas de escritura. Los criterios se fijaron antes; cada tarea se ejecutó una vez en la misma conversación. Se desconocen la instantánea del modelo, el proveedor, el ajuste de razonamiento, los tokens y el coste. No se puede inferir una tasa de éxito ni extrapolar la disponibilidad.
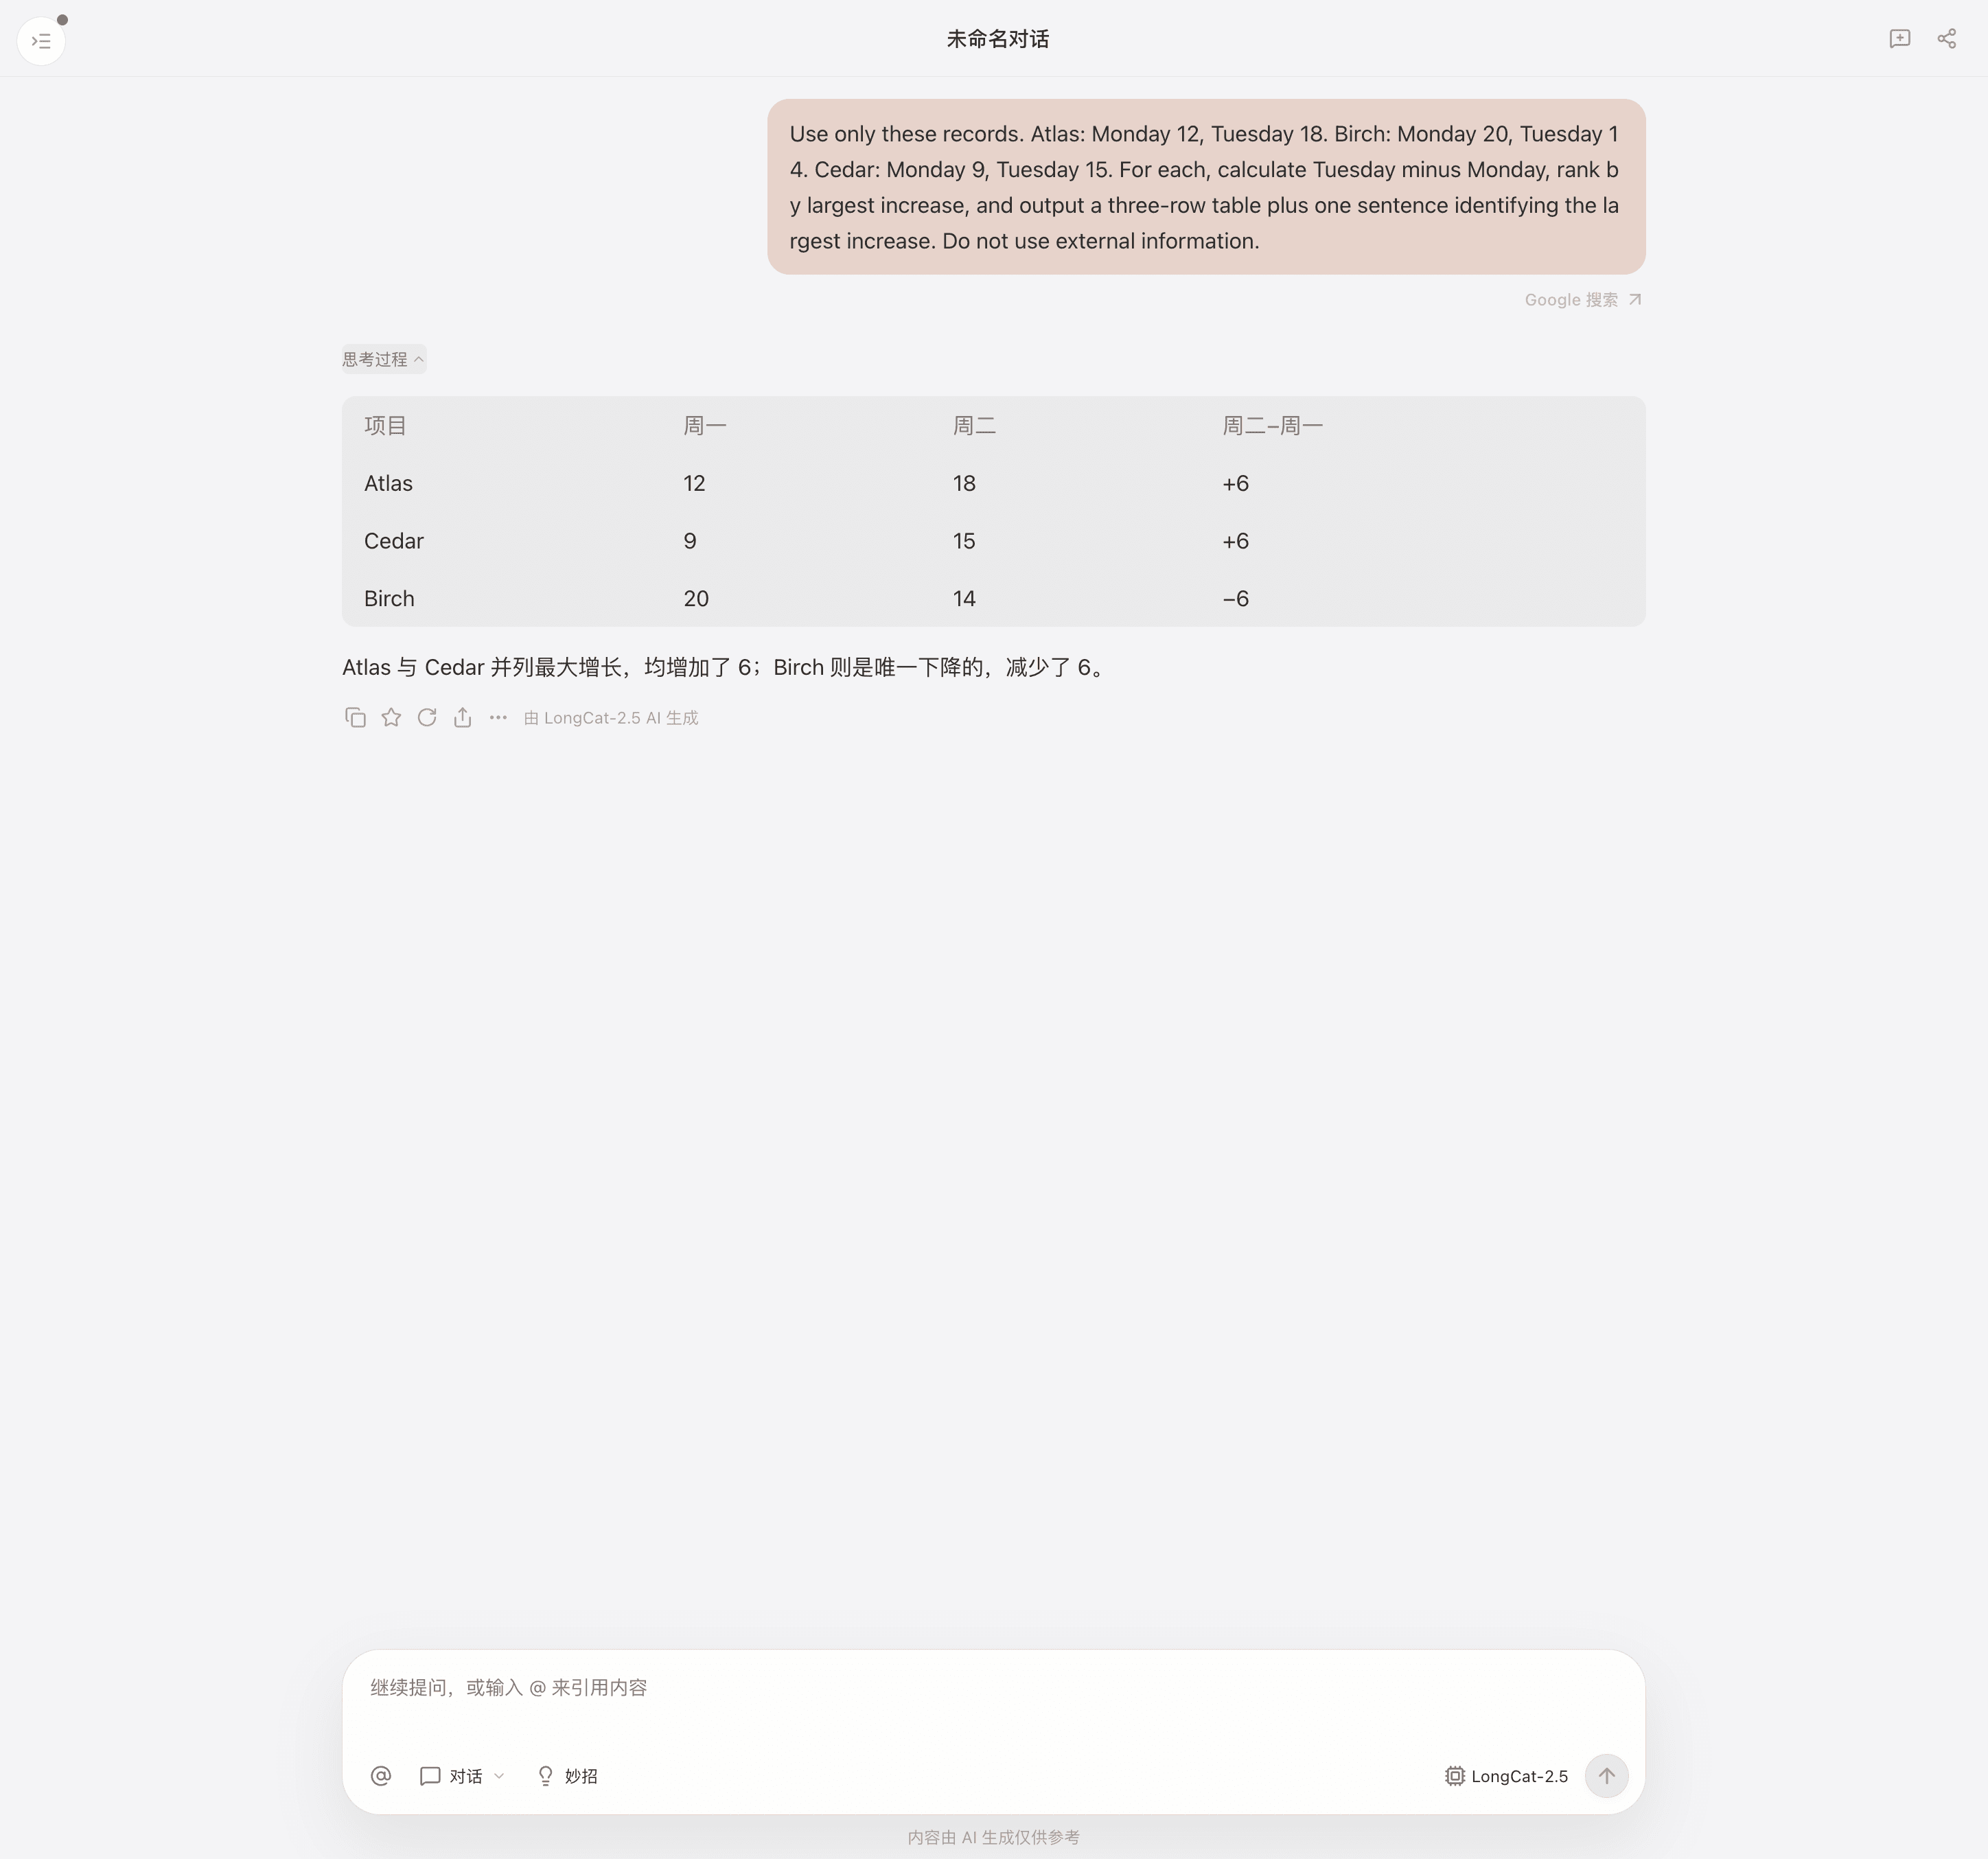
Con tres registros inventados, calculó +6, +6 y −6 y reconoció el empate. Respondió en chino en un entorno chino; el prompt en inglés no exigía idioma de salida.
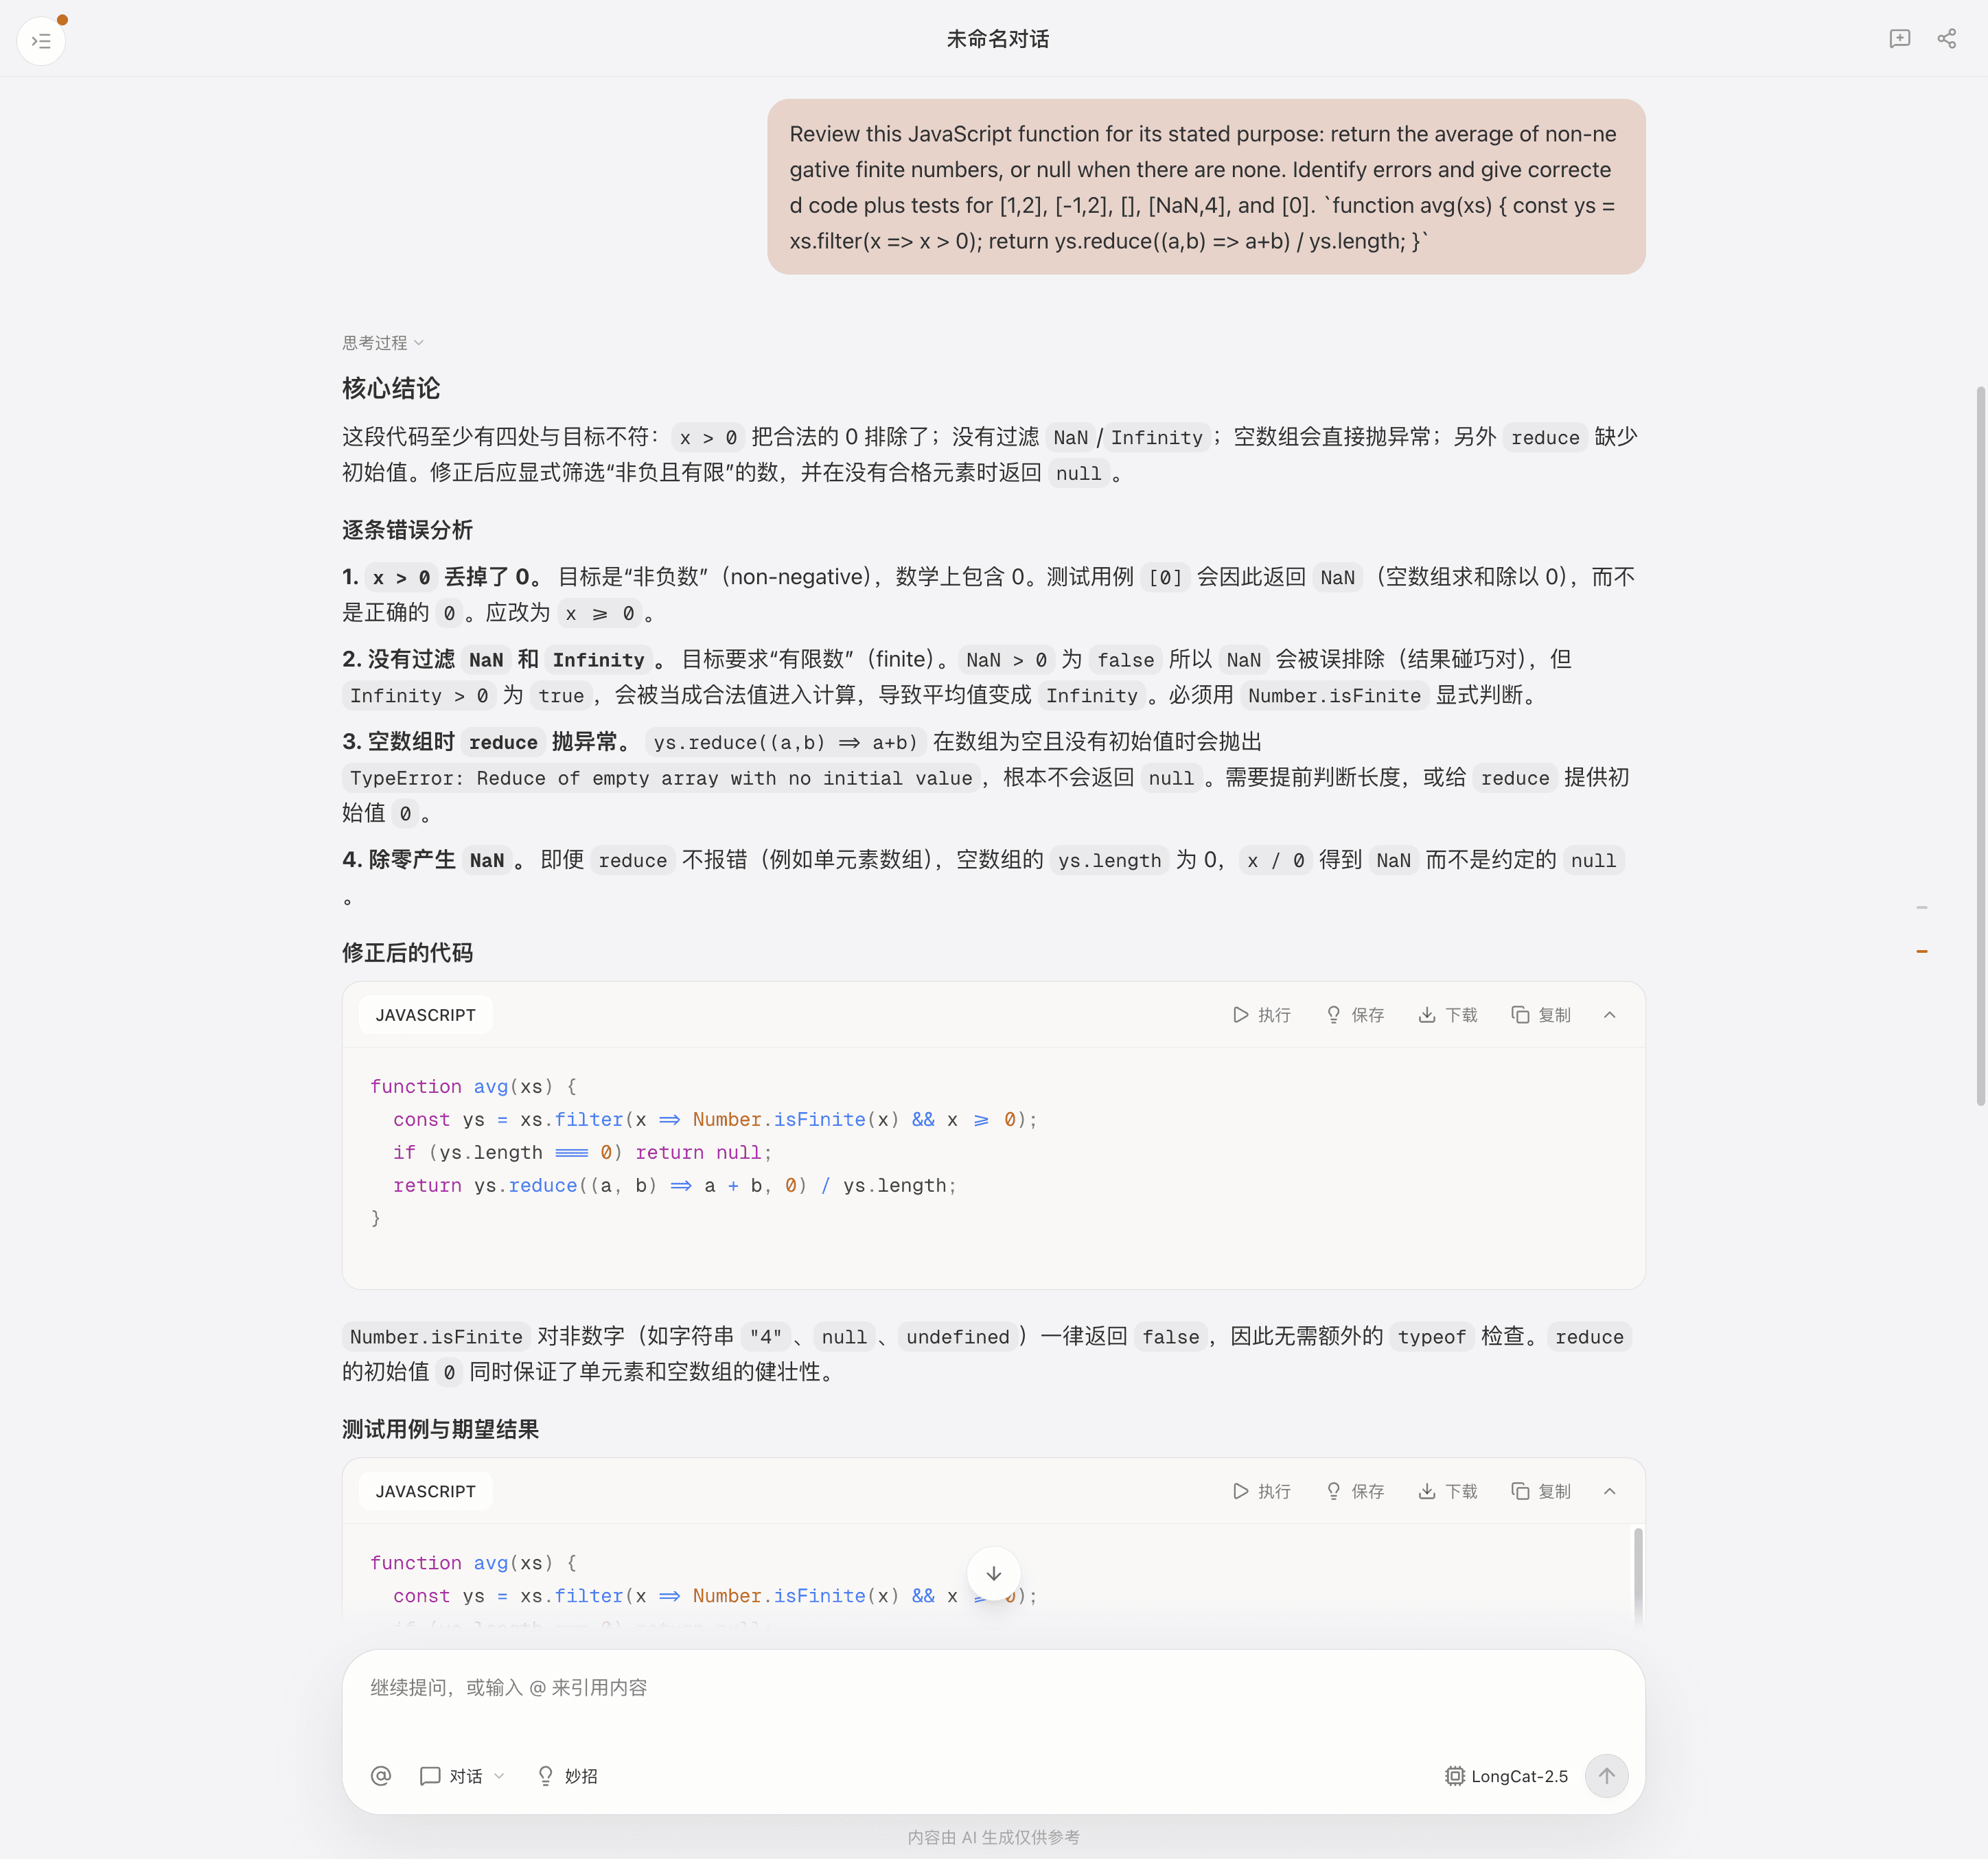
En la revisión de una función JavaScript, la corrección filtró números finitos no negativos y devolvió null para una lista vacía. Al ejecutarla localmente, los cinco casos dieron los resultados esperados. Pero el análisis del código original afirmó por error que [NaN, 4] devuelve NaN (devuelve 4) y que [0] devuelve NaN (lanza TypeError). Propuso pruebas, sin demostrar que las ejecutara. No probamos edición autónoma de repositorios.
Experiencias de la comunidad: Preview y versión de noviembre
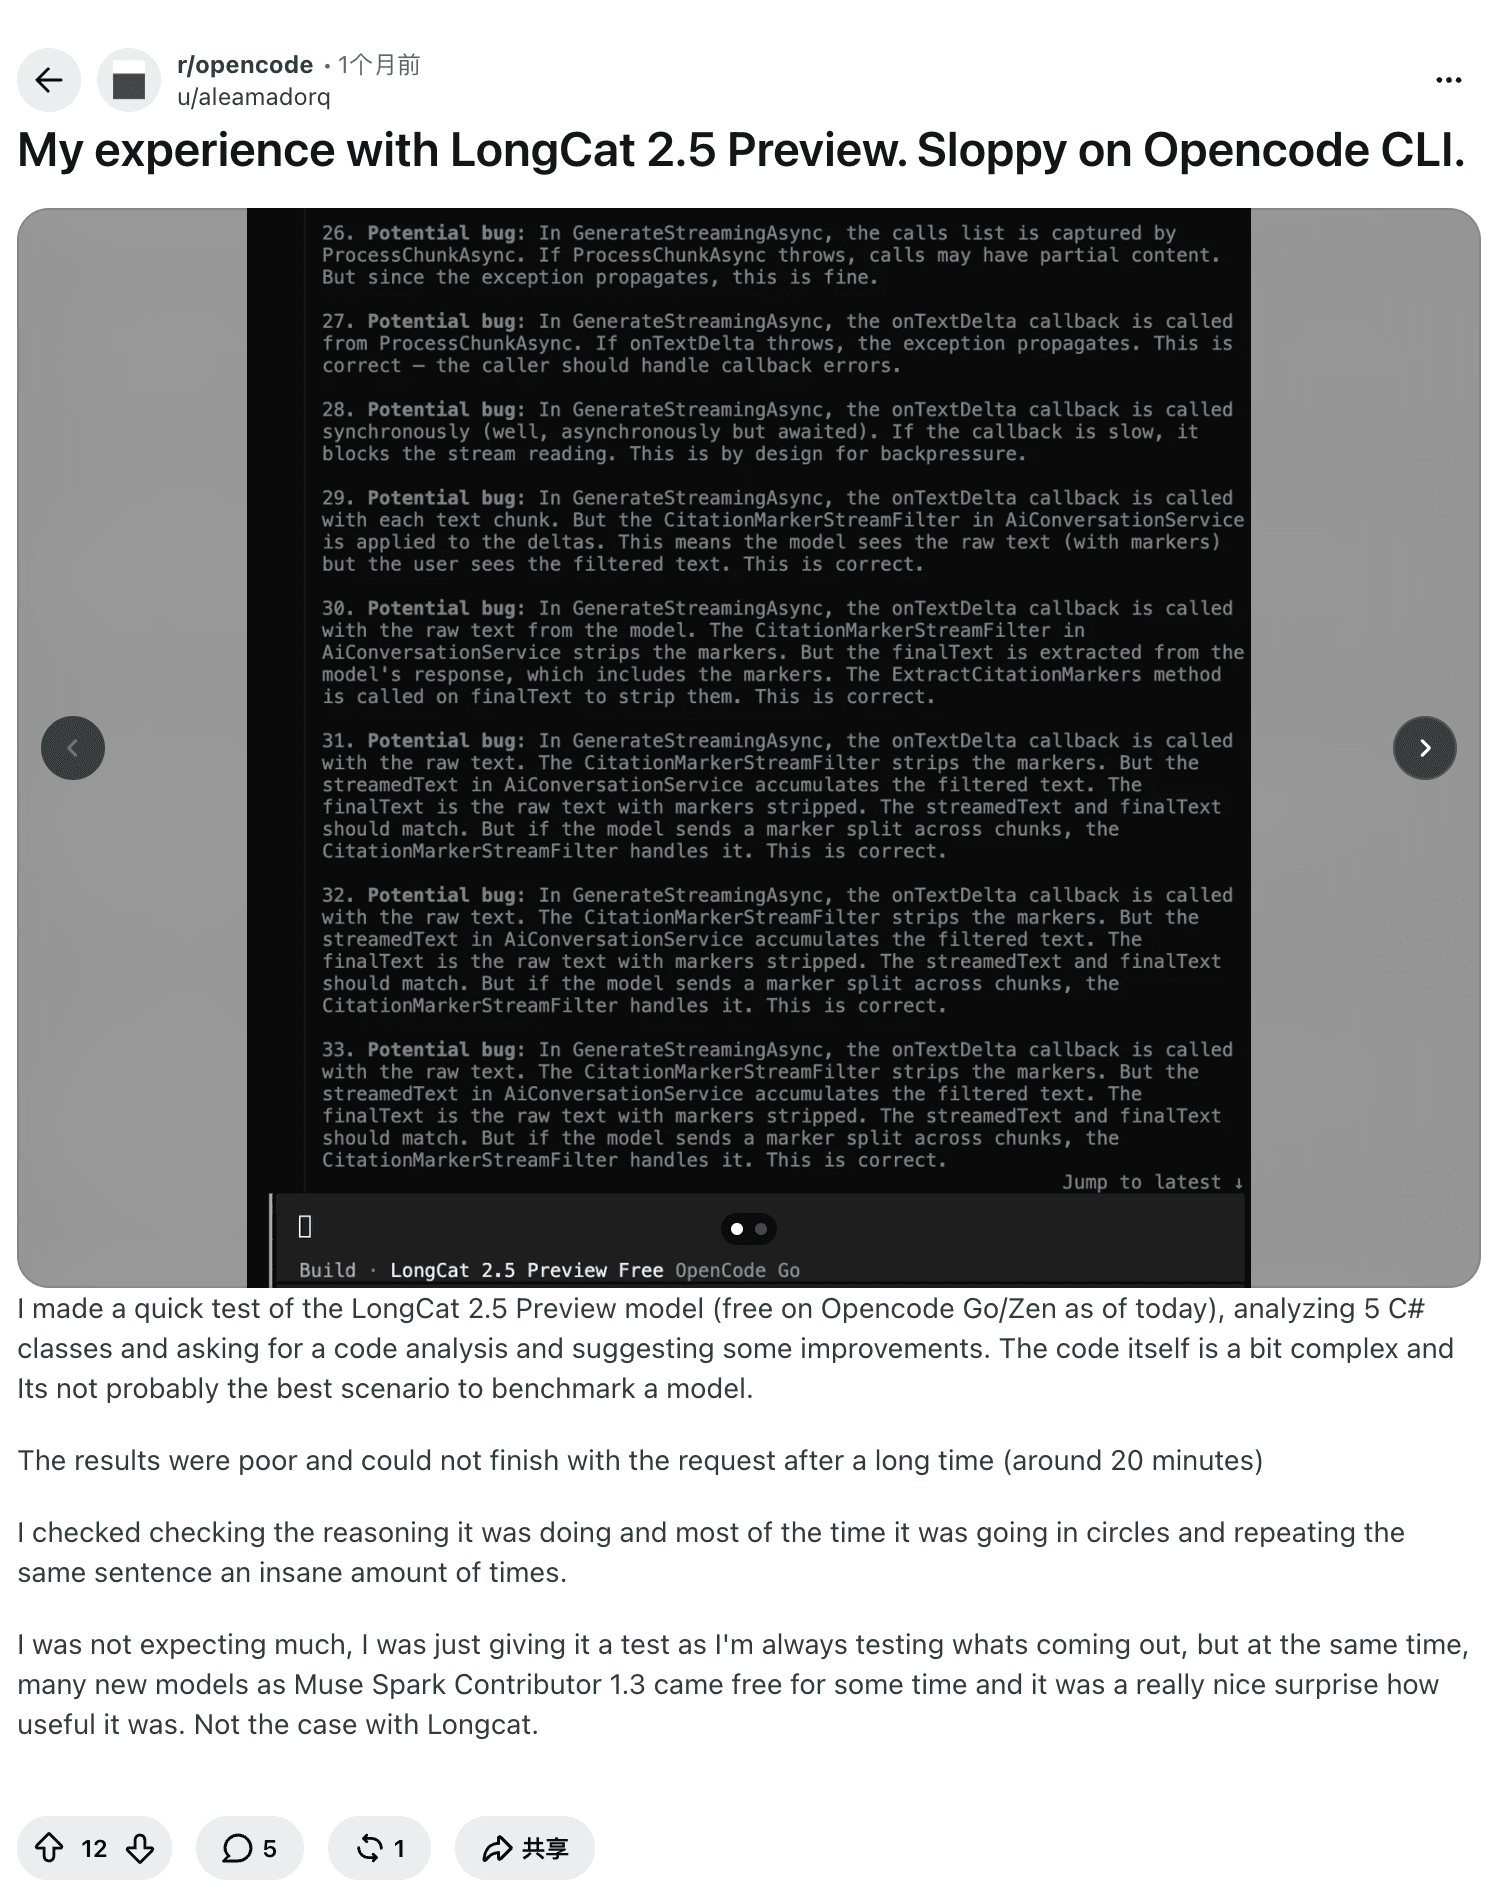
Un usuario de Reddit dice que Preview entró en bucles al analizar cinco clases C# en OpenCode y no terminó en unos 20 minutos; no publicó la entrada ni la configuración completa. Otro ensayo de Preview informa 48,7% pass@1 y 64,0% pass@3 en 89 tareas, con tres ejecuciones y un fallo persistente del dispositivo. No es comparable directamente con el resultado oficial del modelo posterior.
Una experiencia en DEV favoreció el contexto y la coordinación de herramientas de Preview en varios proyectos, sin publicar prompts completos ni registros controlados.
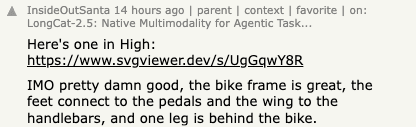
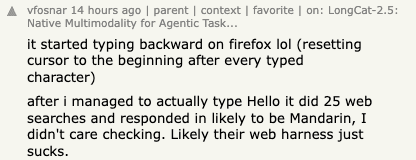
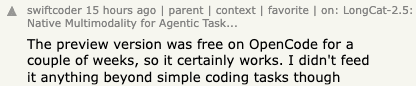
En Hacker News, InsideOutSanta mostró una imagen de un pelícano en bicicleta y la valoró positivamente, sin publicar la configuración completa. vfosnar describió problemas de escritura en Firefox y búsquedas repetidas, atribuyéndolos tentativamente al cliente. swiftcoder encontró útil Preview para tareas simples de código, sin detalles suficientes. Son experiencias individuales, no tasas de éxito.
La evaluación de TOKRACE describe 15 tareas creativas con la versión de noviembre en Claude Code: una estantería respetó las dimensiones; un reductor usó 140 metros en vez de 140 milímetros y no entregó el vídeo solicitado; un gráfico inventó año, unidades y fuente. Son resultados de terceros bajo su propia configuración.
Pruebas oficiales y sus condiciones
| Prueba oficial | 2.5 | 2.0 | Uso |
|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | Agente de terminal |
| Terminal Bench v4.0 | 38.5 | 3.0 | Otra versión de la prueba |
| BrowseComp | 91.9 | 79.9 | Búsqueda e investigación |
| AutomationBench public v1.0.6 | 51.8 | 15.8 | 600 tareas públicas |
| Vision2Web | 78.6 | Sin dato | Imagen a web |
Fuente oficial, consultada el 3 de noviembre de 2026. Salvo indicación contraria: thinking activado, temperatura 1 y top-p 0,95. Terminal v2.1 usó Claude Code v2.1.280, secuencia máxima de 512K y media de tres ejecuciones. BrowseComp usó un harness propio, dos herramientas y hasta 1.024 turnos; Vision2Web usó otro Claude Code y 256K. Las cifras de rivales mezclan fuentes externas y pruebas del fabricante. No compares v2.1 con v4.0 ni infieras costes o éxito real.
Tres posibles puntos fuertes
Código de varios pasos
La mejora declarada en tareas de terminal justifica probar una incidencia acotada con tests.
Investigación con fuentes públicas
BrowseComp es una señal para investigar con fuentes públicas, no una garantía sobre sitios autenticados.
Entrada visual
La entrada visual permite ensayar una interfaz a partir de una captura, pero hay que comprobar renderizado, accesibilidad y código. La guía de automatización explica el flujo, no la calidad del modelo.
Tres límites
El cliente cambia el resultado
El cliente puede afectar a herramientas, bucles y cambios fuera de alcance; fija límites y revisa los archivos, como sugieren estas prácticas de Tabbit.
Pesos pendientes
Los pesos de 2.5 todavía figuraban como próximos.
Precio y datos
La tarifa oficial mostraba el 3 de noviembre ¥2/¥0,04/¥8 por millón de tokens de entrada sin caché, entrada en caché y salida, respectivamente, con descuento temporal. Confirma las condiciones de retención y residencia; API, suscripción y Tabbit son productos distintos. La guía de precios de DeepSeek V4 Flash muestra otra estructura.
Una prueba práctica en Tabbit
Una prueba siguiente: abre un artículo público, pide cinco afirmaciones con enlaces y comprueba cada fuente. Registra modelo, fecha, prompt, respuesta y correcciones; no envíes documentos privados antes de revisar las condiciones. El selector puede variar por cuenta. La guía de DeepSeek Harness explica el papel del cliente y la guía de DeepSeek V4.1 Flash sirve para comparar con las mismas tareas. Para guardar ensayos, consulta investigación con varios modelos.
 Tabbit Browser
Descargar el navegador no ejecuta el modelo; comprueba primero el selector y las condiciones.
Recomendación por tarea
| Tarea | Decisión | Motivo |
|---|---|---|
| Código público con tests | Probar en una rama desechable | Revisar cambios y lógica. |
| Prototipo visual | Probar con una captura | Validar la página y su accesibilidad. |
| Datos sensibles | Esperar condiciones verificadas | La política depende del proveedor. |
| Instalación local obligatoria | Esperar pesos y licencia | Los enlaces seguían pendientes. |
| Agente autónomo en producción | No asumir que está listo | Dos tareas de chat no prueban fiabilidad prolongada. |
Ejecuta la misma tarea verificable en el cliente y proveedor reales; conserva versión, ajustes, reintentos, costes y correcciones. Un resultado no es una tasa de fiabilidad.

Preguntas frecuentes
¿Merece la pena probar LongCat 2.5?
Sí, en tareas controladas de código o trabajo visual. Dos pruebas pequeñas no demuestran fiabilidad en agentes largos y una respuesta explicó mal dos resultados del código original.
¿En qué se diferencia de 2.5 Preview?
LongCat presentó 2.5 el 1 de noviembre de 2026 después de una versión Preview. Las experiencias de Preview no son pruebas directas de la versión de noviembre.
¿Están disponibles los pesos?
El 3 de noviembre los enlaces oficiales de GitHub y Hugging Face indicaban que llegarían próximamente. Comprueba los archivos y la licencia antes de planear una instalación local.
¿Es bueno para programar?
El proveedor informa 88,4 en Terminal Bench v2.1 con Claude Code, como media de tres ejecuciones. Comprueba su comportamiento con pruebas y revisión en tu propio entorno.
¿Puedo usarlo en Tabbit?
Una cuenta de pruebas de Tabbit Browser Dev ofrecía LongCat-2.5 el 3 de noviembre de 2026. La disponibilidad y las condiciones pueden variar según cuenta y edición.
¿Cuánto cuesta?
La página oficial mostraba una promoción por millón de tokens de ¥2 de entrada sin caché, ¥0,04 de entrada en caché y ¥8 de salida. Los precios pueden cambiar y la facturación de API es distinta de las condiciones de Tabbit.