
LongCat 2.5는 코드와 시각 작업에서 통제된 시험을 해볼 만하지만, 무인 프로덕션 에이전트에 맡길 근거는 아직 부족합니다. Tabbit의 두 작은 작업에서 표 계산과 수정 코드는 정확했지만, 원본 코드의 결과 두 가지를 잘못 설명했습니다.
공식 평가의 Terminal Bench v2.1 점수는 2.5가 88.4, 2.0이 70.8입니다. 공급사의 조건에서 얻은 비교이며 자신의 프로젝트 성공 확률은 아닙니다.
핵심 요약
공급사는 전체 1.6조 개 파라미터 중 토큰당 약 480억 개가 활성화된다고 설명합니다.
점수는 실행 환경에 좌우되며 독립 재현 결과가 아닙니다.
Preview에는 긍정적인 의견과 도구 반복 보고가 모두 있었지만 이후 버전의 동작을 증명하지는 못합니다.
11월 3일에도 가중치는 출시 예정으로 표시되었습니다.
파일이나 도구 권한을 주기 전에 사용 가능 여부, 개인정보 처리, 가격을 확인하세요.
LongCat 2.5 한눈에 보기
| 항목 | 11월 3일 확인 내용 | 증명하지 못하는 것 |
|---|---|---|
| 모델 | 전체 1.6T, 토큰당 약 48B 활성 | 실제 지연이나 비용 |
| 에이전트 | 공식 표에서 2.0 대비 향상 | 프로덕션 성공률 |
| 시각 입력 | 시각 정보를 토큰으로 표현 | 생성 페이지의 정확성 |
| 가중치 | GitHub와 Hugging Face 출시 예정 | 출시일 또는 라이선스 |
| Tabbit | 테스트 계정에서 두 가지 채팅 작업 | 다른 계정의 한도 |
이전 세대는 LongCat 2.0 소개, 모델과 클라이언트의 차이는 에이전트 브라우저 설명을 참고하세요.
순위보다 먼저: Tabbit에서 두 가지 테스트
11월 3일 Tabbit Browser Dev 테스트 계정에서 LongCat-2.5를 선택해 쓰기 도구 없이 채팅했습니다. 기준을 미리 정하고 같은 대화에서 각 작업을 한 번 실행했습니다. 모델 스냅샷, 공급 경로, 추론 설정, 토큰, 비용은 알 수 없습니다. 성공률이나 다른 계정의 사용 가능성을 추정할 수 없습니다.
가상의 세 숫자 집합에서 +6, +6, −6을 정확히 계산하고 공동 1위를 표시했습니다. 영어 입력은 출력 언어를 지정하지 않았고 중국어 환경에서 중국어로 답했습니다.
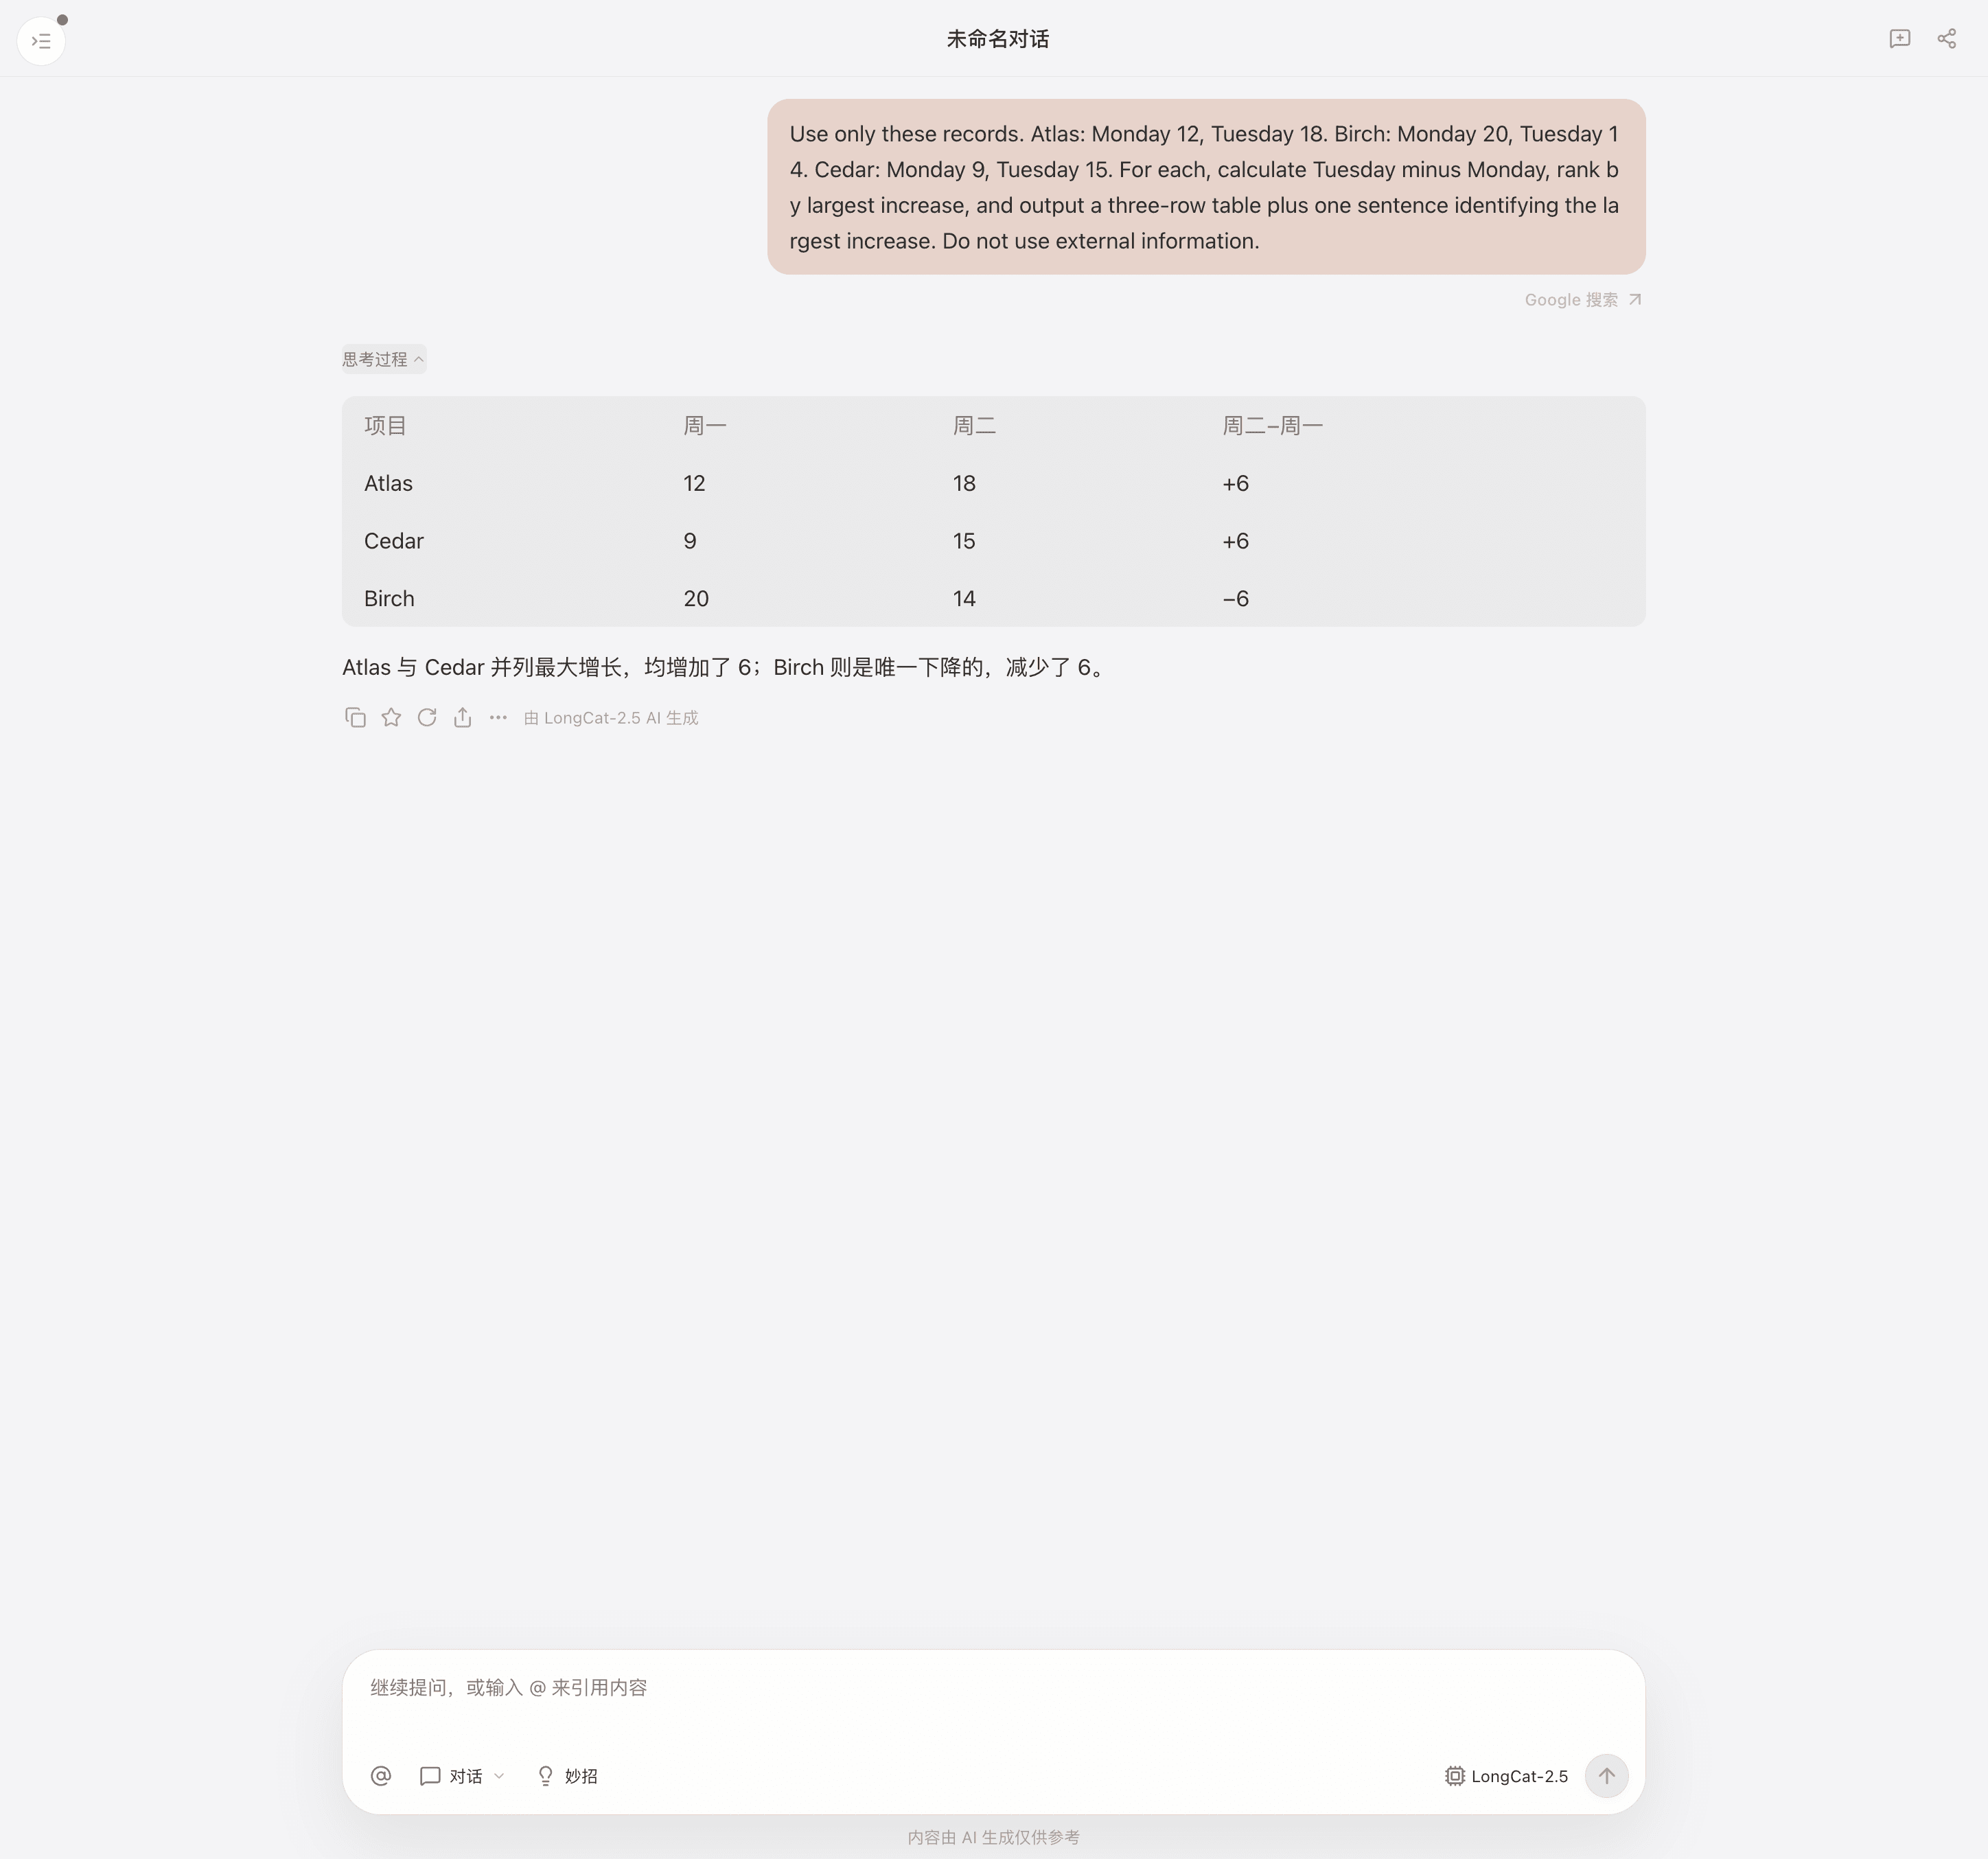
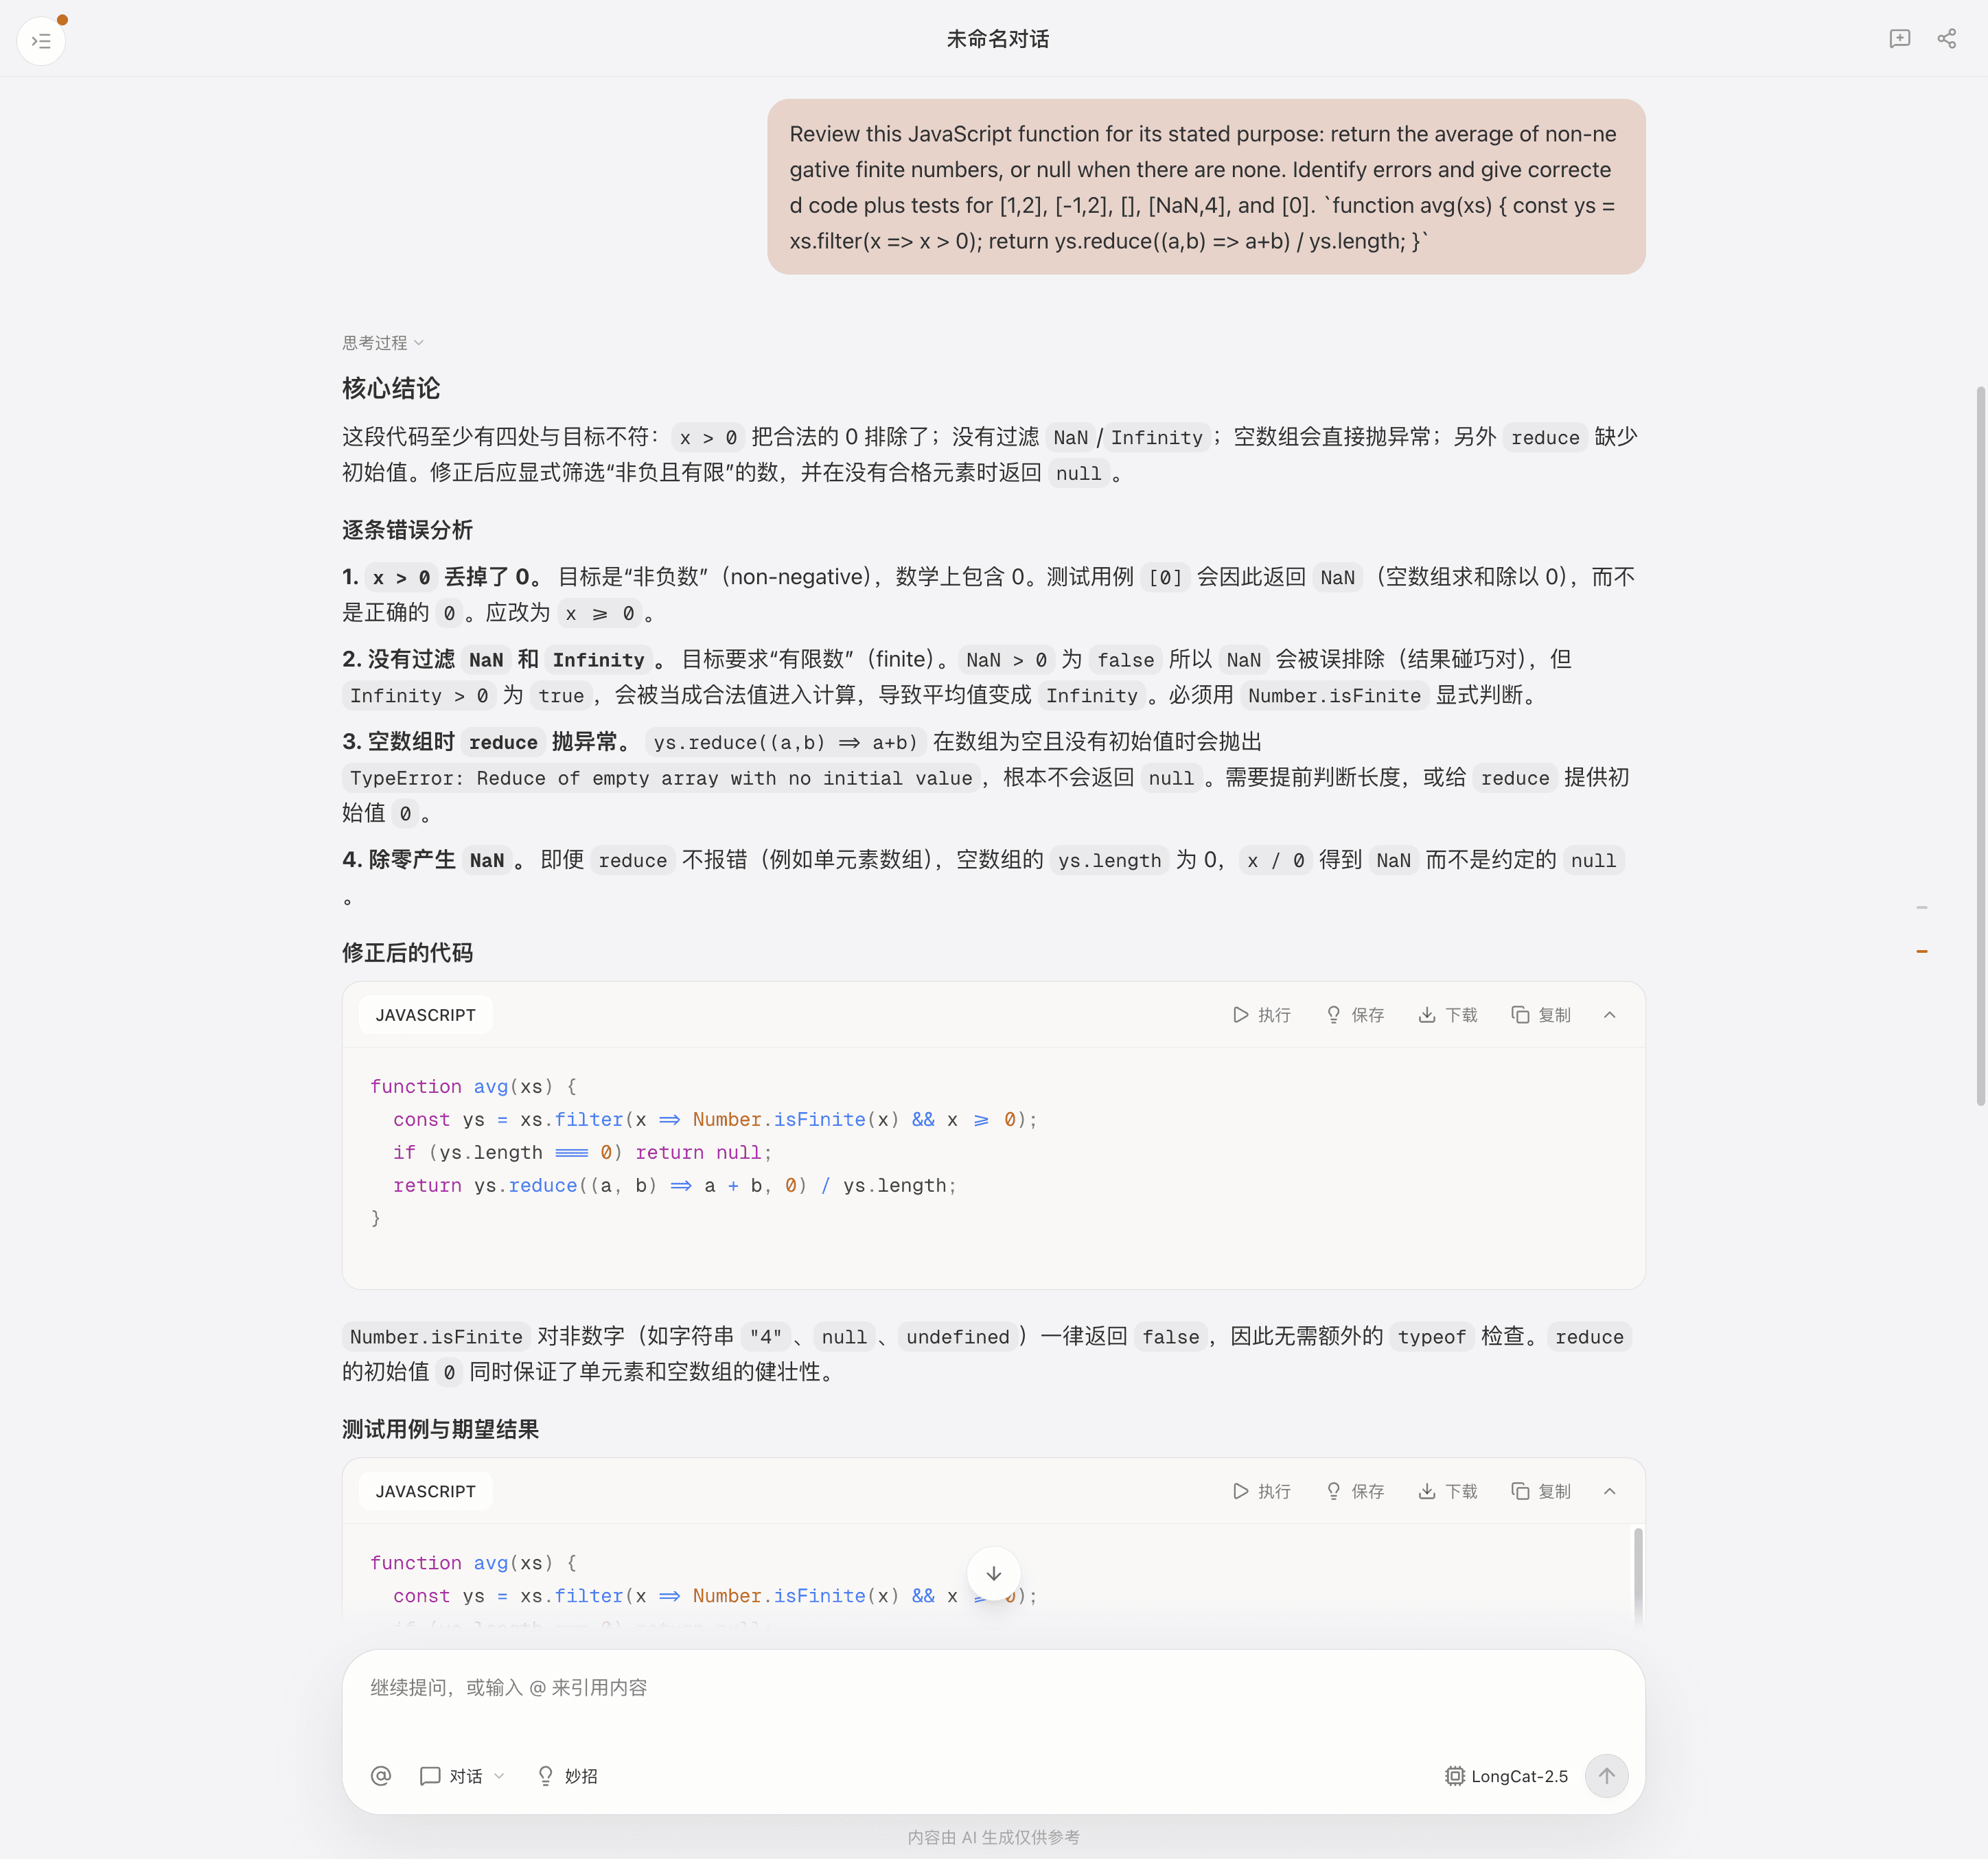
JavaScript 함수 리뷰에서 유한한 비음수만 필터링하고 결과가 없으면 null을 반환하도록 수정했습니다. 로컬 실행에서 다섯 예제는 예상대로 나왔습니다. 그러나 원본 코드의 [NaN, 4]는 NaN이 아니라 4를 반환하고 [0]은 NaN이 아니라 TypeError를 던지는데, 두 결과를 잘못 설명했습니다. 테스트 코드는 제안했으나 모델이 직접 실행한 증거는 없습니다. 저장소 자동 수정은 시험하지 않았습니다.
커뮤니티 의견: Preview와 11월 버전 구분
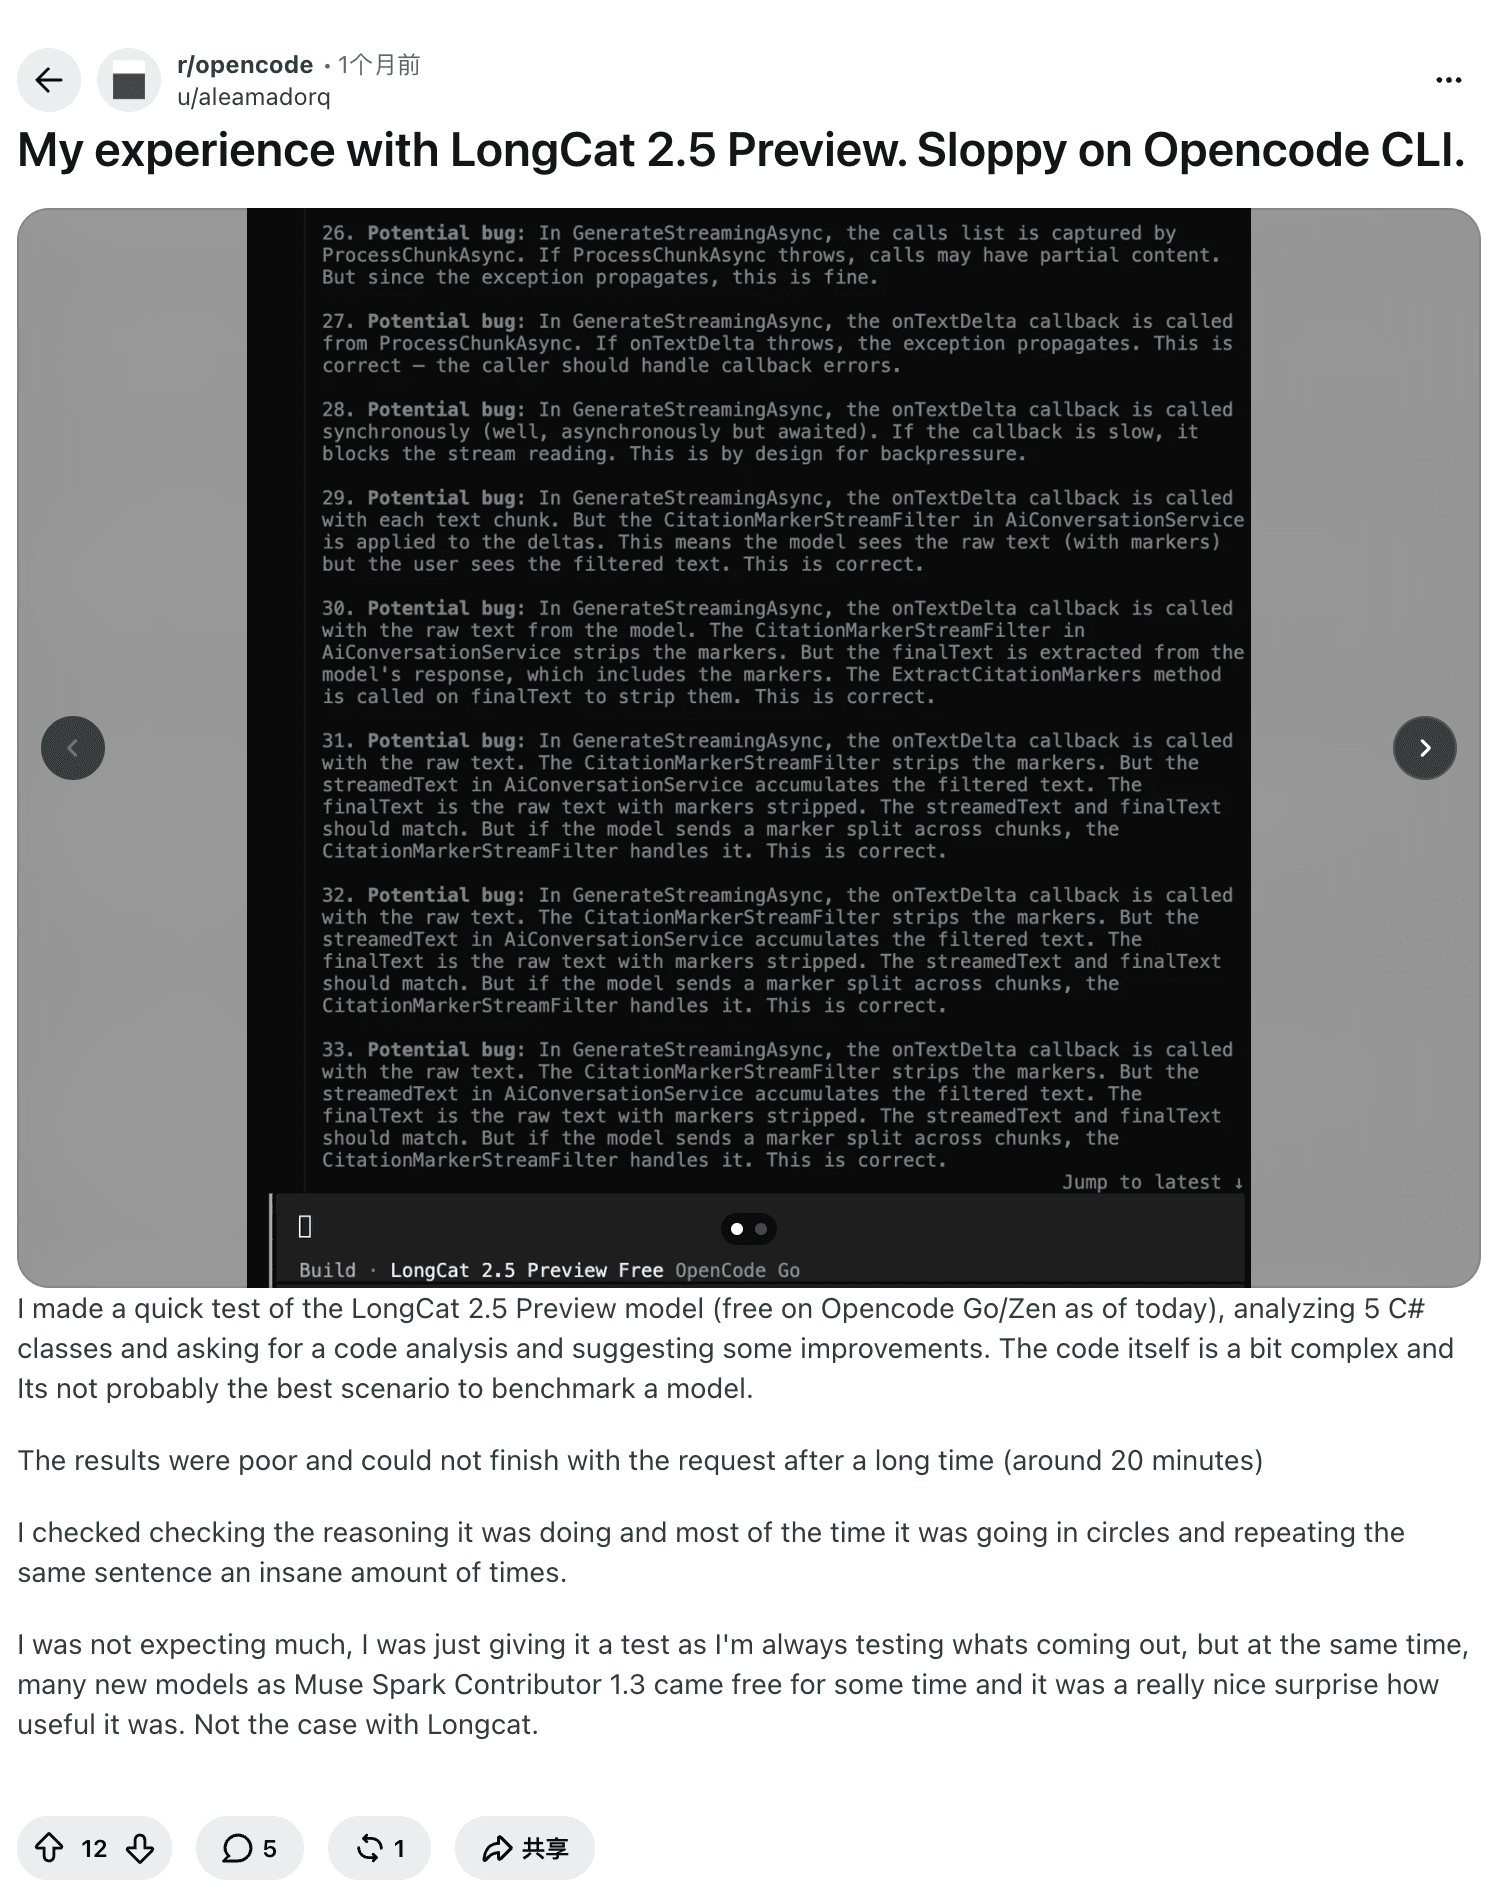
Reddit 사용자는 OpenCode의 Preview로 C# 클래스 다섯 개를 분석할 때 반복에 빠져 약 20분 동안 끝나지 않았다고 보고했습니다. 전체 입력과 설정은 공개되지 않았습니다. 다른 Preview 테스트는 89개 작업을 세 번씩 실행해 pass@1 48.7%, pass@3 64.0%를 보고했고 한 작업에서 기기 오류가 계속 발생했습니다. 이후 모델의 공식 점수와 직접 비교할 수 없습니다.
DEV 사용 후기는 여러 프로젝트에서 Preview의 맥락 이해와 도구 조정을 긍정적으로 평가했지만 전체 입력이나 통제된 로그는 공개하지 않았습니다.
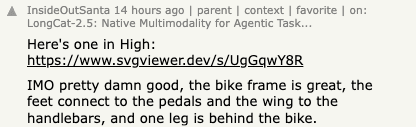
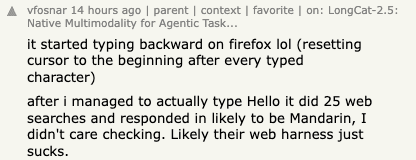
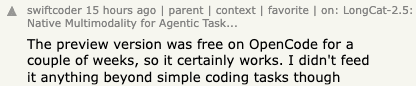
Hacker News의 InsideOutSanta는 자전거를 타는 펠리컨 이미지를 긍정적으로 평가했지만 전체 설정은 공개하지 않았습니다. vfosnar는 Firefox 입력 문제와 반복 검색을 보고하고 클라이언트 문제일 가능성을 언급했습니다. swiftcoder는 Preview로 간단한 코딩 작업을 했다고 했지만 세부 내용은 없습니다. 모두 개인 경험입니다.
TOKRACE 평가는 Claude Code에서 11월 버전을 사용한 창작 작업 15개를 기록했습니다. 책장은 치수를 충족했지만 감속기는 140밀리미터를 140미터로 만들고 요청된 영상을 제출하지 못했습니다. 대시보드는 연도, 단위, 출처를 지어냈습니다. 제3자의 설정에서 얻은 결과입니다.
공식 벤치마크와 조건
| 공식 테스트 | 2.5 | 2.0 | 대상 |
|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 터미널 에이전트 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 다른 버전의 테스트 |
| BrowseComp | 91.9 | 79.9 | 검색과 조사 |
| AutomationBench public v1.0.6 | 51.8 | 15.8 | 공개 문제 600개 |
| Vision2Web | 78.6 | 미보고 | 이미지에서 웹으로 |
공식 자료, 2026년 11월 3일 확인. 별도 명시가 없으면 thinking 활성화, temperature 1, top-p 0.95입니다. Terminal v2.1은 Claude Code v2.1.280, 최대 512K, 세 번의 평균을 사용했습니다. BrowseComp는 자체 하네스와 두 도구, 최대 1,024회 순회를 사용했고 Vision2Web은 다른 Claude Code 버전과 256K를 사용했습니다. 경쟁 모델 수치는 외부 자료와 공급사 측정이 섞여 있습니다. v2.1과 v4.0을 직접 비교하거나 비용과 실제 성공률로 환산하지 마세요.
시험할 만한 세 가지 용도
여러 단계의 코드 작업
공식 터미널 점수의 향상은 테스트가 있는 작은 문제를 시험할 이유가 됩니다.
공개 자료 조사
BrowseComp는 공개 자료 조사에 참고할 수 있지만 로그인 사이트에서의 동작을 보장하지 않습니다.
시각 입력
이미지로 웹 페이지를 시험할 수 있지만 렌더링, 접근성, 코드를 검증해야 합니다. 브라우저 자동화 가이드는 작업 흐름을 설명하며 모델 품질의 증거는 아닙니다.
세 가지 한계
클라이언트에 따라 달라지는 결과
클라이언트는 도구 선택과 반복에 영향을 줍니다.
공개되지 않은 가중치
호출 횟수를 제한하고 Tabbit 활용 가이드를 참고해 파일 변경을 검토하세요.
가격과 데이터 조건
2.5 가중치는 출시 예정으로 표시되어 있었습니다. 공식 가격은 11월 3일 기준 100만 토큰당 캐시되지 않은 입력 2위안, 캐시 입력 0.04위안, 출력 8위안의 기간 한정 요금이었습니다. 데이터 보관과 소재지 조건을 확인하고 API, 구독, Tabbit 조건을 구분하세요. DeepSeek V4 Flash 가격도 참고할 수 있습니다.
Tabbit에서 검증하는 방법
공개 글을 열고 출처가 있는 주장 다섯 개를 요청한 뒤 원문을 확인하세요. 모델, 날짜, 입력, 답변과 수정 내용을 기록하고 조건을 확인하기 전에는 개인 문서를 제공하지 마세요. 선택지는 계정마다 다릅니다. DeepSeek Harness 가이드에서 클라이언트의 역할을 확인하고 DeepSeek V4.1 Flash와는 같은 조건으로 비교하세요. 여러 모델 조사 정리도 참고할 수 있습니다.
 Tabbit Browser
다운로드만으로 모델이 실행되지는 않습니다. 먼저 선택기와 계정 조건을 확인하세요.
작업별 판단
| 작업 | 판단 | 이유 |
|---|---|---|
| 테스트가 있는 공개 코드 | 일회용 브랜치에서 시험 | 변경과 로직을 검토합니다. |
| 시각 프로토타입 | 스크린샷으로 시험 | 렌더링과 접근성을 확인합니다. |
| 민감한 데이터 | 조건 검증까지 대기 | 정책은 공급사에 달려 있습니다. |
| 로컬 배포가 필수 | 가중치와 라이선스 대기 | 링크가 출시 예정이었습니다. |
| 무인 프로덕션 에이전트 | 준비됐다고 가정하지 않기 | 두 번의 채팅은 장기 신뢰성을 증명하지 않습니다. |
실제로 사용할 클라이언트와 공급사에서 같은 검증 가능한 작업을 실행하고 버전, 설정, 재시도, 비용, 수정 내용을 기록하세요. 한 번의 결과는 신뢰도가 아닙니다.

자주 묻는 질문
LongCat 2.5를 써볼 만한가요?
코드나 시각 작업을 통제된 조건에서 시험할 만합니다. 작은 두 가지 테스트는 장시간 에이전트의 신뢰성을 증명하지 못하며, 한 답변은 원본 코드의 결과 두 가지를 잘못 설명했습니다.
2.5 Preview와 어떻게 다른가요?
LongCat은 Preview 이후 2026년 11월 1일 2.5를 발표했습니다. Preview 사용 후기는 11월 버전의 직접 테스트가 아닙니다.
모델 가중치를 받을 수 있나요?
11월 3일 공식 GitHub와 Hugging Face 링크에는 출시 예정이라고 표시되어 있었습니다. 자체 호스팅을 계획하기 전에 실제 파일과 라이선스를 확인하세요.
코딩에 적합한가요?
공급사는 Claude Code를 사용한 세 번의 평균으로 Terminal Bench v2.1에서 88.4를 보고했습니다. 자신의 환경에서 테스트를 실행하고 변경 사항을 검토하세요.
Tabbit에서 사용할 수 있나요?
2026년 11월 3일 Tabbit Browser Dev 테스트 계정에서 LongCat-2.5를 선택할 수 있었습니다. 사용 가능 여부와 조건은 계정과 에디션에 따라 다를 수 있습니다.
가격은 얼마인가요?
공식 페이지에는 100만 토큰당 캐시되지 않은 입력 2위안, 캐시 입력 0.04위안, 출력 8위안의 기간 한정 요금이 표시되었습니다. 가격은 변할 수 있으며 API 요금과 Tabbit 조건은 별개입니다.