
LongCat 2.5 值得在程式碼和視覺任務中做可控試用,但現有證據不足以證明它適合無人值守的生產任務。11 月正式版剛發布,早期 Preview 的回饋不能直接代表正式版。
官方評測中,LongCat 2.5 的 Terminal Bench v2.1 成績為 88.4,2.0 為 70.8。這說明廠商設定的測試條件下有提升,不代表你的專案成功率。我們在 Tabbit Browser 測試版中做了兩項小任務:算術表格正確,程式碼修復也通過指定用例,但對原始碼的兩處解釋有誤。
關鍵結論
官方稱模型總引數 1.6 萬億,每 token 啟用約 480 億,面向長程 Agent 和視覺任務。
官方基準分數取決於測試框架,不能當作獨立復現或實際專案的成功率。
Preview 使用者既報告過上下文處理較好,也遇到工具迴圈;版本和執行環境不同。
11 月 3 日官方 GitHub 與 Hugging Face 入口仍標註即將推出。
帳號可用性、資料條款和費用應分開核對,私有程式碼與寫入許可權尤其如此。
一覽:哪些資訊能用於決策
| 專案 | 2026-11-03 查核結果 | 不能據此推斷 |
|---|---|---|
| 模型 | 官方稱總引數 1.6T、活躍約 48B | 你的延遲或硬體費用 |
| Agent | 官方多個程式碼及檢索基準高於 2.0 | 獨立驗證的生產成功率 |
| 視覺 | 官方介紹了文本與視覺 token 聯合處理 | 任意截圖轉網頁都準確 |
| 權重 | 官方入口顯示即將推出 | 具體發布時間與許可 |
| Tabbit | 測試帳號選中 LongCat-2.5 並完成兩次對話 | 其他帳號的可用性與額度 |
上一代的部署與費用問題可參考 LongCat 2.0 總覽。Agent 瀏覽器介紹解釋了模型之外的客戶端與工具層。
先看兩項 Tabbit 實測
2026 年 11 月 3 日,我們在 Tabbit Browser Dev 測試帳號選擇 LongCat-2.5,事先寫好輸入和驗收標準。兩項任務均為同一對話中的單次文本測試,沒有授予寫入工具許可權;模型快照、服務商路由、推理檔位、token 和費用均未知。結果不能用於推算成功率、速度或其他帳號的可用性。
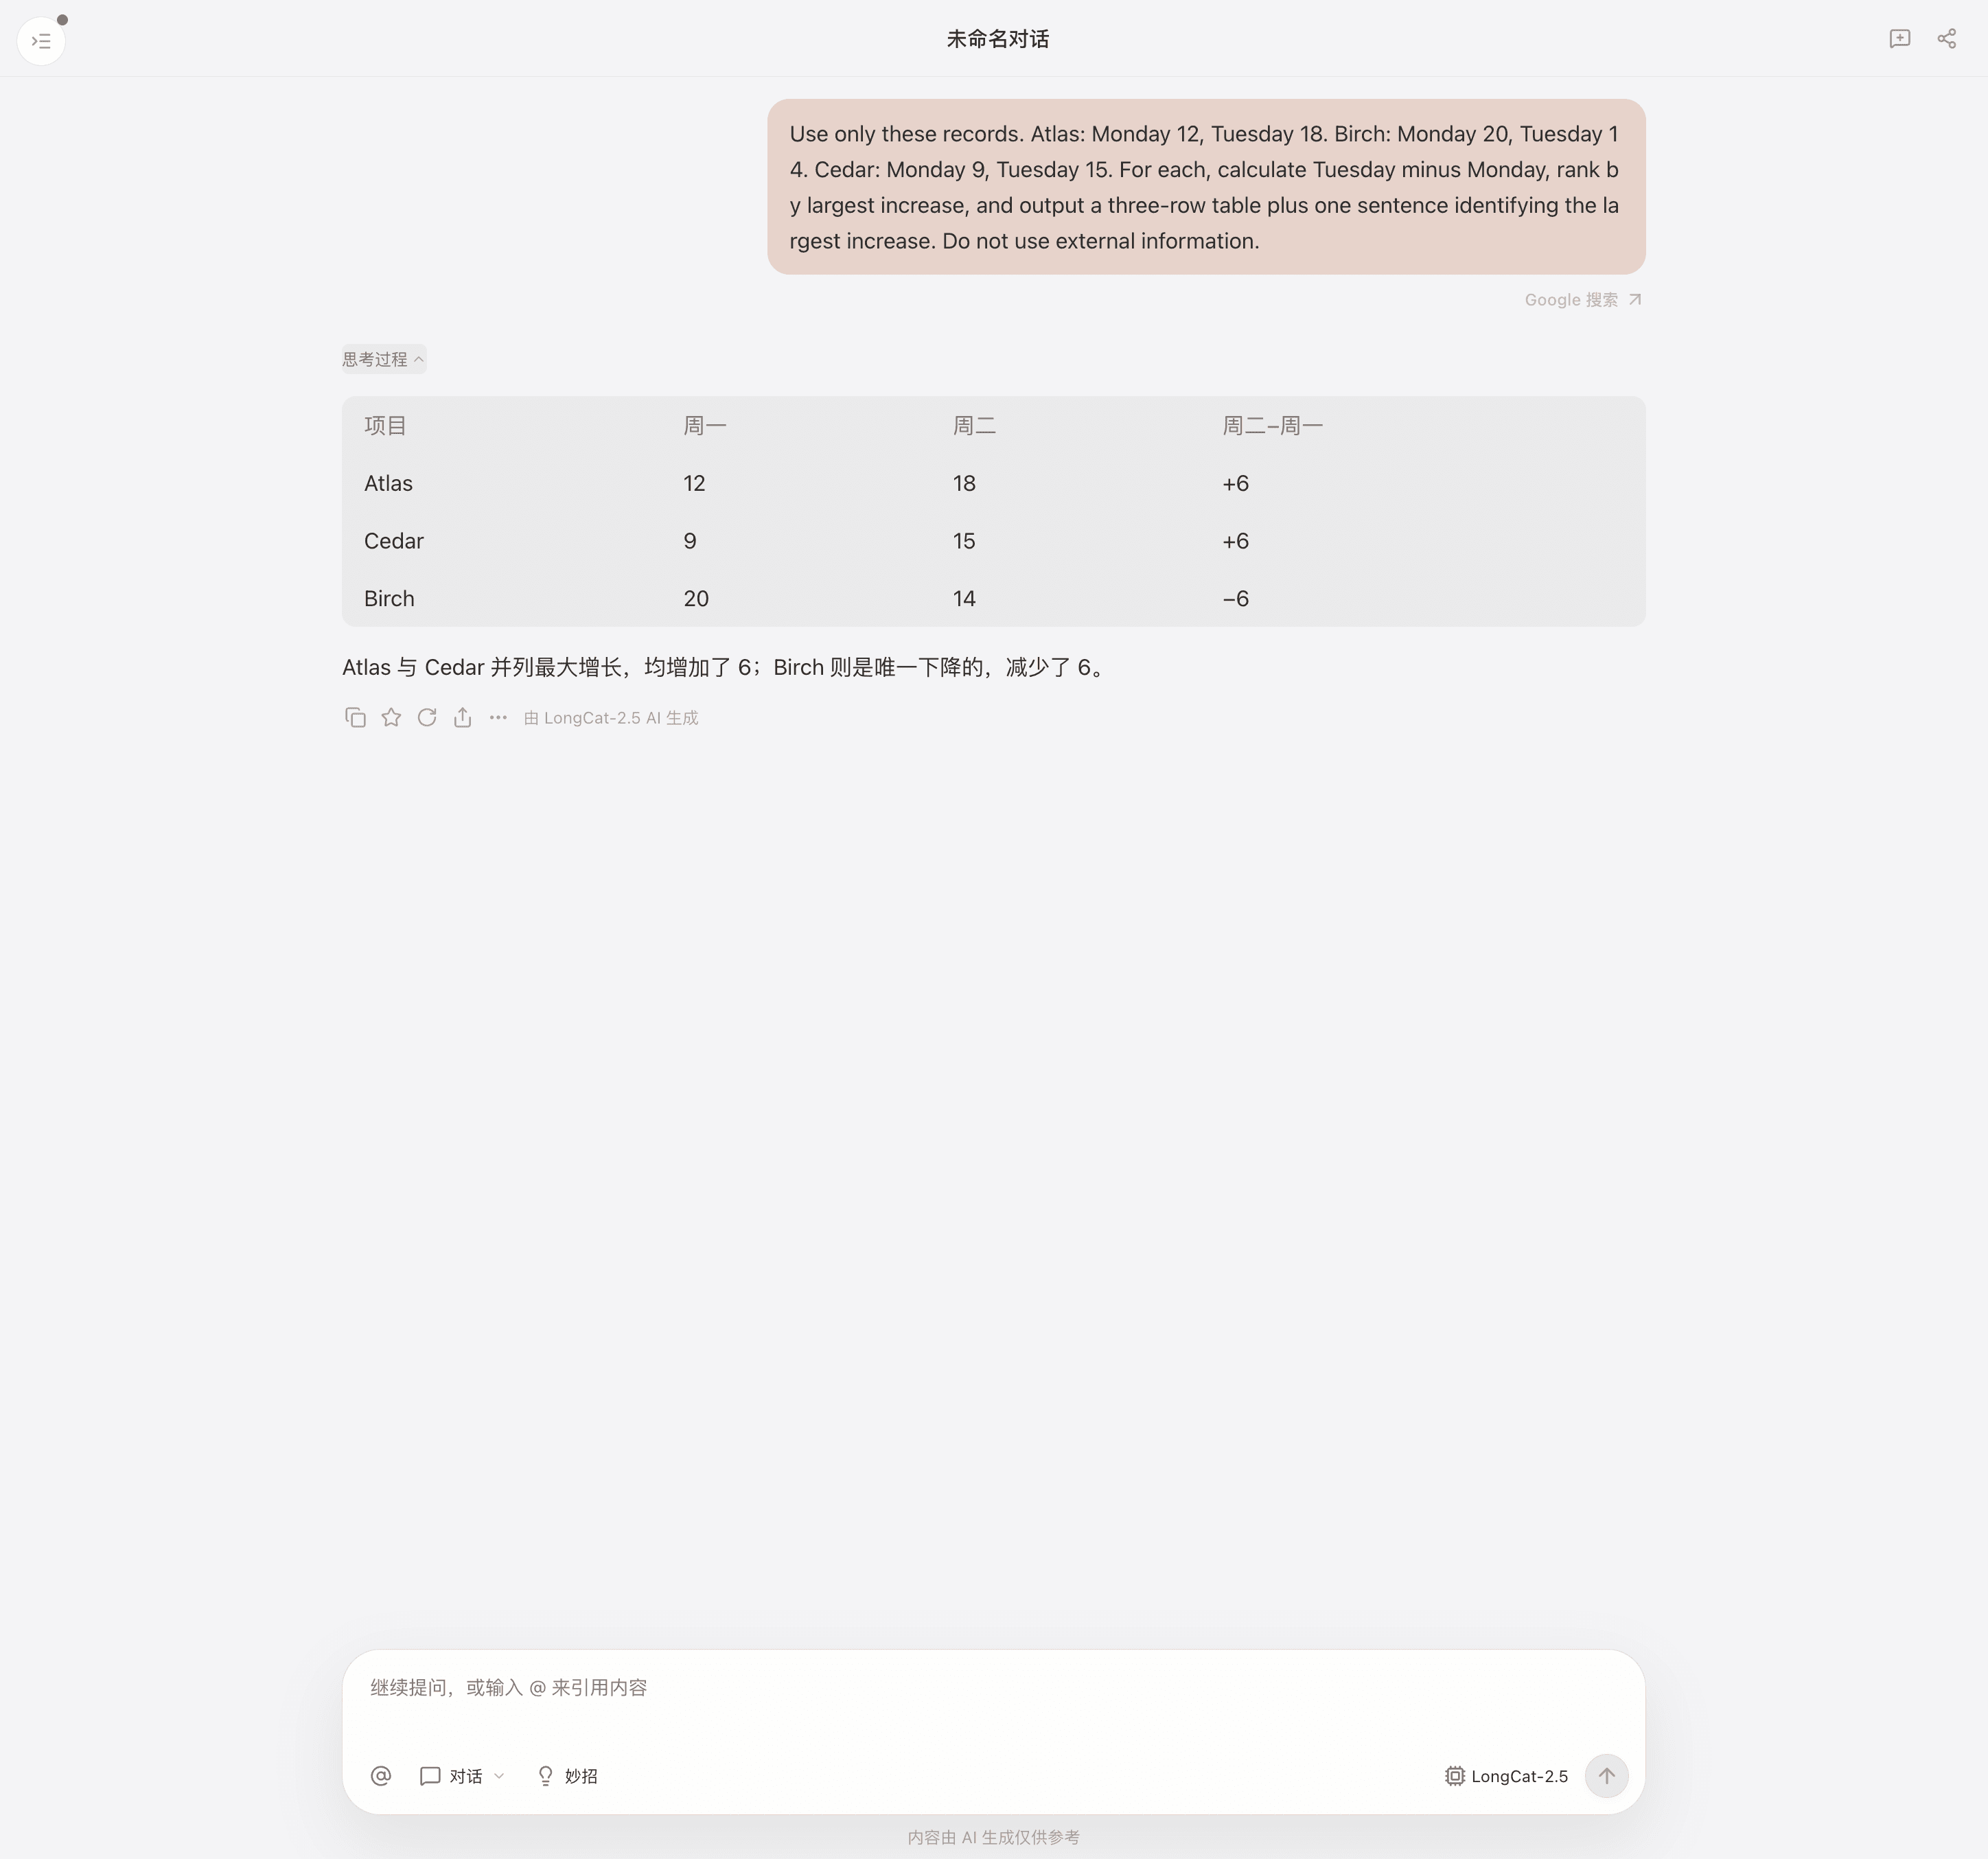
第一項使用三組合成數字。模型正確算出 +6、+6、−6,並指出前兩項並列。輸入是英文,輸出為中文;測試環境為中文,提示詞沒有指定回覆語言。
第二項要求檢查 JavaScript 求平均函式。模型給出的修復正確篩選非負有限數、處理空陣列;我們在本地執行後,五項指定用例得到預期結果。但它對原函式的兩處判斷錯誤:[NaN, 4] 實際返回 4,不是 NaN;[0] 實際丟擲 TypeError,也不是 NaN。回答給出了測試程式碼,但沒有證據表明模型自行執行了它。
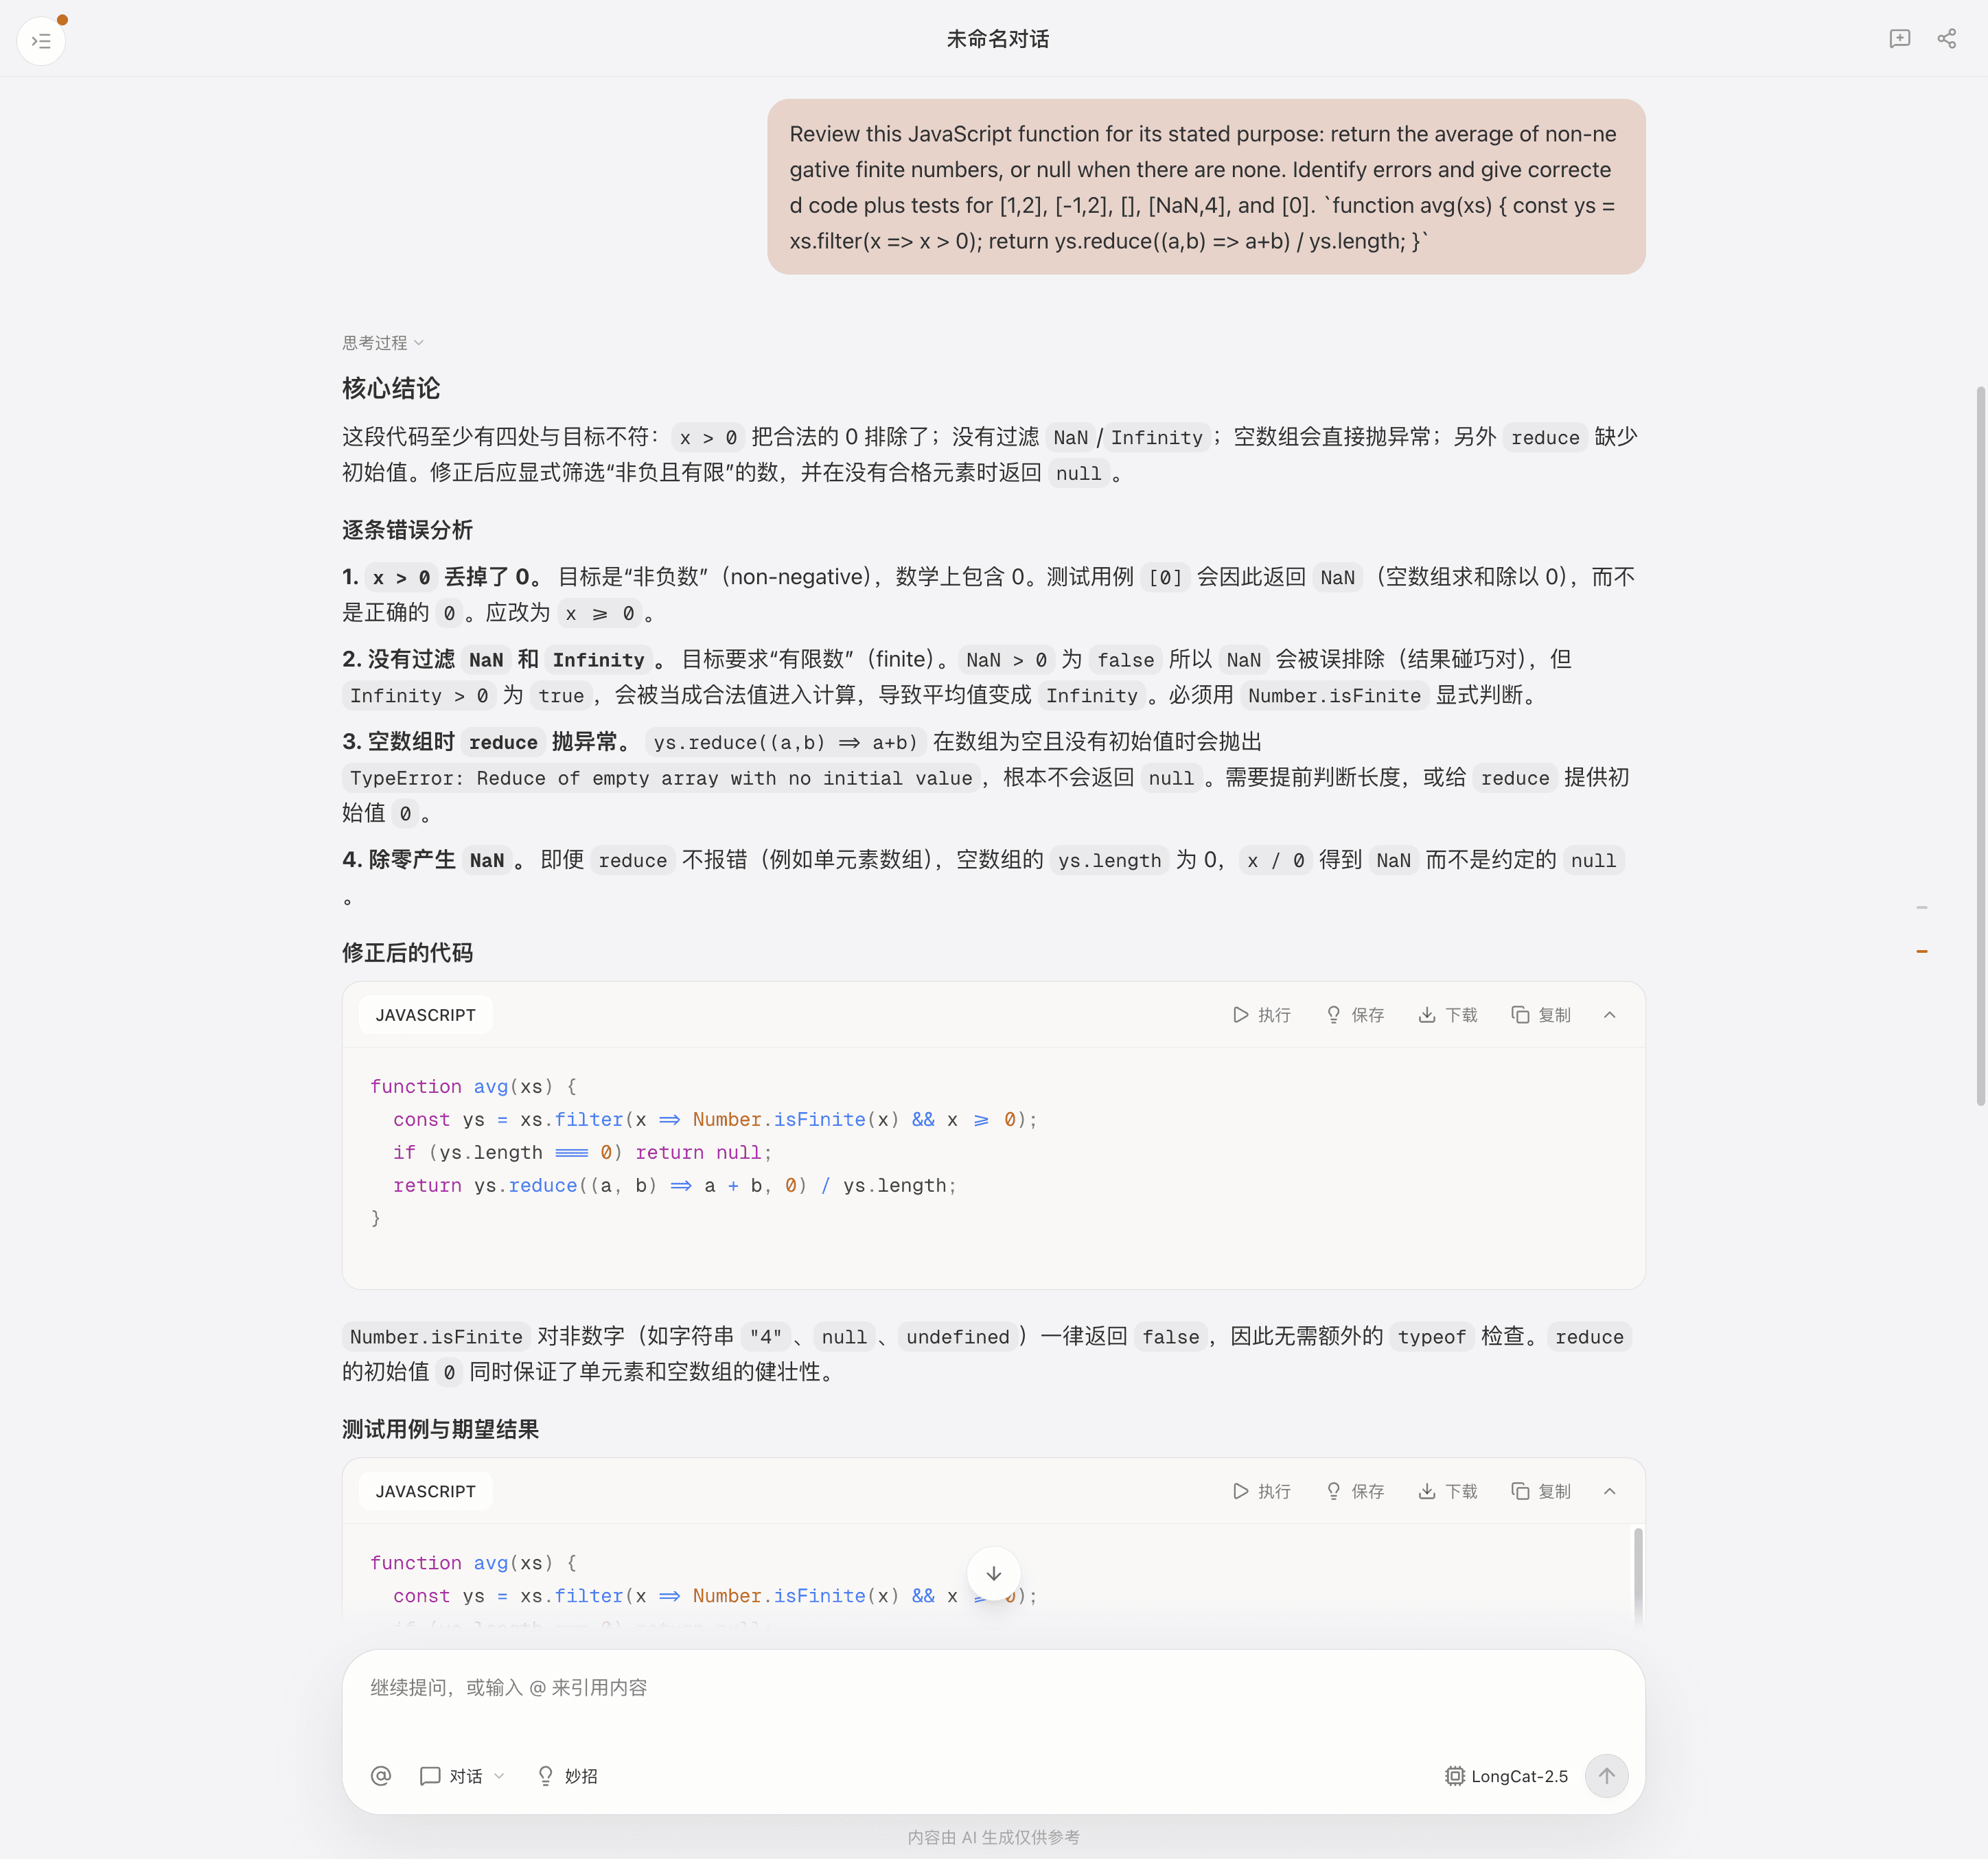
這兩項測試支援的結論很窄:可以讓模型起草修復,但仍要執行程式碼並檢查解釋;它們沒有測試自主修改儲存庫或長程瀏覽器任務。多模型調研組織方法可用於儲存相同任務的輸入和輸出。
社群怎麼說:區分 Preview 與正式版
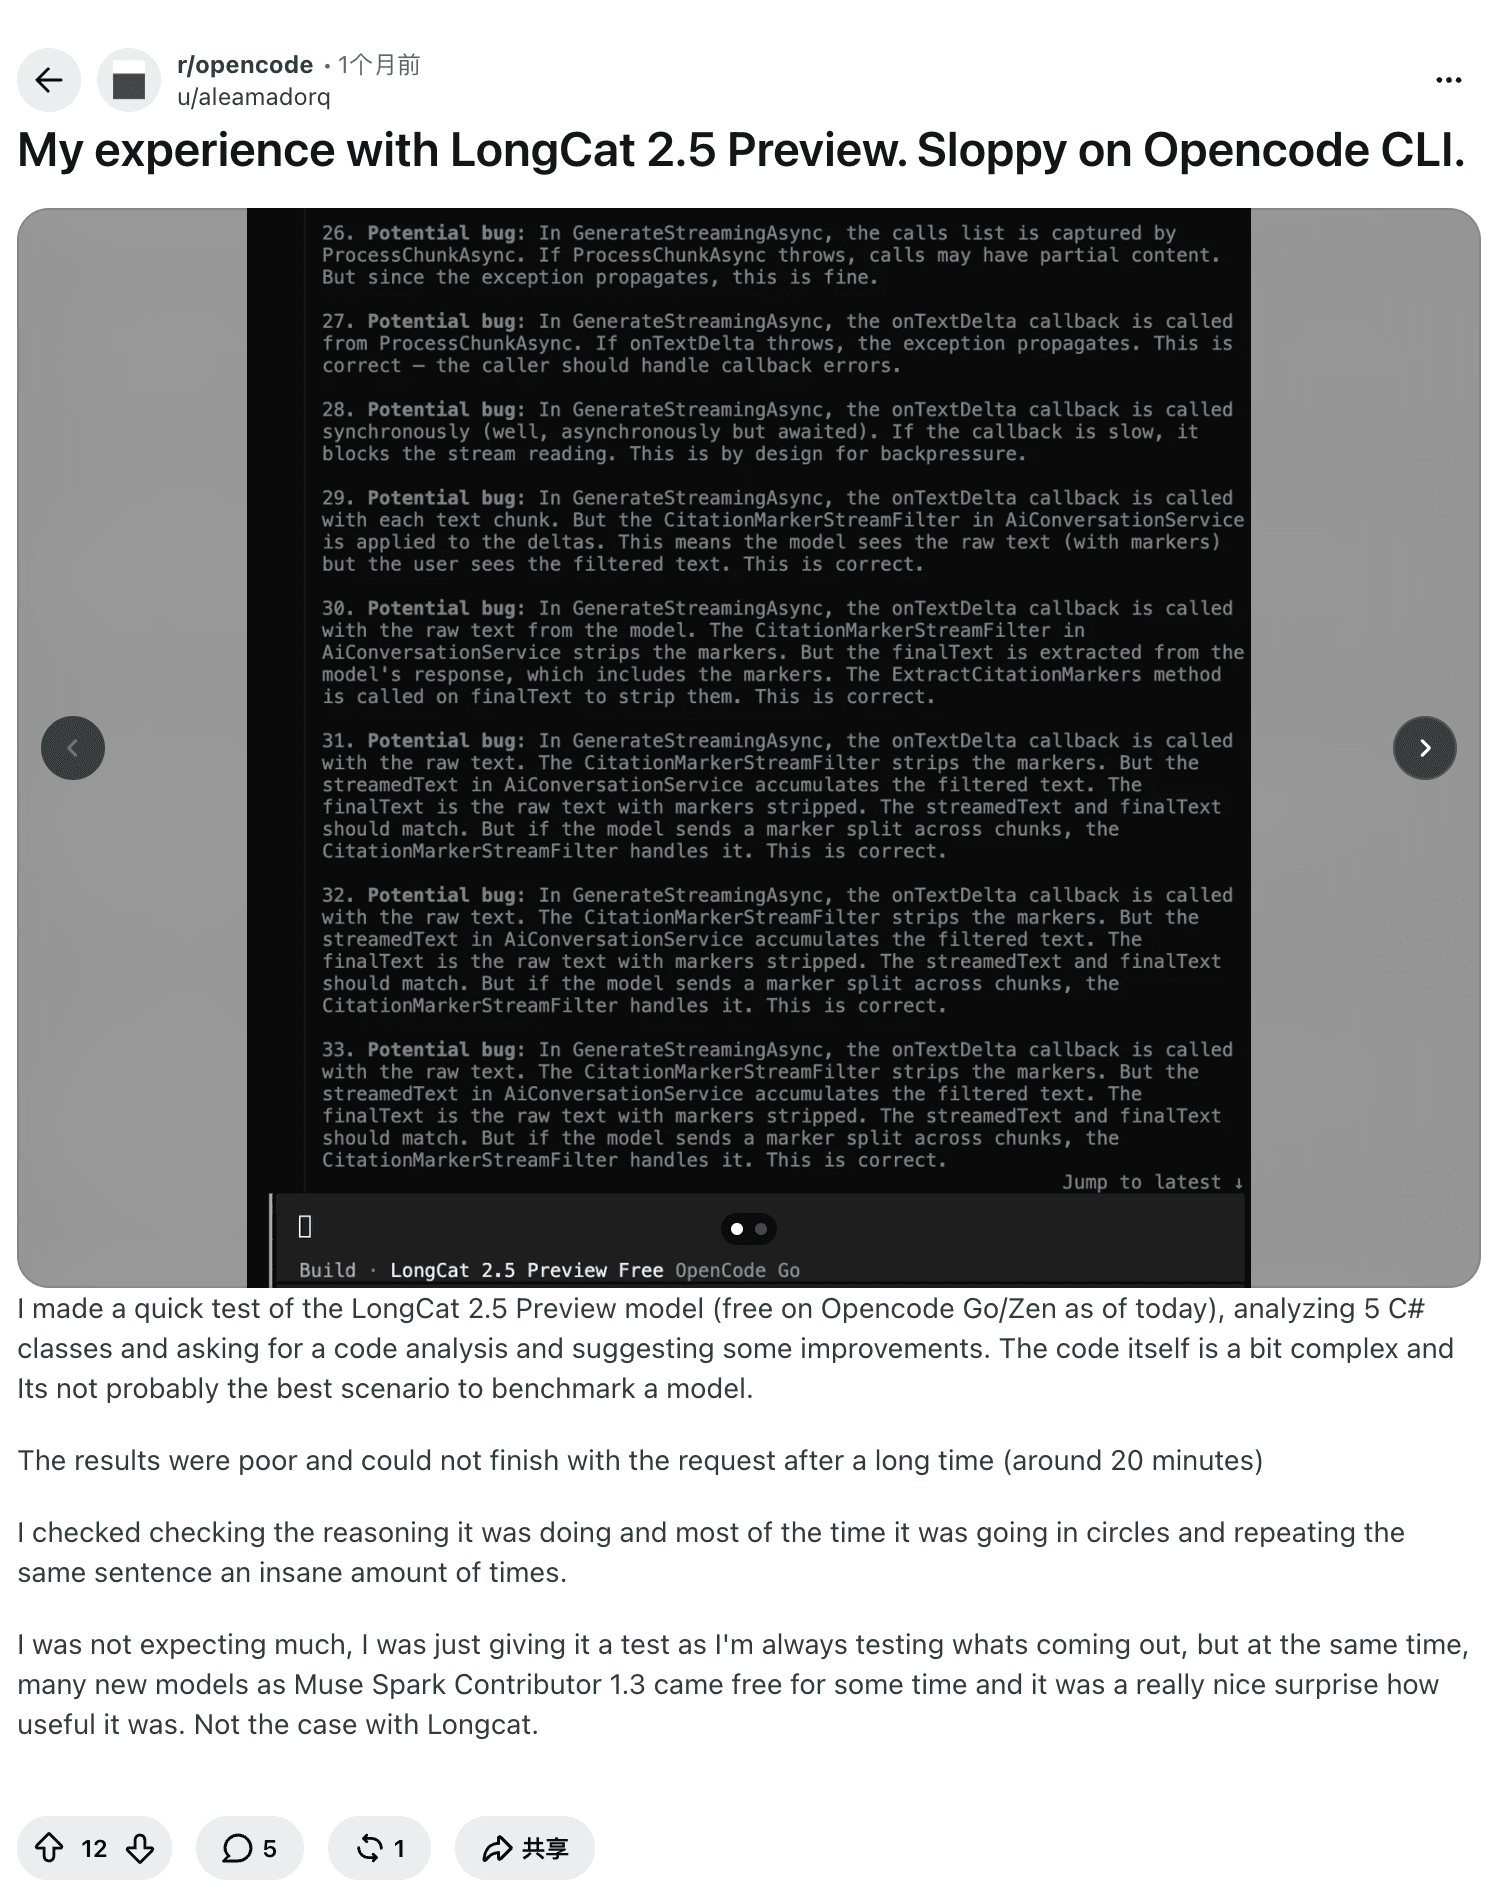
Reddit 作者用 OpenCode 的 Preview 分析五個 C# 類,稱約 20 分鐘仍未完成並反覆迴圈。原帖沒有完整輸入、服務端配置或重複測試,不能推斷正式版出現同樣問題。
另一位 Reddit 使用者報告對 Preview 的 Terminal Bench v2.1 測試:89 題各執行三次,pass@1 為 48.7%、pass@3 為 64.0%;其本機在一道任務上持續失敗。模型版本、環境和框架不等同於官方 88.4 的測試,不能直接比較。DEV 作者則更認可 Preview 在多個專案中的上下文和工具編排,但沒有完整提示詞和受控日誌。
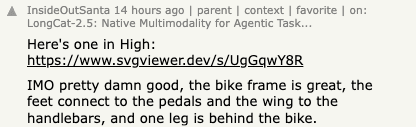
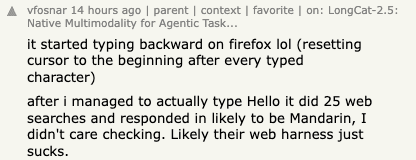
Hacker News 使用者在正式版討論中展示了一隻騎車鵜鶘並給予正面評價,評論未公開完整提示詞與客戶端設定。另一位使用者報告 Firefox 輸入問題及簡單問候觸發多次搜尋,並推測可能是網頁客戶端問題;無法分離模型與客戶端的影響。
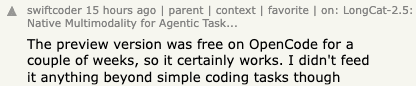
第三位 Hacker News 使用者稱 Preview 在 OpenCode 中完成了簡單程式碼任務,未提供任務細節,也未測試後來的正式版。
TOKRACE 的 11 月 2 日測評使用 Claude Code 呼叫正式版,記錄了 15 個創意任務:書架尺寸符合要求;行星減速器把 140 毫米做成 140 米,還缺少指定影片;季度圖表編造了年份、單位和來源。這是第三方在其設定下的結果,並非我們的 Tabbit 實測。
官方基準與口徑
| 官方報告的測試 | LongCat 2.5 | LongCat 2.0 | 任務 |
|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 終端 Agent |
| Terminal Bench v4.0 | 38.5 | 3.0 | 不同版本的終端測試 |
| BrowseComp | 91.9 | 79.9 | 搜尋和瀏覽研究 |
| AutomationBench public v1.0.6 | 51.8 | 15.8 | 600 道公開自動化題 |
| Vision2Web | 78.6 | 未報告 | 視覺轉網頁 |
來源:LongCat 發布頁,查核於 2026 年 11 月 3 日。除另有說明外,2.5 開啟 thinking,temperature 為 1、top-p 為 0.95。Terminal Bench v2.1 使用 Claude Code v2.1.280、512K 最大序列,三次執行取平均;BrowseComp 使用自研框架、兩種工具,最多 1,024 輪;Vision2Web 使用不同版本的 Claude Code 和 256K 序列。
競品帶星號的成績取自公開報告,其餘由廠商自測並標為僅供參考。測試版本、任務和框架不同;v2.1 應與 v2.1 比較,不能與 v4.0 分數混比。表格沒有給出完整的耗時、成本和真實專案結果分佈。
三個值得試用的方向
多步驟程式碼任務
官方描述了長軌跡、合成任務和 Agent 失敗軌跡訓練,並報告終端基準有所提升。有測試套件的團隊可以在一次性分支上試一個有明確驗收標準的問題,但仍須檢查無關程式碼是否被改動。
檢索與研究
BrowseComp 使用明確的搜尋與瀏覽框架,適合用作試驗線索。真實瀏覽器工作可能涉及登入、動態頁面與額外許可權,未必包含在該評測中。先用公開資料並逐條核驗引用;瀏覽器自動化指南介紹的是工作流,不是模型質量證明。
視覺輸入
官方稱模型以離散 token 處理視覺訊號,並報告 Vision2Web 結果。可以試著讓它根據截圖修改頁面,但仍要檢查畫素、可訪問性和程式碼能否執行,不能把基準分數當作這些結果的保證。
三個限制
工具框架會改變結果
Agent 可能選錯工具、重複命令或修改範圍外檔案。Preview 的案例只能提示應檢查這些失敗方式,不能估計正式版的發生機率。設定時間或工具呼叫上限,逐項檢查變更;也可參考 Tabbit 使用實踐。
2.5 權重尚待確認
查核時,官方發布頁仍將 GitHub 和 Hugging Face 標為即將推出。2.0 的開放權重不能證明 2.5 已可下載或使用相同許可;自託管前應確認實際檔案和條款。
價格與資料處理分別核對
LongCat 官方價格頁在 11 月 3 日顯示限時價格:每百萬 token 未快取輸入 2 元、快取輸入 0.04 元、輸出 8 元。價格和幣種展示可能變化,以平臺帳單為準。資料保留、訓練和駐留條款尚未完整核實;API 計費、訂閱和 Tabbit 帳號條款是不同問題。DeepSeek V4 Flash 價格指南可作為另一種計費結構的參考。
在 Tabbit 中試一個可複核的任務
上述兩項只測試了文本對話。下一步可開啟公開技術文章,要求列出五條帶來源的事實,再逐條核對原文;記錄模型名、日期、輸入、輸出和人工修正。在確認帳號與服務商條款前,不要提供私有文件或寫入許可權。
我們的測試帳號中有 LongCat-2.5,其他帳號可能不同。DeepSeek Harness 指南說明客戶端與工具會怎樣影響流程;如需比較 DeepSeek V4.1 Flash,應使用相同任務和條件。
 Tabbit Browser
下載不會自動執行模型,請先檢查模型選擇器和帳號條款。
按工作負載給結論
| 工作負載 | 建議 | 原因 |
|---|---|---|
| 有測試套件、可複核的公開程式碼任務 | 在一次性分支試用 | 官方成績值得試,但需檢查改動與邏輯。 |
| 根據截圖製作網頁原型 | 用小任務試用 | 視覺能力相關,需檢查渲染與可訪問性。 |
| 敏感儲存庫或受監管文件 | 等待資料條款確認 | 保留與訪問規則取決於實際服務商及客戶端。 |
| 必須本地部署 | 等待權重和許可 | 查核時官方入口仍顯示即將推出。 |
| 無人值守生產 Agent | 不要假定已經可用 | 兩項簡單對話無法證明長任務可靠性。 |
下一步是在實際使用的客戶端和服務商中運行同一個可檢查的小任務,並記錄版本、設定、重試、費用和人工修正。一次成功只是一個例子,不是可靠性估計。

常見問題
LongCat 2.5 值得用嗎?
它值得用於可控的程式碼或視覺任務試用,但上線前應以自己的任務驗證。兩項 Tabbit 對話測試中,一項計算正確,另一項給出的程式碼修復可用,但對原始碼結果的兩處解釋有誤。
LongCat 2.5 和 2.5 Preview 有什麼區別?
LongCat 在 2026 年 11 月 1 日發布了 2.5,此前還有 Preview 版本。明確針對 Preview 的回饋不能直接視為對 11 月版本的測試。
LongCat 2.5 開源了嗎?
2026 年 11 月 3 日查核時,官方發布頁的 GitHub 和 Hugging Face 入口仍標註即將推出。自行部署前應重新確認權重是否發布及其許可。
LongCat 2.5 適合程式開發嗎?
官方使用 Claude Code 對 Terminal Bench v2.1 的三次執行取平均,報告 88.4 分。這個廠商成績不能保證你的儲存庫、客戶端和服務商有相同表現,應先用小任務和測試驗證。
Tabbit 能使用 LongCat 2.5 嗎?
2026 年 11 月 3 日的 Tabbit Browser Dev 測試帳號中可以選擇 LongCat-2.5,我們用它完成了兩項對話任務。不同帳號和版本的可用性、額度與條款可能不同,請以實際選擇器為準。
LongCat 2.5 多少錢?
2026 年 11 月 3 日官方價格頁顯示限時優惠:每百萬 token 未快取輸入 2 元、快取輸入 0.04 元、輸出 8 元。價格可能變化,API 帳單與 Tabbit 帳號條款應分別確認。