
整理 ChatGPT、Claude 和 Gemini 的研究资料,先在聊天之外维护一份统一简报,再用逐条主张的来源表汇总结果。三份原始报告分别保存,重要结论回到原始网页核实后,才写最终建议。
一则关于长期学术研究的 Reddit 讨论提到了实际需求:换工具之后,项目仍要能继续。评论者建议把论文 PDF、笔记和已验证结果保存在聊天之外。这比期待不同网站自动共享记忆可靠。
Tabbit Browser 可以在两个环节提供帮助:内置多模型回复用于比较答案,Agent Mode 用于协调浏览器里的网页任务。下面分别说明操作方式和限制,不把两者混成一种能力。
核心要点
简报、来源台账和最终决策保存在聊天之外。
对照实验使用同一问题和相同输入;分工研究要明确记录各自职责。
Tabbit 内置模型访问权不会自动带来三家网站的研究权限。
Agent 打开网页后,仍要逐站检查登录、额度、研究计划和完成状态。
模型一致不等于独立验证,应检查底层来源。
研究组织方式一览
| 方式 | 比较对象 | 所需权限 | 保存内容 |
|---|---|---|---|
| Tabbit 多模型回复 | 当前选中的内置模型答案 | 对应 Tabbit 计划与可用模型 | 提示词版本、模型名称、各份回复 |
| 三家网站原生研究 | 各网站研究功能生成的报告 | 各自账号、功能与额度 | 对话链接、模式、报告、来源 |
| 主研究工具加审阅工具 | 一份带来源报告及其审阅意见 | 所选工具的访问权 | 证据与审阅分开存放 |
| 手动网页研究 | 原始网页和自己的分析 | 网页访问权限 | 来源表及带日期笔记 |
在 Tabbit 里看到 GPT 系列模型回复,不能据此认定运行了 ChatGPT Deep Research。Claude 和 Gemini 同理。深度研究使用场景解释了多步研究与普通对话的区别。
1. 先写一份研究简报
把问题缩小到一个决策,例如“为五人设计团队比较三款工具的导出格式和访客权限”。写明地区、截止日期、排除项、交付格式和来源要求。示例不是实际产品对比,使用前替换占位名称。
Research brief v1
Decision: Which of Tools A, B, and C fits a five-person design team?
Region: Singapore. Evidence cutoff: 2026-10-29.
Criteria: guest permissions, usable export formats, account requirements.
Prioritize official help pages and current documentation.
For each important claim, give the original URL, visible date,
and supporting passage. Separate facts, interpretation, and unknowns.
Deliver a comparison table, unresolved questions, and a recommendation.
Do not purchase, start trials, or contact vendors.
为简报、文件和对话采用同一项目编号,例如 design-tools / 2026-10-29 / brief-v1。某个工具读不到文件时,向所有工具提供相同的可访问摘录,或明确记录输入差异。不要把完整报告与只读到标题的结果当作公平比较。
浏览器配置、工作区与标签组各有作用。标签组能收纳研究网页,却不会合并网站账号和对话记忆。
2. 决定独立比较还是分工
如果要比较三家结果,先给每家相同简报,避免把第一份报告的结论提前透露给另外两家。否则测试的是追随或批评已有答案的能力。
如果目标只是完成研究,可以由一个工具收集证据,另一个审阅推理。比较三家研究工具的讨论中,用户 Jackson_Rob 提到先向 ChatGPT 和 Gemini 提问,再让 Claude 检查缺口。这是个人流程偏好,不能据此宣布固定的模型排名。
按任务和实际访问权限分配角色。能读取获准文档库的工具,与只能读公开网页的工具,证据范围不同。多模型回复适合问题拆解、解释对照和来源清单初稿;需要网站原生搜索、研究计划及报告时,再选择对应研究功能。Agent 推理与深度研究提供了相关背景。
3. 逐站检查原生研究权限
由账号持有人完成登录,提交前确认研究模式与剩余额度。Tabbit 会员与三家网站订阅独立。
OpenAI 文档列出了工具菜单与 /Deepresearch 入口,以及研究计划审阅、进度和带来源报告。额度以产品内计数器为准,不沿用旧文章中的固定数字。
Claude 官方文档要求付费计划且开启网页搜索,网页入口为 + 菜单中的 Research。运行前检查已启用的连接器,避免三份报告实际使用了不同私有来源。未启用 Research 的普通回复应如实标注。
Gemini 官方指南介绍了 Deep Research 原生流程,包括登录和年龄要求。打开主页本身不能证明有资格使用。功能与额度说明指出可用性与限制会变化。功能不可用时记录阻塞,不用普通回答冒充研究报告。
本文没有完成三个账号界面和三站研究的端到端验证。以下调度流程是根据官方资料提出的模板,不保证无人值守完成。
4. 为每次运行登记状态
记录服务商、界面显示的模型、研究模式、简报版本、对话网址、开始时间和状态。状态可统一为“未启动、需人工处理、运行中、完成、失败”。打开标签页或出现开场文字,都不足以标记完成。
原始报告保持不变,追问单独登记为修订。使用网站实际提供的导出格式,或把相关文字与对话链接存入自己的笔记。私有对话链接未必对同事可见,也不要假设三家都支持同一种导出方式。
小项目用一份 Markdown 和附件文件夹即可。历史记录与收藏检索能帮助找回来源,但不能替代研究档案。
5. 按主张建立来源台账
每行记录主张编号、原始 URL、发布者、可见日期、核查日期、支持段落和核验状态。多份报告引用同一文件时,复用同一来源编号。
例如两个报告说访客可以导出,另一个说仅管理员可以导出。先检查它们是否指同一套餐、角色和格式,避免把条件差异当成事实冲突。
C-01 | Guest can export project data
ChatGPT: yes, S-01
Claude: administrator only, S-02
Gemini: unclear, S-01
Check the plan, role, and export format before deciding.
Status: unresolved
这是记录方式示例,不是产品结论。只有打开原始来源后,才标记“已核实、被反证、未解决”。三个模型引用一个页面,底层仍然只有一个来源。
Andrej Karpathy 在 LLM Council 的 X 原帖中讨论了多模型互评,也对排名是否符合自己的判断提出疑问。它说明人工复核的必要性,不是本工作流的性能测试。标签太多时,可结合浏览器标签管理方法整理核查队列。
在 Tabbit 中落实这套流程
当简报、报告和来源都在浏览器里,Tabbit 的价值是减少重复操作并保留可见的比较结果。研究人员页面介绍了更广泛的场景。
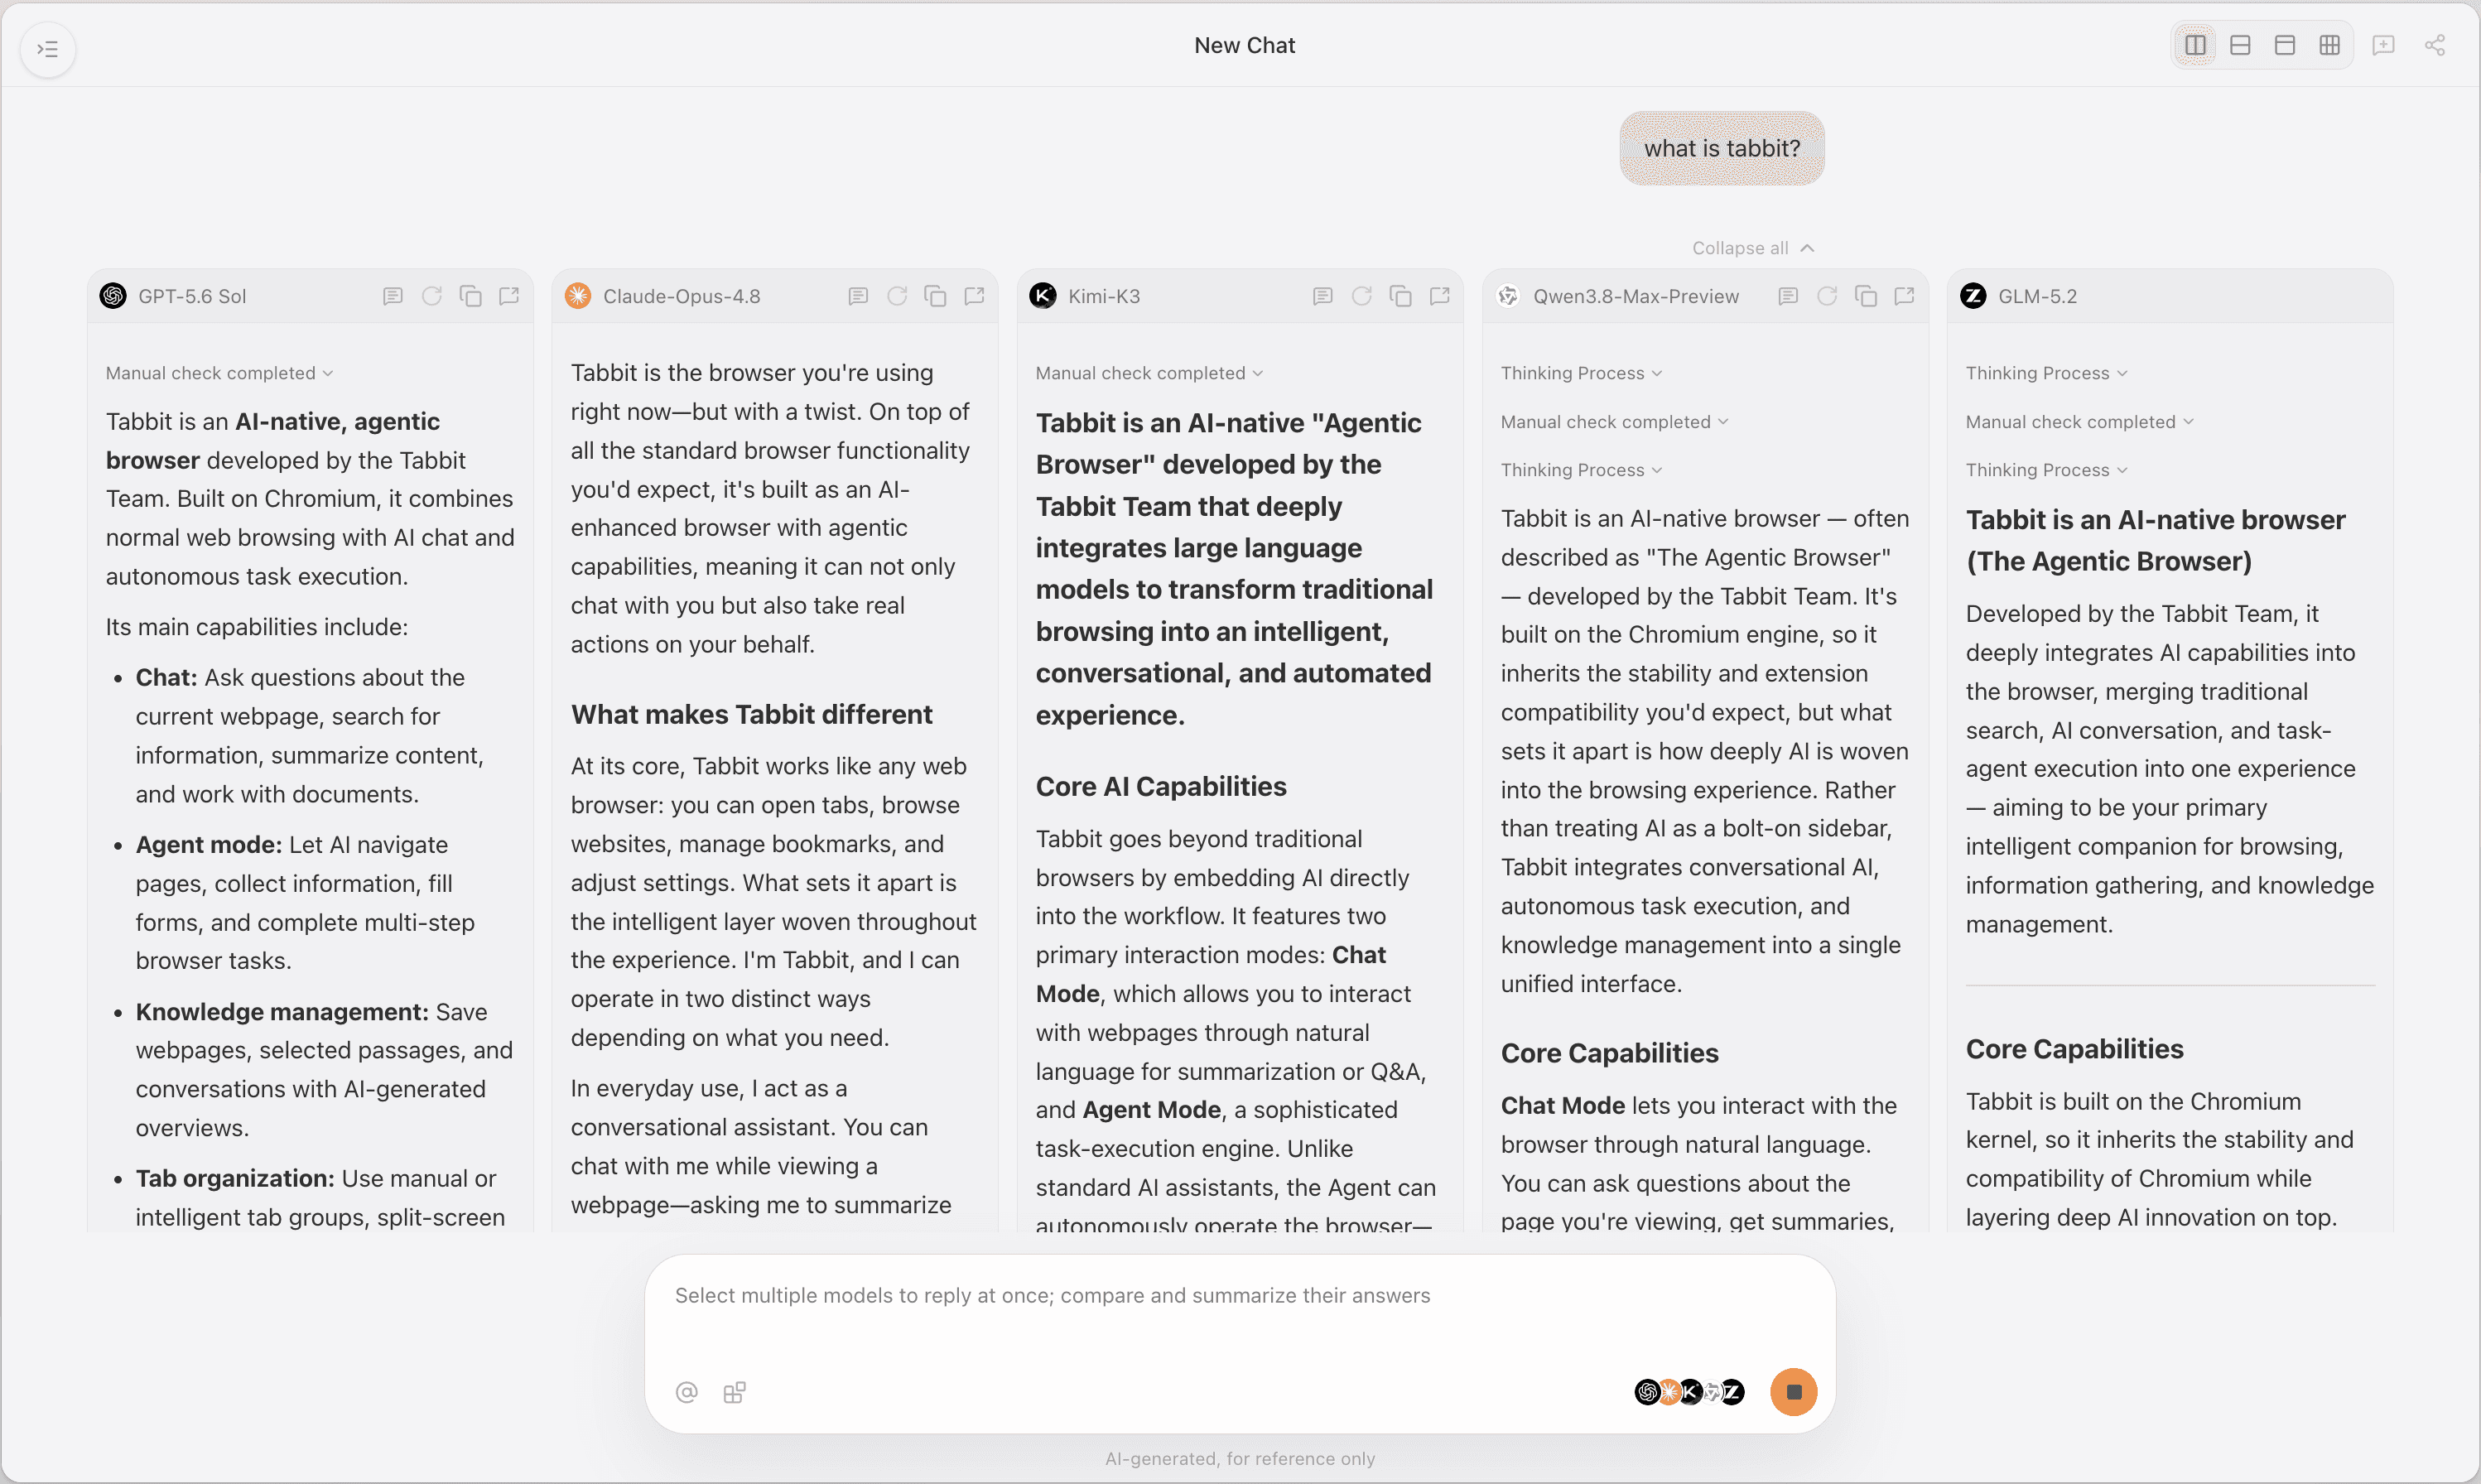
快速对照时,打开模型选择器,在当前套餐允许的情况下多选模型,提交同一简报,按模型标签比较回复。国际会员页将同时多模型回复列在标准版权益中,设为默认浏览器可解锁;国内会员页也列有该能力。具体模型与套餐按当前版本检查,不承诺固定组合。
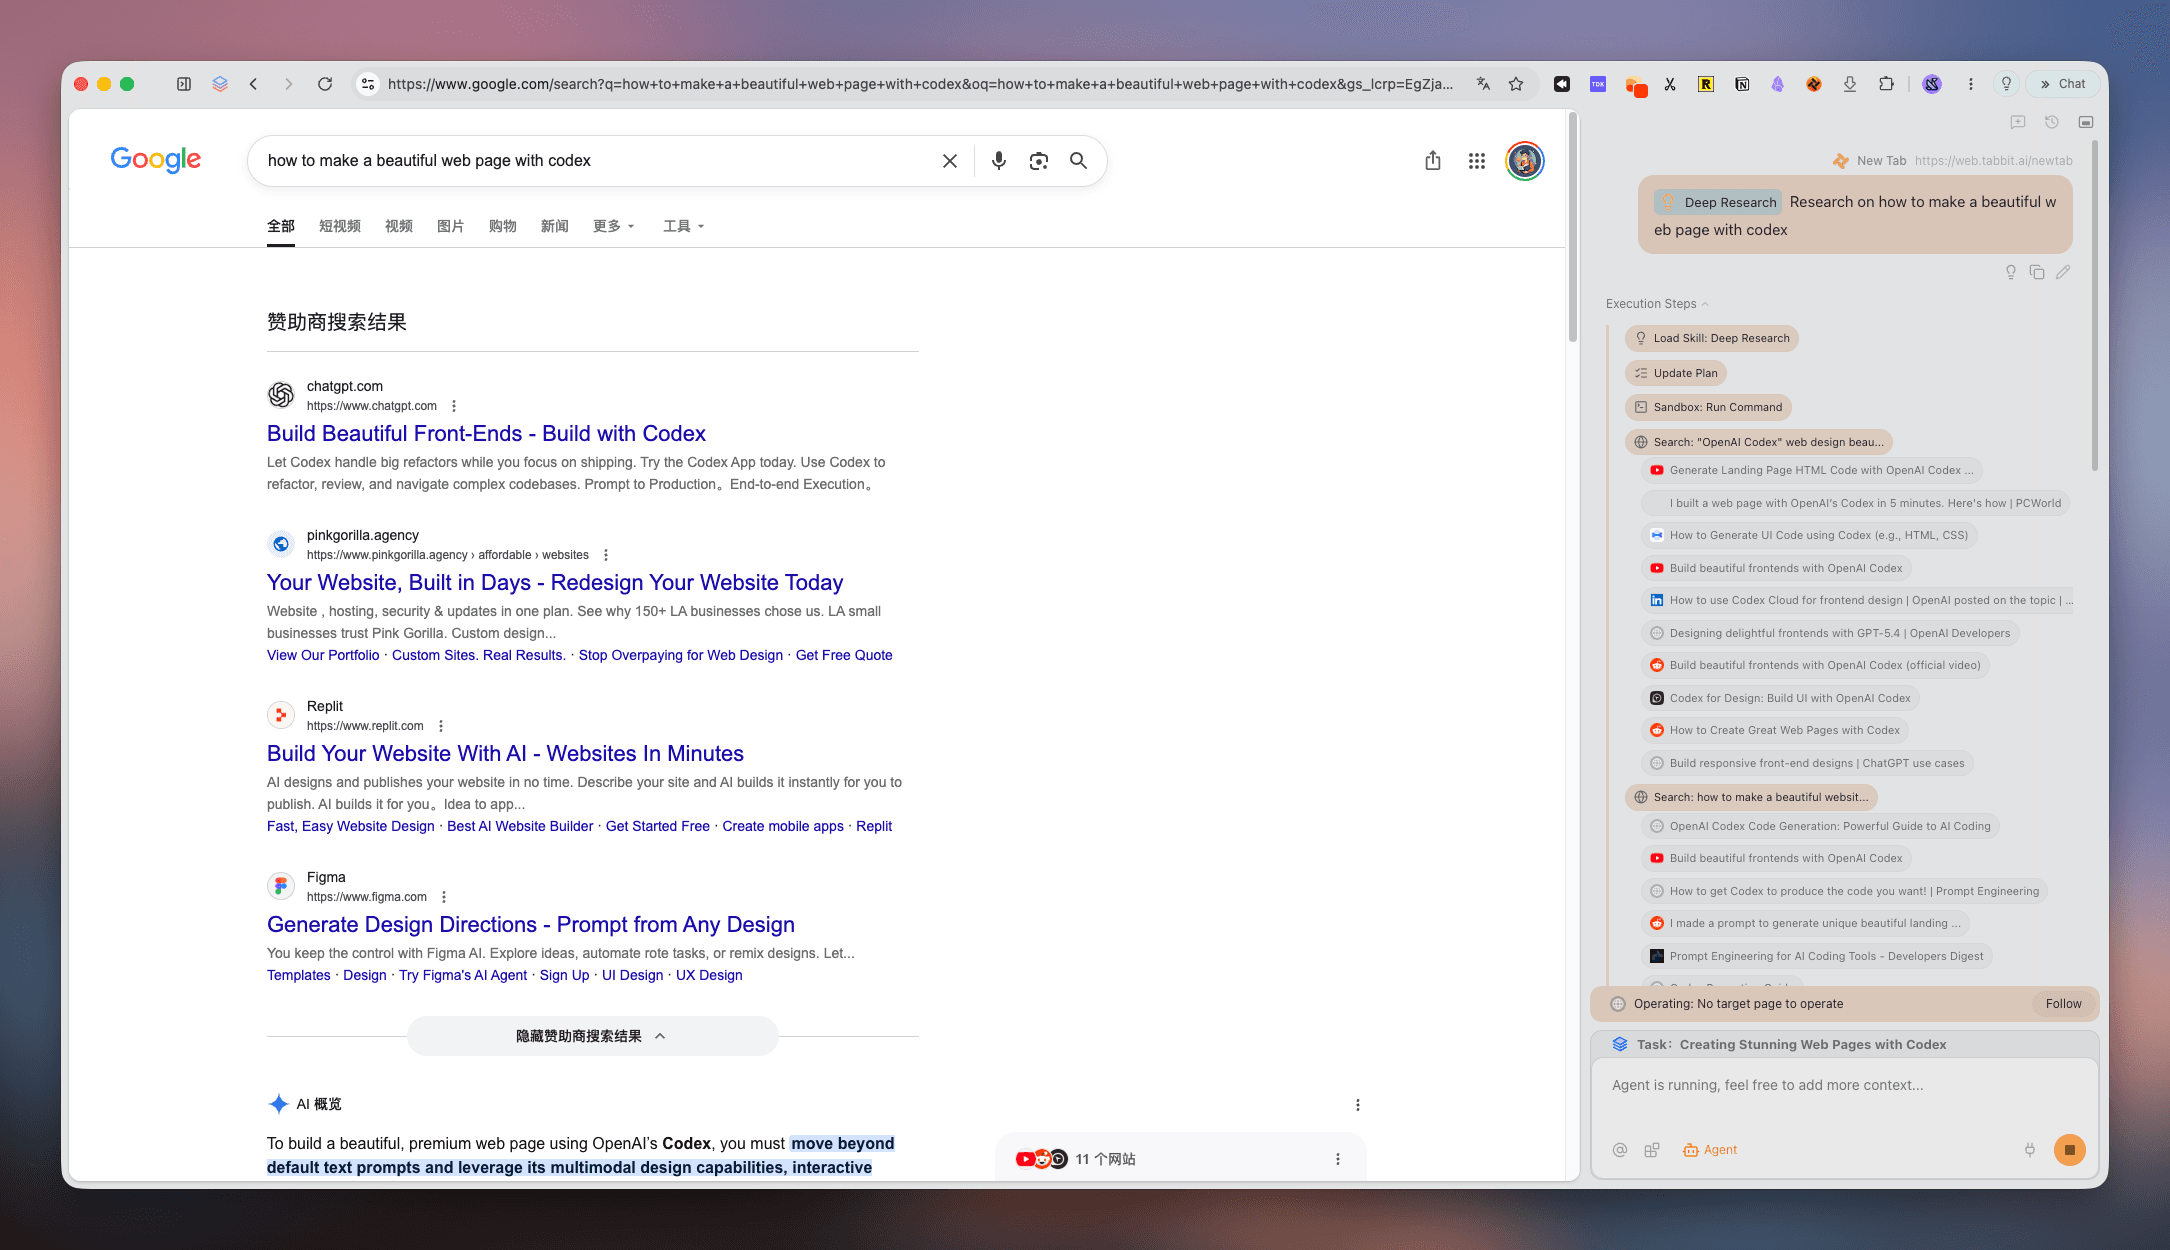
需要网站原生研究时,切换到 Agent Mode,明确要求打开三个网站,先检查登录和研究权限,再按统一简报操作。网站研究可能在服务端持续运行,但 Agent 的网页操作可能依次执行;同时打开不等于同步启动或完成。可先了解浏览器自动化的范围。
Open https://chatgpt.com/, https://claude.ai/, and https://gemini.google.com/
in separate tabs for this research task.
Report each site's login state, research mode, and visible quota first.
Stop on login, CAPTCHA, payment, permission, or quota blocks.
Do not buy subscriptions or change settings.
Where access permits, select the native research mode and use brief v1.
Show me proposed plans and scope changes before starting research.
After I approve the plans, start eligible jobs and record conversation URLs.
Track completion separately. Collect original reports and source URLs.
Do not merge reports, share private files, or publish results.
这是拟定的调度提示词,不是三站实测教程。无法可靠操作的控件由你手动处理后再继续。Tabbit 支持 @ 引用网页或文件,但发送前要检查附加的上下文;打开网页本身不会同步三家聊天历史。Tabbit 产品说明介绍了其基本能力。
6. 综合报告时保留未解决问题
向负责综合的工具提供来源台账和原始报告,要求逐条链接来源,区分事实、解释与未知。不让它凭记忆补齐缺口,也不把模型一致当成独立证据。
Using brief v1, the source register, and the original reports,
write a decision memo. Cite source IDs beside important claims.
Separate verified facts, interpretation, and unresolved questions.
Preserve conflicts about dates, plans, roles, regions, and definitions.
Do not treat model agreement as independent verification.
If evidence is insufficient, state what must be checked next.分享前重新打开决定结论的来源,确认报告保留了其适用条件。第二个模型能帮助找遗漏,但不能代替原文核查。浏览器研究组织可作为补充阅读。
选择足够用的最小流程
| 情况 | 先用什么 | 何时增加工具 |
|---|---|---|
| 简单事实查询 | 一次搜索与原始来源 | 证据冲突或范围扩大 |
| 梳理陌生主题 | 可用的 Tabbit 多模型回复 | 需要多步来源研究 |
| 重要比较决策 | 一份原生研究报告加核验 | 审阅能发现关键假设 |
| 比较三家研究结果 | 同简报的三站运行 | 权限齐全且值得投入 |
| 登录或额度阻塞 | 记录失败并使用可访问证据 | 账号持有人解决后 |
小问题不必生成三份长报告。先获得一个有来源的答案,再按决策需要增加审阅。最终应保存可复核的来源台账和决策说明;重复网页操作多时,先尝试一个有边界的 Tabbit Agent 任务,逐项确认状态后再扩大范围。

常见问题
Tabbit 能同时运行 ChatGPT、Claude 和 Gemini 的深度研究吗?
Agent Mode 可以协助组织网页任务,但每个网站都需要独立账号、研究功能权限和可用额度。打开三个标签页不代表三个研究任务已经启动。本文未完成三站深度研究的端到端实测。
Tabbit 多模型回复等于使用三家官网吗?
不等于。内置回复调用 Tabbit 当前可用的模型,不会自动获得三家网站的研究工具、订阅权益、历史对话或连接器。
怎样保持不同 AI 工具的研究上下文一致?
在聊天之外维护有版本号的研究简报。向每个工具提供相同范围、日期、来源要求和输入文件,并记录后续变更。
哪些研究功能需要付费账号?
Claude Research 当前需要付费 Claude 计划并开启网页搜索。ChatGPT 和 Gemini 的可用性与额度取决于账号和计划;Tabbit 另有分地区的会员权益。
三个模型结论一致,就能确认事实吗?
不能。它们可能引用同一页面、重复同一错误,或使用不同定义。需要打开原始来源,核实它是否直接支持该说法。
研究结束后应保存什么?
保存简报版本、服务商与模式、对话链接、原始报告、来源网址及已核实结论。保留未解决的分歧和访问失败记录,方便后续继续。