
Grok 4.7 是 xAI 在 2026 年 9 月 21 日發布的編碼與知識工作模型。真正要回答的不是發布圖上有沒有一列領先,而是算上它實際寫出的 token 之後,還值不值得離開 Grok 4.6。
Hacker News 上的 dumberquestions 把這個陷阱寫成一句:標價說明不了 token 效率。這就是這篇評測。上一代寫在 Grok 4.6 文章 裡。本站還沒有定價文和替代品文。下面沒有任何一條是在 Tabbit Browser 裡做的受控測試。
決定這篇評測的一個數字
2026 年 9 月 22 日打開原文時,有兩個數字朝相反方向走。
發布頁 給 Grok 4.7 xHigh 的標價是每百萬 token 輸入 2 美元、輸出 6 美元,和 Grok 4.6 High 同一格。API 文件 對 grok-4.7 重複了 2.00 美元和 6.00 美元。
Artificial Analysis 在 xhigh 檔測得,Grok 4.7 每道智慧指數題大約寫出 8.1 萬輸出 token。Grok 4.6 的 xhigh 大約是 3.8 萬。同一篇文章裡,Grok 4.6 high 接近 3.6 萬,GPT-6 Astra max 接近 2.7 萬。標價沒動,寫出來的量動了。
指數只從 Grok 4.6 high 的 44 走到 Grok 4.7 xhigh 的 46。編碼代理指數在 Grok Build 裡走得更多:56 對 47。如果任務只是短回答,你是在為沒有點名的思考付費。如果上一個模型在儲存庫中途停住,多出來的 token 才是這次升級本身。
先看結論
公開標價與 Grok 4.6 相同。智慧指數上 xhigh 的 token 數量不同。
最清楚的進步在代理任務:Grok Build 的編碼代理分高了 9 分,文書分析品質明顯上升。
綜合指數只高 2 分,在這張圖上仍落後於 Claude Fable 5.1、GPT-6 Astra 和 GPT-5.6 Sol。
投影片完成度反向走。簡報 Elo 下降,分析 Elo 上升。
Cursor 方案消耗和 API 美元是兩套表。一位 Ultra 使用者看到方案掉得更快。這不能改寫 API 標價。
基準,以及該信多少
每一列都帶著自己的 harness。xAI 表上的 Terminal-Bench 百分比,不是 Grok Build 裡的那個百分比。
| 訊號 | Grok 4.7 | 對照 | 條件,2026-09-22 核對 |
|---|---|---|---|
| 標價 | 每百萬 $2 / $6 | 與 Grok 4.6 相同。Sol Max $4 / $20。Fable Max $10 / $50 | xAI 發布表,xHigh 欄 |
| API 模型 | grok-4.7 | 上下文 50 萬。預設檔位 high。有 xhigh | docs.x.ai 一覽 |
| 智慧指數 | 46 | Grok 4.6 high 44。Sol max 47。Fable 5.1 與 Astra 53 | Artificial Analysis,xhigh |
| 每題輸出 token | 約 81k | Grok 4.6 xhigh 約 38k。Astra max 約 27k | 同一篇文章,不是美元帳單 |
| 編碼代理指數 | 56 | Grok Build 中的 Grok 4.6 xhigh 為 47。Fable 與 Astra 為 62 | 原生 harness,不是指數那套 |
| AA-Briefcase Elo | 1,657 | Grok 4.6 high 1,546。Fable 5.1 1,678 | 4.7 是 xhigh,4.6 對照是 high |
| 分析對投影片 | 1,994 / 1,499 Elo | Grok 4.6 high 1,690 / 1,519 | 分析升,簡報降 |
| CursorBench 4.0 | 46.3%,約每任務 $6.01 | Fable 5.1 Max 51.8%,約 $17.28 | xAI 散點,Extra High,廠商 harness |
| Terminal-Bench 4.0 | 38.0% | Grok 4.6 High 20.3%。Sol Max 37.3%。Fable Max 57.9% | xAI 表,xHigh 欄 |
| Grok Build 中的 Terminal-Bench | 33% | Grok 4.6 xhigh 18% | Artificial Analysis。不要和 38% 平均 |
這張表上面還有三道限制。
檔位對不齊。好幾句「4.7 贏了 4.6」比的是 xhigh 和 high。81k 對 38k 才是兩邊都在 xhigh 的那一對。指數加 2 分不是這一對。
Harness 會改寫結論。編碼代理分包含 Grok Build。智慧指數用的是統一 harness。xAI 的 Terminal-Bench 格子是 38.0%。Artificial Analysis 在 Grok Build 裡寫成 33%,基線是 18%。The Decoder 文中的 26% 是第三種圖說,這裡不用。
廠商圖會挑選對手。發布頁上的 CursorBench 散點有 Fable、Opus、Sol 和 Sonnet,沒有 GPT-6 Astra。那張圖上的低單任務成本,不是對 Astra 的勝利。基準是方向,不是尺。
這張表前面沒有 Tabbit 任務日誌。後面只使用公開測量和具名評論。
它確實強的地方
分析變好了,投影片沒有
意外不在指數上的 46。AA-Briefcase 上,分析品質從 Grok 4.6 high 的 1,690 Elo 走到 Grok 4.7 的 1,994,簡報品質從 1,519 走到 1,499。Artificial Analysis 在 9 月 22 日的貼文裡寫了同一方向的分裂:Lite 情境分析 Elo 從 1,698 到 1,994,簡報從 1,531 到 1,499。兩處文字的 4.6 基線不是同一對。兩邊都是:分析寫得更好,成片沒有更好。
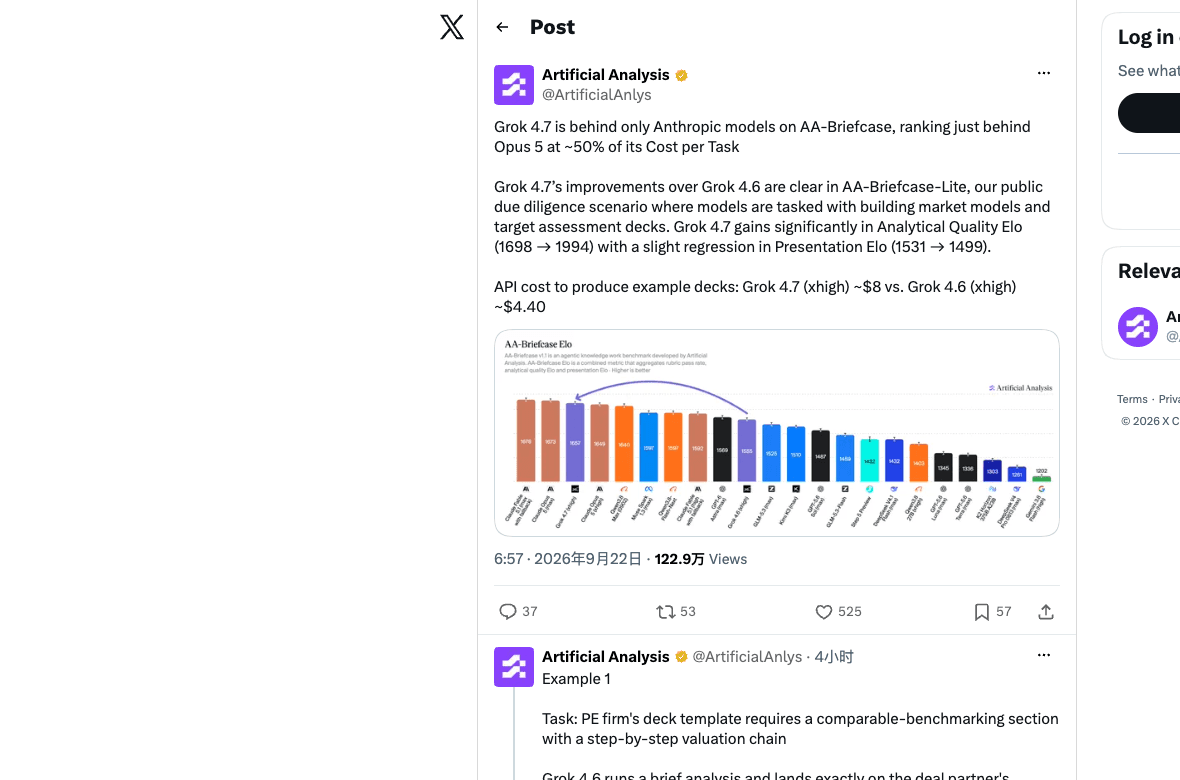
原帖。
如果交付物是市場模型、備忘錄或表格論證,這個分裂比兩分指數更要緊。如果交付物是打磨好的投影片,就沒有理由為 Grok 4.7 的這一項鼓掌。
Grok Build 裡的編碼代理,比指數走得更遠
在 Grok Build 裡,Artificial Analysis 給出 DeepSWE v1.1 為 73% 對 65%,Terminal-Bench 4.0 為 33% 對 18%,SWE-Atlas-QnA 為 63% 對 58%,對照都是 Grok 4.6 xhigh。綜合分是 56,在他們畫出的原生 harness 裡排第四,落後於 Fable 5.1 和 GPT-6 Astra。
這對長編碼循環是真實的一步。它仍是系統分:模型加上 Grok Build。它沒有說一次預設 high、而不是 xhigh 的 grok-4.7 API 呼叫能通過同樣的題。這類循環和單次回答的差別,可以接著看 代理推理說明。
標價仍是旗艦裡便宜的那一格
在 xAI 的 CursorBench 散點上,Grok 4.7 Extra High 是 46.3%,約每任務 6.01 美元。Fable 5.1 Max 是 51.8%,約 17.28 美元。Grok 4.7 High 是 43.9%,約 4.69 美元;Low 是 33.1%,約 1.58 美元。你可以用比 Fable 頂檔少很多的錢買一個較低的分,也可以買 Fable 的更高分。這是兩筆不同的採購。Fable 5.1 評測和 GPT-6 Astra 評測 寫的是貴的那一端。
它會咬人的地方
咬人的是 token 帳單,不是價目表
大約 8.1 萬輸出 token、按每百萬 6 美元計算,輸出部分大約是 0.49 美元,還沒算輸入、快取、工具和重試。大約 3.8 萬則大約是 0.23 美元。這只用了 Artificial Analysis 印出的輸出數量,不是你的發票。
Cursor Ultra 使用者 Dynamix86 說自己在 extra high、關閉 fast mode 的條件下跑了同一項任務,並認為 Grok 4.7 打掉方案百分比的速度大約是 Grok 4.6 的 2.5 倍。他們還把一張圖讀成每任務 8.82 美元對 3.53 美元。方案計時按他們的紀錄理解。那對美元數是他們對圖片的讀數,不是這篇重新測量的結果。
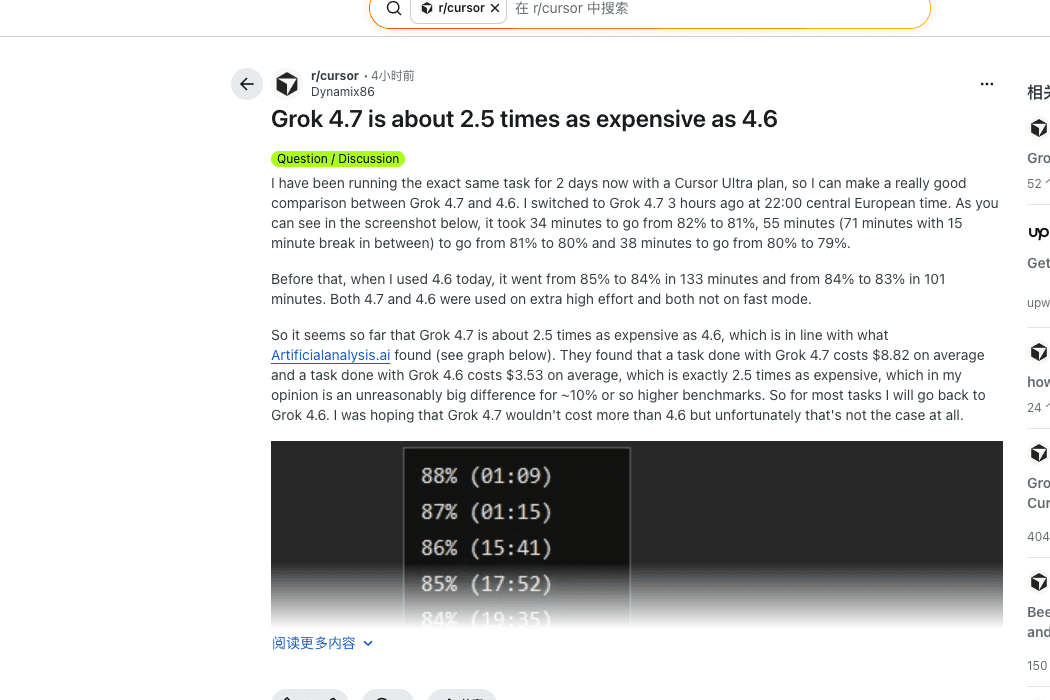
原帖。
xAI 還有一個按兩倍 token 價格計費的快速變體,而且只在 Cursor 和 Grok Build。公開 API 沒有它。美國區域端點還有 10% 的用量溢價。把「快速」和很長的提示疊在一起,就不是標題裡的 2 美元 / 6 美元那一檔。
困難的終端任務仍然大多失敗
官方 Terminal-Bench 4.0 在 xHigh 是 38.0%。同一張表上 Fable 5.1 Max 是 57.9%,Sol Max 是 37.3%。Grok 4.7 高於 Grok 4.6 High 的 20.3%,這組題仍然大多做不完。HealthBench Professional 是 56.7%,Fable 是 62.1%,Sol 是 60.5%。Harvey 法律代理格子是 19.6%,遠高於 Sol 的 2.5%,絕對分仍然低。
一個被訓練去熬多小時任務的模型,仍然可以在那一小時裡失敗。不要把「比 4.6 好」讀成「事情做完了」。
指數只走了一小步,檔位也很容易看錯
46 對 44 不會改變一段短對話、一次翻譯或一個單檔修改。GPT-5.6 Sol max 在這張指數上已經是 47,標價更高。想要全面躍進的團隊,在這次發布裡找不到。拿 xhigh 去比 high,再宣布全面獲勝,只是在挑自己喜歡的標籤。
幻覺率有改善,29% 對 Grok 4.6 high 的 34%,準確率仍大約是 47% 對 48%。非正確答案裡的錯誤少了一些,不等於知道得更多。
人們實際上怎麼說
評論分成帳單和手感兩邊。它們不能給基準定案。
帳單
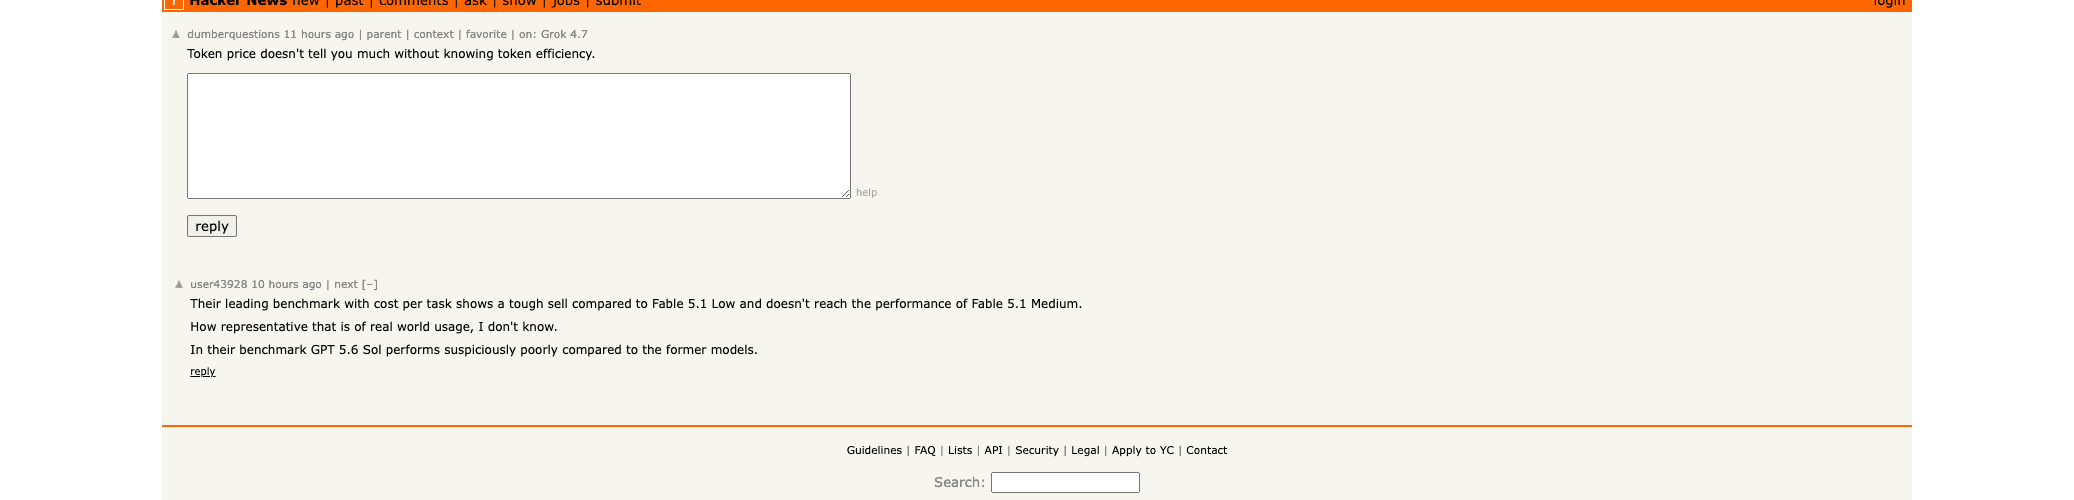
saejox 對一個單價更高、卻用更少 token 的模型說得更直接:離 Astra 還遠,它貴,但 token 用得少。
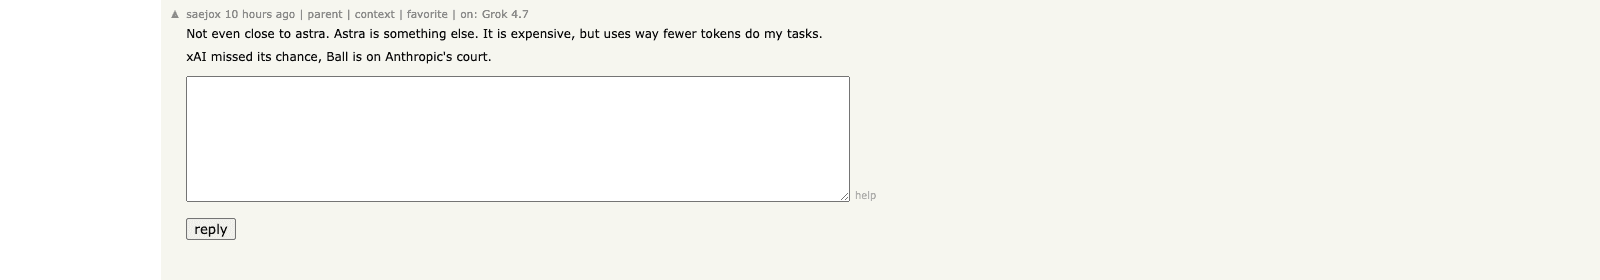
評論。
手感
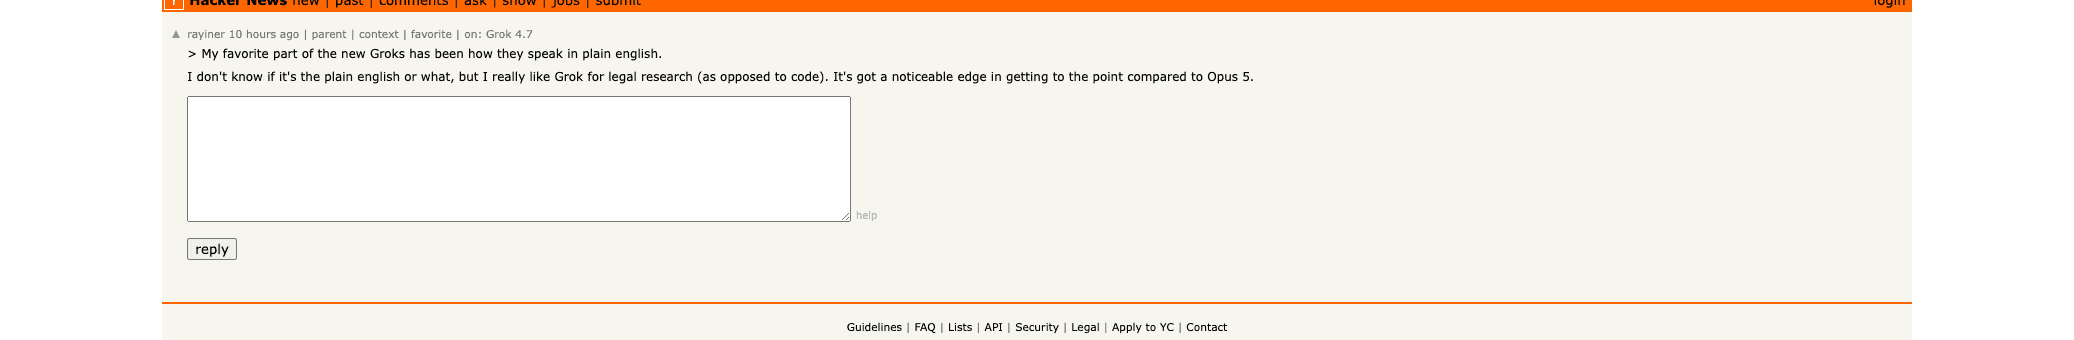
rayiner 說自己做法律檢索時喜歡 Grok,不是寫程式,因為它比 Opus 5 更快說到重點。這句話說的是最近一串 Grok,不是一份打過分的 4.7 案卷。
評論。
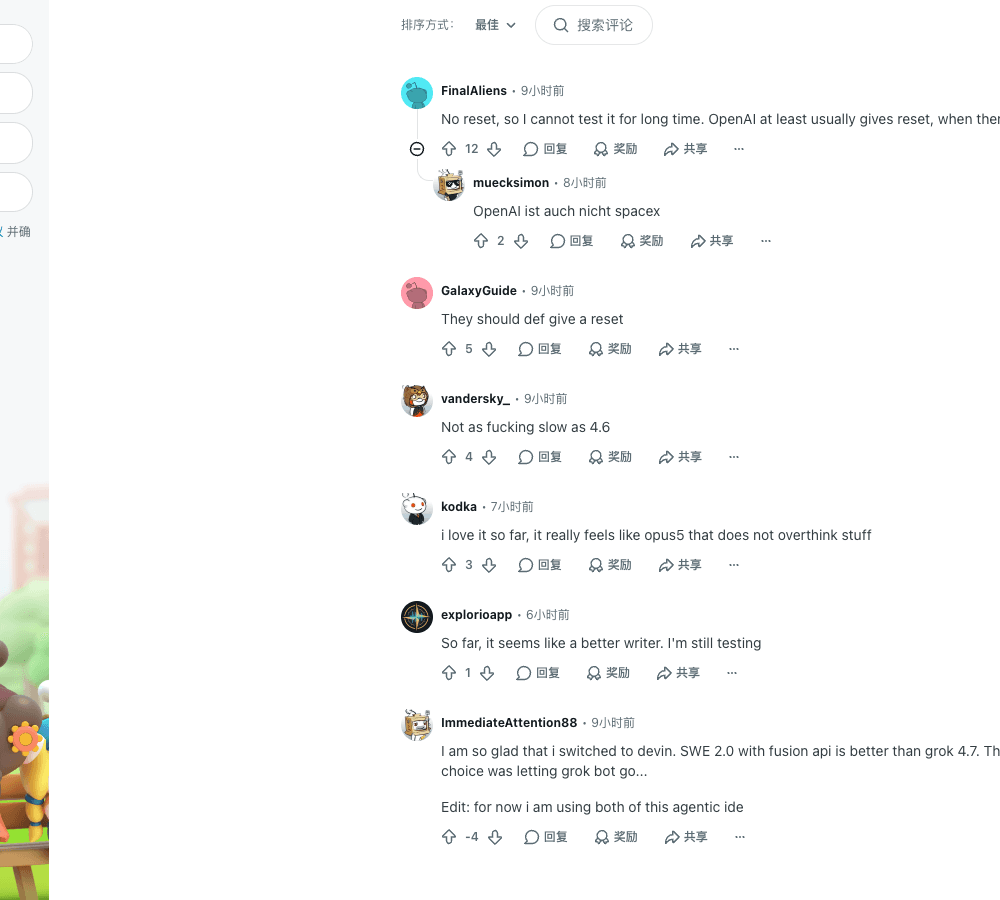
r/cursor 發布後頭幾個小時的貼文,是同一個分裂的縮小版。vandersky_ 寫它沒有 4.6 那麼慢。kodka 寫它像不會過度思考的 Opus 5。exploriosapp 還在測,覺得寫作更好。ImmediateAttention88 更傾向 Devin 的 SWE 2.0 加 fusion API,而且兩個工具都在用。沒有人貼出儲存庫、檔位或計時。
貼文。
編輯判斷和數字一致。盯著用量的人不滿意。想要少一點拖沓編碼手感的人還在試。兩邊都沒有貼出重複任務的分數。
先跑工作流程,再相信那一列分數
一列基準不會告訴你,Grok 4.7 在你已經打開的頁面上是什麼表現。Tabbit Browser 是做這個檢查的用戶端:模型選擇器、目前頁面和檔案在同一個地方。AI 瀏覽器說明和 Tabbit Browser 導覽 寫的是這個版面。代理式瀏覽和 瀏覽器自動化 是相鄰的工作。如果問題是瀏覽器而不是模型,可以看 2026 年 AI 瀏覽器清單。
邊界很直接。這篇沒有在 Tabbit 裡做固定抽取、重複比較或計時的頁面任務。如果選擇器裡沒有 Grok 4.7,下面的按鈕也不會變出權限。API 美元、Cursor 方案和 Tabbit 帳號是三種價格。就算抓到一次碰巧正確的回答,也不能把它寫成成功率。
按工作負載選
| 工作負載 | 用 Grok 4.7 嗎 | 原因 | 要盯住 |
|---|---|---|---|
| 4.6 會中途放棄的長編碼循環 | 用,在 Grok Build 或 Cursor,先不要上到 xhigh | 編碼代理的進步是公開資料裡最大的一塊 | 方案百分比和輸出 token |
| 單檔修改或閒聊 | 不用 | 指數只高 2 分,token 數量卻跳了一大截 | 留在 4.6,或看 Gemini 3.8 Flash 評測 裡的較小模型 |
| 備忘錄、模型或表格論證 | 用,如果產品就是分析 | 分析 Elo 上升了 | 不要指望投影片更好 |
| Fable 已經能通過的終端套件 | 不用,除非價格壓過一切 | 官方 Terminal-Bench 38% 仍然大多失敗 | 不要混進 Grok Build 的 33% |
| 在意簡短的法律檢索 | 試,然後核對來源 | 有一位實作者喜歡這種語氣。Harvey 代理分只有 19.6% | 語氣不是正確性 |
| 工作就在打開的分頁裡 | 只有選擇器裡有它,才在 Tabbit 裡試 | 缺的是用戶端,不是更高的分數 | 這裡不聲稱成功率 |
Grok 4.7 是上一個模型停住、而你付得起額外 token 時的升級。上一個模型已經做完時,它會變成貴習慣。
 Tabbit Browser

常見問題
Grok 4.7 值得從 Grok 4.6 換過去嗎?
只有當長程編碼代理或分析文件在 Grok 4.6 上做不完,而且你付得起更多輸出 token 時,才值得換。標價仍是每百萬 token 輸入 2 美元、輸出 6 美元。Artificial Analysis 在 xhigh 檔測得每道智慧指數題約 8.1 萬輸出 token,Grok 4.6 的 xhigh 約 3.8 萬。日常單檔修改不需要這些額外思考。
標價沒漲,為什麼有人說 Grok 4.7 更貴?
價目表和帳單不是同一個數字。xAI 列出的單價與 Grok 4.6 相同。獨立測試顯示,xhigh 檔寫出的輸出 token 大約是兩倍。一位 Cursor Ultra 使用者在 extra high、關閉 fast mode 時,也看到方案百分比掉得更快。那是單一帳號的用量紀錄,不是 API 發票。
Grok 4.7 和 Claude Fable 5.1、GPT-6 Astra 差多少?
在 Artificial Analysis 智慧指數上,Grok 4.7 xhigh 是 46。Claude Fable 5.1 和 GPT-6 Astra 是 53,GPT-5.6 Sol 是 47。Grok Build 加 Grok 4.7 的編碼代理指數是 56,Fable 和 Astra 是 62。辦公類 Elo 上的差距,比綜合指數上的差距小。
Grok 4.7 Fast 是什麼,API 能用嗎?
xAI 文件把 Grok 4.7 Fast 寫成同一模型的更快服務,按標準 token 價格的兩倍計費。它在 Cursor 和 Grok Build 裡提供,不計入 Grok Build 免費額度,也不在公開 xAI API 上。公開模型名稱是 grok-4.7。
CursorBench 更高,是不是就代表編碼贏了?
不是。xAI 自己的散點圖裡,Grok 4.7 Extra High 是 46.3%,約每任務 6.01 美元;Fable 5.1 Max 是 51.8%,約 17.28 美元。官方 Terminal-Bench 4.0 是 38.0%,這組終端任務仍然大多失敗。Grok Build 裡的 33% 是另一套 harness,不能和 38% 寫進同一格。
能在 Tabbit Browser 裡用 Grok 4.7 嗎?
Tabbit 的 Grok 4.7 頁面寫明,模型出現在目前帳號的選擇器裡時可以使用。這篇評測沒有在 Tabbit 裡跑固定任務,因此不報告成功率、延遲或用戶端費用。API 單價、Cursor 方案和 Tabbit 帳號是三筆不同的費用。