
O Grok 4.7 é o modelo de código e de trabalho de conhecimento que a xAI publicou em 21 de setembro de 2026. A pergunta não é se o gráfico de lançamento tem uma linha vencedora. É se vale a pena deixar o Grok 4.6 quando os tokens de fato gastos também entram na conta.
No Hacker News, dumberquestions resumiu a armadilha numa frase: o preço por token, sozinho, não diz nada sobre eficiência. Esta análise é essa frase. A geração anterior está no guia do Grok 4.6. A página de preços e a lista de alternativas ainda não existem neste site. Mais abaixo não há um experimento controlado feito no Tabbit Browser.
O número que parte esta análise
Em 22 de setembro de 2026, ao abrir as fontes, dois números apontavam em direções opostas.
A página de lançamento anota o Grok 4.7 xHigh a 2 dólares por milhão de tokens de entrada e 6 de saída, a mesma célula do Grok 4.6 High. A documentação da API repete 2,00 e 6,00 dólares para grok-4.7.
A Artificial Analysis mediu que, em xhigh, o Grok 4.7 gasta cerca de 81 mil tokens de saída por tarefa do índice de inteligência. O Grok 4.6 xhigh gasta cerca de 38 mil. No mesmo texto, o Grok 4.6 high fica perto de 36 mil e o GPT-6 Astra max perto de 27 mil. A tarifa não se mexeu. O volume, sim.
O índice só passa de 44 no Grok 4.6 high para 46 no Grok 4.7 xhigh. O índice de agente de código no Grok Build mexe mais: 56 contra 47. Se a resposta é curta, você está pagando um raciocínio que não pediu. Se o modelo anterior parava no meio do repositório, esses tokens a mais são a atualização.
O que levar daqui
A tarifa pública é a do Grok 4.6. A contagem de tokens em xhigh, no índice de inteligência, não é.
O ganho mais claro está no agente. A pontuação de código do Grok Build sobe nove pontos, e a qualidade analítica dos documentos também sobe com força.
O índice geral soma só dois pontos e, nesse gráfico, fica atrás de Claude Fable 5.1, GPT-6 Astra e GPT-5.6 Sol.
Os slides vão ao contrário. O Elo analítico sobe e o Elo de apresentação desce.
O consumo do plano do Cursor e os dólares da API são painéis diferentes. Um usuário Ultra viu o plano acabar mais depressa. Isso não muda a tarifa da API.
Os benchmarks, e até onde acreditar
Cada linha tem o próprio harness. A porcentagem de Terminal-Bench na tabela da xAI não é a porcentagem do Grok Build.
| Sinal | Grok 4.7 | Comparação | Condição, conferida em 2026-09-22 |
|---|---|---|---|
| Tarifa | US$ 2 / US$ 6 por milhão | Igual ao Grok 4.6. Sol Max US$ 4 / US$ 20. Fable Max US$ 10 / US$ 50 | Tabela de lançamento da xAI, coluna xHigh |
| Modelo de API | grok-4.7 | Contexto de 500 mil. O padrão é high. Existe xhigh | Visão rápida de docs.x.ai |
| Índice de inteligência | 46 | Grok 4.6 high 44. Sol max 47. Fable 5.1 e Astra 53 | Artificial Analysis, xhigh |
| Saída por tarefa | cerca de 81k | Grok 4.6 xhigh cerca de 38k. Astra max cerca de 27k | O mesmo artigo. Não é uma fatura |
| Índice de agente de código | 56 | Grok 4.6 xhigh no Grok Build: 47. Fable e Astra: 62 | Harness nativo |
| Elo do AA-Briefcase | 1.657 | Grok 4.6 high 1.546. Fable 5.1 1.678 | 4.7 em xhigh; o lado 4.6 em high |
| Análise contra slides | 1.994 / 1.499 Elo | Grok 4.6 high 1.690 / 1.519 | A análise sobe; a apresentação desce |
| CursorBench 4.0 | 46,3%, cerca de US$ 6,01 por tarefa | Fable 5.1 Max 51,8%, cerca de US$ 17,28 | Gráfico da xAI, Extra High |
| Terminal-Bench 4.0 | 38,0% | Grok 4.6 High 20,3%. Sol Max 37,3%. Fable Max 57,9% | Tabela da xAI, coluna xHigh |
| Terminal-Bench no Grok Build | 33% | Grok 4.6 xhigh 18% | Artificial Analysis. Não tirar média com 38% |
Acima da tabela há três limites.
O esforço não bate. Várias frases do tipo “o 4.7 venceu o 4.6” comparam xhigh com high. O par 81k contra 38k é mais limpo: os dois lados estão em xhigh. Os dois pontos a mais do índice não são esse par.
O harness muda a história. O índice de código inclui o Grok Build. O índice de inteligência usa um harness comum. A célula de Terminal-Bench da xAI é 38,0%. A Artificial Analysis anota 33% dentro do Grok Build, com base de 18%. Os 26% do The Decoder são uma terceira legenda e não entram aqui.
O gráfico do fornecedor escolhe os rivais. O de CursorBench na página de lançamento mostra Fable, Opus, Sol e Sonnet. O GPT-6 Astra não aparece. Um custo por tarefa mais baixo nesse gráfico não é vitória sobre o Astra. Um benchmark é uma direção, não uma nota.
Não há registro de tarefa na Tabbit diante desta tabela. As seções seguintes usam só medições públicas e comentários com nome.
Onde ele de fato melhora
A análise melhorou. Os slides, não
O que chama atenção não é o 46 do índice. No AA-Briefcase, a qualidade analítica passa de 1.690 Elo no Grok 4.6 high para 1.994 no Grok 4.7, e a qualidade de apresentação passa de 1.519 para 1.499. A Artificial Analysis repete essa fenda numa publicação de 22 de setembro. O Elo analítico Lite vai de 1.698 a 1.994 e o de apresentação de 1.531 a 1.499. As bases do 4.6 nos dois textos não são o mesmo par. Os dois dizem que a prosa analítica melhora e que o fechamento de um deck não.
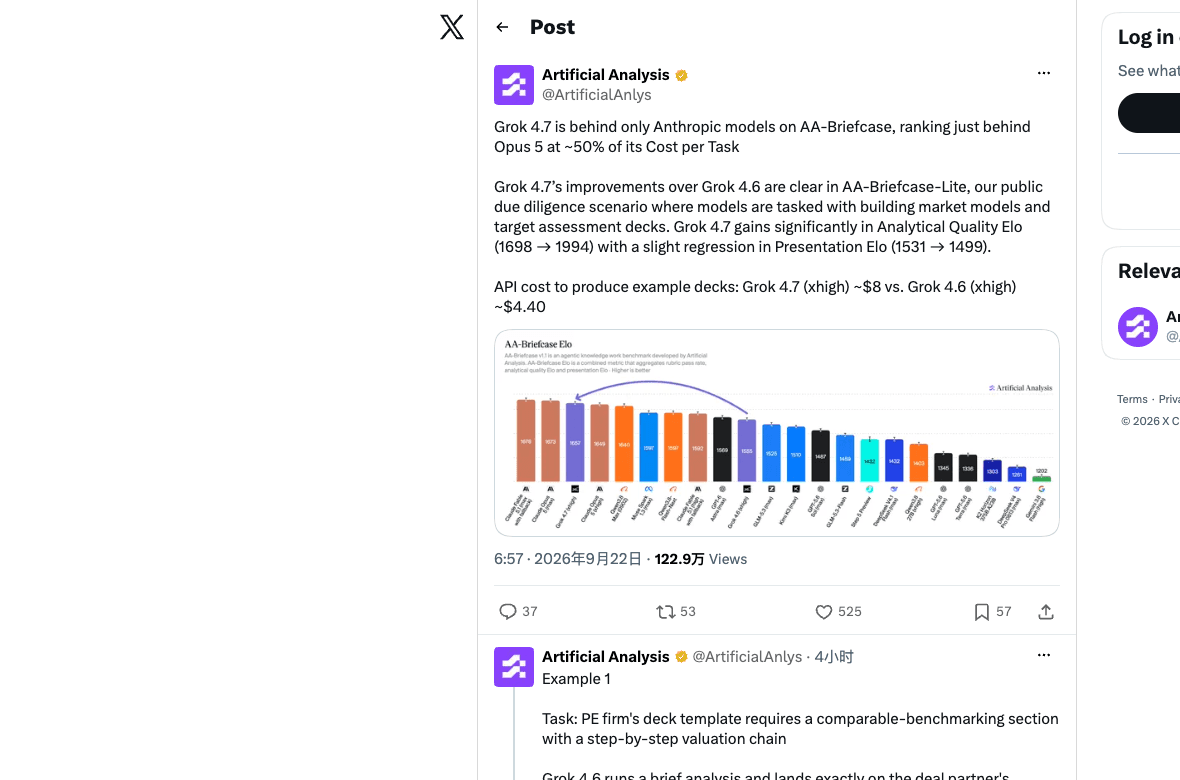
Se a entrega é um modelo de mercado, um memorando ou um argumento em planilha, essa fenda importa mais do que dois pontos de índice. Se a entrega é um deck polido, este dado não justifica comemorar o Grok 4.7.
O agente de código no Grok Build mexeu mais que o índice
Dentro do Grok Build, a Artificial Analysis anota DeepSWE v1.1 em 73% contra 65%, Terminal-Bench 4.0 em 33% contra 18% e SWE-Atlas-QnA em 63% contra 58%. O rival, em cada caso, é o Grok 4.6 xhigh. A soma é 56, quarto lugar entre os harness nativos que eles desenham, atrás de Fable 5.1 e GPT-6 Astra.
Para um laço de código longo, é um passo real. Continua sendo uma pontuação de sistema. O modelo chega com o Grok Build grudado. Isso não significa que uma chamada à API grok-4.7 no high padrão, e não em xhigh, passe nas mesmas tarefas. A diferença entre um laço e uma resposta única está ao lado, na explicação do raciocínio agêntico.
A tarifa continua na célula barata dos modelos de ponta
No gráfico de CursorBench da xAI, o Grok 4.7 Extra High marca 46,3% e cerca de 6,01 dólares por tarefa. O Fable 5.1 Max marca 51,8% e cerca de 17,28 dólares. O Grok 4.7 High marca 43,9% a cerca de 4,69 dólares, e o Low marca 33,1% a cerca de 1,58 dólar. Dá para comprar uma pontuação mais baixa por bem menos que o topo do Fable, ou comprar a pontuação alta do Fable. São compras diferentes. O lado caro está na análise do Fable 5.1 e na análise do GPT-6 Astra.
Onde morde
Quem morde é a fatura de tokens, não a tarifa
Cerca de 81 mil tokens de saída a 6 dólares por milhão são cerca de 0,49 dólar só de saída, antes da entrada, do cache, das ferramentas e das novas tentativas. Cerca de 38 mil são cerca de 0,23 dólar. Só entraram as contagens de saída impressas pela Artificial Analysis. Não é a sua fatura.
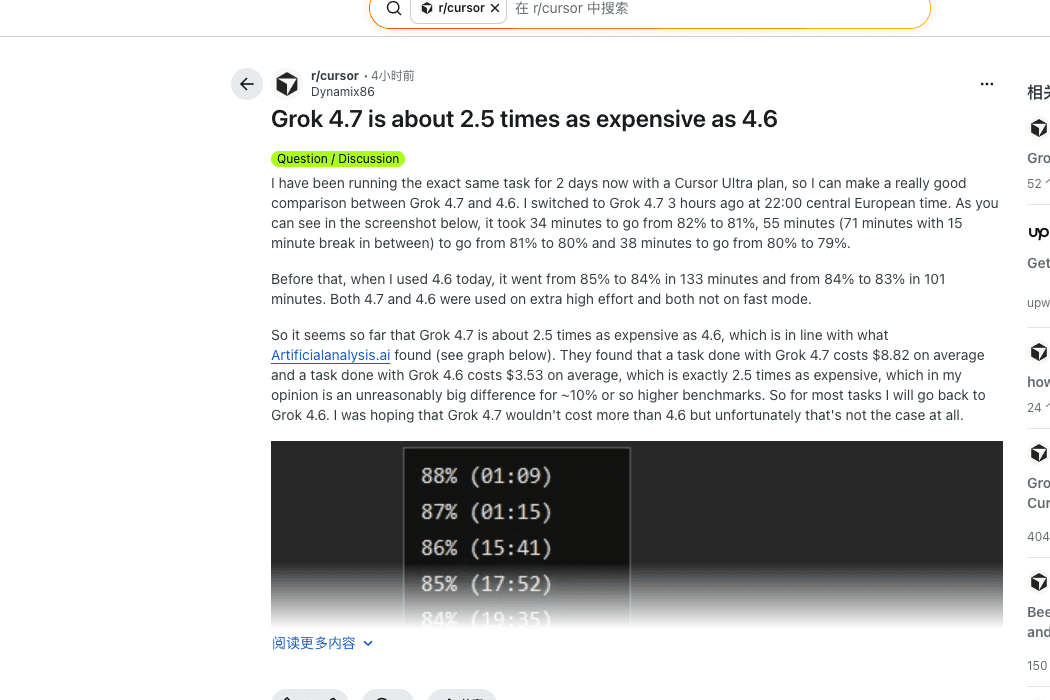
O Dynamix86, no Cursor Ultra, concluiu que em extra high e com o fast mode desligado, no que ele chama de mesma tarefa, o Grok 4.7 cortava a porcentagem do plano cerca de 2,5 vezes mais depressa que o Grok 4.6. Também leu o gráfico como 8,82 dólares contra 3,53 por tarefa. O tempo do plano é o registro dessa pessoa. O par em dólares é uma leitura do gráfico, não uma medição repetida nesta análise.
A xAI também vende uma variante rápida ao dobro do preço por token, e só no Cursor e no Grok Build. Ela não está na API pública. O endpoint da região dos Estados Unidos acrescenta 10% sobre o uso. Se você junta “rápido” com um prompt longo, o produto deixa de ser o de 2 e 6 dólares do título.
A maior parte das tarefas difíceis de terminal ainda falha
O Terminal-Bench 4.0 oficial, em xHigh, é 38,0%. Na mesma tabela, o Fable 5.1 Max marca 57,9% e o Sol Max marca 37,3%. O Grok 4.7 fica acima dos 20,3% do Grok 4.6 High e ainda erra a maior parte do conjunto. O HealthBench Professional marca 56,7%, com o Fable em 62,1% e o Sol em 60,5%. A célula do agente jurídico Harvey é 19,6%, bem acima dos 2,5% do Sol, mas o número absoluto continua baixo.
Um modelo treinado para aguentar várias horas pode falhar dentro dessa hora. Não leia “melhor que o 4.6” como “o trabalho já acabou”.
O passo do índice é pequeno, e o esforço se mistura com facilidade
46 contra 44 não muda um papo curto, uma tradução nem o conserto de um arquivo. O GPT-5.6 Sol max já está em 47 nesse índice, com tarifa mais alta. Uma equipe que queria um salto geral não encontra isso neste lançamento. Comparar xhigh com high e depois anunciar uma vitória larga é ler o rótulo confortável.
A taxa de alucinação melhora para 29% contra 34% do Grok 4.6 high, e a precisão fica perto de 47% contra 48%. Menos erros dentro de uma resposta errada não é a mesma coisa que saber mais.
O que as pessoas de fato disseram
Os comentários se partem entre a fatura e a sensação de uso. Nenhum fecha um benchmark.
A fatura
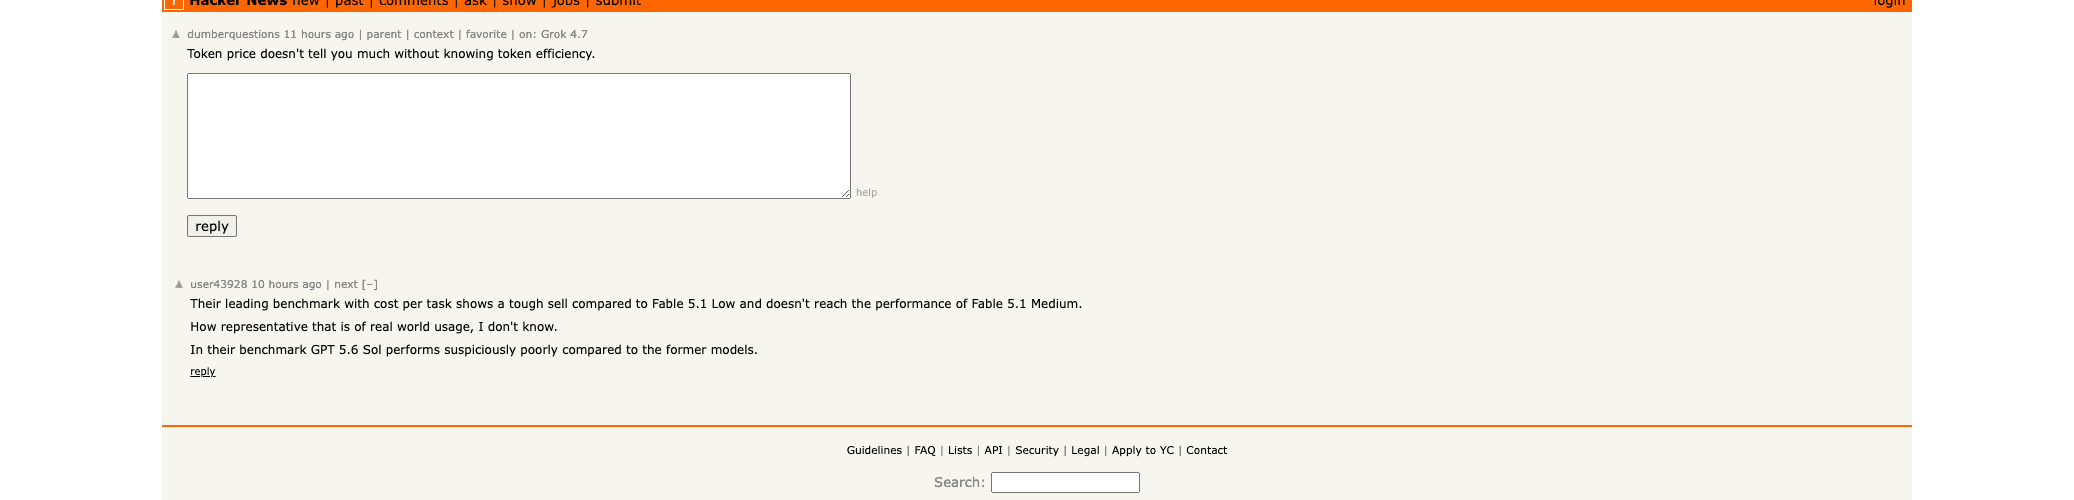
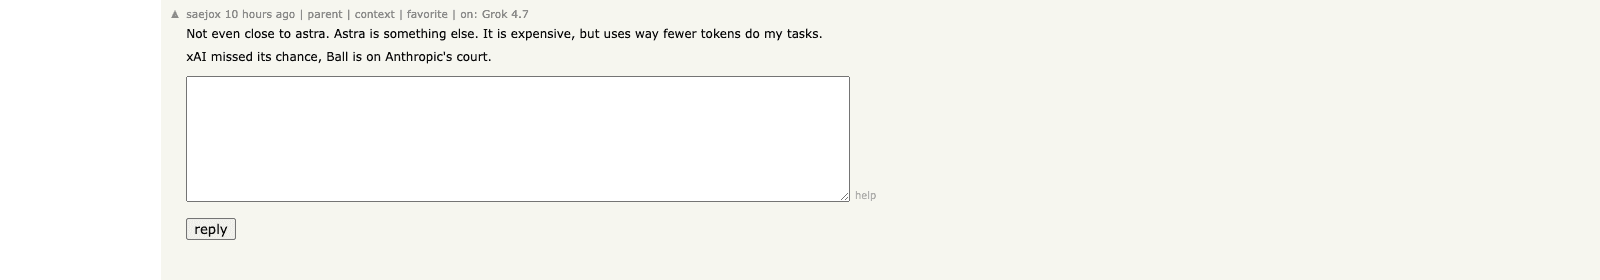
O saejox escreveu, a respeito de um modelo mais caro por token que gasta menos, que o Astra ainda está longe e é caro, mas usa menos tokens.
A sensação
O rayiner diz que prefere o Grok para pesquisa jurídica, não para código, porque chega antes ao ponto do que o Opus 5. A frase fala da família recente do Grok, não de um processo 4.7 já pontuado.
O fio de primeiras impressões no r/cursor, logo depois do lançamento, é a mesma fenda em miniatura. O vandersky_ escreveu que não é tão lento quanto o 4.6. O kodka escreveu que parece um Opus 5 que não pensa demais. O exploriosapp ainda está testando e diz que a escrita parece melhor. O ImmediateAttention88 acha o SWE 2.0 da Devin e a API de fusão melhores, e usa os dois. Ninguém anexou repositório, nível de esforço nem cronômetro.
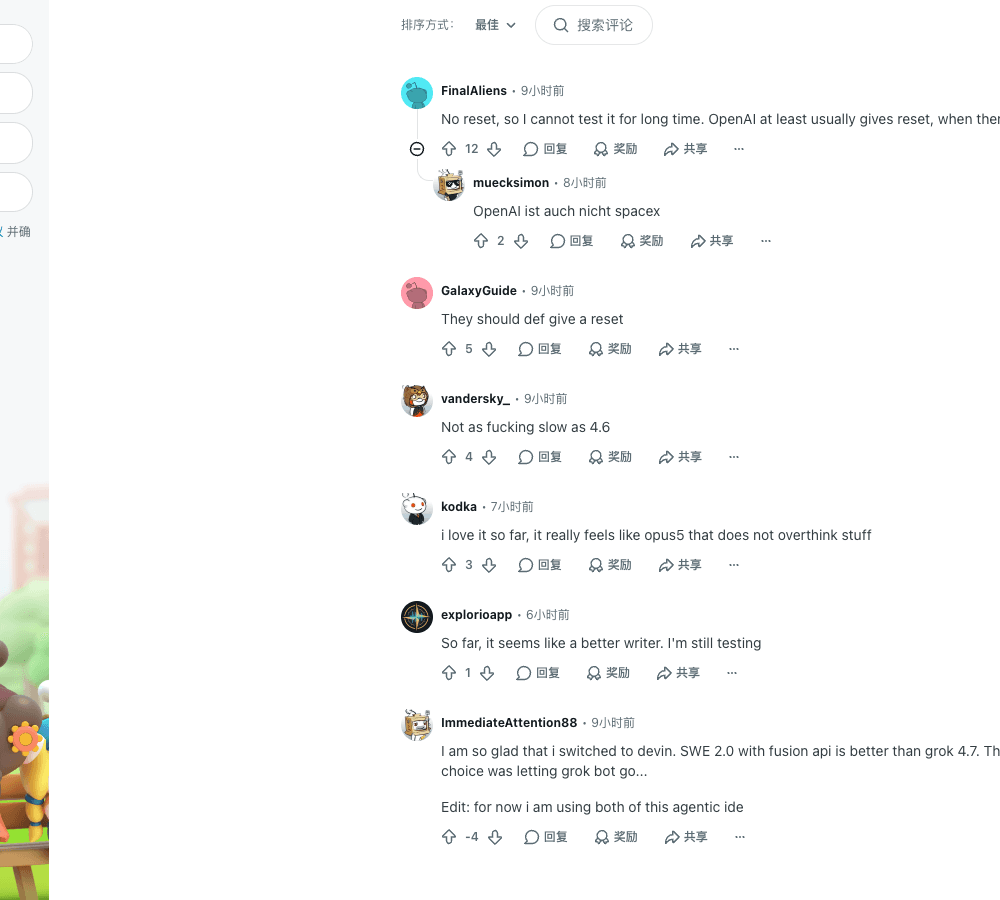
Fio.
O julgamento editorial combina com os números. Quem olha o medidor está irritado. Quem queria um código menos arrastado ainda está testando. Nenhum dos dois publicou uma pontuação repetida.
Teste a forma do trabalho antes de confiar numa linha
Uma linha de benchmark não mostra como o Grok 4.7 se comporta nas páginas que você já deixou abertas. O Tabbit Browser é o cliente para essa conferência: o seletor de modelos, as páginas abertas e os arquivos ficam no mesmo lugar. O guia do navegador com IA e a explicação do Tabbit Browser descrevem esse arranjo. A navegação agêntica e a automação do navegador são trabalhos vizinhos. Se a pergunta é o navegador e não o modelo, existe a lista de navegadores com IA de 2026.
O limite é simples. Esta análise não rodou na Tabbit uma extração fixa, uma comparação repetida nem uma tarefa de página cronometrada. Se o Grok 4.7 não estiver no seletor, o botão abaixo não cria acesso. Os dólares da API, o plano do Cursor e a conta Tabbit são três preços. Uma resposta certa por acaso, mesmo que tivesse sido capturada, não vira taxa de acerto.
Escolher pelo trabalho
| Trabalho | Usar o Grok 4.7? | Por quê | O que vigiar |
|---|---|---|---|
| Código longo em que o 4.6 desiste no meio | Sim. Primeiro no Grok Build ou no Cursor, abaixo de xhigh | O maior ganho dos dados públicos está no agente de código | Porcentagem do plano e tokens de saída |
| Conserto de um arquivo ou conversa | Não | O índice soma dois pontos e a contagem de tokens salta | Ficar no 4.6 ou olhar um modelo menor na análise do Gemini 3.8 Flash |
| Memorandos, modelos e argumentos em tabela | Sim, se a análise for a entrega | O Elo analítico subiu | Não esperar que os slides melhorem |
| Um conjunto de terminal que o Fable já passa | Só se o preço esmagar todo o resto | O Terminal-Bench oficial de 38% ainda erra a maioria | Não misturar os 33% do Grok Build |
| Pesquisa jurídica em que a brevidade importa | Testar e depois conferir as fontes | Um profissional gosta do tom. O Harvey marca só 19,6% | Tom não é precisão |
| Trabalho dentro de abas abertas | Testar na Tabbit só se estiver no seletor | O que falta é o cliente, não uma pontuação mais alta | Nenhuma taxa de acerto é afirmada aqui |
O Grok 4.7 é a atualização quando o modelo anterior para e você pode pagar os tokens a mais. Se o anterior já terminava o trabalho, vira um hábito caro.
 Tabbit Browser

Perguntas frequentes
Vale a pena sair do Grok 4.6 para o Grok 4.7?
Só se um agente de código longo ou um documento analítico parar no meio no Grok 4.6, e se você puder pagar os tokens a mais. A tarifa continua em 2 dólares por milhão na entrada e 6 na saída. A Artificial Analysis mediu cerca de 81 mil tokens de saída por tarefa do índice em xhigh, contra cerca de 38 mil do Grok 4.6 xhigh. Um conserto curto de um arquivo não precisa desse raciocínio.
Se o preço por token não mudou, por que dizem que ficou mais caro?
A tarifa e a fatura são números diferentes. A xAI cobra o mesmo que no Grok 4.6. Uma medição independente mostra que os tokens de saída em xhigh quase dobram. Um usuário do Cursor Ultra anotou que a porcentagem do plano caía mais rápido em extra high, com o fast mode desligado. É o registro de uma conta, não uma fatura de API.
Qual é a distância para o Claude Fable 5.1 e o GPT-6 Astra?
No índice de inteligência da Artificial Analysis, o Grok 4.7 xhigh marca 46. Claude Fable 5.1 e GPT-6 Astra marcam 53, e o GPT-5.6 Sol marca 47. O índice de agente de código do Grok Build com o Grok 4.7 é 56; Fable e Astra chegam a 62. Nas tarefas de escritório, o Elo não abre a mesma distância do índice geral.
O que é o Grok 4.7 Fast e dá para usá-lo pela API?
A documentação da xAI descreve o Grok 4.7 Fast como a mesma família servida mais depressa, cobrada ao dobro do preço padrão por token. Só existe no Cursor e no Grok Build, fora da cota gratuita do Grok Build e fora da API pública da xAI. O nome público do modelo é grok-4.7.
Um CursorBench alto significa que ele ganha em código?
Não. No gráfico da xAI, o Grok 4.7 Extra High chega a 46,3% e cerca de 6,01 dólares por tarefa; o Fable 5.1 Max chega a 51,8% e cerca de 17,28 dólares. O Terminal-Bench 4.0 oficial é 38,0%, então a maior parte dessas tarefas de terminal ainda falha. Os 33% do Grok Build são outro harness: não misture com os 38% na mesma célula.
Dá para usar o Grok 4.7 no Tabbit Browser?
A página do Grok 4.7 na Tabbit diz que ele fica disponível quando aparece no seletor de modelos da conta. Esta análise não rodou uma tarefa fixa na Tabbit, então não informa taxa de acerto, latência nem custo no cliente. O preço da API, o plano do Cursor e a conta Tabbit são três custos diferentes.