
Grok 4.7 est le modèle de code et de travail de connaissance publié par xAI le 21 septembre 2026. La question n'est pas de savoir si le graphique de lancement contient une ligne gagnante. Elle est de savoir s'il vaut la peine de quitter Grok 4.6 une fois les tokens réellement dépensés comptés.
Sur Hacker News, dumberquestions a résumé le piège en une phrase : le prix au token, seul, ne dit rien de l'efficacité. Cet avis est cette phrase. La génération précédente est dans le guide Grok 4.6. La page de tarifs et la liste d'alternatives n'existent pas encore sur ce site. Plus bas, il n'y a pas d'expérience contrôlée menée dans Tabbit Browser.
Le chiffre qui coupe cet avis
Le 22 septembre 2026, à l'ouverture des sources, deux chiffres pointaient dans des sens opposés.
La page de lancement note Grok 4.7 xHigh à 2 dollars le million de tokens d'entrée et 6 en sortie, la même case que Grok 4.6 High. La documentation de l'API répète 2,00 et 6,00 dollars pour grok-4.7.
Artificial Analysis a mesuré qu'en xhigh, Grok 4.7 dépense environ 81 000 tokens de sortie par tâche de l'indice d'intelligence. Grok 4.6 xhigh en dépense environ 38 000. Dans le même texte, Grok 4.6 high tourne autour de 36 000 et GPT-6 Astra max autour de 27 000. Le tarif n'a pas bougé. Le volume, si.
L'indice ne passe que de 44 pour Grok 4.6 high à 46 pour Grok 4.7 xhigh. L'indice d'agent de code dans Grok Build bouge davantage : 56 contre 47. Si la réponse est courte, vous payez une réflexion que vous n'avez pas demandée. Si le modèle précédent s'arrêtait au milieu du dépôt, ces tokens en plus sont la mise à jour.
Ce qu'il faut retenir
Le tarif public est celui de Grok 4.6. Le nombre de tokens en xhigh, sur l'indice d'intelligence, ne l'est pas.
Le gain le plus net est dans l'agent. Le score de code de Grok Build monte de neuf points, et la qualité analytique des documents monte aussi nettement.
L'indice général ne gagne que deux points et, sur ce graphique, reste derrière Claude Fable 5.1, GPT-6 Astra et GPT-5.6 Sol.
Les diapositives vont à l'envers. L'Elo analytique monte et l'Elo de présentation baisse.
La consommation du forfait Cursor et les dollars d'API sont deux tableaux de bord. Un utilisateur Ultra a vu le forfait fondre vite. Cela ne change pas le tarif de l'API.
Les benchmarks, et jusqu'où les croire
Chaque ligne a son harness. Le pourcentage Terminal-Bench du tableau xAI n'est pas celui de Grok Build.
| Signal | Grok 4.7 | Comparaison | Condition, vérifiée le 2026-09-22 |
|---|---|---|---|
| Tarif | 2 $ / 6 $ le million | Identique à Grok 4.6. Sol Max 4 $ / 20 $. Fable Max 10 $ / 50 $ | Tableau de lancement xAI, colonne xHigh |
| Modèle d'API | grok-4.7 | Contexte de 500 000. Défaut : high. xhigh existe | Aperçu de docs.x.ai |
| Indice d'intelligence | 46 | Grok 4.6 high 44. Sol max 47. Fable 5.1 et Astra 53 | Artificial Analysis, xhigh |
| Sortie par tâche | environ 81k | Grok 4.6 xhigh environ 38k. Astra max environ 27k | Le même article. Ce n'est pas une facture |
| Indice d'agent de code | 56 | Grok 4.6 xhigh dans Grok Build : 47. Fable et Astra : 62 | Harness natif |
| Elo AA-Briefcase | 1 657 | Grok 4.6 high 1 546. Fable 5.1 1 678 | 4.7 en xhigh ; le côté 4.6 en high |
| Analyse contre diapositives | 1 994 / 1 499 Elo | Grok 4.6 high 1 690 / 1 519 | L'analyse monte ; la présentation baisse |
| CursorBench 4.0 | 46,3 %, environ 6,01 $ par tâche | Fable 5.1 Max 51,8 %, environ 17,28 $ | Nuage de points xAI, Extra High |
| Terminal-Bench 4.0 | 38,0 % | Grok 4.6 High 20,3 %. Sol Max 37,3 %. Fable Max 57,9 % | Tableau xAI, colonne xHigh |
| Terminal-Bench dans Grok Build | 33 % | Grok 4.6 xhigh 18 % | Artificial Analysis. Ne pas moyenner avec 38 % |
Au-dessus du tableau, trois limites.
L'effort ne correspond pas. Plusieurs phrases du type « 4.7 a battu 4.6 » comparent xhigh et high. La paire 81k contre 38k est plus nette : les deux côtés sont en xhigh. Les deux points d'indice en plus ne sont pas cette paire.
Le harness change l'histoire. L'indice de code inclut Grok Build. L'indice d'intelligence utilise un harness commun. La case Terminal-Bench de xAI est à 38,0 %. Artificial Analysis note 33 % à l'intérieur de Grok Build, avec une base de 18 %. Les 26 % de The Decoder sont une troisième légende et ne sont pas utilisés ici.
Le graphique du fournisseur choisit ses rivaux. Celui de CursorBench sur la page de lancement montre Fable, Opus, Sol et Sonnet. GPT-6 Astra n'y figure pas. Un coût par tâche plus bas sur ce graphique n'est pas une victoire sur Astra. Un benchmark est une direction, pas une note.
Il n'y a pas de relevé de tâche Tabbit devant ce tableau. Les sections suivantes n'utilisent que des mesures publiques et des commentaires nommés.
Là où il est vraiment meilleur
L'analyse a progressé. Les diapositives, non
Ce qui frappe n'est pas le 46 de l'indice. Dans AA-Briefcase, la qualité analytique passe de 1 690 Elo pour Grok 4.6 high à 1 994 pour Grok 4.7, et la qualité de présentation passe de 1 519 à 1 499. Artificial Analysis répète cette fente dans une publication du 22 septembre. L'Elo analytique Lite va de 1 698 à 1 994 et celui de présentation de 1 531 à 1 499. Les bases 4.6 des deux textes ne sont pas la même paire. Les deux disent que la prose analytique s'améliore et que la finition d'un jeu de diapositives, non.
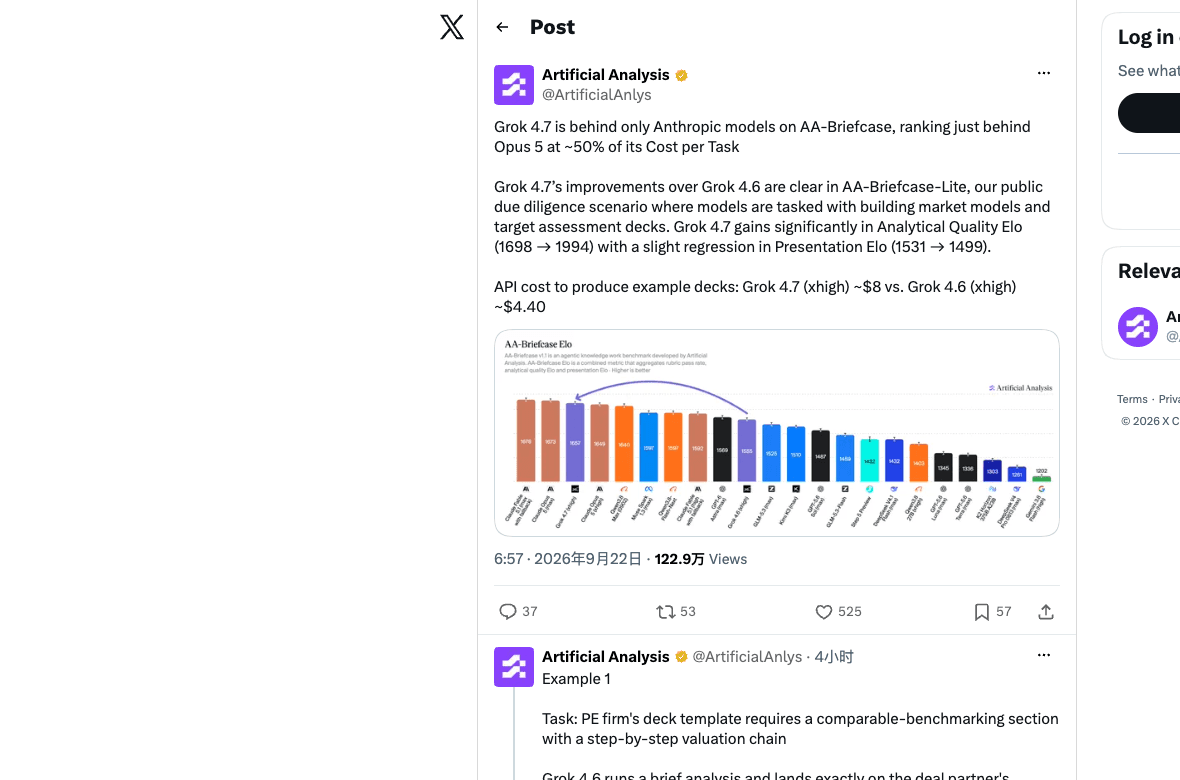
Si le livrable est un modèle de marché, une note ou un argument de tableur, cette fente compte plus que deux points d'indice. Si le livrable est un jeu de diapositives poli, ce chiffre ne justifie pas de célébrer Grok 4.7.
L'agent de code dans Grok Build a bougé plus que l'indice
Dans Grok Build, Artificial Analysis note DeepSWE v1.1 à 73 % contre 65 %, Terminal-Bench 4.0 à 33 % contre 18 % et SWE-Atlas-QnA à 63 % contre 58 %. Le rival, à chaque fois, est Grok 4.6 xhigh. La somme est 56, quatrième parmi les harness natifs qu'ils dessinent, derrière Fable 5.1 et GPT-6 Astra.
Pour une boucle de code longue, c'est un vrai pas. Cela reste un score de système. Le modèle arrive avec Grok Build collé. Cela ne veut pas dire qu'un appel API grok-4.7 en high par défaut, et non en xhigh, passe les mêmes tâches. La différence entre une boucle et une seule réponse est à côté, dans l'explication du raisonnement agentique.
Le tarif reste dans la case bon marché des modèles de pointe
Sur le nuage de points CursorBench de xAI, Grok 4.7 Extra High marque 46,3 % et environ 6,01 dollars par tâche. Fable 5.1 Max marque 51,8 % et environ 17,28 dollars. Grok 4.7 High marque 43,9 % à environ 4,69 dollars, et Low marque 33,1 % à environ 1,58 dollar. Vous pouvez acheter un score plus bas pour bien moins que le sommet de Fable, ou acheter le score élevé de Fable. Ce sont deux achats. Le côté cher est dans l'avis Fable 5.1 et l'avis GPT-6 Astra.
Là où ça mord
C'est la facture de tokens qui mord, pas le tarif
Environ 81 000 tokens de sortie à 6 dollars le million font environ 0,49 dollar de sortie seule, avant l'entrée, le cache, les outils et les nouvelles tentatives. Environ 38 000 font environ 0,23 dollar. Seuls les décomptes de sortie imprimés par Artificial Analysis ont été utilisés. Ce n'est pas votre facture.
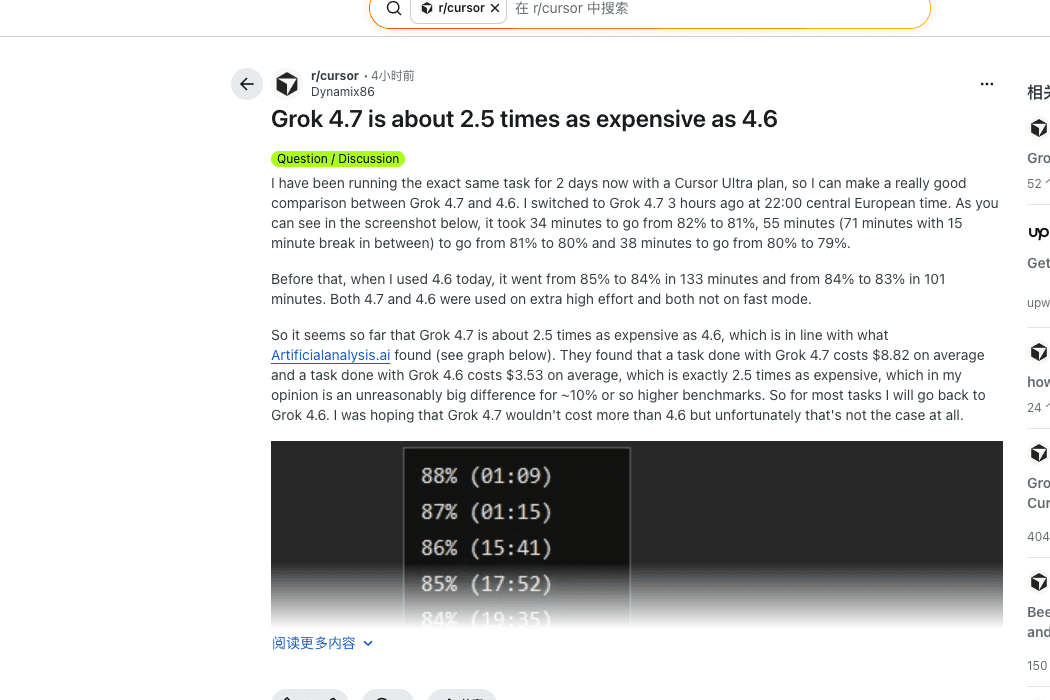
Dynamix86, sur Cursor Ultra, a conclu qu'en extra high et fast mode coupé, sur ce qu'il appelle la même tâche, Grok 4.7 rognait le pourcentage du forfait environ 2,5 fois plus vite que Grok 4.6. Il a aussi lu le graphique comme 8,82 dollars contre 3,53 par tâche. Le temps de forfait est le relevé de cette personne. La paire en dollars est une lecture du graphique, pas une mesure refaite dans cet avis.
xAI vend aussi une variante rapide au double du prix au token, et seulement dans Cursor et Grok Build. Elle n'est pas sur l'API publique. Le point de terminaison de la région des États-Unis ajoute 10 % sur l'usage. Si vous superposez « rapide » et un prompt long, le produit n'est plus celui à 2 et 6 dollars du titre.
La plupart des tâches de terminal difficiles échouent encore
Le Terminal-Bench 4.0 officiel, en xHigh, est à 38,0 %. Dans le même tableau, Fable 5.1 Max marque 57,9 % et Sol Max marque 37,3 %. Grok 4.7 dépasse les 20,3 % de Grok 4.6 High et rate quand même la plus grande partie de l'ensemble. HealthBench Professional marque 56,7 %, avec Fable à 62,1 % et Sol à 60,5 %. La case de l'agent juridique Harvey est à 19,6 %, bien au-dessus des 2,5 % de Sol, mais le chiffre absolu reste bas.
Un modèle entraîné pour tenir plusieurs heures peut échouer dans cette heure. Ne lisez pas « meilleur que 4.6 » comme « le travail est fini ».
Le pas de l'indice est petit, et l'effort se mélange facilement
46 contre 44 ne change pas un court échange, une traduction ni la correction d'un fichier. GPT-5.6 Sol max est déjà à 47 sur cet indice, avec un tarif plus élevé. Une équipe qui cherchait un saut général ne le trouve pas dans ce lancement. Comparer xhigh à high puis annoncer une large victoire, c'est lire l'étiquette confortable.
Le taux d'hallucination s'améliore à 29 % contre 34 % pour Grok 4.6 high, et la précision reste proche de 47 % contre 48 %. Moins d'erreurs dans une réponse fausse n'est pas la même chose que savoir davantage.
Ce que les gens ont vraiment dit
Les commentaires se séparent entre la facture et le ressenti. Aucun ne clôt un benchmark.
La facture
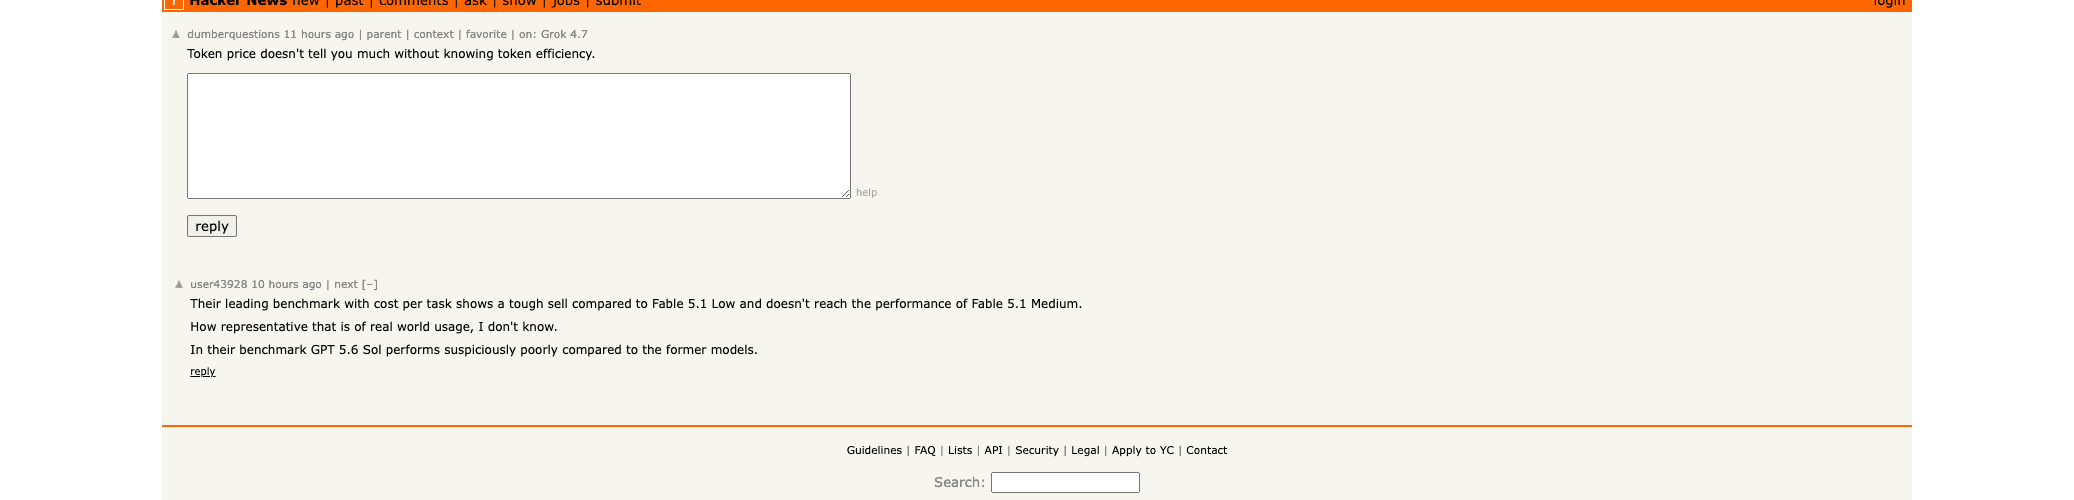
saejox a écrit, à propos d'un modèle plus cher au token qui en dépense moins, qu'Astra reste loin et cher, mais utilise moins de tokens.
Le ressenti
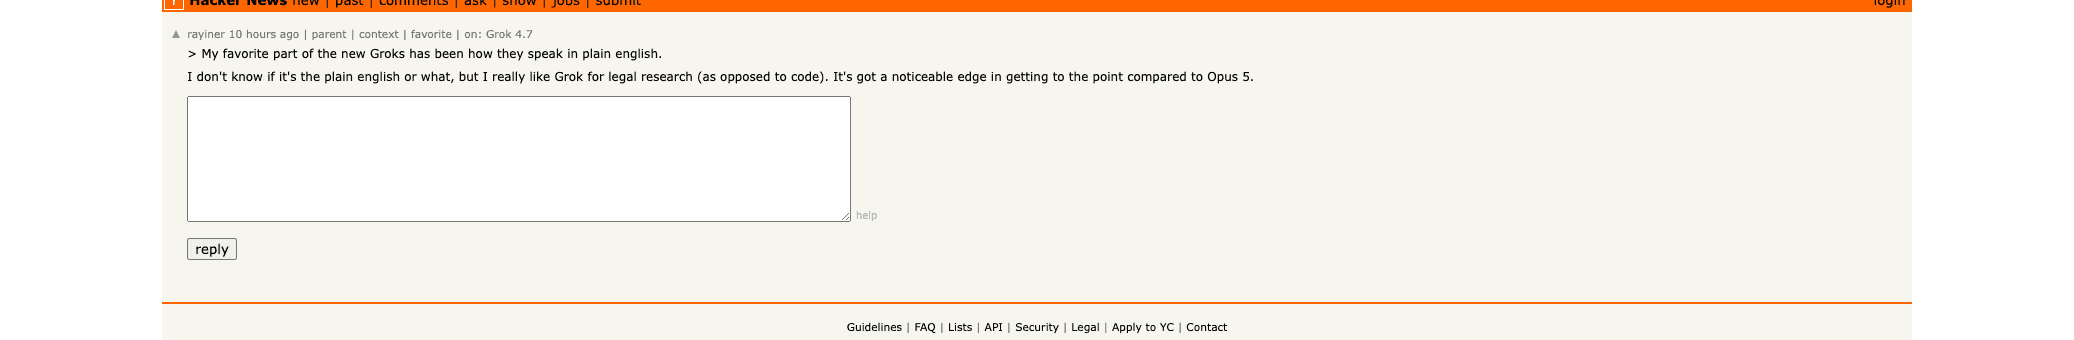
rayiner dit préférer Grok pour la recherche juridique, pas pour le code, parce qu'il arrive plus vite au fait qu'Opus 5. La phrase parle de la famille Grok récente, pas d'un dossier 4.7 déjà noté.
Le fil des premières impressions sur r/cursor, juste après la sortie, est la même fente en petit. vandersky_ a écrit que ce n'est pas aussi lent que 4.6. kodka a écrit que cela ressemble à un Opus 5 qui ne réfléchit pas trop. exploriosapp teste encore et trouve l'écriture meilleure. ImmediateAttention88 trouve SWE 2.0 de Devin et son API de fusion meilleurs, et utilise les deux. Personne n'a joint un dépôt, un niveau d'effort ni un chronomètre.
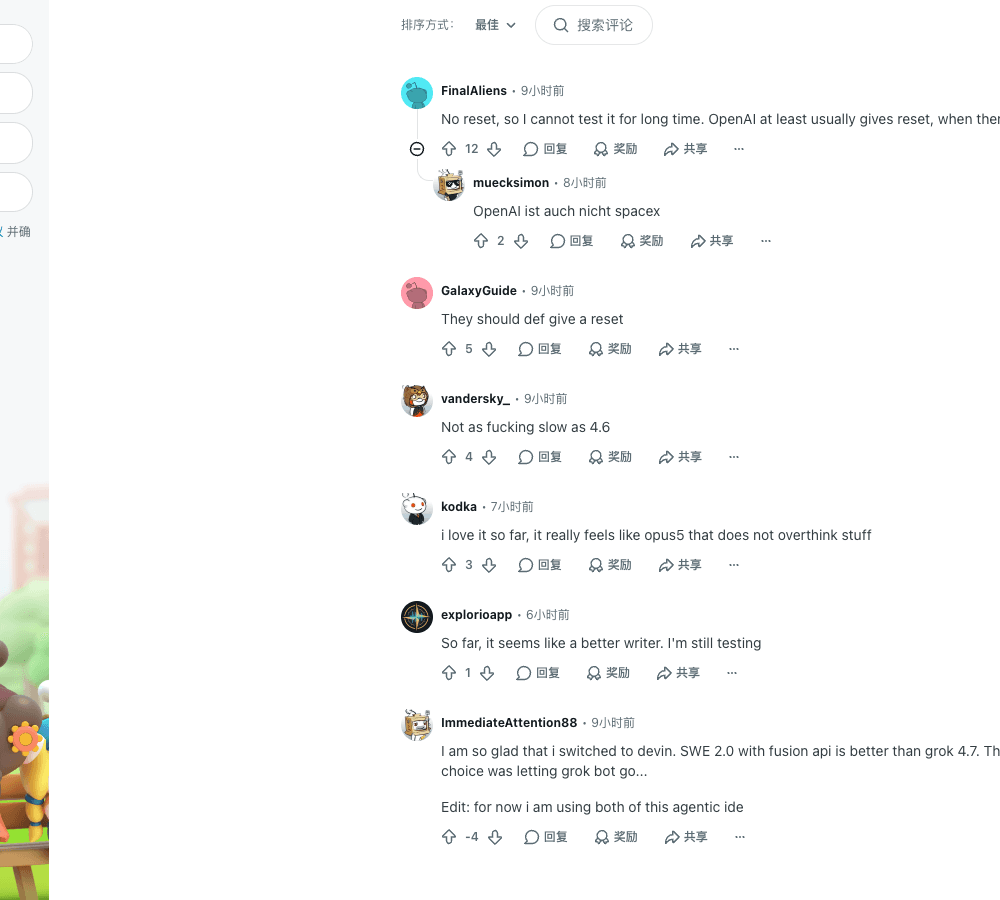
Fil.
Le jugement éditorial colle aux chiffres. Celui qui regarde le compteur est mécontent. Celui qui voulait un code moins traînant teste encore. Aucun des deux n'a publié un score répété.
Testez la forme du travail avant de croire une ligne
Une ligne de benchmark ne montre pas comment Grok 4.7 se comporte sur les pages déjà ouvertes. Tabbit Browser est le client pour cette vérification : le sélecteur de modèles, les pages ouvertes et les fichiers sont au même endroit. Le guide du navigateur IA et l'explication de Tabbit Browser décrivent cette disposition. La navigation agentique et l'automatisation du navigateur sont des travaux voisins. Si la question porte sur le navigateur et non sur le modèle, la liste des navigateurs IA de 2026 est là.
La limite est simple. Cet avis n'a pas lancé dans Tabbit une extraction fixe, une comparaison répétée ni une tâche de page chronométrée. Si Grok 4.7 n'est pas dans le sélecteur, le bouton ci-dessous ne crée pas d'accès. Les dollars d'API, le forfait Cursor et le compte Tabbit sont trois prix. Une réponse juste par hasard, même si elle avait été capturée, ne devient pas un taux de réussite.
Choisir selon le travail
| Travail | Utiliser Grok 4.7 ? | Pourquoi | À surveiller |
|---|---|---|---|
| Code long où 4.6 abandonne à mi-chemin | Oui. D'abord dans Grok Build ou Cursor, sous xhigh | Le plus gros gain des données publiques est dans l'agent de code | Pourcentage du forfait et tokens de sortie |
| Correction d'un fichier ou bavardage | Non | L'indice gagne deux points et le nombre de tokens saute | Rester sur 4.6 ou regarder un modèle plus petit dans l'avis Gemini 3.8 Flash |
| Notes, modèles et arguments de tableaux | Oui, si l'analyse est le livrable | L'Elo analytique a monté | Ne pas attendre que les diapositives s'améliorent |
| Un ensemble de terminal que Fable réussit déjà | Seulement si le prix écrase tout | Le Terminal-Bench officiel à 38 % rate encore la majorité | Ne pas mélanger les 33 % de Grok Build |
| Recherche juridique où la brièveté compte | Essayer, puis vérifier les sources | Un praticien aime le ton. Harvey n'est qu'à 19,6 % | Le ton n'est pas l'exactitude |
| Travail dans des onglets ouverts | L'essayer dans Tabbit seulement s'il est dans le sélecteur | Ce qui manque est le client, pas un score plus haut | Aucun taux de réussite n'est affirmé ici |
Grok 4.7 est la mise à jour lorsque le modèle précédent s'arrête et que vous pouvez payer les tokens en plus. Si le précédent finissait déjà le travail, cela devient une habitude chère.
 Tabbit Browser

Questions fréquentes
Faut-il passer de Grok 4.6 à Grok 4.7 ?
Seulement si un agent de code long ou un document d'analyse s'arrête à mi-chemin sur Grok 4.6, et si vous pouvez payer les tokens en plus. Le tarif reste à 2 dollars le million en entrée et 6 en sortie. Artificial Analysis a mesuré environ 81 000 tokens de sortie par tâche du classement en xhigh, contre environ 38 000 pour Grok 4.6 xhigh. Une petite correction de fichier n'a pas besoin de cette réflexion.
Si le prix au token n'a pas bougé, pourquoi dit-on que c'est plus cher ?
Le tarif et la facture sont deux chiffres. xAI facture comme pour Grok 4.6. Une mesure indépendante montre que les tokens de sortie en xhigh presque doublent. Un utilisateur de Cursor Ultra a noté que le pourcentage du forfait baissait plus vite en extra high, fast mode coupé. C'est le relevé d'un compte, pas une facture d'API.
Quel est l'écart avec Claude Fable 5.1 et GPT-6 Astra ?
Sur l'indice d'intelligence d'Artificial Analysis, Grok 4.7 xhigh marque 46. Claude Fable 5.1 et GPT-6 Astra marquent 53, GPT-5.6 Sol marque 47. L'indice d'agent de code de Grok Build et Grok 4.7 est à 56 ; Fable et Astra atteignent 62. Sur les tâches de bureau, l'Elo n'ouvre pas le même écart que l'indice général.
Qu'est-ce que Grok 4.7 Fast, et l'API le propose-t-elle ?
La documentation xAI décrit Grok 4.7 Fast comme la même famille servie plus vite, facturée au double du prix standard au token. Il n'existe que dans Cursor et Grok Build, hors quota gratuit de Grok Build et hors API publique xAI. Le nom public du modèle est grok-4.7.
Un CursorBench élevé veut-il dire qu'il gagne en code ?
Non. Sur le nuage de points xAI, Grok 4.7 Extra High atteint 46,3 % et environ 6,01 dollars par tâche ; Fable 5.1 Max atteint 51,8 % et environ 17,28 dollars. Le Terminal-Bench 4.0 officiel est à 38,0 %, donc la plupart de ces tâches de terminal échouent encore. Les 33 % de Grok Build sont un autre harness : ne les mélangez pas aux 38 % dans la même case.
Peut-on utiliser Grok 4.7 dans Tabbit Browser ?
La page Grok 4.7 de Tabbit indique qu'il est disponible lorsqu'il apparaît dans le sélecteur de modèles du compte. Cet avis n'a pas lancé de tâche fixe dans Tabbit, donc il ne rapporte ni taux de réussite, ni latence, ni coût côté client. Le prix d'API, le forfait Cursor et le compte Tabbit sont trois coûts distincts.