
Grok 4.7 es el modelo de código y trabajo de conocimiento que xAI publicó el 21 de septiembre de 2026. La pregunta no es si el gráfico de lanzamiento tiene una fila ganadora. Es si vale la pena dejar Grok 4.6 cuando también se cuentan los tokens que de verdad gasta.
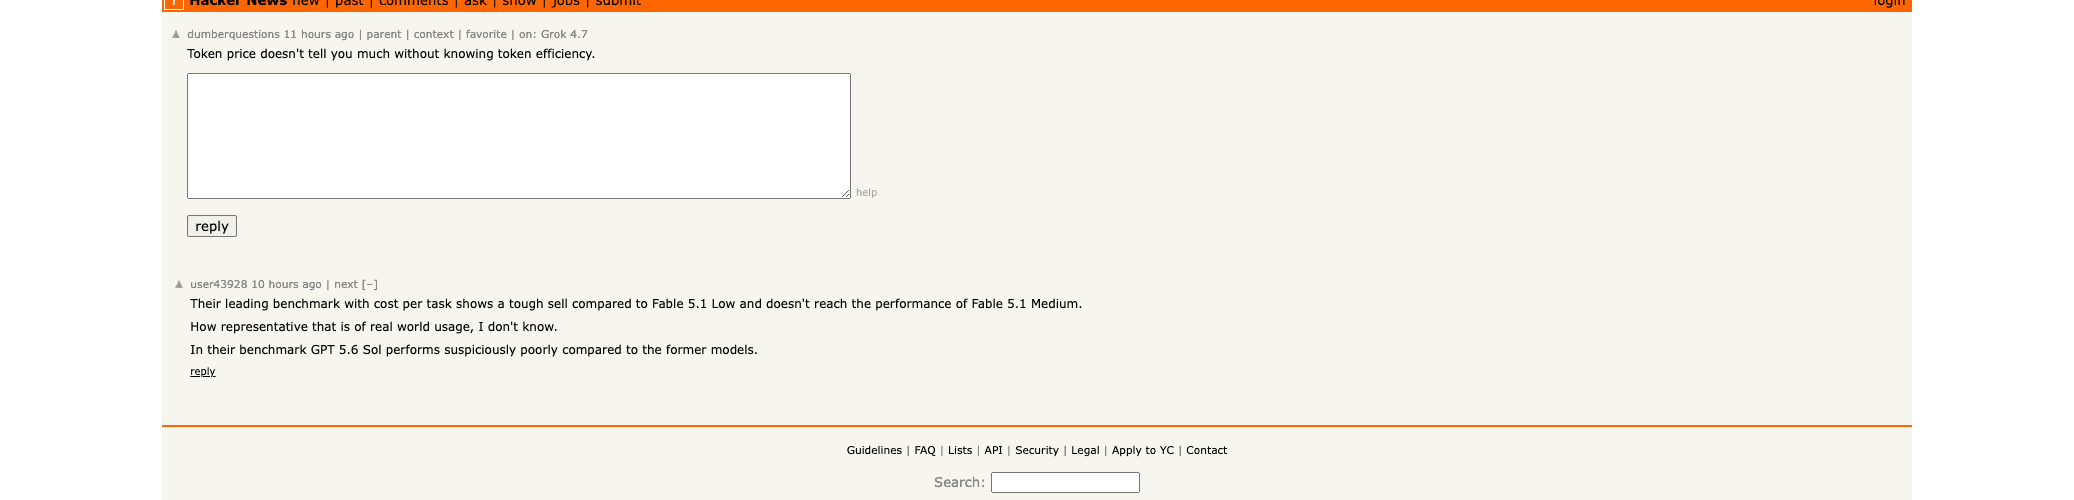
En Hacker News, dumberquestions resumió la trampa en una frase: el precio por token, solo, no dice nada de la eficiencia. Esta reseña es esa frase. La generación anterior está en la guía de Grok 4.6. La página de precios y la lista de alternativas todavía no existen en este sitio. Más abajo no hay un experimento controlado hecho en Tabbit Browser.
El número que parte esta reseña
El 22 de septiembre de 2026, al abrir las fuentes, dos cifras apuntaban en direcciones opuestas.
La página de lanzamiento anota Grok 4.7 xHigh a 2 dólares por millón de tokens de entrada y 6 de salida, la misma celda que Grok 4.6 High. La documentación de la API repite 2,00 y 6,00 dólares para grok-4.7.
Artificial Analysis midió que, en xhigh, Grok 4.7 gasta unos 81.000 tokens de salida por tarea del índice de inteligencia. Grok 4.6 xhigh gasta unos 38.000. En el mismo texto, Grok 4.6 high ronda los 36.000 y GPT-6 Astra max ronda los 27.000. La tarifa no se movió. El volumen sí.
El índice solo pasa de 44 en Grok 4.6 high a 46 en Grok 4.7 xhigh. El índice de agente de código en Grok Build se mueve más: 56 frente a 47. Si la respuesta es corta, estás pagando un pensamiento que no pediste. Si el modelo anterior se detenía a mitad del repositorio, esos tokens de más son la actualización.
Lo que conviene llevarse
La tarifa pública es la de Grok 4.6. El recuento de tokens en xhigh, en el índice de inteligencia, no lo es.
La ganancia más clara está en el agente. La puntuación de código de Grok Build sube nueve puntos, y la calidad analítica de los documentos también sube con fuerza.
El índice general solo suma dos puntos y, en ese gráfico, queda detrás de Claude Fable 5.1, GPT-6 Astra y GPT-5.6 Sol.
Las diapositivas van al revés. El Elo analítico sube y el Elo de presentación baja.
El consumo del plan de Cursor y los dólares de la API son tableros distintos. Un usuario de Ultra vio que el plan se gastaba rápido. Eso no cambia la tarifa de la API.
Los benchmarks, y hasta dónde creerlos
Cada fila tiene su propio harness. El porcentaje de Terminal-Bench en la tabla de xAI no es el porcentaje de Grok Build.
| Señal | Grok 4.7 | Comparación | Condición, comprobada el 2026-09-22 |
|---|---|---|---|
| Tarifa | $2 / $6 por millón | Igual que Grok 4.6. Sol Max $4 / $20. Fable Max $10 / $50 | Tabla de lanzamiento de xAI, columna xHigh |
| Modelo de API | grok-4.7 | Contexto de 500.000. Por defecto, high. Existe xhigh | Vista rápida de docs.x.ai |
| Índice de inteligencia | 46 | Grok 4.6 high 44. Sol max 47. Fable 5.1 y Astra 53 | Artificial Analysis, xhigh |
| Salida por tarea | unos 81k | Grok 4.6 xhigh unos 38k. Astra max unos 27k | El mismo artículo. No es una factura |
| Índice de agente de código | 56 | Grok 4.6 xhigh en Grok Build: 47. Fable y Astra: 62 | Harness nativo |
| Elo de AA-Briefcase | 1.657 | Grok 4.6 high 1.546. Fable 5.1 1.678 | 4.7 en xhigh; el lado 4.6 en high |
| Análisis frente a diapositivas | 1.994 / 1.499 Elo | Grok 4.6 high 1.690 / 1.519 | El análisis sube; la presentación baja |
| CursorBench 4.0 | 46,3 %, unos $6,01 por tarea | Fable 5.1 Max 51,8 %, unos $17,28 | Gráfico de xAI, Extra High |
| Terminal-Bench 4.0 | 38,0 % | Grok 4.6 High 20,3 %. Sol Max 37,3 %. Fable Max 57,9 % | Tabla de xAI, columna xHigh |
| Terminal-Bench en Grok Build | 33 % | Grok 4.6 xhigh 18 % | Artificial Analysis. No promediar con el 38 % |
Encima de la tabla hay tres límites.
El esfuerzo no coincide. Varias frases del tipo “4.7 venció a 4.6” comparan xhigh con high. El par 81k frente a 38k es más limpio: ambos lados están en xhigh. Los dos puntos extra del índice no son ese par.
El harness cambia la historia. El índice de código incluye Grok Build. El índice de inteligencia usa un harness común. La celda de Terminal-Bench de xAI es 38,0 %. Artificial Analysis anota 33 % dentro de Grok Build, con una base de 18 %. El 26 % de The Decoder es un tercer pie de foto y no se usa aquí.
El gráfico del proveedor elige a sus rivales. El de CursorBench en la página de lanzamiento muestra a Fable, Opus, Sol y Sonnet. GPT-6 Astra no aparece. Un coste por tarea más bajo en ese gráfico no es una victoria sobre Astra. Un benchmark es una dirección, no una nota.
No hay un registro de tarea en Tabbit delante de esta tabla. Las secciones siguientes usan solo mediciones públicas y comentarios con nombre.
Dónde de verdad mejora
El análisis mejoró. Las diapositivas, no
Lo llamativo no es el 46 del índice. En AA-Briefcase, la calidad analítica pasa de 1.690 Elo en Grok 4.6 high a 1.994 en Grok 4.7, y la calidad de presentación pasa de 1.519 a 1.499. Artificial Analysis repite esa grieta en una publicación del 22 de septiembre. El Elo analítico Lite va de 1.698 a 1.994 y el de presentación de 1.531 a 1.499. Las bases de 4.6 en los dos textos no son el mismo par. Ambos dicen que la prosa analítica mejora y que el cierre de una presentación no.
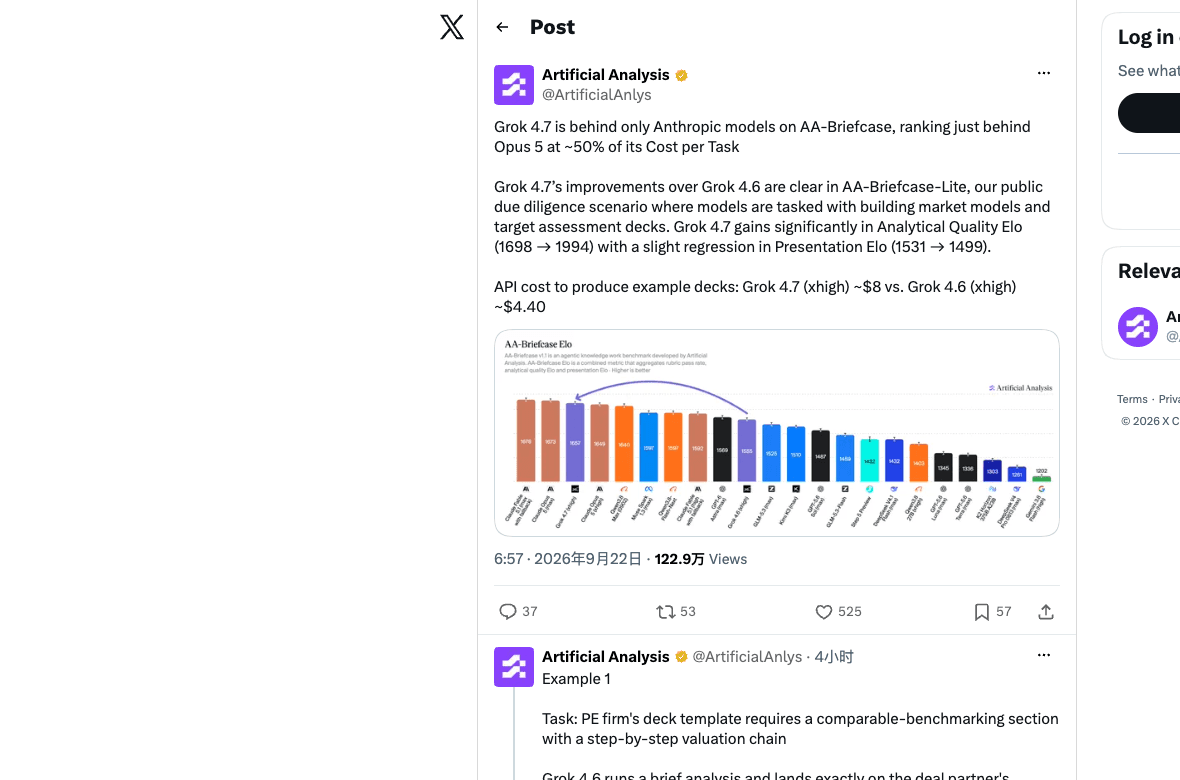
Si el entregable es un modelo de mercado, un memorando o un argumento en hoja de cálculo, esa grieta importa más que dos puntos de índice. Si el entregable es una presentación pulida, este dato no justifica celebrar a Grok 4.7.
El agente de código en Grok Build se movió más que el índice
Dentro de Grok Build, Artificial Analysis anota DeepSWE v1.1 en 73 % frente a 65 %, Terminal-Bench 4.0 en 33 % frente a 18 % y SWE-Atlas-QnA en 63 % frente a 58 %. El rival en cada caso es Grok 4.6 xhigh. La suma es 56, el cuarto puesto entre los harness nativos que dibujan, detrás de Fable 5.1 y GPT-6 Astra.
Para un bucle de código largo es un paso real. Sigue siendo una puntuación de sistema. El modelo llega con Grok Build pegado. No significa que una llamada a la API grok-4.7 en high por defecto, y no en xhigh, supere las mismas tareas. La diferencia entre un bucle y una sola respuesta está al lado, en la explicación del razonamiento agéntico.
La tarifa sigue en la celda barata de los modelos de punta
En el gráfico de CursorBench de xAI, Grok 4.7 Extra High marca 46,3 % y unos 6,01 dólares por tarea. Fable 5.1 Max marca 51,8 % y unos 17,28 dólares. Grok 4.7 High marca 43,9 % a unos 4,69 dólares, y Low marca 33,1 % a unos 1,58 dólares. Puedes comprar una puntuación más baja por mucho menos que el tope de Fable, o comprar la puntuación alta de Fable. Son compras distintas. El lado caro está en la reseña de Fable 5.1 y en la reseña de GPT-6 Astra.
Dónde muerde
Muerde la factura de tokens, no la tarifa
Unos 81.000 tokens de salida a 6 dólares por millón son unos 0,49 dólares solo de salida, antes de la entrada, la caché, las herramientas y los reintentos. Unos 38.000 son unos 0,23 dólares. Solo se usaron los recuentos de salida que imprimió Artificial Analysis. No es tu factura.
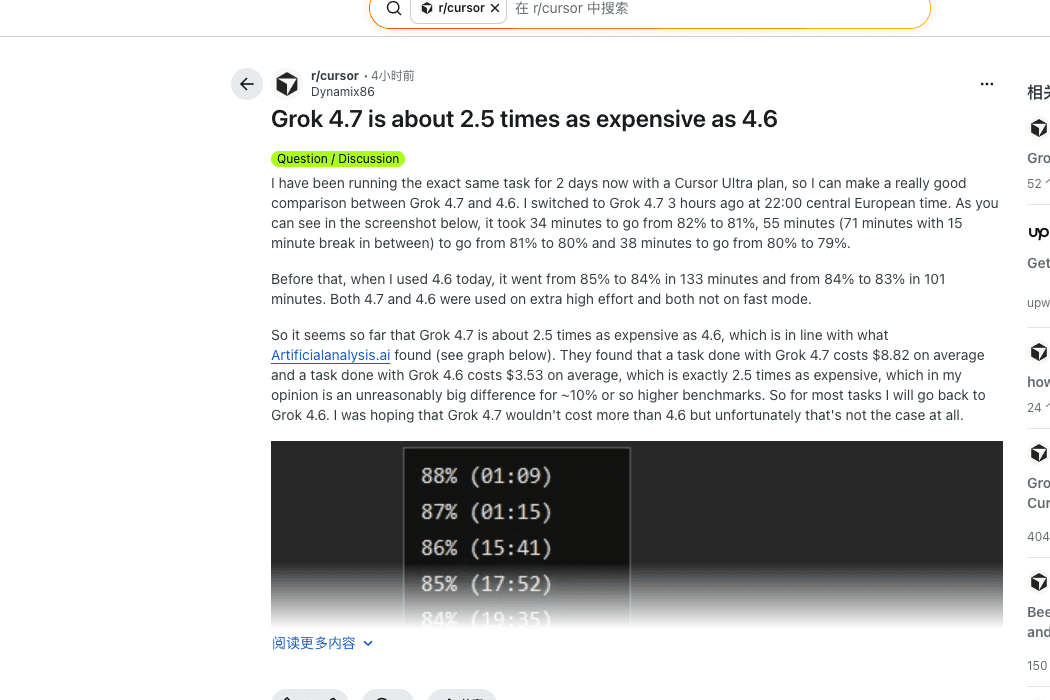
Dynamix86, en Cursor Ultra, concluyó que con extra high y fast mode apagado, en lo que llama la misma tarea, Grok 4.7 recortaba el porcentaje del plan unas 2,5 veces más rápido que Grok 4.6. También leyó el gráfico como 8,82 dólares frente a 3,53 por tarea. El tiempo del plan es el registro de esa persona. El par en dólares es una lectura del gráfico, no una medición repetida en esta reseña.
xAI también vende una variante rápida al doble del precio por token, y solo en Cursor y Grok Build. No está en la API pública. El endpoint de la región de Estados Unidos añade un 10 % sobre el uso. Si juntas “rápido” con un prompt largo, el producto ya no es el de 2 y 6 dólares del título.
La mayoría de las tareas difíciles de terminal siguen fallando
El Terminal-Bench 4.0 oficial, en xHigh, es 38,0 %. En la misma tabla, Fable 5.1 Max marca 57,9 % y Sol Max marca 37,3 %. Grok 4.7 queda por encima del 20,3 % de Grok 4.6 High y aun así falla la mayor parte del conjunto. HealthBench Professional marca 56,7 %, con Fable en 62,1 % y Sol en 60,5 %. La celda del agente jurídico Harvey es 19,6 %, muy por encima del 2,5 % de Sol, pero el número absoluto sigue siendo bajo.
Un modelo entrenado para aguantar varias horas puede fallar dentro de esa hora. No leas “mejor que 4.6” como “el trabajo ya está hecho”.
El paso del índice es pequeño y es fácil mezclar el esfuerzo
46 frente a 44 no cambia un chat corto, una traducción ni el arreglo de un archivo. GPT-5.6 Sol max ya está en 47 en ese índice, con una tarifa más alta. Un equipo que buscaba un salto general no lo encuentra en este lanzamiento. Comparar xhigh con high y luego anunciar una victoria amplia es leer la etiqueta cómoda.
La tasa de alucinación mejora a 29 % frente al 34 % de Grok 4.6 high, y la precisión se queda cerca de 47 % frente a 48 %. Menos errores dentro de una respuesta incorrecta no es lo mismo que saber más.
Lo que la gente dijo de verdad
Los comentarios se parten entre la factura y la sensación al usarlo. Ninguno cierra un benchmark.
La factura
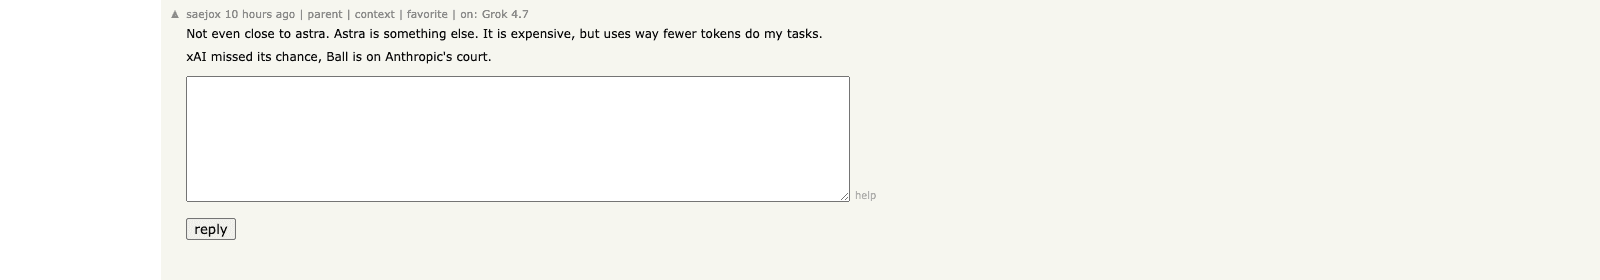
saejox escribió, a propósito de un modelo más caro por token que gasta menos, que Astra sigue lejos y es caro, pero usa menos tokens.
La sensación
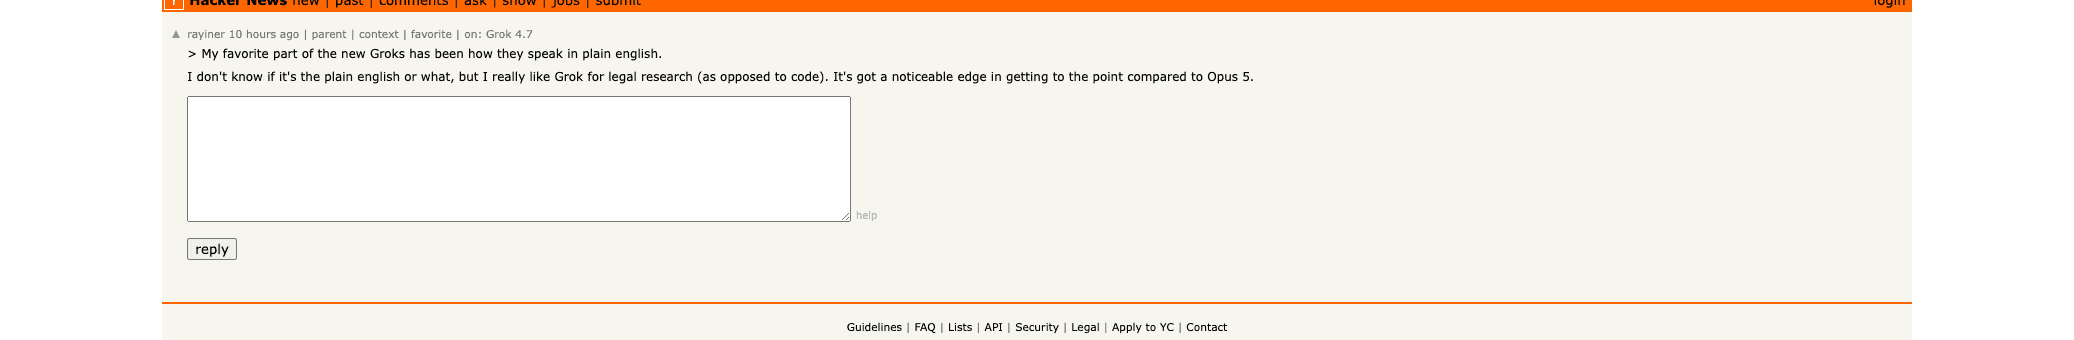
rayiner dice que prefiere Grok para investigación jurídica, no para código, porque llega antes al punto que Opus 5. La frase habla de la familia reciente de Grok, no de un expediente 4.7 ya puntuado.
El hilo de primeras impresiones en r/cursor, justo después del lanzamiento, es la misma grieta en pequeño. vandersky_ escribió que no es tan lento como 4.6. kodka escribió que parece un Opus 5 que no piensa de más. exploriosapp sigue probándolo y dice que la escritura se ve mejor. ImmediateAttention88 ve mejor a SWE 2.0 de Devin y a su API de fusión, y usa los dos. Nadie subió un repositorio, un nivel de esfuerzo ni un cronómetro.
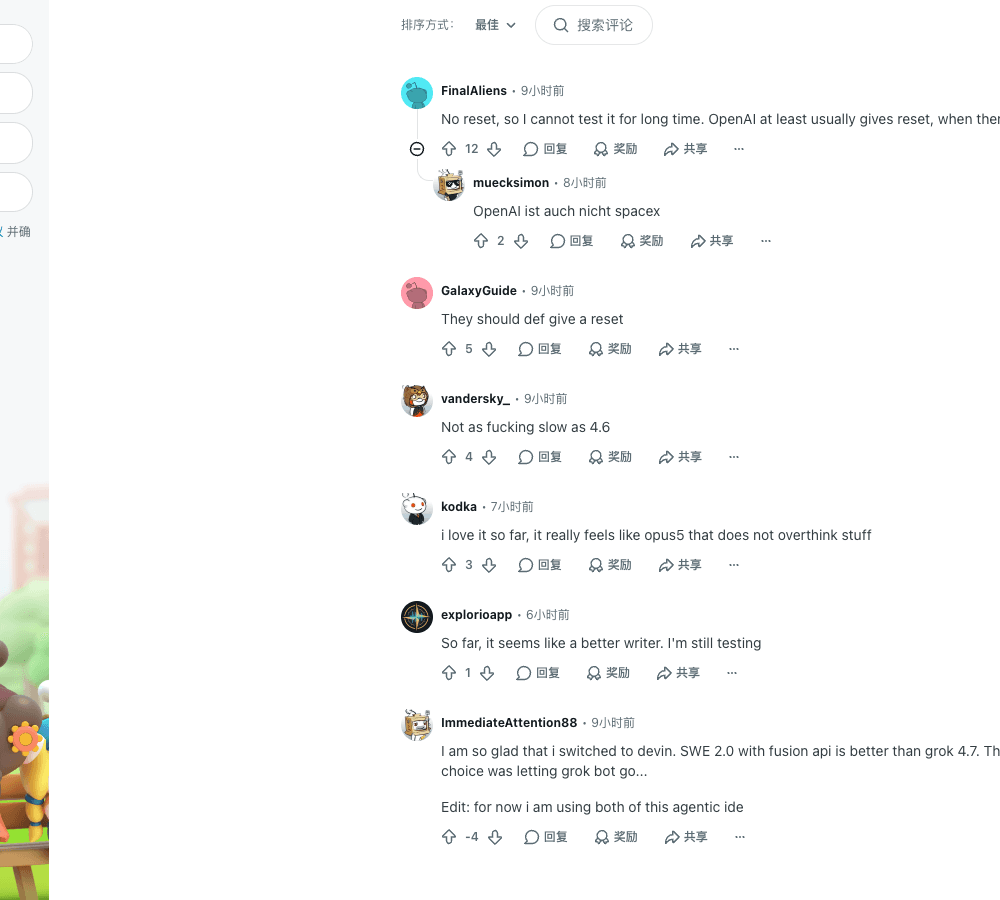
Hilo.
El juicio editorial encaja con los números. Quien mira el contador está molesto. Quien quería que el código se arrastrara menos sigue probando. Ninguno de los dos subió una puntuación repetida.
Prueba la forma del trabajo antes de fiarte de una fila
Una fila de benchmark no muestra cómo se porta Grok 4.7 en las páginas que ya tienes abiertas. Tabbit Browser es el cliente para esa comprobación: el selector de modelos, las páginas abiertas y los archivos están en el mismo sitio. La guía del navegador con IA y la explicación de Tabbit Browser describen esa disposición. La navegación agéntica y la automatización del navegador son trabajos vecinos. Si la pregunta es el navegador y no el modelo, está la lista de navegadores con IA de 2026.
El límite es simple. Esta reseña no ejecutó en Tabbit una extracción fija, una comparación repetida ni una tarea de página cronometrada. Si Grok 4.7 no está en el selector, el botón de abajo no crea acceso. Los dólares de la API, el plan de Cursor y la cuenta de Tabbit son tres precios. Una respuesta que acierta por casualidad, aunque se hubiera capturado, no se convierte en una tasa de éxito.
Elegir según el trabajo
| Trabajo | ¿Usar Grok 4.7? | Por qué | Qué vigilar |
|---|---|---|---|
| Código largo en el que 4.6 se rinde a mitad | Sí. Primero en Grok Build o Cursor, por debajo de xhigh | La mayor ganancia de los datos públicos está en el agente de código | Porcentaje del plan y tokens de salida |
| Arreglo de un archivo o charla | No | El índice suma dos puntos y el recuento de tokens salta | Quedarse en 4.6 o mirar un modelo más pequeño en la reseña de Gemini 3.8 Flash |
| Memorandos, modelos y argumentos en tablas | Sí, si el análisis es el entregable | El Elo analítico subió | No esperar que las diapositivas mejoren |
| Un conjunto de terminal que Fable ya aprueba | Solo si el precio lo aplasta todo | El Terminal-Bench oficial del 38 % sigue fallando la mayoría | No mezclar el 33 % de Grok Build |
| Investigación jurídica donde importa la brevedad | Probar y luego comprobar las fuentes | A un profesional le gusta el tono. Harvey solo marca 19,6 % | El tono no es exactitud |
| Trabajo dentro de pestañas abiertas | Probarlo en Tabbit solo si está en el selector | Lo que falta es el cliente, no una puntuación más alta | No se afirma aquí una tasa de éxito |
Grok 4.7 es la actualización cuando el modelo anterior se detiene y puedes pagar los tokens de más. Si el anterior ya terminaba el trabajo, se convierte en un hábito caro.
 Tabbit Browser

Preguntas frecuentes
¿Merece la pena pasar de Grok 4.6 a Grok 4.7?
Solo si un agente de código largo o un documento analítico se queda a medias en Grok 4.6 y puedes pagar los tokens extra. La tarifa sigue en 2 dólares por millón de entrada y 6 de salida. Artificial Analysis midió unos 81.000 tokens de salida por tarea del índice en xhigh, frente a unos 38.000 de Grok 4.6 xhigh. Un arreglo corto de un archivo no necesita ese pensamiento.
Si el precio por token no cambió, ¿por qué dicen que salió más caro?
La tarifa y la factura son números distintos. xAI cobra lo mismo que por Grok 4.6. Una medición independiente muestra que los tokens de salida en xhigh casi se duplican. Un usuario de Cursor Ultra anotó que el porcentaje del plan bajaba más rápido con extra high y fast mode apagado. Es el registro de una cuenta, no una factura de API.
¿Cuánto se aleja de Claude Fable 5.1 y de GPT-6 Astra?
En el índice de inteligencia de Artificial Analysis, Grok 4.7 xhigh marca 46. Claude Fable 5.1 y GPT-6 Astra marcan 53, y GPT-5.6 Sol marca 47. El índice de agente de código de Grok Build y Grok 4.7 es 56; Fable y Astra llegan a 62. En las tareas de oficina el Elo no abre la misma brecha que el índice general.
¿Qué es Grok 4.7 Fast y se puede usar por API?
La documentación de xAI describe Grok 4.7 Fast como la misma familia servida más rápido, facturada al doble del precio estándar por token. Solo está en Cursor y Grok Build, fuera de la cuota gratuita de Grok Build y fuera de la API pública de xAI. El nombre público del modelo es grok-4.7.
¿Un CursorBench alto significa que gana en código?
No. En el gráfico de xAI, Grok 4.7 Extra High llega al 46,3 % y unos 6,01 dólares por tarea; Fable 5.1 Max llega al 51,8 % y unos 17,28 dólares. El Terminal-Bench 4.0 oficial es 38,0 %, así que la mayoría de esas tareas de terminal siguen fallando. El 33 % de Grok Build es otro harness: no lo mezcles con el 38 % en la misma celda.
¿Se puede usar Grok 4.7 en Tabbit Browser?
La página de Grok 4.7 en Tabbit dice que está disponible cuando aparece en el selector de modelos de la cuenta. Esta reseña no ejecutó una tarea fija en Tabbit, así que no informa tasa de éxito, latencia ni coste en el cliente. El precio de API, el plan de Cursor y la cuenta de Tabbit son tres costes distintos.