
Gemini 3.8 Flash 值得為長流程、工具呼叫和多模態工作做一次認真試用,但它不是人人都更好的模型。Google 將它定位為軟體工程、自主 Agent 和複雜企業工作流的 Flash 工作模型。公開資料支持的是「有條件升級」:high 的獨立快照表現不錯,但各層級的延遲資料並不完整,不能把單一數字延伸成普遍結論。
反直覺錨點:medium 每項任務便宜 25%,指數只低 1 分
Artificial Analysis 顯示 high 每項 Intelligence Index 任務為 1.24 美元,medium 為 0.93 美元。medium 便宜 25%,計算為 (1.24 - 0.93) / 1.24,但指數是 40 對 41。這是有日期的基準快照,不能解讀為統計等價,也不能保證生產成本;只表示值得先測 medium。
判斷方式很簡單:先找出工作瓶頸。需要持續規劃、大型輸入或反覆工具呼叫時,可以先試 Gemini 3.8 Flash;若首響、固定成本或客戶端支援才是硬條件,就把更快或更便宜的模型放入對照。本文結合公開證據與一次 Tabbit 測試帳戶擷取樣例。後文會說明 Tabbit Browser 作為瀏覽器上下文工具的適用邊界。
重點結論
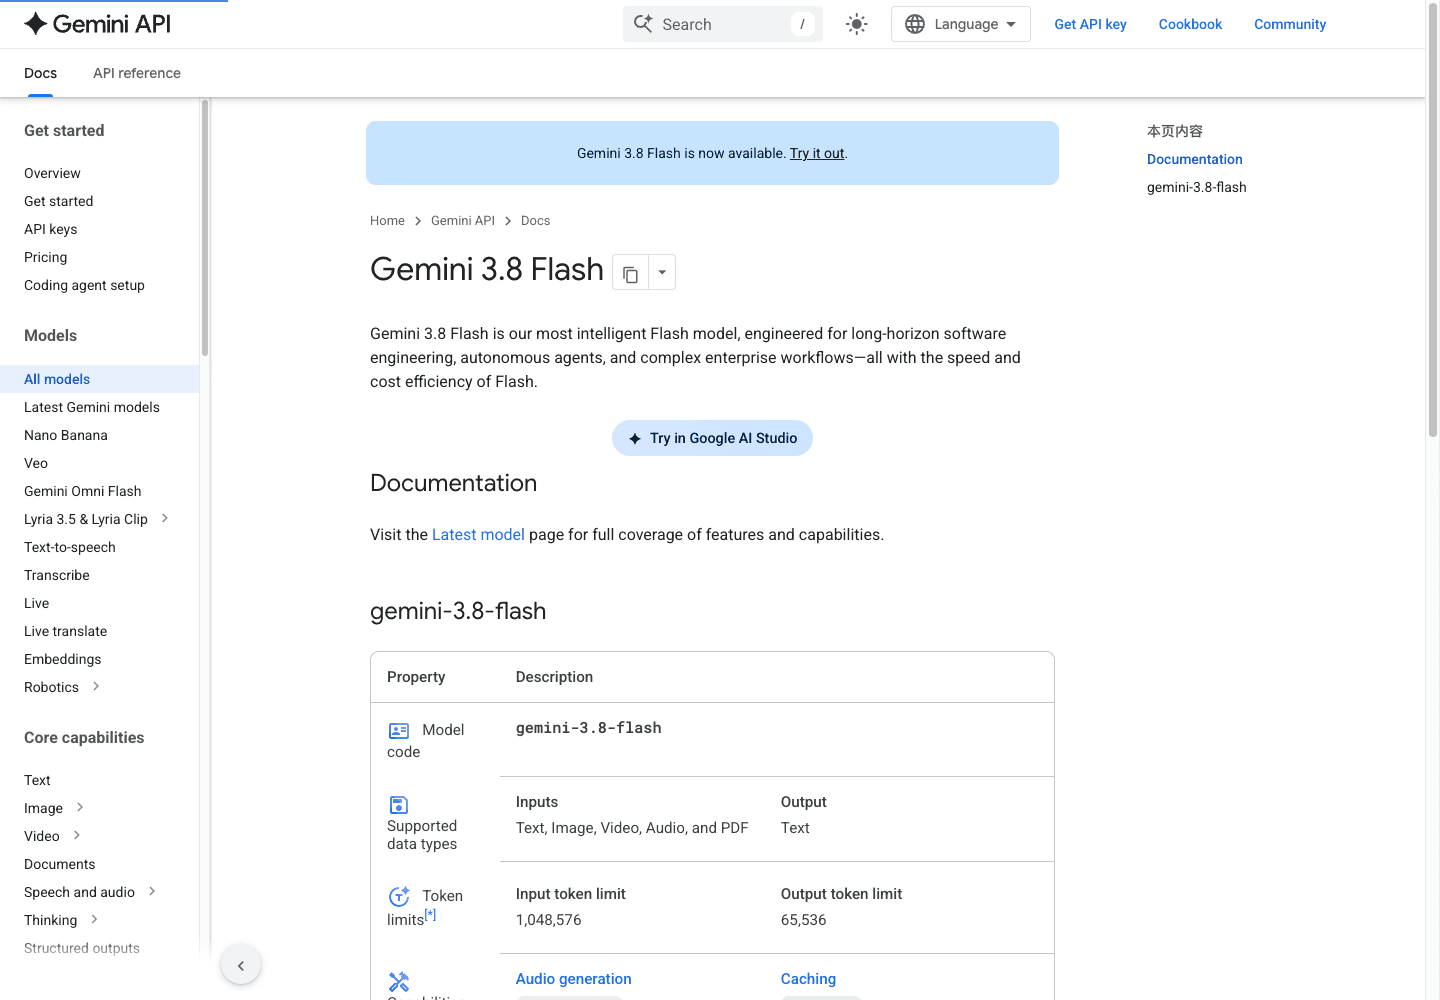
Gemini 3.8 Flash 是穩定 API 模型,接受文字、圖片、影片、音訊和 PDF,輸出文字;輸入上限 1,048,576 token,輸出上限 65,536 token。Google 模型文件
thinking 支援 low、medium、high,不支援 minimal。Google 將 thinking tokens 算入輸出價格,因此更高推理可能帶來更好完成度,也會提高用量。
2026-09-20 的 Artificial Analysis v4.3.2 快照中,high 為 41、305 output tokens/s、每項指數任務 1.24 美元;medium 為 40 和 0.93 美元;low 為 33。未知欄位不能填成零。
條件與方法
一個 Tabbit 抽取樣例:先看產品路徑,再看排行榜
2026 年 9 月 20 日,編輯測試帳戶在 Tabbit Browser 中用 Gemini 3.8 Flash 執行一次合成抽取任務。回傳 JSON 的四個欄位均符合預期,缺少狀態的記錄也沒有被算成逾期。查看樣例截圖。
{"currency":"USD","paid_total":145,"overdue_ids":["B"],"unknown_status_ids":["D"]}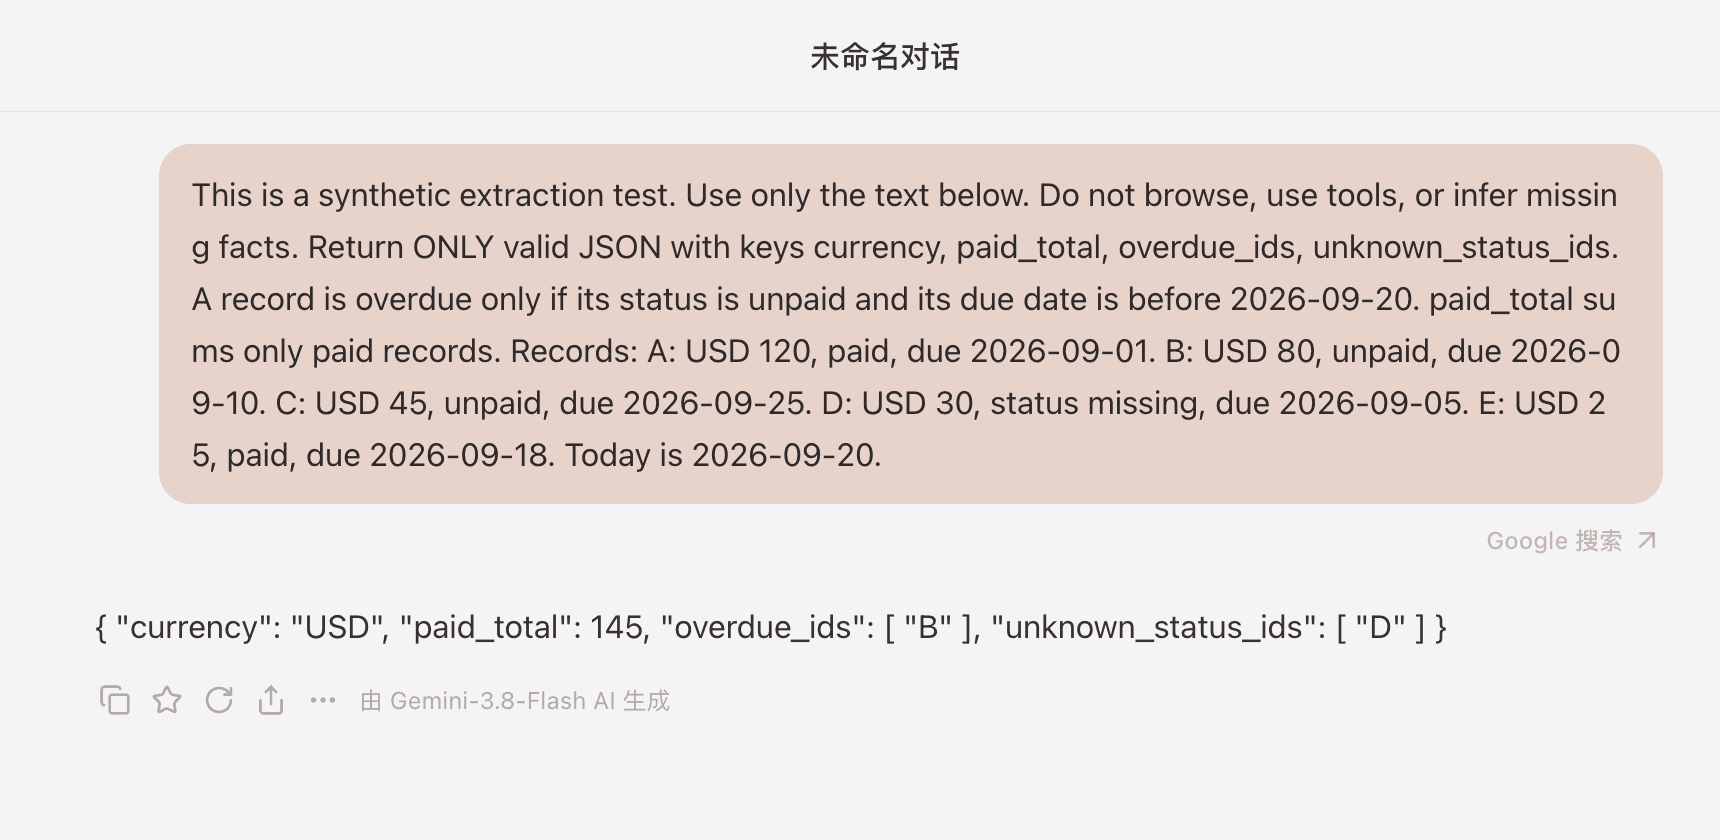
這是一次結構化輸出樣例,不是作者親測基準。沒有測量推理層級、API 版本、token、成本、first-token latency 或成功率;介面同時顯示 Google 搜尋標記,因此不能證明關閉工具或沒有發出搜尋請求,也不能證明所有帳戶都能使用。
公開基準可以參考,但不能過度解讀
| 推理層級 | 版本與日期 | Intelligence Index | 輸出速度 | 每項指數任務成本 | first-token latency | 可支持的判斷 |
|---|---|---|---|---|---|---|
| High | v4.3.2,2026-09-20 | 41 | 305 token/s | $1.24 | 未知 | high 快照表現強,且頁面提供生成速度。 |
| Medium | v4.3.2,2026-09-20 | 40 | 未知 | $0.93 | 未知 | 這個快照的指數接近 high,任務成本較低。 |
| Low | v4.3.2,2026-09-20 | 33 | 未知 | 未知 | 未知 | 指數較低,速度與成本沒有公開。 |
305 token/s 是產生輸出的速度,不是首 token 延遲。頁面沒有數字 first-token latency,所以本文不宣稱首響優勢。Google 的發布文稱 3.8 在軟體工程、Agent 和多步推理上比 3.7 有改善,但這是廠商說法。需要發布背景可看 總覽文章。
medium 每項 Intelligence Index 任務成本比 high 低 25%,計算為 (1.24 - 0.93) / 1.24,但指數只低 1 分(40 對 41)。這是快照,不能解讀為統計等價或生產成本保證,只表示值得先測 medium。
優勢與限制
官方列出 function calling、code execution、file search、structured outputs、URL context 和 computer use preview。這讓它適合「讀資料、規劃、呼叫工具、檢查結果」的工作。不同 SDK、訂閱和瀏覽器客戶端可能只暴露其中一部分。
它接受文字、圖片、影片、音訊和 PDF,API 輸入上限為 1,048,576 token,適合文件密集分析;輸出是文字,模型頁沒有列出圖片或音訊生成。對於分類或短改寫,更高推理未必能抵銷等待與 token 成本。
三項優勢與三項限制
工具呼叫工作流
官方工具適合「讀取—規劃—呼叫—檢查」任務,但客戶端未必開放全部工具。
大型輸入與混合媒體
API 支援文字、圖片、影片、音訊和 PDF,輸入上限為 1M token;客戶端限制和抽取品質仍需驗證。
結構化輸出:有條件的單次樣例
Tabbit 樣例回傳預期四欄 JSON並保留未知狀態。Google 搜尋標記和單次樣例都不支持更廣泛的結論。
Thinking token 會增加任務成本
Google 將 thinking token 計入輸出價格。medium 快照每項任務便宜 25%,但不代表生產成功任務也便宜 25%。
不用缺失延遲資料承諾首響
當前頁面沒有可用的首 token 延遲測量。305 output token/s 只描述生成速度,不能承諾首響。
客戶端與生產範圍要分開判斷
API 規格、Tabbit 選項和一次測試帳戶樣例,不能證明所有客戶端、地區或生產路徑支援相同模型和工具。
四條 Hacker News 原聲說明了什麼
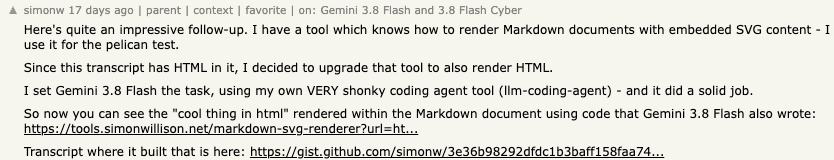
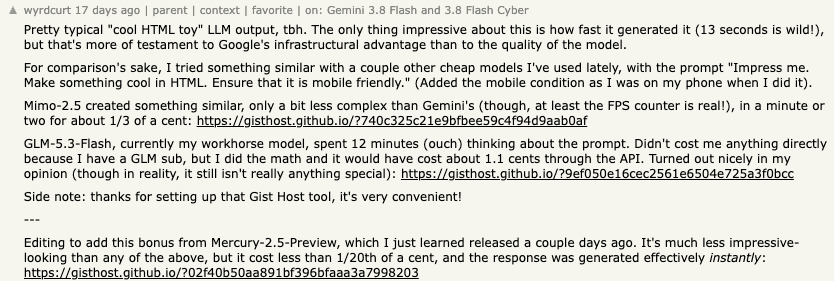

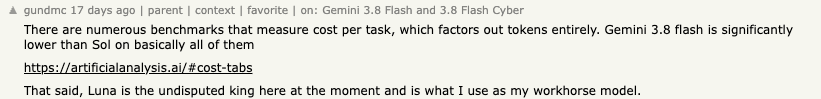
已開啟的 Hacker News 原帖呈現混合回饋,只能說明個人工作流和偏好,不能證明普遍能力、速度、成本或可用性。simonw 說模型在自己的 coding-agent 工具中完成不錯的 HTML 渲染;wyrdcurt 認為結果只是常見的「cool HTML toy」,並提到舊討論中的 13 秒生成,這不是當前 first-token latency;robertwt7 認為非編碼任務有用,但在澳洲仍卡在舊版 Flash,這是單一帳戶的存取觀察;gundmc 指向按任務成本的基準,同時表示另一模型仍是主力,這是偏好而非可重現成本結果。
這些原聲支持有限結論:具體工作流可能有效,但價值取決於任務、路徑和對照模型,不能推出「普遍最好」。
Tabbit Browser 的實測邊界
一次記錄的 Tabbit 樣例在合成抽取任務中回傳預期的四欄 JSON,也正確保留未知狀態。介面顯示 Google 搜尋標記,因此不能證明無工具執行;同時沒有測量 first-token latency、token、成本、推理層級或長期可靠性。它是可重現樣例,不是所有帳戶的生產保證。
從提示詞與工作流程 (简体中文)選擇可重現任務,在測評來源 (简体中文)核對證據。
 Tabbit Browser
按工作負載選擇
| 工作負載或限制 | 建議 | 先試層級 | 理由 | 主要注意事項 |
|---|---|---|---|---|
| 多檔案程式設計、工具呼叫、反覆除錯 | 值得試 | medium,再試 high | 定位和演示都面向長流程 Agent | 記錄測試通過、重試和總 token |
| PDF、圖片、影片或音訊分析 | 路徑支援時試用 | medium | 輸入類型廣且 API 視窗大 | 客戶端上限仍需確認 |
| 短改寫、分類、高量例行文字 | 先比輕量模型 | low | 高推理可能增加費用卻不改變答案 | low 成本在快照中未知 |
| 首響是硬指標 | 不要假設 3.8 Flash 勝出 | low 或替代品 | first-token latency 未公開 | 輸出速度不等於 first-token latency |
| 固定月預算 | 先設定 token 與重試上限 | low/medium | 輸出包含 thinking tokens | API、訂閱、Tabbit 費用口徑不同 |
| 多頁瀏覽研究 | 即時路徑可用時把 Tabbit 當上下文層 | 依客戶端而定 | 標籤組織能減少切換 | Tabbit 推理和生產存取未核實 |
做決定前,可繼續看 Gemini 3.8 Flash 替代品、定價分析、模型資源頁 (简体中文) 和 瀏覽器自動化。
結論:先做小型試點
Gemini 3.8 Flash 是困難、多模態、工具使用工作流的可信候選。最強證據不是「每項基準都第一」,而是廣泛輸入、工具和三個推理層級的組合,以及 high 快照的 41 指數。最重要的限制是各層級速度和成本資料不完整,高推理可能增加輸出用量。
切換預設模型前,選兩個真實任務,先定義成功,重複執行以暴露重試,記錄完成時間、修正、token 和總成本,再與目前模型用相同提示詞與工具比較。若完成品質抵得過額外成本,就讓 3.8 負責這類任務;否則將例行任務交給其他模型。可繼續閱讀 替代品指南、模型資源頁 (简体中文) 和 AI 瀏覽器選擇。

常見問題
Gemini 3.8 Flash 值得使用嗎?
它值得用於需要持續規劃、工具呼叫或多模態輸入的任務,前提是完成品質比完全可預測的延遲更重要。公開證據不足以證明它適合所有工作,高推理層級也可能增加 token 用量。
如何解讀 Gemini 3.8 Flash 的基準結果?
必須同時保留版本、推理層級、指標和日期。2026 年 9 月 20 日查看的 Artificial Analysis v4.3.2 快照中,high 為 41、305 output tokens/s、每項指數任務 1.24 美元,其他未顯示欄位保持未知。
更高推理會使用更多 token 嗎?
Google 將 thinking tokens 計入 output 價格,因此更高層級可能改善困難任務,也可能提高用量與成本。模型頁支援 low、medium、high,不支援 minimal。
305 tokens/s 等於首字回應很快嗎?
不等於。這是生成速度,不是 first-token latency。已查看頁面沒有提供 first-token latency 數值,不能據此判斷使用者等待首字的時間。
Gemini 3.8 Flash 可以在 Tabbit Browser 使用嗎?
一次 Tabbit Browser 測試在合成抽取任務中回傳預期的四欄 JSON。介面同時顯示 Google 搜尋標記,因此不能據此證明無工具執行、生產可用性、延遲、成本或普遍可靠性。
誰不適合使用 Gemini 3.8 Flash?
若硬性約束是嚴格延遲、固定預算、指定客戶端工具或可重現的部署保證,應先比較輕量模型與替代品。