
Grok 4.7 是 xAI 在 2026 年 9 月 21 日发布的编码与知识工作模型。真正要回答的不是发布图上有没有一行领先,而是算上它实际写出的 token 之后,还值不值得离开 Grok 4.6。
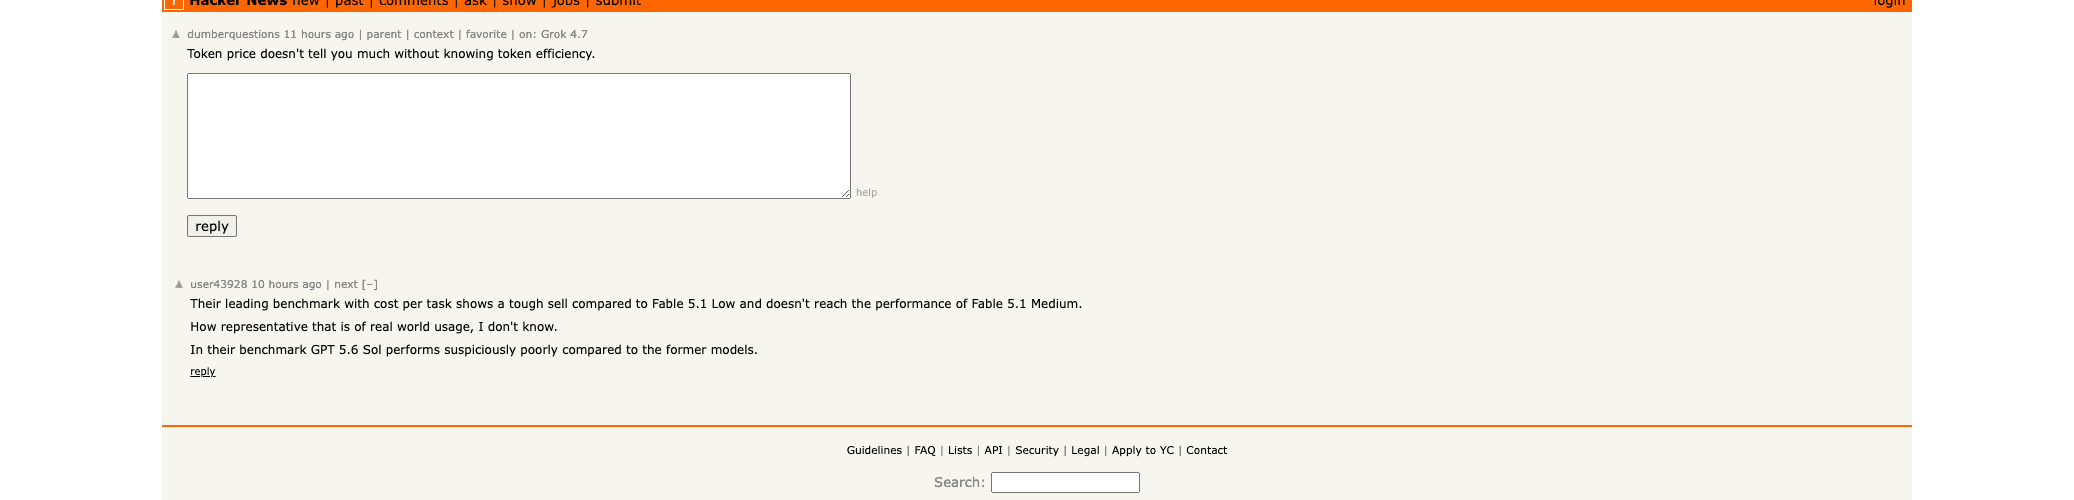
Hacker News 上的 dumberquestions 把这个陷阱写成一句:标价说明不了 token 效率。这就是这篇测评。上一代写在 Grok 4.6 文章 里。本站还没有定价文和替代品文。下面没有任何一条是在 Tabbit Browser 里做的受控测试。
决定这篇测评的一个数字
2026 年 9 月 22 日打开原文时,有两个数字朝相反方向走。
发布页 给 Grok 4.7 xHigh 的标价是每百万 token 输入 2 美元、输出 6 美元,和 Grok 4.6 High 同一格。API 文档 对 grok-4.7 重复了 2.00 美元和 6.00 美元。
Artificial Analysis 在 xhigh 档测得,Grok 4.7 每道智能指数题大约写出 8.1 万输出 token。Grok 4.6 的 xhigh 大约是 3.8 万。同一篇文章里,Grok 4.6 high 接近 3.6 万,GPT-6 Astra max 接近 2.7 万。标价没动,写出来的量动了。
指数只从 Grok 4.6 high 的 44 走到 Grok 4.7 xhigh 的 46。编码代理指数在 Grok Build 里走得更多:56 对 47。如果任务只是短回答,你是在为没有点名的思考付费。如果上一个模型在仓库中途停住,多出来的 token 才是这次升级本身。
先看结论
公开标价与 Grok 4.6 相同。智能指数上 xhigh 的 token 数量不同。
最清楚的进步在代理任务:Grok Build 的编码代理分高了 9 分,文书分析质量明显上升。
综合指数只高 2 分,在这张图上仍落后于 Claude Fable 5.1、GPT-6 Astra 和 GPT-5.6 Sol。
幻灯片完成度反向走。演示 Elo 下降,分析 Elo 上升。
Cursor 套餐消耗和 API 美元是两套表。一位 Ultra 用户看到套餐掉得更快。这不能改写 API 标价。
基准,以及该信多少
每一行都带着自己的 harness。xAI 表上的 Terminal-Bench 百分比,不是 Grok Build 里的那个百分比。
| 信号 | Grok 4.7 | 对照 | 条件,2026-09-22 核对 |
|---|---|---|---|
| 标价 | 每百万 $2 / $6 | 与 Grok 4.6 相同。Sol Max $4 / $20。Fable Max $10 / $50 | xAI 发布表,xHigh 列 |
| API 模型 | grok-4.7 | 上下文 50 万。默认档位 high。有 xhigh | docs.x.ai 一览 |
| 智能指数 | 46 | Grok 4.6 high 44。Sol max 47。Fable 5.1 与 Astra 53 | Artificial Analysis,xhigh |
| 每题输出 token | 约 81k | Grok 4.6 xhigh 约 38k。Astra max 约 27k | 同一篇文章,不是美元账单 |
| 编码代理指数 | 56 | Grok Build 中的 Grok 4.6 xhigh 为 47。Fable 与 Astra 为 62 | 原生 harness,不是指数那套 |
| AA-Briefcase Elo | 1,657 | Grok 4.6 high 1,546。Fable 5.1 1,678 | 4.7 是 xhigh,4.6 对照是 high |
| 分析对幻灯片 | 1,994 / 1,499 Elo | Grok 4.6 high 1,690 / 1,519 | 分析升,演示降 |
| CursorBench 4.0 | 46.3%,约每任务 $6.01 | Fable 5.1 Max 51.8%,约 $17.28 | xAI 散点,Extra High,厂商 harness |
| Terminal-Bench 4.0 | 38.0% | Grok 4.6 High 20.3%。Sol Max 37.3%。Fable Max 57.9% | xAI 表,xHigh 列 |
| Grok Build 中的 Terminal-Bench | 33% | Grok 4.6 xhigh 18% | Artificial Analysis。不要和 38% 平均 |
这张表上面还有三道限制。
档位对不齐。好几句“4.7 赢了 4.6”比的是 xhigh 和 high。81k 对 38k 才是两边都在 xhigh 的那一对。指数 +2 分不是这一对。
Harness 会改写结论。编码代理分包含 Grok Build。智能指数用的是统一 harness。xAI 的 Terminal-Bench 格子是 38.0%。Artificial Analysis 在 Grok Build 里写成 33%,基线是 18%。The Decoder 文中的 26% 是第三种图注,这里不用。
厂商图会挑选对手。发布页上的 CursorBench 散点有 Fable、Opus、Sol 和 Sonnet,没有 GPT-6 Astra。那张图上的低单任务成本,不是对 Astra 的胜利。基准是方向,不是尺子。
这张表前面没有 Tabbit 任务日志。后面只使用公开测量和点名评论。
它确实强的地方
分析变好了,幻灯片没有
意外不在指数上的 46。AA-Briefcase 上,分析质量从 Grok 4.6 high 的 1,690 Elo 走到 Grok 4.7 的 1,994,演示质量从 1,519 走到 1,499。Artificial Analysis 在 9 月 22 日的帖子里写了同一方向的分裂:Lite 场景分析 Elo 从 1,698 到 1,994,演示从 1,531 到 1,499。两处文字的 4.6 基线不是同一对。两边都是:分析写得更好,成片没有更好。
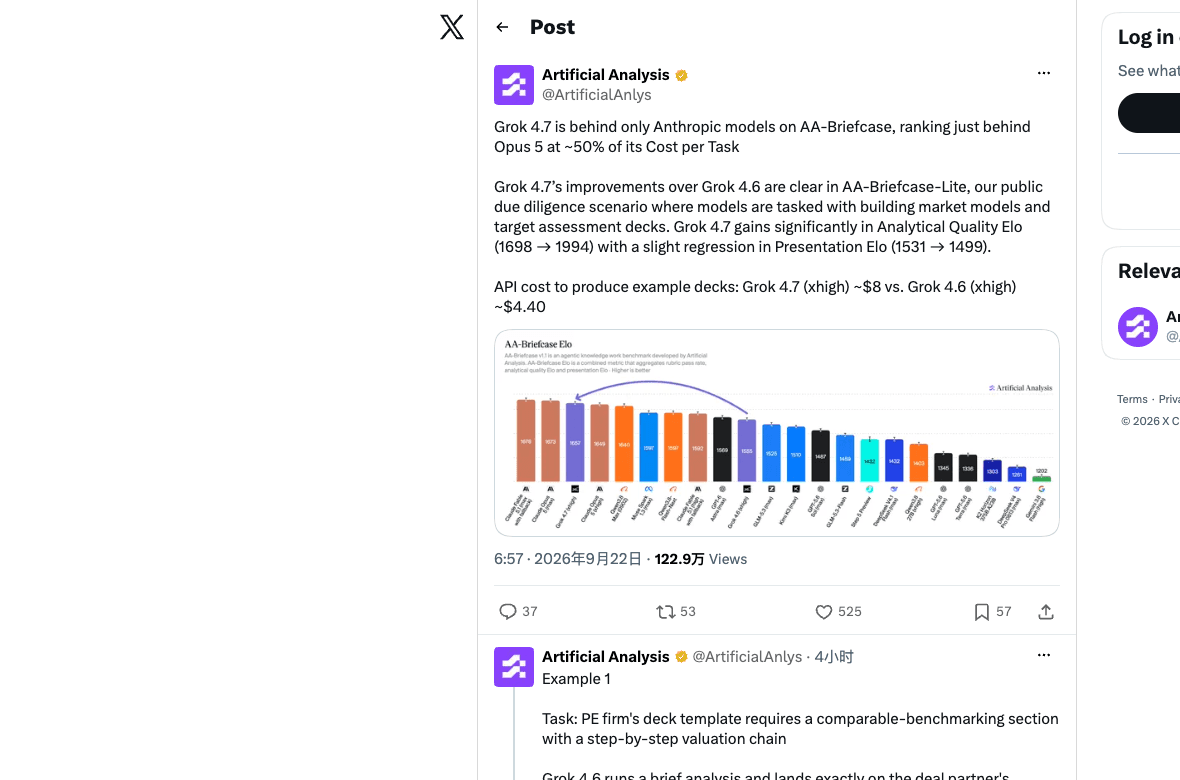
原帖。
如果交付物是市场模型、备忘录或表格论证,这个分裂比两分指数更要紧。如果交付物是打磨好的幻灯片,就没有理由为 Grok 4.7 的这一项鼓掌。
Grok Build 里的编码代理,比指数走得更远
在 Grok Build 里,Artificial Analysis 给出 DeepSWE v1.1 为 73% 对 65%,Terminal-Bench 4.0 为 33% 对 18%,SWE-Atlas-QnA 为 63% 对 58%,对照都是 Grok 4.6 xhigh。综合分是 56,在他们画出的原生 harness 里排第四,落后于 Fable 5.1 和 GPT-6 Astra。
这对长编码循环是真实的一步。它仍是系统分:模型加上 Grok Build。它没有说一次默认 high、而不是 xhigh 的 grok-4.7 API 调用能通过同样的题。这类循环和单次回答的差别,可以接着看 代理推理说明。
标价仍是旗舰里便宜的那一格
在 xAI 的 CursorBench 散点上,Grok 4.7 Extra High 是 46.3%,约每任务 6.01 美元。Fable 5.1 Max 是 51.8%,约 17.28 美元。Grok 4.7 High 是 43.9%,约 4.69 美元;Low 是 33.1%,约 1.58 美元。你可以用比 Fable 顶档少很多的钱买一个更低的分,也可以买 Fable 的更高分。这是两笔不同的采购。Fable 5.1 测评和 GPT-6 Astra 测评 写的是贵的那一端。
它会咬人的地方
咬人的是 token 账单,不是价目表
大约 8.1 万输出 token、按每百万 6 美元计算,输出部分大约是 0.49 美元,还没算输入、缓存、工具和重试。大约 3.8 万则大约是 0.23 美元。这只用了 Artificial Analysis 印出的输出数量,不是你的发票。
Cursor Ultra 用户 Dynamix86 说自己在 extra high、关闭 fast mode 的条件下跑了同一项任务,并认为 Grok 4.7 打掉套餐百分比的速度大约是 Grok 4.6 的 2.5 倍。他们还把一张图读成每任务 8.82 美元对 3.53 美元。套餐计时按他们的记录理解。那对美元数是他们对图片的读数,不是这篇重新测量的结果。
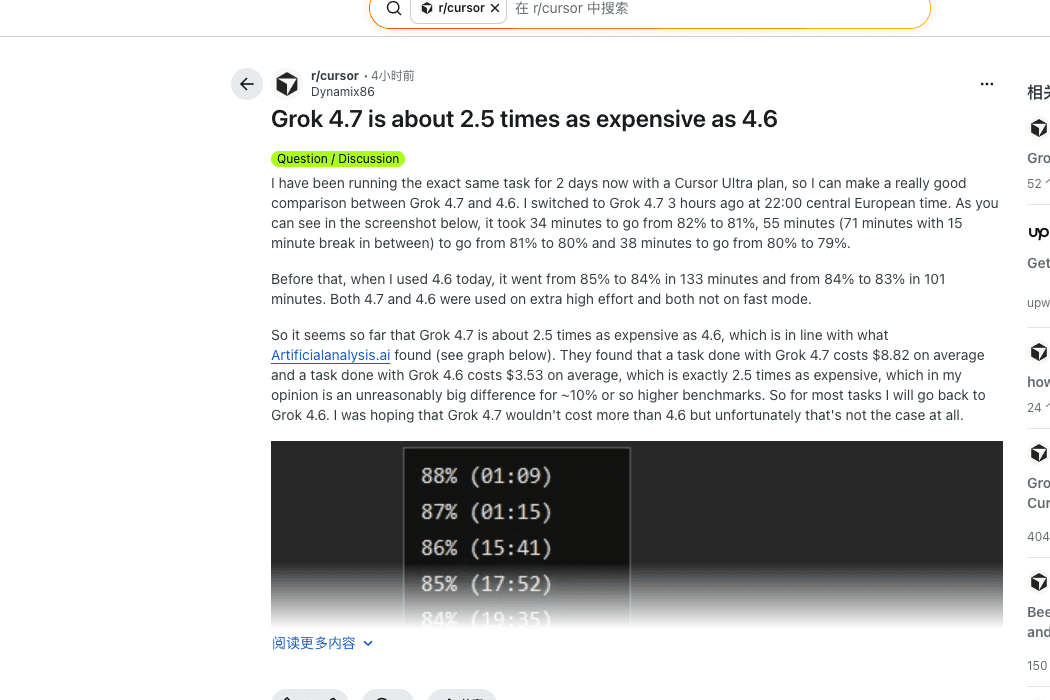
原帖。
xAI 还有一个按两倍 token 价格计费的快速变体,而且只在 Cursor 和 Grok Build。公开 API 没有它。美国区域端点还有 10% 的用量溢价。把“快速”和很长的提示叠在一起,就不是标题里的 2 美元 / 6 美元那一档。
困难的终端任务仍然大多失败
官方 Terminal-Bench 4.0 在 xHigh 是 38.0%。同一张表上 Fable 5.1 Max 是 57.9%,Sol Max 是 37.3%。Grok 4.7 高于 Grok 4.6 High 的 20.3%,这组题仍然大多做不完。HealthBench Professional 是 56.7%,Fable 是 62.1%,Sol 是 60.5%。Harvey 法律代理格子是 19.6%,远高于 Sol 的 2.5%,绝对分仍然低。
一个被训练去熬多小时任务的模型,仍然可以在那一小时里失败。不要把“比 4.6 好”读成“事情做完了”。
指数只走了一小步,档位也很容易看错
46 对 44 不会改变一段短对话、一次翻译或一个单文件修改。GPT-5.6 Sol max 在这张指数上已经是 47,标价更高。想要全面跃迁的团队,在这次发布里找不到。拿 xhigh 去比 high,再宣布全面获胜,只是在挑自己喜欢的标签。
幻觉率有改善,29% 对 Grok 4.6 high 的 34%,准确率仍大约是 47% 对 48%。非正确答案里的错误少了一些,不等于知道得更多。
人们实际上怎么说
评论分成账单和手感两边。它们不能给基准盖棺。
账单
saejox 对一个单价更高、却用更少 token 的模型说得更直:离 Astra 还远,它贵,但 token 用得少。
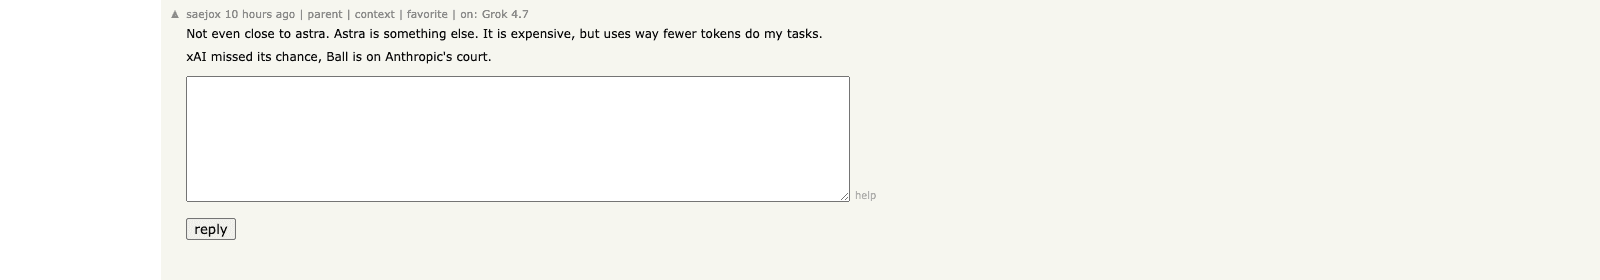
评论。
手感
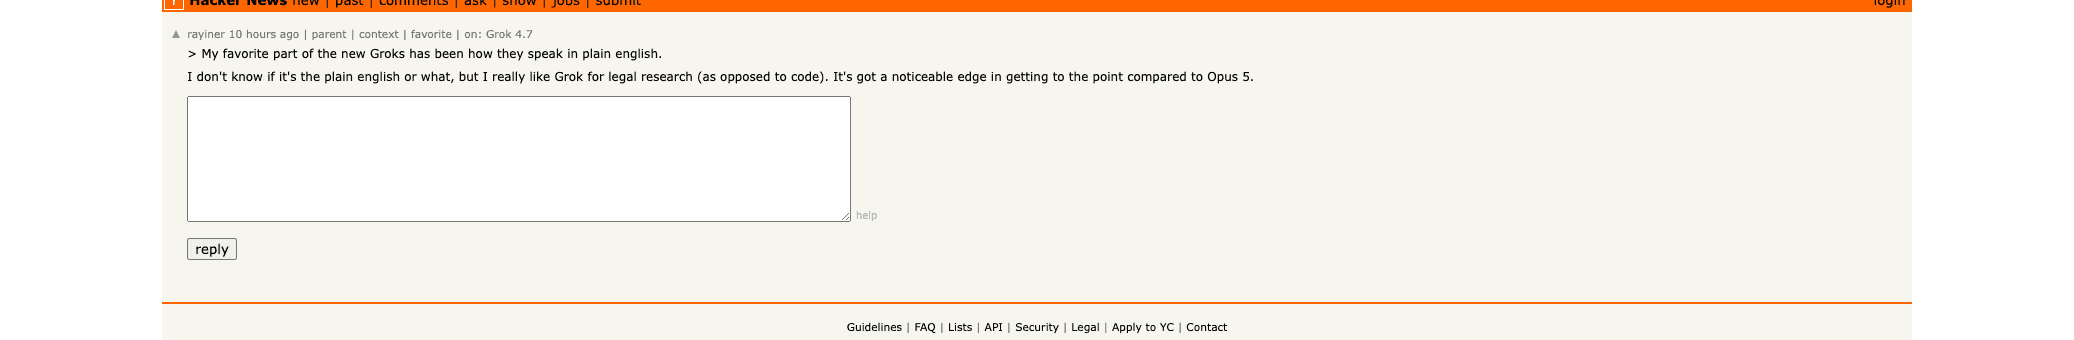
rayiner 说自己做法律检索时喜欢 Grok,不是写代码,因为它比 Opus 5 更快说到点子上。这句话说的是最近一串 Grok,不是一份打过分的 4.7 案卷。
评论。
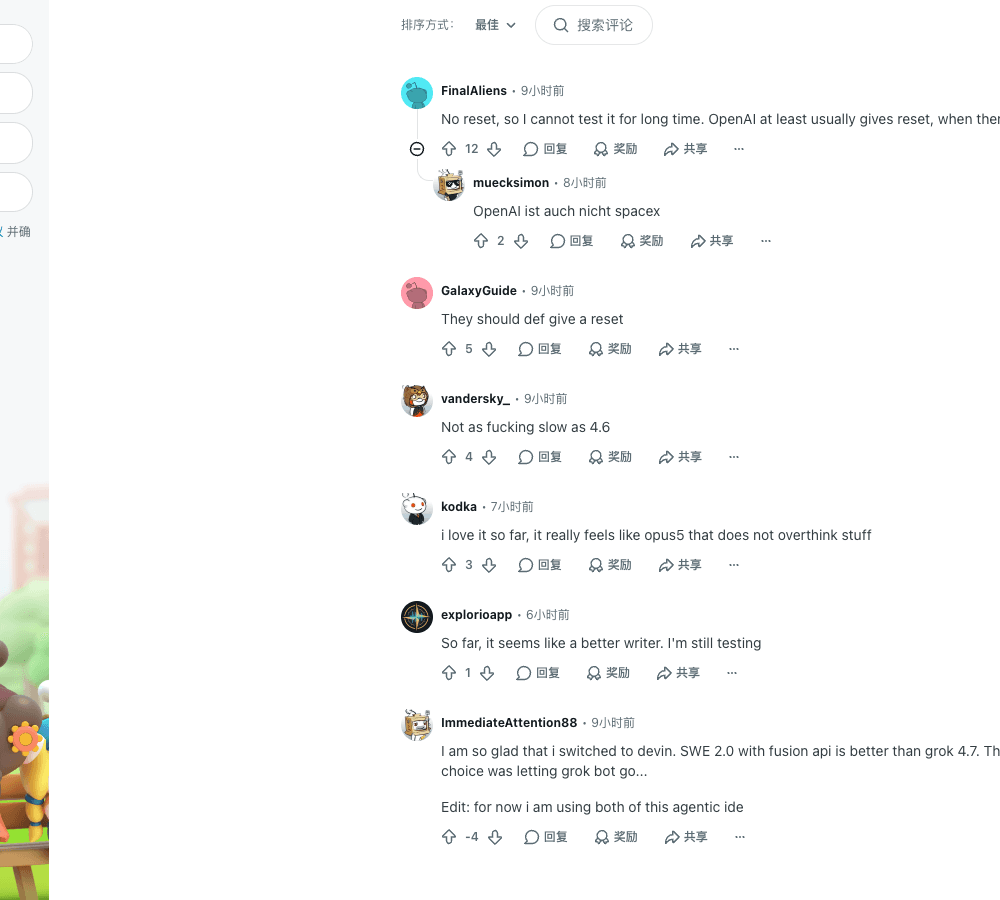
r/cursor 发布后头几个小时的帖子,是同一个分裂的缩小版。vandersky_ 写它没有 4.6 那么慢。kodka 写它像不会过度思考的 Opus 5。exploriosapp 还在测,觉得写作更好。ImmediateAttention88 更倾向 Devin 的 SWE 2.0 加 fusion API,并且两个工具都在用。没有人贴出仓库、档位或计时。
帖子。
编辑判断和数字一致。盯着用量的人不满意。想要少一点拖沓编码手感的人还在试。两边都没有贴出重复任务的分数。
先跑工作流,再相信那一行分数
一行基准不会告诉你,Grok 4.7 在你已经打开的页面上是什么表现。Tabbit Browser 是做这个检查的客户端:模型选择器、当前页面和文件在同一个地方。AI 浏览器说明和 Tabbit Browser 导览 写的是这个布局。代理式浏览和 浏览器自动化 是相邻的工作。如果问题是浏览器而不是模型,可以看 2026 年 AI 浏览器清单。
边界很直白。这篇没有在 Tabbit 里做固定抽取、重复比较或计时的页面任务。如果选择器里没有 Grok 4.7,下面的按钮也不会变出权限。API 美元、Cursor 套餐和 Tabbit 账号是三种价格。就算抓到一次碰巧正确的回答,也不能把它写成成功率。
按工作负载选
| 工作负载 | 用 Grok 4.7 吗 | 原因 | 要盯住 |
|---|---|---|---|
| 4.6 会中途放弃的长编码循环 | 用,在 Grok Build 或 Cursor,先不要上到 xhigh | 编码代理的进步是公开数据里最大的一块 | 套餐百分比和输出 token |
| 单文件修改或闲聊 | 不用 | 指数只高 2 分,token 数量却跳了一大截 | 留在 4.6,或看 Gemini 3.8 Flash 测评 里的更小模型 |
| 备忘录、模型或表格论证 | 用,如果产品就是分析 | 分析 Elo 上升了 | 不要指望幻灯片更好 |
| Fable 已经能通过的终端套件 | 不用,除非价格压过一切 | 官方 Terminal-Bench 38% 仍然大多失败 | 不要混进 Grok Build 的 33% |
| 在意简短的法律检索 | 试,然后核对来源 | 有一位实践者喜欢这种语气。Harvey 代理分只有 19.6% | 语气不是正确性 |
| 工作就在打开的标签页里 | 只有选择器里有它,才在 Tabbit 里试 | 缺的是客户端,不是更高的分数 | 这里不声称成功率 |
Grok 4.7 是上一个模型停住、而你付得起额外 token 时的升级。上一个模型已经做完时,它会变成贵习惯。
 Tabbit Browser

常见问题
Grok 4.7 值得从 Grok 4.6 换过去吗?
只有当长程编码代理或分析文书在 Grok 4.6 上做不完,并且你付得起更多输出 token 时,才值得换。标价仍是每百万 token 输入 2 美元、输出 6 美元。Artificial Analysis 在 xhigh 档测得每道智能指数题约 8.1 万输出 token,Grok 4.6 的 xhigh 约 3.8 万。日常单文件修改不需要这些额外思考。
标价没涨,为什么有人说 Grok 4.7 更贵?
价目表和账单不是同一个数。xAI 列出的单价与 Grok 4.6 相同。独立测试显示,xhigh 档写出的输出 token 大约是两倍。一位 Cursor Ultra 用户在 extra high、关闭 fast mode 时,也看到套餐百分比掉得更快。那是单个账号的用量记录,不是 API 发票。
Grok 4.7 和 Claude Fable 5.1、GPT-6 Astra 差多少?
在 Artificial Analysis 智能指数上,Grok 4.7 xhigh 是 46。Claude Fable 5.1 和 GPT-6 Astra 是 53,GPT-5.6 Sol 是 47。Grok Build 加 Grok 4.7 的编码代理指数是 56,Fable 和 Astra 是 62。办公类 Elo 上的差距,比综合指数上的差距小。
Grok 4.7 Fast 是什么,API 能用吗?
xAI 文档把 Grok 4.7 Fast 写成同一模型的更快服务,按标准 token 价格的两倍计费。它在 Cursor 和 Grok Build 里提供,不计入 Grok Build 免费额度,也不在公开 xAI API 上。公开模型名是 grok-4.7。
CursorBench 更高,是不是就代表编码赢了?
不是。xAI 自己的散点图里,Grok 4.7 Extra High 是 46.3%,约每任务 6.01 美元;Fable 5.1 Max 是 51.8%,约 17.28 美元。官方 Terminal-Bench 4.0 是 38.0%,这组终端任务仍然大多失败。Grok Build 里的 33% 是另一套 harness,不能和 38% 写进同一格。
能在 Tabbit Browser 里用 Grok 4.7 吗?
Tabbit 的 Grok 4.7 页面写明,模型出现在当前账号的选择器里时可以使用。这篇测评没有在 Tabbit 里跑固定任务,因此不报告成功率、延迟或客户端费用。API 单价、Cursor 套餐和 Tabbit 账号是三笔不同的费用。