
Grok 4.7 は、xAI が 2026 年 9 月 21 日に出したコーディングと知識作業向けのモデルです。発売図の一行が勝っているかより、実際に書くトークンを含めて Grok 4.6 を離れる価値があるかが問いです。
Hacker News の dumberquestions は、トークン単価だけでは効率は分からない、と一行で罠を書いています。それがこのレビューです。前世代は Grok 4.6 の記事 にあります。料金の記事と代替モデルの記事は、このサイトにはまだありません。以下に Tabbit Browser での対照実験はありません。
このレビューを決める一つの数字
2026 年 9 月 22 日に原文を開いたとき、二つの数字は逆を向いていました。
発表ページ は Grok 4.7 xHigh を入力100万トークンあたり2ドル、出力6ドルとし、Grok 4.6 High と同じマスです。API 文書 も grok-4.7 に 2.00 ドルと 6.00 ドルを繰り返しています。
Artificial Analysis は xhigh で、Grok 4.7 が知能指数の課題あたり約 8.1 万出力トークンと測りました。Grok 4.6 の xhigh は約 3.8 万です。同じ記事では Grok 4.6 high が約 3.6 万、GPT-6 Astra max が約 2.7 万です。料金表は動かず、書く量だけ動きました。
指数は Grok 4.6 high の 44 から Grok 4.7 xhigh の 46 へしか動いていません。Grok Build のコーディングエージェント指数は 56 対 47 と、もっと動きました。短い答えなら、頼んでいない思考に払っています。前のモデルがリポジトリの途中で止まったなら、増えたトークンが今回の中身です。
先に結論
公開単価は Grok 4.6 と同じです。知能指数での xhigh のトークン数は同じではありません。
いちばんはっきりした伸びはエージェント側です。Grok Build のコーディングスコアは 9 点上がり、文書の分析品質も大きく上がりました。
総合指数は 2 点だけで、その図では Claude Fable 5.1、GPT-6 Astra、GPT-5.6 Sol にまだ遅れます。
スライドの仕上がりは逆です。分析の Elo は上がり、プレゼンテーションの Elo は下がりました。
Cursor のプラン消化と API のドルは別のメーターです。Ultra の一人が消化の速さを見ています。それが API 単価を書き換えるわけではありません。
ベンチマークと、どこまで信じてよいか
各行は自分の harness を持っています。xAI の表の Terminal-Bench は、Grok Build の Terminal-Bench ではありません。
| 信号 | Grok 4.7 | 比べる相手 | 条件(2026-09-22 確認) |
|---|---|---|---|
| 単価 | 100万あたり $2 / $6 | Grok 4.6 と同じ。Sol Max $4 / $20。Fable Max $10 / $50 | xAI の発表表、xHigh 列 |
| API モデル | grok-4.7 | コンテキスト 50 万。既定は high。xhigh あり | docs.x.ai の一覧 |
| 知能指数 | 46 | Grok 4.6 high 44。Sol max 47。Fable 5.1 と Astra 53 | Artificial Analysis、xhigh |
| 課題あたり出力 | 約 81k | Grok 4.6 xhigh 約 38k。Astra max 約 27k | 同じ記事。請求書ではない |
| コーディング指数 | 56 | Grok Build の Grok 4.6 xhigh は 47。Fable と Astra は 62 | ネイティブ harness |
| AA-Briefcase Elo | 1,657 | Grok 4.6 high 1,546。Fable 5.1 1,678 | 4.7 は xhigh、4.6 側は high |
| 分析とスライド | 1,994 / 1,499 Elo | Grok 4.6 high 1,690 / 1,519 | 分析は上昇、発表は低下 |
| CursorBench 4.0 | 46.3%、約 $6.01 / 課題 | Fable 5.1 Max 51.8%、約 $17.28 | xAI の散布図、Extra High |
| Terminal-Bench 4.0 | 38.0% | Grok 4.6 High 20.3%。Sol Max 37.3%。Fable Max 57.9% | xAI の表、xHigh 列 |
| Grok Build の Terminal-Bench | 33% | Grok 4.6 xhigh 18% | Artificial Analysis。38% と平均しない |
表の上に、三つの但し書きがあります。
努力レベルが揃っていません。「4.7 が 4.6 に勝った」のいくつかは xhigh と high の比較です。81k 対 38k は、両方 xhigh なのでこちらの方がきれいです。指数の +2 はその組ではありません。
Harness が話を変えます。コーディング指数には Grok Build が含まれます。知能指数は共通 harness です。xAI の Terminal-Bench は 38.0% です。Artificial Analysis は Grok Build の中で 33%、基線 18% と書いています。The Decoder の 26% は第三のキャプションなので、ここには使いません。
ベンダーの図は相手を選びます。発表ページの CursorBench には Fable、Opus、Sol、Sonnet が見え、GPT-6 Astra は見えません。その図の課題単価の安さは、Astra への勝利ではありません。ベンチマークは方角であって、ものさしではありません。
この表の前に Tabbit の課題ログはありません。続く節は公開測定と名前のあるコメントだけです。
確かに強いところ
分析は良くなり、スライドは良くならなかった
驚きは指数の 46 ではありません。AA-Briefcase では、分析品質が Grok 4.6 high の 1,690 Elo から Grok 4.7 の 1,994 へ動き、プレゼンテーションは 1,519 から 1,499 へ動きました。Artificial Analysis は 9 月 22 日の投稿でも同じ割れ方を書いています。Lite の分析 Elo は 1,698 から 1,994、発表は 1,531 から 1,499 です。二つの文章の 4.6 基線は同じ組ではありません。どちらも、分析の文章は良くなり、デッキの仕上がりは良くなっていない、と言っています。
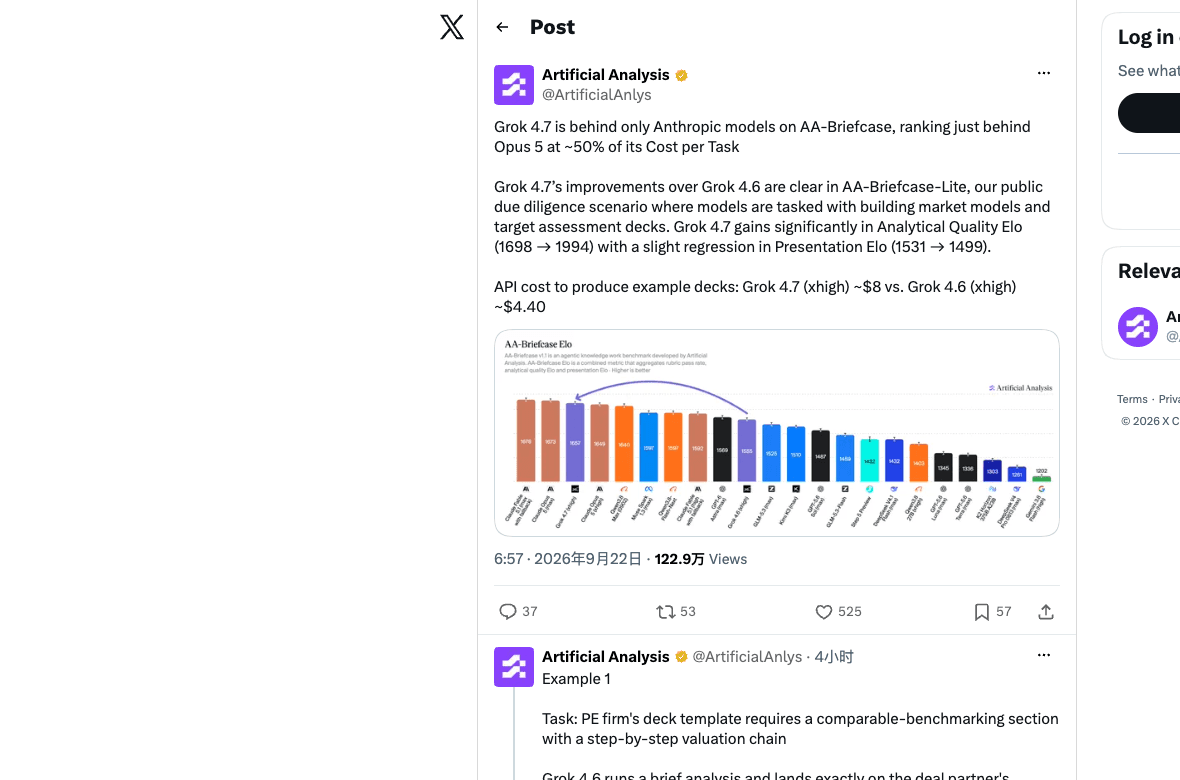
元の投稿。
成果物が市場モデル、メモ、表計算の論証なら、この割れ方は 2 点の指数より大事です。磨いたスライドが成果物なら、この項目で Grok 4.7 を祝う理由はありません。
Grok Build のコーディングエージェントは指数より動いた
Grok Build の中で、Artificial Analysis は DeepSWE v1.1 を 73% 対 65%、Terminal-Bench 4.0 を 33% 対 18%、SWE-Atlas-QnA を 63% 対 58% としました。相手はすべて Grok 4.6 xhigh です。合成点は 56 で、彼らが描いたネイティブ harness では 4 位、Fable 5.1 と GPT-6 Astra の後ろです。
長いコーディングのループには実のある一歩です。それでもシステム点です。モデルに Grok Build が足されています。既定の high であって xhigh ではない grok-4.7 の API 呼び出しが、同じ課題を通すとは書いてありません。ループと一回の答えの違いは、エージェント推論のノート が隣の説明です。
料金表は、旗艦のなかではまだ安いマス
xAI の CursorBench では、Grok 4.7 Extra High は 46.3%、課題あたり約 6.01 ドルです。Fable 5.1 Max は 51.8%、約 17.28 ドルです。Grok 4.7 High は 43.9% で約 4.69 ドル、Low は 33.1% で約 1.58 ドルです。Fable の最上段よりずっと少ない金額で低い点を買うことも、Fable の高い点を買うこともできます。別の買い物です。高い側は Fable 5.1 のレビュー と GPT-6 Astra のレビュー にあります。
噛みつくところ
噛みつくのはトークンの請求で、料金表ではない
約 8.1 万の出力トークンを 100 万あたり 6 ドルで置くと、出力分はおよそ 0.49 ドルです。入力、キャッシュ、ツール、再試行の前です。約 3.8 万はおよそ 0.23 ドルです。使ったのは Artificial Analysis が印刷した出力数だけです。あなたの請求書ではありません。
Cursor Ultra の Dynamix86 は、extra high、fast mode オフで同じ課題だと言い、Grok 4.7 がプランのパーセントを Grok 4.6 の約 2.5 倍の速さで削ったと結論しています。図を課題あたり 8.82 ドル対 3.53 ドルとも読んでいます。プランの時間は本人の記録です。ドルの組は図の読み取りであり、このレビューが測り直した数字ではありません。
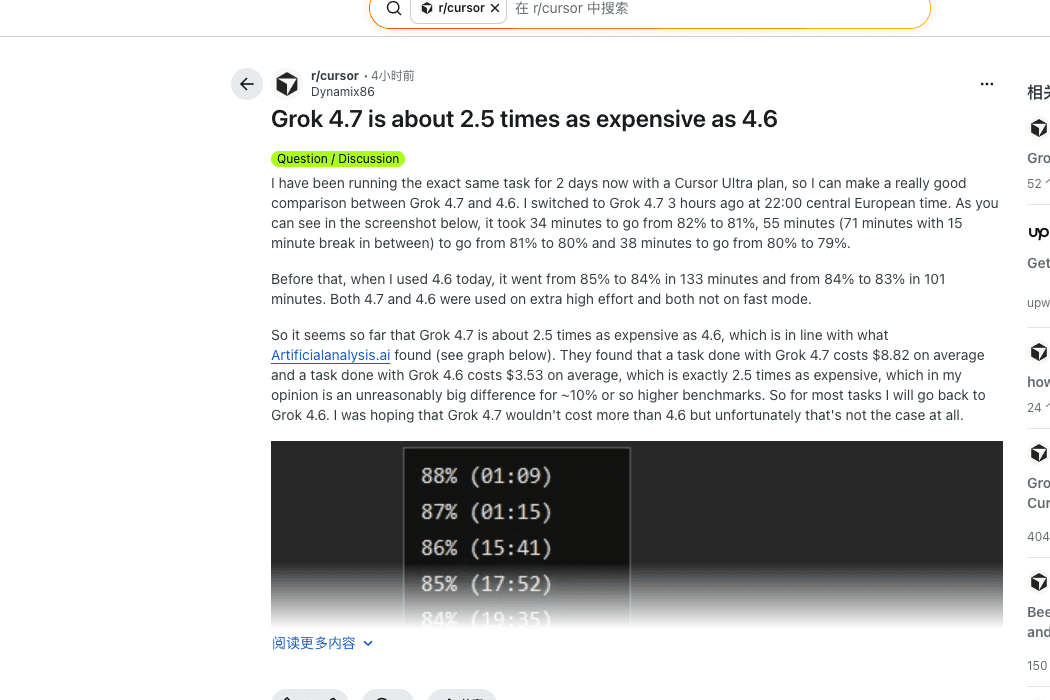
xAI はトークン料金が 2 倍の高速版も出していて、場所は Cursor と Grok Build だけです。公開 API にはありません。米国リージョンの端点は利用量に 10% の上乗せがあります。「高速」と長いプロンプトを重ねると、見出しの 2 ドル / 6 ドルとは別の製品です。
難しい端末課題の多くは今も失敗する
公式の Terminal-Bench 4.0、xHigh は 38.0% です。同じ表の Fable 5.1 Max は 57.9%、Sol Max は 37.3% です。Grok 4.7 は Grok 4.6 High の 20.3% より上で、それでもセットの大半を外します。HealthBench Professional は 56.7% で、Fable は 62.1%、Sol は 60.5% です。Harvey の法律エージェントは 19.6% で、Sol の 2.5% よりずっと高く、絶対値はまだ低いです。
何時間も続けるよう訓練されたモデルでも、その一時間で失敗できます。「4.6 より良い」を「仕事が終わった」と読まないでください。
指数の一歩は小さく、努力レベルの取り違えが起きやすい
46 対 44 は、短い会話、翻訳、単一ファイルの修正を変えません。GPT-5.6 Sol max はその指数で既に 47 で、単価はより高いです。全体の跳躍を待っていたチームは、今回のリリースにはそれを見つけません。xhigh を high と比べてから広い勝利を宣言するのは、都合のよいラベルを読んでいるだけです。
幻覚率は 29% 対 Grok 4.6 high の 34% と改善し、正解率は 47% 対 48% の近くに留まりました。正しくない応答のなかの誤りが減ったことは、知っていることが増えたことと同じではありません。
実際に言われていたこと
コメントは請求の議論と感触の議論に分かれます。ベンチマークの決着にはなりません。
請求
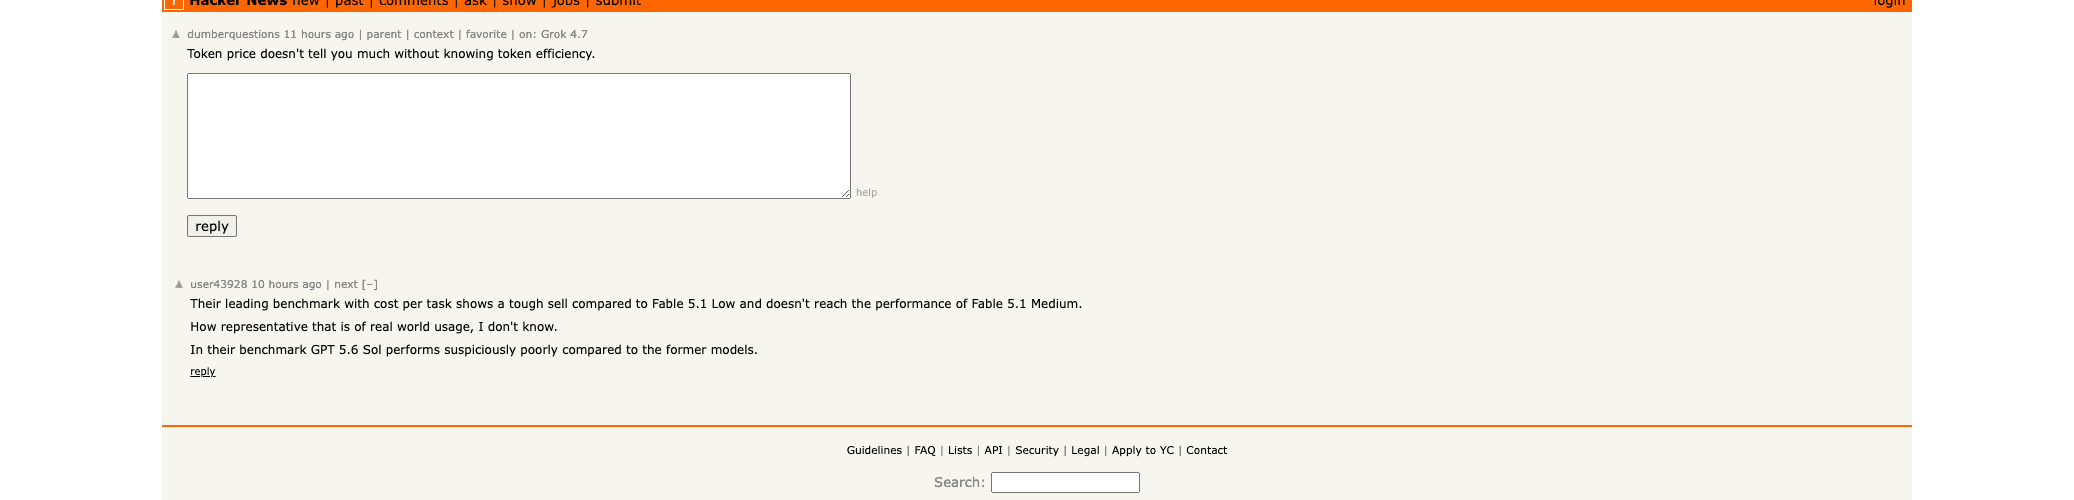
saejox は、単価は高くてもトークンを少なく使うモデルについて、Astra にはまだ遠く、高いがトークンは少ない、と短く書いています。
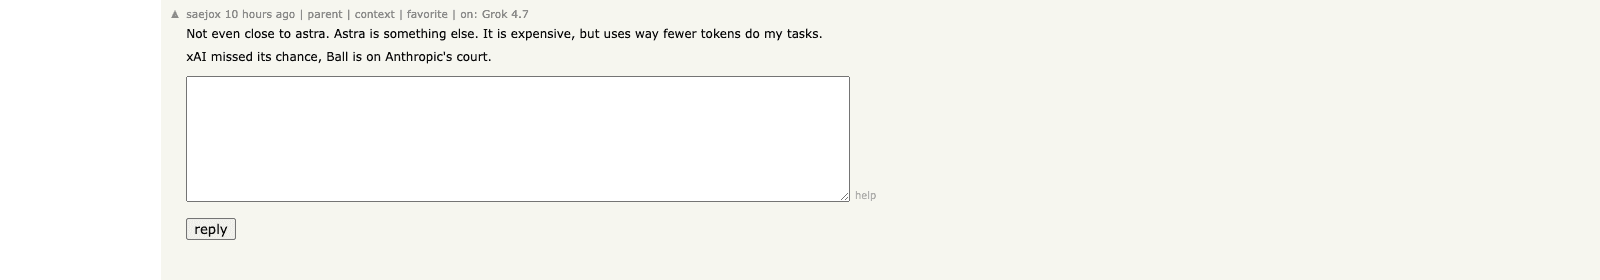
コメント。
感触
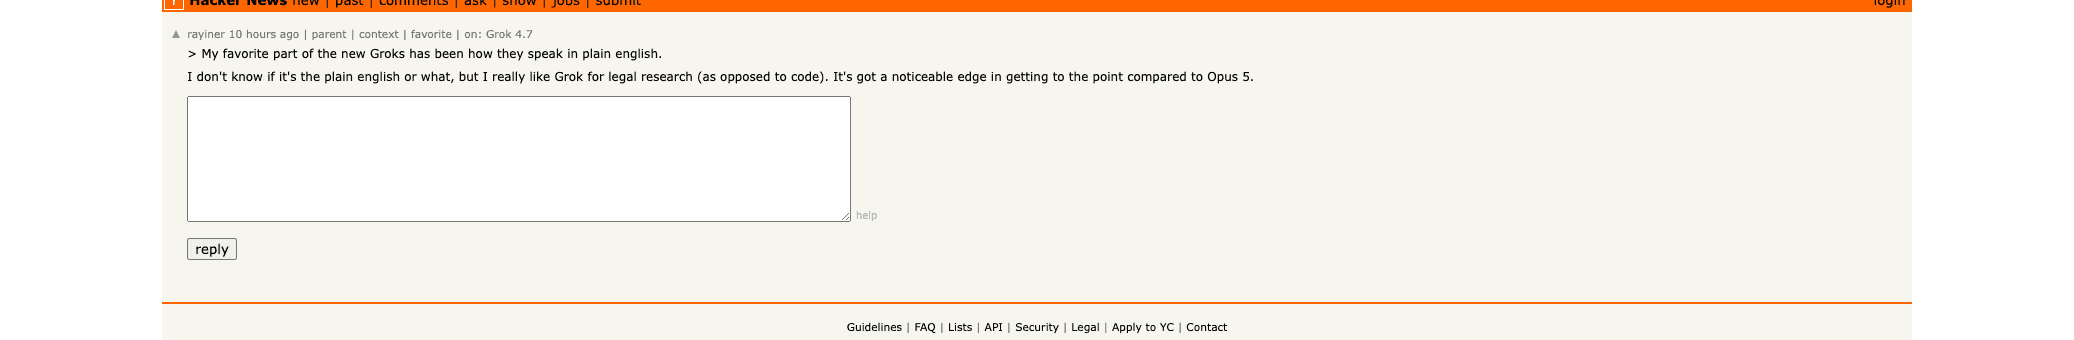
rayiner は、コードではなく法律調査で Grok が好きだと言います。Opus 5 より要点に着くのが速いからです。文は最近の Grok の系統についてであり、採点済みの 4.7 の事件ファイルではありません。
コメント。
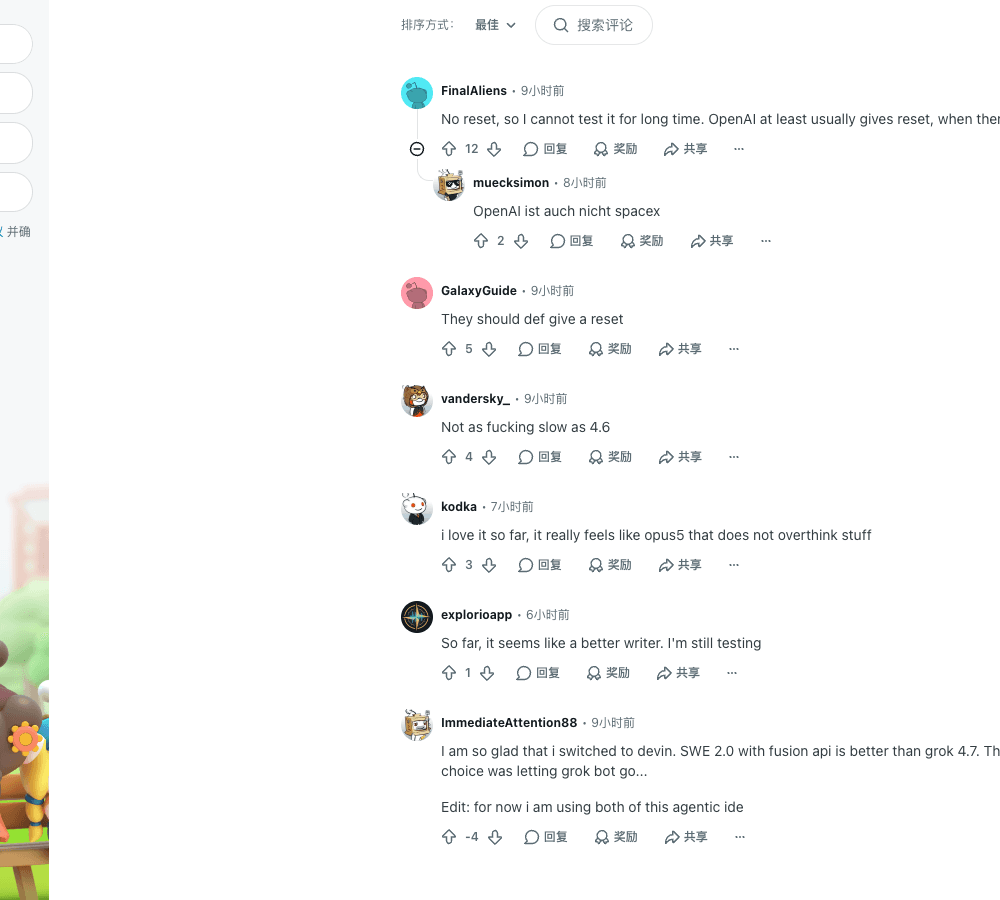
r/cursor の公開直後のスレッドは、同じ分裂の縮小版です。vandersky_ は 4.6 ほど遅くないと書きました。kodka は、考えすぎない Opus 5 のようだと書きました。exploriosapp はまだ試していて、文章は良くなったように感じるそうです。ImmediateAttention88 は Devin の SWE 2.0 と fusion API の方が良いとし、両方を使っています。リポジトリ、努力レベル、タイマーを出した人はいません。
スレッド。
編集としての読みは数字と揃います。メーターを見ている人は不満です。コーディングの重たさが減ることを望んだ人はまだ試しています。どちらも、繰り返した課題の点数は出していません。
行を信じる前に、作業の形を試す
ベンチマークの一行は、すでに開いているページで Grok 4.7 がどう振る舞うかを見せません。Tabbit Browser はその確認のためのクライアントです。モデル選択、開いているページ、ファイルが一つの場所にあります。AI ブラウザの案内と Tabbit Browser の説明 がその配置です。エージェント型の閲覧と ブラウザ自動化 は隣の仕事で、問いがモデルではなくブラウザなら 2026 年の AI ブラウザ一覧 があります。
境界は単純です。このレビューは Tabbit で固定の抽出、繰り返しの比較、時間を計ったページ課題を走らせていません。選択に Grok 4.7 がなければ、下のボタンは権限を作りません。API のドル、Cursor のプラン、Tabbit のアカウントは三つの価格です。たまたま当たった一つの答えを、たとえ撮っていたとしても成功率にはできません。
作業の形で選ぶ
| 作業 | Grok 4.7 を使うか | 理由 | 見るもの |
|---|---|---|---|
| 4.6 が途中で捨てる長いコーディング | 使う。Grok Build か Cursor で、まず xhigh 未満 | 公開データで最大の伸びはコーディングエージェント | プランのパーセントと出力トークン |
| 単一ファイルの修正や雑談 | 使わない | 指数は 2 点だけで、トークン数は跳ねた | 4.6 に残るか、Gemini 3.8 Flash のレビュー の小さいモデルを見る |
| メモ、モデル、表の論証 | 分析が成果物なら使う | 分析 Elo が上がった | スライドが良くなるとは期待しない |
| Fable がすでに通す端末一式 | 価格がすべてを上回るとき以外は使わない | 公式 Terminal-Bench 38% は大半が失敗 | Grok Build の 33% を混ぜない |
| 短さが大事な法律調査 | 試し、出典を確認する | 一人の実務家が調子を好む。Harvey は 19.6% だけ | 調子は正しさではない |
| 開いたタブの中の仕事 | 選択に出ているときだけ Tabbit で試す | 足りないのはクライアントであり、より高い点数ではない | 成功率はここでは主張しない |
Grok 4.7 は、前のモデルが止まり、増えたトークンを払えるときのアップグレードです。前のモデルがすでに終えているなら、高い習慣になります。
 Tabbit Browser

よくある質問
Grok 4.6 から Grok 4.7 に替える価値はありますか?
長いコーディングエージェントや分析文書が Grok 4.6 で止まり、増えた出力トークンを払えるときだけ替える価値があります。単価は入力100万トークンあたり2ドル、出力6ドルのままです。Artificial Analysis は xhigh で、知能指数の課題あたり約8.1万出力トークン、Grok 4.6 の xhigh は約3.8万と測っています。短い単一ファイルの修正にはその思考量は要りません。
単価が同じなのに、なぜ高くなったと言う人がいるのですか?
料金表と請求は別の数字です。xAI の単価は Grok 4.6 と同じです。独立測定では xhigh の出力トークンが約2倍です。Cursor Ultra の利用者が extra high、fast mode オフで、プラン消化が速いとも書いています。それは一つのアカウントの記録であり、API の請求書ではありません。
Claude Fable 5.1 や GPT-6 Astra と比べるとどうですか?
Artificial Analysis の知能指数では Grok 4.7 xhigh は 46 です。Claude Fable 5.1 と GPT-6 Astra は 53、GPT-5.6 Sol は 47 です。Grok Build と Grok 4.7 のコーディングエージェント指数は 56 で、Fable と Astra は 62 です。オフィス作業の Elo では、総合指数ほど差は開いていません。
Grok 4.7 Fast とは何で、API から使えますか?
xAI の文書は Grok 4.7 Fast を、同じモデルをより速い基盤で提供し、標準トークン料金の2倍で請求するものと説明しています。Cursor と Grok Build にあり、Grok Build の無料枠には含まれず、公開 xAI API にはありません。公開のモデル名は grok-4.7 です。
CursorBench が高ければコーディングで勝ったことになりますか?
なりません。xAI 自身の散布図では Grok 4.7 Extra High は 46.3%、課題あたり約6.01ドル、Fable 5.1 Max は 51.8%、約17.28ドルです。公式の Terminal-Bench 4.0 は 38.0% で、その端末課題の多くは今も失敗します。Grok Build の 33% は別の harness なので、38% と同じマスに混ぜません。
Tabbit Browser で Grok 4.7 を使えますか?
Tabbit の Grok 4.7 ページは、アカウントのモデル選択に出ているときに使えると書いています。このレビューは Tabbit で固定課題を走らせていないので、成功率、遅延、クライアント費用は報告しません。API 単価、Cursor のプラン、Tabbit のアカウントは別の費用です。