
Grok 4.7은 xAI가 2026년 9월 21일에 낸 코딩과 지식 작업 모델입니다. 출시 차트에 이긴 줄이 있는지가 아니라, 실제로 쓴 토큰까지 넣고 Grok 4.6을 떠날 가치가 있는지가 질문입니다.
Hacker News의 dumberquestions는 토큰 단가만으로는 효율을 알 수 없다고 한 줄로 함정을 적었습니다. 이 리뷰가 그 문장입니다. 이전 세대는 Grok 4.6 글에 있습니다. 가격 글과 대안 목록은 이 사이트에 아직 없습니다. 아래에는 Tabbit Browser에서 한 통제 실험이 없습니다.
이 리뷰를 가르는 숫자 하나
2026년 9월 22일에 원문을 열었을 때, 두 숫자는 반대 방향을 가리켰습니다.
출시 페이지는 Grok 4.7 xHigh를 입력 100만 토큰당 2달러, 출력 6달러로 적고, Grok 4.6 High와 같은 칸입니다. API 문서도 grok-4.7에 2.00달러와 6.00달러를 반복합니다.
Artificial Analysis는 xhigh에서 Grok 4.7이 지능 지수 과제당 약 8.1만 출력 토큰을 쓴다고 측정했습니다. Grok 4.6 xhigh는 약 3.8만입니다. 같은 글에서 Grok 4.6 high는 약 3.6만, GPT-6 Astra max는 약 2.7만입니다. 요금표는 그대로이고 쓴 양만 움직였습니다.
지수는 Grok 4.6 high의 44에서 Grok 4.7 xhigh의 46으로만 움직였습니다. Grok Build의 코딩 에이전트 지수는 56 대 47로 더 움직였습니다. 짧은 답변이면 주문하지 않은 생각에 돈을 내는 셈입니다. 이전 모델이 저장소 중간에 멈췄다면, 늘어난 토큰이 이번 업그레이드입니다.
먼저 결론
공개 단가는 Grok 4.6과 같습니다. 지능 지수에서 xhigh 토큰 수는 같지 않습니다.
가장 분명한 이득은 에이전트입니다. Grok Build 코딩 점수는 9점 올랐고, 문서 분석 품질도 크게 올랐습니다.
종합 지수는 2점 차이이고, 그 차트에서는 Claude Fable 5.1, GPT-6 Astra, GPT-5.6 Sol에 뒤집니다.
슬라이드 완성도는 반대입니다. 분석 Elo는 오르고 발표 Elo는 내렸습니다.
Cursor 요금제 소모와 API 달러는 다른 계기판입니다. Ultra 사용자 한 명이 소모가 빠르다고 봤습니다. 그것이 API 단가를 바꾸지는 않습니다.
벤치마크, 그리고 어디까지 믿을지
각 행은 자기 harness를 갖습니다. xAI 표의 Terminal-Bench 비율은 Grok Build의 비율이 아닙니다.
| 신호 | Grok 4.7 | 비교 | 조건, 2026-09-22 확인 |
|---|---|---|---|
| 단가 | 100만당 $2 / $6 | Grok 4.6과 같음. Sol Max $4 / $20. Fable Max $10 / $50 | xAI 출시 표, xHigh 열 |
| API 모델 | grok-4.7 | 컨텍스트 50만. 기본은 high. xhigh 있음 | docs.x.ai 한눈에 보기 |
| 지능 지수 | 46 | Grok 4.6 high 44. Sol max 47. Fable 5.1과 Astra 53 | Artificial Analysis, xhigh |
| 과제당 출력 | 약 81k | Grok 4.6 xhigh 약 38k. Astra max 약 27k | 같은 글. 청구서 아님 |
| 코딩 에이전트 지수 | 56 | Grok Build의 Grok 4.6 xhigh는 47. Fable과 Astra는 62 | 네이티브 harness |
| AA-Briefcase Elo | 1,657 | Grok 4.6 high 1,546. Fable 5.1 1,678 | 4.7은 xhigh, 4.6 쪽은 high |
| 분석 대 슬라이드 | 1,994 / 1,499 Elo | Grok 4.6 high 1,690 / 1,519 | 분석은 상승, 발표는 하락 |
| CursorBench 4.0 | 46.3%, 과제당 약 $6.01 | Fable 5.1 Max 51.8%, 약 $17.28 | xAI 산점도, Extra High |
| Terminal-Bench 4.0 | 38.0% | Grok 4.6 High 20.3%. Sol Max 37.3%. Fable Max 57.9% | xAI 표, xHigh 열 |
| Grok Build의 Terminal-Bench | 33% | Grok 4.6 xhigh 18% | Artificial Analysis. 38%와 평균 내지 말 것 |
표 위에는 세 가지 한계가 있습니다.
노력 단계가 맞지 않습니다. “4.7이 4.6을 이겼다”는 문장 여럿은 xhigh와 high를 비교합니다. 81k 대 38k는 양쪽이 xhigh라 더 깨끗한 쌍입니다. 지수 +2점은 그 쌍이 아닙니다.
Harness가 이야기를 바꿉니다. 코딩 지수에는 Grok Build가 들어 있습니다. 지능 지수는 공통 harness입니다. xAI의 Terminal-Bench 칸은 38.0%입니다. Artificial Analysis는 Grok Build 안에서 33%, 기준선 18%를 적습니다. The Decoder의 26%는 세 번째 캡션이라 여기서 쓰지 않습니다.
벤더 차트는 상대를 고릅니다. 출시 페이지 CursorBench 산점도에는 Fable, Opus, Sol, Sonnet이 보이고 GPT-6 Astra는 없습니다. 그 차트의 낮은 과제 비용은 Astra에 대한 승리가 아닙니다. 벤치마크는 방향이지 자가 아닙니다.
이 표 앞에 Tabbit 과제 기록은 없습니다. 다음 절은 공개 측정과 이름이 있는 댓글만 씁니다.
정말로 나은 곳
분석은 좋아졌고 슬라이드는 아니었습니다
놀라운 점은 지수의 46이 아닙니다. AA-Briefcase에서 분석 품질은 Grok 4.6 high의 1,690 Elo에서 Grok 4.7의 1,994로, 발표 품질은 1,519에서 1,499로 움직였습니다. Artificial Analysis는 9월 22일 게시물에서도 같은 갈라짐을 적습니다. Lite 분석 Elo는 1,698에서 1,994, 발표는 1,531에서 1,499입니다. 두 글의 4.6 기준선은 같은 쌍이 아닙니다. 둘 다 분석 문장은 나아지고 덱 마무리는 나아지지 않았다고 말합니다.
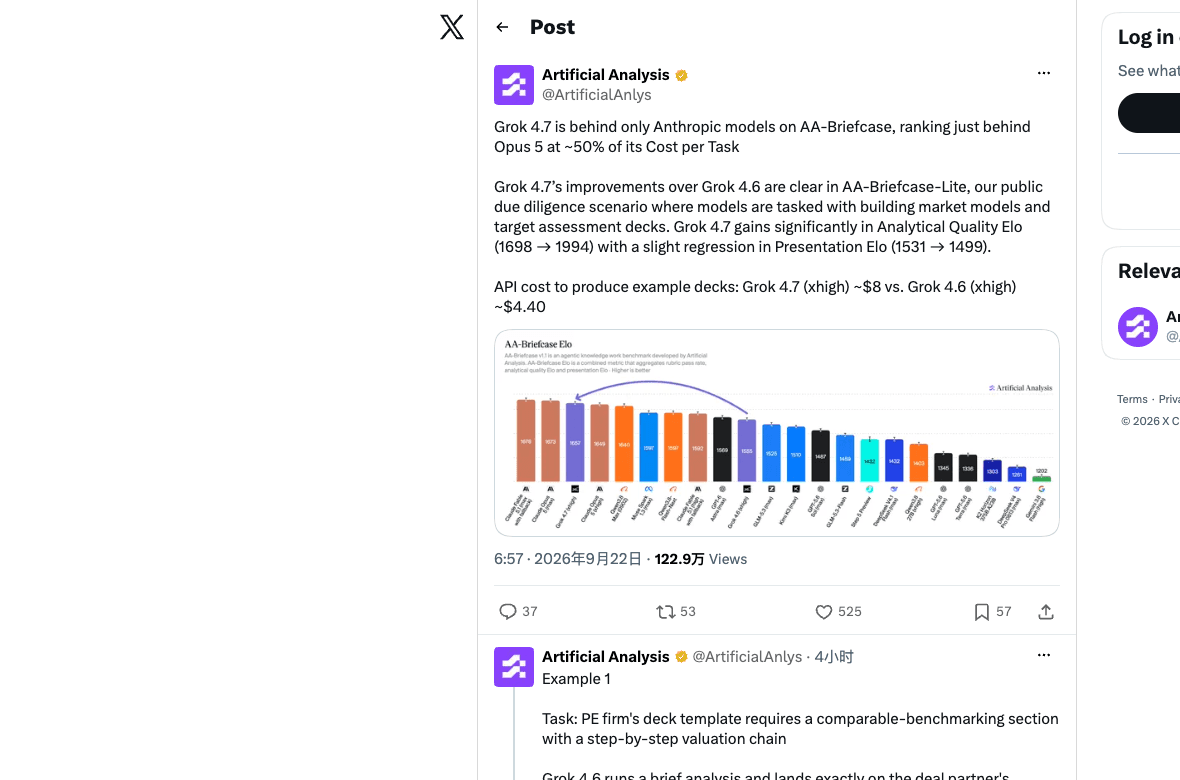
원문.
산출물이 시장 모델, 메모, 스프레드시트 논증이면 이 갈라짐이 2점 지수보다 중요합니다. 다듬은 슬라이드가 산출물이면 이 항목으로 Grok 4.7을 축하할 이유가 없습니다.
Grok Build의 코딩 에이전트는 지수보다 더 움직였습니다
Grok Build 안에서 Artificial Analysis는 DeepSWE v1.1을 73% 대 65%, Terminal-Bench 4.0을 33% 대 18%, SWE-Atlas-QnA를 63% 대 58%로 적었습니다. 비교 대상은 모두 Grok 4.6 xhigh입니다. 합산은 56으로, 그들이 그린 네이티브 harness 중 4위이고 Fable 5.1과 GPT-6 Astra 뒤입니다.
긴 코딩 루프에는 실제 한 걸음입니다. 그래도 시스템 점수입니다. 모델에 Grok Build가 붙어 있습니다. 기본 high이고 xhigh가 아닌 grok-4.7 API 호출이 같은 과제를 통과한다는 뜻은 아닙니다. 루프와 한 번의 답 차이는 에이전트 추론 설명이 옆 글입니다.
요금표는 여전히 플래그십 중 싼 칸입니다
xAI CursorBench 산점도에서 Grok 4.7 Extra High는 46.3%, 과제당 약 6.01달러입니다. Fable 5.1 Max는 51.8%, 약 17.28달러입니다. Grok 4.7 High는 43.9%에 약 4.69달러, Low는 33.1%에 약 1.58달러입니다. Fable 최상단보다 훨씬 적은 돈으로 낮은 점수를 사거나, Fable의 높은 점수를 살 수 있습니다. 다른 구매입니다. 비싼 쪽은 Fable 5.1 리뷰와 GPT-6 Astra 리뷰에 있습니다.
무는 곳
무는 것은 토큰 청구서이지 요금표가 아닙니다
약 8.1만 출력 토큰을 100만당 6달러로 두면 출력분만 약 0.49달러입니다. 입력, 캐시, 도구, 재시도 전입니다. 약 3.8만은 약 0.23달러입니다. Artificial Analysis가 인쇄한 출력 개수만 썼습니다. 당신의 청구서가 아닙니다.
Cursor Ultra의 Dynamix86은 extra high, fast mode 끄기에서 같은 과제라고 하며 Grok 4.7이 요금제 퍼센트를 Grok 4.6의 약 2.5배 속도로 깎았다고 결론 냈습니다. 그림을 과제당 8.82달러 대 3.53달러로도 읽었습니다. 요금제 시간은 그 사람의 기록입니다. 달러 쌍은 그림 읽기이며 이 리뷰가 다시 잰 값이 아닙니다.
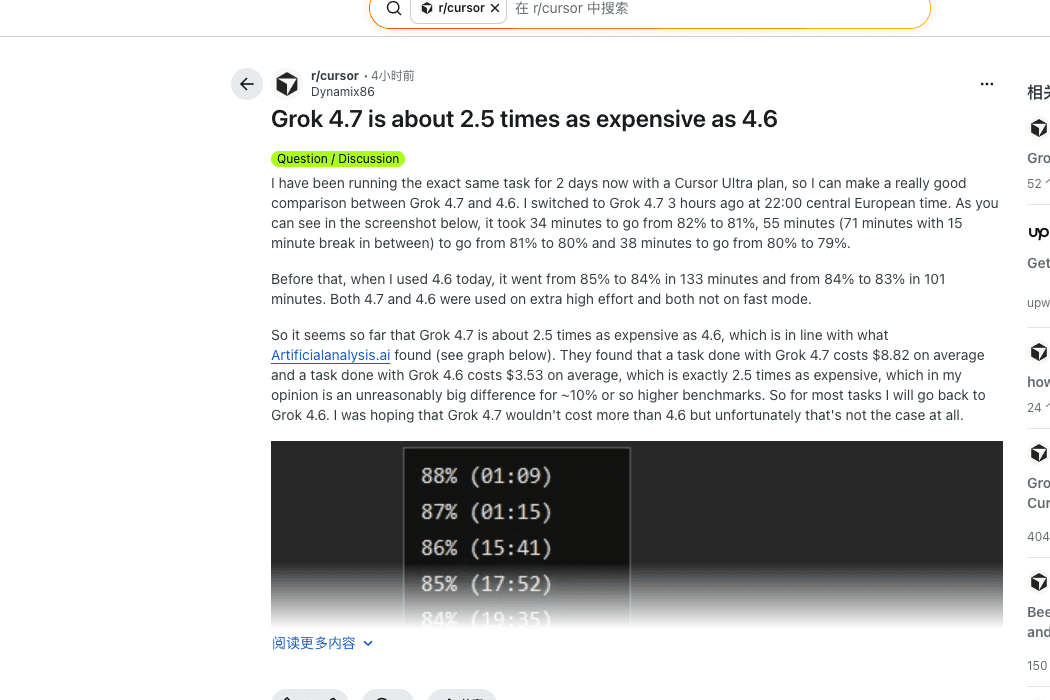
원문.
xAI는 토큰 가격이 두 배인 빠른 변형도 팔며, 장소는 Cursor와 Grok Build뿐입니다. 공개 API에는 없습니다. 미국 리전 엔드포인트는 사용량에 10% 할증이 있습니다. “빠름”과 긴 프롬프트를 겹치면 제목의 2달러 / 6달러와 다른 제품입니다.
어려운 터미널 과제 대부분은 여전히 실패합니다
공식 Terminal-Bench 4.0, xHigh는 38.0%입니다. 같은 표의 Fable 5.1 Max는 57.9%, Sol Max는 37.3%입니다. Grok 4.7은 Grok 4.6 High의 20.3%보다 높고, 그래도 세트의 대부분을 놓칩니다. HealthBench Professional은 56.7%이고 Fable은 62.1%, Sol은 60.5%입니다. Harvey 법률 에이전트 칸은 19.6%로 Sol의 2.5%보다 훨씬 높지만 절대값은 낮습니다.
여러 시간을 버티도록 훈련된 모델도 그 한 시간 안에 실패할 수 있습니다. “4.6보다 낫다”를 “일이 끝났다”로 읽지 마십시오.
지수 걸음은 작고, 노력 단계를 섞기 쉽습니다
46 대 44는 짧은 대화, 번역, 파일 하나 수정을 바꾸지 않습니다. GPT-5.6 Sol max는 그 지수에서 이미 47이고 단가는 더 높습니다. 전반적인 도약을 원한 팀은 이번 출시에서 그것을 찾지 못합니다. xhigh를 high와 비교한 뒤 넓은 승리를 선언하는 것은 편한 라벨을 읽는 일입니다.
환각률은 29% 대 Grok 4.6 high의 34%로 나아졌고, 정확도는 47% 대 48% 근처에 머물렀습니다. 정답이 아닌 응답 속의 오류가 준 것은 더 많이 안다는 뜻과 같지 않습니다.
사람들이 실제로 한 말
댓글은 청구 논쟁과 손맛 논쟁으로 갈립니다. 벤치마크를 끝내지는 못합니다.
청구
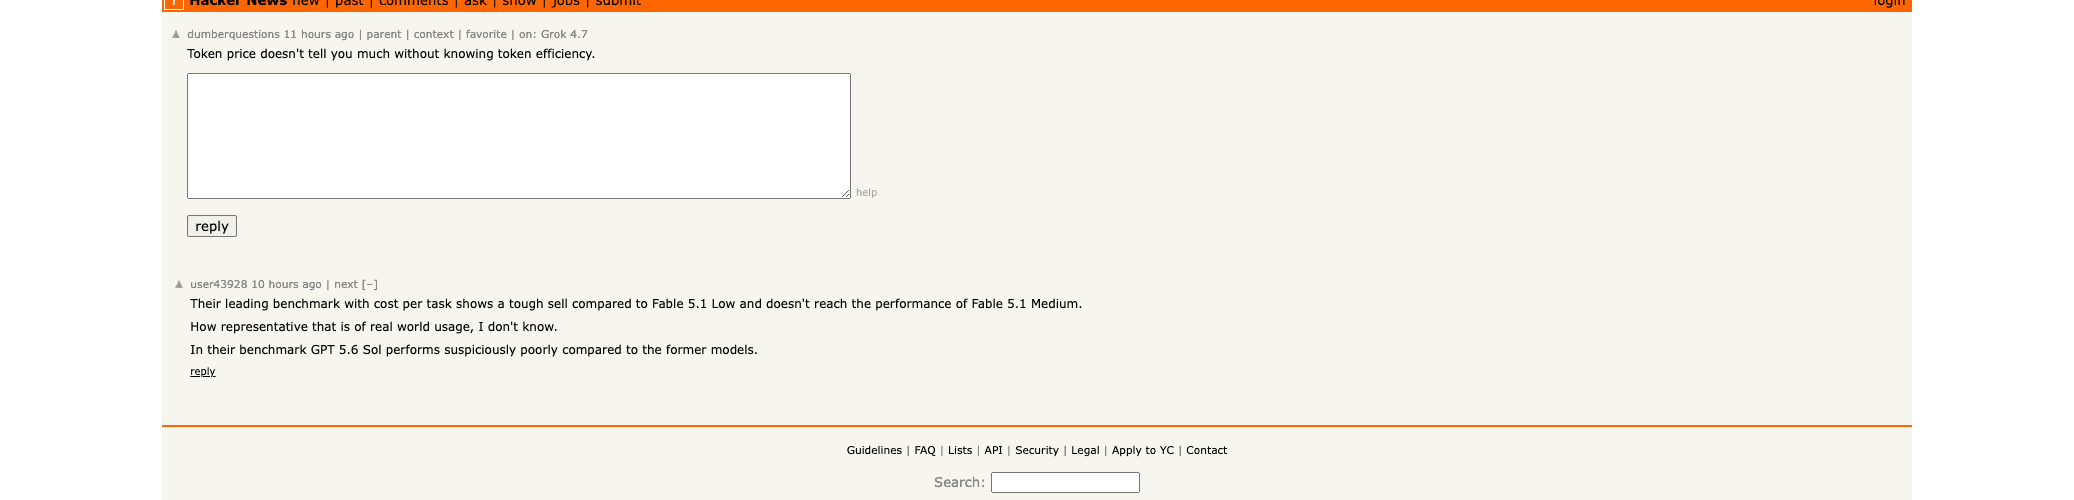
saejox는 단가는 더 비싸도 토큰을 덜 쓰는 모델에 대해, Astra에는 아직 멀고 비싸지만 토큰은 적다고 짧게 적었습니다.
댓글.
손맛
rayiner는 코드가 아니라 법률 조사에서 Grok을 좋아한다고 합니다. Opus 5보다 요점에 빨리 닿기 때문입니다. 문장은 최근 Grok 계열에 대한 것이지, 채점된 4.7 사건 파일이 아닙니다.
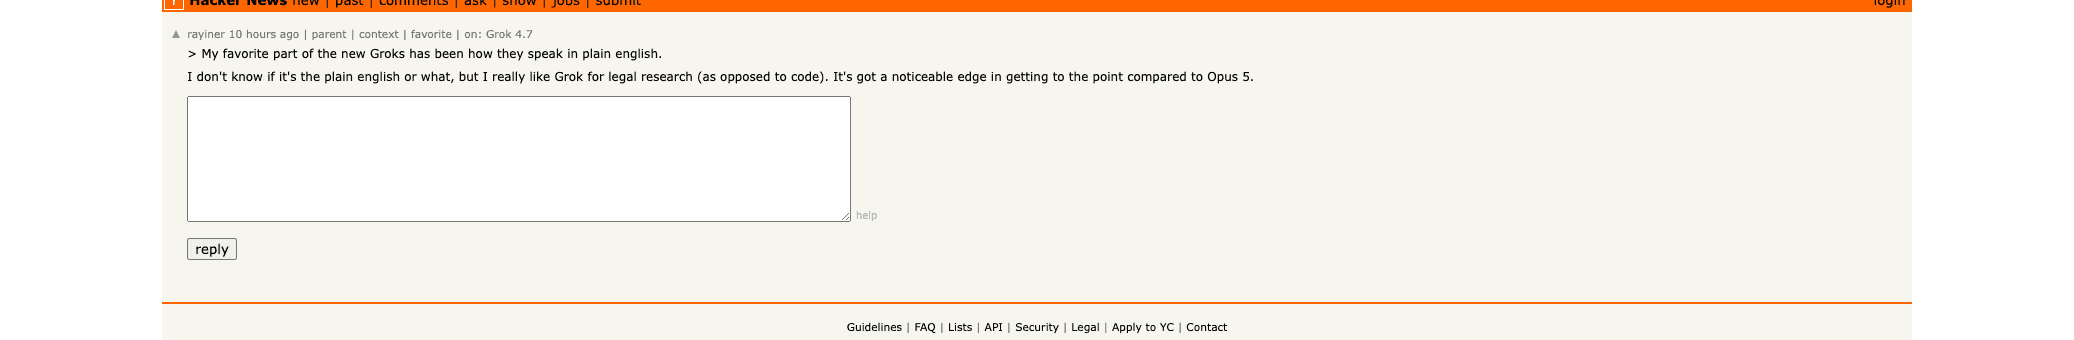
댓글.
r/cursor의 공개 직후 글은 같은 분열의 축소판입니다. vandersky_는 4.6만큼 느리지 않다고 썼습니다. kodka는 지나치게 생각하지 않는 Opus 5 같다고 썼습니다. exploriosapp는 아직 시험 중이며 글이 더 나아 보인다고 합니다. ImmediateAttention88은 Devin의 SWE 2.0과 fusion API가 더 낫다고 보고 둘 다 씁니다. 저장소, 노력 단계, 타이머를 올린 사람은 없습니다.
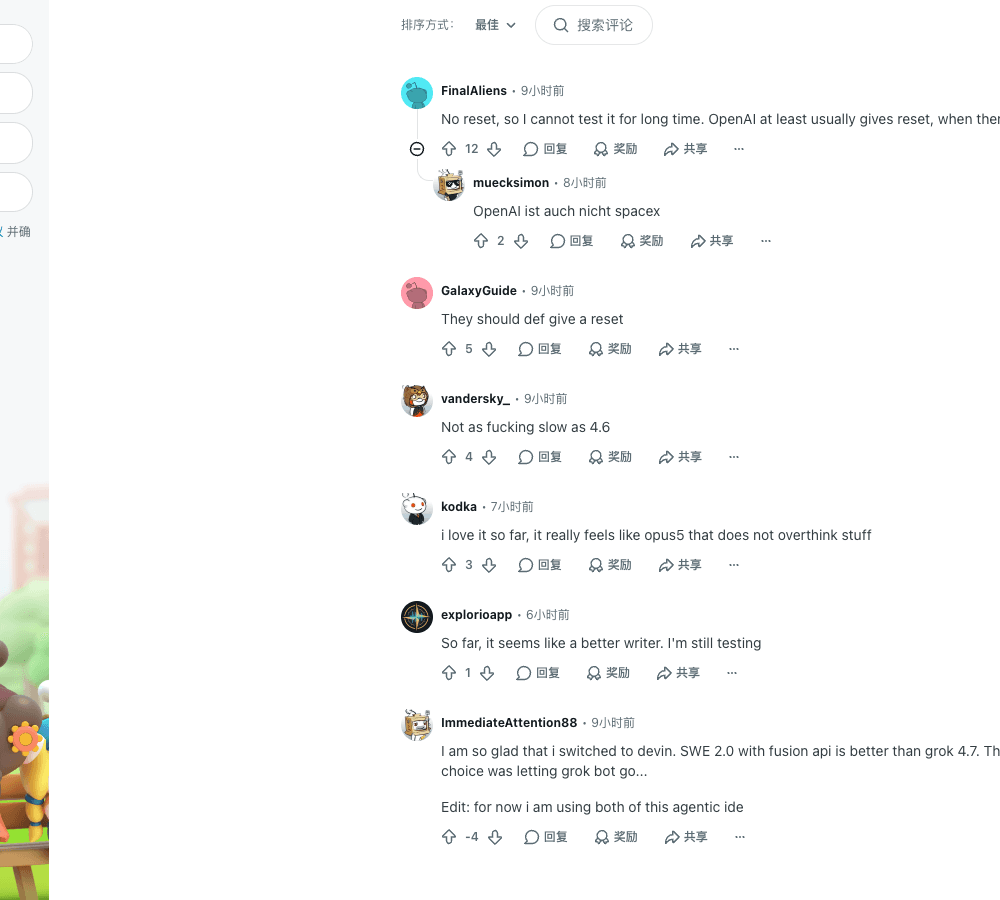
글.
편집 판단은 숫자와 맞습니다. 계량기를 보는 사람은 불만입니다. 코딩이 덜 늘어지길 원한 사람은 아직 시험 중입니다. 어느 쪽도 반복 과제 점수를 올리지 않았습니다.
한 줄을 믿기 전에 작업 형태를 시험하세요
벤치마크 한 줄은 이미 열어 둔 페이지에서 Grok 4.7이 어떻게 행동하는지 보여 주지 않습니다. Tabbit Browser는 그 확인을 위한 클라이언트입니다. 모델 선택기, 열린 페이지, 파일이 한곳에 있습니다. AI 브라우저 안내와 Tabbit Browser 설명이 그 배치입니다. 에이전트형 브라우징과 브라우저 자동화는 이웃 작업이고, 질문이 모델이 아니라 브라우저라면 2026 AI 브라우저 목록이 있습니다.
경계는 단순합니다. 이 리뷰는 Tabbit에서 고정 추출, 반복 비교, 시간을 잰 페이지 과제를 돌리지 않았습니다. 선택기에 Grok 4.7이 없으면 아래 버튼이 권한을 만들지 않습니다. API 달러, Cursor 요금제, Tabbit 계정은 세 가지 가격입니다. 우연히 맞은 답 하나를, 설령 캡처했더라도 성공률로 만들 수 없습니다.
작업 형태로 고르기
| 작업 | Grok 4.7을 쓸까 | 이유 | 볼 것 |
|---|---|---|---|
| 4.6이 중간에 포기하는 긴 코딩 | 씀. Grok Build나 Cursor에서 먼저 xhigh 아래 | 공개 데이터에서 가장 큰 이득은 코딩 에이전트 | 요금제 비율과 출력 토큰 |
| 파일 하나 수정이나 잡담 | 쓰지 않음 | 지수는 2점인데 토큰 수는 뛰었음 | 4.6에 남거나 Gemini 3.8 Flash 리뷰의 더 작은 모델을 봄 |
| 메모, 모델, 표 논증 | 분석이 산출물이면 씀 | 분석 Elo가 올랐음 | 슬라이드가 더 나아질 거라 기대하지 않음 |
| Fable이 이미 통과하는 터미널 세트 | 가격이 모든 것을 압도할 때만 | 공식 Terminal-Bench 38%는 대부분 실패 | Grok Build 33%를 섞지 않음 |
| 짧음이 중요한 법률 조사 | 시험한 뒤 출처를 확인 | 실무자 한 명이 어조를 좋아함. Harvey는 19.6%뿐 | 어조는 정확성이 아님 |
| 열린 탭 안의 일 | 선택기에 있을 때만 Tabbit에서 시험 | 부족한 것은 클라이언트이지 더 높은 점수가 아님 | 여기서 성공률을 주장하지 않음 |
Grok 4.7은 이전 모델이 멈추고, 늘어난 토큰을 낼 수 있을 때의 업그레이드입니다. 이전 모델이 이미 끝냈다면 비싼 습관이 됩니다.
 Tabbit Browser

자주 묻는 질문
Grok 4.6에서 Grok 4.7로 바꿀 가치가 있나요?
긴 코딩 에이전트나 분석 문서가 Grok 4.6에서 멈추고, 늘어난 출력 토큰을 감당할 수 있을 때만 바꿀 가치가 있습니다. 단가는 입력 100만 토큰당 2달러, 출력 6달러로 같습니다. Artificial Analysis는 xhigh에서 지능 지수 과제당 약 8.1만 출력 토큰, Grok 4.6 xhigh는 약 3.8만으로 측정했습니다. 짧은 파일 하나 수정에는 그 생각이 필요 없습니다.
단가가 같은데 왜 더 비싸졌다고 하나요?
요금표와 청구서는 다른 숫자입니다. xAI의 단가는 Grok 4.6과 같습니다. 독립 측정에서는 xhigh 출력 토큰이 약 두 배입니다. Cursor Ultra 사용자 한 명은 extra high, fast mode 끄기에서 요금제 비율이 더 빨리 준다고 적었습니다. 그것은 계정 하나의 기록이지 API 청구서가 아닙니다.
Claude Fable 5.1, GPT-6 Astra와 차이는 얼마인가요?
Artificial Analysis 지능 지수에서 Grok 4.7 xhigh는 46입니다. Claude Fable 5.1과 GPT-6 Astra는 53, GPT-5.6 Sol은 47입니다. Grok Build와 Grok 4.7의 코딩 에이전트 지수는 56이고 Fable과 Astra는 62입니다. 사무 작업 Elo에서는 종합 지수만큼 격차가 크지 않습니다.
Grok 4.7 Fast는 무엇이며 API에서 쓸 수 있나요?
xAI 문서는 Grok 4.7 Fast를 같은 모델의 더 빠른 제공이며, 표준 토큰 가격의 두 배로 청구된다고 설명합니다. Cursor와 Grok Build에만 있고 Grok Build 무료 한도에는 없으며 공개 xAI API에도 없습니다. 공개 모델 이름은 grok-4.7입니다.
CursorBench가 높으면 코딩에서 이긴 것인가요?
아닙니다. xAI 산점도에서 Grok 4.7 Extra High는 46.3%, 과제당 약 6.01달러이고 Fable 5.1 Max는 51.8%, 약 17.28달러입니다. 공식 Terminal-Bench 4.0은 38.0%라서 그 터미널 과제 대부분은 아직 실패합니다. Grok Build의 33%는 다른 harness이므로 38%와 한 칸에 섞지 않습니다.
Tabbit Browser에서 Grok 4.7을 쓸 수 있나요?
Tabbit의 Grok 4.7 페이지는 계정 모델 선택기에 보일 때 쓸 수 있다고 적습니다. 이 리뷰는 Tabbit에서 고정 과제를 돌리지 않았으므로 성공률, 지연, 클라이언트 비용을 보고하지 않습니다. API 단가, Cursor 요금제, Tabbit 계정은 서로 다른 비용입니다.