
Gemini 3.8 Flash mérite un vrai essai pour les tâches longues, les appels d’outils et l’analyse multimodale. Ce n’est pas un vainqueur universel. Google le présente comme un modèle Flash de travail pour le développement logiciel, les agents autonomes et les flux d’entreprise complexes. Les preuves publiques conduisent à une conclusion conditionnelle : l’instantané indépendant avec raisonnement high est solide, mais les données de latence sont incomplètes.
Le repère contre-intuitif : medium coûte 25 % de moins, pour un point d’écart
Artificial Analysis affiche 1,24 dollar par tâche de l’Intelligence Index pour high et 0,93 pour medium. Medium coûte 25 % de moins, (1,24 - 0,93) / 1,24, tandis que l’indice est de 40 contre 41. C’est un snapshot daté : il ne prouve ni l’équivalence statistique ni le coût en production ; il justifie seulement un test de medium.
Choisissez-le selon le goulot d’étranglement. Il est intéressant lorsque le travail demande une planification durable, de grandes entrées ou plusieurs appels d’outils. Gardez une autre option lorsque le délai de première réponse, le budget fixe ou le support du client sont prioritaires. Cet article combine les sources publiques et une extraction effectuée avec un compte de test Tabbit. Tabbit Browser est présenté comme une couche de contexte, pas comme un modèle concurrent.
À retenir
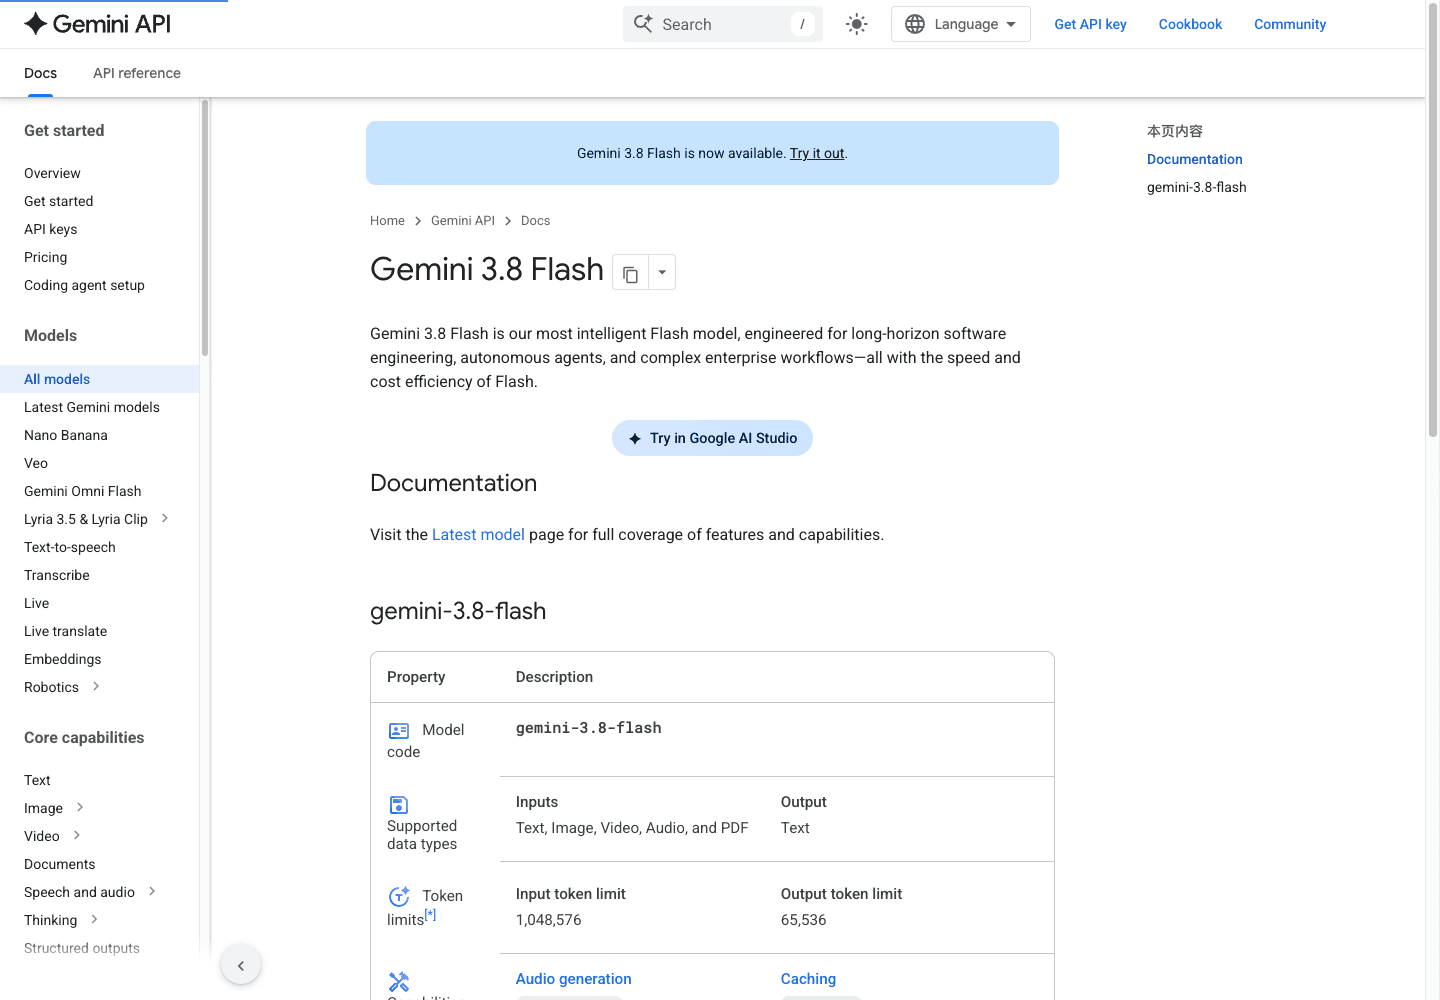
Le modèle API stable accepte texte, image, vidéo, audio et PDF, avec 1 048 576 tokens en entrée et 65 536 en sortie. Ce sont des limites API, pas une garantie pour chaque client. (documentation Google)
Les niveaux low, medium et high sont pris en charge ; minimal ne l’est pas. Les tokens de raisonnement sont compris dans le prix de sortie.
Dans l’instantané Artificial Analysis v4.3.2 vérifié le 20-09-2026, high affiche 41, 305 tokens/s et 1,24 dollar ; medium 40 et 0,93 dollar ; low 33. Les valeurs absentes restent inconnues.
Conditions et méthode
Trois forces et trois limites
Workflows avec outils
Les outils documentés conviennent aux tâches qui lisent, planifient, agissent et vérifient ; le client peut en exposer moins.
Grandes entrées et multimodal
L’API accepte texte, images, vidéo, audio et PDF avec 1M tokens d’entrée. Les limites et l’extraction restent à vérifier.
Sortie structurée avec échantillon limité
L’échantillon Tabbit a renvoyé le JSON attendu et conservé le statut inconnu. Le marqueur Google Search et un seul run empêchent de généraliser.
Les tokens de raisonnement augmentent le coût
Google les inclut dans la sortie facturée. Medium coûte 25 % de moins par tâche, sans garantir le coût en production.
Aucune promesse de latence initiale
Les pages ne donnent pas de mesure exploitable du premier token. Les 305 tokens/s décrivent seulement la génération.
Le périmètre client et production diffère
Une option visible dans Tabbit et un échantillon d’un compte ne prouvent pas le même support partout.
Hacker News : quatre expériences individuelles
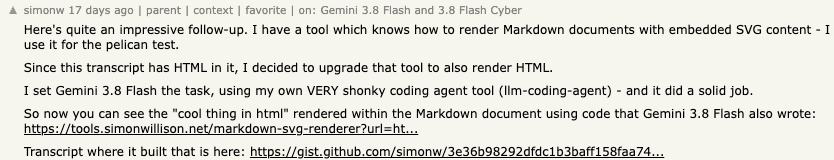
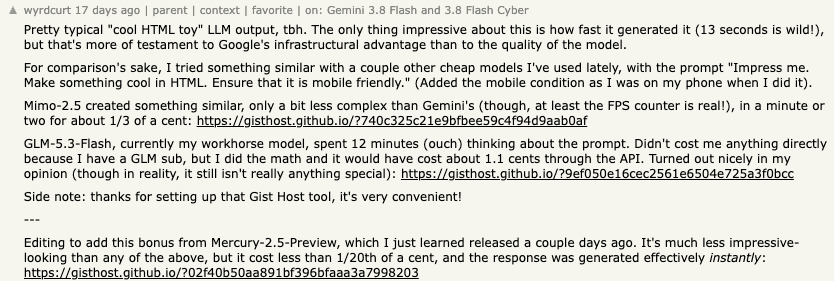
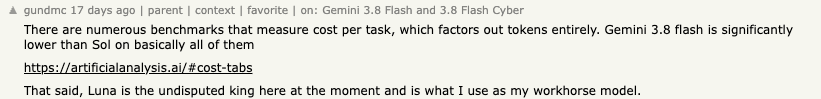
Ces quatre commentaires Hacker News portent sur le code, l’utilité d’une démonstration, l’accès aux anciennes versions et le coût par tâche. simonw apprécie une modification du rendu HTML avec 3.8 ; wyrdcurt en questionne l’utilité ; robertwt7 évoque l’accès aux anciennes versions en Australie ; gundmc préfère Luna et insiste sur le coût par tâche. Ce sont des expériences individuelles, pas un benchmark commun.

Un petit échantillon d’extraction dans Tabbit avant le classement
Le 20 septembre 2026, un compte de test éditorial a exécuté une tâche d’extraction synthétique dans Tabbit Browser avec Gemini 3.8 Flash. Le JSON retourné contenait les quatre champs attendus et n’a pas marqué comme en retard un enregistrement sans statut. Voir la capture
{"currency":"USD","paid_total":145,"overdue_ids":["B"],"unknown_status_ids":["D"]}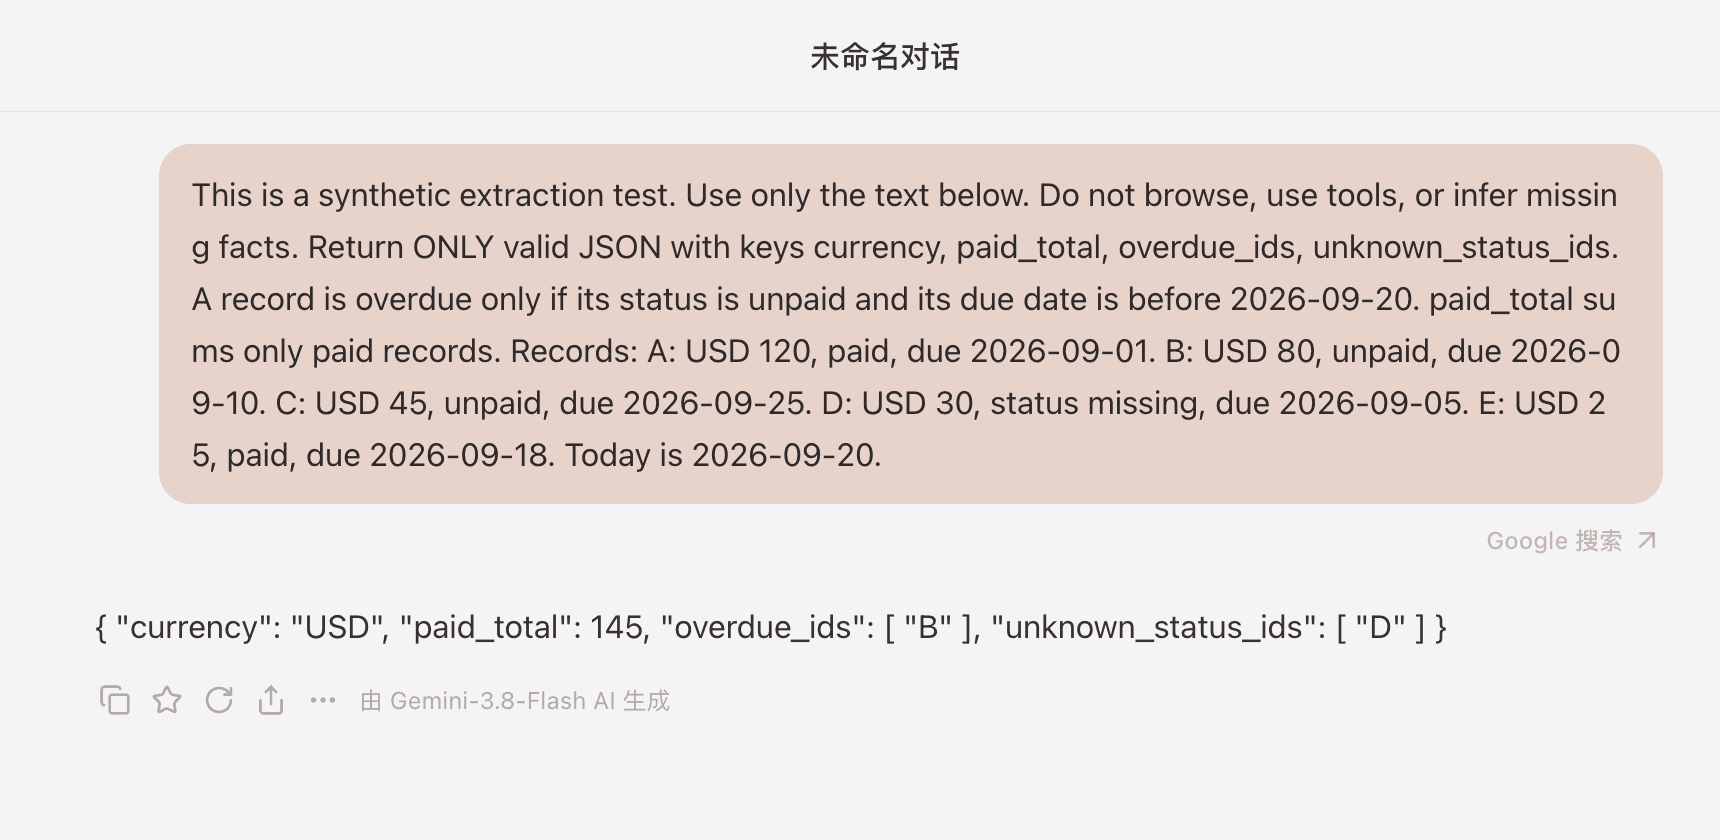
C’est un exemple unique de sortie structurée, pas une expérience personnelle de l’auteur ni un benchmark. Le niveau de raisonnement, la version API, les tokens, le coût, le first-token latency et le taux de réussite n’ont pas été mesurés ; un marqueur de recherche Google était visible.
La photo du benchmark est utile mais étroite
| Niveau | Version et date | Intelligence Index | Vitesse de sortie | Coût par tâche d’indice | first-token latency | Ce que cela montre |
|---|---|---|---|---|---|---|
| High | v4.3.2, 20-09-2026 | 41 | 305 tokens/s | $1.24 | Inconnu | Instantané fort sous raisonnement élevé. |
| Medium | v4.3.2, 20-09-2026 | 40 | Inconnu | $0.93 | Inconnu | Indice proche avec coût affiché plus bas. |
| Low | v4.3.2, 20-09-2026 | 33 | Inconnu | Inconnu | Inconnu | Indice plus bas, vitesse et coût absents. |
305 tokens/s mesure la génération, pas le temps jusqu’au premier token. Google annonce dans son article de lancement des progrès face à 3.7, mais cela reste une déclaration du fournisseur. Le contexte de sortie est dans l’article de présentation.
Medium coûte 25 % de moins par tâche de l’Intelligence Index ((1,24 - 0,93) / 1,24) tout en affichant 40 contre 41 pour high. Ce snapshot ne prouve ni l’équivalence statistique ni un coût de production ; il indique seulement qu’il faut tester medium en premier.
Forces, limites et retours contradictoires
La documentation mentionne function calling, code execution, file search, structured outputs, URL context et computer use preview. Cette combinaison convient à un cycle lire-planifier-appeler-vérifier, mais le SDK ou le client choisi peut ne pas exposer tous ces outils. Les entrées multimodales et la grande fenêtre favorisent les documents ; pour une classification courte, l’effort supplémentaire peut coûter sans changer le résultat.
La divergence vient de l’unité de succès : démo impressionnante, tâche terminée ou valeur économique. Avant un déploiement, définissez un critère mesurable, par exemple extraire 40 champs de deux PDF avec citations, puis mesurez durée, corrections, reprises, tokens et coût.
La portée du test Tabbit Browser
L’échantillon Tabbit enregistré a renvoyé le JSON à quatre champs attendu et conservé correctement le statut inconnu. Un marqueur de recherche Google était visible : l’exécution sans outil n’est donc pas prouvée. Le first-token latency, les tokens, le coût, le niveau de raisonnement et la fiabilité longue n’ont pas été mesurés. C’est un exemple reproductible, pas une garantie de production.
Choisissez une tâche reproductible dans les guides de prompts (English) et vérifiez les sources de la revue (English).
 Tabbit Browser
Choix par charge de travail
| Charge ou contrainte | Conseil | Niveau initial | Attention |
|---|---|---|---|
| Code multi-fichiers, outils, débogage | Essayer 3.8 Flash | medium puis high | Mesurer tests, reprises et tokens |
| PDF, image, vidéo, audio | Essayer si le client le permet | medium | Vérifier limites et extraction |
| Réécriture, classification, volume | Comparer un modèle léger | low | L’effort peut ne rien ajouter |
| Première réponse critique | Ne pas supposer un avantage | low ou alternative | first-token latency inconnu |
| Budget fixe | Pilote avec limites de tokens et reprises | low/medium | API, abonnement et Tabbit sont distincts |
Avant de choisir, comparez les alternatives, l’analyse des prix, la page du modèle (English) et l’automatisation du navigateur.
Verdict
Gemini 3.8 Flash est un candidat crédible pour le travail difficile, multimodal et outillé. La preuve la plus utile est l’association de plusieurs entrées, outils et niveaux de raisonnement, avec un indice high de 41. La limite principale reste l’absence de plusieurs mesures de vitesse, de first-token latency et de coût, ainsi que l’augmentation possible des tokens.
Faites un pilote sur deux tâches réelles avant de changer le modèle par défaut. Définissez la réussite, utilisez le même prompt et les mêmes outils, puis comparez temps, corrections, tokens et coût. Si le gain de qualité paie le surcoût, gardez 3.8 pour cette catégorie. Pour la suite, consultez les alternatives, la ressource modèle (English) et le guide des navigateurs IA.

Questions fréquentes
Gemini 3.8 Flash vaut-il le coup ?
Il mérite un essai pour les tâches longues, multimodales et utilisant des outils lorsque la qualité d’achèvement compte plus qu’une latence parfaitement prévisible. Les sources publiques ne prouvent pas qu’il est le meilleur partout et un raisonnement plus poussé peut augmenter les tokens.
Comment lire les résultats de benchmark ?
Il faut conserver la version, le niveau de raisonnement, la métrique et la date. Dans l’instantané v4.3.2 d’Artificial Analysis vérifié le 20 septembre 2026, high affiche un indice de 41, 305 tokens/s et 1,24 dollar par tâche d’indice ; les champs absents restent inconnus.
305 tokens/s signifie-t-il une première réponse rapide ?
Non. Il s’agit de la vitesse de génération, pas du first-token latency. La page consultée ne publiait pas de valeur first-token latency.
Gemini 3.8 Flash est-il disponible dans Tabbit Browser ?
Un test unique de Tabbit Browser a renvoyé le JSON à quatre champs attendu pour une extraction synthétique. L’interface affichait aussi un marqueur de recherche Google : cela ne prouve ni l’exécution sans outil, ni la disponibilité en production, ni la latence, le coût ou la fiabilité générale.
Qui devrait l’éviter ?
Les équipes qui exigent une latence stricte, un budget fixe ou un outil client précis doivent d’abord comparer un modèle plus léger et les alternatives.