
Gemini 3.8 Flash merece una prueba seria para tareas largas, con herramientas y multimodales. No es un ganador universal. Google lo presenta como un modelo Flash de trabajo para ingeniería de software, agentes autónomos y flujos empresariales complejos. La evidencia pública permite una conclusión condicional: la instantánea independiente con razonamiento alto es sólida, pero faltan datos de latencia y los niveles no son intercambiables.
El ancla contraintuitiva: medium cuesta 25% menos por tarea y queda a un punto
Artificial Analysis muestra 1,24 dólares por tarea del Intelligence Index para high y 0,93 para medium. Medium cuesta un 25% menos, (1,24 - 0,93) / 1,24, mientras el índice es 40 frente a 41. Es una instantánea fechada: no demuestra equivalencia estadística ni garantiza el coste de producción; sugiere probar medium primero.
La elección depende del cuello de botella. Usa Gemini 3.8 Flash cuando el trabajo necesita planificación sostenida, entradas grandes o llamadas repetidas a herramientas. Mantén otra opción cuando el tiempo hasta la primera respuesta, el presupuesto fijo o el soporte exacto del cliente sean más importantes. Esta revisión combina fuentes públicas con una extracción realizada en una cuenta de prueba de Tabbit. Más adelante explico el papel posible de Tabbit Browser como capa de contexto y su límite de disponibilidad.
Conclusiones clave
El razonamiento admite low, medium y high; minimal no está soportado. Los tokens de razonamiento cuentan en la salida facturable.
En Artificial Analysis v4.3.2, consultado el 20-09-2026, high muestra índice 41, 305 tokens/s y 1,24 dólares por tarea; medium 40 y 0,93 dólares; low 33. Los valores no publicados no se rellenan.
Es un candidato para tareas difíciles de varios pasos. No cambies todos los valores predeterminados basándote en una demostración y no deduzcas acceso de producción de Tabbit a partir de un selector.
Condiciones y método
La pregunta útil es qué puede decidir un comprador con evidencia pública. Hay que mantener juntos versión, nivel de razonamiento, métrica y fecha.
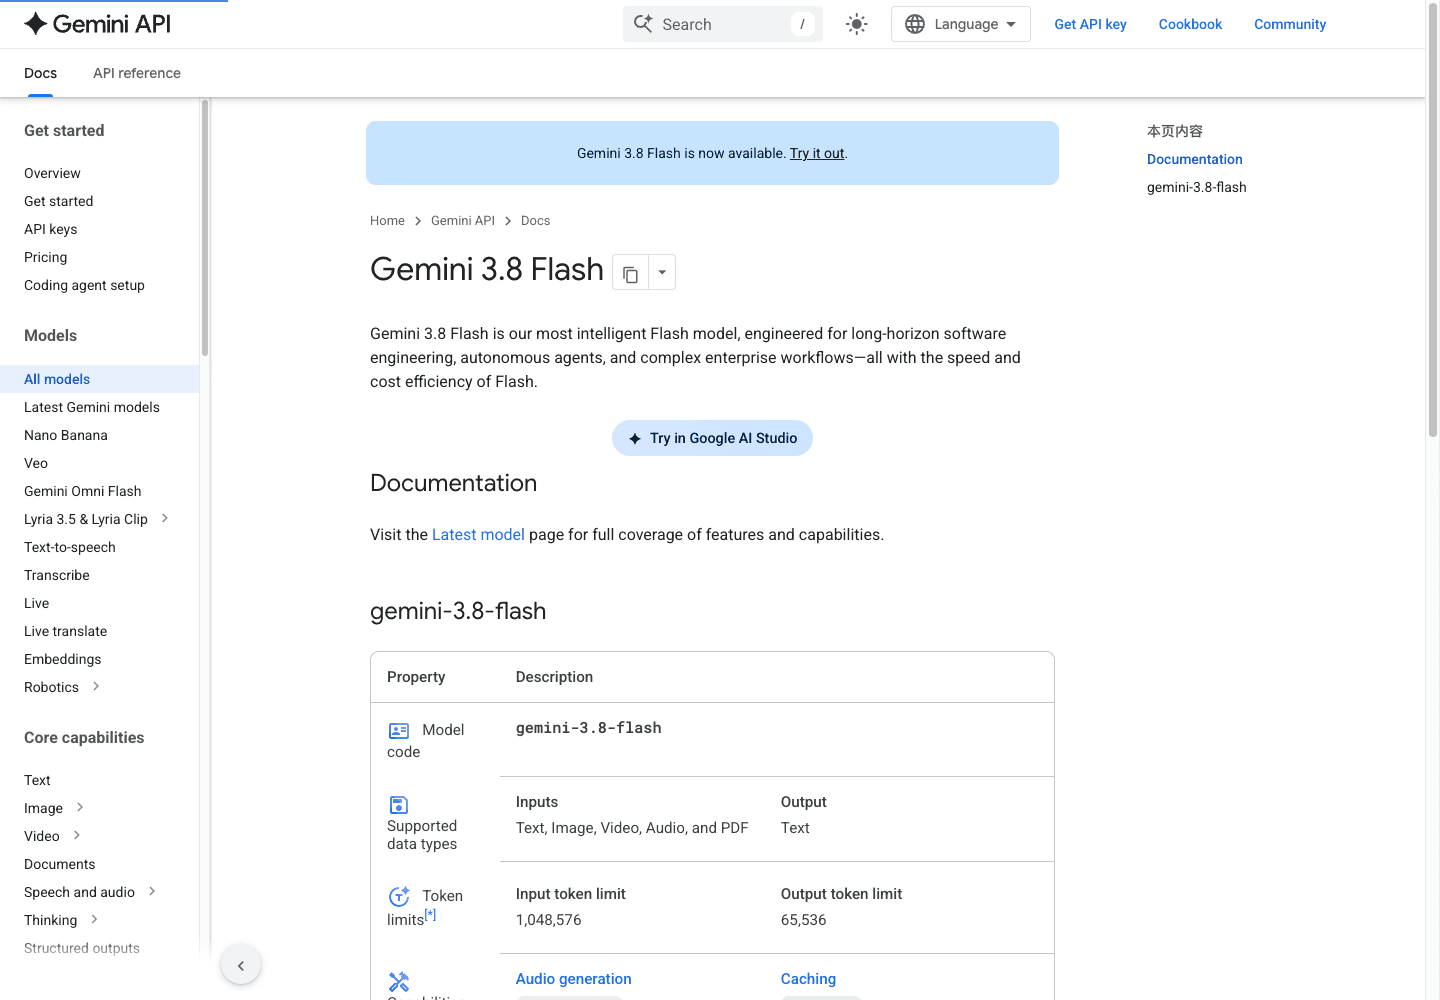
Una muestra de extracción en Tabbit, antes de la tabla
El 20 de septiembre de 2026, una operación asistida por editorial ejecutó una tarea sintética de extracción en Tabbit Browser con Gemini 3.8 Flash. La respuesta JSON devolvió los cuatro campos esperados y no clasificó como vencido un registro cuyo estado faltaba. Ver la captura del ejemplo.
{"currency":"USD","paid_total":145,"overdue_ids":["B"],"unknown_status_ids":["D"]}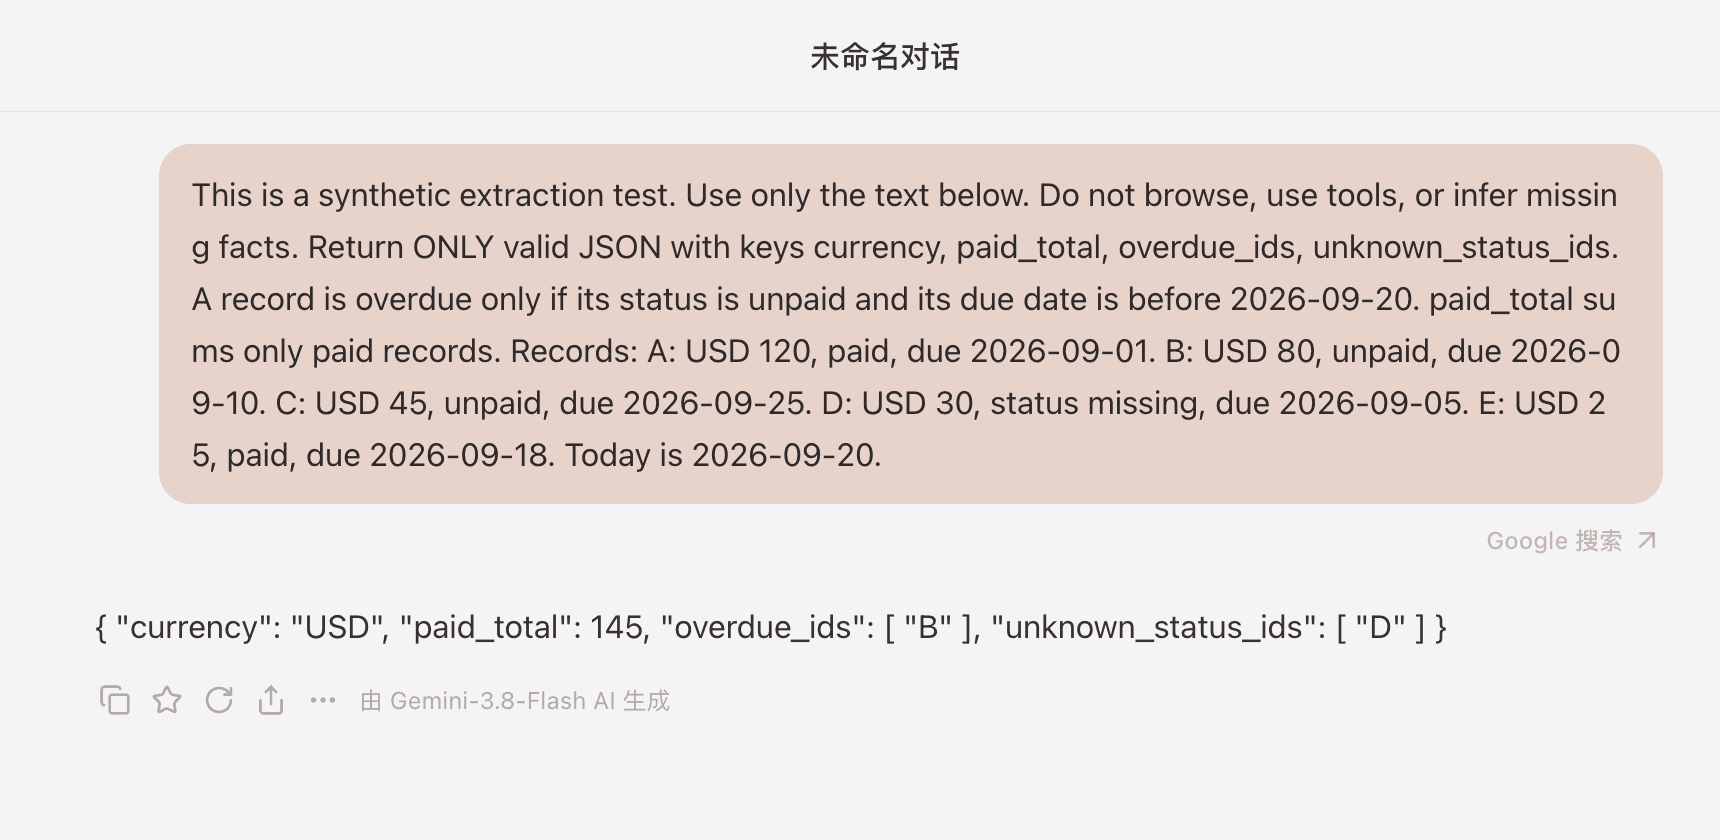
Es una muestra única de salida estructurada, no una prueba personal del autor ni un benchmark. No se midieron nivel de razonamiento, versión API, tokens, coste, first-token latency o tasa de éxito. La interfaz mostró una marca de búsqueda de Google, así que no prueba que las herramientas estuvieran desactivadas ni la disponibilidad para todas las cuentas.
La instantánea pública es útil, pero limitada
| Nivel | Versión y fecha | Intelligence Index | Velocidad de salida | Coste por tarea del índice | first-token latency | Qué permite decir |
|---|---|---|---|---|---|---|
| High | v4.3.2, 20-09-2026 | 41 | 305 tokens/s | $1.24 | Desconocido | Instantánea fuerte con velocidad de generación visible. |
| Medium | v4.3.2, 20-09-2026 | 40 | Desconocido | $0.93 | Desconocido | Índice cercano al high con menor coste listado. |
| Low | v4.3.2, 20-09-2026 | 33 | Desconocido | Desconocido | Desconocido | Índice inferior; faltan velocidad y coste. |
Desconocido no significa cero. Además, 305 tokens/s no es tiempo hasta el primer token. Google afirma en su anuncio de lanzamiento mejoras frente a 3.7 en ingeniería y tareas agentic, pero son afirmaciones del proveedor. Para el contexto consulta el resumen de Gemini 3.8 Flash.
El ancla contraintuitiva es el coste por tarea: medium cuesta un 25% menos que high por tarea del Intelligence Index, (1,24 - 0,93) / 1,24, pero queda a un punto del índice (40 frente a 41). Es una instantánea, no equivalencia estadística ni garantía de coste en producción; sugiere probar medium antes de usar high por defecto.
Fortalezas y límites reales
La documentación enumera function calling, code execution, file search, structured outputs, URL context y computer use preview. Es una buena combinación para leer, planificar, llamar a una herramienta y comprobar el resultado. El SDK o cliente que elijas puede exponer solo una parte.
La entrada multimodal y la ventana de un millón de tokens favorecen el análisis de documentos. La salida es texto y no se documenta generación de imagen o audio. Para una clasificación o reescritura corta, un razonamiento mayor puede costar más sin cambiar la respuesta.
Tres fortalezas y tres límites
Flujos con herramientas
Las herramientas documentadas encajan con tareas de leer, planificar, actuar y verificar; cada cliente puede exponer menos.
Entradas grandes y multimodales
La API admite texto, imágenes, vídeo, audio y PDF con entrada de 1M tokens. Los límites del cliente y la extracción aún requieren pruebas.
Salida estructurada con una muestra acotada
La muestra de Tabbit devolvió el JSON esperado y conservó el estado desconocido. La marca de Google Search y una sola ejecución impiden generalizar.
El razonamiento aumenta el coste
Google factura los tokens de razonamiento como salida. Medium cuesta 25% menos por tarea del índice, sin garantizar el coste de producción.
Sin promesa de latencia inicial
Las páginas no ofrecen una medición utilizable del primer token. Los 305 tokens/s describen generación, no una primera respuesta garantizada.
El cliente y producción tienen alcances distintos
Una opción visible en Tabbit y una muestra de una cuenta no prueban el mismo soporte para todos los clientes, regiones o rutas.
Qué aportan cuatro comentarios de Hacker News
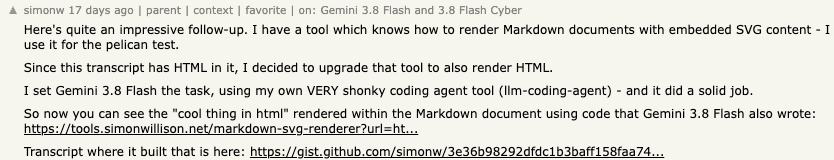
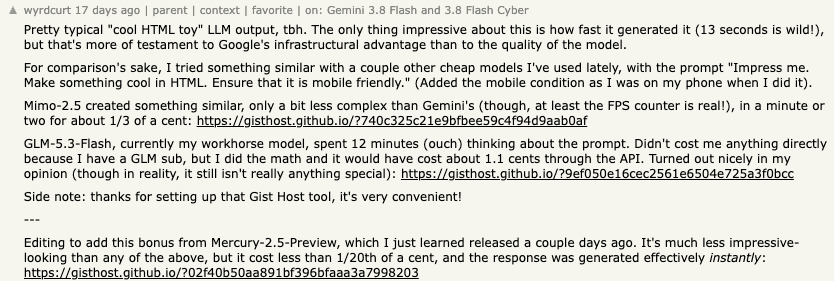

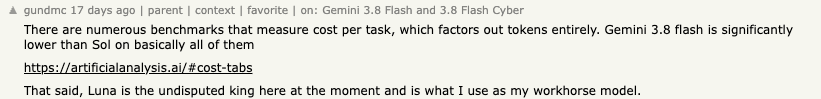
Los cuatro originales abiertos muestran experiencias individuales, no rendimiento universal. simonw describe un buen resultado HTML en su agente de código; wyrdcurt lo llama un “cool HTML toy” y menciona 13 segundos en aquella conversación antigua, no un first-token latency actual; robertwt7 señala utilidad fuera del código pero acceso a una versión antigua en Australia; gundmc remite al coste por tarea y mantiene otro modelo como principal. Son preferencias y límites individuales.
El límite práctico de Tabbit Browser
La muestra registrada de Tabbit devolvió el JSON de cuatro campos esperado y conservó correctamente el estado desconocido. La interfaz mostró una marca de búsqueda de Google, por lo que no prueba ejecución sin herramientas; tampoco midió first-token latency, tokens, coste, nivel de razonamiento ni fiabilidad prolongada. Es un ejemplo reproducible, no una garantía de producción.
Elige una tarea reproducible en las guías de prompts (English) y consulta las fuentes de evaluación (English).
 Tabbit Browser
Recomendación por carga de trabajo
| Carga o restricción | Recomendación | Nivel inicial | Motivo | Riesgo |
|---|---|---|---|---|
| Código en varios archivos, herramientas y depuración | Probar 3.8 Flash | medium, luego high | Diseñado para trabajo agentic sostenido | Medir pruebas, reintentos y tokens |
| Reescritura, clasificación y texto rutinario | Comparar un modelo ligero | low | El esfuerzo extra puede no aportar valor | Coste low desconocido |
| Primera respuesta crítica | No asumir ventaja | low u otra opción | first-token latency no publicado | Velocidad de salida no es first-token latency |
| Presupuesto fijo | Piloto con límites de tokens y reintentos | low/medium | El razonamiento cuenta en salida | API, suscripción y Tabbit son costes distintos |
| Investigación en muchas páginas | Usar Tabbit como capa de contexto solo si funciona | Según el cliente | Reduce cambios de contexto | Acceso de Tabbit no verificado |
Antes de decidir, compara las alternativas, el análisis de precios, la página del modelo (English) y la automatización del navegador.
Veredicto: mejora condicional
Gemini 3.8 Flash es una opción creíble para trabajo difícil, multimodal y con herramientas. La evidencia más fuerte es la combinación de entradas, herramientas y tres niveles, junto al índice high de 41. La limitación principal es que velocidad, first-token latency y coste no están completos para cada nivel y que pensar más puede usar más tokens.
Antes de cambiar el modelo predeterminado, ejecuta dos tareas reales con criterios de éxito definidos, repeticiones y registro de tiempo, correcciones, tokens y coste. Compáralas con el modelo actual usando el mismo prompt y herramientas. Si la calidad adicional paga el coste adicional, conserva 3.8 para esa clase de tareas. Para comparar familias, lee las alternativas de Gemini 3.8 Flash, el recurso del modelo (English) y la guía de navegadores de IA.

Preguntas frecuentes
¿Vale la pena usar Gemini 3.8 Flash?
Merece una prueba para tareas largas, multimodales y con herramientas cuando la finalización importa más que una latencia perfectamente predecible. La evidencia pública no demuestra que sea el mejor para todo y un nivel de razonamiento alto puede aumentar el uso de tokens.
¿Cómo debo leer los benchmarks de Gemini 3.8 Flash?
Hay que conservar la versión, el nivel de razonamiento, la métrica y la fecha. En la instantánea v4.3.2 de Artificial Analysis consultada el 20 de septiembre de 2026, high muestra índice 41, 305 tokens de salida por segundo y 1,24 dólares por tarea del índice; los campos ausentes siguen siendo desconocidos.
¿Pensar más aumenta el coste?
Google incluye los tokens de razonamiento en el precio de salida. Un nivel mayor puede mejorar una tarea difícil, pero también aumentar el consumo y el coste.
¿305 tokens por segundo significa una primera respuesta rápida?
No. Es velocidad de generación, no first-token latency. La página consultada no mostraba first-token latency numérico.
¿Está Gemini 3.8 Flash disponible en Tabbit Browser?
Una prueba de Tabbit Browser devolvió el JSON de cuatro campos esperado para una extracción sintética. La interfaz mostró una marca de búsqueda de Google, así que no prueba ejecución sin herramientas, disponibilidad de producción, latencia, coste ni fiabilidad general.
¿Quién debería evitarlo?
Los equipos con latencia estricta, presupuesto fijo o una herramienta concreta garantizada deben comparar primero modelos ligeros y alternativas.