
如果你的工作負載是高用量編碼、自動化或以每任務成本定預算的 agent 迴圈,GPT-6 Sol 值得切換;如果你需要最高的知識工作上限,或者一個絕不半途放棄任務的 agent,那就先別動。半價費率卡是真的:輸入每百萬 token $2、輸出 $10,是 GPT-5.6 Sol 促銷價的一半——這是 2026 年 9 月 23 日在 OpenAI 模型卡上核對過的。但這篇評測真正有趣的地方不是價格,而是模型變準的方式:Artificial Analysis 測到它的幻覺率從 92% 降到 60%,同時它嘗試回答的問題比例從 99% 降到了 83%。精確地說,新的 Sol 是一個「更少回答」的模型。
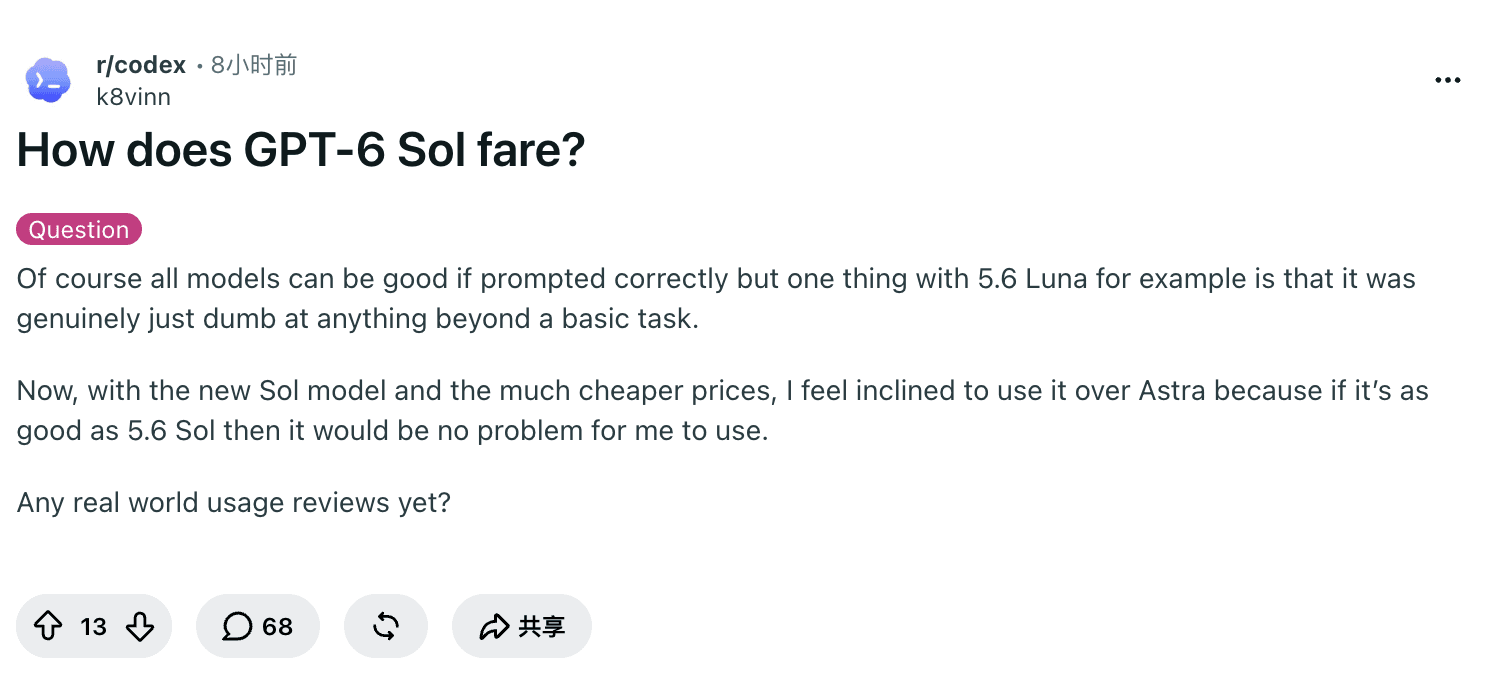
這個交換正是發布社群吵翻天的焦點。發布 4 小時後,u/k8vinn 在 r/codex 開了一個討論串,問的正是這篇評測要回答的問題:「新 Sol 便宜了這麼多,我傾向於用它替代 Astra——只要它有 5.6 Sol 那麼好,用起來就沒問題。有真實使用評測了嗎?」("Any real world usage reviews yet?")(Reddit)
GPT-6 Sol 費率卡我們另外拆解過,GPT-6 Sol 對 Claude Opus 5.5 的比較負責二選一問題,同門的 GPT-6 Astra 評測也已發布。這一篇負責裁決:GPT-6 Sol 哪裡真的變好了,哪裡會咬人,哪些工作負載該切、該留、該走。如果你想拿它處理真實網頁而不是測試基準,文末會給一條瀏覽器層的路線。
核心結論
智力持平,價格減半。 Artificial Analysis 給出 GPT-6 Sol (max) 的 Intelligence Index 為 48——與 GPT-5.6 Sol 持平——每任務 $1.06 對 $1.99;費率卡從 $4/$20 降到 $2/$10。
準確率提升是一場棄答交換。 AA-Omniscience 上幻覺率從 92% 降到 60%,代價是嘗試率從 99% 降到 83%,已答題目的準確率從 59% 微降到 54%。
Token 效率是安靜的升級。 Sol (max) 在 AA 全套測試裡生成 77M token,低於 88M 的中位數;實務工作者報告 Codex 任務對週配額的消耗小得多。
它不是知識工作升級。 Sol 在 GDPval-AA v2.1 上跌了約 100 Elo;48 的 II 也低於 GPT-6 Astra(53)和 Claude Opus 5.5(58)。
本週的平台現實很重要。 Sol 進了 ChatGPT Work 和 Codex,但沒進 Chat;訂閱用戶回報 6 代模型的 Plus 配額燒得飛快;走 Chat Completions 的 API 團隊在
reasoning_effort高於 none 時沒有 function calling。
決定這篇評測的那個數字:靠少答題換來的準確率
基準測試給 GPT-6 Sol 的開場是聳肩:Artificial Analysis 的發布評註寫道「Intelligence Index 和 Coding Agent Index 與 GPT-5.6 持平,部分評估有進展,部分退步。」兩行之後,同一段文字給出了真正改變行為的數字:在知識與幻覺基準 AA-Omniscience 上,GPT-6 Sol (max) 的幻覺率從 92% 降到 60%,而實現方式是嘗試率從 GPT-5.6 Sol (max) 的 99% 降到 83%——答錯的大約少了四分之一,但已答題目的準確率從 59% 降到 54%(Artificial Analysis,2026 年 9 月 23 日核對)。
翻譯成工程語言:OpenAI 用覆蓋率換了正確性。這個模型更少舉手,而且舉手時每次回答的準確率還比上代略低——但「自信地答錯」的總量塌縮了。OpenAI 自己的事實性評測講的是同一個故事:在使用者標記過錯誤的真實對話樣本上,「GPT-6 Sol 的錯誤數量大約是上代的一半,接近 Astra 級的可靠性」(官方公告)。注意 OpenAI 附帶的邊界:這些對話是篩出來「會誘發錯誤」的,不代表典型用量;分數也沒有控制長度。
這篇評測的每個判斷都按同一個問題分揀:你的成本是被「答錯」主導,還是被「答不出」主導?如果答錯代價高——程式碼審查、合規、給下游系統餵資料的擷取——棄答交換是實打實的升級。如果覆蓋率才是本職——agent 管線裡一次拒答就意味著卡死任務和永遠做不完的頁面——同一個設計就表現為退步。記住這根軸,裁決環節它還會回來。
基準數據,以及該信幾分
以下所有獨立資料來自 2026 年 9 月 23 日的同一次 Artificial Analysis 快照,並標注 effort 檔位——因為 effort 正是發布週比較裡最常見的作弊點。價格列來自 OpenAI 模型卡與同日發布的定價指南。
| 維度 | GPT-6 Sol (max) | GPT-5.6 Sol (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max w/ fallback) | 這意味著什麼 |
|---|---|---|---|---|---|
| API 價格,輸入/輸出每百萬 | $2 / $10 | $4 / $20(促銷至 11 月 21 日) | $10 / $50 | $4 / $20 | Sol 輸入價與 Opus 5.5 持平,輸出只有它一半。 |
| AA Intelligence Index | 48 | 與 Sol 持平 | 53 | 58 | 你買到的是更便宜的同檔智力,不是更多智力。 |
| AA 每任務成本(II) | $1.06 | $1.99 | $3.26 | $5.98 | 5.6 Sol 的一半、Astra 的三分之一、Opus 5.5 max 檔的約 18%。 |
| 幻覺率,AA-Omniscience | 60% | 92% | 未報告 | 未報告 | 頭條的準確率勝利。 |
| 同基準嘗試率 | 83% | 99% | — | — | ……以及代價:它答得更少。 |
| GDPval-AA v2.1(知識工作) | 較前沿約 −100 Elo | 未報告 | 未報告 | 1846 Elo(Anthropic 報告) | 別僱 Sol 做專家級知識工作。 |
| 輸出速度(AA 中位) | 131 tok/s | 未報告 | 58 tok/s | 未報告 | 中游:比 Astra、Fable 5.1 快,遠慢於 Flash 級。 |
| 上下文 / 最大輸出 | 1.05M / 128K | 1M / 32K | 1.05M / 128K | 1M / 128K | 規格來自廠商模型頁;272K 計費門檻全家通用。 |
在相信任何一行之前,先潑三盆冷水:
廠商分數跑在自家 harness 上。 OpenAI 發布的 AutomationBench、Agents' Last Exam(Sol max 56.4%,成本只有 Opus 5 最佳的 40%)、DeepSWE(68.8% 對 Fable 5 的 69.9%,成本低約 80%)、OSWorld 2.0 offline(60.5% ≈ Opus 5 medium 的 60.3%,成本低約 80%)全部是自報成績;公告自己的腳註承認評測跑在「可能與生產 ChatGPT 輸出略有不同」的研究環境或 API 裡,競品分數取自公開報告。方向性有用,不是福音。
指數數值會漂移。 我們一天前發布的 GPT-6 Astra 評測引用的 AA Intelligence Index 還是 Astra 61.2、5.6 Sol 60.9;同一個追蹤器現在列的是 Astra 53、Sol 48。Artificial Analysis 會對指數做版本化重定基——只在同一次快照內比較模型,永遠不要跨週比。
Effort 錯位是發布週的作弊碼。 Sol 公開的成績多是 max 檔;Opus 5.5 的頭條數字常是 medium 預設檔。任何不標明雙方檔位的「Sol 贏了/輸了」都是行銷。我們的比較文做了成本對齊版的那道數學。
基準在這裡是方向針,不是尺。這個階段更有分量的是真實任務的實測——而發布後 24 小時給出了一組出奇一致的訊號。
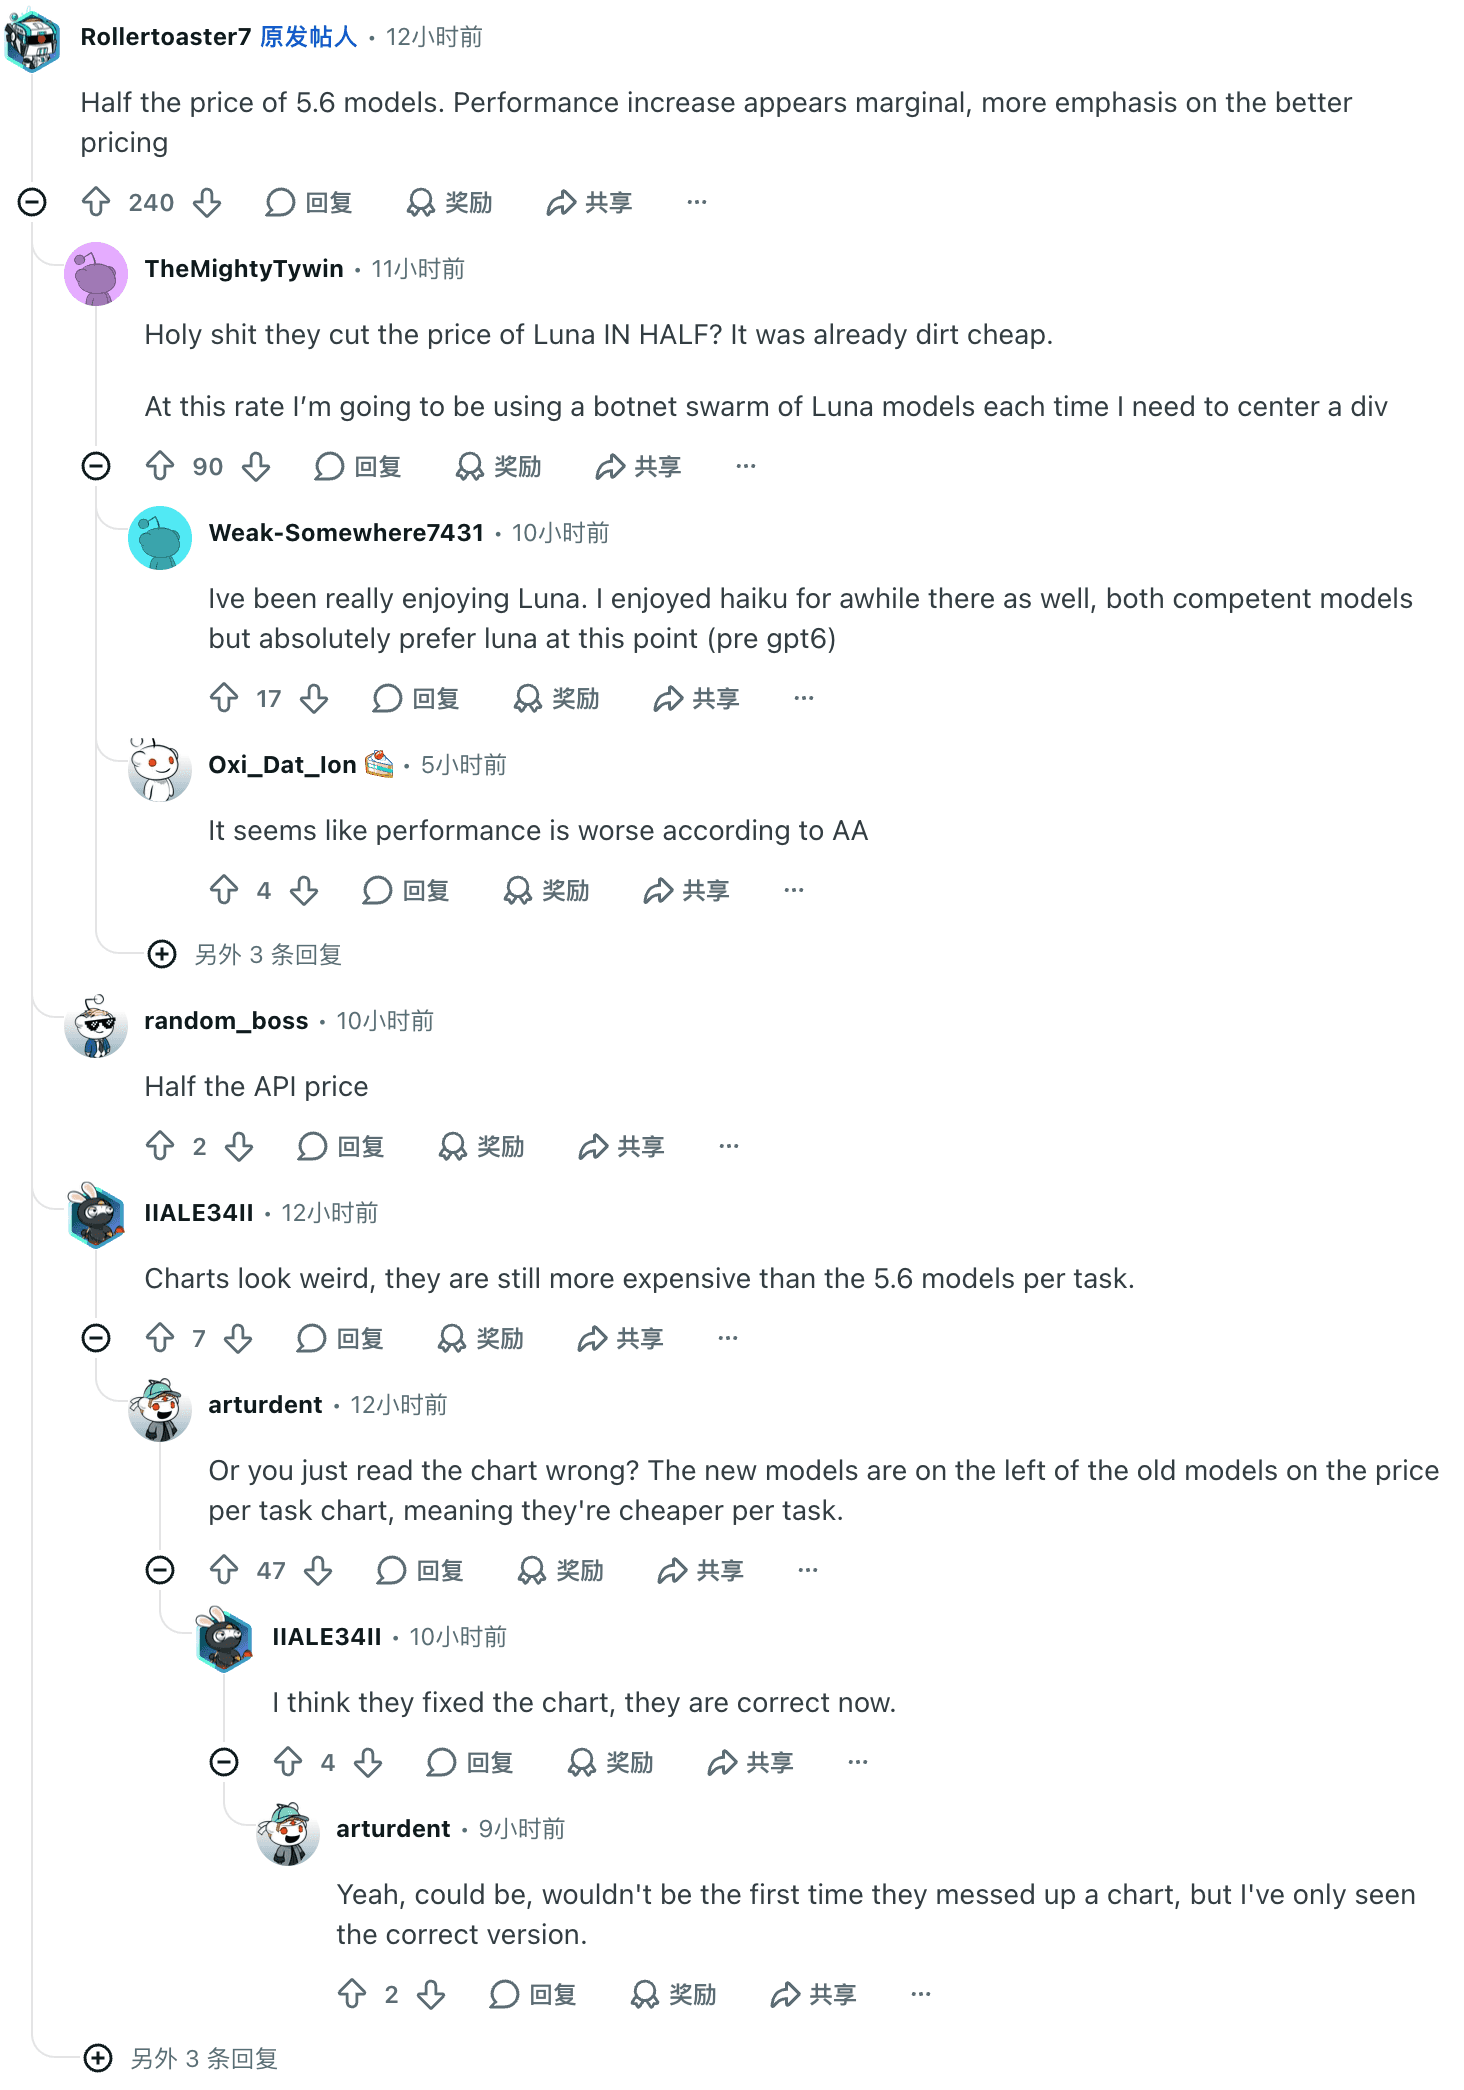
「價格減半、效能平平」是 r/codex 發布討論串幾小時內的最高讚評論:原 PO u/Rollertoaster7 一句「Half the price of 5.6 models. Performance increase appears marginal, more emphasis on the better pricing」(半價,效能提升看起來微乎其微,重點在更好的定價)拿了 240 讚,還有使用者直接引用了 AA 的好壞參半(Reddit)。獨立評測機構 Vals AI 從自己的基準得出同一個平台期:「GPT-6 Sol……在 Vals Index 排名第 8,與 GPT 5.6 Sol 大致持平,成本是一半」(X)。
GPT-6 Sol 真正好的地方
1. 事實性:更少的自信錯誤
棄答機制不只是基準現象——它在真實管線裡的樣子,是一個「會反駁而不是順著說」的模型。一位 Hacker News 使用者描述了把 Sol 當成另一個模型程式碼審查的「第二意見」:"i used it for code review and it flagged twenty issues, sol checked the review and found 75% of them were hallucinations. sol was much closer to reality."(我用它做程式碼審查:那個模型標了 20 個問題,Sol 複查後發現其中 75% 是幻覺,Sol 離現實近得多。)(HN)。單一軼事證明不了比率,但它與 AA 測量和 OpenAI「錯誤減半」的說法從三個獨立方向互相印證。如果你的工作負懲罰錯誤——審查、擷取、合規——這才是比任何指數分都重要的升級。
2. Token 效率:安靜的帳單削減
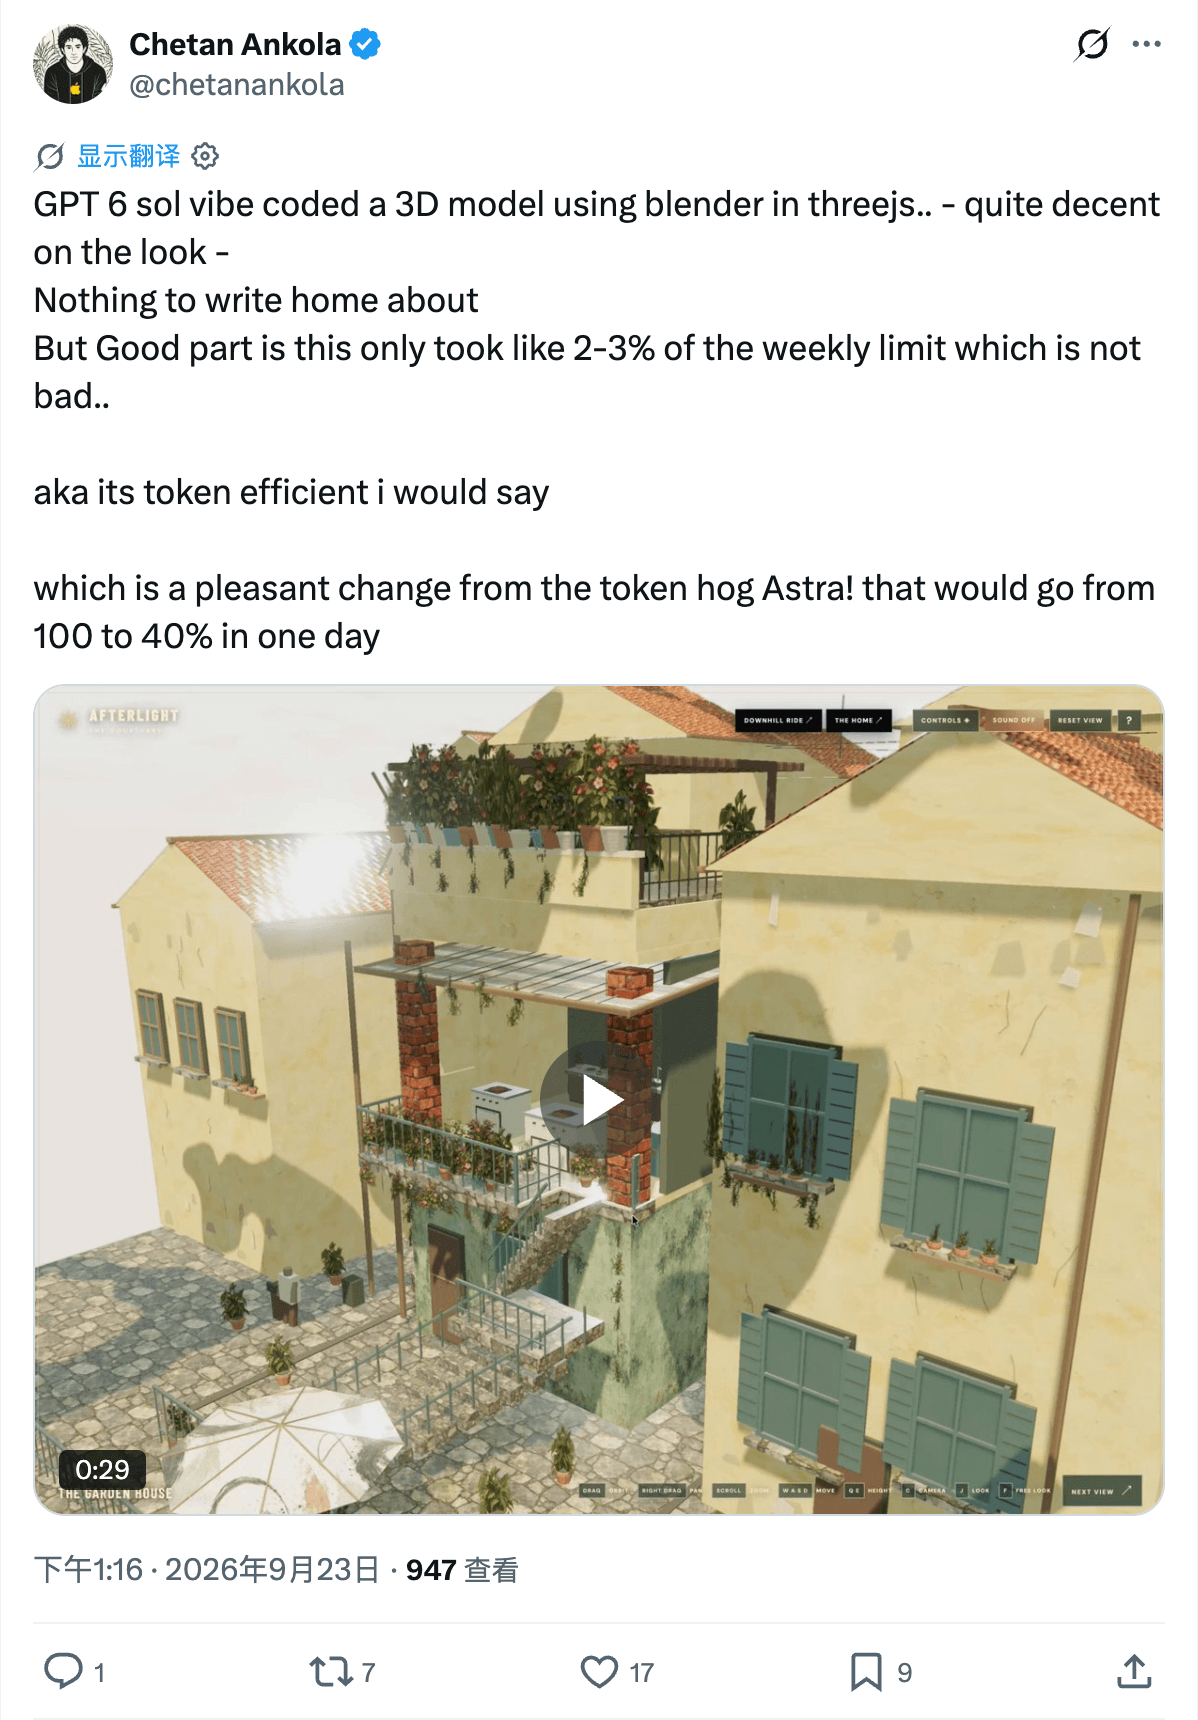
推理模型收兩次錢——一次是答案,一次是思考。Sol 在 AA 套件上的生成量為 77M token,低於 88M 的中位數;訂閱使用者也注意到同樣的「瘦」:r/codex 調侃「我的 Codex token 用量 < 黑洞」;X 上一位開發者量了一個 Blender/Three.js 任務:「只花了週配額的 2-3%……它的 token 效率我得說個好——和一天從 100% 燒到 40% 的吞 token 怪獸 Astra 相比,令人愉快」(X)。疊上費率卡,這就是為什麼 OpenAI 宣稱 Sol(xhigh) 在 AutomationBench 上以 Opus 5 (max) 每任務 9% 的成本勝出至少是可信的:更少的 token、更便宜的 token,正對自動化形狀的工作。
3. 寫作與協作風格
OpenAI 說 Astra 改進的溝通風格——「更清晰、更少行話」——延續到了 Sol;而這是罕見的在一天內就被獨立盲測印證的廠商聲明:How I AI 的盲測把「清晰的寫作、可讀的 PRD 和價格」列為 Sol 仍然勝出的地方(Lenny's Newsletter)。對那些程式碼之外還要交付文件的團隊——規格、PRD、審查紀要——這是沒有任何榜單列能捕捉的日常品質改進。
GPT-6 Sol 會咬人的地方
1. 棄答稅
上面每一條優點都有鏡像。一個只嘗試 83% 問題的模型,放進無人值守的 agent 管線,就是一個會交回 17% 空位的模型——每個空位都是一次卡死、一次重試或一次人工升級。AA 還量出了每答案的代價:已答題目的準確率從 59% 降到 54%;在度量「經濟價值知識工作」的 GDPval-AA v2.1 上,Sol 較前沿同行跌了約 100 Elo。知識工作的上限根本不是這個模型的目標。如果你的管線無法容忍拒答,從第一天就預留一個兜底模型。
2. 一部分社群把它讀成「Terra 換皮」
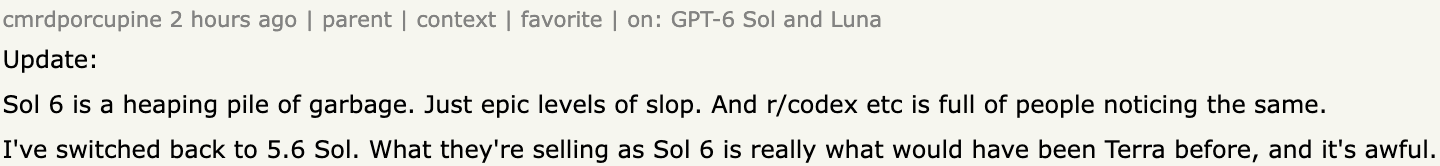
最尖銳的負面報告匯聚在同一主題:這是重新定價,不是換代。一位 Hacker News 開發者已經回退:"Update: Sol 6 is a heaping pile of garbage... I've switched back to 5.6 Sol. What they're selling as Sol 6 is really what would have been Terra before."(更新:Sol 6 是一堆垃圾……我換回了 5.6 Sol。他們當作 Sol 6 賣的東西,其實就是以前的 Terra。)(HN)。r/codex 上同一種直覺:「用過之後,它確實更笨。感覺更像 Terra。」測量的中間地帶是:指數在平均意義上持平,但「部分評估有進展、部分退步」意味著單個工作負載完全可能踩在退步的那一半上。如果你的 prompt 組合恰好落在退步的評估上,你的體感就會和平均數矛盾——兩邊都對,並不衝突。
3. 發布週的平台摩擦
三處現實摩擦會給本週的切換降溫。第一,可用性:Sol 進了付費方案的 ChatGPT Work 和 Codex,但還沒進 Chat,Free/Go 使用者只有 GPT-6 Luna(官方公告)。第二,訂閱經濟學:一位 Plus 使用者回報「它幾分鐘就燒穿了我的 Plus 用量,而 5.6 我能悠哉用幾小時。它會在一個簡單提示上空轉幾分鐘,然後在用量限制前放棄」(HN)——API 降價了,推理 token 照樣燒配額。第三,API 面:在舊的 Chat Completions 端點上,function calling 只在 reasoning_effort: none 下可用——工具呼叫工作流請走 Responses API——並且不支援微調(模型卡)。如果你因為用量行為留在 5.6 Sol,注意它的促銷價至少持續到 2026 年 11 月 21 日,我們的 1M 上下文設定指南也仍然適用。

社群到底怎麼說
24 小時的社群訊號沿著第二節的那根軸乾淨地分成兩半——而不是按技術水準或資深程度。
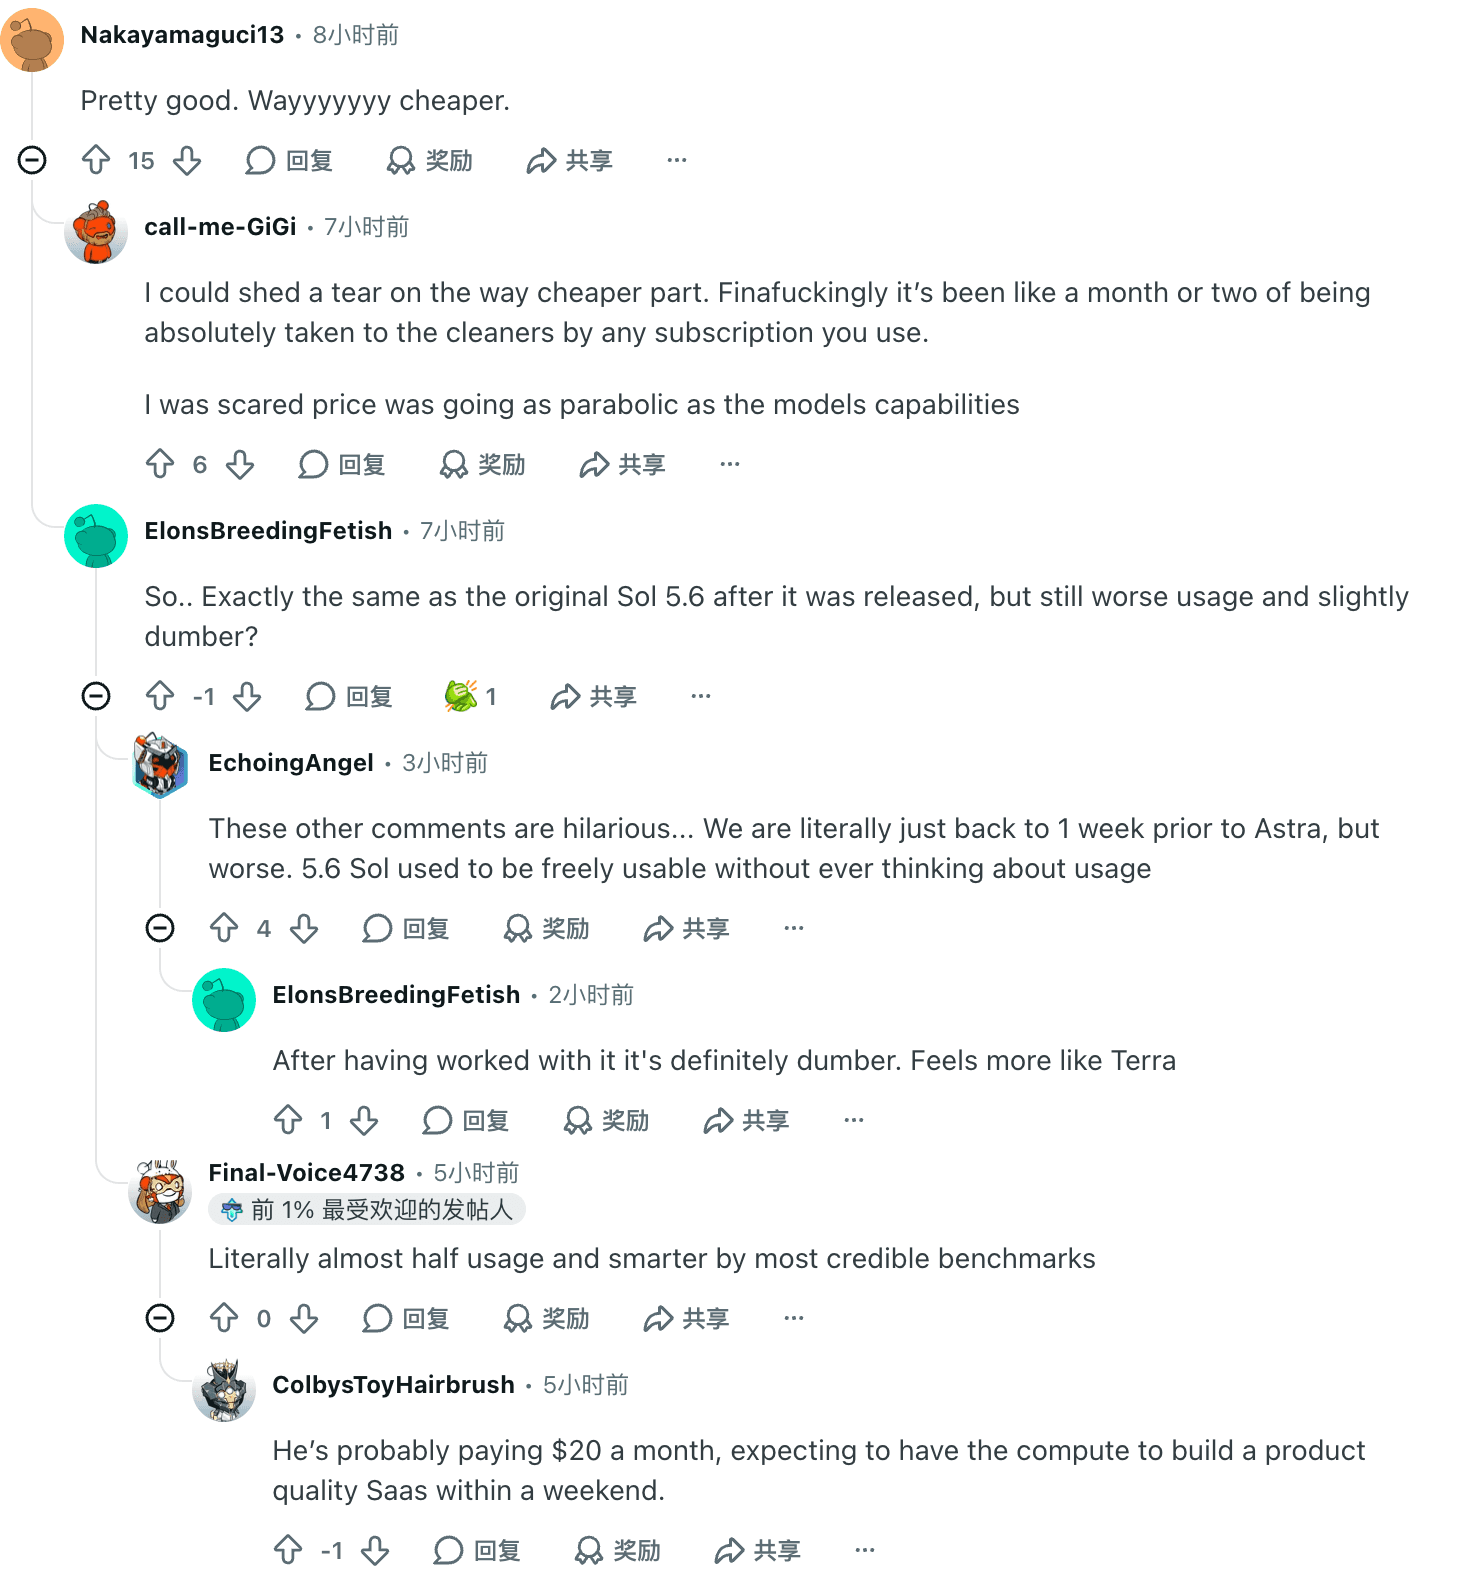
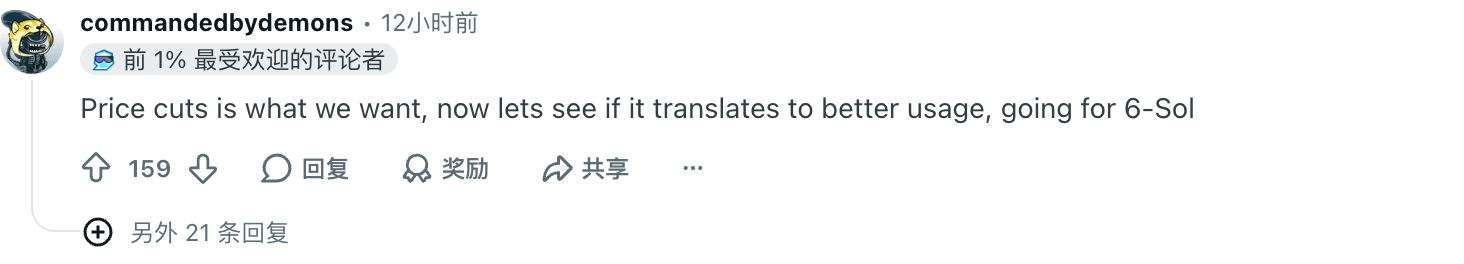
陣營一:「半價就是升級。」 "Pretty good. Wayyyyyyy cheaper."(好得很,便宜太多了。)(u/Nakayamaguci13)。"Literally almost half usage and smarter by most credible benchmarks"(用量幾乎減半,多數可信基準還更聰明)(u/Final-Voice4738)。觀望的大多數把 r/codex 串頂到 159 讚:"Price cuts is what we want, now lets see if it translates to better usage, going for 6-Sol"(降價就是我們要的,接下來看它能不能轉化為更好的使用體驗,我上 6-Sol 了)(u/commandedbydemons)。
陣營二:「這是重新定價,不是繼任者。」「它確實更笨。感覺更像 Terra。」(u/ElonsBreedingFetish)。"According to AA,效能反而更差了。"(u/Oxi_Dat_Ion)。cmrdporcupine 的回退是這個陣營最重的表態,見上文。
中間派握著真正的資訊。 Hacker News 的 u/mchusma 說出了大多數團隊面對的真實比較:"I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."(非常早期的測試裡,我個人更偏好 medium 檔的 Opus 5.5 而不是 max 檔的 GPT-6 Sol。價位相近,能力更多。)(HN)。
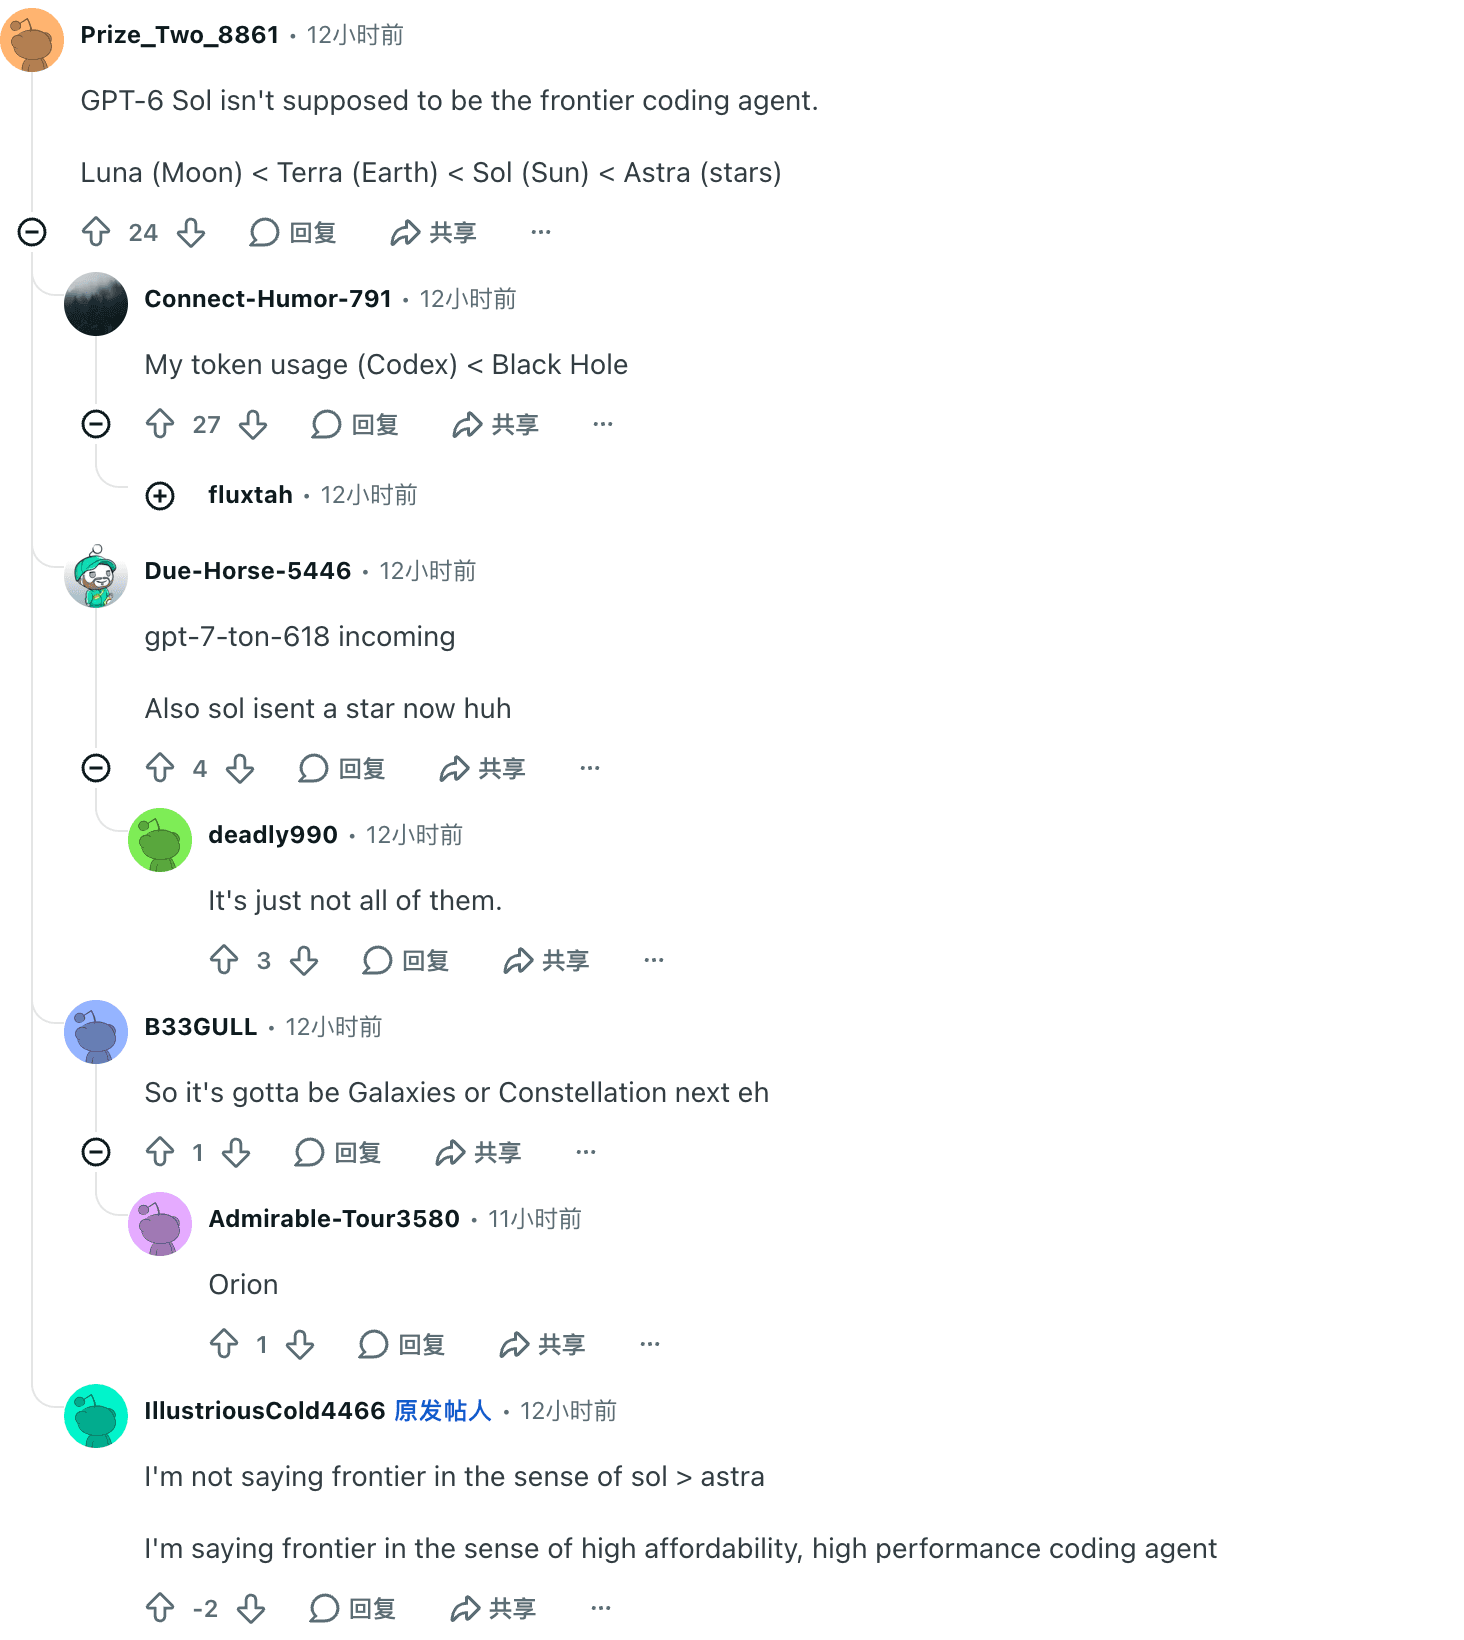

我們的編輯判斷:兩個陣營描述的是同一個設計選擇,只是站在各自的工作負載一側。答錯代價高的地方,Sol 比上代顯得更聰明;覆蓋率珍貴的地方,它顯得更笨。基準說「持平」,而兩個陣營都對——各自對上了平均值屬於自己的一半。
裁決:按工作負載選
| 你的工作負載 | 最佳選擇 | 理由 | 注意 |
|---|---|---|---|
| 高用量例行自動化、預算敏感的 agent 迴圈 | GPT-6 Sol(xhigh) | AutomationBench 上以 Opus 5 (max) 每任務 9% 的成本勝出;xhigh 檔約 $0.53/任務 | 上下文壓在 272K 計費懸崖之下;快取窗口 30 分鐘 |
| 日常編碼與「第二意見」程式碼審查 | GPT-6 Sol(high–max) | FrontierCode 與 Fable 5.1 xhigh 持平且成本低得多;能揪出幻覺結論 | 給棄答留兜底路徑;引用要核驗 |
| 30 分鐘以上的頑固自我除錯、長時程自主 | GPT-6 Astra | 溢價買的就是頑固——見 Astra 總覽與 Astra 評測 | 每任務成本 3 倍以上;高 effort 下首字延遲拉長 |
| 專家知識工作:法律、金融、深度分析 | Claude Opus 5.5 | Sol 在 GDPval 上跌約 100 Elo;Opus 以 58 領跑 II | 每任務成本最高;max 檔話多 |
| ChatGPT 端的日常聊天 | 暫留 5.6(免費檔 Luna,Plus 用 5.6 Sol) | Sol 還沒進 Chat;6 代配額燒穿是真的 | 留守則促銷價與 1M 上下文設定仍然適用 |
| 跨即時瀏覽器分頁的研究與自動化 | Tabbit + Sol(出現在你的選擇器時) | 模型就貼著你的分頁和檔案跑——見下文 | 可用性取決於帳號的模型選擇器 |
一句話裁決:把自動化和編碼的預算切到 GPT-6 Sol;不要切知識工作的上限和無人值守的長時程 agent。它就是你一直在向 OpenAI 購買的同一檔智力,標價減半,附帶一種新性格:寧可留下一個不回答的問題,也不願意答錯。就照這份職位說明書僱它。下單預算前再注意一行小字:每一句「便宜 50%」用來對比的 GPT-5.6 基準價,都是至少持續到 2026 年 11 月 21 日的促銷價。
讓 GPT-6 Sol 在你工作已經在的地方跑起來:Tabbit
成績單不是瀏覽器工作流。真實的工作——研究、比價、擷取、審查——散落在二十個開啟的分頁、本機檔案和網頁應用裡,裸 API 呼叫一個都看不見。手動把 Sol 接進去,意味著把頁面內容複製進提示詞、自己管理上下文視窗,每次都重搭一遍管線。
這正是 Tabbit 瀏覽器在一篇模型評測裡值得佔據一節的原因。Tabbit 是一款 agentic AI 瀏覽器,讓模型工作流直接跑在你的瀏覽上下文上:跨分頁研究、agentic 推理與深度研究任務、跨即時頁面的自動化。當 GPT-6 Sol 出現在你帳號的模型選擇器裡,這些工作流可以直接指向它,不用寫任何編排程式碼——而且可以按任務切換更便宜或更強的模型,這恰好是一台「半價、智力持平」的模型最獎勵的使用紀律。
兩條誠實的邊界:Tabbit 內的模型可用性取決於你的連動帳號和方案——圍繞 Sol 搭工作流之前先看選擇器;用戶端不改變 OpenAI 的計費,$2/$10 的費率卡怎麼都是那張。想看這個模型在實務中到底被怎麼用,可以瀏覽 GPT-6 Sol 模型頁 (简体中文)、提示詞目錄 (简体中文)和社群評測證據庫 (简体中文)。
準備好讓 GPT-6 Sol 跑在你自己的分頁上,而不是基準裡了嗎?
 Tabbit Browser

常見問題
GPT-6 Sol 比 GPT-5.6 Sol 更強嗎?
獨立測量顯示兩者智力大致持平:Artificial Analysis 給出 GPT-6 Sol (max) 的 Intelligence Index 為 48,與 GPT-5.6 Sol 持平,但每任務成本減半($1.06 對 $1.99)。GPT-6 Sol 在 AA-Omniscience 上的幻覺率從 92% 降到 60%,但實現方式是只嘗試 83% 的問題(上代為 99%)。這個交換是否划算,取決於你的情境裡答錯和答不出哪個代價更大。
GPT-6 Sol 為什麼拒答或跳過更多問題?
Artificial Analysis 把幻覺率改善歸因於棄答:GPT-6 Sol (max) 在 AA-Omniscience 上只嘗試 83% 的問題(GPT-5.6 Sol 為 99%),答錯的少了,但已答題目的準確率也從 59% 降到 54%。在 agent 管線裡,棄答通常表現為任務卡死或升級人工,所以應該預留兜底路徑,而不是把拒答當成失敗。
GPT-6 Sol 每個任務多少錢?
在 Artificial Analysis 的 Intelligence Index 上,GPT-6 Sol max 檔每任務約 $1.06;同一張 $2/$10 費率卡上,effort 從 low 到 max 的成本階梯約為 $0.13 到 $1.06,光調 effort 就能讓成本擺動約 8 倍。完整費率、快取規則和 272K 長上下文門檻見我們的 GPT-6 Sol 定價指南。
GPT-6 Sol 和 GPT-6 Astra 怎麼選?
高用量編碼、自動化和成本敏感的 agent 迴圈選 GPT-6 Sol;長時程自主任務、需要頑固堅持的場景選 GPT-6 Astra。Sol 的 AA Intelligence Index 是 48,Astra 是 53,但 Sol 每任務成本約為 Astra 的三分之一;兩者共用 272K 長上下文計費門檻。什麼時候值得為 Astra 付溢價,見我們的 GPT-6 Astra 評測。
GPT-6 Sol 在 ChatGPT 裡能用嗎?
Chat 端還沒有。發布時 GPT-6 Sol 面向 Plus、Pro、Business、Enterprise 和 Edu 用戶在 ChatGPT Work 與 Codex 中可用,Free 和 Go 用戶在桌面端拿到的是 GPT-6 Luna。OpenAI 說 Chat 端會逐步放量,API 側模型 ID 是 gpt-6-sol。把工作流押上去之前,先在自己的方案模型選擇器裡確認。
能在 Tabbit 瀏覽器裡用 GPT-6 Sol 嗎?
Tabbit 瀏覽器支援跨分頁、本機檔案和即時網頁的多模型工作流,當你的帳號或 API 權限包含 GPT-6 Sol 時,它會出現在模型選擇器裡。可用性取決於帳號,使用用戶端也不會改變 OpenAI 的計費。下載前可以先在 GPT-6 Sol 提示詞目錄裡瀏覽任務配方。