
Se sua carga de trabalho é programação de alto volume, automação ou loops de agentes em que o custo por tarefa decide o orçamento, vale a pena migrar para o GPT-6 Sol. Se você precisa do teto mais alto em trabalho de conhecimento ou de um agente que jamais abandona uma tarefa, fique onde está. A tabela pela metade do preço é real: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, metade das tarifas promocionais do GPT-5.6 Sol, verificado na ficha do modelo da OpenAI em 23 de setembro de 2026. Mas a parte interessante desta análise não é o preço: é como o modelo ficou mais preciso. A Artificial Analysis mediu a taxa de alucinações caindo de 92% para 60% enquanto a parcela de perguntas que ele tenta caiu de 99% para 83%. Em um sentido preciso, o novo Sol é um modelo que responde menos.
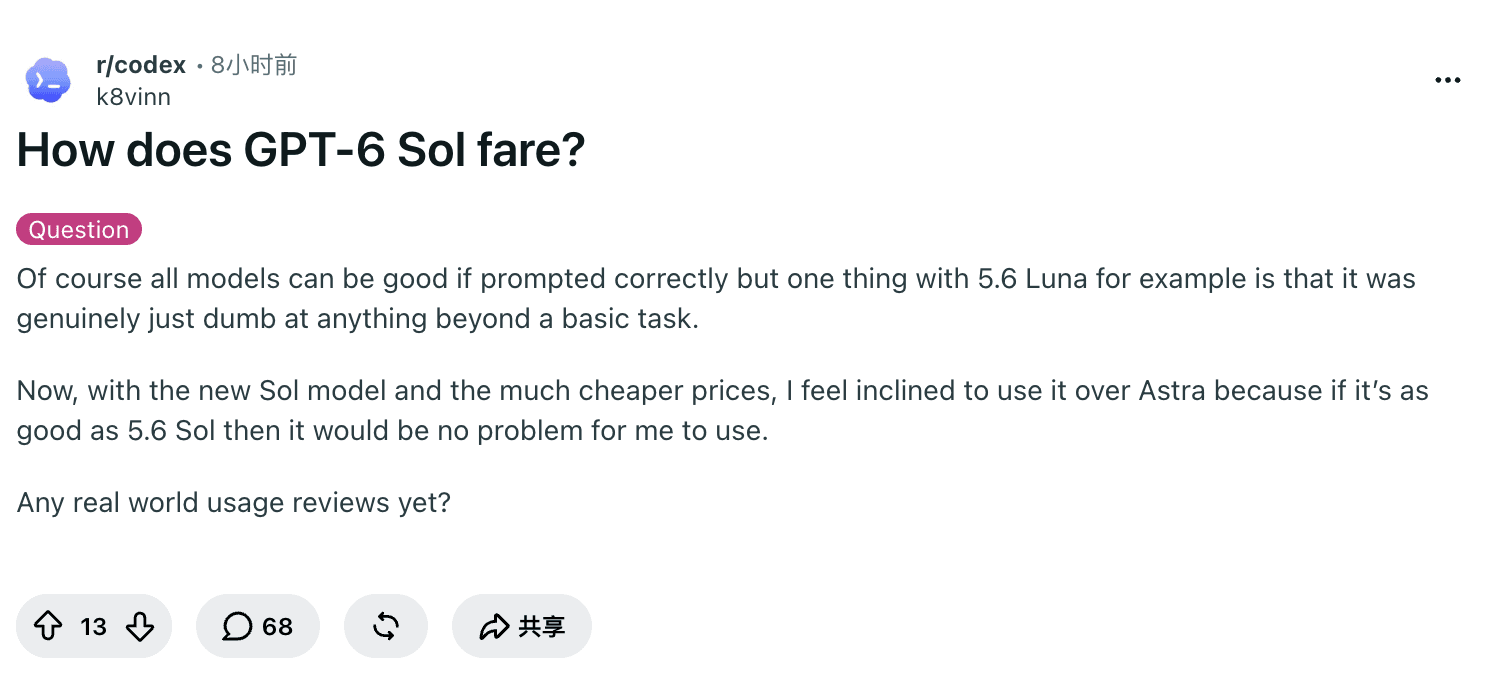
Essa troca é exatamente o que divide a comunidade desde o lançamento. Quatro horas depois do lançamento, u/k8vinn abriu um tópico no r/codex com a pergunta que esta análise responde: "Now, with the new Sol model and the much cheaper prices, I feel inclined to use it over Astra... Any real world usage reviews yet?" ("Com o novo Sol e os preços muito mais baratos, fico inclinado a usá-lo no lugar do Astra… Já existem análises de uso real?") (Reddit)
A tabela de preços do GPT-6 Sol foi dissecada à parte, e nossa comparação entre GPT-6 Sol e Claude Opus 5.5 resolve o problema de escolha entre os dois. O lançamento irmão tem sua própria análise do GPT-6 Astra. Este texto é o veredito sobre o modelo: onde o GPT-6 Sol realmente melhora, onde ele morde e quais cargas de trabalho devem migrar, ficar ou passar longe. Se você quer rodar o modelo em páginas web de verdade em vez de bancadas de teste, ao final aponto um caminho em nível de navegador.
Conclusões principais
A inteligência é a mesma; o preço, a metade. A Artificial Analysis coloca o GPT-6 Sol (max) em 48 pontos do Intelligence Index — no nível do GPT-5.6 Sol — a $1,06 por tarefa contra $1,99, com a tabela cortada de $4/$20 para $2/$10 por milhão de tokens.
O ganho de precisão é um jogo de abstenção. A taxa de alucinações no AA-Omniscience caiu de 92% para 60% porque o Sol tenta 83% das perguntas contra 99% do 5.6 Sol; a precisão sobre as perguntas tentadas recuou de 59% para 54%.
A eficiência de tokens é a melhoria silenciosa. O Sol (max) gerou 77M de tokens na suíte da AA contra uma mediana de 88M, e profissionais relatam tarefas do Codex que mal arranharam os limites semanais.
Não é uma melhoria para trabalho de conhecimento. O Sol caiu cerca de 100 pontos Elo no GDPval-AA v2.1, e seus 48 de II ficam abaixo do GPT-6 Astra (53) e do Claude Opus 5.5 (58).
A realidade da plataforma importa nesta semana. O Sol está no ChatGPT Work e no Codex, mas não no Chat; assinantes relatam cotas Plus indo embora em minutos na geração 6; equipes de API no Chat Completions perdem function calling acima de
reasoning_effort: none.
O número que decide esta análise: precisão respondendo menos
Os benchmarks chegaram de ombros encolhidos para o GPT-6 Sol: a nota de lançamento da Artificial Analysis diz que "os escores de Intelligence Index e Coding Agent Index permanecem no nível do GPT-5.6, com avanços em algumas avaliações e retrocessos em outras". Duas linhas depois, o mesmo texto solta o número que muda o comportamento de verdade: no AA-Omniscience, seu benchmark de conhecimento e alucinações, o GPT-6 Sol (max) corta sua taxa de alucinações de 92% para 60%, tentando 83% das perguntas contra 99% do GPT-5.6 Sol (max) — cerca de um quarto menos de respostas erradas, mas a precisão sobre as perguntas tentadas cai de 59% para 54% (Artificial Analysis, consultado em 23 de setembro de 2026).
Traduzido para a linguagem da engenharia: a OpenAI trocou cobertura por correção. O modelo levanta a mão menos vezes e, quando levanta, é ligeiramente menos preciso por resposta que seu antecessor — mas o volume total de erros confiantes desaba. A própria avaliação de factualidade da OpenAI conta uma história compatível: em conversas reais em que os usuários haviam marcado erros, "o GPT-6 Sol comete cerca de metade dos erros de seu antecessor, se aproximando da confiabilidade do Astra" (anúncio). Note as ressalvas que a própria OpenAI anexa: essas conversas foram selecionadas porque induziam erros, então não representam o uso típico, e os escores não foram controlados por comprimento.
Cada juízo desta análise se ordena por uma pergunta: seu custo é dominado por respostas erradas ou por respostas ausentes? Se o erro custa caro — revisão de código, conformidade, extração que alimenta outros sistemas — a troca por abstenção é uma melhoria genuína. Se a cobertura é o trabalho — pipelines de agentes em que uma recusa significa tarefa travada e uma página que nunca termina — o mesmo design aparece como retrocesso. Guarde esse eixo: ele volta no veredito.
Os benchmarks, e quanta confiança merecem
Todos os números independentes abaixo vêm de um único retrato da Artificial Analysis tirado em 23 de setembro de 2026, com os níveis de esforço nomeados — porque é no esforço que as comparações da semana de lançamento trapaceiam em silêncio. As linhas de preço vêm da ficha do modelo da OpenAI e do nosso guia de preços do mesmo dia.
| Dimensão | GPT-6 Sol (max) | GPT-5.6 Sol (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max c/ fallback) | O que significa |
|---|---|---|---|---|---|
| Preço de API, entrada / saída por 1M | $2 / $10 | $4 / $20 (promo até 21 de nov.) | $10 / $50 | $4 / $20 | O Sol iguala a entrada do Opus 5.5 com metade da sua saída. |
| AA Intelligence Index | 48 | no nível do Sol | 53 | 58 | Você compra o mesmo nível de inteligência mais barato, não mais inteligência. |
| Custo AA por tarefa (II) | $1,06 | $1,99 | $3,26 | $5,98 | Metade do 5.6 Sol, um terço do Astra, ~18% do Opus 5.5 em ajustes máximos. |
| Taxa de alucinações, AA-Omniscience | 60% | 92% | não reportado | não reportado | A vitória de precisão da manchete. |
| Taxa de tentativa, mesmo benchmark | 83% | 99% | — | — | …e a pegadinha: responde menos. |
| GDPval-AA v2.1 (trabalho de conhecimento) | ~100 Elo abaixo da fronteira | não reportado | não reportado | 1846 Elo (reportado pela Anthropic) | Não contrate o Sol para trabalho de conhecimento especializado. |
| Velocidade de saída (mediana AA) | 131 tok/s | não reportado | 58 tok/s | não reportado | Meio do pelotão: mais rápido que Astra ou Fable 5.1, bem mais lento que os modelos Flash. |
| Contexto / saída máxima | 1,05M / 128K | 1M / 32K | 1,05M / 128K | 1M / 128K | Especificações das fichas do fornecedor; o limiar de cobrança de 272K vale para toda a família. |
Antes de acreditar em qualquer linha, três baldes de água fria:
Os escores do fornecedor rodam em seus próprios harnesses. Os benchmarks de lançamento da OpenAI — AutomationBench, Agents' Last Exam (Sol max 56,4%, acima do melhor Opus 5 com 60% menos custo), DeepSWE (68,8% contra 69,9% do Fable 5 com ~80% menos custo), OSWorld 2.0 offline (60,5% ≈ 60,3% do Opus 5 medium com ~80% menos custo) — são todos autorreportados, e a própria nota de rodapé do anúncio admite que as avaliações rodaram em um ambiente de pesquisa ou API que "pode dar uma saída ligeiramente diferente do ChatGPT de produção", com escores de concorrentes tirados de relatórios públicos. Úteis como bússola, não como evangelho.
Os valores do índice derivam. Nossa análise do GPT-6 Astra, escrita um dia antes, citava valores do Intelligence Index da AA de 61,2 para o Astra e 60,9 para o 5.6 Sol; o mesmo rastreador agora lista o Astra em 53 e o Sol em 48. A Artificial Analysis versiona e recalcula seu índice: compare modelos dentro de um mesmo retrato, nunca entre semanas.
O desalinhamento de esforço é o cheat code da semana de lançamento. Os números publicados do Sol são quase todos em esforço máximo; os titulares do Opus 5.5 costumam ser seu modo medium padrão. Qualquer "Sol ganha/perde" que não nomeie ambos os ajustes é marketing. Nosso comparativo faz essa matemática com custos alinhados.
Aqui, os benchmarks são uma bússola, não uma régua. O que pesa mais neste momento é o que relatam quem mede tarefas reais — e as primeiras 24 horas produziram um conjunto surpreendentemente coerente.
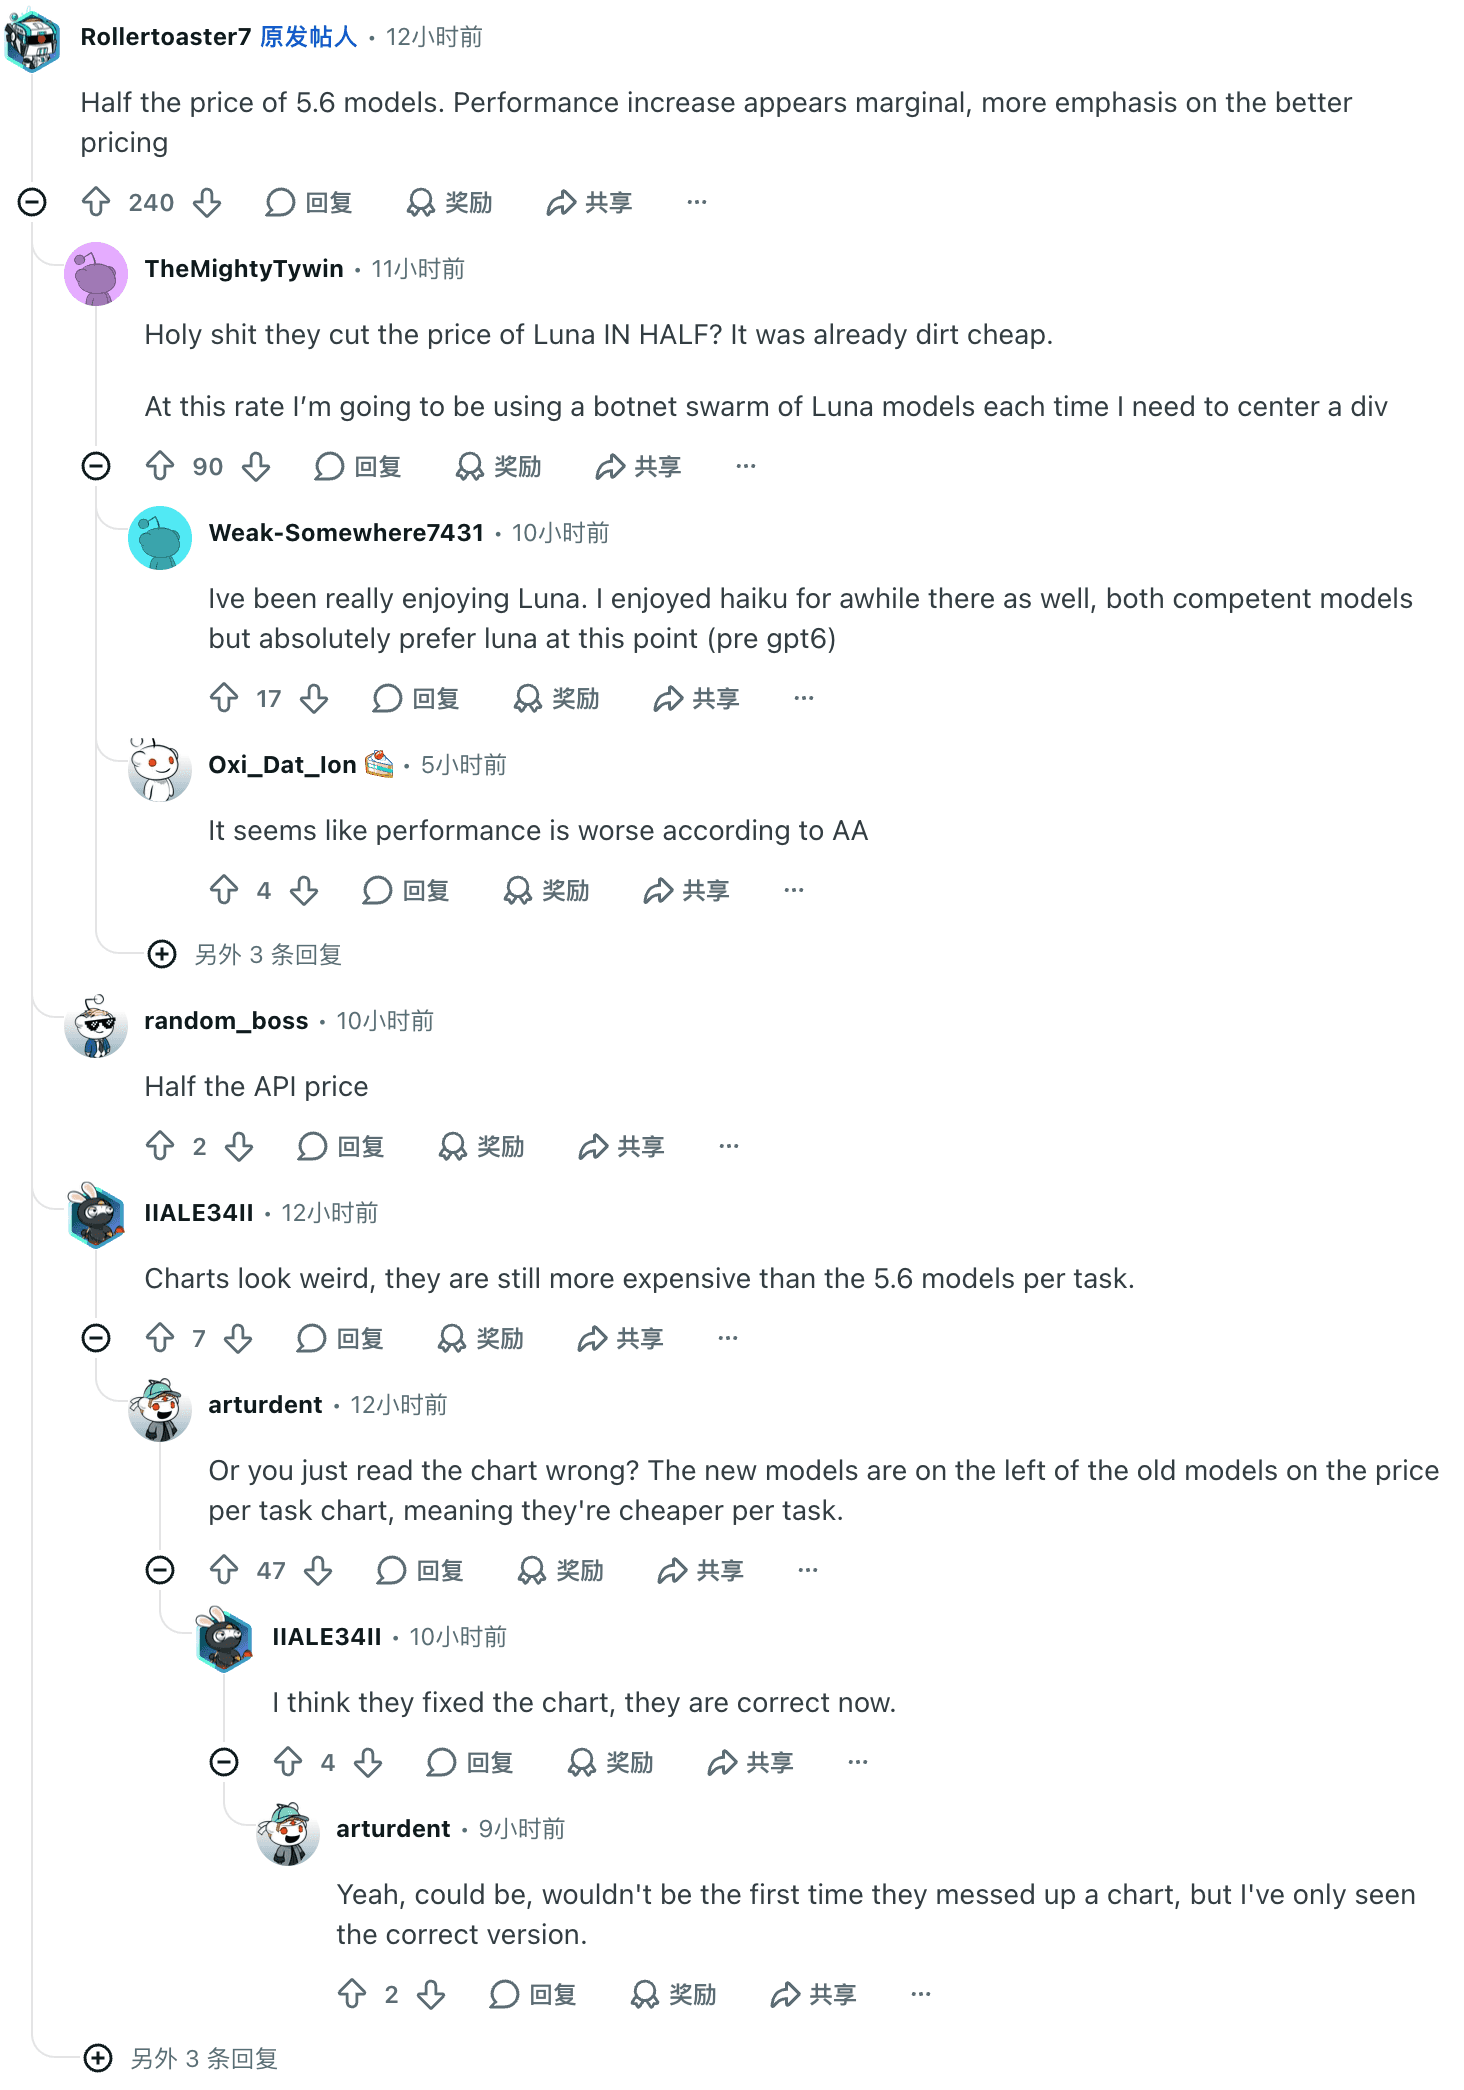
A leitura "preços pela metade, desempenho marginal" virou o comentário mais votado do tópico de lançamento do r/codex em poucas horas: u/Rollertoaster7, o autor do tópico, somou 240 pontos com "Half the price of 5.6 models. Performance increase appears marginal, more emphasis on the better pricing" ("Metade do preço dos modelos 5.6. A melhora de desempenho parece marginal; o destaque é o preço melhor"), com outro usuário citando diretamente os resultados irregulares da AA (Reddit). A Vals AI, avaliadora independente, chegou ao mesmo platô pela sua própria bancada: "GPT-6 Sol… ocupa o 8º lugar no Vals Index, aproximadamente no nível do GPT 5.6 Sol pela metade do custo" (X).
Onde o GPT-6 Sol é genuinamente bom
1. Factualidade: menos erros confiantes
O mecanismo de abstenção não é só um artefato de benchmark: em pipelines reais, ele aparece como um modelo que empurra de volta em vez de empilhar. Um comentarista do Hacker News contou que usou o Sol como segunda opinião sobre a revisão de código de outro modelo: "i used it for code review and it flagged twenty issues, sol checked the review and found 75% of them were hallucinations. sol was much closer to reality." ("Usei para revisão de código: aquele marcou vinte problemas, o Sol revisou e achou que 75% eram alucinações. O Sol estava bem mais perto da realidade.") (HN). Uma anedota não prova taxas, mas rima exatamente com a medição da AA e com o "metade dos erros" da OpenAI, de três direções independentes. Se sua carga pune erros — revisão, extração, conformidade —, esta é a melhoria que importa mais que qualquer ponto de índice.
2. Eficiência de tokens: o corte silencioso da fatura
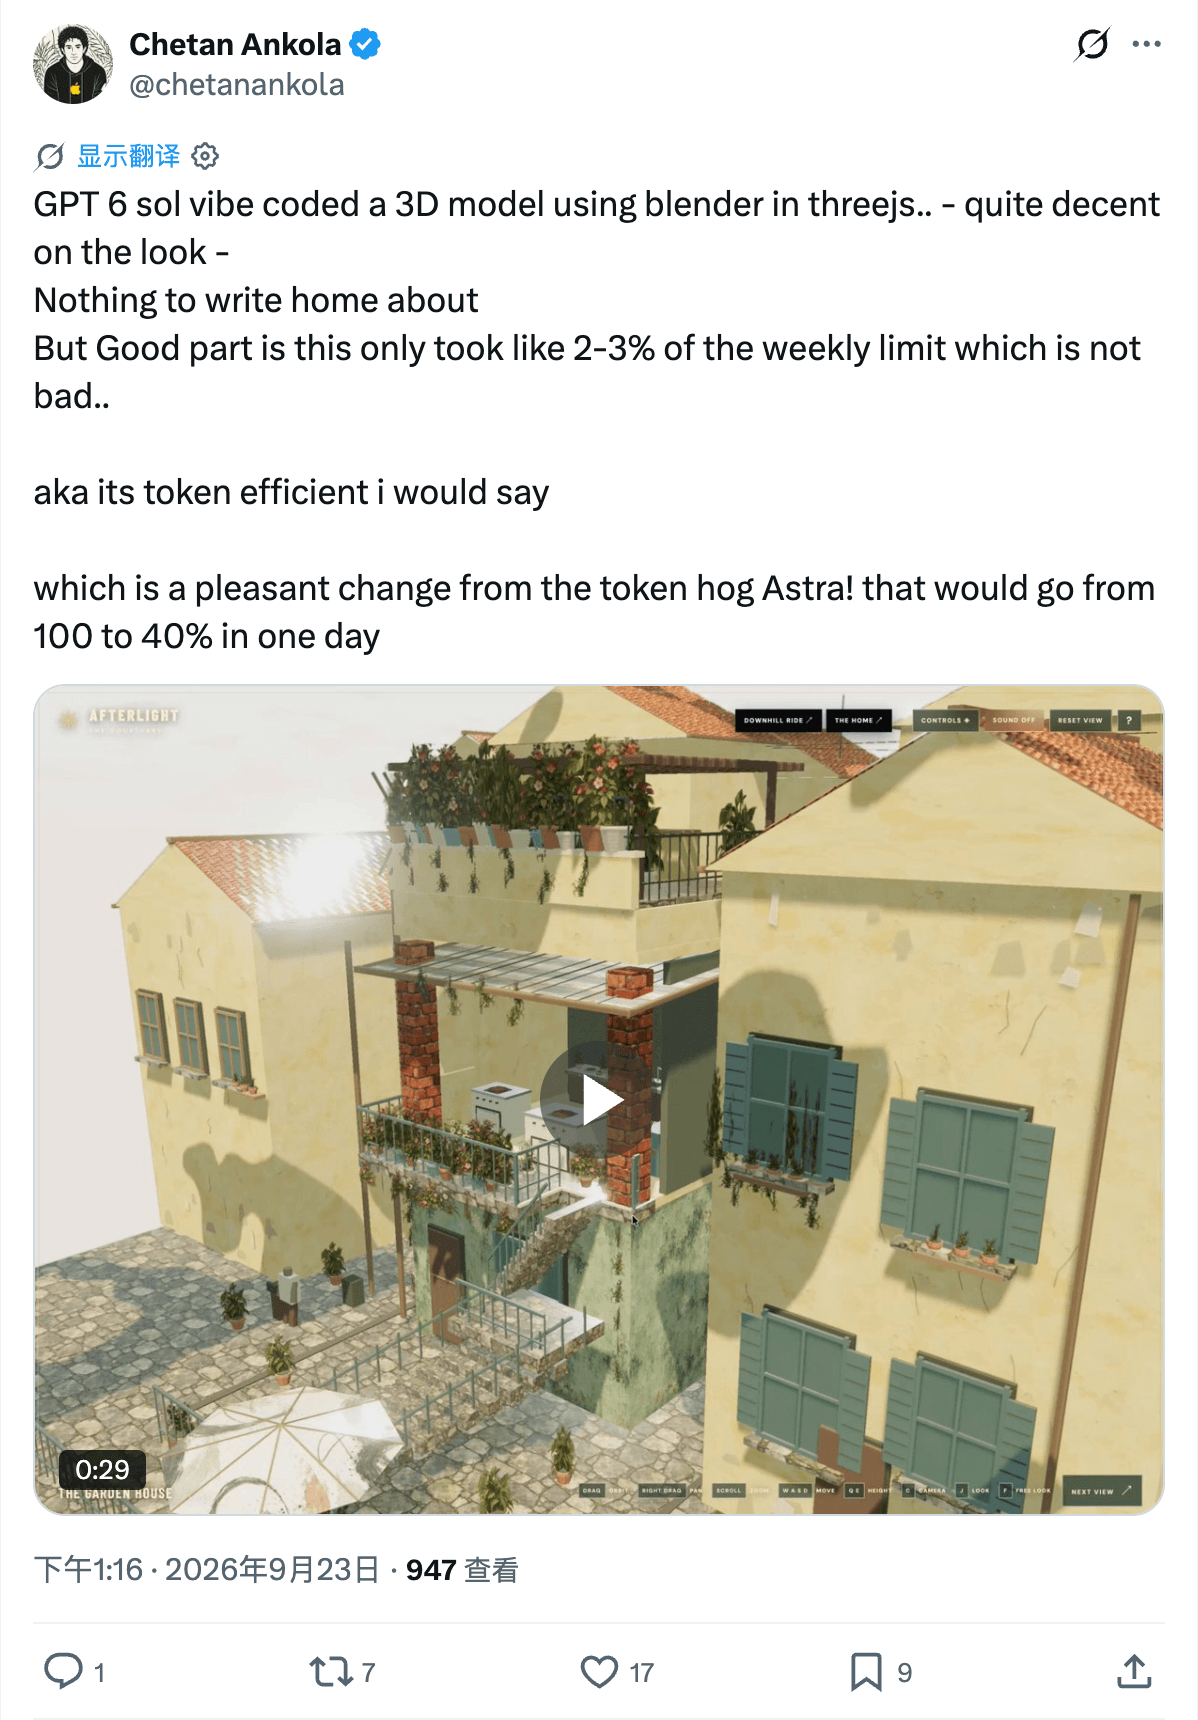
Modelos de raciocínio cobram duas vezes: pela resposta e pelo pensamento. O volume de geração do Sol na suíte da AA foi de 77M de tokens contra uma mediana de 88M, e profissionais notaram a mesma magreza em planos de assinatura: no r/codex brincavam com "meu uso de tokens no Codex < um buraco negro", e no X um desenvolvedor mediu uma tarefa de Blender/Three.js em "uns 2-3% do limite semanal… diria que é eficiente em tokens, uma mudança agradável em relação àquele devorador de tokens chamado Astra, que vai de 100% a 40% em um dia" (X). Somada à tabela de tarifas, é por isso que a afirmação da OpenAI de que o Sol(xhigh) supera o Opus 5 (max) no AutomationBench com 9% do custo por tarefa é ao menos plausível: menos tokens, mais baratos, em trabalho com forma de automação.
3. Escrita e estilo de colaboração
A OpenAI diz que o estilo de comunicação aprimorado do Astra — "mais clareza, menos jargão" — se transmite ao Sol, e esta é a rara afirmação de fornecedor ecoada por um teste cego independente em um dia: a bancada às cegas do How I AI apontou "escrita clara, PRDs legíveis e preço" como onde o Sol ainda vence (Lenny's Newsletter). Para times que entregam documentos junto com código — especificações, PRDs, resumos de revisão —, é uma melhoria de qualidade diária que nenhuma linha de leaderboard captura.
Onde o GPT-6 Sol morde
1. O imposto da abstenção
Cada força acima tem seu espelho. Um modelo que tenta 83% das perguntas, dentro de um pipeline sem supervisão, é um modelo que devolve 17% de espaços vazios — e cada espaço vazio é uma tarefa travada, uma tentativa extra ou uma escalada para um humano. A AA também mediu o custo por resposta: a precisão sobre as perguntas tentadas caiu de 59% para 54%, e no GDPval-AA v2.1, seu benchmark de trabalho de conhecimento de valor econômico, o Sol caiu cerca de 100 Elo frente aos pares de fronteira. O teto do trabalho de conhecimento simplesmente não é o que este modelo busca. Se seu pipeline não tolera recusas, orce um modelo de reserva desde o primeiro dia.
2. Parte da comunidade lê como "Terra com etiqueta nova"
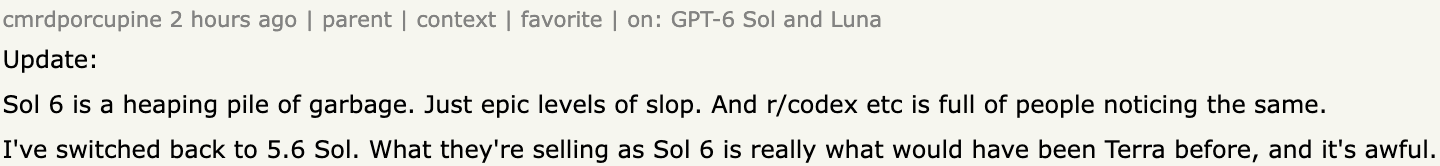
Os relatos negativos mais afiados convergem para o mesmo tema: isso é reprecificação, não uma nova geração. Um desenvolvedor do Hacker News que já voltou atrás escreveu: "Update: Sol 6 is a heaping pile of garbage... I've switched back to 5.6 Sol. What they're selling as Sol 6 is really what would have been Terra before." ("Atualização: o Sol 6 é uma pilha de lixo… Voltei para o 5.6 Sol. O que vendem como Sol 6 é realmente o que antes teria sido o Terra.") (HN). No r/codex, a mesma intuição: "Depois de usar, com certeza ficou mais burro. Parece mais o Terra." O ponto médio medido: o índice está nivelado na média, mas "avanços em algumas avaliações e retrocessos em outras" significa que cargas individuais podem cair exatamente na metade que regride. Se o seu mix de prompts cair numa avaliação que regrediu, sua experiência contradirá a média — e os dois lados têm razão ao mesmo tempo.
3. Atritos de plataforma na semana de lançamento
Três roços práticos esfriam a migração nesta semana. Primeiro, disponibilidade: o Sol está no ChatGPT Work e no Codex para planos pagos, mas ainda não no Chat, e usuários Free/Go só recebem o GPT-6 Luna (anúncio). Segundo, a economia da assinatura: um usuário Plus relatou "queimou meu uso de Plus em minutos, enquanto com o 5.6 eu podia navegar por horas. Ficava rodando em círculos minutos num prompt básico e depois desistia diante dos limites de uso" (HN): mesmo com a API mais barata, tokens de raciocínio queimam cota. Terceiro, a superfície de API: no endpoint legado do Chat Completions, o function calling só funciona com reasoning_effort: none — fluxos com ferramentas pertencem à API de Responses — e o fine-tuning não é suportado (ficha do modelo). Se você fica no 5.6 Sol pelo comportamento de uso, saiba que as tarifas promocionais duram ao menos até 21 de novembro de 2026, e nosso guia de configuração de contexto de 1M continua valendo.

O que as pessoas realmente disseram
Vinte e quatro horas de sinal da comunidade se partem com limpeza ao longo do eixo da seção dois — não por habilidade nem senioridade.
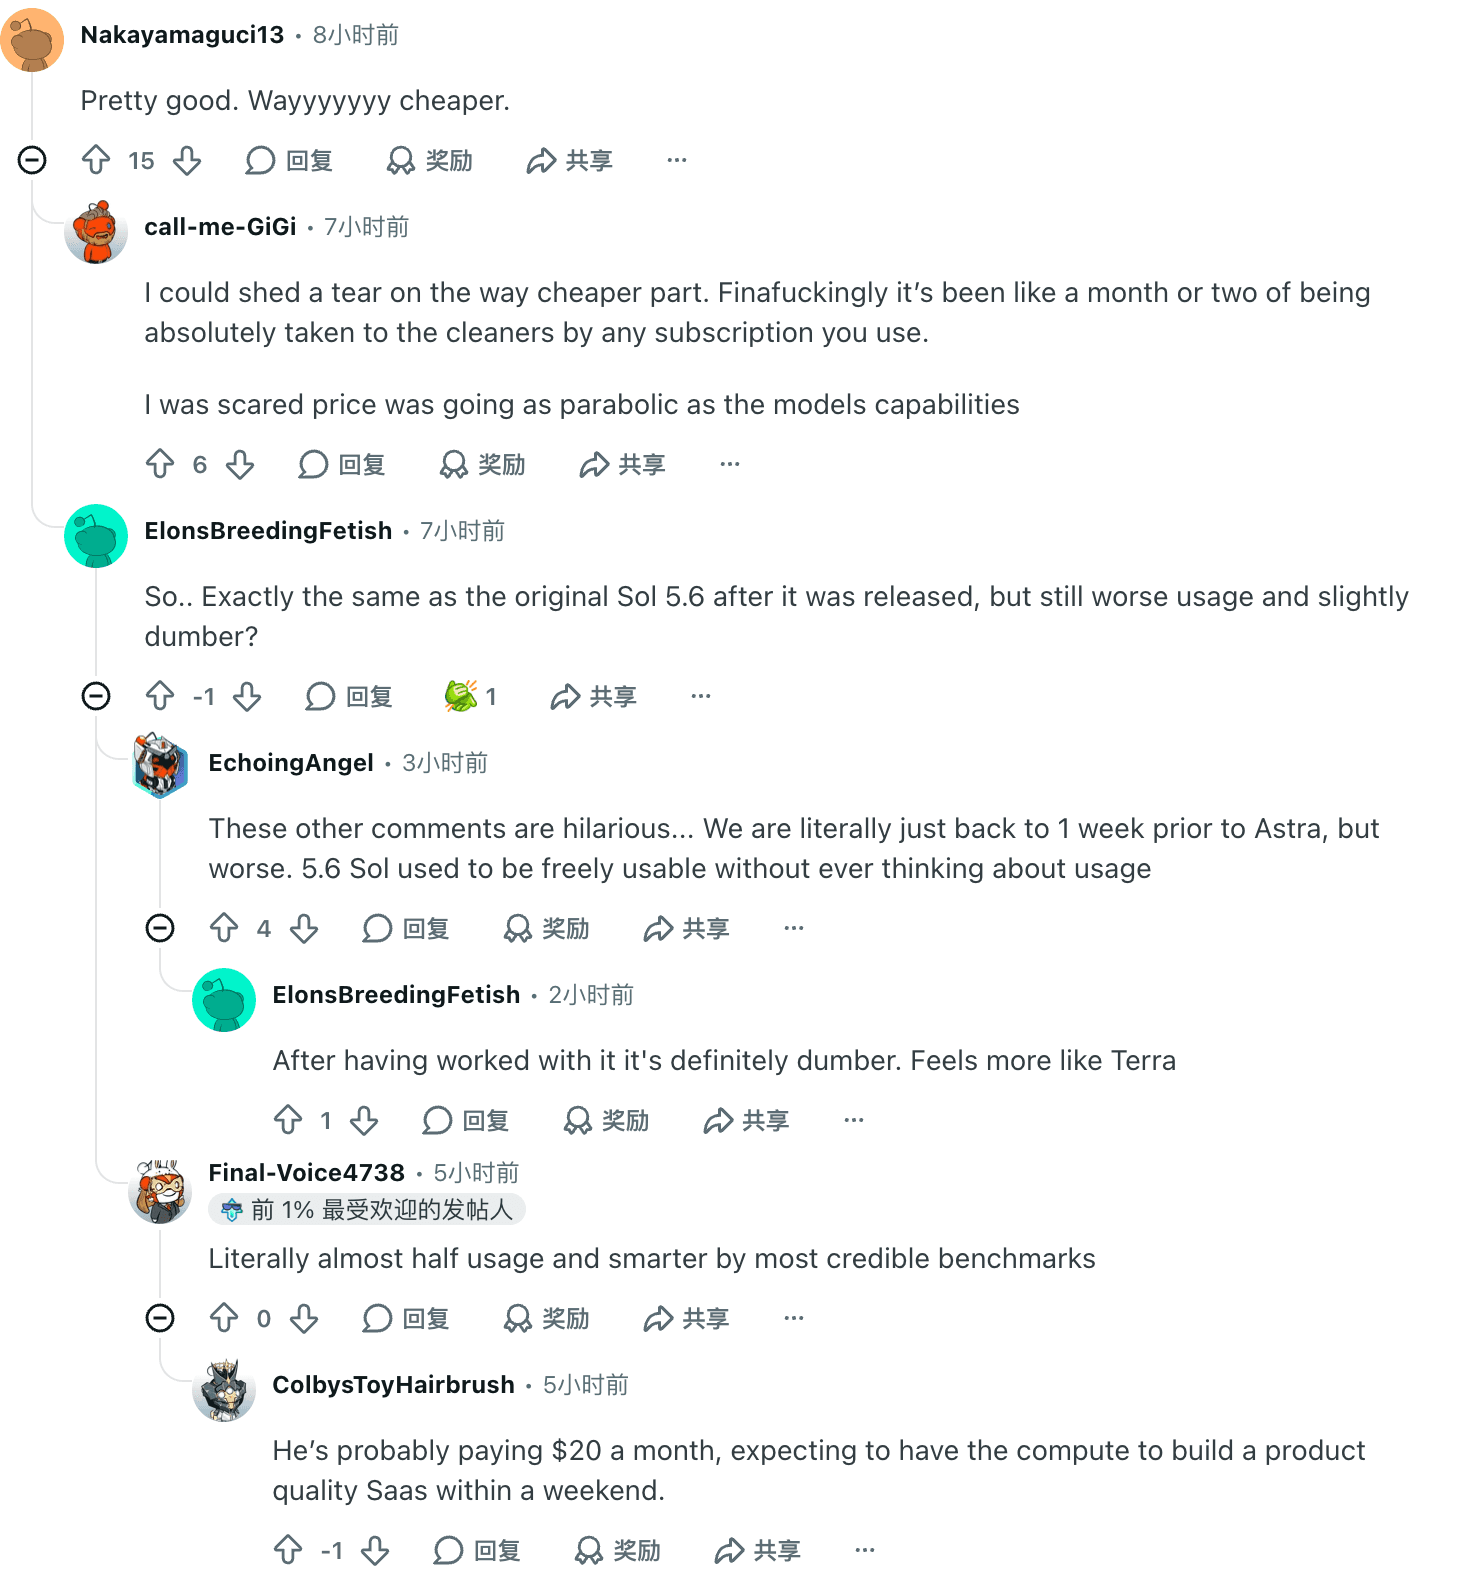
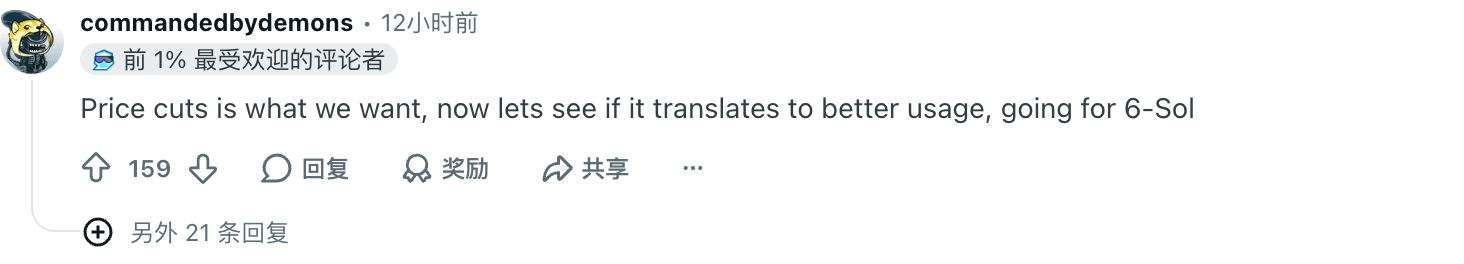
Campo um: "metade do preço é a melhoria". "Pretty good. Wayyyyyyy cheaper." ("Bom demais. Muuuuuito mais barato.") (u/Nakayamaguci13). "Literally almost half usage and smarter by most credible benchmarks" ("Literamente quase metade do uso e mais esperto pela maioria dos benchmarks críveis") (u/Final-Voice4738). A maioria que espera para ver empurrou o tópico do r/codex a 159 pontos: "Price cuts is what we want, now lets see if it translates to better usage, going for 6-Sol" ("Cortes de preço é o que queríamos; agora é ver se viram melhor uso, sigo para o 6-Sol") (u/commandedbydemons).
Campo dois: "isso é reprecificação, não um sucessor". "Com certeza ficou mais burro. Parece mais o Terra." (u/ElonsBreedingFetish). "Pela AA, o desempenho parece pior." (u/Oxi_Dat_Ion). O retorno ao 5.6 Sol de cmrdporcupine, citado acima, é a declaração mais pesada do campo.
O centro guarda a informação real. u/mchusma no Hacker News nomeou a comparação que a maioria dos times enfrenta: "I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability." ("Pessoalmente prefiro o Opus 5.5 em medium ao GPT-6 Sol em Max, em testes bem iniciais. Faixa de preço parecida, mais capacidade.") (HN).
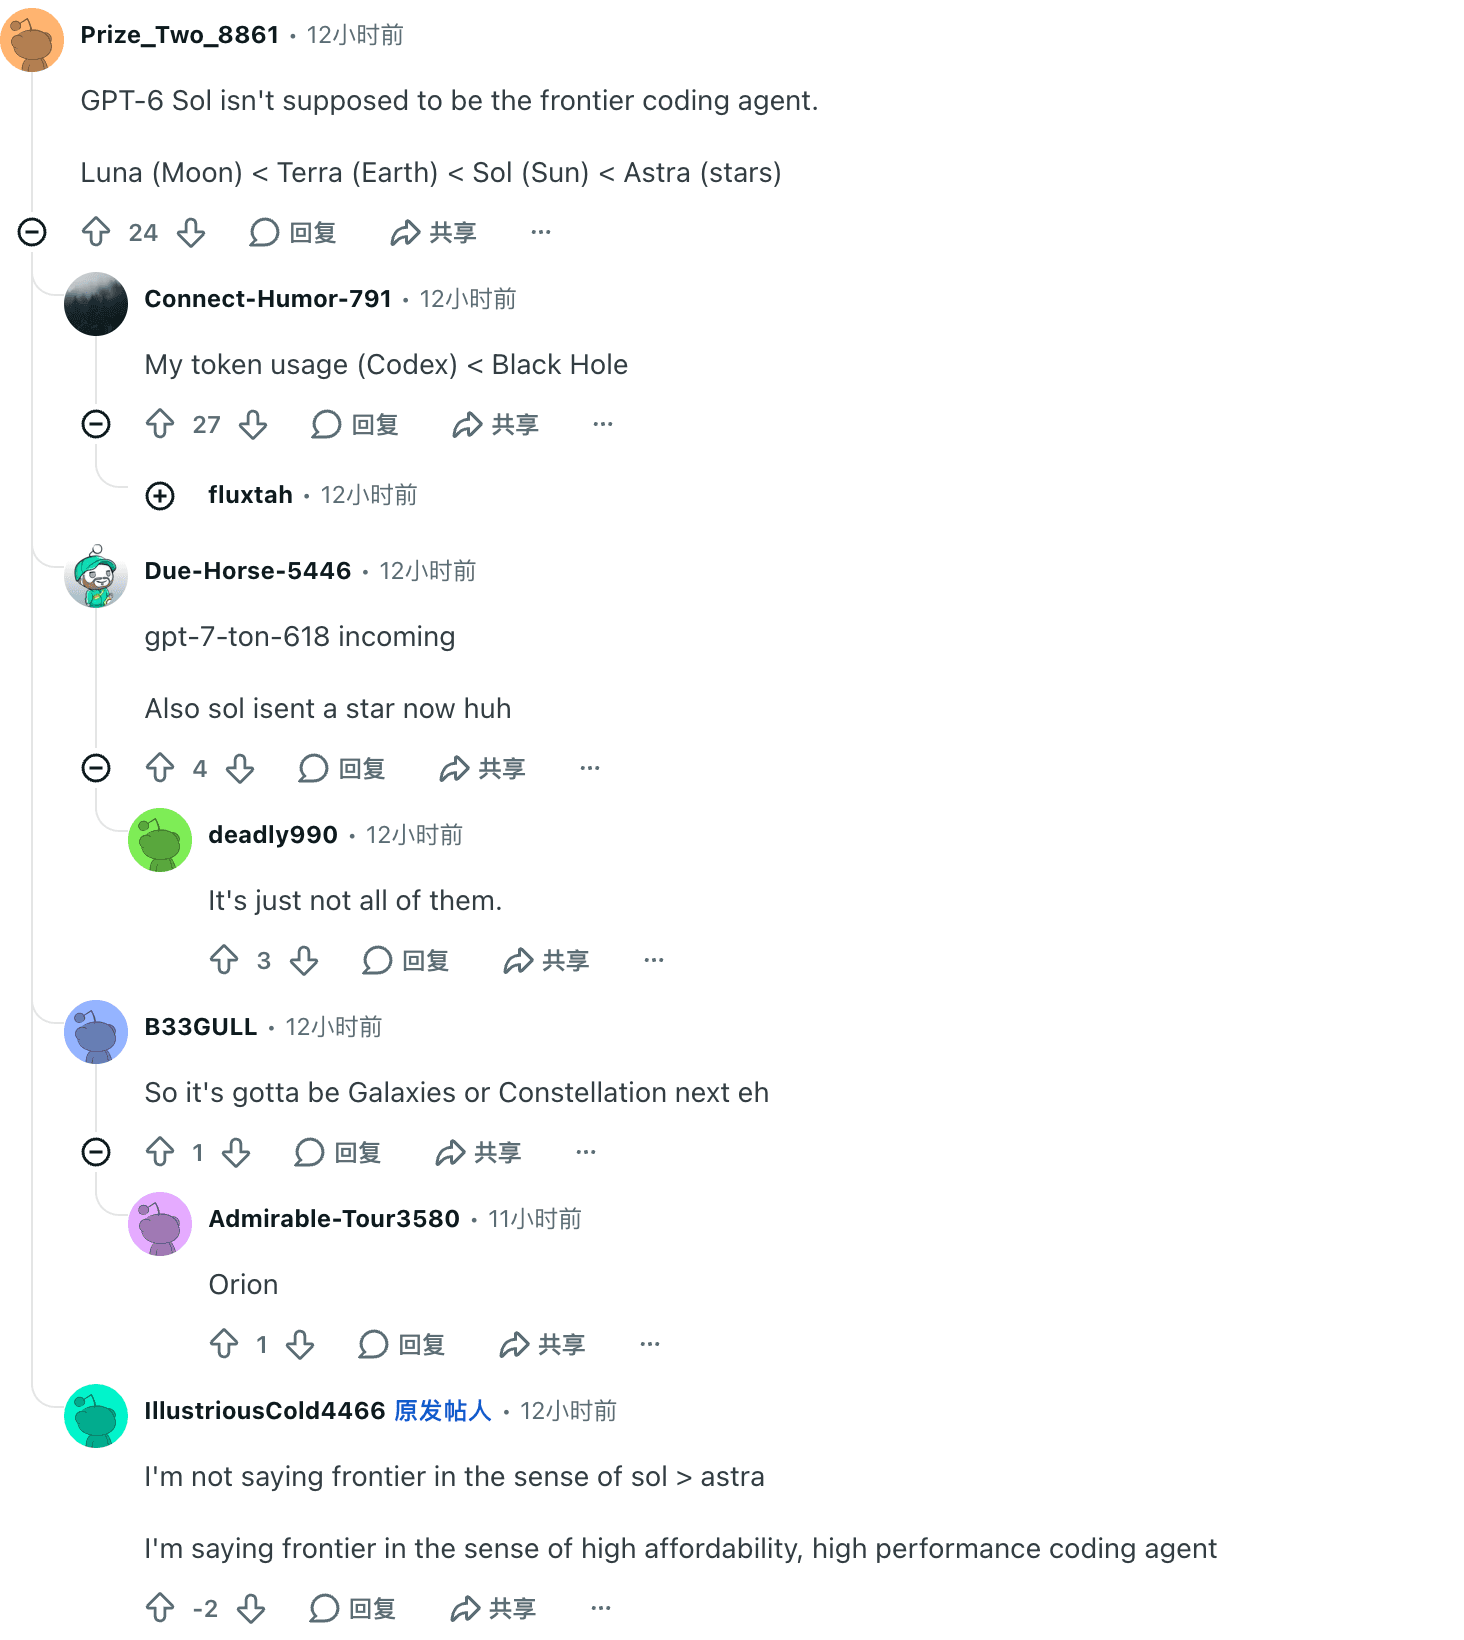

Nossa leitura editorial: os dois campos descrevem a mesma escolha de design a partir de cargas opostas. Onde erros custam, o Sol parece mais esperto que seu antecessor; onde a cobertura é sagrada, parece mais burro. Os benchmarks dizem "nivelado", e ambos os campos acertam — cada um sobre a metade da média que lhe cabe.
O veredito: escolha pela forma da carga de trabalho
| Sua carga de trabalho | Melhor escolha | Por quê | Cuidado com |
|---|---|---|---|
| Automação rotineira de alto volume, loops de agentes com orçamento apertado | GPT-6 Sol (xhigh) | Supera o Opus 5 (max) no AutomationBench com 9% do custo por tarefa; ~$0,53/tarefa no xhigh | Mantenha os contextos abaixo do penhasco de cobrança de 272K; a janela de cache é de 30 minutos |
| Programação do dia a dia e segunda opinião em revisão de código | GPT-6 Sol (high–max) | Paridade no FrontierCode com o Fable 5.1 xhigh a custo bem menor; pega conclusões alucinadas | Preveja uma rota de reserva para abstenções; verifique citações |
| Autodepuração obstinada de 30+ minutos, autonomia de longo fôlego | GPT-6 Astra | A persistência é o que o prêmio compra — veja nossa análise do Astra | Custo por tarefa 3 vezes maior; TTFT se estica em esforço alto |
| Trabalho de conhecimento especializado: jurídico, finanças, análise profunda | Claude Opus 5.5 | O Sol caiu ~100 Elo no GDPval; o Opus lidera o II com 58 | O custo por tarefa mais alto; verbosidade no esforço máximo |
| Conversa diária pelo ChatGPT | Fique no 5.6 por ora (Luna grátis, 5.6 Sol no Plus) | O Sol ainda não está no Chat; a queima de cota da geração 6 é real | Se ficar, o preço promocional e a configuração de 1M seguem valendo |
| Pesquisa e automação por abas de navegador ao vivo | Tabbit + Sol (quando aparecer no seu seletor) | Roda o modelo ao lado das suas abas e arquivos — veja abaixo | A disponibilidade depende do seletor de modelos da sua conta |
O veredito em uma linha: migra para o GPT-6 Sol os orçamentos de automação e programação; não migra o teto do trabalho de conhecimento nem seus agentes autônomos de longo fôlego. É a mesma inteligência que você já comprava da OpenAI, com a etiqueta pela metade e uma personalidade nova: prefere deixar uma pergunta sem resposta a respondê-la errado. Contrate-o exatamente para essa função. E uma letra miúda antes de fechar um orçamento: o preço de base do GPT-5.6 em cada afirmação de "50% mais barato" é promocional ao menos até 21 de novembro de 2026.
Rode o GPT-6 Sol onde seu trabalho já vive: Tabbit
Uma folha de escores não é um fluxo de trabalho de navegador. O trabalho real — a pesquisa, as comparações, a extração, a revisão — vive espalhado por vinte abas abertas, arquivos locais e aplicativos web que uma chamada crua de API jamais vê. Cabeamento manual do Sol significa copiar conteúdo de páginas para prompts, gerenciar janelas de contexto por conta própria e refazer a encanação toda hora.
É aqui que o Tabbit Browser conquista sua seção numa análise de modelo. O Tabbit é um navegador de IA agêntica que roda fluxos de modelos diretamente sobre o seu contexto de navegação: pesquisa multi-abas, tarefas de raciocínio agêntico e pesquisa profunda, automação por páginas ao vivo. Quando o GPT-6 Sol aparecer no seletor de modelos da sua conta, você pode apontar esses fluxos para ele sem escrever um orquestrador — e trocar para um modelo mais barato ou mais forte por tarefa, exatamente a disciplina que um modelo pela metade do preço com inteligência nivelada recompensa.
Dois limites honestos: a disponibilidade de modelos dentro do Tabbit depende da sua conta conectada e do seu plano — verifique o seletor antes de construir um fluxo em volta do Sol — e o cliente não muda a cobrança da OpenAI; a tabela de $2/$10 cobra igual. Para ver como o modelo é posto a trabalhar na prática, explore a página do modelo GPT-6 Sol (English), o diretório de prompts (English) e a base de evidências de análises (English) da comunidade.
Pronto para rodar o GPT-6 Sol nas suas próprias abas em vez de um benchmark?
 Tabbit Browser

Perguntas frequentes
O GPT-6 Sol é melhor que o GPT-5.6 Sol?
Medições independentes indicam inteligência praticamente empatada: a Artificial Analysis coloca o GPT-6 Sol (max) em 48 pontos do seu Intelligence Index, no nível do GPT-5.6 Sol, com metade do custo por tarefa ($1,06 contra $1,99). O GPT-6 Sol também reduz sua taxa de alucinações de 92% para 60% no AA-Omniscience, mas consegue isso tentando 83% das perguntas contra 99%. Se essa troca compensa depende de o que custa mais no seu caso: uma resposta errada ou uma resposta ausente.
Por que o GPT-6 Sol se recusa a responder ou pula mais perguntas?
A Artificial Analysis atribui a melhoria de alucinações à abstenção: o GPT-6 Sol (max) tenta 83% das perguntas do AA-Omniscience contra 99% do GPT-5.6 Sol (max), o que corta respostas erradas mas derruba a precisão sobre as perguntas tentadas de 59% para 54%. Em um pipeline de agentes, uma abstenção normalmente aparece como tarefa travada ou escalada para humano, então preveja uma rota de reserva em vez de tratar a recusa como falha.
Quanto custa o GPT-6 Sol por tarefa?
No Intelligence Index da Artificial Analysis, o GPT-6 Sol custa cerca de $1,06 por tarefa no esforço máximo, com uma escada que vai de aproximadamente $0,13 no esforço baixo a $1,06 no máximo sobre a mesma tarifa de $2/$10. Só a escolha do esforço já balança o custo cerca de 8 vezes. A tabela completa, as regras de cache e o limiar de contexto longo de 272K estão no nosso guia de preços do GPT-6 Sol.
GPT-6 Sol ou GPT-6 Astra: qual usar?
Use o GPT-6 Sol para programação e automação de alto volume em que o custo por tarefa importa, e o GPT-6 Astra para execuções autônomas de longo fôlego em que a persistência importa. O Sol marca 48 no Intelligence Index da AA contra 53 do Astra, por cerca de um terço do custo por tarefa, e ambos compartilham o limiar de cobrança de contexto longo de 272K. Nossa análise do GPT-6 Astra cobre quando o prêmio se justifica.
O GPT-6 Sol está disponível no ChatGPT?
Ainda não no Chat. No lançamento, o GPT-6 Sol está disponível no ChatGPT Work e no Codex para os planos Plus, Pro, Business, Enterprise e Edu, enquanto usuários Free e Go recebem o GPT-6 Luna no app de desktop. A OpenAI informa que o rollout para o Chat será gradual, e o modelo está na API como gpt-6-sol. Verifique o seletor de modelos do seu plano antes de apostar um fluxo de trabalho nele.
Posso usar o GPT-6 Sol no Tabbit Browser?
O Tabbit Browser suporta fluxos de trabalho multimodelo sobre suas abas abertas, arquivos locais e sessões web ao vivo; o GPT-6 Sol aparece no seletor de modelos quando sua conta ou acesso de API o inclui. A disponibilidade depende da sua conta, e usar o cliente não muda a cobrança da OpenAI. Antes de baixar, você pode explorar receitas de tarefas no diretório de prompts do GPT-6 Sol.