
2026 年 9 月 22 日,兩個前沿模型在同一天落地。OpenAI 發布了 GPT-6 Sol(gpt-6-sol),這是 GPT-6 家族中與 GPT-6 Luna 同步推出、面向編程與智能體的專用模型;Anthropic 發布了 Claude Opus 5.5(claude-opus-5-5),作為 Opus 5 的繼任者,以更低的價格定位為自家最強的全能模型。如果你這一週正在兩者之間做選擇,你面對的不是誰贏誰輸,而是兩種截然不同的模型定價與調校理念。
作為一名每天把基礎模型接入自主智能體與多頁研究系統的工程師,我不會根據新聞稿評估發布當天的模型。以下內容基於官方模型卡與公告,加上發布最初 24 小時內的獨立測量——並且每個基準都明確標註努力檔位,因為大多數發布日對比都在這個地方悄悄作弊。
如果你只需要 GPT-6 Sol 的費率表,請讀我們專門的 GPT-6 Sol 定價指南。OpenAI 這邊的姊妹款,見我們的 GPT-6 Astra 評測與 GPT-6 Astra 概覽。Anthropic 這邊,我們的 Claude Fable 5.1 評測涵蓋了 Opus 5.5 之下中端產品線的進展。你也可以在 GPT-6 Sol 模型頁 (简体中文)與 Claude Opus 5.5 模型頁 (简体中文)查看原始規格。本文是直接的工程對比。
關鍵結論
一家廠商的預設檔擊敗另一家的最高檔:Claude Opus 5.5 在預設 medium 檔位下智能指數每任務 51.2 分、$1.34,高於 GPT-6 Sol 最高 max 檔位的 47.5 分、$1.06。在約 44 分以上的智能需求區間,Opus 5.5 以相近花費勝出。
Sol 頭條上的 2 倍差價有明確的失效點:未快取費率為 Opus 5.5 的一半(每百萬 token $2.00/$10.00 對 $4.00/$20.00),但一旦請求輸入超過 272K token,整個 Sol 請求改按長上下文費率 $4.00/$15.00 計費——不再是折扣,而是平價。
日常自動化是 Sol 的主場:在 AutomationBench-AA 上,Sol xhigh 檔(61.7%)以約低 40% 的成本追平 Opus 5.5 medium 檔(61.2%),且其
none檔位可以完全關閉擴展思考。終端與前沿編程工作屬於 Opus 5.5:即使在 medium 檔,它在 Terminal-Bench 4.0 上也領先 8.6 個百分點(52.5% 對 Sol max 的 43.9%),Anthropic 公布的 xhigh 檔為 66.4%。
輸出冗長度是一個計費變量:max 檔下 Opus 5.5 每任務產生約 119K 輸出 token,Sol 約為 31K。按輸出每百萬 token $20 計費,這 3.8 倍差距會疊加成開放式任務上真實的發票差額。
決定這場對決的一個數字:預設檔擊敗最高檔
這場對比的核心張力,是發布日報導大多遺漏的一組配對。截至 2026 年 9 月 23 日的獨立測量顯示,Claude Opus 5.5 在預設 medium 檔位下智能指數 51.2 分、每任務 $1.34;GPT-6 Sol 在最高的 max 檔位下為 47.5 分、每任務 $1.06。
每美元得分(獨立測量,2026-09-23):
Claude Opus 5.5  medium(預設檔):  51.2 分   $1.34/任務
GPT-6 Sol        max   (最高檔):  47.5 分   $1.06/任務

交叉點:智能需求低於約 44 分時 Sol 更便宜;
高於 44 分時 Opus 5.5 以相近花費直接勝出。
一家廠商的開箱配置在交叉點以上同時贏得分數與每美元得分,壓過另一家的最大檔位。這就是「預設檔擊敗最高檔」悖論,並且在發布後數小時內的社區早期測試中得到了印證。
第二個數字決定 Sol 的價格優勢到底在哪裡成立。OpenAI 的費率表很乾淨:標準短上下文請求每百萬 token 輸入 $2.00、輸出 $10.00——恰好是 Opus 5.5 $4.00/$20.00 的一半。但模型卡裡有一個大多數標題都漏掉的閾值:一旦請求輸入超過 272K token,整個請求改按長上下文費率計費——輸入 $4.00、快取讀 $0.40、快取寫 $5.00、輸出 $15.00。此時 Sol 在自己宣傳的 1,050,000 token 上下文窗口內,用得比 Opus 5.5 還貴或一樣貴,而 Opus 5.5 的 1M 上下文沒有同等的懸崖。
每 1M token 的有效輸入成本:
272K 輸入以內:  Sol $2.00  對  Opus 5.5 $4.00  --> Sol 便宜一半
272K 輸入以上:  Sol $4.00  對  Opus 5.5 $4.00  --> 平價(輸出 $15 對 $20)
如果你的負載是緊湊上下文下的智能體循環——也就是 智能體推理系統的典型形態——Sol 的折扣是實實在在的錢。如果你的負載是把整個代碼庫或長篇文件語料塞進提示詞,折扣恰恰在你最需要上下文窗口的那一刻蒸發。
規格與定價一覽
兩個模型都宣傳百萬級上下文和分檔的努力檔位,但機制差異對成本工程有實際影響。下表為每百萬 token 的美元費率,已於 2026 年 9 月 23 日對照兩份官方模型卡核實。
| 維度 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| API 標識 | gpt-6-sol | claude-opus-5-5 |
| 上下文窗口 | 1,050,000 token | 1,000,000 token |
| 最大輸出 | 未在上下文以下單獨設限 | 128,000 token(Batch 測試版 300K) |
| 努力檔位 | none / low / medium(預設)/ high / xhigh / max | low / medium(預設)/ high / xhigh / max |
| 擴展思考開關 | 可關閉(none) | 不可關閉 |
| 輸入(未快取) | $2.00(272K 輸入以上 $4.00) | $4.00 |
| 快取輸入讀 | $0.20(272K 輸入以上 $0.40) | $0.20(較 Opus 5 折讓約 60%) |
| 快取輸入寫 | $2.50(272K 輸入以上 $5.00) | $5.00 |
| 輸出 | $10.00(272K 輸入以上 $15.00) | $20.00 |
| Batch 定價 | 標準價 50%(Flex) | 輸入 $2.00 / 輸出 $10.00 |
| 快速檔 | 標準價 2× | $8.00 / $40.00(約 2.5× 速度) |
| 知識截止 | GPT-6 家族代際 | 2026-06 |
| 廠商成本宣稱 | — | 典型負載較 Opus 5 便宜約 40%(廠商口徑) |
有三個工程細節值得注意。第一,Sol 的 none 檔位是獨家的:它徹底關閉擴展思考,提供一種 Opus 5.5 無法複製的確定性低延遲模式——後者的思考永遠在線。第二,兩個模型的快取讀取價都是每百萬 token $0.20,因此在高快取命中率的生產管線裡,發票的輸入側打平,輸出冗長度成為決定性變量。第三,Anthropic「比 Opus 5 便宜約 40%」的說法是廠商口徑;本文後面會寫到,社區複算在一種真實負載上得到的結論更接近持平。
一個算例可以把檔位機制講具體。假設一條自動化管線每月跑 50,000 個任務,每個任務 40K 輸入 token(快取命中率 90%)、2K 輸出 token,檔位對齊到 medium 檔,且全部在 272K 閾值以內:
GPT-6 Sol(每任務:4K 未快取輸入 × $2.00 + 36K 快取讀 × $0.20 + 2K 輸出 × $10.00):$0.008 + $0.0072 + $0.020 = $0.0352 → 每月 $1,760
Claude Opus 5.5(每任務:4K 未快取輸入 × $4.00 + 36K 快取讀 × $0.20 + 2K 輸出 × $20.00):$0.016 + $0.0072 + $0.040 = $0.0632 → 每月 $3,160
Sol 跑同一條管線便宜約 44%(成本約為 Opus 5.5 帳單的 56%)。現在把輸入換成每任務 300K token:Sol 的整個請求翻轉到長上下文費率(未快取 $4.00、快取讀 $0.40、輸出 $15.00),結果為 $12,900 對 Opus 5.5 的 $10,700——名義上更便宜的模型反而貴出 20%。這個閾值不是腳註,而是長上下文架構的決定性變量。
基準測試,以及該信多少
發布日的基準表在獨立實驗室複現之前都是行銷材料。下表混合了廠商口徑(已標註)與獨立測量,而後面四條校準說明比任何單一數字都重要。
| 基準 | Claude Opus 5.5 | GPT-6 Sol | 解讀 |
|---|---|---|---|
| 智能指數(得分 / 每任務美元) | 51.2 / $1.34(medium) | 47.5 / $1.06(max) | Opus 預設檔高於 Sol 最高檔;44 分以下 Sol 更便宜 |
| Terminal-Bench 4.0 | 52.5%(medium);66.4%(xhigh,廠商,±2.6 標準誤) | 43.9%(max);44%(獨立) | Opus 在終端/智能體 CLI 場景領先約 9 分 |
| AutomationBench-AA | 61.2%(medium) | 61.7%(xhigh) | 統計打平;Sol 成本低約 40% |
| GDPval-AA v2.1 | 1846 Elo(廠商) | 較前沿模型回退約 100 Elo(獨立) | Opus 在知識工作評測上更強 |
| Humanity's Last Exam(帶工具) | 67.7%(max,廠商) | 本週期未經獨立核實 | 僅作方向性參考 |
在把任何一條當作結論之前,有四條校準提醒:
檔位不對齊是最常見的作弊。 發布時流傳的 Sol 數字大多來自 max 或 xhigh 檔,而 Opus 數字來自 medium 預設檔。任何不寫明雙方檔位的結論,都是拿調校過的設定對比未調校的設定。本文始終標註檔位。
廠商口徑帶著廠商口徑的樂觀。 Opus 5.5 的 Terminal-Bench 66.4% 與 HLE 67.7% 是 Anthropic 在標註條件下的公布值;其中 Terminal-Bench 帶有 ±2.6 的標準誤。Sol 的 $1.06/任務與幻覺率數字由 Artificial Analysis 獨立測量。獨立數字權重應更高。
Sol 的幻覺率改善有一部分是拒答換來的。 獨立測量顯示 Sol 的幻覺率從 92% 降到 60%——但很大程度上靠更頻繁地拒答實現。在智能體管線裡,拒答不是免費的:它表現為任務卡死或升級到人工,而基準百分比把這部分藏了起來。
冗長度會放大 Opus 的輸出費率溢價。 max 檔下 Opus 5.5 每任務產生約 119K 輸出 token,Sol 約 31K。疊加 $20/M 對 $10/M 的輸出費率,高努力檔位下的開放式任務成本可能是標價差距的好幾倍。低檔時差距明顯收窄。
Claude Opus 5.5 真正贏在哪裡
Opus 5.5 不是更便宜的模型,它也沒打算做便宜的模型。它在任務質量天花板、而不是發票成為約束條件的地方獲勝。
1. 終端與前沿編程智能體工作
最清晰的結構性優勢在 Terminal-Bench 4.0——它衡量的是自主命令行軟體工程。Opus 5.5 在 medium 檔拿下 52.5%,Sol 在 max 檔為 43.9%。在兩家廠商都明確瞄準的負載類別——多步 shell 環境、構建-修復循環、測試驅動的修復——這是約 17% 的相對差距。Anthropic 公布的 xhigh 檔 66.4% 進一步拉大了差距,不過帶有前述廠商口徑的保留條件。
2. 知識工作與通用智能評測
在職業知識工作評測 GDPval-AA v2.1 上,Anthropic 公布 1846 Elo。獨立測量發現 Sol 在同族評測上較可比前沿模型回退約 100 Elo。這與 Sol 的定位一致:它是一個編程與自動化專用模型,拿通用知識面的寬度換成本效率。在研究綜合、文件分析與開放域推理上,Opus 5.5 的上限更高。我們關於 Anthropic 中端 Claude Fable 5.1 的報導,有助於理解這個家族在 Opus 價位之下把通用能力推到了多遠。
3. 預設檔體驗
Opus 5.5 最被低估的特性是:它的預設檔就是它的強檔。Medium 檔在交叉點以上的每美元得分勝過 Sol 的 max,意味著沒有精力調校預算的團隊開箱即得前沿表現。而 Sol 的最優價值需要主動配置——確定性任務選 none,自動化選 xhigh,並接受 max 檔在通用能力上仍落後 Opus 預設檔。
GPT-6 Sol 真正贏在哪裡
Sol 的賣點不是「便宜點但差不多好」。它是一種不同的成本架構,有三項具體優勢。
1. 標價恰好一半,還附贈思考關閉開關
未快取短上下文每百萬 token $2.00 輸入、$10.00 輸出,Sol 比 Opus 5.5 便宜 50%——而且它提供了一個前沿競品都沒有的東西:none 檔位徹底關閉擴展思考。對高吞吐的結構化抽取、分類與模板化生成來說,為一台停不下來的模型付費是浪費,Sol 讓你把推理表關掉。想看這份費率表與其他廠商的橫向比較,我們的 Kimi K3 定價 分析用的是同一套總成本方法。
2. 在能力打平處的自動化成本效率
在 AutomationBench-AA 上,Sol xhigh 檔 61.7%,Opus 5.5 medium 檔 61.2%——統計打平,而每任務成本低約 40%。如果你的管線是瀏覽器自動化、DOM 抽取、表單導航與工具編排,Sol 是理性預設:能力相同,帳單不同。
3. 輸出紀律
Sol 在 max 檔每任務產生約 31K 輸出 token,Opus 5.5 約 119K。對必須產出有界產物的智能體——JSON 載荷、補丁 diff、結構化摘要——Sol 的簡潔是特性而非限制:更少的 token 要解析,更少的 token 要付費,更少的返工循環。
開發者與社區真實怎麼說
雙發布後的 24 小時內,開發者論壇產出的信號多於大多數發布日報導。以下是 6 條代表性聲音,採集於 2026 年 9 月 23 日:
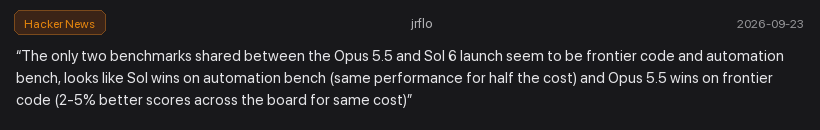
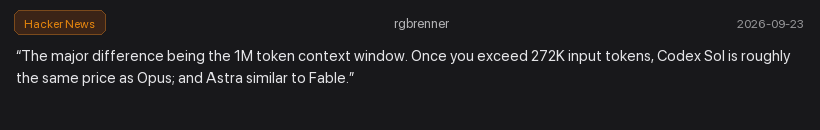
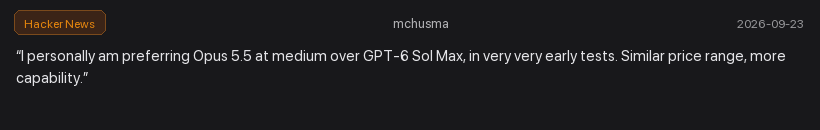
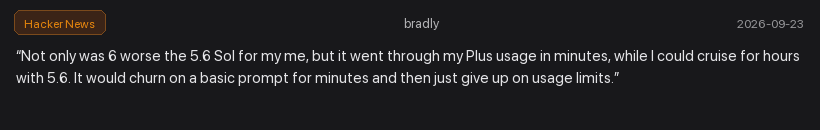
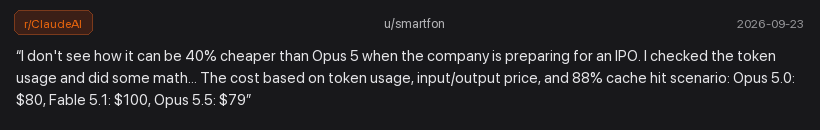
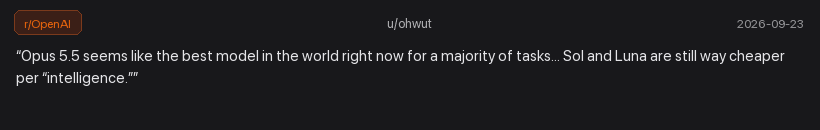
這六條聲音呈現出的模式與測量數據一致:社區沒有加冕唯一的勝者,而是沿負載邊界分裂——自動化與成本效率偏向 Sol,前沿編程與通用能力偏向 Opus 5.5——並且立刻把注意力放在檔位對齊與總成本核算上,而不是原始榜單名次。
結論:負載決策矩陣
| 負載畫像 | 推薦模型 | 決定性理由 | 成本說明 |
|---|---|---|---|
| 終端智能體與 CLI 驅動的編程 | Claude Opus 5.5 | medium 檔在 Terminal-Bench 4.0 領先約 9 分(52.5% 對 Sol max 的 43.9%) | 標價 2 倍,能力差距足以支撐 |
| 高吞吐瀏覽器自動化與抽取 | GPT-6 Sol | AutomationBench-AA 打平(61.7% xhigh 對 61.2% medium),none 檔適合確定性任務 | 每任務便宜約 40% |
| 緊湊上下文智能體循環(輸入 < 272K) | GPT-6 Sol | 2 倍未快取折扣完整成立;快取讀同價($0.20/M) | Opus 5.5 標價的一半 |
| 長上下文任務(輸入 > 272K) | Claude Opus 5.5 | Sol 長上下文翻轉($4/$15)抹平折扣;Opus 無同等懸崖 | 與翻轉後的 Sol 費率相比持平或更優 |
| 開放式研究與知識工作 | Claude Opus 5.5 | GDPval-AA 與 HLE 上限更高;預設 medium 在 44 分以上勝過 Sol max | max 檔冗長度稅更高 |
| 預算受限的通用助手 | GPT-6 Sol | max 檔智能指數 $1.06/任務;44 分交叉點以下最便宜 | 單位智能成本最低 |
從原始 token 到瀏覽器執行:Tabbit 工作流
基準分數不會替你抓網頁、維持登入態,或在四十個打開的分頁之間核對互相矛盾的文件。原始基礎模型對文本進行推理;它們不會自己管理分頁爆炸、動態 shadow DOM 或多步網頁工作流。
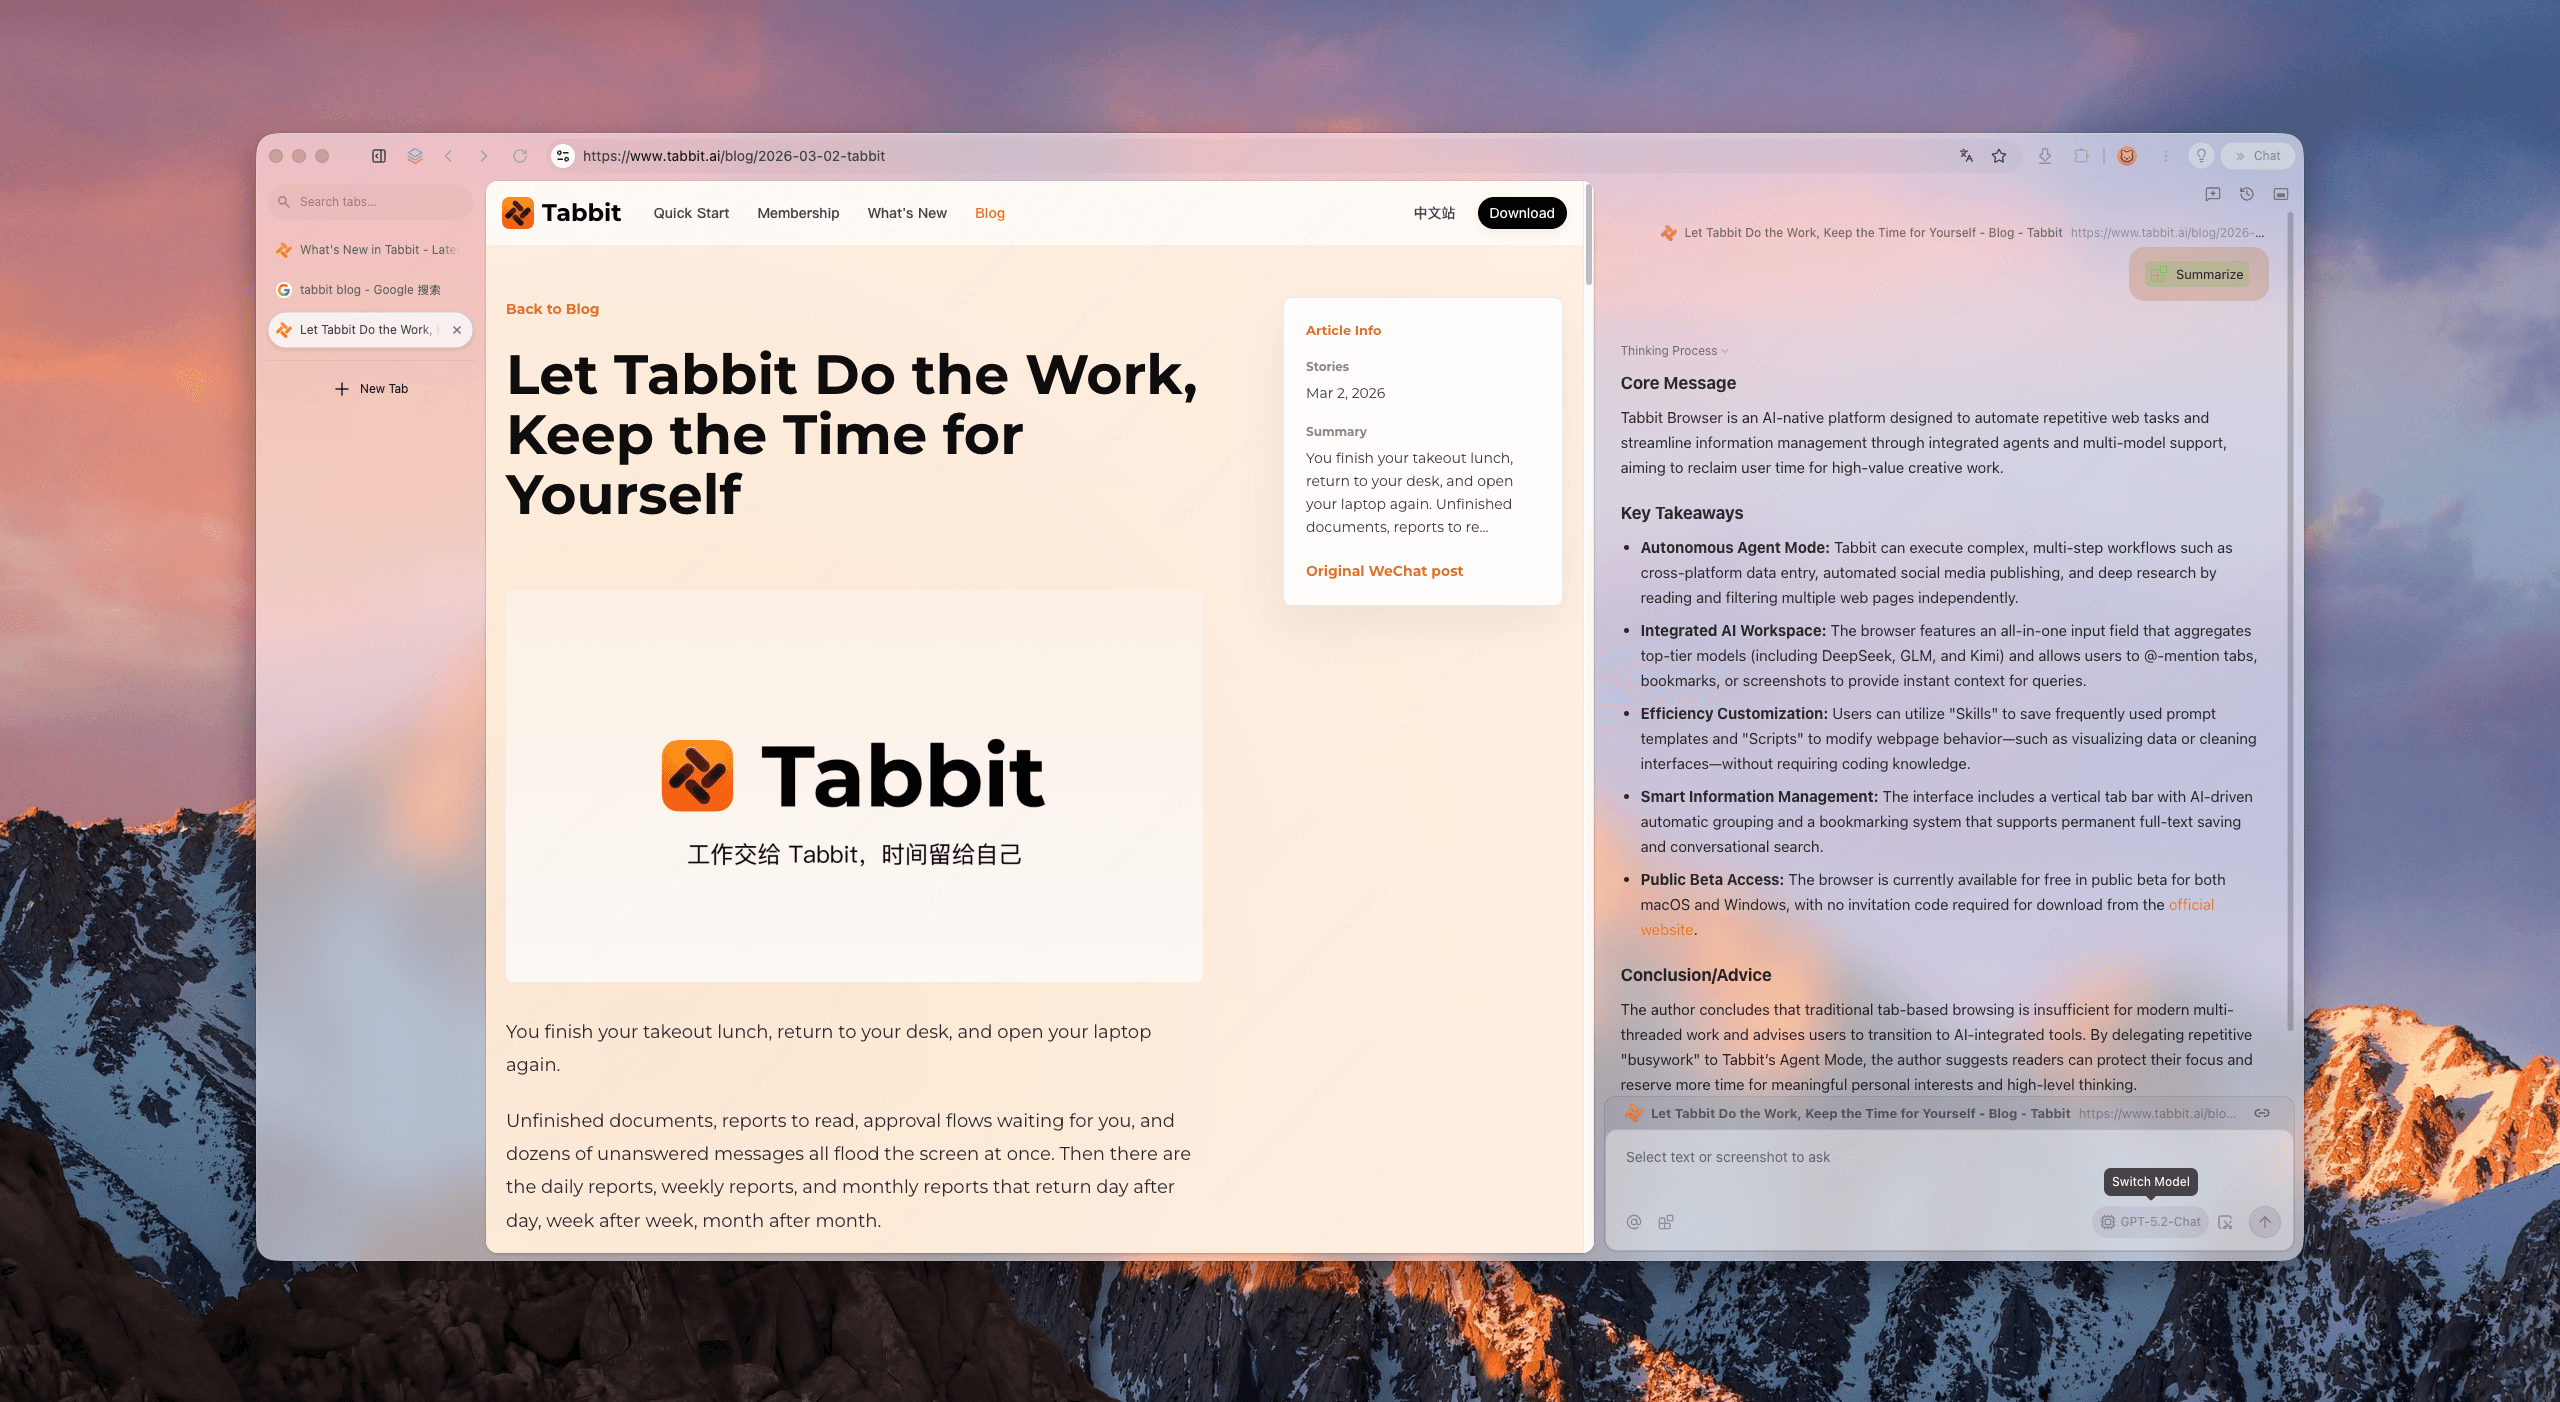
這正是編排環境的價值所在。在 Tabbit Browser 中運行瀏覽器智能體時,模型負責推理,瀏覽器層負責記憶、導航與執行。無論你是讓 GPT-6 Sol 跑緊湊的自動化循環,還是用 Claude Opus 5.5 驅動終端級編程智能體,AI 原生的智能體瀏覽器 才是把 token 定價變成完工交付的東西。2026 年的全景掃描見我們的 2026 最佳 AI 瀏覽器 盤點。
說明:根據平台政策,Tabbit 中的即時模型可用性取決於你帳號的模型選擇器、支援的整合與平台條款。本文基於官方材料與獨立測量,而非內部基準實測。
 Tabbit Browser

常見問題
GPT-6 Sol 和 Claude Opus 5.5 哪個更便宜?
在未快取的短上下文費率上,GPT-6 Sol 恰好是 Opus 5.5 的一半:每百萬 token 輸入 $2.00、輸出 $10.00,而 Opus 5.5 為 $4.00 與 $20.00。但當一個請求的輸入超過 272K token 後,Sol 的整個請求會改按長上下文費率計費(輸入 $4.00、輸出 $15.00),折扣隨即消失。兩者的快取讀取價均為每百萬 token $0.20。
兩個模型誰的基準測試分數更高?
取決於對比的努力檔位。Claude Opus 5.5 在預設的 medium 檔位下,智能指數每任務 51.2 分、成本 $1.34;GPT-6 Sol 在最高的 max 檔位下為 47.5 分、$1.06。Opus 5.5 在 Terminal-Bench 4.0 上也領先(medium 檔 52.5%、Anthropic 口徑 xhigh 檔 66.4%),而 Sol 在 AutomationBench-AA 上以約低 40% 的成本追平 Opus medium 檔(61.7% 對 61.2%)。
GPT-6 Sol 和 Claude Opus 5.5 各有哪些努力檔位?
GPT-6 Sol 提供 none、low、medium(預設)、high、xhigh、max 六檔,其中 none 可以完全關閉擴展思考。Claude Opus 5.5 提供 low、medium(預設)、high、xhigh、max 五檔,且擴展思考無法關閉。努力檔位同時影響能力與每任務成本,因此任何對比都必須寫明雙方檔位。
為什麼很多對比都把 Opus 5.5 medium 和 GPT-6 Sol max 放在一起比?
因為這兩個檔位下兩模型的每任務總成本最接近。對齊成本的測量顯示,在約 44 分以上的智能需求區間,Opus 5.5 medium 勝過 Sol max;低於該閾值時 Sol 更便宜。凡是不寫明雙方檔位的對比,通常都是行銷而非測量。
Claude Opus 5.5 真的比 Claude Opus 5 便宜 40% 嗎?
這是 Anthropic 公布的廠商口徑(典型負載)。有社區使用者用真實用量日誌按 88% 快取命中率複算,得到 Opus 5.5 每單位工作約 $79、Opus 5.0 約 $80——基本持平,而非便宜 40%。對廠商的成本宣稱應按自己的 token 結構重新核算。
我可以在 Tabbit Browser 裡使用 GPT-6 Sol 和 Claude Opus 5.5 嗎?
Tabbit Browser 提供面向研究、資料提取與多模型對比的 AI 原生工作區。具體模型在 Tabbit 中的可用性取決於你帳號的即時模型選擇器與平台條款。