
대량 코딩, 자동화, 그리고 태스크당 비용으로 예산이 결정되는 에이전트 루프가 주력 업무라면 GPT-6 Sol로의 전환이 값진 선택입니다. 지식 노동의 최고 상한선이나, 절대 태스크를 포기하지 않는 에이전트가 필요하다면 당분간 자리를 옮기지 마세요. 반 값 요금표는 진짜입니다. 백만 토큰당 입력 $2, 출력 $10으로, GPT-5.6 Sol 프로모션 요금의 절반이며 2026년 9월 23일 OpenAI 모델 카드에서 확인했습니다. 하지만 이 리뷰에서 진짜로 흥미로운 부분은 가격이 아닙니다. 모델이 정확해진 '방식'입니다. Artificial Analysis의 측정에서 환각률은 92%에서 60%로 떨어졌지만, 동시에 시도하는 질문의 비율은 99%에서 83%로 낮아졌습니다. 정확히 말해 새 Sol은 "더 적게 대답하는 모델"입니다.
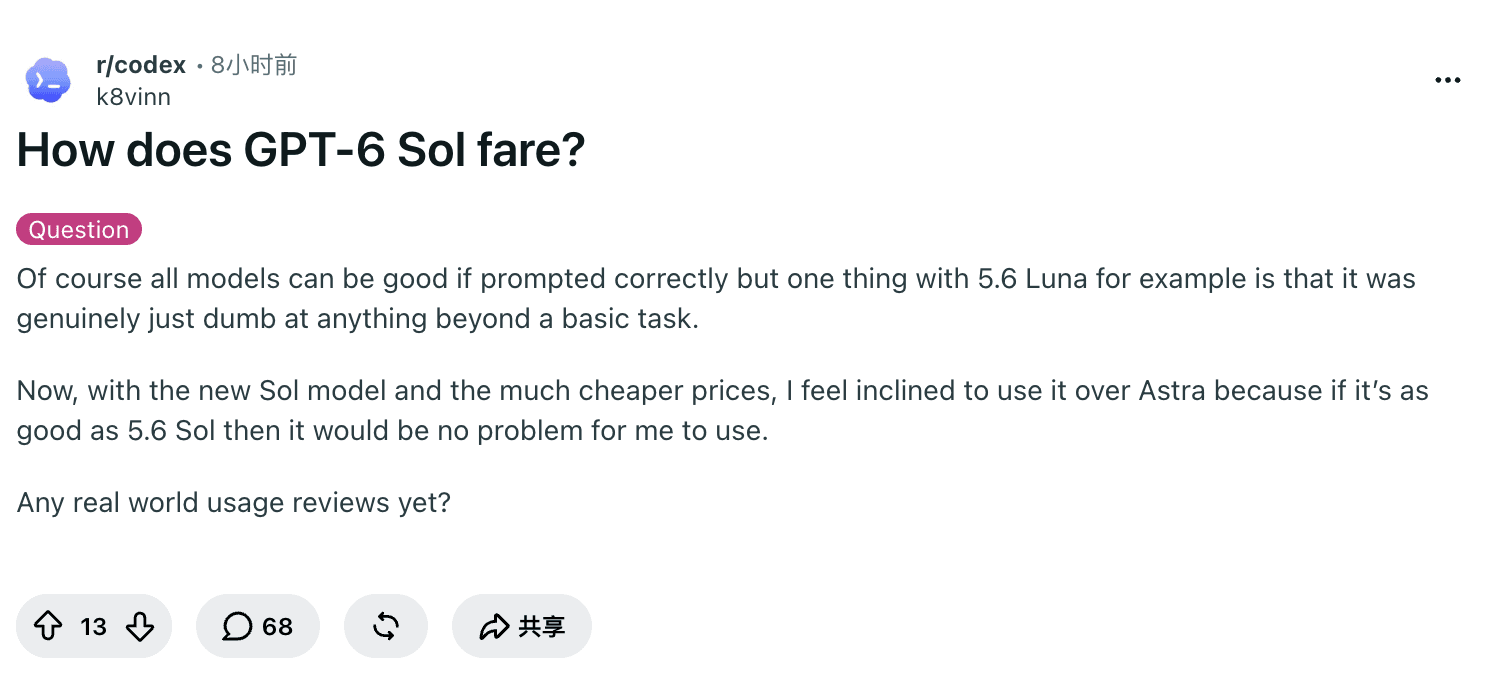
바로 이 트레이드가 출시 커뮤니티를 둘로 가른 쟁점입니다. 출시 4시간 뒤 u/k8vinn은 r/codex에 이 리뷰가 답하려는 질문을 올렸습니다. "새 Sol과 훨씬 싼 가격을 보니 Astra 대신 이걸 쓰고 싶어집니다. 5.6 Sol 수준이라면 쓰는 데 아무 문제 없을 텐데요. 실전 사용 리뷰한 분 있나요?" ("Any real world usage reviews yet?") (Reddit)
GPT-6 Sol 요금표는 별도로 분해했고, GPT-6 Sol 대 Claude Opus 5.5 비교가 둘 중 하나 고르기 문제를 다룹니다. 같은 가문의 GPT-6 Astra 리뷰도 나와 있습니다. 이 글은 모델 그 자체의 판정입니다. GPT-6 Sol이 정말 좋아진 곳, 물리는 곳, 그리고 어떤 워크로드가 갈아타고·머물고·떠나야 하는지. 테스트 하네스가 아니라 실제 웹 페이지에서 모델을 돌리고 싶다면 글 끝에 브라우저 차원의 경로를 안내합니다.
핵심 요약
지능은 동급, 가격은 절반. Artificial Analysis의 GPT-6 Sol (max)은 Intelligence Index 48로 GPT-5.6 Sol과 동등하며, 태스크당 $1.06 대 $1.99. 요금표는 $4/$20에서 $2/$10로 인하됐습니다.
정확도 개선은 기권 전략입니다. AA-Omniscience에서 환각률은 92%→60%로 떨어졌지만, 시도율은 99%→83%, 시도한 질문 기준 정확도는 59%→54%로 내려가는代价를 치릅니다.
토큰 효율은 조용한 업그레이드. Sol (max)은 AA 스위트에서 77M 토큰을 생성해 88M 중앙값보다 적었고, 실무자들은 주간 쿼터를 거의 쓰지 않는 Codex 작업을 보고했습니다.
지식 노동의 업그레이드는 아닙니다. Sol은 GDPval-AA v2.1에서 약 100 Elo 하락했고, II 48은 GPT-6 Astra(53), Claude Opus 5.5(58)보다 낮습니다.
이번 주 플랫폼 현실도 중요합니다. Sol은 ChatGPT Work와 Codex에는 있지만 Chat에는 없습니다. 구독자들은 6세대에서 Plus 쿼터가 급격히 녹는다고 보고하며, Chat Completions를 쓰는 API 팀은
reasoning_effort가 none을 넘으면 function calling을 잃습니다.
이 리뷰를 결정하는 한 개의 숫자: 덜 대답해서 얻은 정확도
벤치마크는 GPT-6 Sol을 향해 어깨를 으쓱하며 시작했습니다. Artificial Analysis의 출시 노트는 "Intelligence Index와 Coding Agent Index 점수는 GPT-5.6과 동급을 유지하며, 일부 평가에서는 진전, 일부에서는 후퇴"라고 적고, 두 줄 뒤 같은 문장에서 행동을 실제로 바꾸는 숫자를 던집니다. 지식·환각 벤치마크 AA-Omniscience에서 GPT-6 Sol (max)의 환각률은 92%에서 60%로 낮아졌는데, 그 방식은 GPT-5.6 Sol (max)의 99%에서 83%로 시도율을 줄이는 것. 오답은 약 4분의 1 줄었지만 시도한 질문 기준 정확도는 59%에서 54%로 내려갔습니다(Artificial Analysis, 2026년 9월 23일 확인).
엔지니어링 언어로 옮기면 OpenAI는 커버리지를 정확도와 바꾼 것입니다. 이 모델은 손을 덜 들고, 손을 들었을 때 한 번당 정확도도 이전 세대보다 살짝 낮습니다. 그러나 "자신만만한 오답"의 총량은 무너졌습니다. OpenAI 자체 사실성 평가도 같은 이야기를 합니다. 사용자가 오류로 표시한 실제 대화 샘플에서 "GPT-6 Sol은 전 세대 대비 오류가 약 절반이며, Astra 수준의 신뢰성에 접근한다"(공식 발표). 단, OpenAI가 붙인 단서도 읽어야 합니다. 그 대화들은 '오류를 유발하는' 것들을 골라낸 표본이라 일반적인 사용을 대표하지 않고, 점수는 길이에 대해 통제되지 않았습니다.
이 리뷰의 모든 판단은 한 질문으로 분류됩니다. 당신의 비용을 지배하는 건 '오답'입니까, '무응답'입니까? 오답이 비싼 곳. 코드 리뷰, 컴플라이언스, 하위 시스템에 공급하는 추출에서는 기권 트레이드가 실질적 업그레이드입니다. 커버리지가 본업인 곳. 거절 한 번이 곧 막힌 태스크이자 끝나지 않는 페이지가 되는 에이전트 파이프라인에서는 같은 설계가 후퇴로 보입니다. 이 축을 기억하세요. 최종 판정에서 다시 등장합니다.
벤치마크, 그리고 몇 퍼센트만 믿을 것인가
아래 독립 수치는 모두 2026년 9월 23일의 동일한 Artificial Analysis 스냅샷에서 나왔으며, 노력 수준(effort)을 명시합니다. 출시 주 비교가 몰래 부정행위를 하는 지점이 대부분 effort이기 때문입니다. 가격 행은 OpenAI 모델 카드와 같은 날 공개된 요금 가이드에서 왔습니다.
| 항목 | GPT-6 Sol (max) | GPT-5.6 Sol (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max w/ fallback) | 의미하는 것 |
|---|---|---|---|---|---|
| API 가격(입력/출력, 백만 토큰당) | $2 / $10 | $4 / $20(11월 21일까지 프로모) | $10 / $50 | $4 / $20 | Sol은 Opus 5.5와 같은 입력 가격에 출력은 절반. |
| AA Intelligence Index | 48 | Sol과 동급 | 53 | 58 | 당신이 사는 건 더 싼 같은 등급의 지능이지, 더 많은 지능이 아닙니다. |
| AA 태스크당 비용(II) | $1.06 | $1.99 | $3.26 | $5.98 | 5.6 Sol의 절반, Astra의 3분의 1, max끼리면 Opus 5.5의 약 18%. |
| 환각률, AA-Omniscience | 60% | 92% | 미보고 | 미보고 | 헤드라인이 되는 정확도 승리. |
| 같은 벤치마크 시도율 | 83% | 99% | — | — | …그리고 대가: 더 적게 대답합니다. |
| GDPval-AA v2.1(지식 노동) | 프런티어 대비 약 −100 Elo | 미보고 | 미보고 | 1846 Elo(Anthropic 보고) | 전문 지식 노동을 Sol에게 맡기지 마세요. |
| 출력 속도(AA 중앙값) | 131 tok/s | 미보고 | 58 tok/s | 미보고 | 중위권. Astra·Fable 5.1보다 빠르고 Flash급보다는 훨씬 느림. |
| 컨텍스트 / 최대 출력 | 1.05M / 128K | 1M / 32K | 1.05M / 128K | 1M / 128K | 사양은 벤더 모델 페이지 기준. 272K 과금 기준값은 가문 전체에 적용. |
어떤 행을 믿기 전에 찬물 세 그릇:
벤더 점수는 벤더 하네스에서 나옵니다. OpenAI가 발표한 AutomationBench, Agents' Last Exam(Sol max 56.4%, Opus 5 최고 기록을 비용 60% 적게 들이고 상회), DeepSWE(68.8% 대 Fable 5의 69.9%, 비용 약 80% 절감), OSWorld 2.0 offline(60.5% ≈ Opus 5 medium의 60.3%, 비용 약 80% 절감)은 모두 자체 보고입니다. 발표문의 각주조차 평가가 "프로덕션 ChatGPT와 출력이 약간 다를 수 있는" 연구 환경이나 API에서 이뤄졌으며 경쟁사 점수는 공개 보고서에서 가져왔다고 인정합니다. 방향 나침반으로는 유용, 복음은 아닙니다.
지수 값은 흘러갑니다. 하루 전에 발표한 우리의 GPT-6 Astra 리뷰가 인용할 당시 AA Intelligence Index는 Astra 61.2, 5.6 Sol 60.9였습니다. 같은 트래커가 지금 올려놓은 값은 Astra 53, Sol 48입니다. Artificial Analysis는 지수를 버전 관리하고 재기준화합니다. 모델 비교는 반드시 같은 스냅샷 안에서, 절대 주 단위로 건너뛰지 말고 하세요.
Effort 불일치는 출시 주의 치트키입니다. Sol의 공개 점수는 대부분 max, Opus 5.5의 헤드라인 숫자는 종종 기본값 medium입니다. 양쪽 설정을 명시하지 않는 "Sol이 이겼다/졌다"는 마케팅입니다. 우리의 비교글이 비용을 맞춘 버전의 계산을 해 뒀습니다.
여기서 벤치마크는 나침반이지 자가 아닙니다. 이 시점에서 더 무게를 두는 것은 실제 태스크를 측정한 사람들의 보고이며, 출시 후 24시간은 놀랄 만큼 일관된 신호 묶음을 돌려줬습니다.
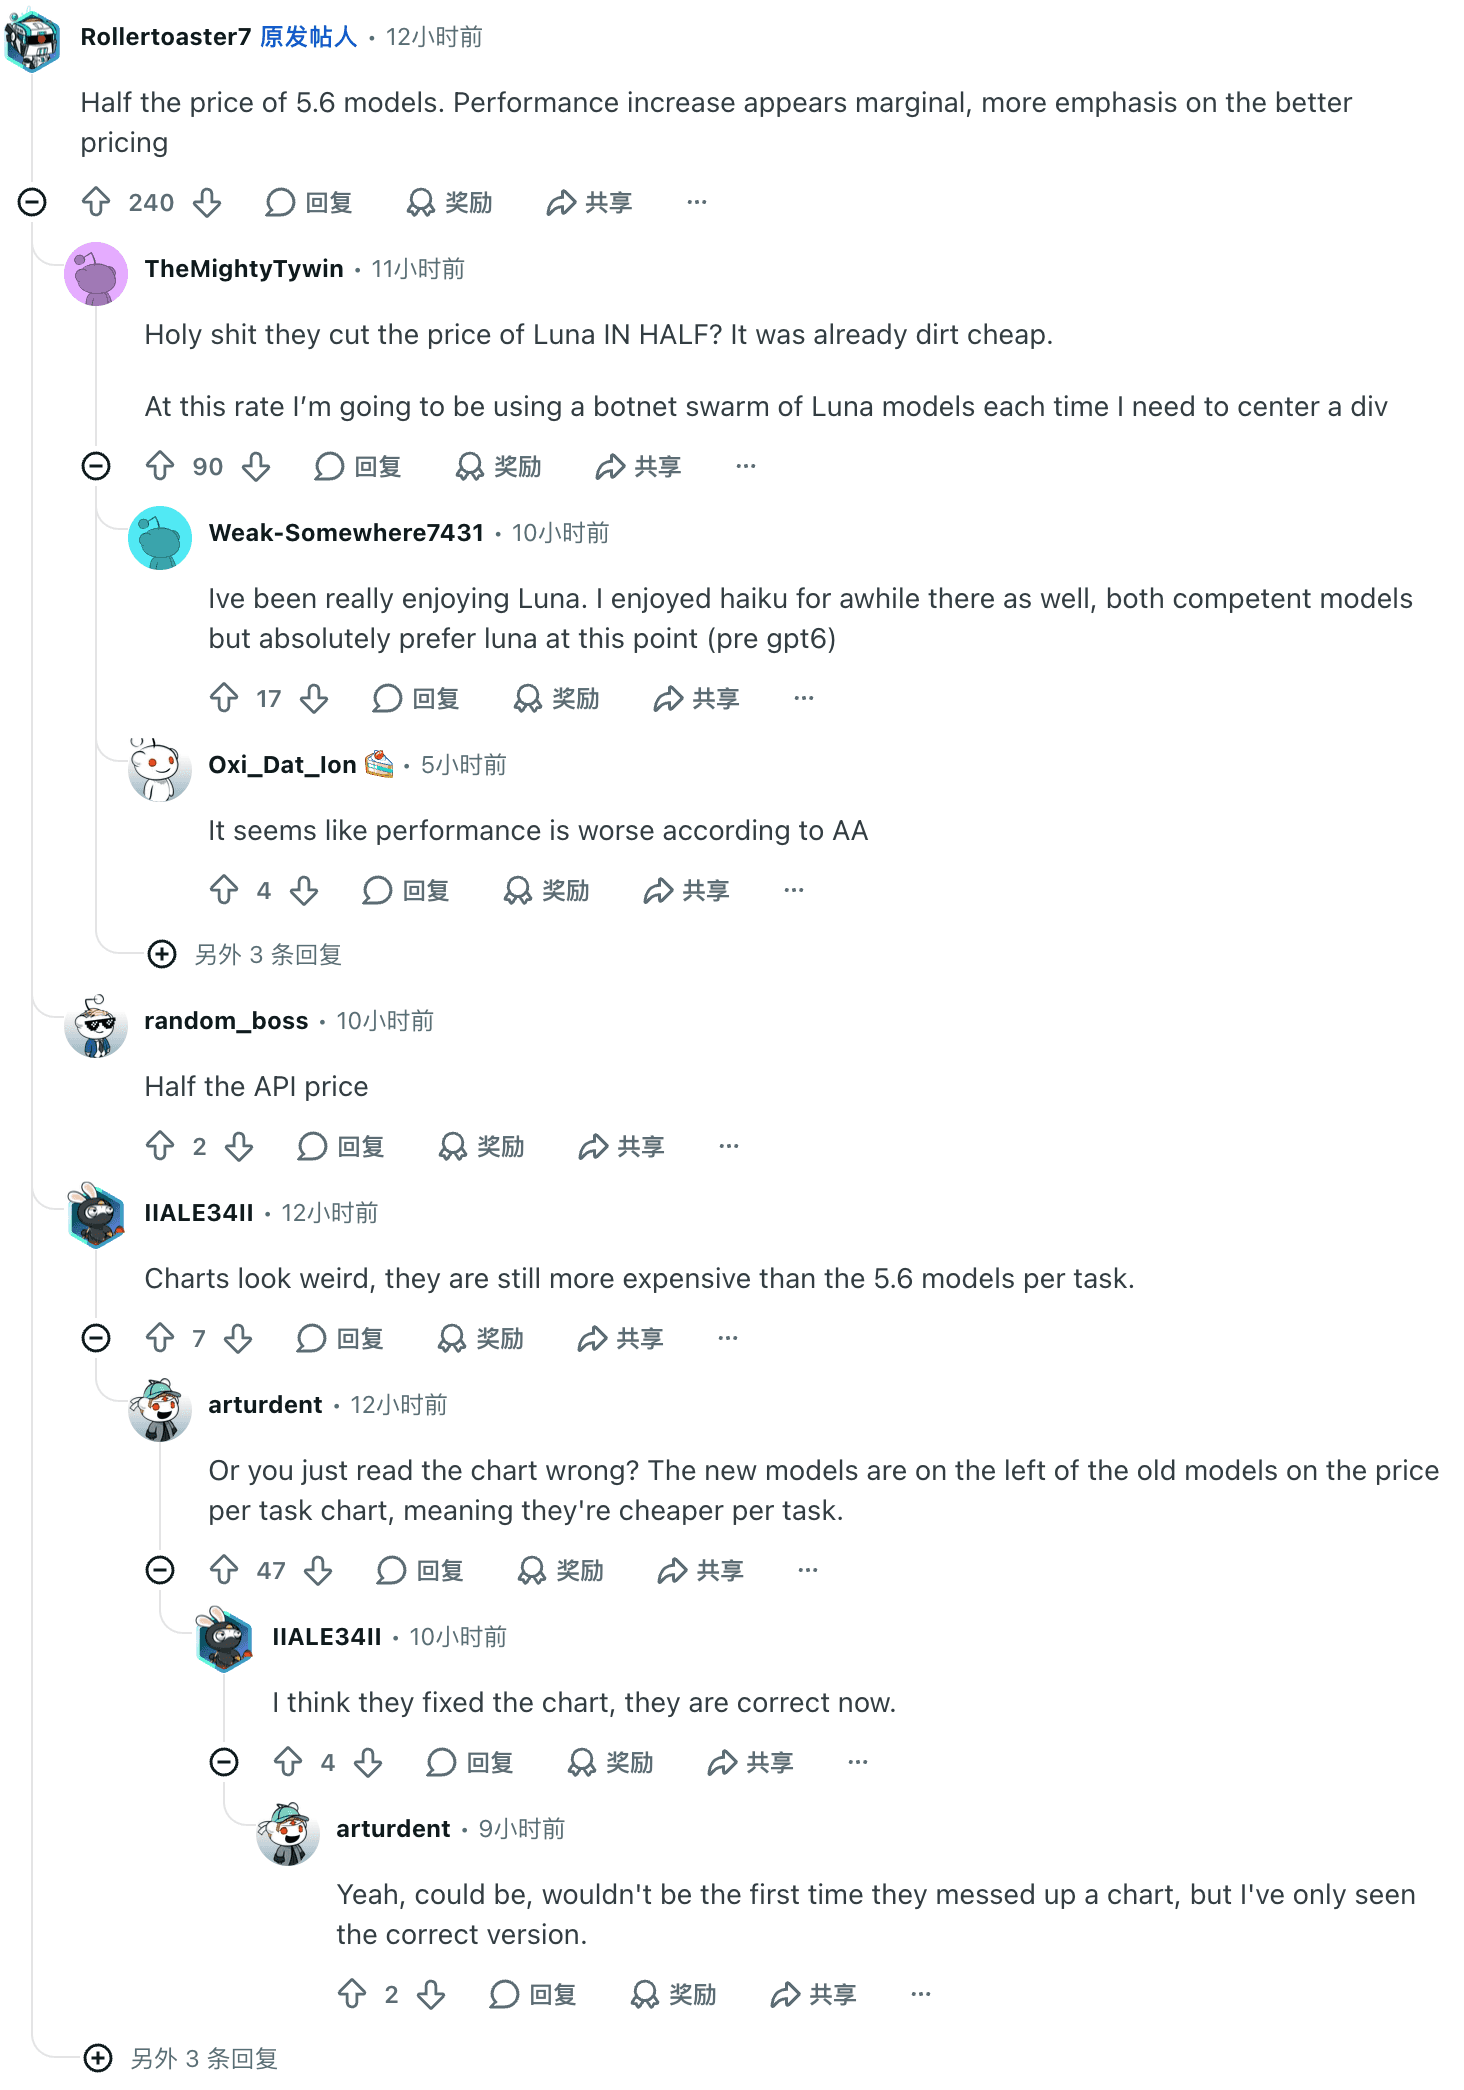
"가격은 절반, 성능은 평작미"라는 읽기는 r/codex 출시 스레드에서 몇 시간 만에 최고 추천 댓글이 됐습니다. 글쓴이 u/Rollertoaster7의 "Half the price of 5.6 models. Performance increase appears marginal, more emphasis on the better pricing"(5.6 모델의 반 값. 성능 향상은 미미해 보이고, 더 나은 가격에 무게가 실린다)은 240 추천을 받았고, 다른 사용자는 AA의 오르락내리락하는 결과를 직접 인용했습니다(Reddit). 독립 평가기관 Vals AI도 자체 벤치에서 같은 고원에 도달했습니다. "GPT-6 Sol… Vals Index 8위, GPT 5.6 Sol과 거의 동등한 수준에 비용은 절반"(X).
GPT-6 Sol이 진짜로 좋은 곳
1. 사실성: 자신만만한 오답이 줄었다
기권 메커니즘은 벤치마크 안의 현상으로 끝나지 않습니다. 실제 파이프라인에서는 "흐름에 맞장구 대신 반박하는 모델"로 나타납니다. Hacker News의 한 사용자는 다른 모델의 코드 리뷰에 '제2의 의견'으로 Sol을 쓴 경험을 이렇게 적었습니다. "i used it for code review and it flagged twenty issues, sol checked the review and found 75% of them were hallucinations. sol was much closer to reality."(코드 리뷰에 썼는데 그쪽은 20개 문제를 지적했고, Sol이 그 리뷰를 검토해 75%가 환각임을 찾아냈습니다. 현실에 더 가까웠던 건 Sol이었습니다.)(HN). 일화 하나로 비율을 증명할 수는 없지만, AA의 측정과 OpenAI의 '오류 절반' 주장과 세 방향에서 정확히 맞물립니다. 오류를 벌하는 업무. 리뷰, 추출, 컴플라이언스에서는 이것이 어떤 지수 점수보다 중요한 업그레이드입니다.
2. 토큰 효율: 조용한 청구서 컷
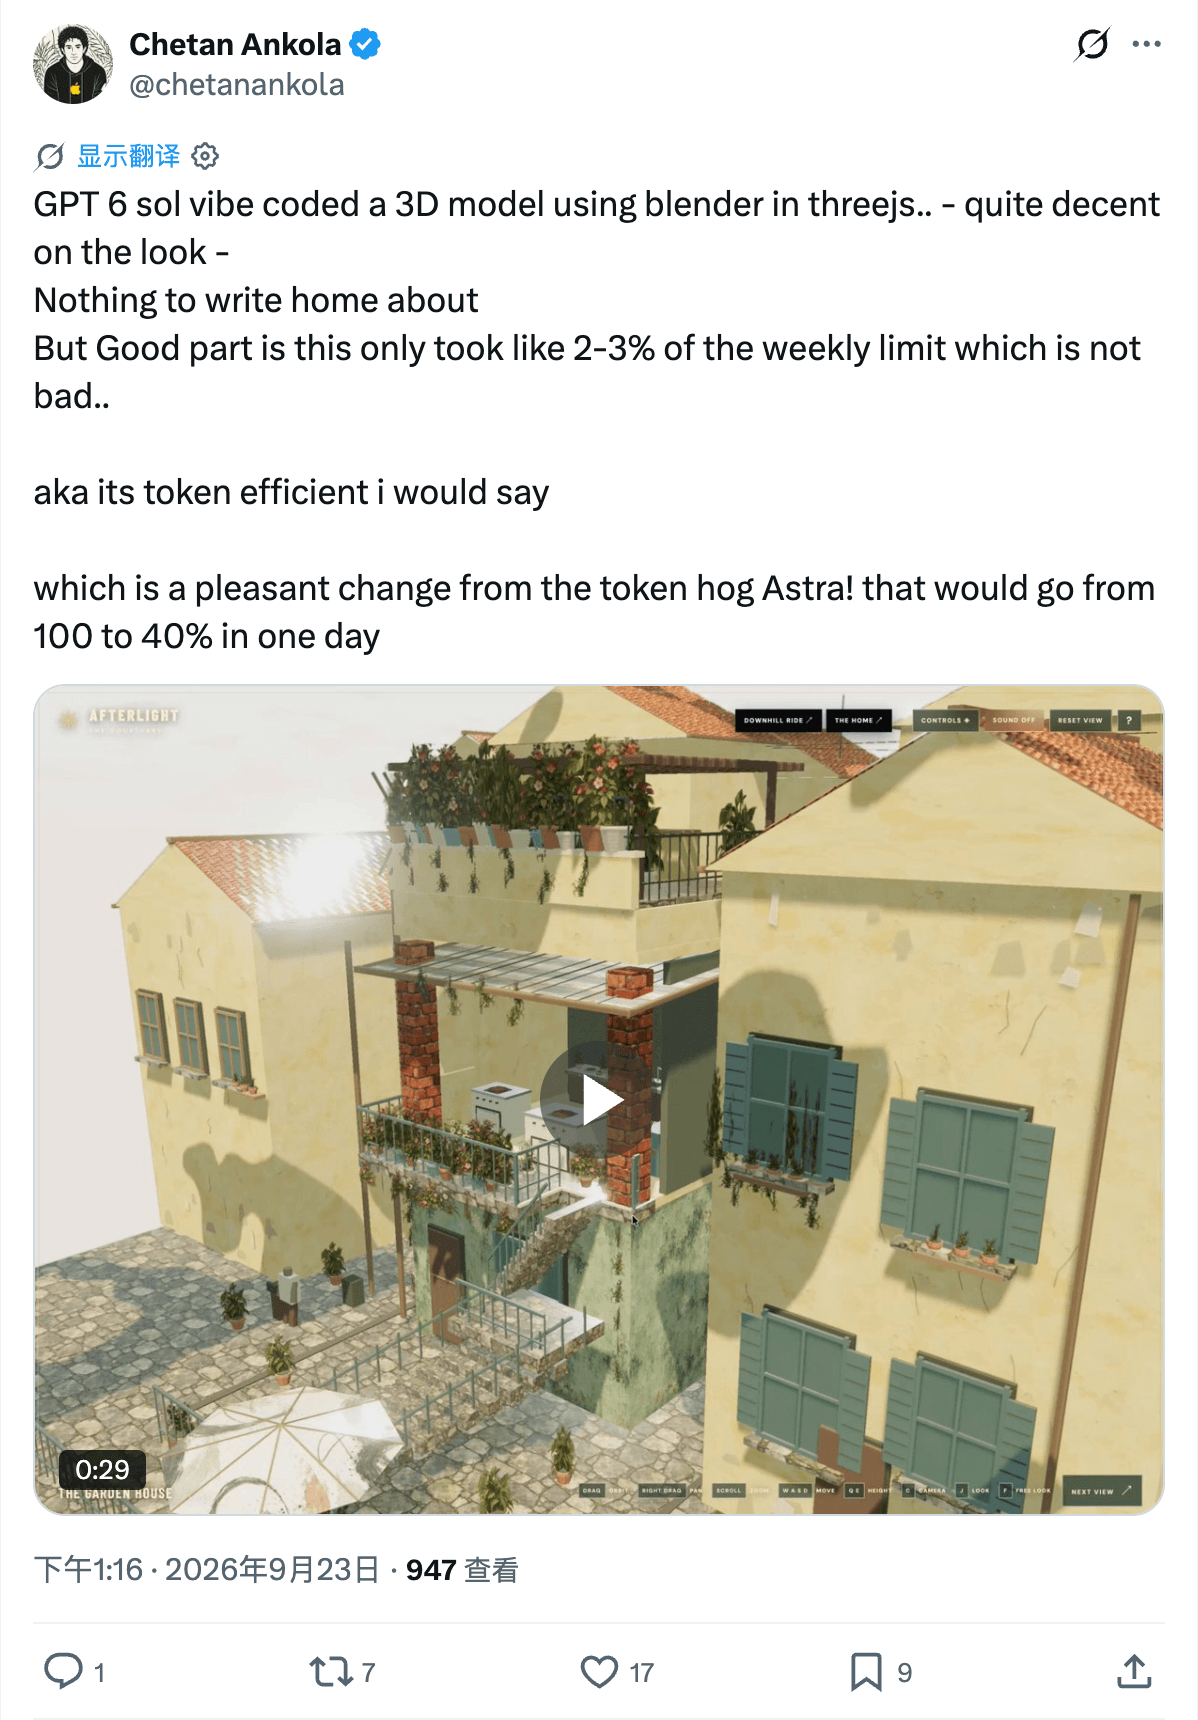
추론 모델은 두 번 청구합니다. 대답에 한 번, 생각에 한 번. Sol의 AA 스위트 생성량은 77M 토큰으로 88M 중앙값 아래였고, 구독자들도 같은 '마른' 소비를 알아챘습니다. r/codex에서는 "내 Codex 토큰 사용량 < 블랙홀"이라는 농담이 나왔고, X의 한 개발자는 Blender/Three.js 작업을 측정해 "주간 한도의 2-3% 정도만 썼습니다… 토큰 효율이 좋다고 해야죠. 하루 만에 100에서 40으로 녹는 토큰 괴물 Astra에서 벗어나 기분 좋은 변화입니다"(X)라고 했습니다. 요금표와 겹쳐 보면 OpenAI가 "Sol(xhigh)은 AutomationBench에서 Opus 5 (max)를 태스크당 비용 9%로 이긴다"는 주장이 최소한 그럴듯한 이유가 보입니다. 더 적은 토큰을, 더 싼 단가로, 자동화 형태의 일에.
3. 글쓰기와 협업 스타일
OpenAI는 Astra에서 개선된 커뮤니케이션 스타일. "더 명확하게, 더 적은 은어로". 이 Sol에도 이어진다고 말하며, 이는 하루 만에 독립 블라인드 테스트가 재확인한 드문 벤더 주장입니다. How I AI의 블라인드 벤치는 "명확한 글쓰기, 읽기 쉬운 PRD, 가격"을 Sol이 여전히 이기는 항목으로 꼽았습니다(Lenny's Newsletter). 코드와 함께 문서를 내놓는 팀. 스펙, PRD, 리뷰 요약에게는 어떤 리더보드 행에도 담기지 않는 일상 품질의 개선입니다.
GPT-6 Sol이 물리는 곳
1. 기권세
위의 강점은 모두 거울상을 갖습니다. 83%의 질문만 시도하는 모델을 무인 에이전트 파이프라인에 넣으면, 17%의 빈칸을 돌려주는 모델이 됩니다. 빈칸 하나하나가 막힌 태스크, 재시도, 사람에게 넘기는 에스컬레이션입니다. AA는 답변 한 건의 대가도 측정했습니다. 시도한 질문 기준 정확도는 59%에서 54%로 떨어졌고, 경제적 가치가 있는 지식 노동을 재는 GDPval-AA v2.1에서 Sol은 프런티어 동료들보다 약 100 Elo 하락했습니다. 지식 노동의 상한선은 애초에 이 모델의 목표가 아닙니다. 파이프라인이 거절을 용납할 수 없다면 첫날부터 폴백 모델을 예산에 넣으세요.
2. 커뮤니티의 일부는 이를 'Terra 포장 바꾸기'로 읽습니다
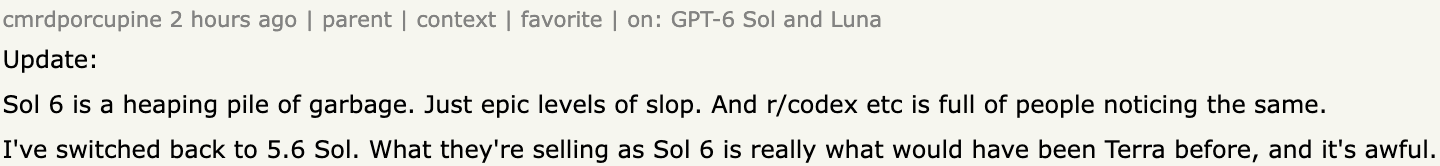
가장 날카로운 부정 보고는 같은 주제로 수렴합니다. 이것은 세대 교체가 아니라 재가격 책정이라는 것입니다. 이미 되돌아간 Hacker News 개발자는 이렇게 썼습니다. "Update: Sol 6 is a heaping pile of garbage... I've switched back to 5.6 Sol. What they're selling as Sol 6 is really what would have been Terra before."(업데이트: Sol 6은 쓰레기 더미입니다… 5.6 Sol로 되돌렸습니다. 그들이 Sol 6로 파는 것은 예전에 Terra였을 물건입니다.)(HN). r/codex에서도 같은 직관이 나왔습니다. "써 보니 확실히 더 멍하다. Terra 느낌이다." 측정된 중간지점은 이렇습니다. 지수는 평균으로 동급이지만, "일부 평가에서 진전, 일부에서 후퇴"라는 말은 개별 워크로드가 후퇴한 쪽에 놓일 수도 있다는 뜻입니다. 당신의 프롬프트 조합이 하락한 평가 위에 놓이면 체감은 평균과 모순될 것입니다. 두 진영이 다 맞다는 것과 모순되지 않습니다.
3. 출시 주의 플랫폼 마찰
이번 주 전환을 식히는 현실적인 마찰 세 곳. 첫째, 가용성: Sol은 유료 플랜의 ChatGPT Work와 Codex에는 있지만 아직 Chat에는 없고, Free/Go 사용자는 GPT-6 Luna만 받습니다(공식 발표). 둘째, 구독 경제학: 한 Plus 사용자는 "5.6으로는 몇 시간씩 여유롭게 쓴 게 6에서는 몇 분 만에 Plus 사용량을 태웠습니다. 단순한 프롬프트에서 몇 분씩 맴돌다 사용 한도 앞에서 포기했습니다"(HN)라고 보고했습니다. API가 싸져도 추론 토큰은 쿼터를 태웁니다. 셋째, API 표면: 구형 Chat Completions 엔드포인트에서는 function calling이 reasoning_effort: none에서만 동작하며, 도구 호출 워크플로는 Responses API로 가야 하고, 파인튜닝은 지원되지 않습니다(모델 카드). 사용 양식 때문에 5.6 Sol에 남는다면 그 프로모 가격은 최소 2026년 11월 21일까지 유지되며 우리의 1M 컨텍스트 설정 가이드도 여전히 유효합니다.

커뮤니티는 실제로 뭐라고 했나
24시간치 커뮤니티 신호는 2절의 그 축을 따라 깔끔하게 둘로 나뉩니다. 실력이나 경력이 아니라요.
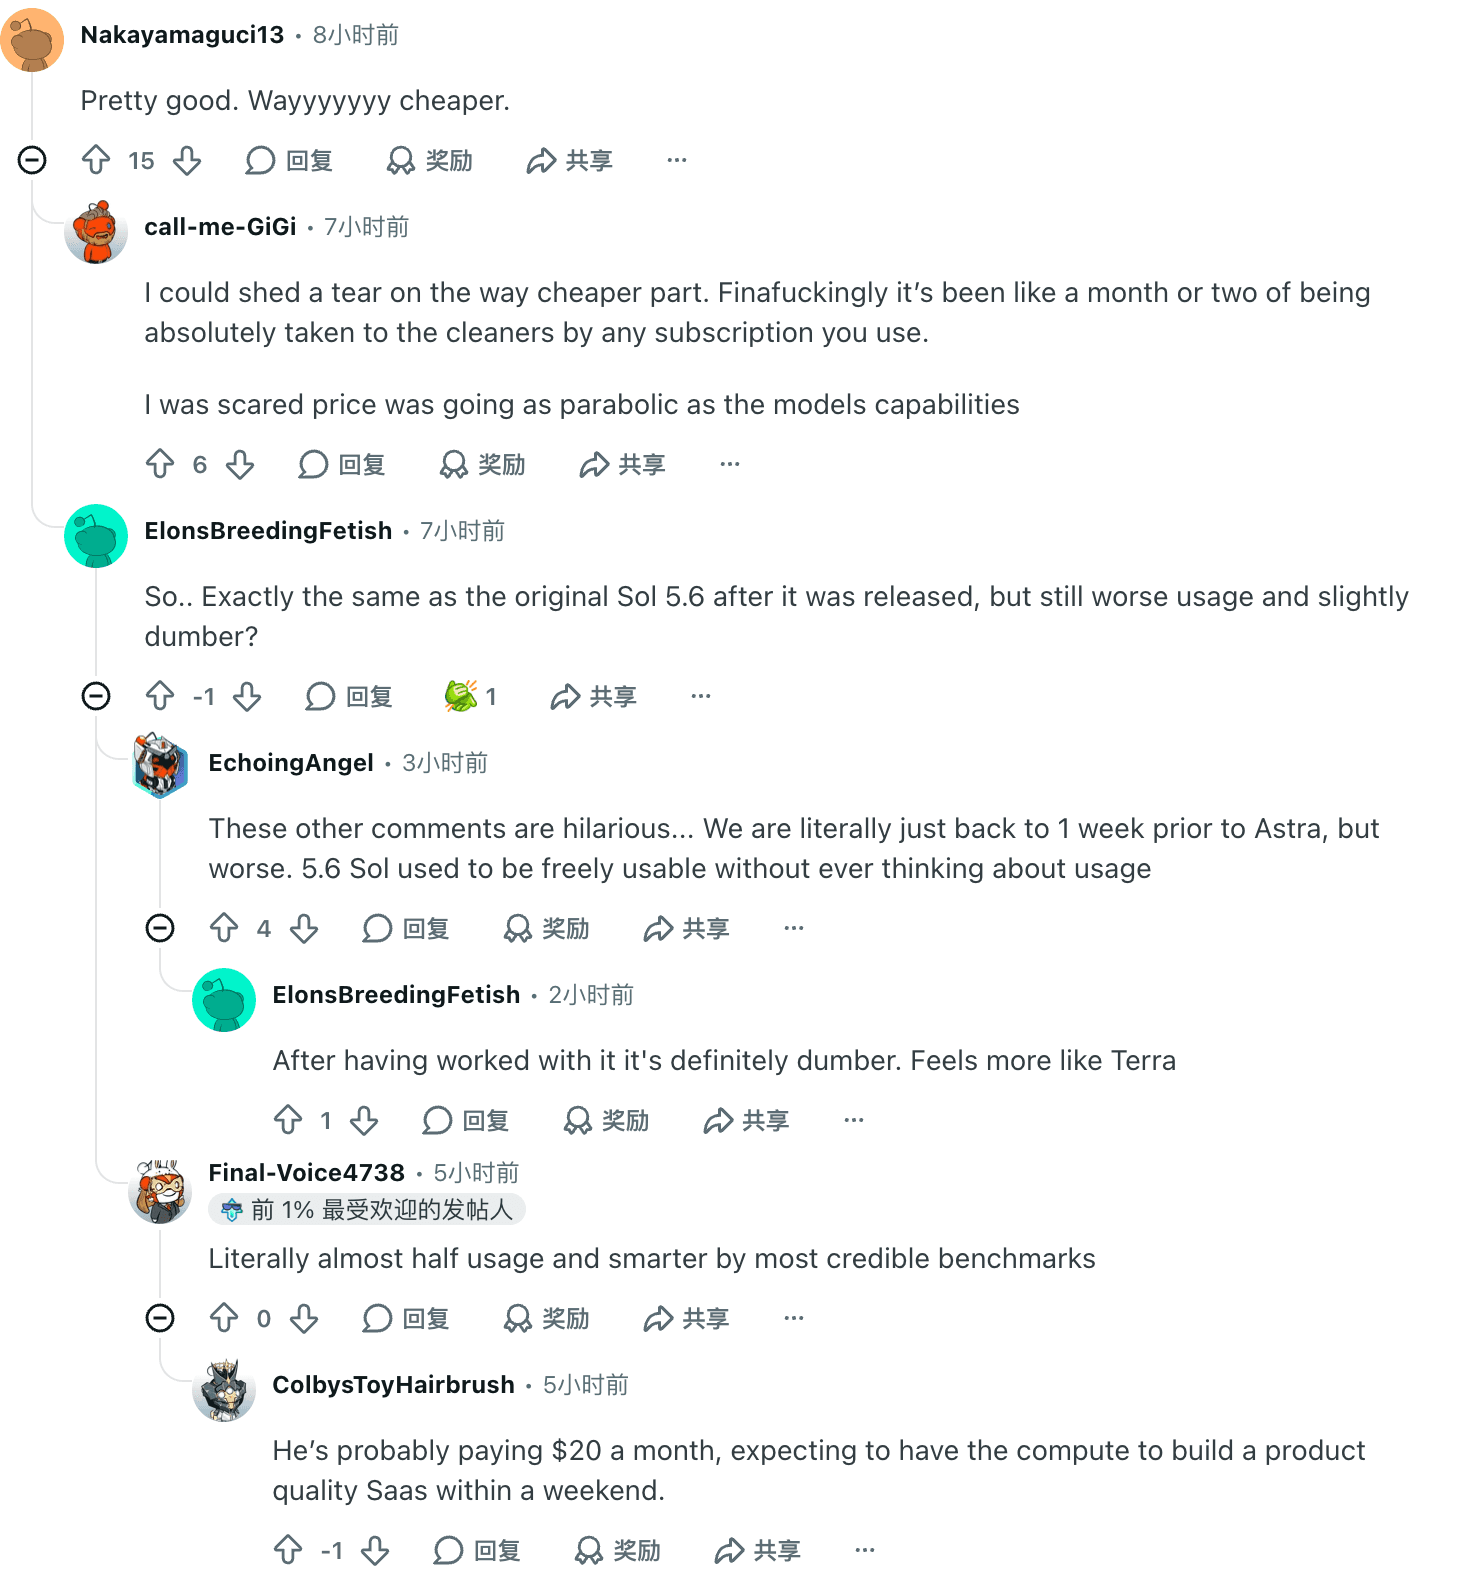
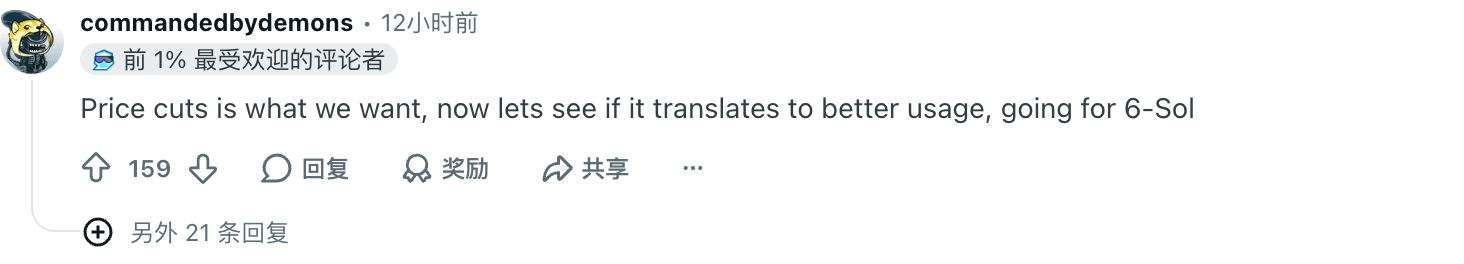
진영 1: "반 값이야말로 업그레이드." "Pretty good. Wayyyyyyy cheaper."(좋군. 엄청 싸.)(u/Nakayamaguci13). "Literally almost half usage and smarter by most credible benchmarks"(말 그대로 사용량은 거의 절반, 그럴듯한 벤치마크 대부분에서는 더 똑똑)(u/Final-Voice4738). 지켜보는 다수가 r/codex 스레드를 159 추천까지 밀어올렸습니다. "Price cuts is what we want, now lets see if it translates to better usage, going for 6-Sol"(가격 인하는 우리가 원하던 것. 이제 더 나은 사용으로 이어지는지 보는 거지. 나는 6-Sol 갑니다)(u/commandedbydemons).
진영 2: "후계자가 아니라 재가격 책정이다." "확실히 더 멍하다. Terra 느낌."(u/ElonsBreedingFetish). "AA에 따르면 성능이 오히려 worse"(u/Oxi_Dat_Ion). 위에서 인용한 cmrdporcupine의 복귀 선언이 이 진영의 가장 무거운 발언입니다.
중간파가 진짜 정보를 쥐고 있습니다. Hacker News의 u/mchusma는 대부분의 팀이 마주한 실제 비교를 이름으로 지목했습니다. "I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."(아주 이른 테스트에서 개인적으로는 max의 GPT-6 Sol보다 medium의 Opus 5.5를 더 선호합니다. 가격대는 비슷한데 능력은 더 있습니다.)(HN).
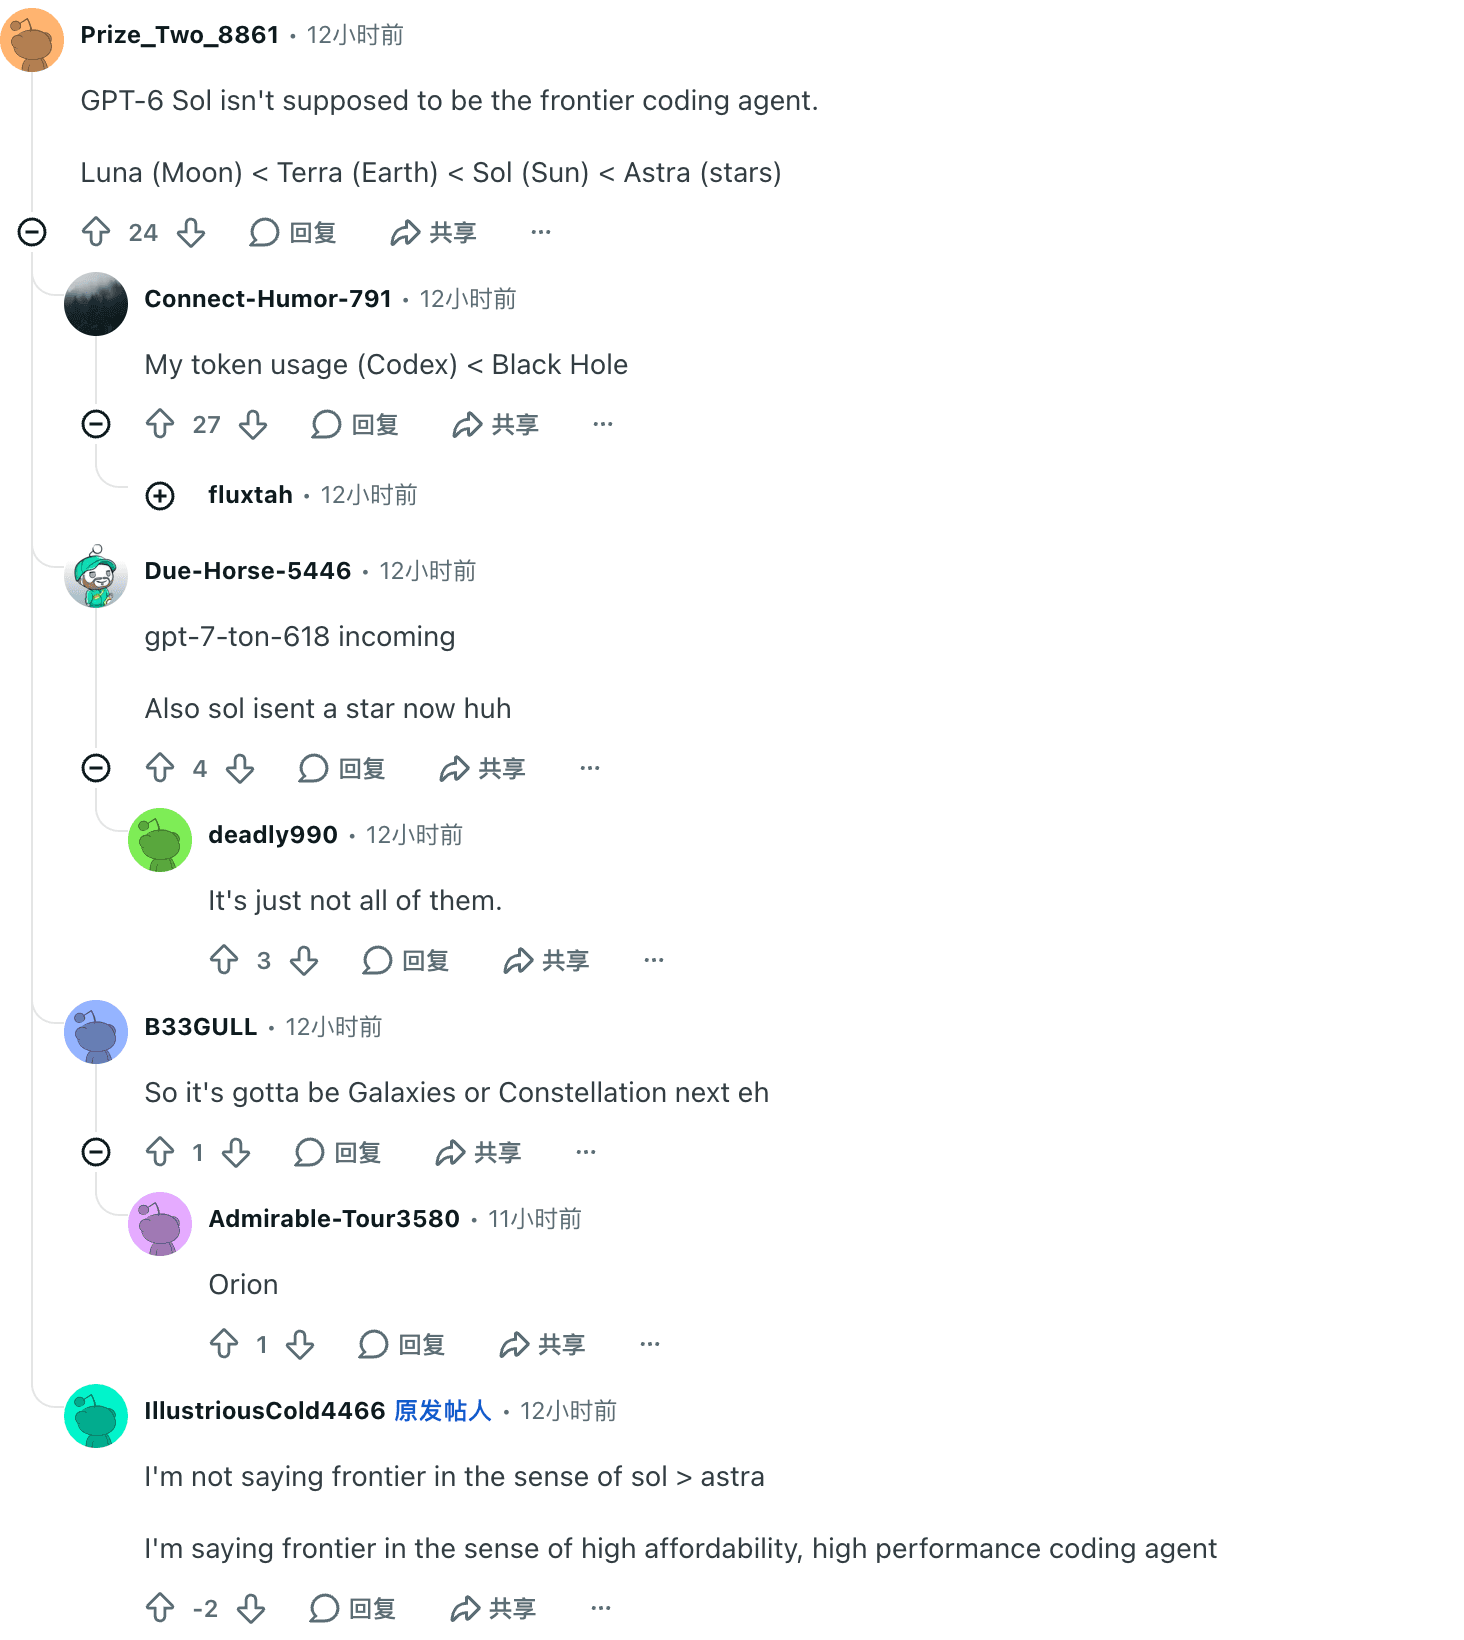

우리의 편집 판단: 두 진영은 같은 설계 선택을 정반대 워크로드에서 각각 기술하고 있습니다. 오답이 비싼 곳에서 Sol은 전 세대보다 똑똑해 보이고, 커버리지가 소중한 곳에서는 더 멍해 보입니다. 벤치마크는 '동급'이라 말하며, 두 진영 모두 자기 쪽 절반에 대해서는 옳습니다.
판정: 워크로드 형태로 고르기
| 당신의 워크로드 | 최선의 선택 | 이유 | 주의 |
|---|---|---|---|
| 대량 정기 자동화, 예산 민감한 에이전트 루프 | GPT-6 Sol(xhigh) | AutomationBench에서 Opus 5 (max)를 태스크당 비용 9%로 이김. xhigh에서 약 $0.53/태스크 | 컨텍스트를 272K 과금 절벽 아래로. 캐시 창은 30분 |
| 일상 코딩과 코드 리뷰의 '제2 의견' | GPT-6 Sol(high–max) | FrontierCode는 Fable 5.1 xhigh와 동급이며 훨씬 싸다. 환각 섞인 지적을 걸러냄 | 기권용 폴백 경로 마련. 인용은 검증 |
| 30분 넘는 끈질긴 셀프 디버깅, 장시간 자율 | GPT-6 Astra | 프리미엄이 사는 것은 끈기. Astra 총람과 Astra 리뷰 참고 | 태스크당 비용 3배 이상. 고 effort에서 첫 토큰 지연 |
| 전문 지식 노동: 법률, 금융, 깊은 분석 | Claude Opus 5.5 | Sol은 GDPval에서 약 100 Elo 하락. Opus는 II 58로 선두 | 태스크당 비용 최고 수준. max에서 장황 |
| ChatGPT 쪽 일상 채팅 | 당분간 5.6 유지(무료는 Luna, Plus는 5.6 Sol) | Sol은 아직 Chat에 없음. 6세대 쿼터 소모는 현실 | 남는다면 프로모 가격과 1M 컨텍스트 설정 주의가 계속 적용 |
| 실시간 브라우저 탭을 가로지르는 리서치와 자동화 | Tabbit + Sol(선택기에 나타날 때) | 모델이 당신의 탭과 파일 바로 옆에서 실행됨. 아래 참조 | 가용성은 계정의 모델 선택기에 따름 |
한 줄 판정: 자동화와 코딩 예산은 GPT-6 Sol로 옮기세요. 지식 노동의 상한선과 무인 장시간 에이전트는 옮기지 마세요. OpenAI에서 지금까지 사 온 같은 등급의 지능을, 표시 가격 절반에, 새로운 성격까지 얹어 살 수 있습니다. 질문에 답하지 않고 남겨두는 편을 택할지언정 틀리게 답하고 싶지 않은 유형입니다. 딱 그 직무 기술서대로 고용하세요. 예산을 확정하기 전에 작은 글씨도 하나. '50% 더 싸다'의 비교 대상인 GPT-5.6 기준 가격은 최소 2026년 11월 21일까지의 프로모 가격입니다.
GPT-6 Sol을 당신의 일이 사는 곳에서 돌리기: Tabbit
스코어시트는 브라우저 워크플로가 아닙니다. 진짜 일. 리서치, 비교, 추출, 리뷰는 열려 있는 스무 개의 탭, 로컬 파일, 웹 앱에 흩어져 있고, 날것의 API 호출은 그 어느 것도 보지 못합니다. Sol을 손으로 물려는 것은 페이지 내용을 프롬프트에 복사하고, 컨텍스트 창을 직접 관리하고, 배관을 매번 다시 짜는 것을 의미합니다.
바로 여기서 Tabbit 브라우저가 모델 리뷰 안에 한 절을 가질 가치가 생깁니다. Tabbit은 에이전트형 AI 브라우저로, 모델 워크플로를 브라우징 컨텍스트 위에서 직접 실행합니다. 탭을 가로지르는 리서치, 에이전트형 추론과 딥 리서치 작업, 실시간 페이지에 걸친 자동화. 계정의 모델 선택기에 GPT-6 Sol이 나타나면 오케스트레이터 코드 없이 그 워크플로를 Sol로 향하게 할 수 있고, 태스크별로 더 싸거나 더 강한 모델로 갈아탈 수 있습니다. 반 값에 동급 지능인 모델이 가장 보상하는 규율이 바로 그것입니다.
정직한 경계 두 개. Tabbit 안의 모델 가용성은 연결 계정과 플랜에 따릅니다. Sol 중심으로 워크플로를 짜기 전에 선택기를 확인하세요. 그리고 클라이언트는 OpenAI 과금을 바꾸지 않습니다. $2/$10 카드는 어느 쪽이든 같은 카드입니다. 이 모델이 실무에서 어떻게 쓰이는지 보려면 GPT-6 Sol 모델 페이지 (English), 프롬프트 디렉터리 (English), 커뮤니티 리뷰 증거 베이스 (English)를 둘러보세요.
벤치마크가 아니라 당신의 탭 위에서 GPT-6 Sol을 돌릴 준비가 됐나요?
 Tabbit Browser

자주 묻는 질문
GPT-6 Sol이 GPT-5.6 Sol보다 나은가요?
독립 측정 기준으로는 지능이 거의 동등합니다. Artificial Analysis는 GPT-6 Sol (max)의 Intelligence Index를 48로 평가하며 GPT-5.6 Sol과 동급, 태스크당 비용은 절반($1.06 대 $1.99)이라고 밝혔습니다. GPT-6 Sol은 AA-Omniscience에서 환각률을 92%에서 60%로 낮췄지만, 이는 질문의 83%만 시도하는 방식(이전 세대는 99%)으로 달성됐습니다. 이 트레이드가 유리한지는 오답과 무응답 중 무엇이 더 큰 비용을 만드는지에 달려 있습니다.
GPT-6 Sol은 왜 거절하거나 건너뛰는 질문이 더 많아졌나요?
Artificial Analysis는 환각률 개선을 포기(기권)에 돌립니다. GPT-6 Sol (max)은 AA-Omniscience 질문의 83%만 시도하고(GPT-5.6 Sol은 99%), 오답은 줄지만 시도한 질문에 대한 정확도는 59%에서 54%로 떨어졌습니다. 에이전트 파이프라인에서 기권은 보통 막힌 태스크나 사람에게 넘기는 에스컬레이션으로 나타나므로, 거절을 실패로 처리하지 말고 폴백 경로를 마련해 두는 것이 좋습니다.
GPT-6 Sol은 태스크당 얼마인가요?
Artificial Analysis Intelligence Index 기준으로 GPT-6 Sol은 최대 노력(max)에서 태스크당 약 $1.06입니다. 같은 $2/$10 요금표에서 effort를 low부터 max까지 옮기면 약 $0.13~$1.06의 사다리가 형성되며, effort 선택만으로 비용이 약 8배 움직입니다. 전체 요금표, 캐시 규칙, 272K 장문 컨텍스트 기준값은 GPT-6 Sol 요금 가이드에 정리돼 있습니다.
GPT-6 Sol과 GPT-6 Astra 중 무엇을 써야 하나요?
비용 민감도가 높은 대량 코딩·자동화에는 GPT-6 Sol, 장시간 자율 실행에서 끈기가 필요한 경우에는 GPT-6 Astra가 맞습니다. Sol의 AA Intelligence Index는 48, Astra는 53이지만 Sol의 태스크당 비용은 Astra의 약 3분의 1입니다. 두 모델 모두 272K 장문 과금 기준값을 공유합니다. Astra 프리미엄이 정당화되는 시점은 GPT-6 Astra 리뷰를 참고하세요.
GPT-6 Sol은 ChatGPT에서 쓸 수 있나요?
아직 Chat에는 없습니다. 출시 시점에 GPT-6 Sol은 Plus, Pro, Business, Enterprise, Edu 플랜 대상 ChatGPT Work와 Codex에서 사용할 수 있고, Free·Go 사용자는 데스크톱 앱에서 GPT-6 Luna를 받습니다. OpenAI는 Chat 배포가 점진적으로 이뤄진다고 설명하며, API 모델 ID는 gpt-6-sol입니다. 워크플로를 걸기 전에 자신의 플랜 모델 선택기에서 먼저 확인하세요.
Tabbit 브라우저에서 GPT-6 Sol을 쓸 수 있나요?
Tabbit 브라우저는 열려 있는 탭, 로컬 파일, 실시간 웹 세션을 아우르는 멀티모델 워크플로를 지원하며, 계정이나 API 접근에 GPT-6 Sol이 포함되어 있으면 모델 선택기에 나타납니다. 가용성은 계정에 따라 다르며, 클라이언트를 사용해도 OpenAI 과금은 변하지 않습니다. 다운로드 전에 GPT-6 Sol 프롬프트 디렉터리에서 태스크 레시피를 살펴볼 수 있습니다.