
Si votre charge de travail, c'est du codage à haut volume, de l'automatisation ou des boucles d'agents où le coût par tâche décide du budget, GPT-6 Sol mérite le passage. Si vous cherchez le plafond le plus haut en travail de connaissance ou un agent qui n'abandonne jamais une tâche, restez où vous êtes. La grille à moitié prix est réelle : 2 $ par million de tokens d'entrée et 10 $ par million de sortie, soit la moitié des tarifs promotionnels de GPT-5.6 Sol, vérifiée sur la fiche du modèle d'OpenAI le 23 septembre 2026. Mais la partie intéressante de ce test n'est pas le prix : c'est la manière dont le modèle est devenu plus précis. Artificial Analysis a mesuré son taux d'hallucinations en baisse de 92 % à 60 %, pendant que la part de questions tentées reculait de 99 % à 83 %. En un sens très précis, le nouveau Sol est un modèle qui répond moins.
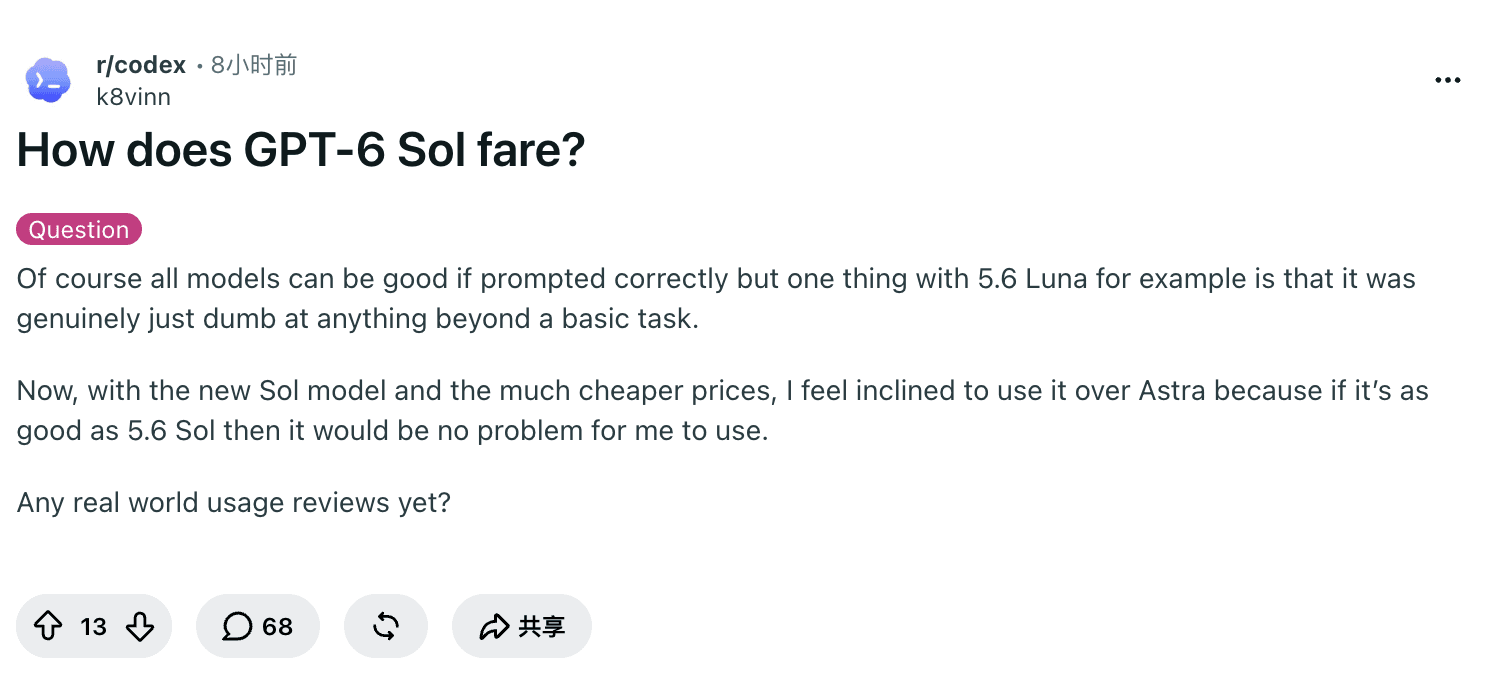
C'est exactement cet échange qui divise la communauté depuis le lancement. Quatre heures après la sortie, u/k8vinn a ouvert un fil sur r/codex avec la question que ce test se propose de trancher : "Now, with the new Sol model and the much cheaper prices, I feel inclined to use it over Astra... Any real world usage reviews yet?" (« Avec le nouveau Sol et des prix bien plus bas, je suis tenté de le préférer à Astra… Des retours d'usage réel ? ») (Reddit)
Nous avons décortiqué séparément la grille tarifaire de GPT-6 Sol, et notre comparaison entre GPT-6 Sol et Claude Opus 5.5 traite du choix entre les deux. Le lancement jumeau a son propre test de GPT-6 Astra. Ce billet, c'est le verdict sur le modèle : où GPT-6 Sol s'améliore vraiment, où il mord, et quelles charges de travail doivent basculer, rester ou passer leur chemin. Si vous voulez faire tourner le modèle sur des pages web réelles plutôt que sur des harnais de test, une voie à niveau navigateur arrive en fin d'article.
À retenir
L'intelligence est à niveau ; le prix, à moitié. Artificial Analysis place GPT-6 Sol (max) à 48 sur son Intelligence Index — au niveau de GPT-5.6 Sol — à 1,06 $ par tâche contre 1,99 $, sur une grille passée de 4 $/20 $ à 2 $/10 $ par million de tokens.
Le gain de précision est un pari d'abstention. Le taux d'hallucinations sur AA-Omniscience est tombé de 92 % à 60 % parce que Sol tente 83 % des questions contre 99 % pour 5.6 Sol ; la précision sur les questions tentées glisse de 59 % à 54 %.
L'efficacité en tokens est l'amélioration discrète. Sol (max) a généré 77 M de tokens sur la suite d'AA contre une médiane de 88 M, et les praticiens rapportent des tâches Codex qui entament à peine les quotas hebdomadaires.
Ce n'est pas une amélioration pour le travail de connaissance. Sol a perdu environ 100 points Elo sur GDPval-AA v2.1, et ses 48 d'II restent sous GPT-6 Astra (53) et Claude Opus 5.5 (58).
La réalité de la plateforme compte cette semaine. Sol est dans ChatGPT Work et Codex mais pas dans Chat ; des abonnés rapportent des quotas Plus partis en fumée sur la génération 6 ; les équipes API sur Chat Completions perdent le function calling au-dessus de
reasoning_effort: none.
Le chiffre qui décide de ce test : la précision en répondant moins
Les benchmarks sont arrivés en haussant les épaules face à GPT-6 Sol : la note de lancement d'Artificial Analysis indique que « les scores d'Intelligence Index et de Coding Agent Index restent au niveau de GPT-5.6, avec des progrès sur certaines évaluations et des reculs sur d'autres ». Deux lignes plus loin, le même texte lâche le chiffre qui change réellement le comportement : sur AA-Omniscience, son benchmark de connaissance et d'hallucinations, GPT-6 Sol (max) ramène son taux d'hallucinations de 92 % à 60 %, en ne tentant que 83 % des questions contre 99 % pour GPT-5.6 Sol (max) — soit environ un quart de réponses erronées en moins, mais une précision sur les questions tentées qui glisse de 59 % à 54 % (Artificial Analysis, consulté le 23 septembre 2026).
Traduit en langage d'ingénieur : OpenAI a échangé de la couverture contre de la correction. Le modèle lève la main moins souvent, et quand il la lève, il est légèrement moins précis par réponse que son prédécesseur — mais le volume total de fausses réponses assurées s'effondre. L'évaluation de factualité d'OpenAI raconte une histoire compatible : sur des conversations réelles où des utilisateurs avaient signalé des erreurs, « GPT-6 Sol fait environ deux fois moins d'erreurs que son prédécesseur, s'approchant de la fiabilité d'Astra » (annonce). Notez les garde-fous qu'OpenAI attache lui-même : ces conversations ont été sélectionnées parce qu'elles induisaient des erreurs, donc elles ne représentent pas un usage typique, et les scores ne sont pas contrôlés pour la longueur.
Chaque jugement de ce test se trie selon une même question : votre coût est-il dominé par les réponses erronées ou par les réponses manquantes ? Si l'erreur coûte cher — revue de code, conformité, extraction qui alimente d'autres systèmes — l'échange d'abstention est une vraie amélioration. Si la couverture est le travail — pipelines d'agents où un refus signifie une tâche bloquée et une page jamais terminée — le même design apparaît comme une régression. Gardez cet axe en tête : il revient au verdict.
Les benchmarks, et le crédit qu'il faut leur accorder
Tous les chiffres indépendants ci-dessous proviennent d'une seule capture d'Artificial Analysis datée du 23 septembre 2026, avec les niveaux d'effort nommés — car c'est sur l'effort que les comparaisons de semaine de lancement trichent en silence. Les lignes de prix viennent de la fiche du modèle d'OpenAI et de notre guide tarifaire du même jour.
| Dimension | GPT-6 Sol (max) | GPT-5.6 Sol (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max avec fallback) | Ce que ça signifie |
|---|---|---|---|---|---|
| Prix API, entrée / sortie par 1 M | 2 $ / 10 $ | 4 $ / 20 $ (promo jusqu'au 21 nov.) | 10 $ / 50 $ | 4 $ / 20 $ | Sol égale le tarif d'entrée d'Opus 5.5 avec la moitié de sa sortie. |
| AA Intelligence Index | 48 | au niveau de Sol | 53 | 58 | Vous achetez le même étage d'intelligence moins cher, pas plus d'intelligence. |
| Coût AA par tâche (II) | 1,06 $ | 1,99 $ | 3,26 $ | 5,98 $ | La moitié de 5.6 Sol, un tiers d'Astra, ~18 % d'Opus 5.5 à réglages max. |
| Taux d'hallucinations, AA-Omniscience | 60 % | 92 % | non rapporté | non rapporté | La victoire de précision du titre. |
| Taux de tentative, même benchmark | 83 % | 99 % | — | — | …et l'attrape : il répond moins. |
| GDPval-AA v2.1 (travail de connaissance) | ~100 Elo sous la frontière | non rapporté | non rapporté | 1846 Elo (rapporté par Anthropic) | N'embauchez pas Sol pour du travail de connaissance expert. |
| Vitesse de sortie (médiane AA) | 131 tok/s | non rapporté | 58 tok/s | non rapporté | Milieu de peloton : plus rapide qu'Astra ou Fable 5.1, bien plus lent que les modèles Flash. |
| Contexte / sortie max | 1,05 M / 128 K | 1 M / 32 K | 1,05 M / 128 K | 1 M / 128 K | Specs des fiches du fournisseur ; le seuil de facturation de 272 K s'applique à toute la famille. |
Avant de croire la moindre ligne, trois seaux d'eau froide :
Les scores du fournisseur tournent sur ses propres harnais. Les benchmarks de lancement d'OpenAI — AutomationBench, Agents' Last Exam (Sol max 56,4 %, au-dessus du meilleur Opus 5 pour 60 % de coût en moins), DeepSWE (68,8 % contre 69,9 % pour Fable 5 à ~80 % de coût en moins), OSWorld 2.0 offline (60,5 % ≈ 60,3 % d'Opus 5 medium à ~80 % de coût en moins) — sont tous auto-rapportés, et la note de bas de page de l'annonce concède que les évaluations ont tourné dans un environnement de recherche ou une API qui « peut donner une sortie légèrement différente du ChatGPT de production », avec des scores concurrents tirés de rapports publics. Utile comme boussole, pas comme évangile.
Les valeurs de l'indice dérivent. Notre test de GPT-6 Astra, écrit la veille, citait des valeurs de l'Intelligence Index d'AA de 61,2 pour Astra et 60,9 pour 5.6 Sol ; le même traqueur liste aujourd'hui Astra à 53 et Sol à 48. Artificial Analysis versionne et recalcule son indice : comparez les modèles au sein d'une même capture, jamais d'une semaine à l'autre.
Le décalage d'effort est le code de triche de la semaine de lancement. Les chiffres publiés de Sol sont presque tous en effort maximum ; les gros titres d'Opus 5.5 sont souvent son mode medium par défaut. Tout « Sol gagne/perd » qui ne nomme pas les deux réglages relève du marketing. Notre comparatif fait cette maths en coûts alignés.
Ici, les benchmarks sont une boussole, pas un mètre. Ce qui pèse davantage à cette heure, c'est ce que rapportent ceux qui mesurent des tâches réelles — et les 24 premières heures ont livré un ensemble étonnamment cohérent.
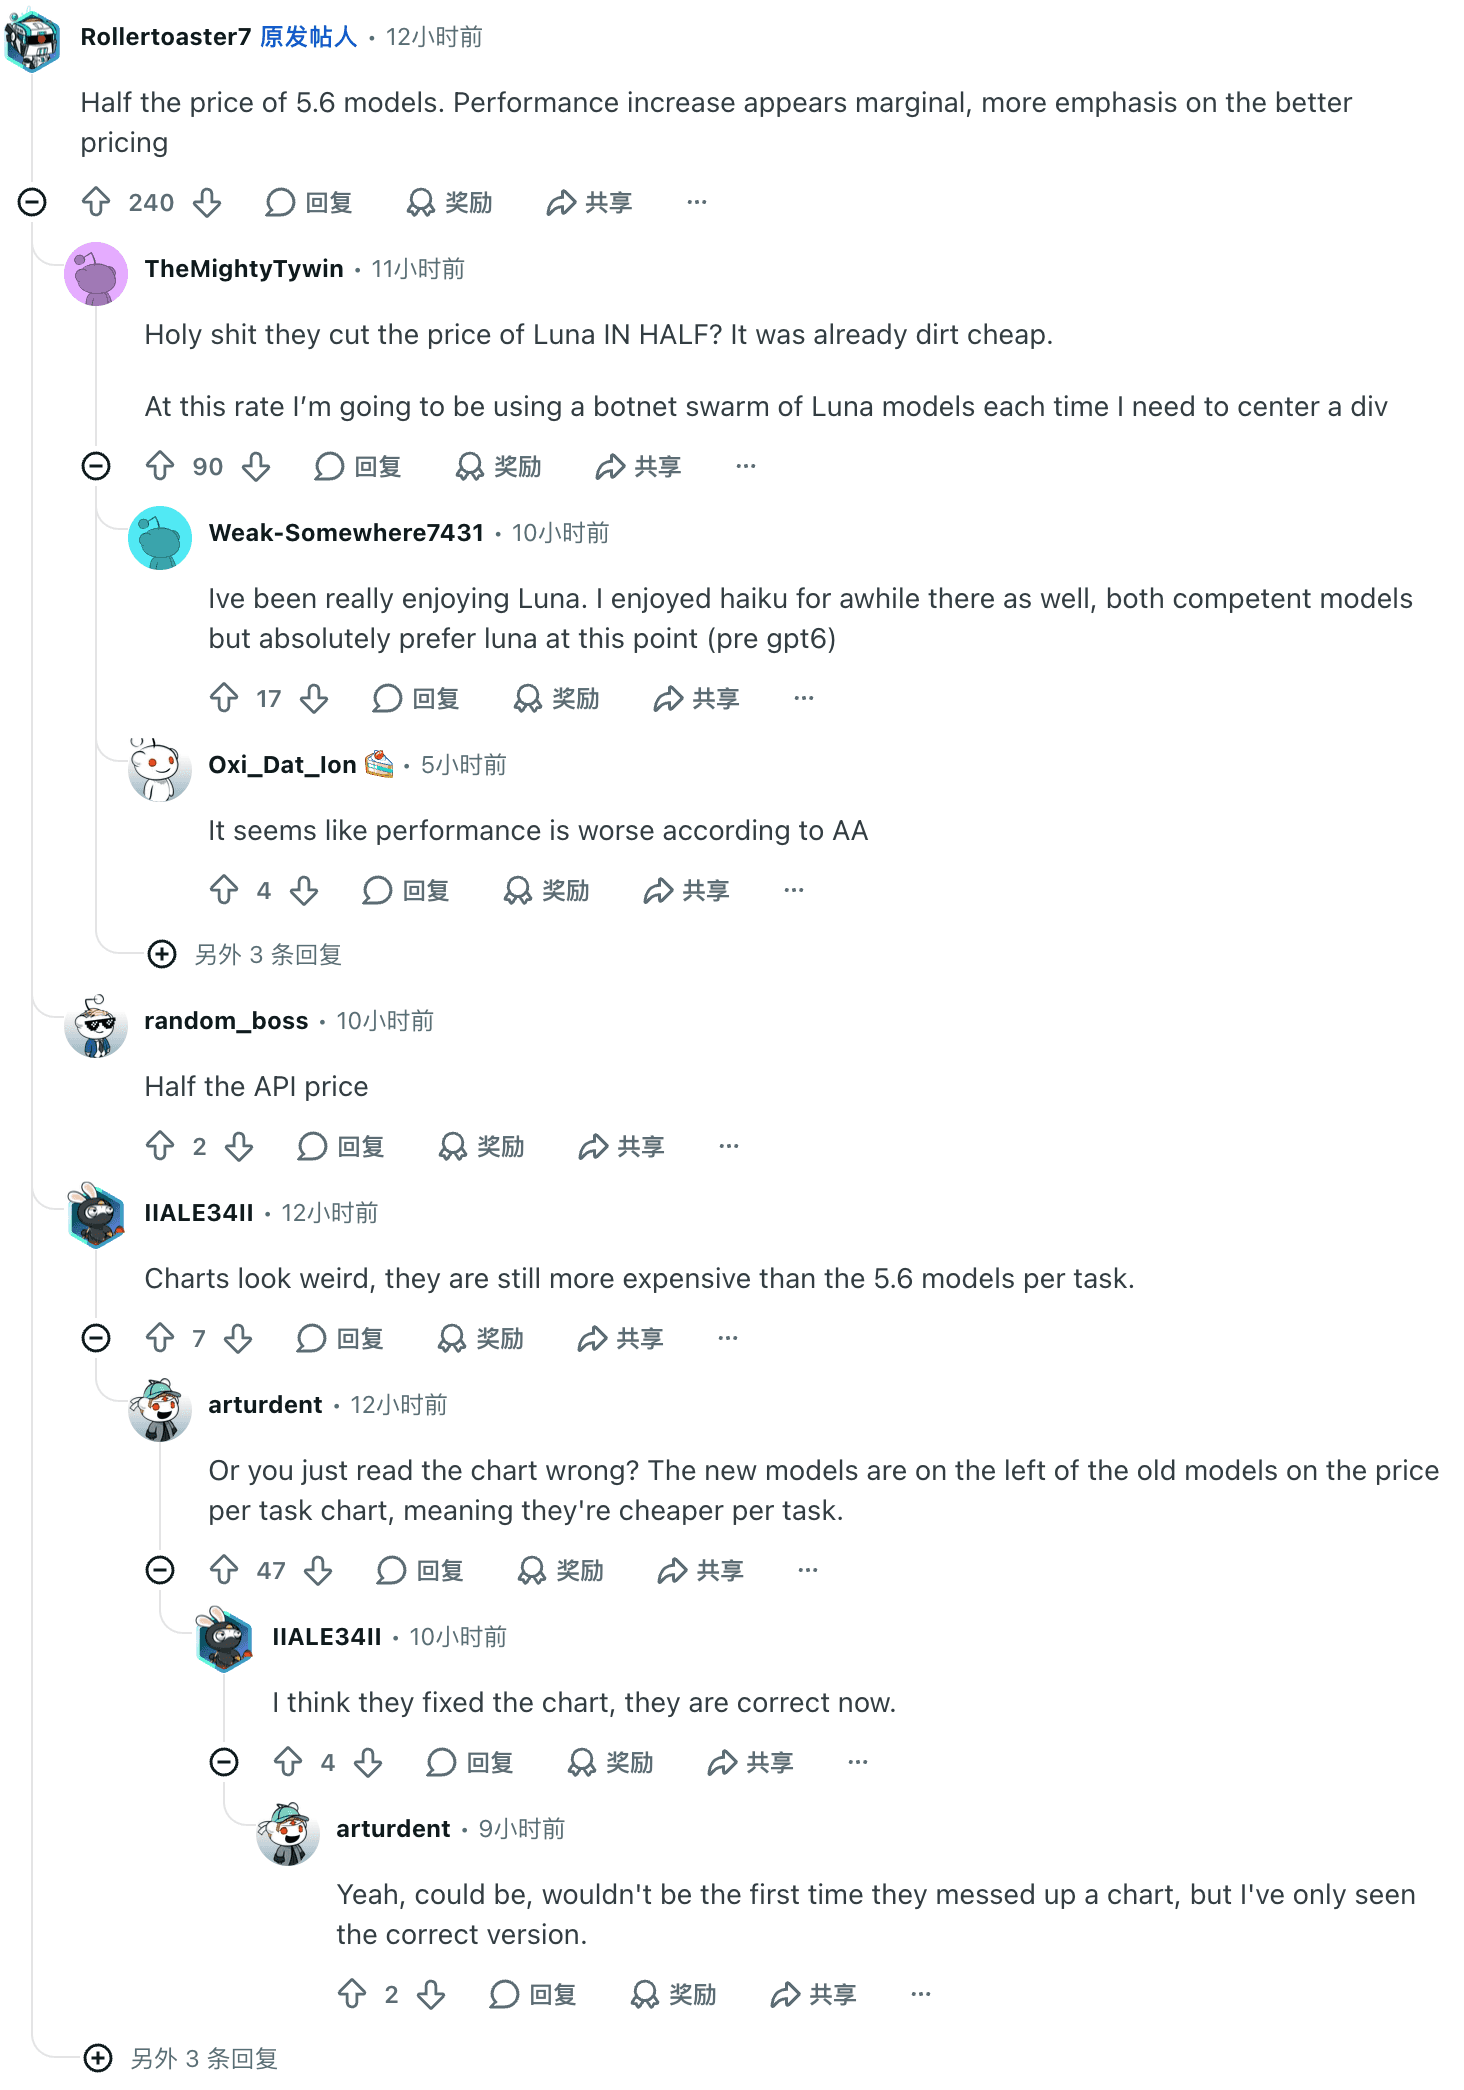
La lecture « prix divisé par deux, progrès marginaux » est devenue le commentaire le plus voté du fil de lancement de r/codex en quelques heures : u/Rollertoaster7, l'auteur du fil, a récolté 240 points avec « Half the price of 5.6 models. Performance increase appears marginal, more emphasis on the better pricing » (« La moitié du prix des modèles 5.6. L'amélioration de performance paraît marginale, l'accent est mis sur le meilleur tarif »), tandis qu'un autre utilisateur citait directement les résultats en demi-teinte d'AA (Reddit). Vals AI, évaluateur indépendant, a rejoint le même plateau depuis son propre banc : « GPT-6 Sol… se classe #8 au Vals Index, approximativement au niveau de GPT 5.6 Sol pour la moitié du coût » (X).
Là où GPT-6 Sol est réellement bon
1. La factualité : moins de fausses réponses assurées
Le mécanisme d'abstention n'est pas qu'un artefact de benchmark : dans des pipelines réels, il prend la forme d'un modèle qui pousse en arrière au lieu d'empiler. Un commentateur de Hacker News a raconté avoir utilisé Sol comme seconde opinion sur la revue de code d'un autre modèle : « i used it for code review and it flagged twenty issues, sol checked the review and found 75% of them were hallucinations. sol was much closer to reality. » (« Je l'ai utilisé pour une revue de code : l'autre signalait vingt problèmes ; Sol a relu et a trouvé que 75 % étaient des hallucinations. Sol était bien plus proche de la réalité. ») (HN). Une anecdote ne prouve aucun taux, mais elle rime exactement avec la mesure d'AA et le « deux fois moins d'erreurs » d'OpenAI, depuis trois directions indépendantes. Si votre charge punit les erreurs — revue, extraction, conformité — c'est l'amélioration qui compte plus que n'importe quel point d'indice.
2. L'efficacité en tokens : la réduction silencieuse de la facture
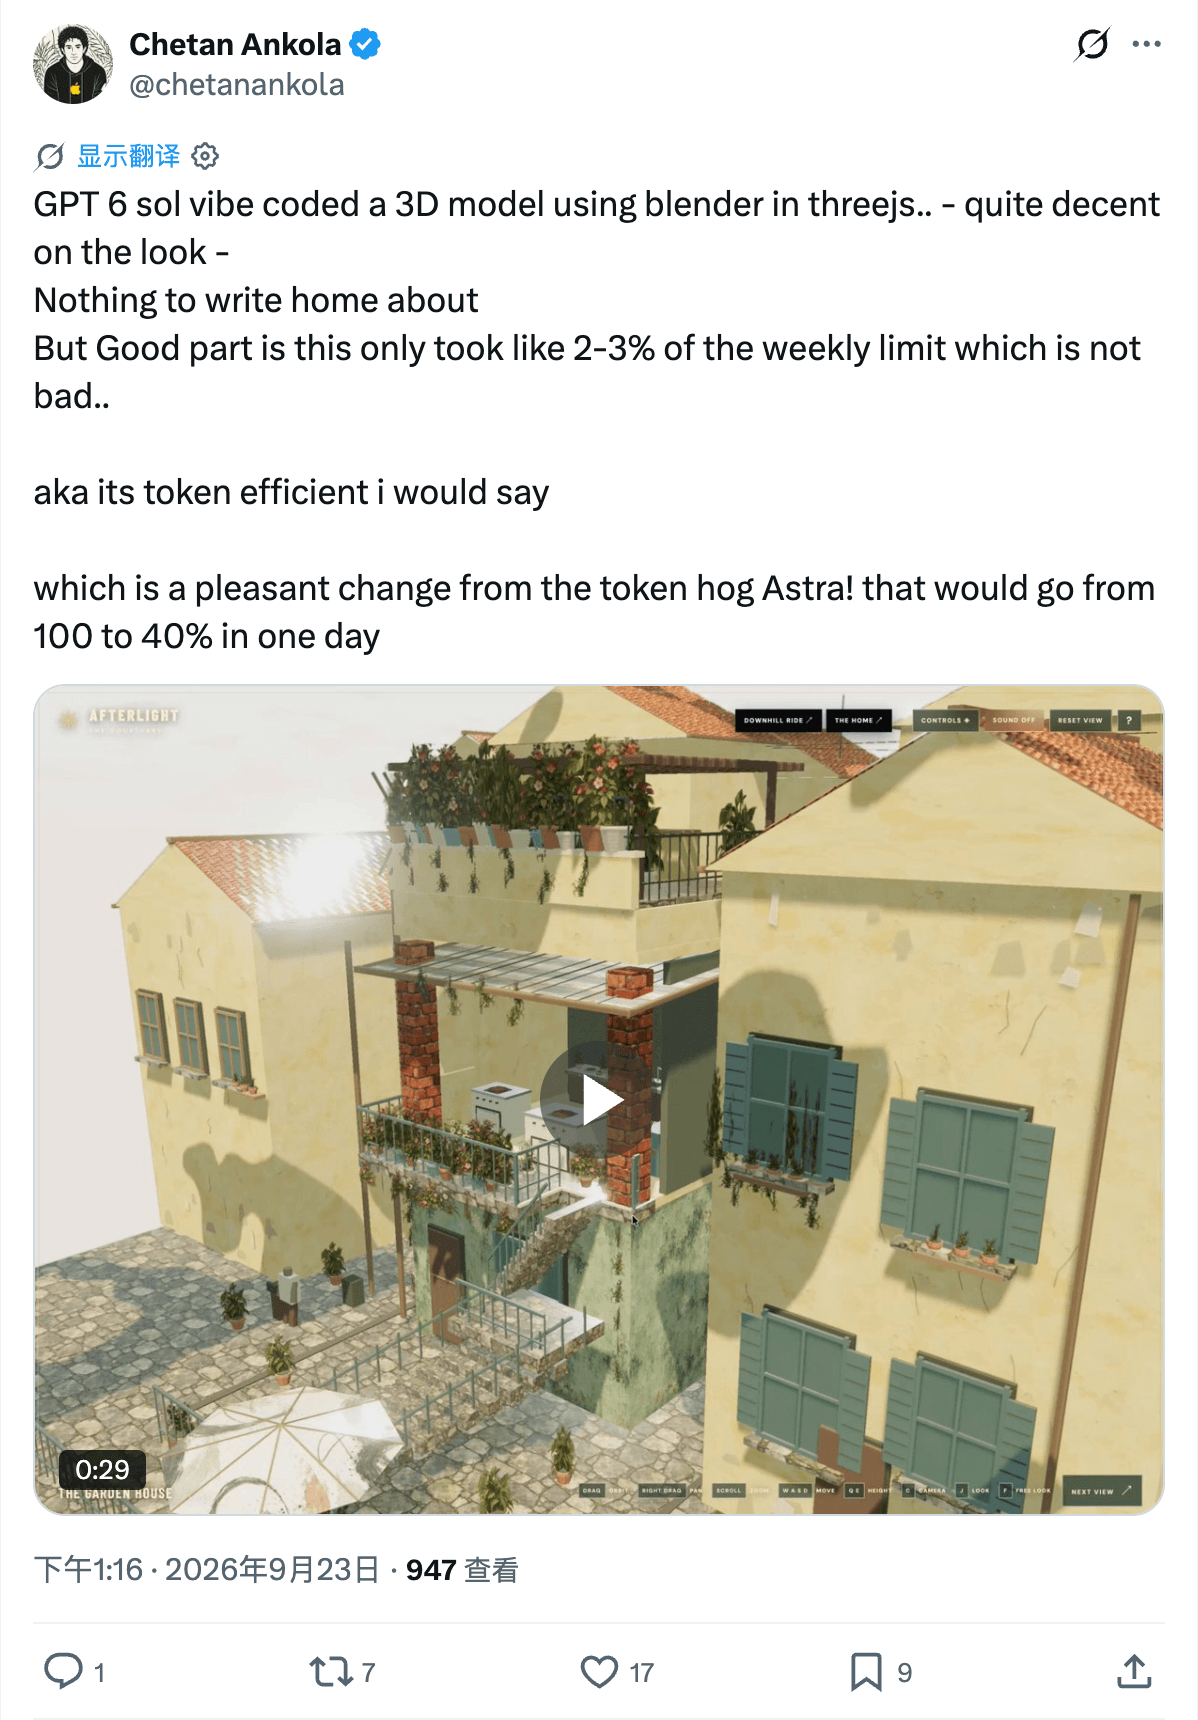
Les modèles de raisonnement facturent deux fois : la réponse, et la réflexion. Le volume de génération de Sol sur la suite d'AA a été de 77 M de tokens contre une médiane de 88 M, et les praticiens ont remarqué la même maigreur sur les abonnements : r/codex plaisantait avec « mon usage de tokens sur Codex < un trou noir », et sur X un développeur a mesuré une tâche Blender/Three.js à « comme 2-3 % de la limite hebdomadaire… je dirais qu'il est efficace en tokens, un changement agréable après le gouffre à tokens Astra, qui passe de 100 à 40 % en une journée » (X). Ajoutez la grille tarifaire, et voilà pourquoi l'affirmation d'OpenAI — Sol(xhigh) bat Opus 5 (max) sur AutomationBench pour 9 % de son coût par tâche — est au moins plausible : moins de tokens, moins chers, sur un travail en forme d'automatisation.
3. L'écriture et le style de collaboration
OpenAI affirme que le style de communication amélioré d'Astra — « plus de clarté, moins de jargon » — se transmet à Sol, et c'est la rare affirmation du fournisseur qu'un test à l'aveugle indépendant a rejointe en une journée : le banc à l'aveugle de How I AI retient « l'écriture claire, des PRD lisibles, et le prix » comme le terrain où Sol gagne encore (Lenny's Newsletter). Pour les équipes qui livrent des documents avec le code — cahiers des charges, PRD, synthèses de revue — c'est une amélioration de qualité quotidienne qu'aucune ligne de leaderboard ne capture.
Là où GPT-6 Sol mord
1. L'impôt d'abstention
Chaque force ci-dessus a son miroir. Un modèle qui tente 83 % des questions, placé dans un pipeline sans surveillance, est un modèle qui rend 17 % de cases vides — et chaque case vide est une tâche bloquée, un essai supplémentaire ou une escalade vers un humain. AA a aussi mesuré le coût par réponse : la précision sur les questions tentées est passée de 59 % à 54 %, et sur GDPval-AA v2.1, son benchmark de travail de connaissance à valeur économique, Sol a perdu environ 100 Elo face à ses pairs de frontière. Le plafond du travail de connaissance n'est tout simplement pas ce que ce modèle vise. Si votre pipeline ne tolère pas les refus, budgétez un modèle de secours dès le premier jour.
2. Une partie de la communauté le lit comme « Terra sous une nouvelle étiquette »
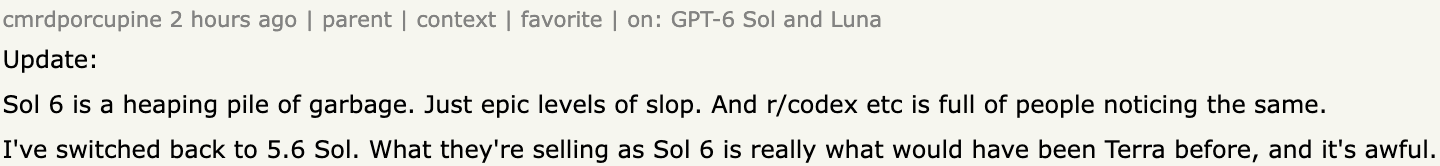
Les retours négatifs les plus tranchants convergent vers le même thème : c'est une re-tarification, pas une nouvelle génération. Un développeur de Hacker News qui est déjà revenu en arrière a écrit : « Update: Sol 6 is a heaping pile of garbage... I've switched back to 5.6 Sol. What they're selling as Sol 6 is really what would have been Terra before. » (« Mise à jour : Sol 6 est un tas d'ordures… Je suis revenu à 5.6 Sol. Ce qu'ils vendent comme Sol 6, c'est ce qui aurait été Terra avant. ») (HN). Sur r/codex, la même intuition : « Après l'avoir utilisé, il est vraiment plus bête. On dirait Terra. » Le point médian mesuré : l'indice est à niveau en moyenne, mais « des progrès sur certaines évaluations et des reculs sur d'autres » signifie que des charges individuelles peuvent tomber exactement sur la moitié qui recule. Si votre mix de prompts tombe sur une évaluation en recul, votre expérience contredira la moyenne — et les deux camps ont raison en même temps.
3. Les frictions de plateforme de la semaine de lancement
Trois frottements concrets refroidissent le passage cette semaine. D'abord, la disponibilité : Sol est dans ChatGPT Work et Codex pour les offres payantes, mais pas encore dans Chat, et les utilisateurs Free/Go ne reçoivent que GPT-6 Luna (annonce). Ensuite, l'économie de l'abonnement : un utilisateur Plus a rapporté « il a brûlé mon quota Plus en quelques minutes, alors qu'avec 5.6 je pouvais rouler des heures. Il tournait en rond des minutes sur un prompt basique puis abandonnait devant les limites d'usage » (HN) : même quand l'API baisse, les tokens de raisonnement brûlent le quota. Enfin, la surface API : sur l'ancien endpoint Chat Completions, le function calling ne fonctionne qu'à reasoning_effort: none — les flux avec outils appartiennent à l'API Responses — et le fine-tuning n'est pas pris en charge (fiche du modèle). Si vous restez sur 5.6 Sol pour son comportement d'usage, sachez que ses tarifs promotionnels durent au moins jusqu'au 21 novembre 2026, et notre guide de configuration du contexte 1M s'applique toujours.

Ce que les gens ont réellement dit
Vingt-quatre heures de signal communautaire se coupent proprement le long de l'axe de la section deux — pas selon le talent ni l'ancienneté.
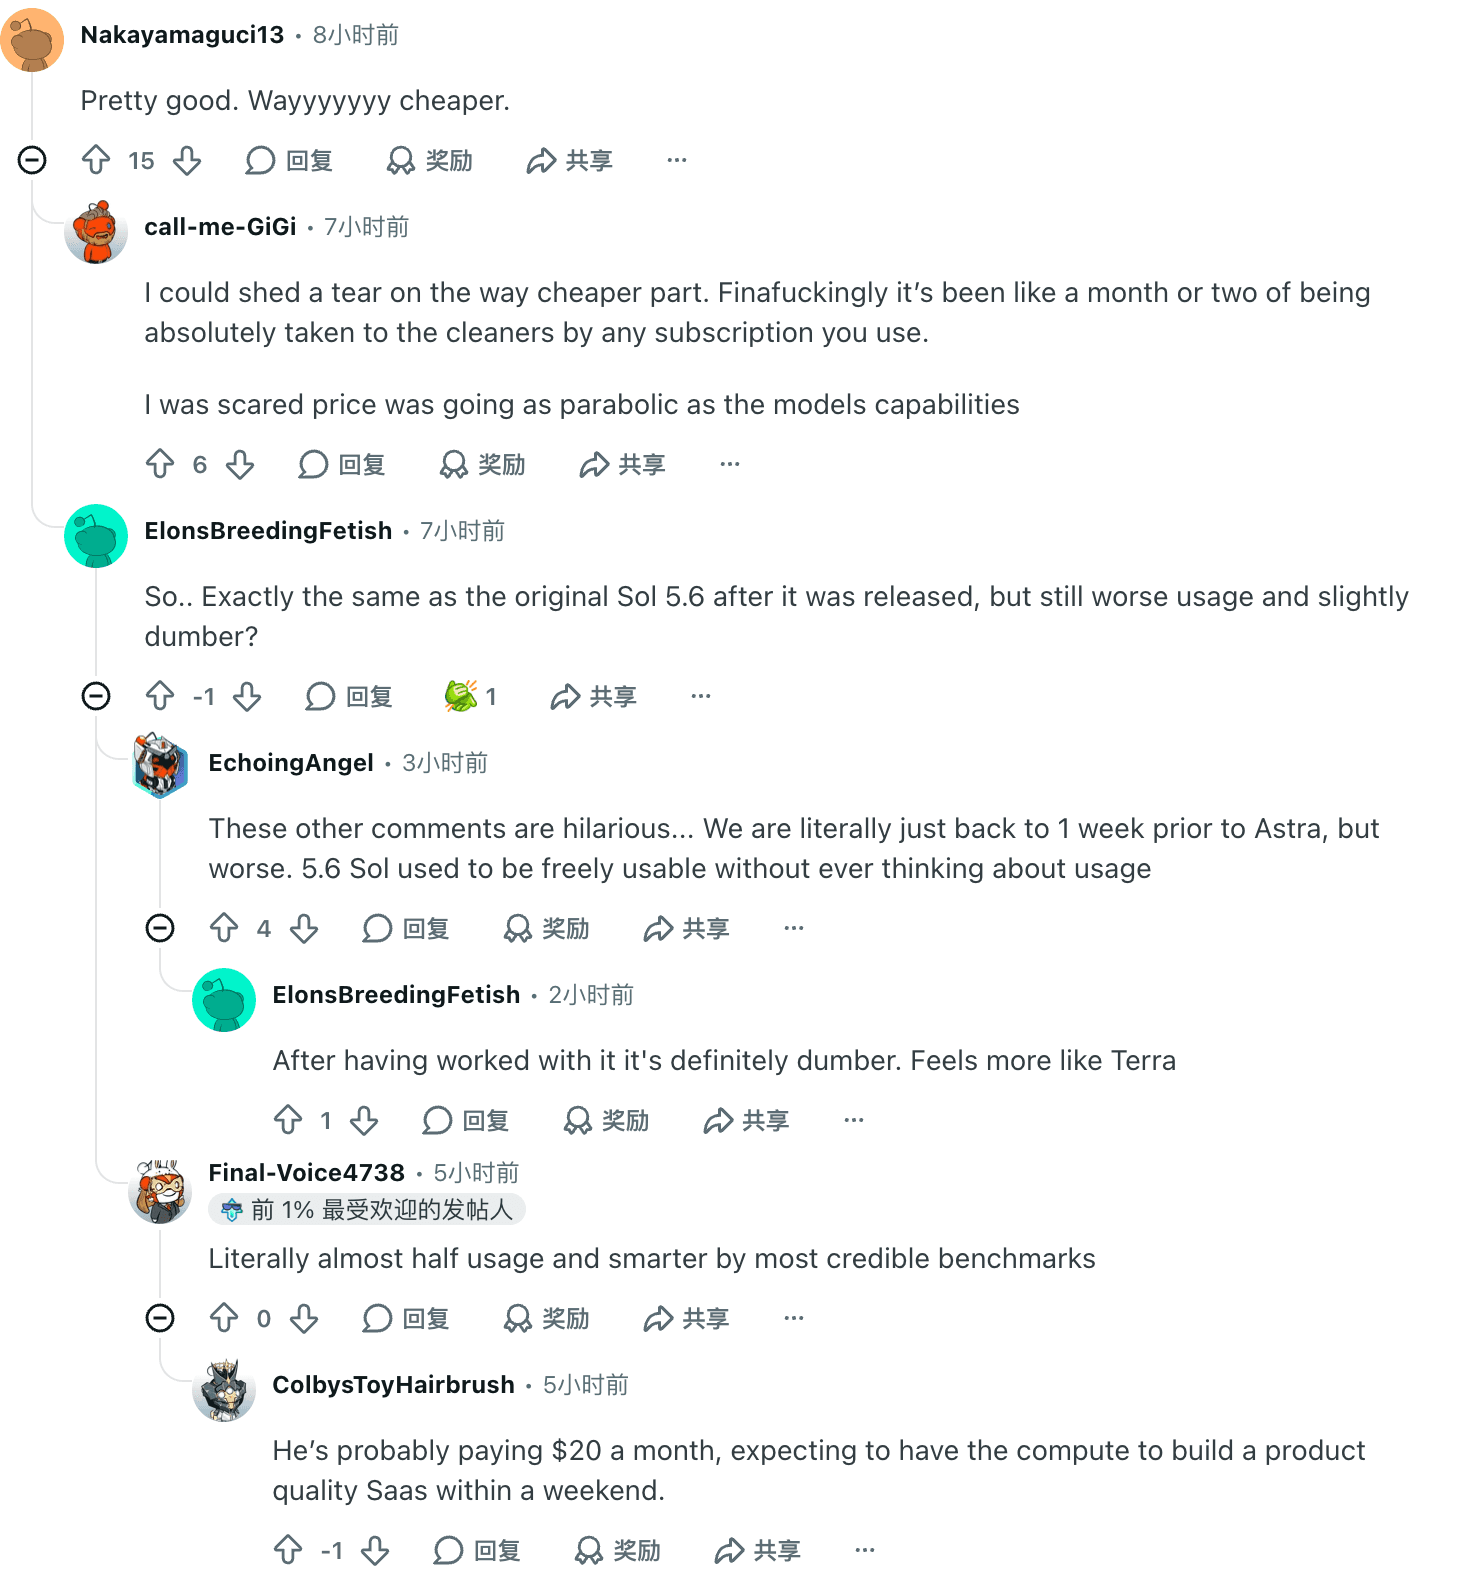
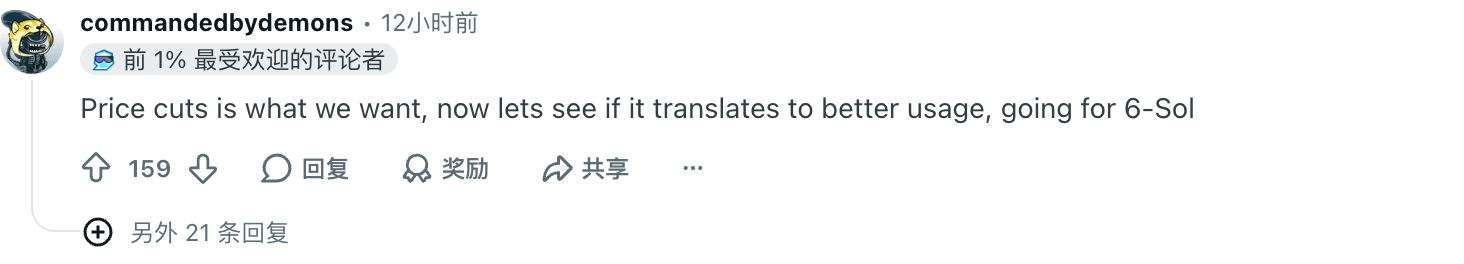
Camp un : « moitié prix, c'est l'amélioration ». « Pretty good. Wayyyyyyy cheaper. » (« Plutôt bien. Beuuuucoup moins cher. ») (u/Nakayamaguci13). « Literally almost half usage and smarter by most credible benchmarks » (« Littéralement presque moitié moins d'usage et plus intelligent sur la plupart des benchmarks crédibles ») (u/Final-Voice4738). La majorité attentiste a propulsé le fil de r/codex à 159 points : « Price cuts is what we want, now lets see if it translates to better usage, going for 6-Sol » (« Les baisses de prix, c'est ce qu'on voulait ; on verra si ça se traduit en meilleur usage, je pars sur le 6-Sol ») (u/commandedbydemons).
Camp deux : « c'est une re-tarification, pas un successeur ». « Il est vraiment plus bête. On dirait Terra. » (u/ElonsBreedingFetish). « Selon AA, la performance est pire. » (u/Oxi_Dat_Ion). Le retour en arrière de cmrdporcupine, cité plus haut, est la déclaration la plus lourde du camp.
Le centre détient la vraie information. u/mchusma sur Hacker News a nommé la comparaison à laquelle la plupart des équipes font face : « I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability. » (« Personnellement je préfère Opus 5.5 en medium à GPT-6 Sol en Max, sur des tests très très préliminaires. Gamme de prix proche, plus de capacité. ») (HN).
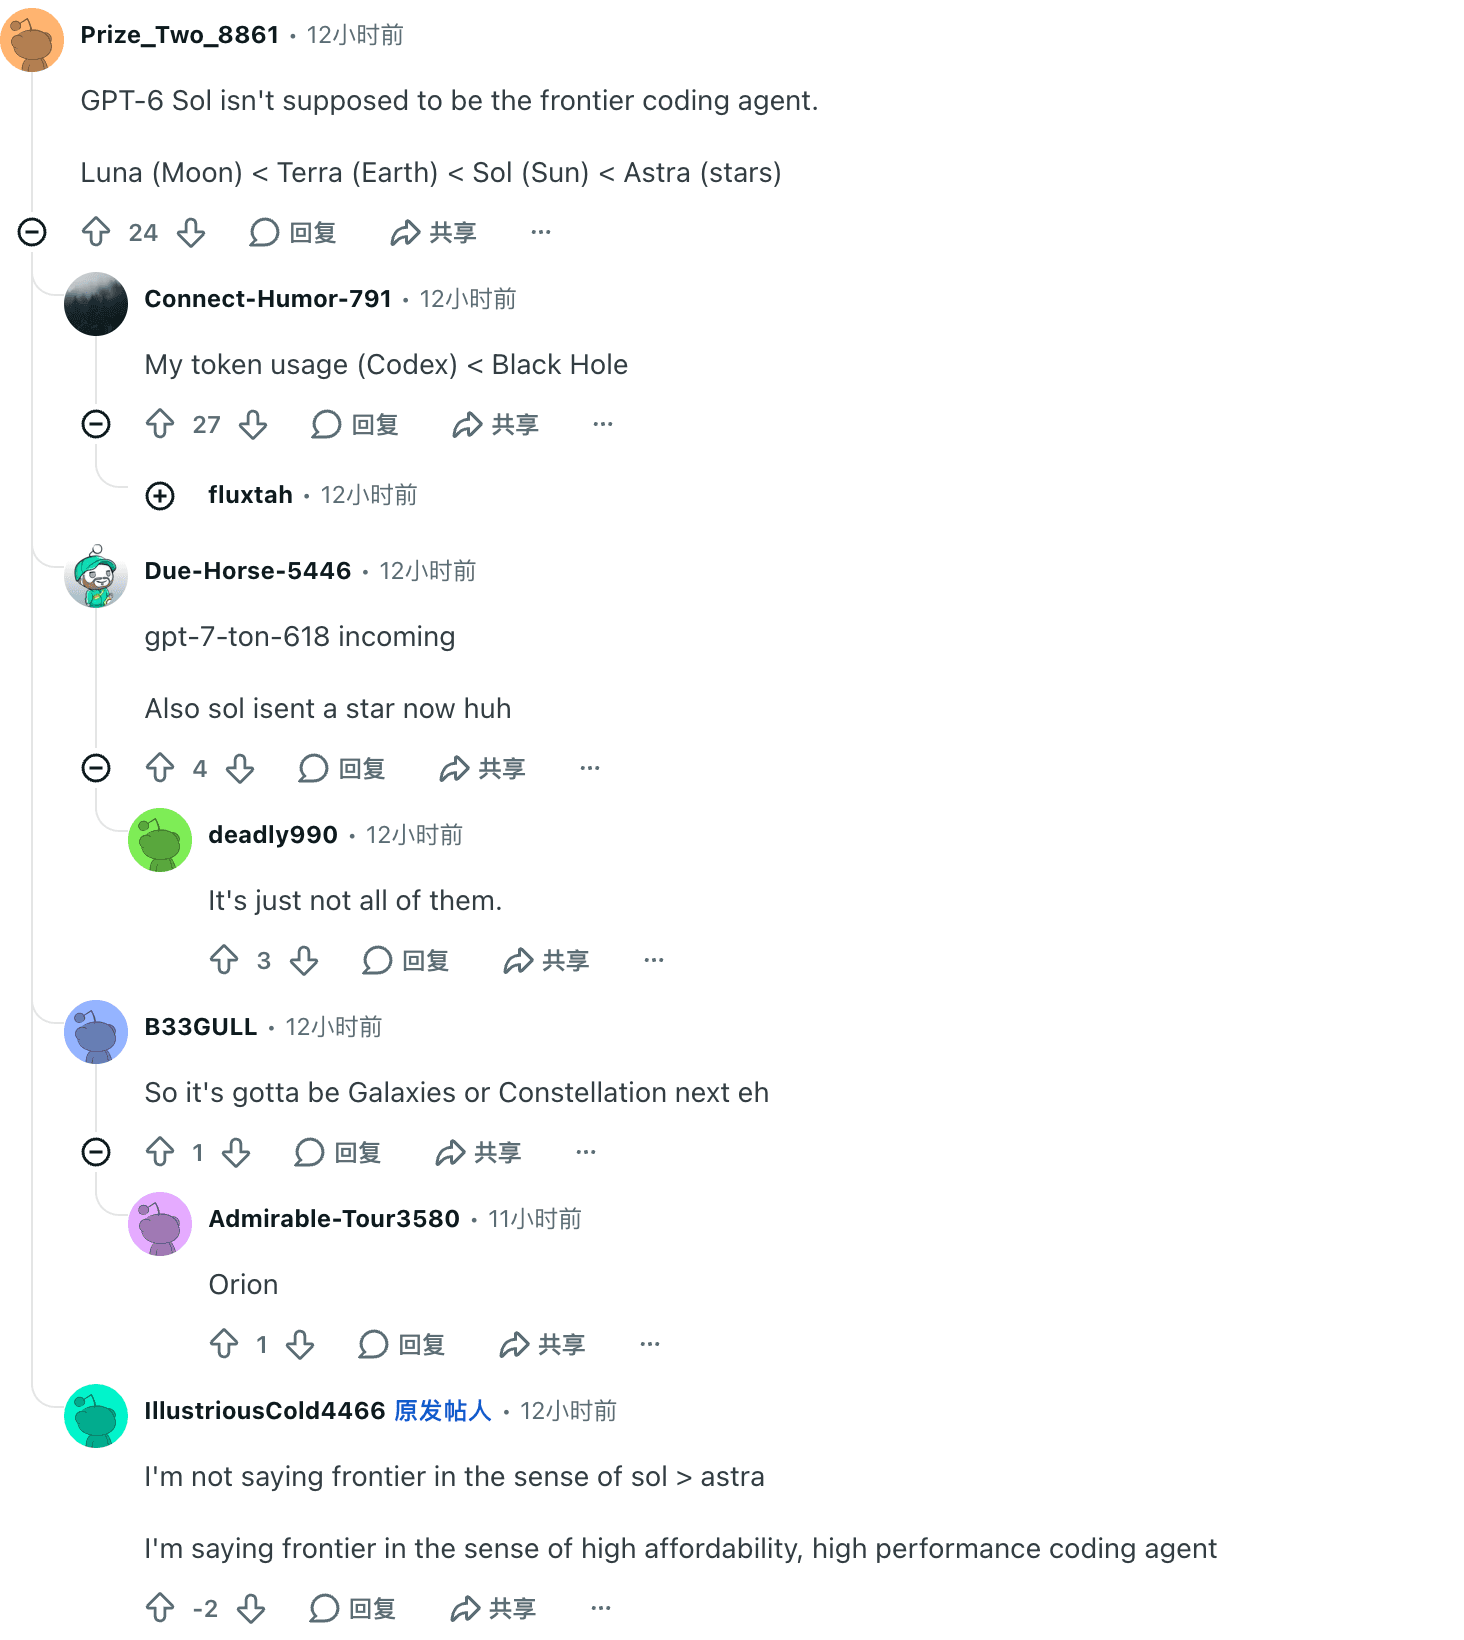

Notre lecture éditoriale : les deux camps décrivent le même choix de design depuis des charges opposées. Là où les erreurs coûtent, Sol paraît plus intelligent que son prédécesseur ; là où la couverture est précieuse, il paraît plus bête. Les benchmarks disent « à niveau », et les deux camps ont raison — chacun sur la moitié de la moyenne qui le concerne.
Le verdict : choisissez par forme de charge de travail
| Votre charge de travail | Meilleur choix | Pourquoi | Attention à |
|---|---|---|---|
| Automatisation routinière à haut volume, boucles d'agents au budget serré | GPT-6 Sol (xhigh) | Bat Opus 5 (max) sur AutomationBench pour 9 % de son coût par tâche ; ~0,53 $/tâche en xhigh | Gardez les contextes sous la falaise de facturation 272K ; la fenêtre de cache est de 30 minutes |
| Codage quotidien et seconde opinion en revue de code | GPT-6 Sol (high–max) | Parité FrontierCode avec Fable 5.1 xhigh à coût bien moindre ; attrape des conclusions hallucinées | Prévoyez une voie de secours pour les abstentions ; vérifiez les citations |
| Autodébogage obstiné de 30+ minutes, autonomie longue haleine | GPT-6 Astra | La persistance est ce que la prime achète — voir notre test d'Astra | Coût par tâche 3 fois supérieur ; TTFT qui s'étire en effort haut |
| Travail de connaissance expert : droit, finance, analyse profonde | Claude Opus 5.5 | Sol a perdu ~100 Elo sur GDPval ; Opus mène l'II à 58 | Le coût par tâche le plus élevé ; verbosité en effort max |
| La conversation quotidienne côté ChatGPT | Restez sur 5.6 pour l'instant (Luna gratuite, 5.6 Sol sur Plus) | Sol n'est pas encore dans Chat ; la combustion de quota de la génération 6 est réelle | Si vous restez, prix promotionnel et config 1M s'appliquent toujours |
| Recherche et automatisation à travers des onglets de navigateur en direct | Tabbit + Sol (quand il apparaît dans votre sélecteur) | Fait tourner le modèle à côté de vos onglets et fichiers — voir ci-dessous | La disponibilité dépend du sélecteur de modèles de votre compte |
Le verdict en une ligne : basculez sur GPT-6 Sol les budgets d'automatisation et de codage ; ne basculez ni votre plafond de travail de connaissance ni vos agents autonomes de longue haleine. C'est la même intelligence que vous achetiez déjà à OpenAI, à moitié prix en vitrine, avec une nouvelle personnalité : il préfère laisser une question sans réponse plutôt que de se tromper. Embauchez-le précisément pour cette fiche de poste. Et une ligne en petits caractères avant d'engager un budget : le prix de base de GPT-5.6 dans chaque affirmation « 50 % moins cher » est promotionnel au moins jusqu'au 21 novembre 2026.
Faites tourner GPT-6 Sol là où votre travail vit déjà : Tabbit
Une feuille de scores n'est pas un flux de travail navigateur. Le vrai travail — la recherche, les comparaisons, l'extraction, la revue — vit à travers vingt onglets ouverts, des fichiers locaux et des applications web qu'un appel API brut ne voit jamais. Câbler Sol à la main signifie copier le contenu des pages dans des prompts, gérer soi-même les fenêtres de contexte et refaire la plomberie à chaque fois.
C'est là que Tabbit Browser gagne sa section dans un test de modèle. Tabbit est un navigateur IA agentique qui fait tourner des flux de modèles directement sur votre contexte de navigation : recherche multi-onglets, tâches de raisonnement agentique et recherche approfondie, automatisation à travers des pages en direct. Quand GPT-6 Sol apparaît dans le sélecteur de modèles de votre compte, vous pouvez pointer ces flux vers lui sans écrire d'orchestrateur — et basculer vers un modèle moins cher ou plus fort par tâche, exactement la discipline qu'un modèle à moitié prix à intelligence à niveau récompense.
Deux limites honnêtes : la disponibilité des modèles dans Tabbit dépend de votre compte connecté et de son offre — vérifiez le sélecteur avant de bâtir un flux autour de Sol — et le client ne change pas la facturation OpenAI ; la grille à 2 $/10 $ facture pareil. Pour voir comment on fait réellement travailler le modèle, parcourez la page du modèle GPT-6 Sol (English), son répertoire de prompts (English) et la base de preuves de tests (English) communautaire.
Prêt à faire tourner GPT-6 Sol sur vos propres onglets plutôt que sur un benchmark ?
 Tabbit Browser

Questions fréquentes
GPT-6 Sol est-il meilleur que GPT-5.6 Sol ?
Les mesures indépendantes indiquent une intelligence quasiment à égalité : Artificial Analysis place GPT-6 Sol (max) à 48 sur son Intelligence Index, au niveau de GPT-5.6 Sol, pour moitié moins de coût par tâche (1,06 $ contre 1,99 $). GPT-6 Sol réduit aussi son taux d'hallucinations de 92 % à 60 % sur AA-Omniscience, mais en ne tentant que 83 % des questions contre 99 %. Cet échange vous avantage si la réponse erronée vous coûte plus cher que la réponse manquante.
Pourquoi GPT-6 Sol refuse-t-il ou esquive-t-il plus de questions ?
Artificial Analysis attribue l'amélioration des hallucinations à l'abstention : GPT-6 Sol (max) tente 83 % des questions d'AA-Omniscience contre 99 % pour GPT-5.6 Sol (max), ce qui réduit les réponses erronées mais fait baisser la précision sur les questions tentées de 59 % à 54 %. Dans un pipeline d'agents, une abstention se manifeste généralement par une tâche bloquée ou escaladée : prévoyez une voie de secours au lieu de traiter le refus comme un échec.
Combien coûte GPT-6 Sol par tâche ?
Sur l'Intelligence Index d'Artificial Analysis, GPT-6 Sol coûte environ 1,06 $ par tâche en effort maximum, avec une échelle allant d'environ 0,13 $ en effort bas à 1,06 $ en maximum sur la même grille à 2 $/10 $. Le seul choix de l'effort fait donc varier le coût d'un facteur 8 environ. La grille complète, les règles de cache et le seuil de contexte long de 272K sont dans notre guide tarifaire GPT-6 Sol.
GPT-6 Sol ou GPT-6 Astra : lequel utiliser ?
Choisissez GPT-6 Sol pour le codage et l'automatisation à haut volume où le coût par tâche compte, et GPT-6 Astra pour les exécutions autonomes de longue haleine où la persistance compte. Sol affiche 48 à l'Intelligence Index d'AA contre 53 pour Astra, pour environ un tiers du coût par tâche, et les deux partagent le seuil de facturation de contexte long de 272K. Notre test de GPT-6 Atra détaille quand la prime se justifie.
GPT-6 Sol est-il disponible dans ChatGPT ?
Pas encore dans Chat. Au lancement, GPT-6 Sol est disponible dans ChatGPT Work et Codex pour les offres Plus, Pro, Business, Enterprise et Edu, tandis que les utilisateurs Free et Go reçoivent GPT-6 Luna dans l'application de bureau. OpenAI indique un déploiement progressif vers Chat, et le modèle est présent dans l'API sous l'identifiant gpt-6-sol. Vérifiez le sélecteur de modèles de votre offre avant d'y engager un flux de travail.
Puis-je utiliser GPT-6 Sol dans Tabbit Browser ?
Tabbit Browser prend en charge des flux de travail multi-modèles à travers vos onglets ouverts, vos fichiers locaux et vos sessions web en direct ; GPT-6 Sol apparaît dans le sélecteur de modèles lorsque votre compte ou votre accès API l'inclut. La disponibilité dépend de votre compte, et l'utilisation du client ne change pas la facturation d'OpenAI. Avant de télécharger, parcourez les recettes de tâches du répertoire de prompts GPT-6 Sol.