
Si tu carga de trabajo es programación de alto volumen, automatización o bucles de agentes donde el costo por tarea decide el presupuesto, GPT-6 Sol merece el cambio; si necesitas el techo más alto en trabajo de conocimiento o un agente que jamás abandone una tarea, quédate donde estás. La tarjeta a mitad de precio es real: $2 por millón de tokens de entrada y $10 por millón de salida, la mitad de las tarifas promocionales de GPT-5.6 Sol, verificado en la ficha del modelo de OpenAI el 23 de septiembre de 2026. Pero lo interesante de este análisis no es el precio: es cómo el modelo se volvió más preciso. Artificial Analysis midió que su tasa de alucinaciones cayó del 92% al 60% mientras la proporción de preguntas que intenta bajó del 99% al 83%. En un sentido preciso, el nuevo Sol es un modelo que responde menos.
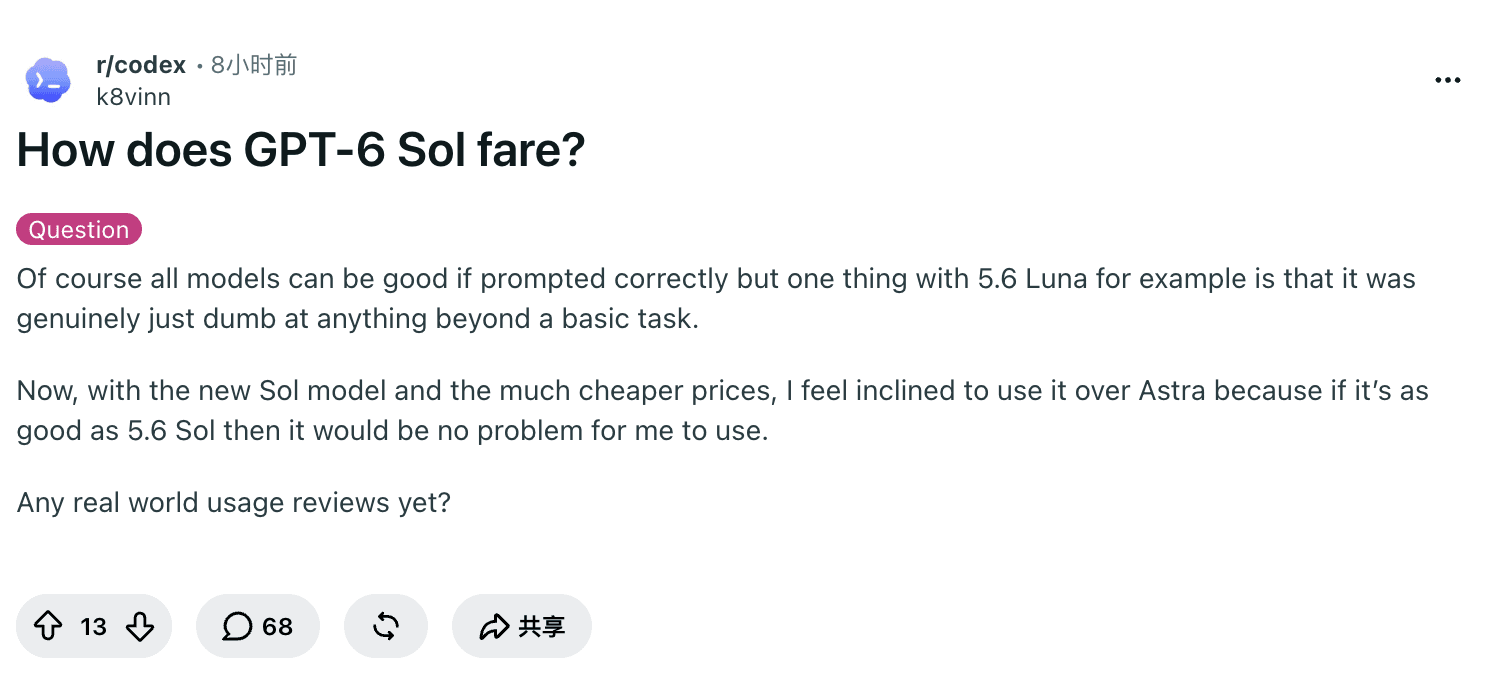
Ese intercambio es exactamente lo que divide a la comunidad desde el lanzamiento. Cuatro horas después del estreno, u/k8vinn abrió un hilo en r/codex con la pregunta que este análisis responde: "Now, with the new Sol model and the much cheaper prices, I feel inclined to use it over Astra... Any real world usage reviews yet?" ("Con el nuevo Sol y los precios mucho más baratos, me inclino a usarlo en lugar de Astra… ¿Ya hay análisis de uso real?") (Reddit)
La tarifa de GPT-6 Sol la desglosamos por separado, y nuestra comparación de GPT-6 Sol con Claude Opus 5.5 resuelve el problema de elección entre dos modelos. El lanzamiento hermano tiene su propio análisis de GPT-6 Astra. Esta entrega es el veredicto del modelo: dónde mejora GPT-6 Sol de verdad, dónde muerde y qué cargas de trabajo deben cambiar, quedarse o irse. Si quieres ejecutar el modelo contra páginas web reales en lugar de bancos de pruebas, al final señalo una ruta a nivel de navegador.
Conclusiones clave
La inteligencia es la misma; el precio, la mitad. Artificial Analysis sitúa a GPT-6 Sol (max) en 48 puntos de su Intelligence Index —al nivel de GPT-5.6 Sol— a $1,06 por tarea frente a $1,99, con una tarjeta recortada de $4/$20 a $2/$10 por millón de tokens.
La ganancia de precisión es un juego de abstención. La tasa de alucinaciones en AA-Omniscience cayó del 92% al 60% porque Sol intenta el 83% de las preguntas frente al 99% de 5.6 Sol; la precisión sobre las preguntas intentadas bajó del 59% al 54%.
La eficiencia de tokens es la mejora silenciosa. Sol (max) generó 77M de tokens en la suite de AA frente a una mediana de 88M, y los profesionales reportan tareas de Codex que apenas muerden las cuotas semanales.
No es una mejora para el trabajo de conocimiento. Sol cayó unos 100 puntos Elo en GDPval-AA v2.1, y su 48 de II queda por debajo de GPT-6 Astra (53) y Claude Opus 5.5 (58).
La realidad de la plataforma importa esta semana. Sol está en ChatGPT Work y Codex pero no en Chat; los usuarios de suscripción reportan cuotas Plus que se queman a toda velocidad con la generación 6; los equipos de API en Chat Completions pierden function calling por encima de
reasoning_effort: none.
El número que decide este análisis: precisión respondiendo menos
Los benchmarks llegaron encogiéndose de hombros con GPT-6 Sol: la nota de lanzamiento de Artificial Analysis dice que "las puntuaciones de Intelligence Index y Coding Agent Index se mantienen a la par con GPT-5.6, con avances en algunas evaluaciones y retrocesos en otras". Dos líneas después, la misma nota suelta el número que sí cambia el comportamiento: en AA-Omniscience, su benchmark de conocimiento y alucinaciones, GPT-6 Sol (max) recorta su tasa de alucinaciones del 92% al 60%, mientras que intenta el 83% de las preguntas frente al 99% de GPT-5.6 Sol (max): un cuarto menos de respuestas erróneas, pero la precisión sobre las preguntas intentadas baja del 59% al 54% (Artificial Analysis, consultado el 23 de septiembre de 2026).
Traducido a términos de ingeniería: OpenAI cambió cobertura por corrección. El modelo levanta la mano menos veces y, cuando la levanta, es ligeramente menos preciso por respuesta que su predecesor, pero el volumen total de errores confiantes se desploma. La propia evaluación de factualidad de OpenAI cuenta una historia compatible: en conversaciones reales donde los usuarios habían marcado errores, "GPT-6 Sol comete aproximadamente la mitad de errores que su predecesor, acercándose a la fiabilidad de Astra" (anuncio). Atención a las advertencias: esas conversaciones se seleccionaron porque inducían errores, así que no son representativas del uso típico, y las puntuaciones no se controlaron por longitud.
Cada juicio de este análisis se ordena con una pregunta: ¿tu costo lo dominan las respuestas erróneas o las respuestas ausentes? Si un error es caro —revisión de código, cumplimiento, extracción que alimenta otros sistemas— el intercambio de abstención es una mejora genuina. Si el trabajo es la cobertura —pipelines de agentes donde una negativa significa tarea atascada y página que nunca se termina— el mismo diseño aparece como retroceso. Ten presente ese eje: vuelve en el veredicto.
Los benchmarks, y cuánto confianza merecen
Todas las cifras independientes provienen de una sola instantánea de Artificial Analysis tomada el 23 de septiembre de 2026, con los niveles de esfuerzo indicados, porque el esfuerzo es donde las comparaciones del día de lanzamiento hacen trampa. Las filas de precios vienen de la ficha del modelo de OpenAI y de nuestra guía de precios del mismo día.
| Dimensión | GPT-6 Sol (max) | GPT-5.6 Sol (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max c/ fallback) | Qué significa |
|---|---|---|---|---|---|
| Precio API, entrada / salida por 1M | $2 / $10 | $4 / $20 (promo hasta el 21 de nov.) | $10 / $50 | $4 / $20 | Sol iguala la entrada de Opus 5.5 con la mitad de su salida. |
| AA Intelligence Index | 48 | al nivel de Sol | 53 | 58 | Compras el mismo nivel de inteligencia más barato, no más inteligencia. |
| Costo AA por tarea (II) | $1,06 | $1,99 | $3,26 | $5,98 | La mitad de 5.6 Sol, un tercio de Astra, ~18% de Opus 5.5 en máximo. |
| Tasa de alucinaciones, AA-Omniscience | 60% | 92% | no reportado | no reportado | La victoria de precisión del titular. |
| Tasa de intento, mismo benchmark | 83% | 99% | — | — | …y la trampa: responde menos. |
| GDPval-AA v2.1 (trabajo de conocimiento) | ~100 Elo por debajo de la frontera | no reportado | no reportado | 1846 Elo (reportado por Anthropic) | No contrates a Sol para trabajo de conocimiento experto. |
| Velocidad de salida (mediana AA) | 131 tok/s | no reportado | 58 tok/s | no reportado | Término medio: más rápido que Astra o Fable 5.1, muy por debajo de los modelos Flash. |
| Contexto / salida máxima | 1,05M / 128K | 1M / 32K | 1,05M / 128K | 1M / 128K | Especificaciones de las fichas del fabricante; el umbral de facturación de 272K aplica a toda la familia. |
Antes de creerte ninguna fila, tres tandas de agua fría:
Las puntuaciones del fabricante corren en sus propios harness. Los benchmarks de lanzamiento de OpenAI —AutomationBench, Agents' Last Exam (Sol max 56,4%, por encima del mejor Opus 5 con un 60% menos de costo), DeepSWE (68,8% frente al 69,9% de Fable 5 con ~80% menos de costo), OSWorld 2.0 offline (60,5% ≈ 60,3% de Opus 5 medium con ~80% menos de costo)— son todos autoinformados, y la propia nota al pie del anuncio admite que las evaluaciones corrieron en un entorno de investigación o API que "puede dar una salida ligeramente diferente al ChatGPT de producción", con puntuaciones de la competencia tomadas de informes públicos. Útiles como brújula, no como evangelio.
Los valores del índice se desplazan. Nuestro análisis de GPT-6 Astra, escrito un día antes, citaba valores del Intelligence Index de AA de 61,2 para Astra y 60,9 para 5.6 Sol; el mismo tracker ahora lista a Astra en 53 y a Sol en 48. Artificial Analysis versiona y recalcula su índice: compara modelos dentro de una misma instantánea, nunca entre semanas.
El desajuste de esfuerzo es el truco de la semana de lanzamiento. Las cifras publicadas de Sol son casi todas de esfuerzo máximo; los titulares de Opus 5.5 suelen ser su modo medium por defecto. Cualquier "Sol gana/pierde" que no nombre ambos ajustes es marketing. Nuestra comparación hace esa matemática con costos alineados.
Aquí los benchmarks son una brújula, no una regla. Lo que más pesa en estas horas es lo que reporta quien mide tareas reales, y las primeras 24 horas produjeron un conjunto sorprendentemente coherente.
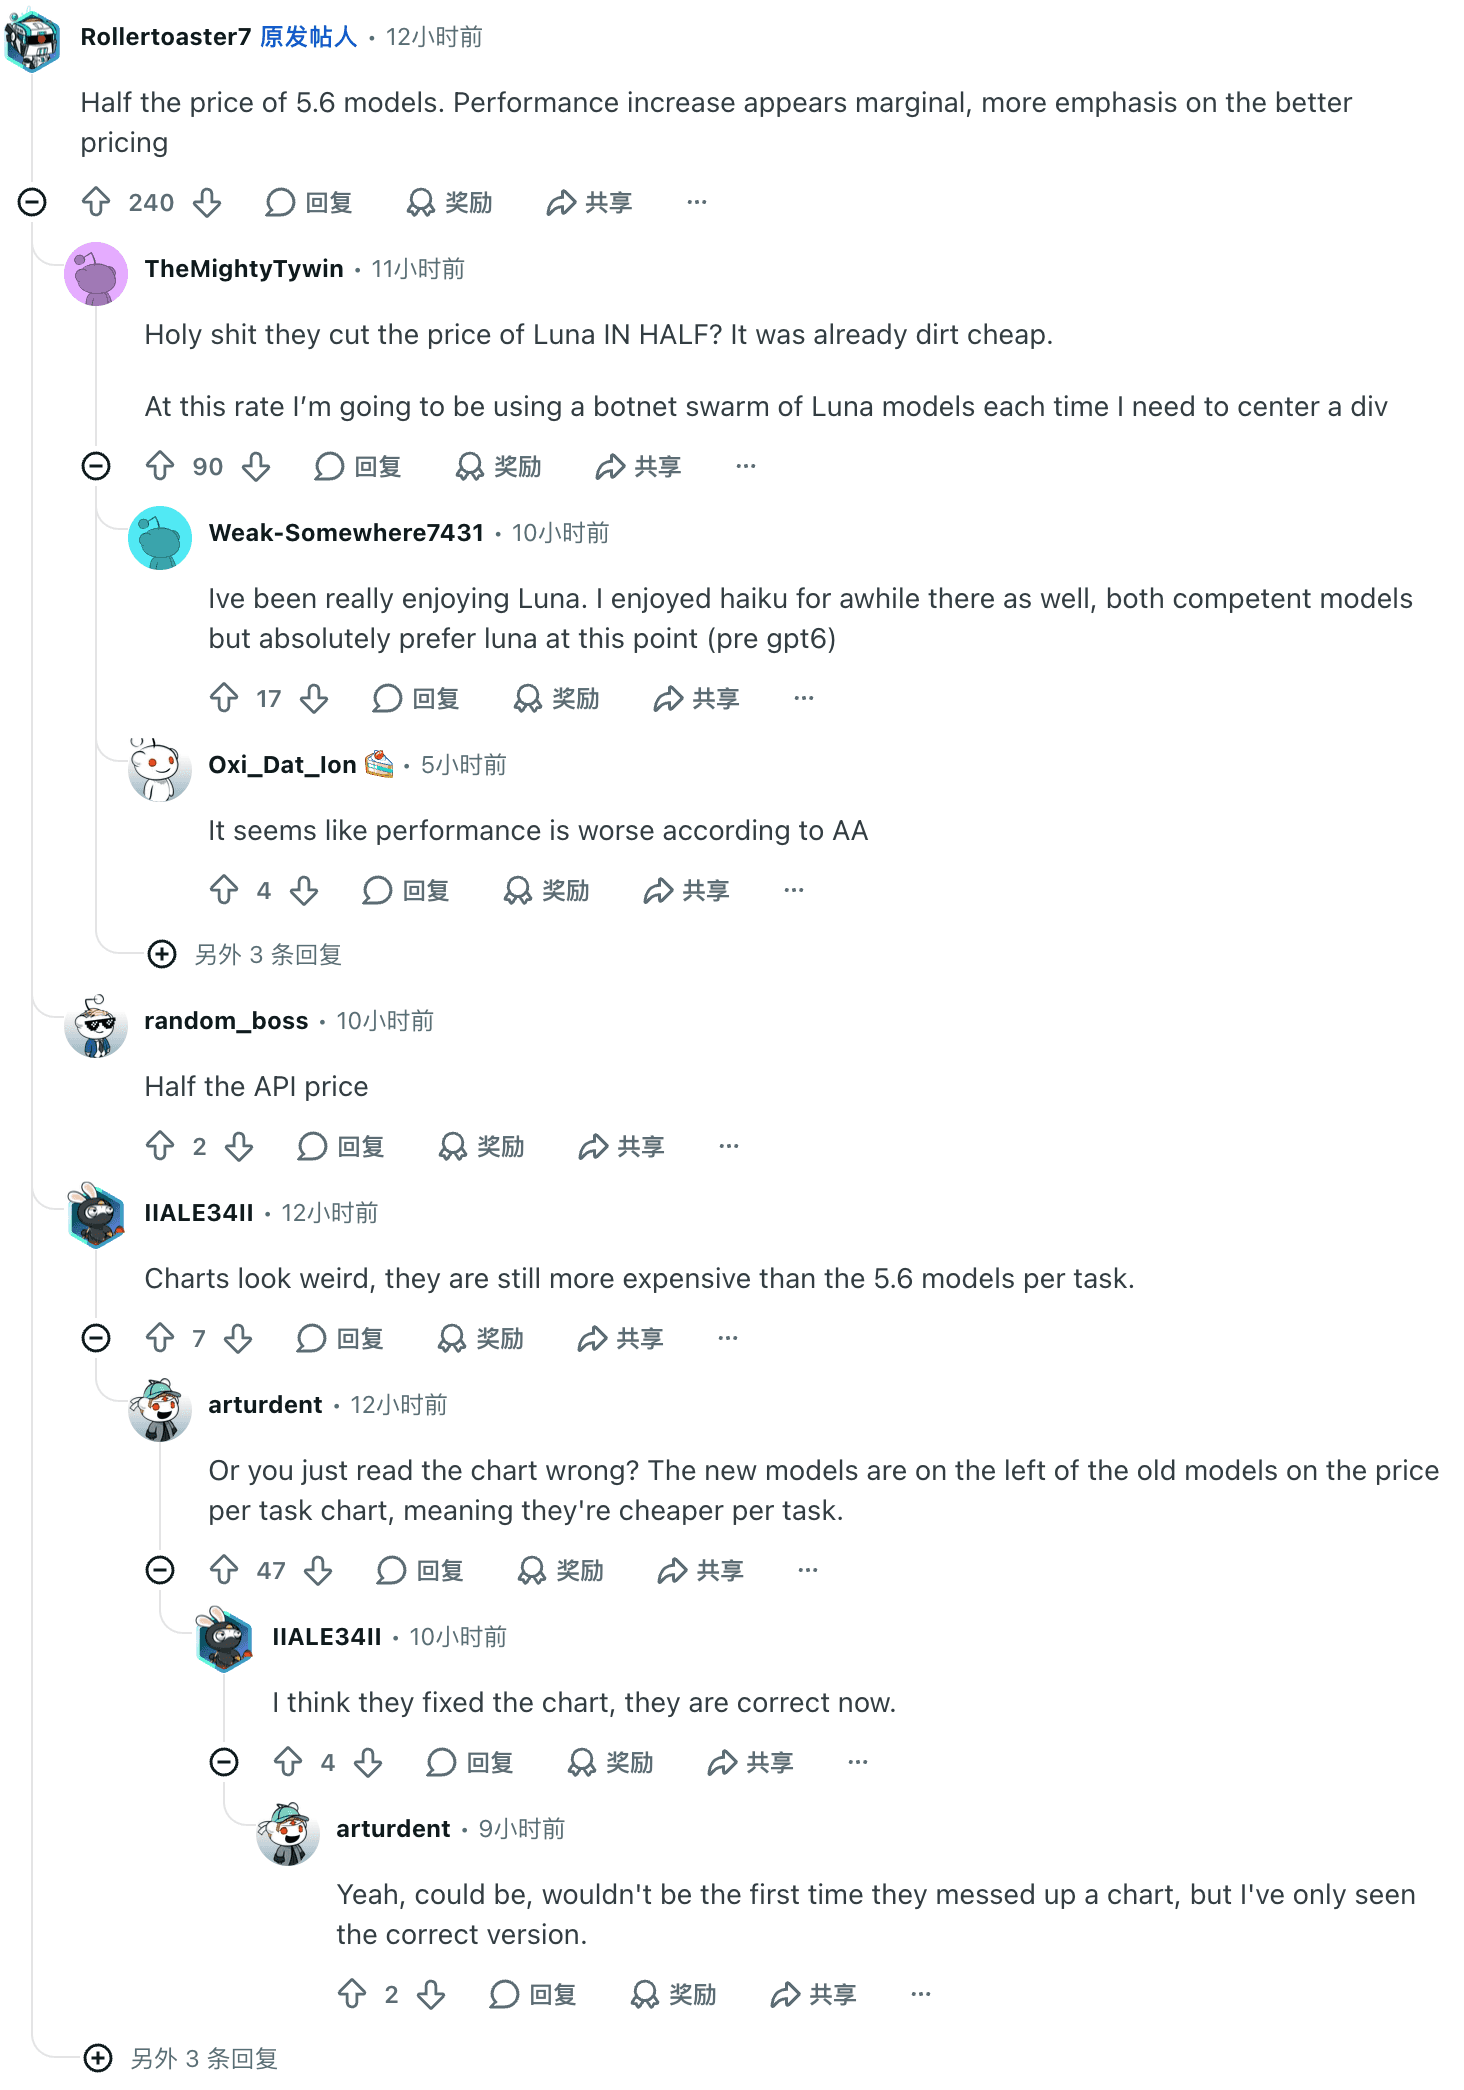
La lectura "precios a la mitad, rendimiento marginal" fue el comentario más votado del hilo de lanzamiento de r/codex en cuestión de horas: u/Rollertoaster7, el autor original, sumó 240 puntos con "Half the price of 5.6 models. Performance increase appears marginal, more emphasis on the better pricing" ("La mitad de precio que los 5.6. La mejora de rendimiento parece marginal; el énfasis está en el mejor precio"), con otro usuario citando directamente los resultados agridulces de AA (Reddit). Vals AI, evaluador independiente, llegó a la misma meseta desde su propio banco: "GPT-6 Sol… ocupa el puesto #8 del Vals Index, aproximadamente al nivel de GPT 5.6 Sol con la mitad de costo" (X).
Donde GPT-6 Sol es genuinamente bueno
1. Factualidad: menos errores confiados
El mecanismo de abstención no es solo un artefacto de benchmark: en pipelines reales se traduce en un modelo que empuja hacia atrás en lugar de acumular. Un comentarista de Hacker News contó que usó a Sol como segunda opinión sobre la revisión de código de otro modelo: "i used it for code review and it flagged twenty issues, sol checked the review and found 75% of them were hallucinations. sol was much closer to reality." ("Lo usé para revisar código: aquel marcó veinte problemas y Sol, al revisarlo, halló que el 75% eran alucinaciones. Sol estaba mucho más cerca de la realidad.") (HN). Una anécdota no prueba tasas, pero rima exactamente con la medición de AA y con el "la mitad de errores" de OpenAI desde tres direcciones independientes. Si tu carga castiga los errores —revisión, extracción, cumplimiento— esta es la mejora que importa más que cualquier punto de índice.
2. Eficiencia de tokens: el recorte silencioso de la factura
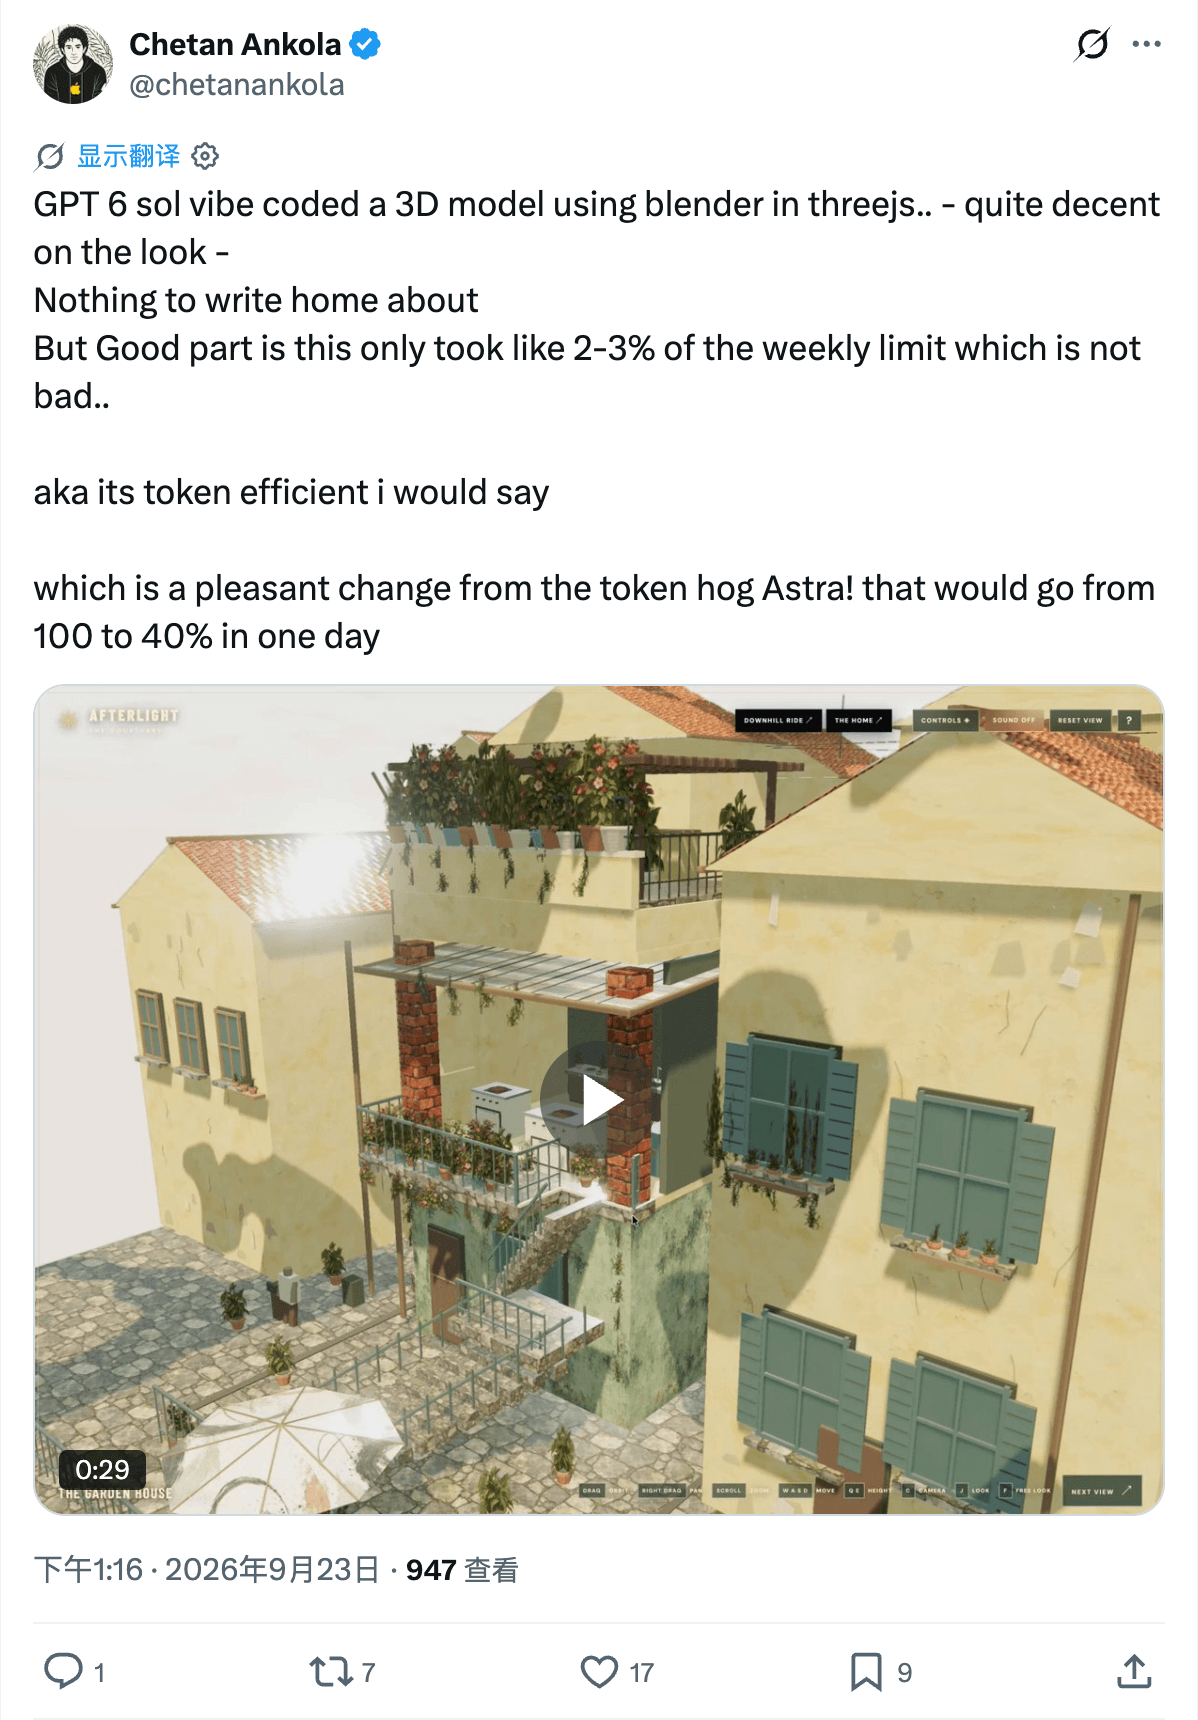
Los modelos de razonamiento cobran dos veces: por la respuesta y por el pensamiento. El volumen de generación de Sol en la suite de AA fue de 77M de tokens contra una mediana de 88M, y los profesionales notaron la misma delgadez en planes de suscripción: en r/codex bromeaban con "mi uso de tokens en Codex < un agujero negro", y en X un desarrollador midió una tarea de Blender/Three.js en "como el 2-3% del límite semanal… diría que es token-eficiente, un cambio agradable respecto a ese devorador de tokens llamado Astra, que pasa del 100% al 40% en un día" (X). Sumado a la tarjeta de tarifas, he aquí por qué la afirmación de OpenAI de que Sol(xhigh) supera a Opus 5 (max) en AutomationBench con el 9% de su costo por tarea es al menos plausible: menos tokens, más baratos, en trabajo con forma de automatización.
3. Escritura y estilo de colaboración
OpenAI dice que el estilo de comunicación mejorado de Astra —"más claridad, menos jerga"— se traslada a Sol, y esta es la rara afirmación del fabricante que una prueba ciega independiente hizo eco en un día: el banco a ciegas de How I AI señaló la "escritura clara, PRD legibles y el precio" como donde Sol sigue ganando (Lenny's Newsletter). Para los equipos que entregan documentos junto con código —especificaciones, PRD, resúmenes de revisión— es una mejora de calidad diaria que ninguna fila de leaderboard captura.
Donde GPT-6 Sol falla
1. El impuesto de abstención
Cada fortaleza anterior tiene su espejo. Un modelo que intenta el 83% de las preguntas, dentro de un pipeline desatendido, es un modelo que devuelve un 17% de espacios vacíos, y cada espacio vacío es una tarea atascada, un reintento o una escalada a un humano. AA también midió el costo por respuesta: la precisión sobre las preguntas intentadas cayó del 59% al 54%, y en GDPval-AA v2.1, su benchmark de trabajo de conocimiento de valor económico, Sol cayó unos 100 Elo frente a sus pares de frontera. El techo del trabajo de conocimiento simplemente no es lo que este modelo busca. Si tu pipeline no tolera negativas, presupuesta un modelo de respaldo desde el primer día.
2. Parte de la comunidad lo lee como "Terra con etiqueta nueva"
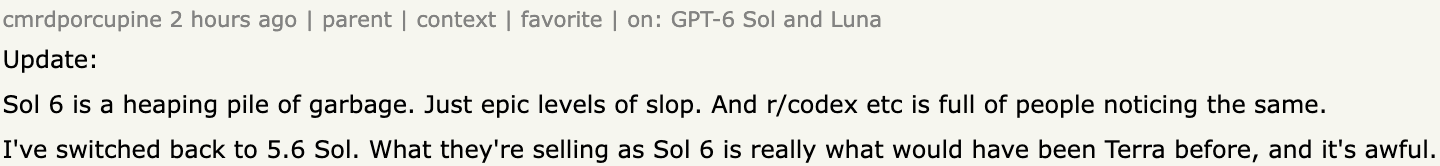
Los informes negativos más afilados convergen en el mismo tema: esto es una re-tarificación, no una nueva generación. Un desarrollador de Hacker News que ya volvió atrás escribió: "Update: Sol 6 is a heaping pile of garbage... I've switched back to 5.6 Sol. What they're selling as Sol 6 is really what would have been Terra before." ("Actualización: Sol 6 es un montón de basura… Volví a 5.6 Sol. Lo que venden como Sol 6 es realmente lo que antes habría sido Terra.") (HN). En r/codex, la misma intuición: "Después de trabajar con él, definitivamente es más tonto. Se siente más como Terra." El punto medio medido: el índice está nivelado en promedio, pero "avances en algunas evaluaciones y retrocesos en otras" significa que cargas individuales pueden caer justo en la mitad que retrocede. Si tu mezcla de prompts cae en una evaluación que retrocedió, tu experiencia contradirá el promedio, y ambas partes tienen razón a la vez.
3. Fricción de plataforma en la semana de lanzamiento
Tres roces prácticos enfrían el cambio esta semana. Primero, disponibilidad: Sol está en ChatGPT Work y Codex para planes de pago, pero todavía no en Chat, y los usuarios Free/Go solo reciben GPT-6 Luna (anuncio). Segundo, la economía de la suscripción: un usuario de Plus reportó que "quemó mi uso de Plus en minutos, mientras con 5.6 podía navegar durante horas. Se ponía a dar vueltas minutos sobre un prompt básico y luego se rendía ante los límites de uso" (HN): aunque la API baje, los tokens de razonamiento queman cuota. Tercero, la superficie de API: en el endpoint heredado de Chat Completions, function calling solo funciona con reasoning_effort: none; los flujos con herramientas pertenecen a la API de Responses, y el fine-tuning no está soportado (ficha del modelo). Si te quedas en 5.6 Sol por su comportamiento de uso, recuerda que sus tarifas promocionales duran al menos hasta el 21 de noviembre de 2026, y nuestra guía de configuración de contexto de 1M sigue aplicando.

Lo que dijo la gente
Veinticuatro horas de señal comunitaria se parten con limpieza sobre el eje de la sección dos, no por habilidad ni antigüedad.
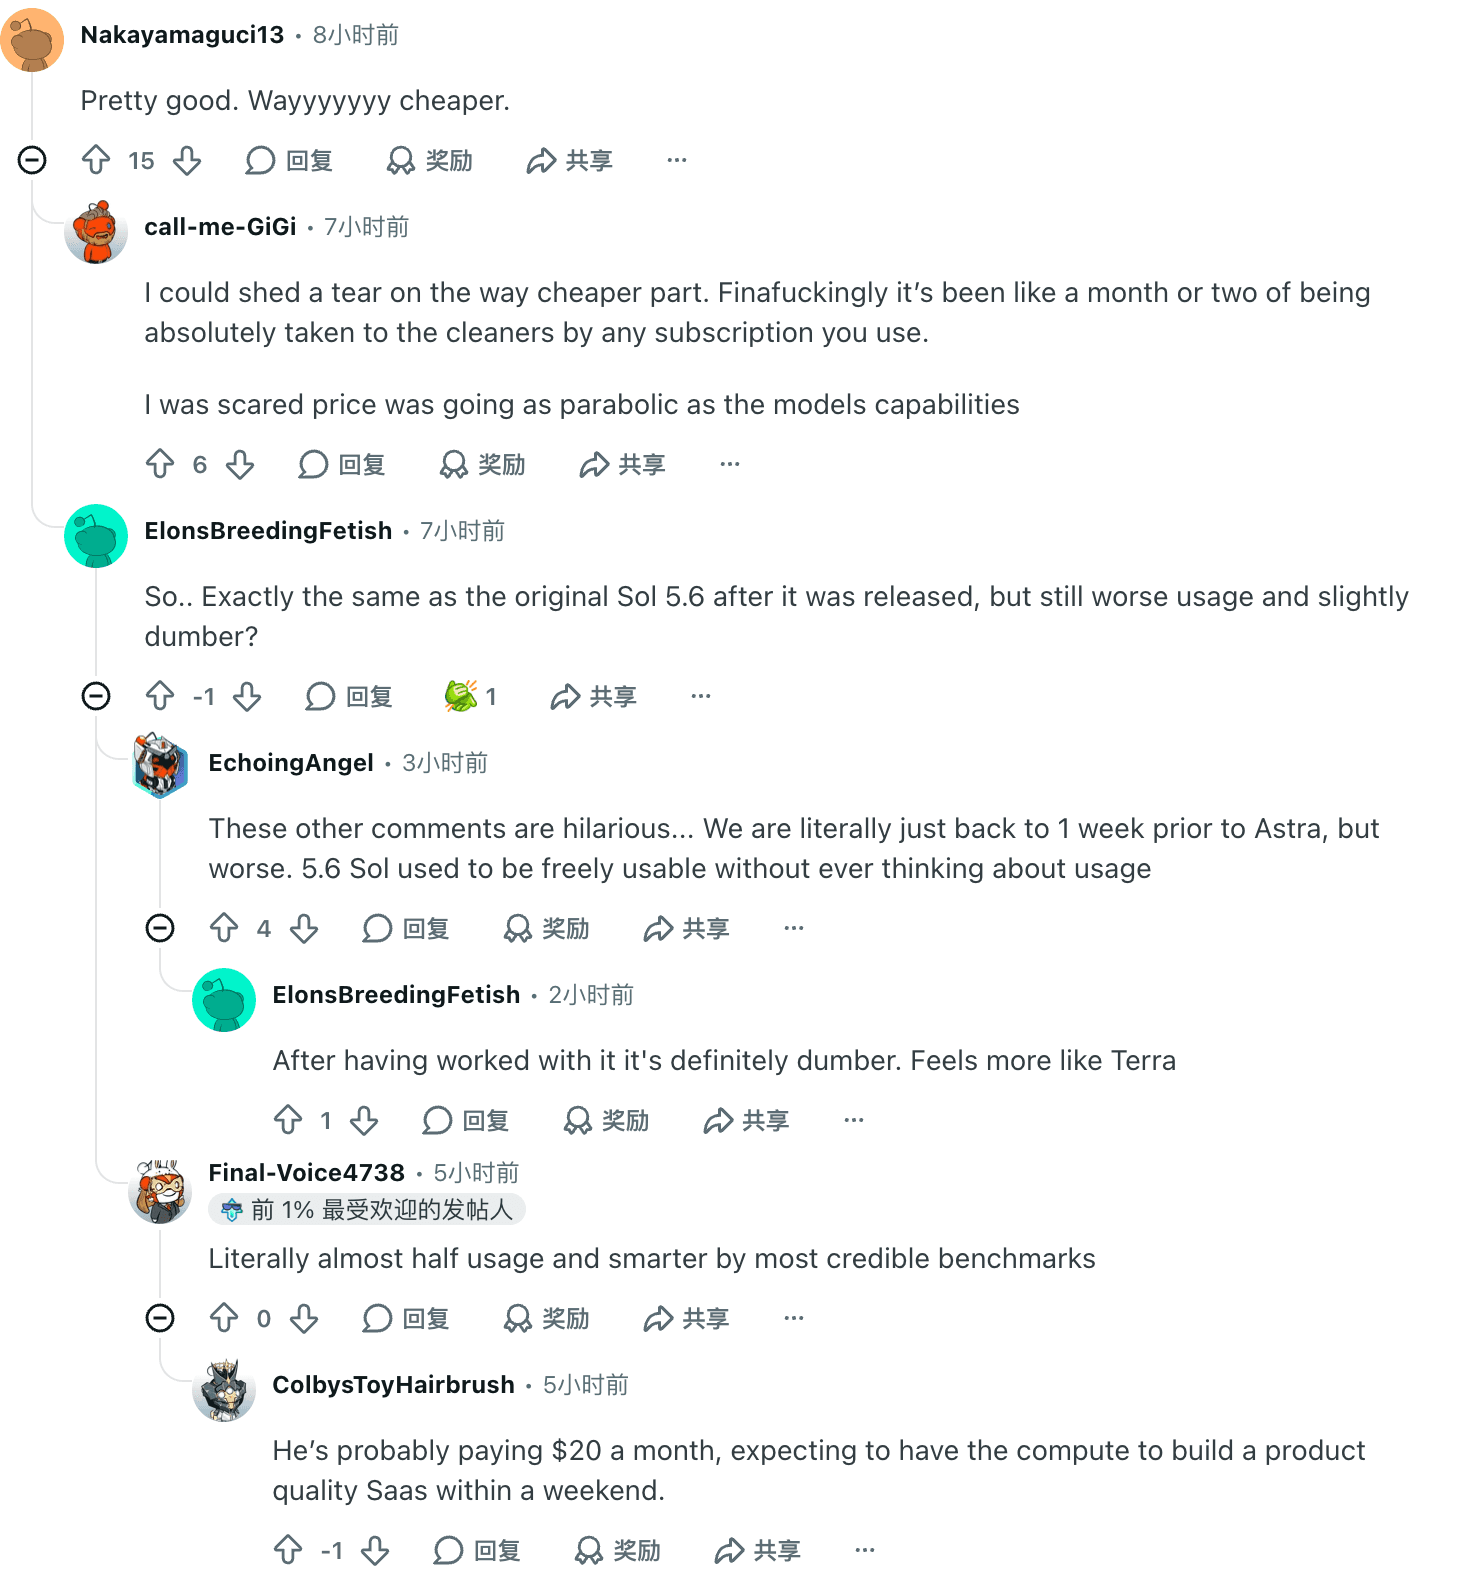
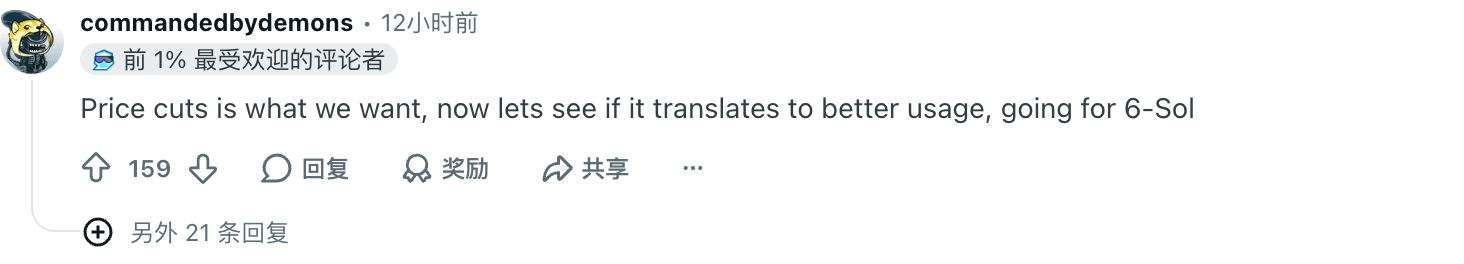
Campo uno: "la mitad de precio es la mejora". "Pretty good. Wayyyyyyy cheaper." ("Bastante bueno. Muuuucho más barato.") (u/Nakayamaguci13). "Literally almost half usage and smarter by most credible benchmarks" ("Casi la mitad de uso y más listo según la mayoría de benchmarks creíbles") (u/Final-Voice4738). La mayoría de espera-y-verás llevó el hilo de r/codex a 159 puntos: "Price cuts is what we want, now lets see if it translates to better usage, going for 6-Sol" ("Los recortes de precio es lo que queríamos; a ver si se traducen en mejor uso, me paso al 6-Sol") (u/commandedbydemons).
Campo dos: "esto es una re-tarificación, no un sucesor". "Definitivamente es más tonto. Se siente más como Terra." (u/ElonsBreedingFetish). "Según AA, el rendimiento es peor." (u/Oxi_Dat_Ion). La vuelta atrás de cmrdporcupine, citada arriba, es la declaración más fuerte del campo.
El centro guarda la información real. u/mchusma en Hacker News nombró la comparación que enfrentan la mayoría de los equipos: "I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability." ("Personalmente prefiero Opus 5.5 en medium antes que GPT-6 Sol en Max, en pruebas muy muy tempranas. Rango de precio similar, más capacidad.") (HN).
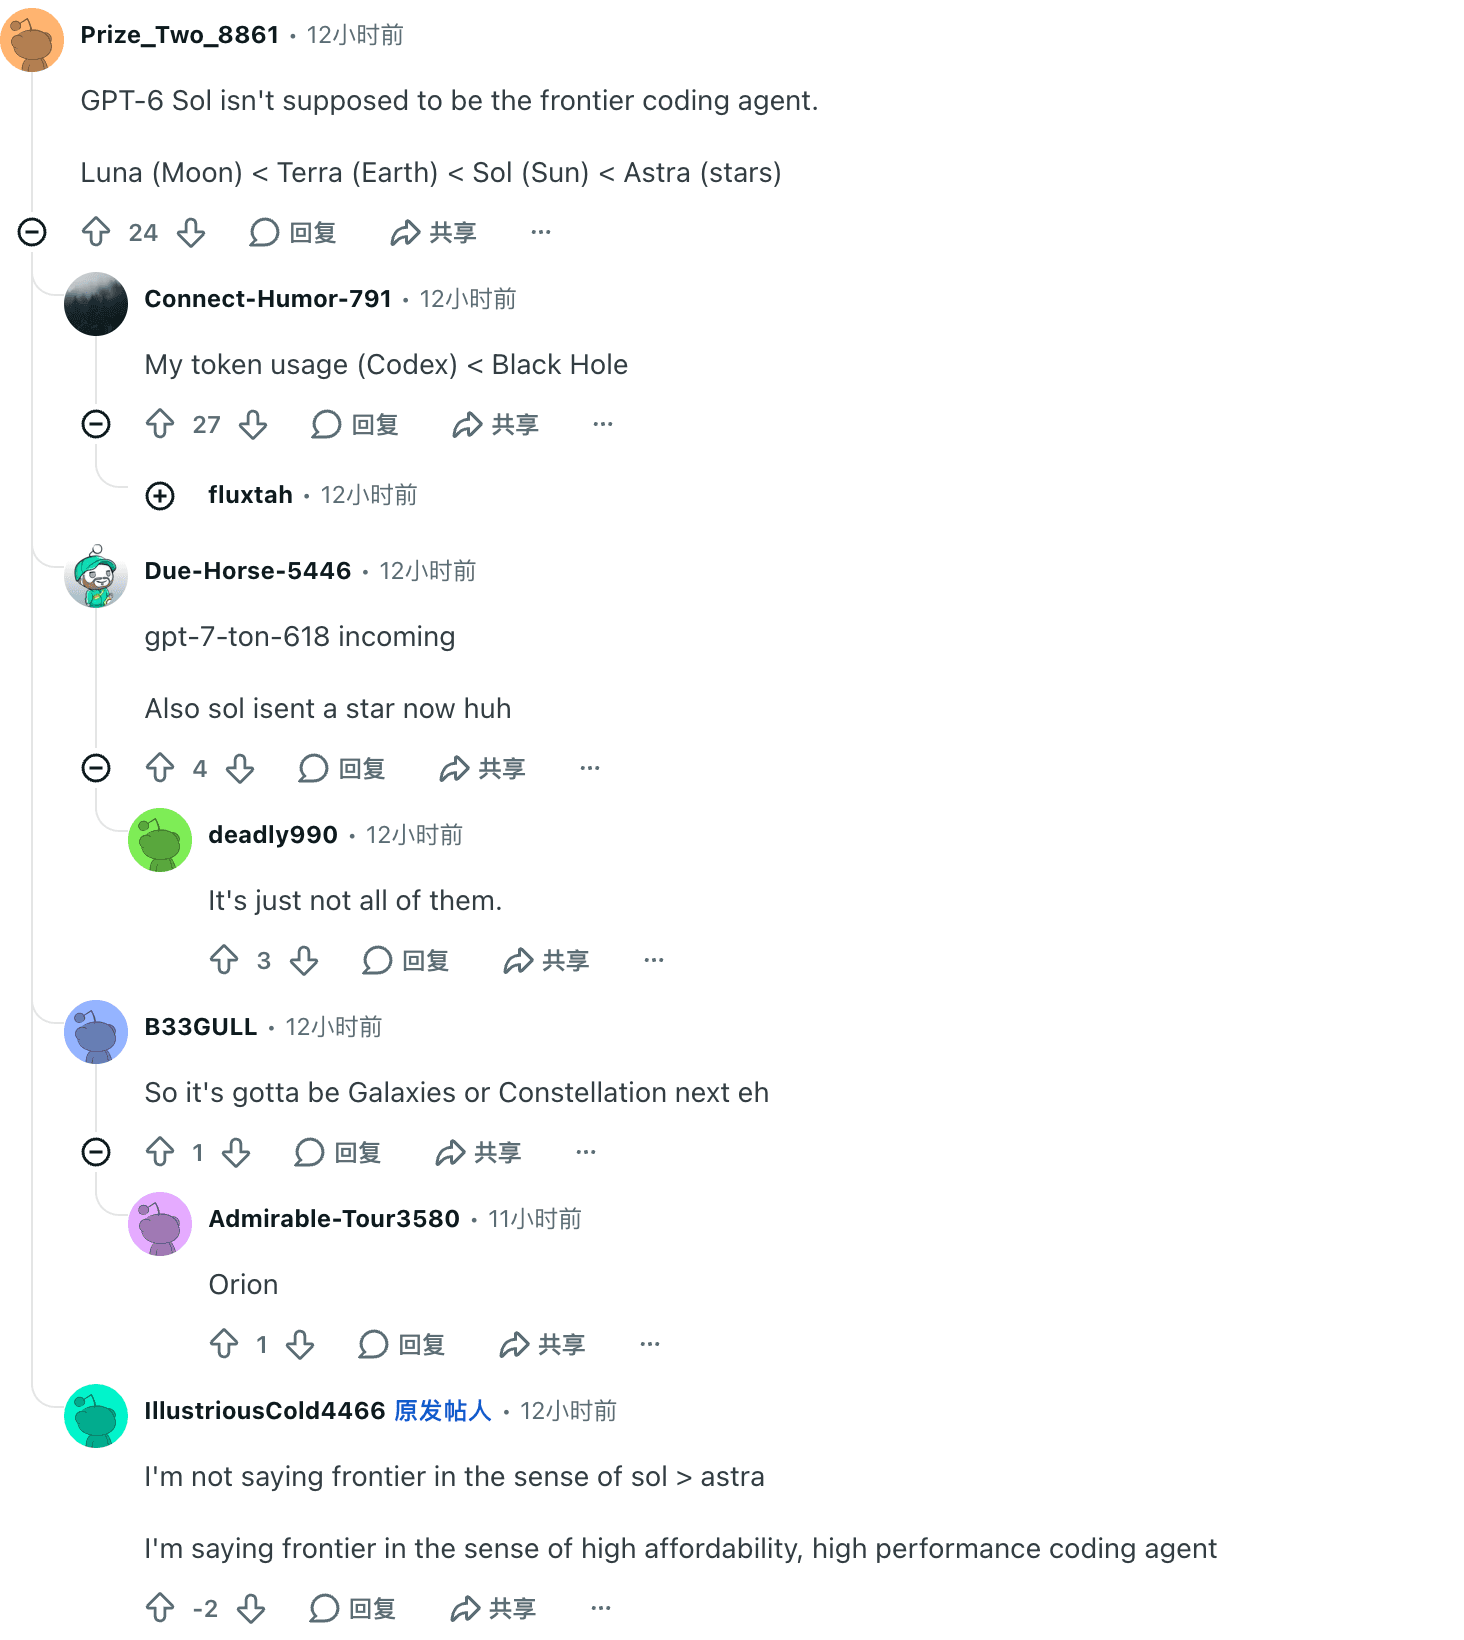

Nuestra lectura editorial: ambos campos describen la misma decisión de diseño desde cargas opuestas. Donde los errores cuestan, Sol parece más listo que su predecesor; donde la cobertura es sagrada, parece más tonto. Los benchmarks dicen "nivel", y ambos campos aciertan: cada uno, sobre la mitad del promedio que le toca.
El veredicto: elige por forma de carga de trabajo
| Tu carga de trabajo | Mejor opción | Por qué | Ojo con |
|---|---|---|---|
| Automatización rutinaria de alto volumen, bucles de agentes con presupuesto ajustado | GPT-6 Sol (xhigh) | Supera a Opus 5 (max) en AutomationBench con el 9% de su costo por tarea; ~$0,53/tarea en xhigh | Mantén los contextos bajo el acantilado de 272K; la ventana de caché es de 30 minutos |
| Programación diaria y segunda opinión en revisión de código | GPT-6 Sol (high–max) | Paridad en FrontierCode con Fable 5.1 xhigh a mucho menor costo; detecta hallazgos alucinados | Prevé una ruta de respaldo para abstenciones; verifica citas |
| Autodepuración obstinada de 30+ minutos, autonomía de largo horizonte | GPT-6 Astra | La persistencia es lo que compra la prima: mira nuestra reseña de Astra | Costo por tarea 3 veces mayor; TTFT se estira en esfuerzo alto |
| Trabajo de conocimiento experto: legal, finanzas, análisis profundo | Claude Opus 5.5 | Sol cayó ~100 Elo en GDPval; Opus lidera el II con 58 | El costo por tarea más alto; verbosidad en esfuerzo máximo |
| Charla diaria en ChatGPT | Quédate en 5.6 por ahora (Luna gratis, 5.6 Sol en Plus) | Sol aún no está en Chat; la quema de cuota de la generación 6 es real | Si te quedas, aplican el precio promocional y la configuración de 1M |
| Investigación y automatización sobre pestañas de navegador en vivo | Tabbit + Sol (cuando aparezca en tu selector) | Ejecuta el modelo junto a tus pestañas y archivos: véase abajo | La disponibilidad depende del selector de modelos de tu cuenta |
El veredicto en una línea: mueve a GPT-6 Sol los presupuestos de automatización y programación; no muevas el techo de trabajo de conocimiento ni tus agentes autónomos de largo horizonte. Es la misma inteligencia que ya le comprabas a OpenAI, con la etiqueta a la mitad y una personalidad nueva: prefiere dejar una pregunta sin responder antes que responderla mal. Contrátalo exactamente para ese puesto. Y antes de comprometer un presupuesto, la letra pequeña: el precio base de GPT-5.6 en cada afirmación de "50% más barato" es promocional al menos hasta el 21 de noviembre de 2026.
Ejecuta GPT-6 Sol donde tu trabajo ya vive: Tabbit
Una hoja de puntuaciones no es un flujo de navegador. El trabajo real —la investigación, las comparaciones, la extracción, la revisión— vive repartido entre veinte pestañas abiertas, archivos locales y aplicaciones web que una llamada cruda a la API jamás ve. Cablear Sol a mano significa copiar el contenido de las páginas en prompts, gestionar ventanas de contexto por tu cuenta y rehacer la fontanería cada vez.
Ahí es donde Tabbit Browser se gana su sección en un análisis de modelos. Tabbit es un navegador de IA agéntica que ejecuta flujos de modelos directamente sobre tu contexto de navegación: investigación multi-pestaña, tareas de razonamiento agéntico e investigación profunda y automatización sobre páginas en vivo. Cuando GPT-6 Sol aparezca en el selector de modelos de tu cuenta, puedes apuntar esos flujos hacia él sin escribir un orquestador, y cambiar a un modelo más barato o más fuerte por tarea, que es justo la disciplina que premia un modelo a mitad de precio con inteligencia nivelada.
Dos límites honestos: la disponibilidad de modelos dentro de Tabbit depende de tu cuenta conectada y su plan —revisa el selector antes de construir un flujo alrededor de Sol— y el cliente no cambia la facturación de OpenAI; la tarjeta de $2/$10 factura igual. Para ver cómo se le pide trabajo al modelo en la práctica, explora la página del modelo GPT-6 Sol (English), su directorio de prompts (English) y la base de evidencia de reseñas (English) de la comunidad.
¿Listo para ejecutar GPT-6 Sol sobre tus propias pestañas en lugar de un benchmark?
 Tabbit Browser

Preguntas frecuentes
¿Es GPT-6 Sol mejor que GPT-5.6 Sol?
Las mediciones independientes indican que están prácticamente empatados en inteligencia: Artificial Analysis sitúa a GPT-6 Sol (max) en 48 puntos de su Intelligence Index, al nivel de GPT-5.6 Sol, con la mitad de costo por tarea ($1,06 frente a $1,99). GPT-6 Sol también reduce su tasa de alucinaciones del 92% al 60% en AA-Omniscience, pero lo consigue intentando el 83% de las preguntas frente al 99%. Si ese intercambio te conviene depende de si te cuesta más una respuesta errónea o una respuesta ausente.
¿Por qué GPT-6 Sol se niega a responder o salta más preguntas?
Artificial Analysis atribuye la mejora de alucinaciones a la abstención: GPT-6 Sol (max) intenta el 83% de las preguntas de AA-Omniscience frente al 99% de GPT-5.6 Sol (max), lo que reduce las respuestas erróneas pero baja la precisión sobre las preguntas intentadas del 59% al 54%. En un pipeline de agentes, una abstención suele traducirse en una tarea atascada o escalada, así que prevé una ruta de respaldo en lugar de tratar la negativa como un fallo.
¿Cuánto cuesta GPT-6 Sol por tarea?
En el Intelligence Index de Artificial Analysis, GPT-6 Sol cuesta unos $1,06 por tarea en esfuerzo máximo, con una escalera que va de unos $0,13 en esfuerzo bajo a $1,06 en máximo sobre la misma tarifa de $2/$10. Solo con elegir el esfuerzo, el costo oscila unas 8 veces. La tarjeta completa, las reglas de caché y el umbral de contexto largo de 272K están en nuestra guía de precios de GPT-6 Sol.
GPT-6 Sol frente a GPT-6 Astra: ¿cuál usar?
Usa GPT-6 Sol para programación y automatización de alto volumen donde importa el costo por tarea, y GPT-6 Astra para ejecuciones autónomas de largo horizonte donde importa la persistencia. Sol puntúa 48 en el Intelligence Index de AA frente a 53 de Astra, con aproximadamente un tercio del costo por tarea, y ambos comparten el umbral de facturación de contexto largo de 272K. Nuestro análisis de GPT-6 Astra cubre cuándo se justifica la prima.
¿Está GPT-6 Sol disponible en ChatGPT?
Todavía no en Chat. En el lanzamiento, GPT-6 Sol está disponible en ChatGPT Work y Codex para los planes Plus, Pro, Business, Enterprise y Edu, mientras que los usuarios Free y Go reciben GPT-6 Luna en la app de escritorio. OpenAI indica que el despliegue en Chat será gradual, y el modelo está en la API como gpt-6-sol. Revisa el selector de modelos de tu plan antes de comprometer un flujo de trabajo.
¿Puedo usar GPT-6 Sol en Tabbit Browser?
Tabbit Browser admite flujos de trabajo multimodelo sobre tus pestañas abiertas, archivos locales y sesiones web en vivo; GPT-6 Sol aparece en el selector de modelos cuando tu cuenta o acceso de API lo incluye. La disponibilidad depende de tu cuenta, y usar el cliente no cambia la facturación de OpenAI. Antes de descargar, puedes explorar recetas de tareas en el directorio de prompts de GPT-6 Sol.