
大量のコーディング、自動化、タスクあたりコストで予算が決まるエージェントループが主戦場なら、GPT-6 Sol への乗り換えには価値があります。知識作業の最高峰や、決してタスクを投げないエージェントが欲しいなら、今は動かない方がいい。半額のレートカードは本物です。入力 100万トークンあたり $2、出力 $10。GPT-5.6 Sol のプロモ価格の半額で、2026 年 9 月 23 日時点で OpenAI のモデルカード上で確認済み。しかしこのレビューで本当に面白いのは価格ではありません。モデルがどうやって正確になったかです。Artificial Analysis の計測では、幻覚率は 92% から 60% に下がった一方で、試みる質問の割合は 99% から 83% へ落ちました。端的に言えば、新しい Sol は「より少なく答えるモデル」です。
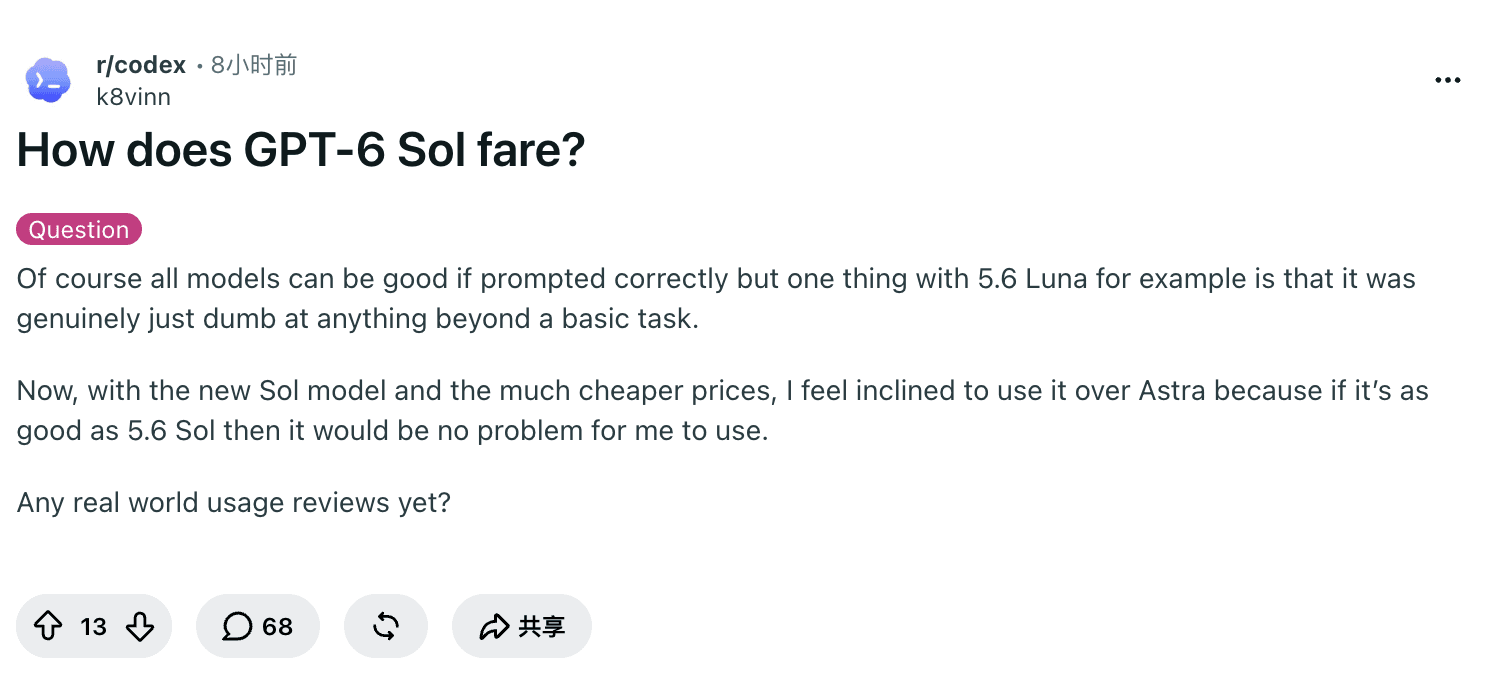
このトレードこそ、ローンチコミュニティが揉めている焦点です。リリース 4 時間後、u/k8vinn が r/codex に立てたスレッドは、このレビューが答える問いそのものでした。「新しい Sol と大幅に安い価格を見ると、Astra よりこっちを使いたくなる。5.6 Sol と同じくらいなら何も困らない。実戦での使用レビューはまだですか?」("Any real world usage reviews yet?")(Reddit)
GPT-6 Sol の料金は別記事で分解し、GPT-6 Sol 対 Claude Opus 5.5 の比較が二択の問題を扱います。同家族の GPT-6 Astra レビューも公開済み。本稿はモデルそのものの判定です。GPT-6 Sol が本当に改善した場所、牙を剥く場所、そしてどのワークロードが乗り換え・維持・見送りすべきか。テストハーネスではなく生きた Web ページで動かしたい人のために、最後にブラウザ層のルートを示します。
重要なポイント
知能は据え置き、価格は半額。 Artificial Analysis の GPT-6 Sol (max) は Intelligence Index 48 で GPT-5.6 Sol と同水準。タスクあたり $1.06 対 $1.99、レートカードは $4/$20 から $2/$10 に引き下げ。
正確率の向上は「棄答」の交換です。 AA-Omniscience の幻覚率は 92% → 60%。ただし試みる割合は 99% → 83%、回答した質問についての正確率は 59% → 54% に微減。
トークン効率は静かなアップグレード。 Sol (max) は AA スイートで 77M トークンを生成(中央値 88M)。実務者からは「週次クォータをほとんど消費しない Codex タスク」の報告。
知識作業のアップグレードではない。 Sol は GDPval-AA v2.1 で約 100 Elo 下落。II の 48 は GPT-6 Astra(53)や Claude Opus 5.5(58)を下回ります。
今週のプラットフォーム現実が効く。 Sol は ChatGPT Work と Codex にはあるが Chat には無し。サブスク勢からは「6 世代で Plus クォータが一瞬で溶ける」との報告。Chat Completions の API チームは
reasoning_effort: noneを超えると function calling を失う。
このレビューを決めるひとつの数字:少なく答えることで得た正確さ
ベンチマークは GPT-6 Sol に対して肩をすくめて始まります。Artificial Analysis のリリースノートは「Intelligence Index と Coding Agent Index は GPT-5.6 と同水準を維持。一部の評価で進歩、一部で退歩」と記し、その 2 行後の同じ文章が、挙動を実際に変える数字を落としています。知識と幻覚のベンチマーク AA-Omniscience で、GPT-6 Sol (max) の幻覚率は 92% から 60% へ低下。その実現方法は、試みる質問の割合を GPT-5.6 Sol (max) の 99% から 83% へ下げること――誤答は約 4 分の 1 減った一方で、回答した質問についての正確率は 59% から 54% へ下がった(Artificial Analysis、2026 年 9 月 23 日確認)。
エンジニアリングの言葉に訳すと、OpenAI はカバレッジを正確さに交換した、ということです。このモデルはあまり手を挙げない。挙げたときの 1 回ごとの正確率も前世代よりわずかに低い。それでも「自信満々に間違える」総量は崩壊しました。OpenAI 自身の事実性評価も整合する話をします。ユーザーが誤りをフラグした実会話のサンプルで、「GPT-6 Sol は前世代の約半分のミスで、Astra 水準の信頼性に接近」(公式発表)。ただし OpenAI 自身が但し書きを付けています。その会話は「誤りを誘発する」よう選ばれたもので典型的な利用を代表せず、スコアは長さで制御されていない、と。
本レビューのすべての判断は、ひとつの質問で分類されます。あなたのコストを支配するのは「誤答」ですか、「無回答」ですか? 誤答が高いところ――コードレビュー、コンプライアンス、下流システムへ流す抽出――では、棄答トレードは純増の改善です。カバレッジが仕事の場所――拒否 1 回がタスクの滞留と永遠に終わらないページを意味するエージェントパイプライン――では、同じ設計が退歩として現れます。この軸を覚えてください。最後の判定で戻ってきます。
ベンチマークと、それを何割だけ信じるか
以下の独立系の数値はすべて 2026 年 9 月 23 日の同一スナップショットによるもので、努力レベル(effort)を明記しています。ローンチ週の比較が静かに不正をするのは、ほぼいつも effort だからです。価格行は OpenAI のモデルカードと同日公開の料金ガイドから。
| 項目 | GPT-6 Sol (max) | GPT-5.6 Sol (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max w/ fallback) | 意味するところ |
|---|---|---|---|---|---|
| API 価格(入力/出力、100万トークンあたり) | $2 / $10 | $4 / $20(〜11月21日はプロモ) | $10 / $50 | $4 / $20 | Sol は Opus 5.5 と同入力価格で、出力はその半分。 |
| AA Intelligence Index | 48 | Sol と同水準 | 53 | 58 | 買うのは「より安い同レベルの知能」であって「より多くの知能」ではない。 |
| AA タスクあたりコスト(II) | $1.06 | $1.99 | $3.26 | $5.98 | 5.6 Sol の半分、Astra の 3 分の 1、max 同士なら Opus 5.5 の約 18%。 |
| 幻覚率(AA-Omniscience) | 60% | 92% | 未報告 | 未報告 | ヘッドラインの正確さの勝利。 |
| 同ベンチマークの試み率 | 83% | 99% | — | — | ……そして落とし穴:より少なく答える。 |
| GDPval-AA v2.1(知識作業) | フロンティア比 約 −100 Elo | 未報告 | 未報告 | 1846 Elo(Anthropic 報告) | 専門性の高い知識作業を Sol に頼るな。 |
| 出力速度(AA 中央値) | 131 tok/s | 未報告 | 58 tok/s | 未報告 | 中位。Astra や Fable 5.1 より速く、Flash 級よりはるかに遅い。 |
| コンテキスト / 最大出力 | 1.05M / 128K | 1M / 32K | 1.05M / 128K | 1M / 128K | 仕様はベンダーのモデルページより。272K の課税閾値はファミリー共通。 |
どの行を信じる前にも、冷水を 3 はい。
ベンダーのスコアはベンダーのハーネスで動く。 OpenAI 発表の AutomationBench、Agents' Last Exam(Sol max 56.4%、Opus 5 の最高をコスト 60% 減で上回る)、DeepSWE(68.8% 対 Fable 5 の 69.9%、コスト約 80% 減)、OSWorld 2.0 offline(60.5% ≈ Opus 5 medium の 60.3%、コスト約 80% 減)はすべて自己報告です。発表自身の脚注が、評価は「本番 ChatGPT とは出力がやや異なりうる」研究環境または API で行われ、競合のスコアは公開レポートから取ったと認めています。方向づけには有用、福音ではありません。
インデックスの値は漂います。 1 日前に公開した私たちの GPT-6 Astra レビューが引用したとき、AA Intelligence Index は Astra 61.2、5.6 Sol 60.9 でした。同じトラッカーが今 listing しているのは Astra 53、Sol 48。Artificial Analysis はインデックスを版管理し再基準化します。モデルの比較は必ず同一スナップショット内で行い、週をまたいで比べないこと。
Effort の取り違えは、ローンチ週のチートコードです。 Sol の公開スコアはほぼ max、Opus 5.5 の見出し数字はしばしばデフォルトの medium。双方のレベルを明記しない「Sol が勝った/負けた」はマーケティングです。比較記事がコストを合わせた版の計算をやっています。
ベンチマークはここでは方位磁針であって物差しではありません。この時間帯でより重いのは、実際のタスクを計測した人々の報告です。そしてローンチ後 24 時間は、驚くほど整合的な信号の集合を返してきました。
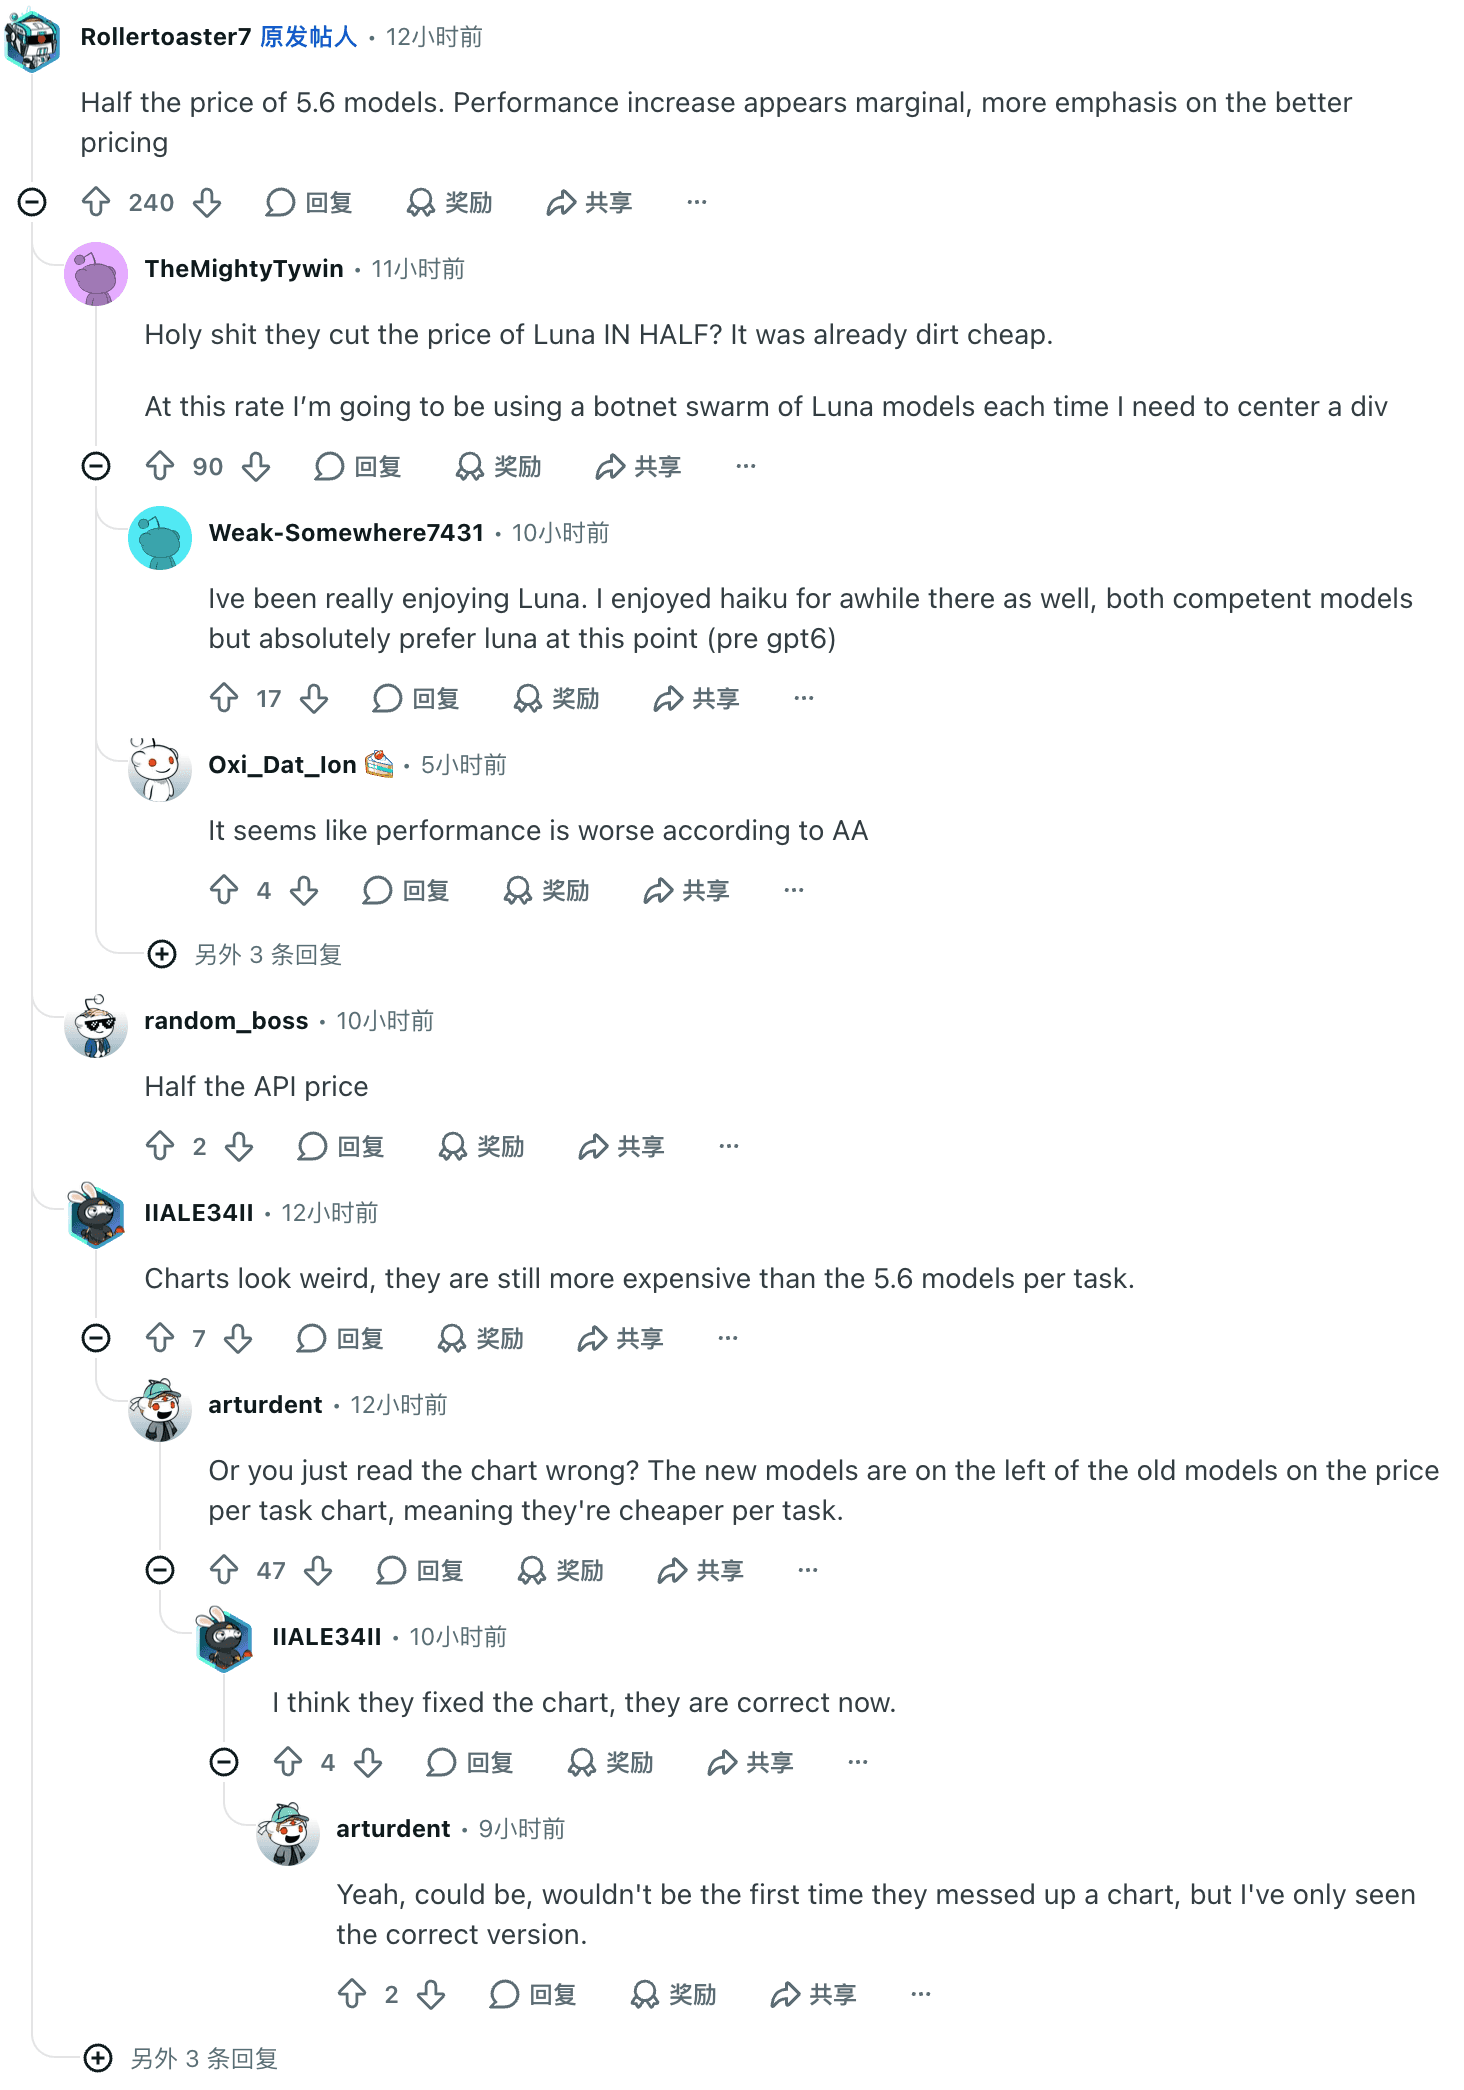
「価格は半額、性能の向上は微小」という読みは、r/codex のローンチスレッドで数時間のうちに最高評価のコメントになりました。スレ主 u/Rollertoaster7 の「Half the price of 5.6 models. Performance increase appears marginal, more emphasis on the better pricing」(5.6 モデルの半額。性能向上は微小に見える。強化されているのは価格のほう)は 240 評価を集め、別のユーザーが AA の一進一退の結果を直接引用しました(Reddit)。独立系評価機関の Vals AI も自社ベンチから同じプラトーに達しています。「GPT-6 Sol…は Vals Index の第 8 位。GPT 5.6 Sol とほぼ同等で、コストは半分」(X)。
GPT-6 Sol が本当に優れているところ
1. 事実性:自信満々の誤答が減った
棄答メカニズムはベンチマークの中の現象では終わりません。実パイプラインでは「流れに合わせない、反論してくるモデル」として現れます。Hacker News のある利用者は、別モデルのコードレビューへの「セカンドオピニオン」として Sol を使った様子をこう書きました。"i used it for code review and it flagged twenty issues, sol checked the review and found 75% of them were hallucinations. sol was much closer to reality."(コードレビューに使ったらあちらは 20 の問題を指摘。Sol がそのレビューを確認したところ、75% は幻覚だと判明。現実に近かったのは Sol のほうでした)(HN)。一つの逸事で率は証明できませんが、AA の計測と OpenAI の「ミス半分」の主張と、三方向からぴたりと噛み合っています。誤りが高いコストを払う workload――レビュー、抽出、コンプライアンス――にとって、これはどんなインデックスの点より重要な改善です。
2. トークン効率:静かな請求書カット
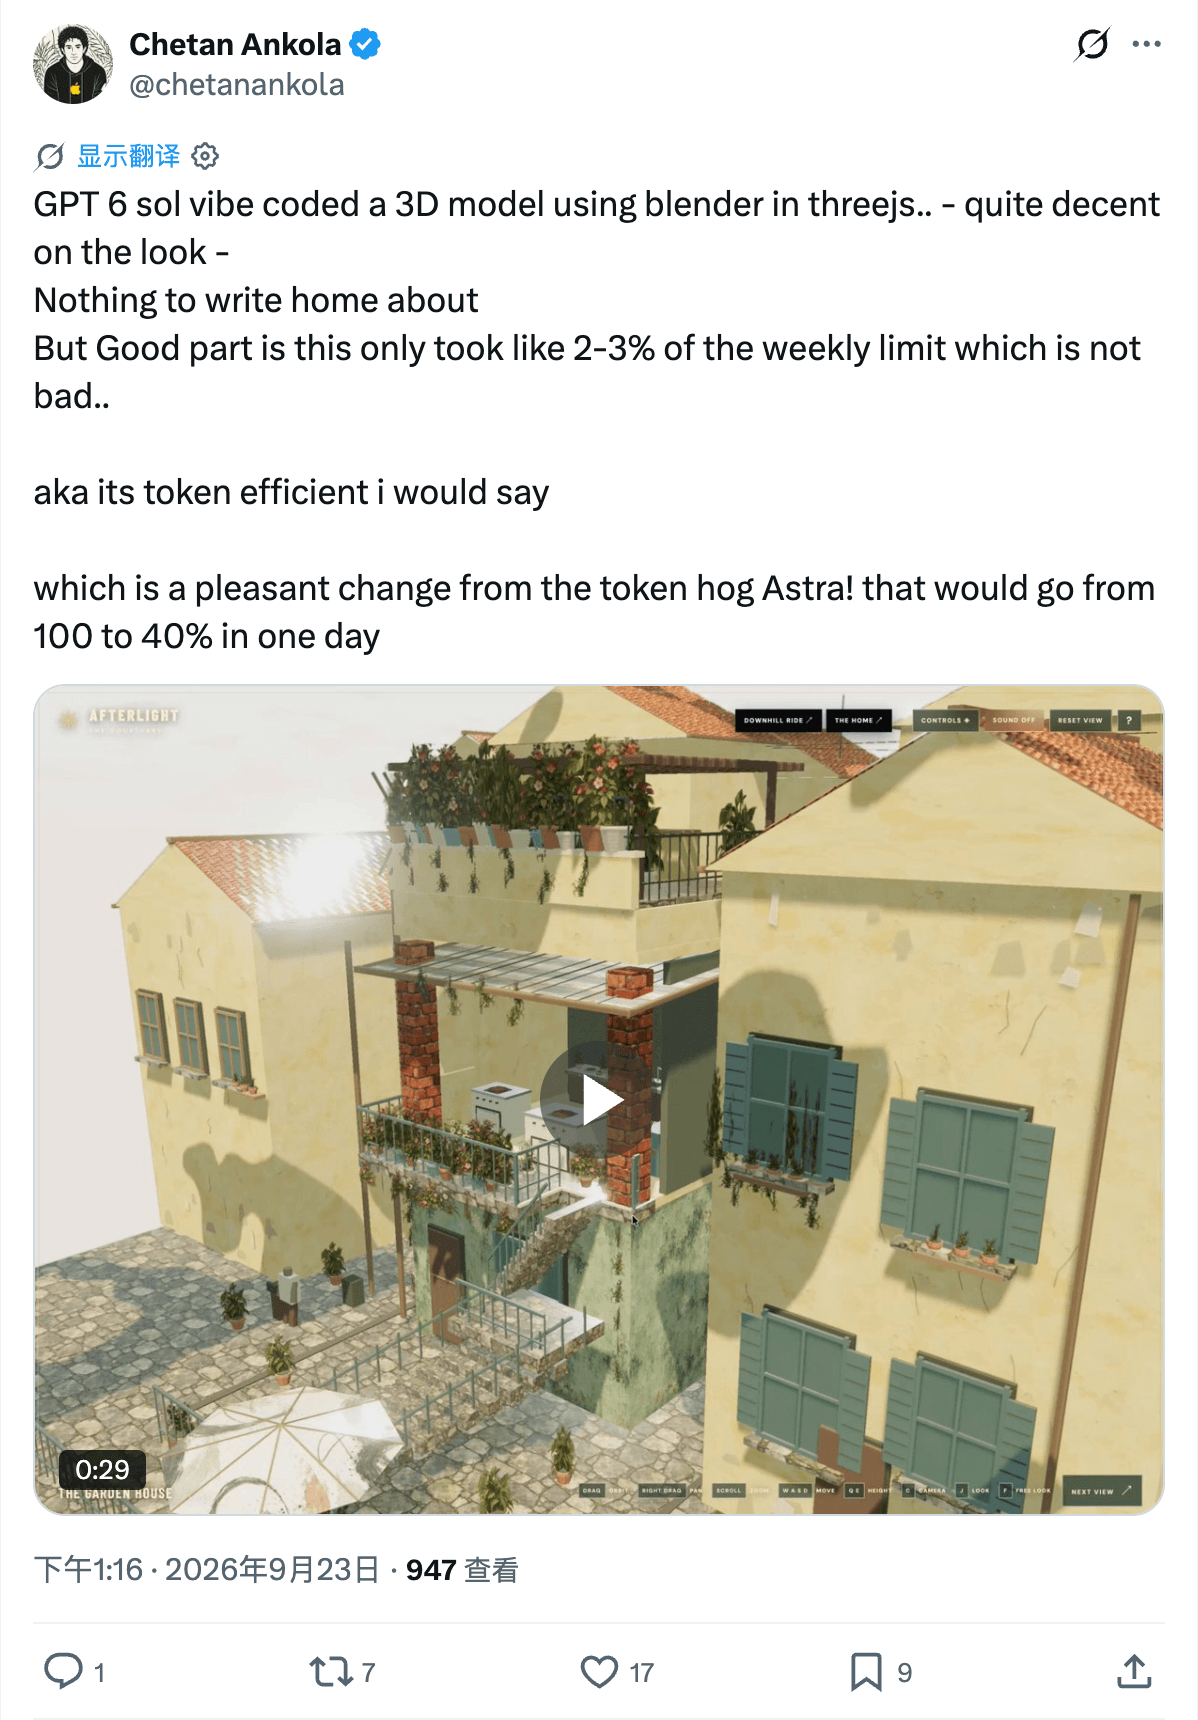
推論モデルは二重に課金されます。回答と、思考です。Sol の AA スイートでの生成量は 77M トークンで中央値 88M を下回り、サブスク勢も同じ「痩せた」消費に気づいています。r/codex では「自分の Codex のトークン使用量 < ブラックホール」と冗談になり、X ではある開発者が Blender/Three.js のタスクを計測して「週次リミットの 2〜3% しか使っていない…トークン効率は良いと言っていい。1 日で 100 から 40 まで溶けるトークン塊 Astra から変わって、心地よい変化だ」(X)。レートカードと合わせれば、OpenAI が「Sol(xhigh) は AutomationBench で Opus 5 (max) をタスクあたりコスト 9% で上回る」と主張することの少なくとも筋が通る理由がわかります。より少ないトークンを、より安い単価で、自動化の形をした仕事に。
3. ライティングと協業スタイル
OpenAI は、Astra で改善されたコミュニケーションスタイル――「より明確に、より少ない専門用語で」――が Sol にも引き継がれたと説明します。そしてこれは珍しくも、1 日以内に独立系のブラインドテストが裏付けたベンダー主張です。How I AI のブラインドベンチは「明快な文章、読みやすい PRD、そして価格」を Sol がいまだに勝っている項目に挙げました(Lenny's Newsletter)。コードと一緒にドキュメントを納品するチーム――仕様書、PRD、レビュー要約――にとって、どのリーダーボードの行にも載らない日々の品質改善です。
GPT-6 Sol が牙を剥くところ
1. 棄答税(abstention tax)
上記の強みはすべて鏡像を持ちます。83% しか質問に試みないモデルを無人のエージェントパイプラインに置くと、17% の空席を返してくるモデルになります。空席 1 つ 1 つが、滞留、リトライ、人間へのエスカレーションです。AA は回答 1 件ごとの代償も計測しています。試みた質問についての正確率は 59% から 54% へ低下。経済的価値のある知識作業を測る GDPval-AA v2.1 では、Sol はフロンティアの peer 比で約 100 Elo 下落しました。知識作業の天井は、そもそもこのモデルの狙いではありません。パイプラインが拒否を許容できないなら、初日からフォールバックモデルを予算に組み込んでください。
2. コミュニティの一部は「Terra の箱換え」と読んでいる
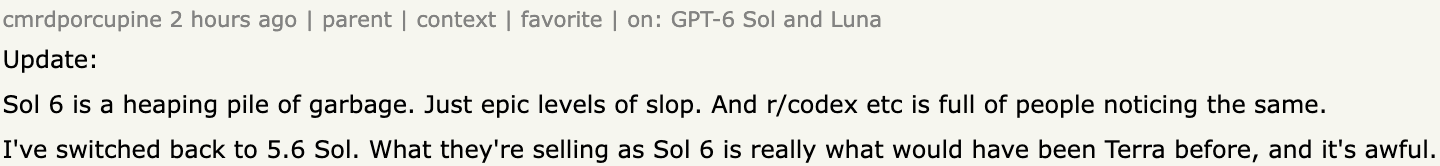
最も鋭いネガティブ報告は同じテーマに収束します。これは新世代ではなく、再プライシングだ、と。すでに巻き戻した Hacker News の開発者はこう書きました。"Update: Sol 6 is a heaping pile of garbage... I've switched back to 5.6 Sol. What they're selling as Sol 6 is really what would have been Terra before."(更新:Sol 6 はゴミの山だ…5.6 Sol に戻した。Sol 6 として売られているのは、以前なら Terra と呼ばれていたものだ)(HN)。r/codex でも同じ直感です。「使ってみて、確かにバカになった。Terra の感じ」("After having worked with it it's definitely dumber. Feels more like Terra")。計測された中間点はこうです。インデックスは平均として同水準。ただし「一部の評価で進歩、一部で退歩」ということは、個々のワークロードは退歩した側に乗ることも完全にありうる、ということ。あなたのプロンプトの組み合わせが退歩した評価の上に乗れば、体感は平均と矛盾します。両陣営が正しいのは、それと矛盾しません。
3. ローンチ週のプラットフォーム摩擦
今週の乗り換えを冷ます、現実的な摩擦が 3 つ。第一に可用性:Sol は有料プランの ChatGPT Work と Codex にはあるものの、Chat にはまだ来ていません。Free/Go ユーザーが受け取るのは GPT-6 Luna です(公式発表)。第二にサブスクの経済性:Plus ユーザーの一人は「5.6 では何時間も余裕だったのに、6 は数分で Plus の用量を溶かした。単純なプロンプトで数分間空回りした挙句、使用制限で諦めた」(HN)と報告しています。API が安くなっても、推論トークンはクォータを焼きます。第三に API の表面:レガシーな Chat Completions エンドポイントでは function calling が reasoning_effort: none のときしか動かず、ツール呼び出しのワークフローは Responses API へ。fine-tuning も非対応です(モデルカード)。使い勝手で 5.6 Sol に残るなら、そのプロモ価格は少なくとも 2026 年 11 月 21 日まで続き、私たちの 1M コンテキスト設定ガイドも引き続き有効です。

コミュニティは実際に何と言ったか
24 時間分のコミュニティの信号は、セクション 2 のあの軸に沿ってきれいに二分割されます。スキルやキャリアの長さではありません。
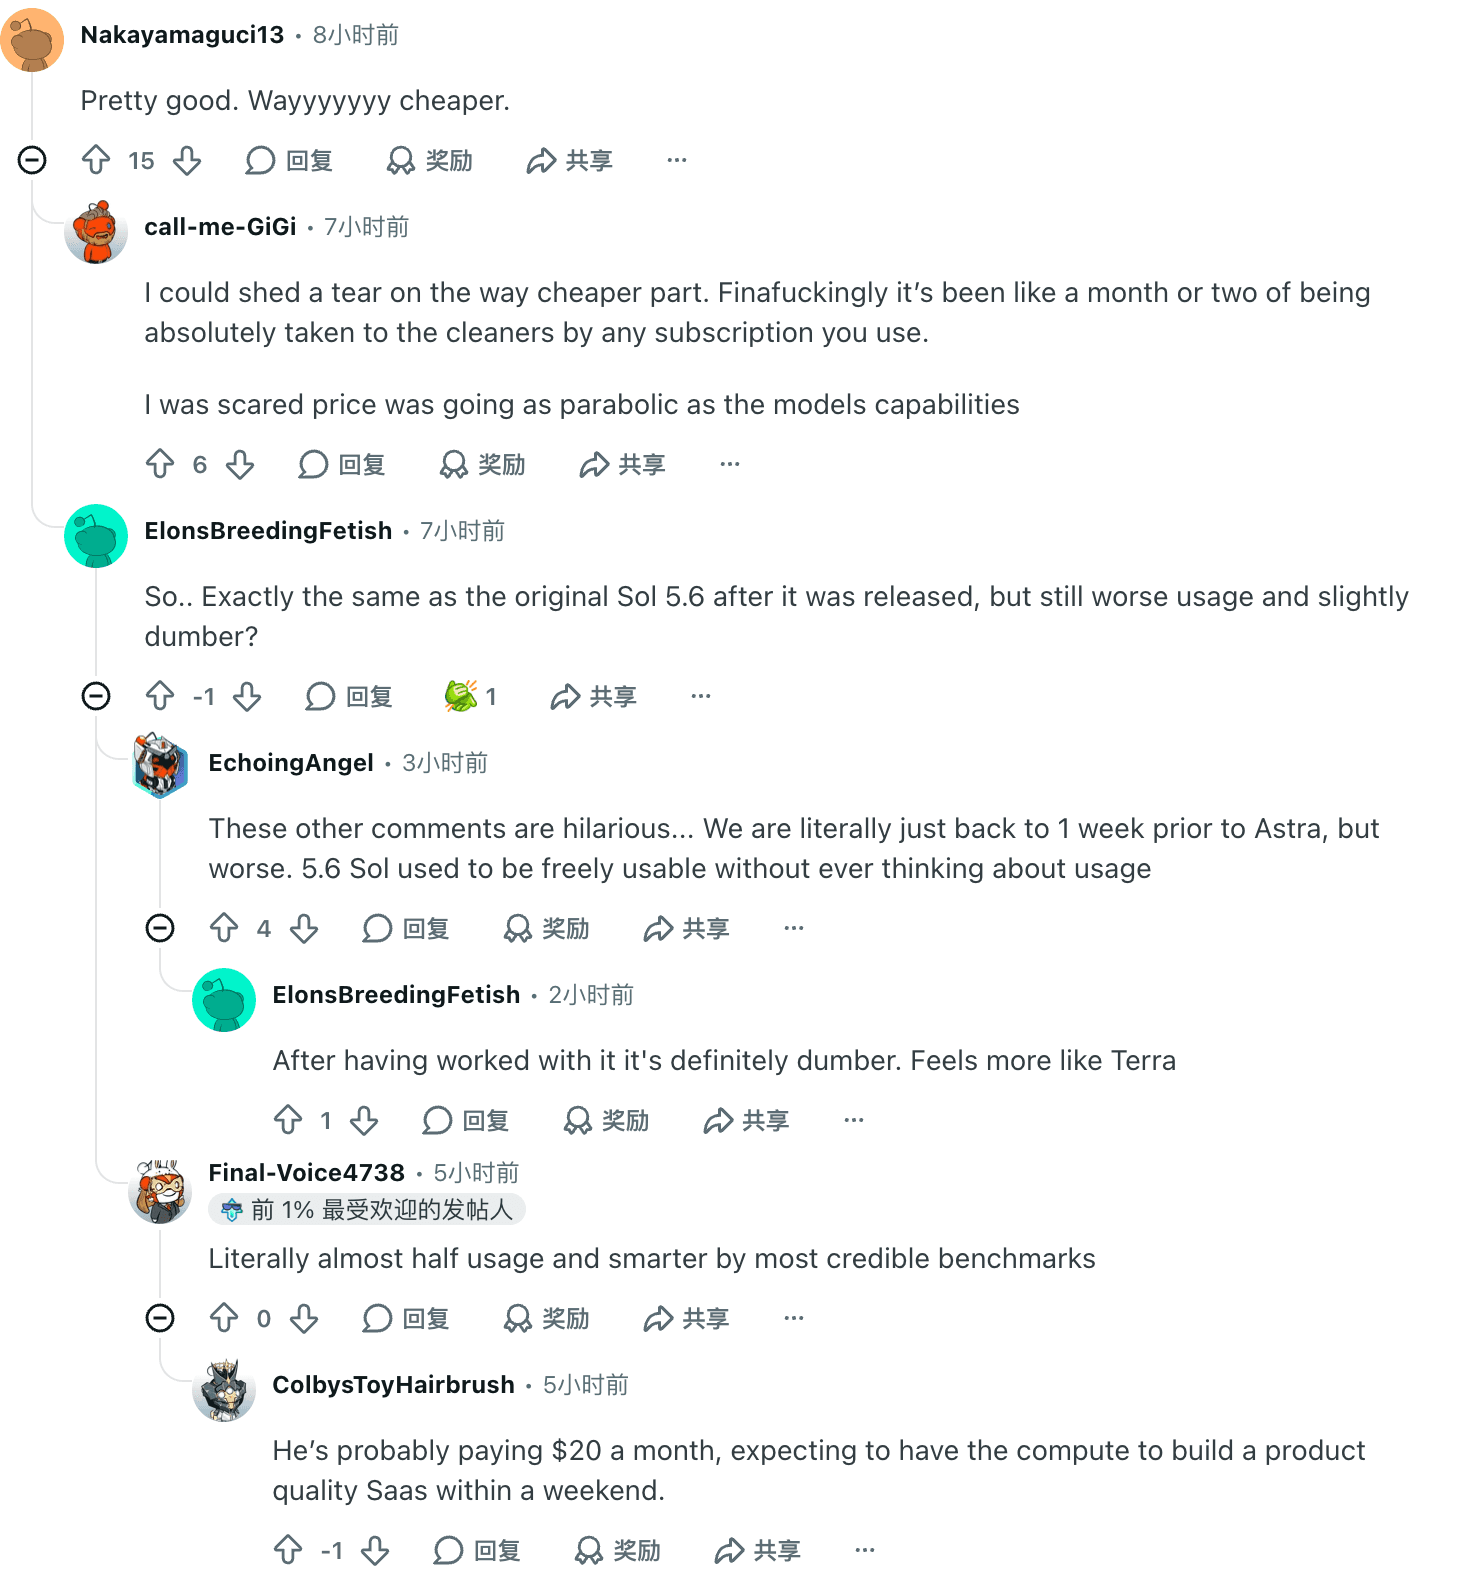
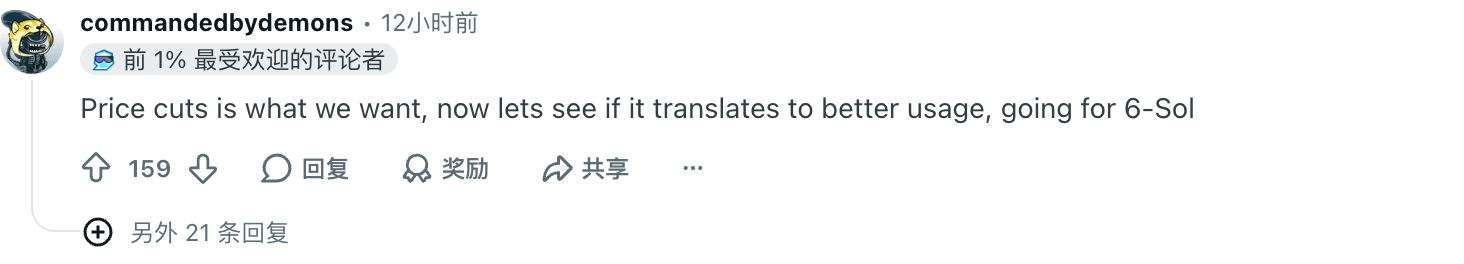
陣営 1:「半額こそアップグレード」 "Pretty good. Wayyyyyyy cheaper."(いいね。めちゃくちゃ安い)(u/Nakayamaguci13)。"Literally almost half usage and smarter by most credible benchmarks"(文字通り使用量はほぼ半分、まともなベンチマークの大半ではより賢い)(u/Final-Voice4738)。様子見の多数派が r/codex のスレッドを 159 評価まで押し上げました。"Price cuts is what we want, now lets see if it translates to better usage, going for 6-Sol"(値下げこそ欲しかったもの。これがより良い使い勝手に繋がるか見よう。6-Sol で行く)(u/commandedbydemons)。
陣営 2:「これは後継者ではなく再プライシングだ」 「確かにバカになった。Terra の感じ」(u/ElonsBreedingFetish)。「AA によれば性能はむしろ悪い」(u/Oxi_Dat_Ion)。上で引用した cmrdporcupine の巻き戻しが、この陣営の最重量級の発言です。
中間派が本当の情報を握っています。 Hacker News の u/mchusma は、ほとんどのチームが直面する本当の比較を名指ししました。"I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."(ごく初期のテストでは、max の GPT-6 Sol より medium の Opus 5.5 のほうを好んでいます。価格帯は近いが、能力が多い)(HN)。
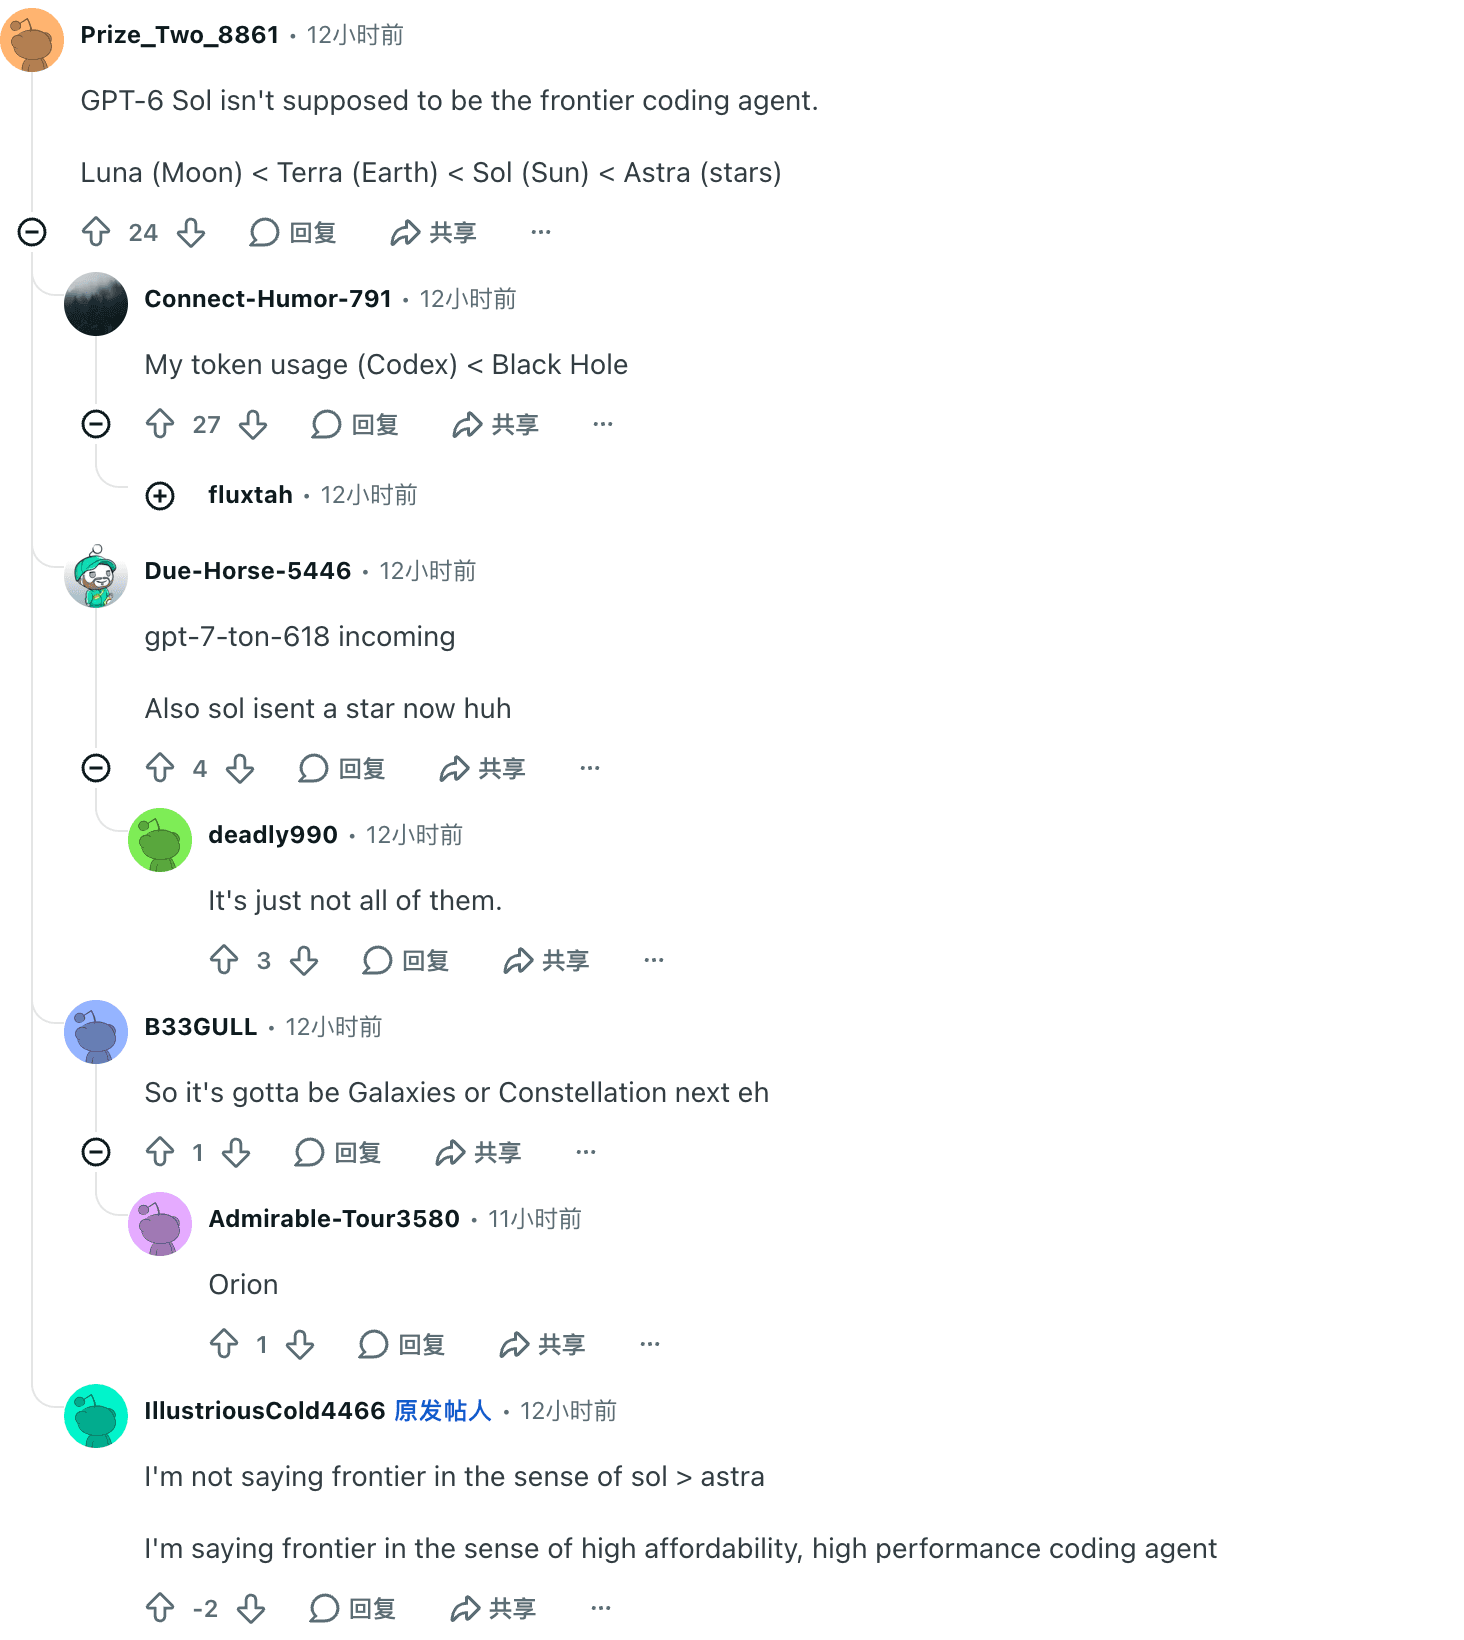

私たちの編集的読解はこうです。両陣営は同じ設計選択を、逆のワークロードから記述しています。誤りが高くつく場所では、Sol は前世代より賢く見える。カバレッジが貴重な場所では、より愚かに見える。ベンチマークは「同水準」と言い、両陣営とも自分の半分については正しいのです。
判定:ワークロードの形で選ぶ
| あなたのワークロード | 最適解 | 理由 | 注意点 |
|---|---|---|---|
| 大量の定例自動化、予算シビアなエージェントループ | GPT-6 Sol(xhigh) | AutomationBench で Opus 5 (max) をタスクあたりコスト 9% で上回る。xhigh で約 $0.53/タスク | コンテキストは 272K の課税クリフ以下に。キャッシュは 30 分窓 |
| 日常のコーディングとセカンドオピニオンのコードレビュー | GPT-6 Sol(high–max) | FrontierCode は Fable 5.1 xhigh と同等で大幅に安い。幻覚まじりの指摘を検出 | 棄答へのフォールバック経路を用意。引用は検証 |
| 30 分超のしつこい自己デバッグ、長時間の自律ラン | GPT-6 Astra | プレミアムが買うのは粘り強さ。Astra の総覧と Astra レビューを参照 | タスクあたりコスト 3 倍超。高 effort では初トークンが遅延 |
| 専門性の高い知識作業:法務、金融、深い分析 | Claude Opus 5.5 | Sol は GDPval で約 100 Elo 下落。Opus は II 58 で首位 | タスクあたりコストは最高水準。max では冗長 |
| ChatGPT 側の日々のチャット | 今は 5.6 に留まる(無料枠は Luna、Plus は 5.6 Sol) | Sol はまだ Chat に無い。6 世代のクォータ消耗は現実 | 留まるならプロモ価格と 1M コンテキスト設定の注記が続く |
| ライブなブラウザタブ横断のリサーチと自動化 | Tabbit + Sol(セレクターに現れたら) | モデルがタブやファイルの隣で走る。下記参照 | 可用性はアカウントのモデルセレクター次第 |
ひとこと判定:自動化とコーディングの予算は GPT-6 Sol に。知識作業の天井と、無人の長時間エージェントは動かさない。 OpenAI から今まで買ってきたのと同じ階層の知能を、表示価格半分で、新しい性格つきで買える――質問に答えないでおく道を選んでも、間違えて答えたくないタイプです。その職務記述書のまま採用してください。予算を確定させる前の但し書きも一つ。「50% 安い」の比較対象になっている GPT-5.6 の基準価格は、少なくとも 2026 年 11 月 21 日までのプロモ価格です。
GPT-6 Sol を、あなたの仕事が住む場所で走らせる:Tabbit
スコアシートはブラウザワークフローではありません。本当の仕事――リサーチ、比較、抽出、レビュー――は、開いた 20 のタブ、ローカルファイル、Web アプリに散らばっていて、生の API 呼び出しはそのどれも見えません。Sol を手動で繋ぐとは、ページの内容をプロンプトにコピーし、コンテキストウィンドウを自分で管理し、配管を作り直すことの繰り返しです。
ここで Tabbit Browser が、モデルレビューの中に一節を持つ価値が出てきます。Tabbit は agentic AI ブラウザで、モデルのワークフローをブラウジングのコンテキストに直接実行します。タブ横断のリサーチ、agentic な推論とディープリサーチタスク、ライブなページにまたがる自動化。アカウントのモデルセレクターに GPT-6 Sol が現れれば、オーケストレーターを書かずにそのワークフローを Sol に向けられ、タスクごとに安いモデルや強いモデルへ切り替えられます。半額で同水準の知能というモデルが最も報酬を与えるのは、まさにその規律です。
正直な境界を 2 つ。Tabbit 内のモデルの利用可否は接続アカウントとプラン次第です。Sol の周りにワークフローを組む前にセレクターを確認してください。そしてクライアントは OpenAI の課金を変えません。$2/$10 のカードはどちら道でも同じです。このモデルが実務でどう使われているかを見るには、GPT-6 Sol のモデルページ (English)、プロンプトディレクトリ (English)、コミュニティのレビューエビデンスベース (English)を覗いてください。
ベンチマークではなく、自分のタブの上で GPT-6 Sol を走らせる準備はできていますか?
 Tabbit Browser

よくある質問
GPT-6 Sol は GPT-5.6 Sol より優れていますか?
独立系の計測では知能はほぼ同等です。Artificial Analysis は GPT-6 Sol (max) の Intelligence Index を 48 とし、GPT-5.6 Sol と同水準、タスクあたりコストは半額($1.06 対 $1.99)としています。GPT-6 Sol は AA-Omniscience での幻覚率を 92% から 60% に下げましたが、それは質問の 83% しか試みないこと(前世代は 99%)で達成されています。このトレードが得かどうかは、誤答と無回答どちらがあなたのコストを支配するかで決まります。
GPT-6 Sol はなぜ拒答やスキップが増えたのですか?
Artificial Analysis は幻覚率の改善を棄答(abstention)に帰しています。GPT-6 Sol (max) は AA-Omniscience の質問の 83% しか試みず(GPT-5.6 Sol は 99%)、誤答は減るものの、回答した質問についての正確率は 59% から 54% に低下しました。エージェントパイプラインでは棄答はタスクの滞留や人間へのエスカレーションとして顕在化するため、拒否を失敗扱いせずフォールバック経路を用意すべきです。
GPT-6 Sol のタスクあたりコストはいくらですか?
Artificial Analysis の Intelligence Index では、GPT-6 Sol は max 努力レベルで約 $1.06/タスク。同じ $2/$10 のレートカードで effort を low から max まで動かすと約 $0.13〜$1.06 になり、effort の選択だけでコストが約 8 倍動きます。完全なレートカード、キャッシュ規則、272K 長文コンテキストの閾値は GPT-6 Sol の料金ガイドにまとめています。
GPT-6 Sol と GPT-6 Astra、どちらを使うべきですか?
コスト重視の大量コーディングや自動化には GPT-6 Sol、長時間の自律ランで粘り強さが要る場面には GPT-6 Astra を。Sol の AA Intelligence Index は 48、Astra は 53 ですが、Sol のタスクあたりコストは Astra の約 3 分の 1。両者とも 272K の長文コンテキスト課税閾値を共有します。Astra のプレミアムが正当化される場面は GPT-6 Astra レビューを参照してください。
GPT-6 Sol は ChatGPT で使えますか?
Chat にはまだ届いていません。ローンチ時点で GPT-6 Sol は Plus・Pro・Business・Enterprise・Edu 向けに ChatGPT Work と Codex で利用可能で、Free・Go ユーザーのデスクトップアプリで受け取るのは GPT-6 Luna です。OpenAI は Chat への展開を段階的に進めると説明しており、API のモデル ID は gpt-6-sol です。ワークフローを預ける前に自分のプランのモデルセレクターを確認してください。
Tabbit Browser で GPT-6 Sol は使えますか?
Tabbit Browser は開いているタブ、ローカルファイル、ライブな Web セッションを横断するマルチモデルワークフローに対応し、接続アカウントや API アクセスに GPT-6 Sol が含まれればモデルセレクターに表示されます。利用可否はアカウント次第で、クライアントを使っても OpenAI の課金は変わりません。ダウンロード前に GPT-6 Sol のプロンプトディレクトリでタスクレシピを確認できます。