
2026년 9월 22일, 두 개의 프론티어 모델이 같은 날 착륙했습니다. OpenAI는 GPT-6 Sol(gpt-6-sol)을 출시했습니다. GPT-6 Luna와 함께 나온, 코딩과 에이전트에 특화된 모델입니다. Anthropic은 Claude Opus 5.5(claude-opus-5-5)을 출시했습니다. Opus 5의 후속으로, 더 낮은 가격에 자사 최강의 올라운드 모델을 표방합니다. 이번 주 둘 사이에서 고르고 있다면, 당신이 비교하는 것은 승자와 패자가 아닙니다. 모델의 가격 책정과 튜닝에 관한 두 가지 완전히 다른 이론입니다.
자율 에이전트와 멀티 페이지 리서치 시스템에 기반 모델을 연결하는 일을 매일 하는 엔지니어로서, 저는 출시 당일 모델을 본사 본인들이 평가하지 않습니다. 다음 내용은 공식 모델 카드와 발표, 그리고 출시 후 처음 24시간 이내에 공표된 독립 측정에 근거합니다. 그리고 모든 벤치마크에 에포트 레벨을 명시합니다. 출시일 비교의 대부분이 바로 그 지점에서 조용히 속이기 때문입니다.
GPT-6 Sol 요금표만 필요하다면 전용 GPT-6 Sol 가이드를 읽으세요. OpenAI 쪽 형제 모델은 GPT-6 Astra 리뷰와 GPT-6 Astra 개요를 참조하세요. Anthropic 쪽은 Claude Fable 5.1 리뷰가 Opus 5.5 아래 미드티어의 진화를 다룹니다. 원시 사양은 GPT-6 Sol 모델 페이지 (English)와 Claude Opus 5.5 모델 페이지 (English)에서도 확인할 수 있습니다. 이 글은 직접적인 실무 비교입니다.
핵심 요약
한쪽의 기본값이 다른 쪽의 상한을 이긴다: Claude Opus 5.5는 기본 medium 레벨에서 지능 지수 태스크당 51.2점, $1.34를 기록해 GPT-6 Sol의 최고 max 설정(47.5점, $1.06)을 앞섭니다. 요구 지능이 약 44점 이상인 영역에서 Opus 5.5가 비슷한 비용으로 승리합니다.
Sol의 2배 가격 할인에는 명확한 만료일이 있다: 캐시되지 않은 요금은 Opus 5.5의 절반(백만 토큰당 $2.00/$10.00 대 $4.00/$20.00)이지만, 요청 입력이 272K 토큰을 넘으면 Sol 요청 전체가 롱컨텍스트 요금 $4.00/$15.00으로 전환됩니다. 할인이 아니라 동가입니다.
일상 자동화는 Sol의 본진: AutomationBench-AA에서 Sol의 xhigh(61.7%)는 약 40% 더 낮은 비용으로 Opus 5.5의 medium(61.2%)과 동률이며,
none레벨은 확장 사고를 완전히 끌 수 있습니다.터미널과 프론티어 코딩 작업은 Opus 5.5의 것: medium에서도 Terminal-Bench 4.0에서 8.6포인트 차이로 앞섭니다(52.5% 대 Sol max의 43.9%). Anthropic이 보고한 xhigh는 66.4%입니다.
장황함은 청구 변수다: max에서 Opus 5.5는 태스크당 약 119K 출력 토큰을 만들고 Sol은 약 31K입니다. 출력 백만 토큰당 $20로 청구되므로 이 3.8배 격차는 오픈 엔드 태스크에서 실제 청구서 차이로 누적됩니다.
이 대결을 결정하는 하나의 숫자: 기본값이 상한을 이기다
이 비교의 중심 긴장은 출시일 본도 대부분 놓친 한 쌍입니다. 2026년 9월 23일 기준 독립 측정에서는 Claude Opus 5.5의 기본 medium이 지능 지수 51.2점, 태스크당 $1.34입니다. GPT-6 Sol의 최고 max 설정은 47.5점, 태스크당 $1.06입니다.
달러당 점수(독립 측정, 2026-09-23):
Claude Opus 5.5  medium(기본값):  51.2점   $1.34/태스크
GPT-6 Sol        max   (상한):     47.5점   $1.06/태스크

교차점: 요구 점수 약 44점 미만에서는 Sol이 더 저렴하고,
44점 이상에서는 Opus 5.5가 비슷한 비용으로 명확히 이긴다.
한쪽 벤더의 초기 설정이 교차점 이상에서 점수와 달러당 점수를 모두 이겨 다른 쪽의 최대 설정을 압도합니다. 이것이 "기본값이 상한을 이긴다" 역설이며, 출시 후 몇 시간 이내의 커뮤니티 초기 테스트에서도 확인됐습니다.
두 번째 숫자는 Sol의 가격 우위가 실제로 어디서 성립하는지를 결정합니다. OpenAI의 요금표는 깔끔합니다. 표준 짧은 컨텍스트 요청은 백만 토큰당 입력 $2.00, 출력 $10.00. Opus 5.5의 $4.00/$20.00의 정확한 절반입니다. 그러나 모델 카드에는 대부분의 헤드라인이 걸러 넘긴 임계값이 있습니다. 요청 입력이 272K 토큰을 넘으면 요청 전체가 롱컨텍스트 요금으로 청구됩니다. 입력 $4.00, 캐시 읽기 $0.40, 캐시 쓰기 $5.00, 출력 $15.00. 이 시점에서 자사가 광고하는 1,050,000 토큰 컨텍스트 안에서 Sol은 Opus 5.5와 같거나 더 비싸집니다. Opus 5.5의 1M 컨텍스트에는 동등한 절벽이 없습니다.
백만 토큰당 유효 입력 비용:
272K 입력 이하:  Sol $2.00  대  Opus 5.5 $4.00  --> Sol이 절반
272K 입력 초과:  Sol $4.00  대  Opus 5.5 $4.00  --> 동가(출력 $15 대 $20)
워크로드가 컴팩트한 컨텍스트의 에이전트 루프, 즉 에이전틱 리서치 시스템이 사는 영역이라면 Sol의 할인은 실제 돈입니다. 코드베이스 전체 또는 방대한 문서 코퍼스를 프롬프트에 채우는 워크로드라면, 할인은 컨텍스트 윈도우가 가장 필요한 순간에 정확히 증발합니다.
사양 및 가격 한눈에 보기
두 모델 모두 백만 토큰 컨텍스트와 단계적 에포트 레벨을 광고하지만, 메커니즘 차이는 비용 엔지니어링에 영향을 줍니다. 아래 요금은 백만 토큰당 미국 달러이며 2026년 9월 23일 양쪽 공식 모델 카드로 확인했습니다.
| 항목 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| API 식별자 | gpt-6-sol | claude-opus-5-5 |
| 컨텍스트 윈도우 | 1,050,000 토큰 | 1,000,000 토큰 |
| 최대 출력 | 컨텍스트 이하로 별도 상한 없음 | 128,000 토큰(Batch 베타 300K) |
| 에포트 레벨 | none / low / medium(기본) / high / xhigh / max | low / medium(기본) / high / xhigh / max |
| 확장 사고 토글 | 끌 수 있음(none) | 끌 수 없음 |
| 입력(캐시 안 됨) | $2.00(272K 초과 시 $4.00) | $4.00 |
| 캐시 입력 읽기 | $0.20(272K 초과 시 $0.40) | $0.20(Opus 5 대비 약 60% 할인) |
| 캐시 입력 쓰기 | $2.50(272K 초과 시 $5.00) | $5.00 |
| 출력 | $10.00(272K 초과 시 $15.00) | $20.00 |
| Batch 가격 | 표준의 50%(Flex) | 입력 $2.00 / 출력 $10.00 |
| 고속 티어 | 표준의 2× | $8.00 / $40.00(약 2.5× 속도) |
| 지식 컷오프 | GPT-6 패밀리 세대 | 2026-06 |
| 벤더 비용 주장 | — | 전형적 워크로드 기준 Opus 5 대비 약 40% 저렴(벤더 주장) |
주목할 엔지니어링 세부 사항은 세 가지입니다. 첫째, Sol의 none 레벨은 독보적입니다. 확장 사고를 완전히 꺼서 Opus 5.5가 재현할 수 없는 결정론적 저지연 모드를 제공합니다. 둘째, 두 모델의 캐시 읽기는 모두 백만 토큰당 $0.20이므로 캐시 적중률이 높은 운영 파이프라인에서는 청구서의 입력 측이 동률이 되고 출력 장황함이 결정 변수가 됩니다. 셋째, Anthropic의 "Opus 5 대비 약 40% 저렴" 주장은 벤더 프레이밍이며, 뒤에서 다루겠지만 커뮤니티 재계산은 실제 워크로드에서 사실상 동률에 가까웠습니다.
구체적인 예시로 레벨 메커니즘을 확인해 보겠습니다. 월 5만 태스크, 태스크당 40K 입력 토큰(캐시 적중률 90%), 2K 출력 토큰, medium급 레벨로 정렬, 모두 272K 임계값 이하인 자동화 파이프라인을 가정합니다.
GPT-6 Sol(태스크당: 캐시 안 된 입력 4K×$2.00 + 캐시 읽기 36K×$0.20 + 출력 2K×$10.00): $0.008 + $0.0072 + $0.020 = $0.0352 → 월 $1,760
Claude Opus 5.5(태스크당: 캐시 안 된 입력 4K×$4.00 + 캐시 읽기 36K×$0.20 + 출력 2K×$20.00): $0.016 + $0.0072 + $0.040 = $0.0632 → 월 $3,160
같은 파이프라인을 Sol이 돌리는 비용은 약 44% 저렴합니다(Opus 5.5 청구액의 약 56%). 이제 태스크당 입력을 300K 토큰으로 바꿔 보겠습니다. Sol 요청 전체가 롱컨텍스트 요금(캐시 안 됨 $4.00, 캐시 읽기 $0.40, 출력 $15.00)으로 전환되어 $12,900 대 Opus 5.5의 $10,700이 됩니다. 명목상 더 저렴한 모델이 오히려 20% 더 비싸집니다. 이 임계값은 각주가 아니라 롱컨텍스트 아키텍처의 결정 변수입니다.
벤치마크, 그리고 얼마나 믿어야 하는가
출시일 벤치마크 표는 독립 연구소가 재현하기 전까지는 마케팅 자료입니다. 아래 표는 벤더 보고치(표기됨)와 독립 측정을 섞은 것이며, 그 뒤의 네 가지 보정 주의사항이 어떤 단일 숫자보다 중요합니다.
| 벤치마크 | Claude Opus 5.5 | GPT-6 Sol | 해석 |
|---|---|---|---|
| 지능 지수(점수 / 태스크당 $) | 51.2 / $1.34(medium) | 47.5 / $1.06(max) | Opus 기본값이 Sol 상한 위. 44점 미만은 Sol이 저렴 |
| Terminal-Bench 4.0 | 52.5%(medium); 66.4%(xhigh, 벤더, ±2.6 표준오차) | 43.9%(max); 44%(독립) | Opus가 터미널/에이전트 CLI에서 약 9포인트 선두 |
| AutomationBench-AA | 61.2%(medium) | 61.7%(xhigh) | 통계적 동률. Sol은 비용이 약 40% 저렴 |
| GDPval-AA v2.1 | 1846 Elo(벤더) | 프론티어 대비 약 100 Elo 후퇴(독립) | Opus가 지식 작업 평가에서 강함 |
| Humanity's Last Exam(도구 사용) | 67.7%(max, 벤더) | 이번 주기에 독립 검증 안 됨 | 방향성 참고만 |
이 중 무엇이든 결론으로 취급하기 전에 네 가지 보정이 적용됩니다.
레벨 불일치가 가장 흔한 부정행위입니다. 출시 당시 유통된 Sol의 숫자 대부분은 max나 xhigh에서 왔고 Opus의 숫자는 medium 기본값에서 왔습니다. 양쪽 레벨을 명시하지 않는 주장은 튜닝된 설정과 튜닝되지 않은 설정을 비교하는 것입니다. 이 글은 항상 레벨을 명시합니다.
벤더 보고에는 벤더 낙관주의가 붙습니다. Opus 5.5의 Terminal-Bench 66.4%와 HLE 67.7%는 Anthropic이 명명된 조건으로 보고한 수치이며 Terminal-Bench에는 ±2.6의 표준오차가 있습니다. Sol의 $1.06/태스크와 환각률 수치는 Artificial Analysis의 독립 측정입니다. 독립 수치에 더 높은 가중치를 두세요.
Sol의 환각률 개선은 일부 거부로 얻은 것입니다. 독립 측정에서 Sol의 환각률은 92%에서 60%로 낮아졌지만, 그것은 훨씬 더 자주 거부함으로써 달성된 측면이 큽니다. 에이전트 파이프라인에서 거부는 공짜가 아닙니다. 멈춘 태스크나 인간 에스컬레이션으로 표면화되며, 벤치마크 백분율은 그것을 숨깁니다.
장황함은 Opus의 출력 요금 프리미엄을 증폭합니다. max에서 Opus 5.5는 태스크당 약 119K 출력 토큰을 만들고 Sol은 약 31K입니다. $20/M 대 $10/M 출력 요금과 결합하면, 고 에포트의 오픈 엔드 태스크는 요금 비율이 암시하는 것보다 몇 배 더 비싸질 수 있습니다. 낮은 레벨에서는 격차가 상당히 좁아집니다.
Claude Opus 5.5가 진짜로 이기는 곳
Opus 5.5는 더 저렴한 모델이 아니며, 그렇게 하려고도 하지 않았습니다. 청구서가 아니라 태스크 품질의 상한이 제약이 되는 곳에서 이깁니다.
1. 터미널과 프론티어 코딩 에이전트 작업
가장 명확한 구조적 우위는 Terminal-Bench 4.0, 자율 명령줄 소프트웨어 공학을 측정하는 벤치마크입니다. Opus 5.5는 medium에서 52.5%, Sol은 max에서 43.9%입니다. 양사가 명확히 노리는 워크로드 군, 멀티스텝 셸 환경과 빌드-수정 루프, 테스트 주도 수리에서 약 17%의 상대 격차입니다. Anthropic이 보고한 xhigh 66.4%는 격차를 더 벌리지만 앞서 언급한 벤더 보고 주의사항이 따릅니다.
2. 지식 작업과 일반 지능 평가
직업적 지식 작업 평가 GDPval-AA v2.1에서 Anthropic은 1846 Elo를 보고합니다. 독립 측정에서는 Sol이 같은 계열 평가에서 비교 가능한 프론티어 대비 약 100 Elo 후퇴했습니다. 이는 Sol의 포지셔닝과 일치합니다. 코딩과 자동화 전문가가 일반 지식의 폭을 비용 효율과 맞바꾼 것입니다. 연구 종합, 문서 분석, 개방 영역 추론에서는 Opus 5.5의 상한이 더 높습니다. Anthropic 미드티어 Claude Fable 5.1에 대한 우리의 본보기는 이 패밀리가 Opus 가격대 아래에서 일반 능력을 얼마나 밀어붙였는지의 맥락으로 유용합니다.
3. 기본값 경험
Opus 5.5의 가장 과소평가된 특성은 기본값이 강한 설정이라는 점입니다. medium 레벨은 교차점 이상에서 Sol의 max보다 달러당 점수가 좋아, 에포트 예산 튜닝에 시간을 쓸 수 없는 팀도 처음부터 프론티어 수준을 얻습니다. 반면 Sol의 최적 가치는 의도적인 설정을 요구합니다. 결정적 태스크에는 none, 자동화에는 xhigh를 선택하고, max에서도 일반 능력으로는 Opus 기본값에 뒤진다는 점을 받아들여야 합니다.
GPT-6 Sol이 진짜로 이기는 곳
Sol의 논리는 "좀 더 싸고 거의 비슷하다"가 아닙니다. 다른 비용 아키텍처의 세 가지 구체적 우위입니다.
1. 표시 가격이 정확히 절반, 사고 끄기 스위치 포함
캐시되지 않은 짧은 컨텍스트에서 백만 토큰당 $2.00 입력, $10.00 출력의 Sol은 Opus 5.5보다 50% 저렴합니다. 그리고 프론티어 경쟁 제품에 없는 것을 제공합니다. none 레벨은 확장 사고를 완전히 끕니다. 고처리량 구조화 추출, 분류, 템플릿 생성에서는 멈추지 않는 모델에 비용을 지불하는 것이 낭비입니다. Sol은 추전 미터를 끌 수 있습니다. 이 요금표가 다른 벤더와 어떻게 비교되는지는 같은 총비용 방법을 쓴 Kimi K3 가격 분석을 참조하세요.
2. 능력이 맞물리는 곳의 자동화 비용 효율
AutomationBench-AA에서 Sol의 xhigh는 61.7%, Opus 5.5의 medium은 61.2%. 통계적 동률을 태스크당 약 40% 더 싸게 제공합니다. 파이프라인이 브라우저 자동화, DOM 추출, 폼 탐색, 도구 오케스트레이션이라면 Sol이 합리적인 기본값입니다. 능력은 같고 청구서는 다릅니다.
3. 출력 규율
Sol은 max에서 태스크당 약 31K 출력 토큰을 만들고 Opus 5.5는 약 119K입니다. 유계 산출물, JSON 페이로드, 패치 diff, 구조화된 요약을 만들어야 하는 에이전트에게 Sol의 간결함은 제한이 아니라 기능입니다. 파싱할 토큰이 줄고, 청구될 토큰이 줄고, 사후 수정 루프의 여지가 줄어듭니다.
개발자와 커뮤니티의 진짜 목소리
동시 출시 후 24시간 이내에, 개발자 포럼은 대부분의 출시일 본보기보다 많은 신호를 냈습니다. 2026년 9월 23일에 수집한 여섯 가지 대표적인 목소리입니다.
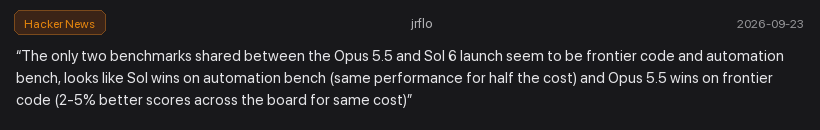
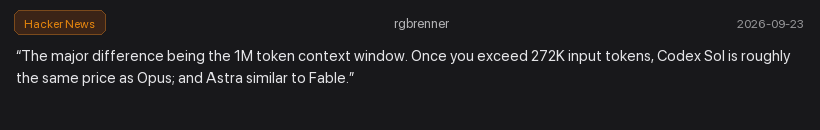
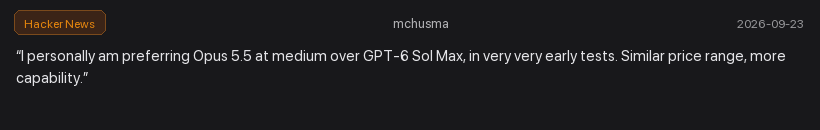
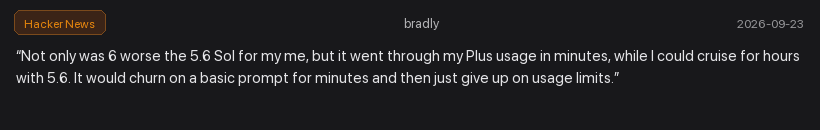
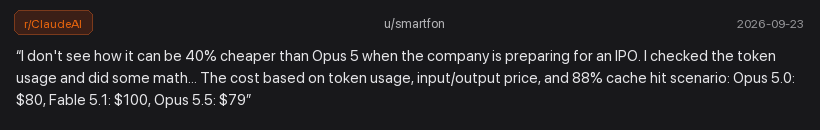
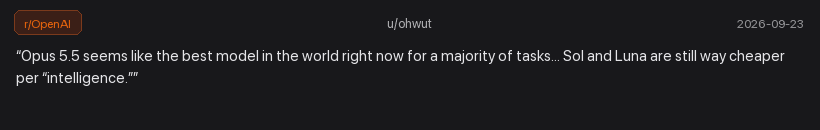
이 여섯 목소리가 보여 주는 패턴은 측정 데이터와 일치합니다. 커뮤니티는 단일 승자를 추대하지 않았습니다. 워크로드 경계로 갈렸습니다. 자동화와 비용 효율은 Sol로, 프론티어 코딩과 일반 능력은 Opus 5.5로. 그리고 즉시 레벨 정렬과 총비용 회계에 주목했지, 순위표 상의 자리가 아니라.
결론: 워크로드 결정 매트릭스
| 워크로드 | 추천 모델 | 결정적 근거 | 비용 참고 |
|---|---|---|---|
| 터미널 에이전트와 CLI 주도 코딩 | Claude Opus 5.5 | Terminal-Bench 4.0에서 medium이 약 9포인트 선두(52.5% 대 Sol max 43.9%) | 요금 2배, 능력 격차가 정당화 |
| 고처리량 브라우저 자동화와 추출 | GPT-6 Sol | AutomationBench-AA 동률(61.7% xhigh 대 61.2% medium), 결정적 태스크에는 none | 태스크당 약 40% 저렴 |
| 컴팩트 컨텍스트 에이전트 루프(입력 < 272K) | GPT-6 Sol | 캐시 안 된 2배 할인이 완전히 성립. 캐시 읽기 동가($0.20/M) | Opus 5.5 요금의 절반 |
| 롱컨텍스트 작업(입력 > 272K) | Claude Opus 5.5 | Sol의 롱컨텍스트 반전($4/$15)이 할인을 지움. Opus에는 동등한 절벽 없음 | 반전된 Sol 요금과 비교해 동률 이상 |
| 오픈 엔드 리서치와 지식 작업 | Claude Opus 5.5 | GDPval-AA와 HLE에서 상한이 높음. 기본 medium이 44점 이상에서 Sol max 승리 | max의 장황함 세금이 높음 |
| 예산 제약이 있는 일반 어시스턴트 | GPT-6 Sol | max에서 지능 지수 $1.06/태스크. 약 44점 교차점 이하에서 최저가 | 단위 지능당 최저 비용 |
원시 모델 토큰에서 브라우저 실행까지: Tabbit 워크플로
벤치마크 점수는 웹사이트를 긁거나, 인증된 세션을 유지하거나, 열린 40개의 탭 사이에서 모순되는 문서를 맞춰 보지 않습니다. 원시 기반 모델은 텍스트에 대해 추론합니다. 탭 난립, 동적 섀도 DOM, 멀티스텝 웹 워크플로를 스스로 관리하지 않습니다.
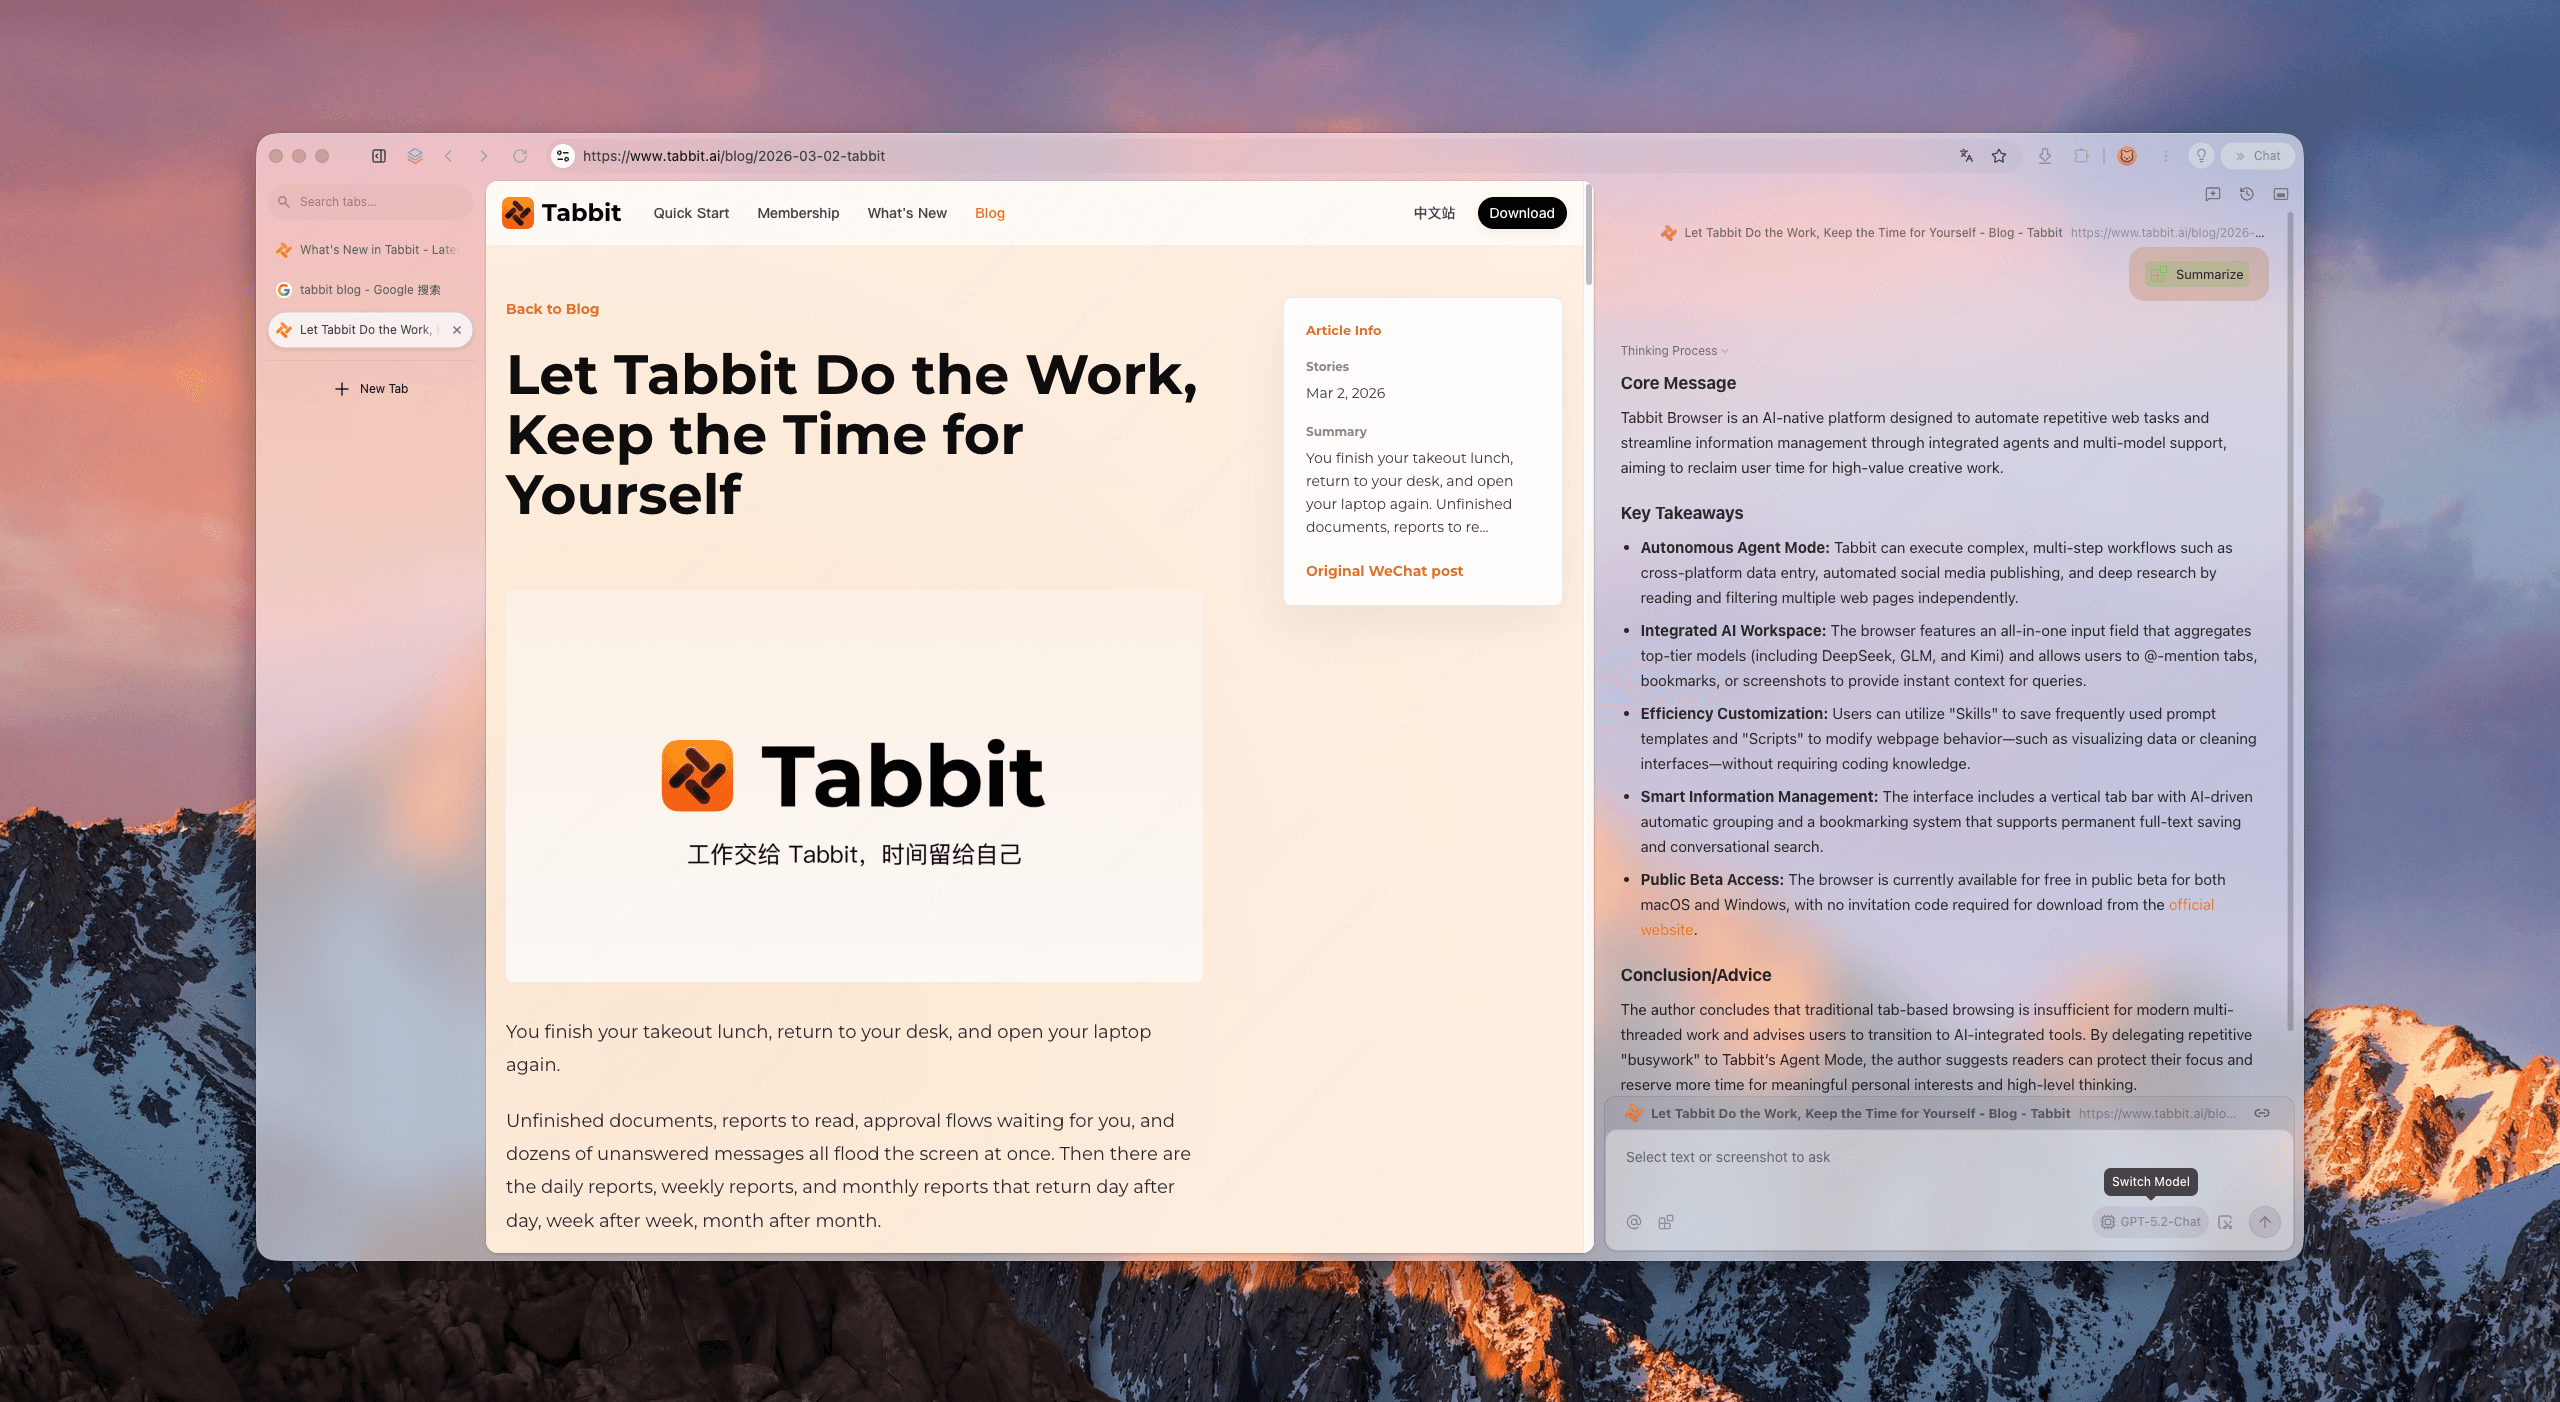
여기서 오케스트레이션 환경이 중요해집니다. Tabbit Browser에서 브라우저 에이전트를 실행할 때, 모델은 추론을 담당하고 브라우저 층은 메모리, 탐색, 실행을 담당합니다. GPT-6 Sol로 컴팩트한 자동화 루프를 돌리든 Claude Opus 5.5로 터미널급 코딩 에이전트를 돌리든, AI 네이티브 에이전틱 브라우저가 토큰 가격을 완성된 작업으로 바꾸는 것입니다. 전체 그림은 2026년 최고의 AI 브라우저 모음을 참조하세요.
참고: 플랫폼 정책에 따라 Tabbit에서의 실시간 모델 사용 가능 여부는 계정의 활성 모델 선택기, 지원되는 통합, 플랫폼 약관에 따라 달라집니다. 이 비교는 사내 벤치마크 실행이 아닌 공식 자료와 독립 측정에 근거합니다.
 Tabbit Browser

자주 묻는 질문
GPT-6 Sol과 Claude Opus 5.5 중 어떤 것이 더 저렴한가요?
캐시되지 않은 짧은 컨텍스트 요금 기준으로 GPT-6 Sol은 Opus 5.5의 정확히 절반입니다. 백만 토큰당 입력 $2.00, 출력 $10.00이며 Opus 5.5는 $4.00과 $20.00입니다. 다만 요청의 입력이 272K 토큰을 넘으면 Sol 요청 전체가 롱컨텍스트 요금(입력 $4.00, 출력 $15.00)으로 전환되어 할인이 사라집니다. 캐시 읽기는 두 모델 모두 백만 토큰당 $0.20입니다.
벤치마크 점수는 어느 모델이 더 높은가요?
비교하는 에포트 레벨에 따라 다릅니다. Claude Opus 5.5는 기본 medium 레벨에서 지능 지수 51.2점, 태스크당 $1.34를 기록하고, GPT-6 Sol은 최고 max 레벨에서 47.5점, $1.06입니다. Opus 5.5는 Terminal-Bench 4.0에서도 앞서지만(medium 52.5%, Anthropic 보고 xhigh 66.4%), AutomationBench-AA에서는 Sol이 약 40% 낮은 비용으로 Opus medium과 동률(61.7% 대 61.2%)을 이룹니다.
GPT-6 Sol과 Claude Opus 5.5의 에포트 레벨은 무엇인가요?
GPT-6 Sol은 none, low, medium(기본), high, xhigh, max의 6단계를 제공하며 none은 확장 사고를 완전히 끕니다. Claude Opus 5.5는 low, medium(기본), high, xhigh, max의 5단계이며 확장 사고를 끌 수 없습니다. 에포트 레벨은 능력과 태스크당 비용을 모두 바꾸므로 어떤 비교든 양쪽 레벨을 명시해야 합니다.
왜 많은 비교가 Opus 5.5 medium과 GPT-6 Sol max를 맞붙히나요?
그 두 설정에서 두 모델의 태스크당 총비용이 가장 비슷해지기 때문입니다. 비용 정렬 측정에서는 요구 지능이 약 44점 이상인 영역에서 Opus 5.5 medium이 Sol max를 앞서고, 그 임계값 이하에서는 Sol이 더 저렴합니다. 양쪽 레벨을 명시하지 않는 비교는 측정이 아니라 마케팅입니다.
Claude Opus 5.5가 정말 Claude Opus 5보다 40% 저렴한가요?
그것은 Anthropic이 공표한 벤더 주장(전형적 워크로드 기준)입니다. 커뮤니티의 한 사용자가 실제 사용 로그와 88% 캐시 적중률로 재계산한 결과 Opus 5.5는 단위 작업당 약 $79, Opus 5.0은 약 $80으로 나타났습니다. 40% 저렴함이 아니라 사실상 동률입니다. 벤더의 비용 주장은 자신의 토큰 구성으로 다시 계산해야 합니다.
Tabbit Browser에서 GPT-6 Sol과 Claude Opus 5.5를 사용할 수 있나요?
Tabbit Browser는 리서치, 데이터 추출, 멀티모델 비교를 위한 AI 네이티브 워크스페이스를 제공합니다. Tabbit에서 특정 모델의 사용 가능 여부는 계정의 실시간 모델 선택기와 플랫폼 약관에 따라 달라집니다.