
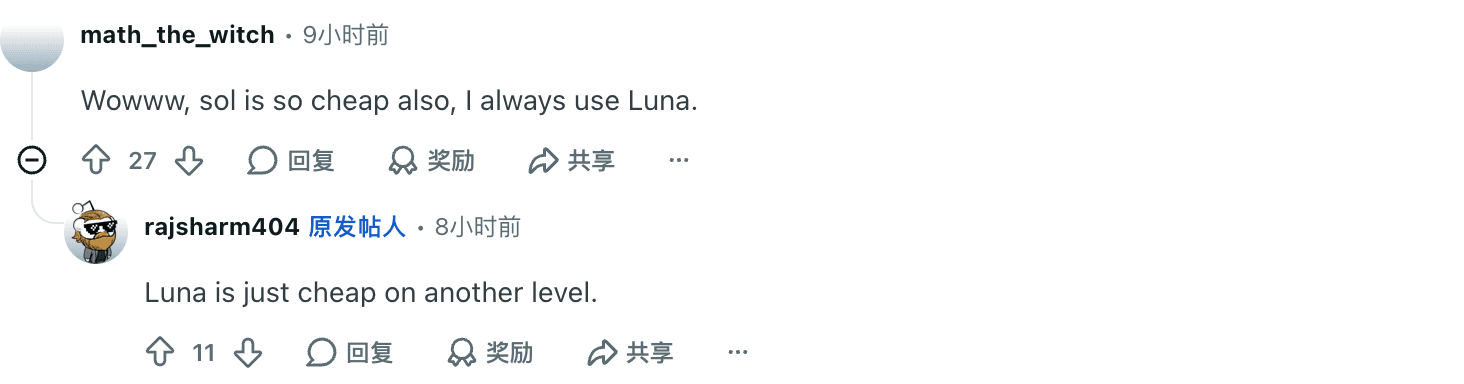
GPT-6 Sol coûte 2 $ par million de tokens en entrée et 10 $ en sortie au tarif API Standard d’OpenAI, vérifié le 23 septembre 2026. L’entrée en cache coûte 0,20 $ et les écritures cache 2,50 $. Le seuil qui peut changer le budget est 272 000 tokens d’entrée : au-delà, toute la requête passe aux tarifs de contexte long. La réaction du jour de lancement sur r/codex a réuni 371 votes en quelques heures sous le titre « GPT 6 Sol and Luna Prices! WTF!? », et son commentaire le plus voté résume la structure : « Sol now has terra pricing, Luna's price halved and terra is dead. » Le choc tarifaire est une affaire d’arithmétique : GPT-6 Sol est affiché à 2 $/10 $, tandis que le tarif de comparaison GPT-5.6 Sol est explicitement promotionnel au moins jusqu’au 21 novembre. (Discussion Reddit ; tarifs OpenAI)
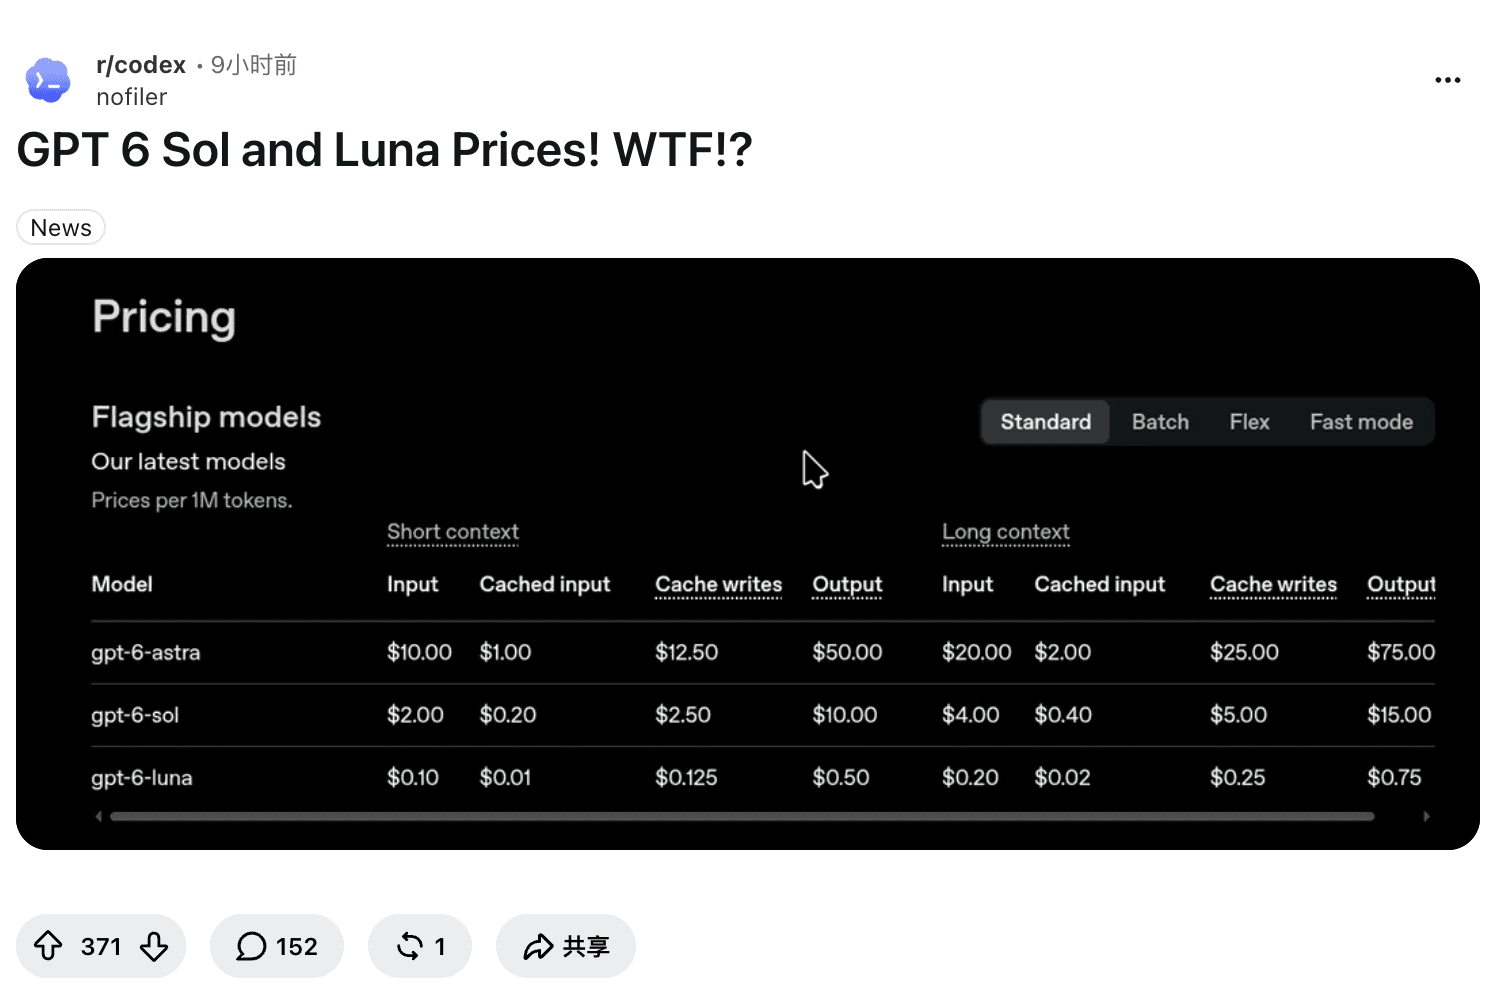
Ce guide distingue la facture API des abonnements ChatGPT/Codex, présente la grille complète et calcule deux budgets reproductibles. Pour utiliser le modèle avec des pages ou des fichiers, Tabbit Browser peut être un client si le modèle apparaît dans le sélecteur de votre compte. Il ne modifie pas la facturation OpenAI.
À retenir
Contexte court Standard : 2 $ en entrée, 0,20 $ en entrée cachée, 2,50 $ en écriture cache et 10 $ en sortie par million de tokens.
Au-delà de 272K tokens d’entrée, toute la requête utilise 4 $ / 0,40 $ / 5 $ / 15 $ par million.
Batch/Flex coûtent la moitié du Standard ; Fast coûte deux fois le tarif applicable. Vérifiez le traitement et le point d’accès avant de prévoir une remise.
Le tarif GPT-5.6 Sol actuellement affiché est promotionnel au moins jusqu’au 21 novembre 2026.
Le prix par token ne décrit ni le quota d’un abonnement ni le coût par tâche réussie. Comptez séparément sortie, écritures cache, outils et nouvelles tentatives.
Tarifs API GPT-6 Sol en un coup d’œil
Prix en dollars US par million de tokens, vérifiés sur la fiche du modèle et la page des tarifs le 23-09-2026. Le contexte long s’applique lorsque l’entrée dépasse 272 000 tokens.
| Niveau | Contexte d’entrée | Entrée | Entrée en cache | Écriture cache | Sortie |
|---|---|---|---|---|---|
| Standard | ≤272K | 2,00 $ | 0,20 $ | 2,50 $ | 10,00 $ |
| Standard | >272K | 4,00 $ | 0,40 $ | 5,00 $ | 15,00 $ |
| Batch / Flex | ≤272K | 1,00 $ | 0,10 $ | 1,25 $ | 5,00 $ |
| Batch / Flex | >272K | 2,00 $ | 0,20 $ | 2,50 $ | 7,50 $ |
| Fast | ≤272K | 4,00 $ | 0,40 $ | 5,00 $ | 20,00 $ |
| Fast | >272K | 8,00 $ | 0,80 $ | 10,00 $ | 30,00 $ |
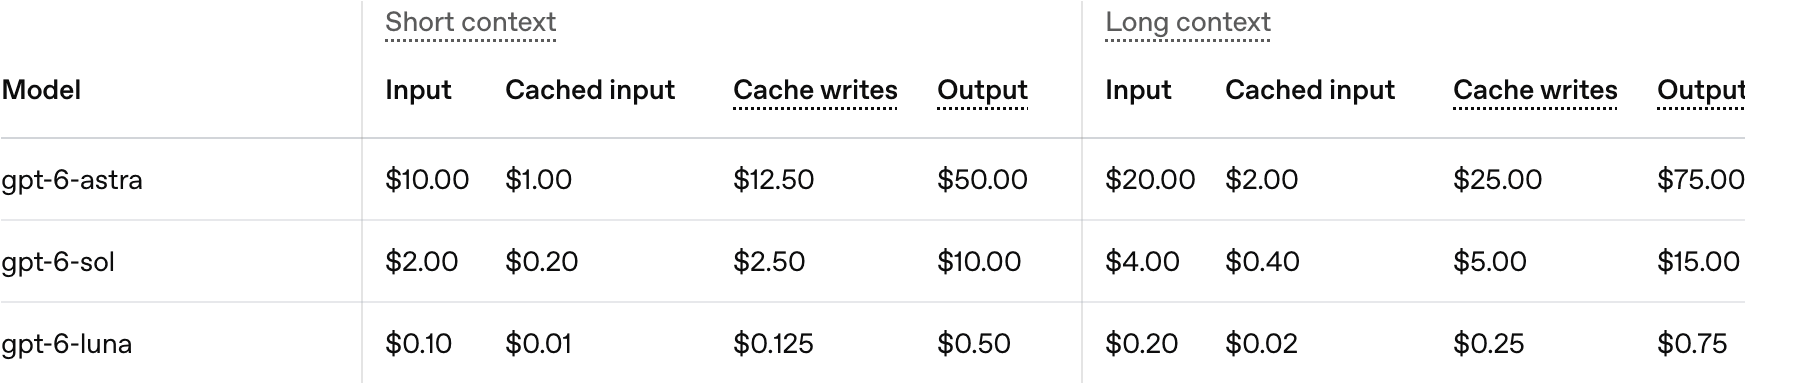
La grille indique un prix de token, pas le coût total d’une tâche. GPT-5.6 Sol est affiché à 4 $ en entrée et 20 $ en sortie, mais OpenAI précise que ce tarif promotionnel vaut au moins jusqu’au 21 novembre 2026. Aujourd’hui, GPT-6 Sol affiche la moitié de ce prix court. Cela ne garantit pas une facture divisée par deux : raisonnement, tentatives, longueur de sortie, cache et contexte comptent aussi.
| Modèle | Entrée | En cache | Écriture cache | Sortie | À évaluer pour |
|---|---|---|---|---|---|
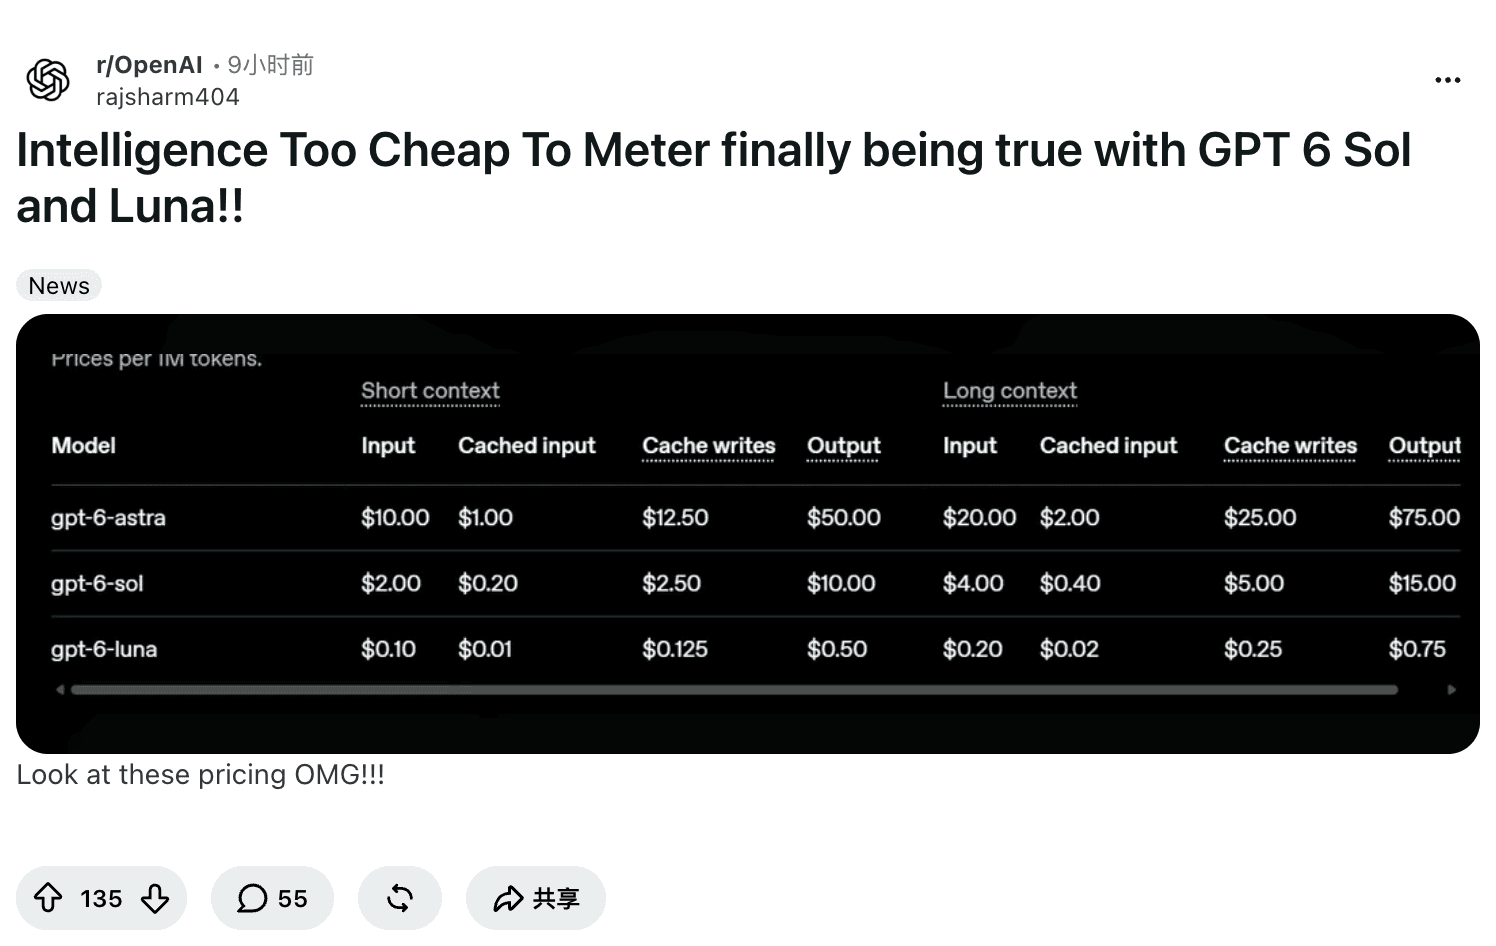
| GPT-6 Luna | 0,10 $ | 0,01 $ | 0,125 $ | 0,50 $ | Volume élevé ou budget serré ; valider la qualité |
| GPT-6 Sol | 2,00 $ | 0,20 $ | 2,50 $ | 10,00 $ | Codage et agents de milieu de gamme selon OpenAI |
| GPT-6 Astra | 10,00 $ | 1,00 $ | 12,50 $ | 50,00 $ | Option phare plus coûteuse |
Il s’agit des prix Standard courts de la même table, pas d’un classement de performances. Un détail structurel de cette même page : sur la capture du 23 septembre, les lignes GPT-5.6 Terra et GPT-5.6 Luna ont disparu de la grille, tandis que gpt-5.6-sol reste dans la section Daybreak « Cyber models » à son ancien tarif promotionnel de 4 $/20 $. Voir aussi l’analyse du prix de GPT-6 Astra et le guide de coût de GPT-5.6 Sol.
Le seuil de 272K modifie toute la requête
La fiche OpenAI dit qu’au-delà de 272K tokens d’entrée, les tarifs d’entrée et de cache doublent et celui de sortie est multiplié par 1,5. Le changement porte sur toute la requête, pas seulement sur les tokens excédentaires.
Cela compte pour l’analyse de grands dépôts, les longs documents et les agents qui conservent un historique important. Une requête de 273 000 tokens ne garde pas le tarif court pour ses premiers 272 000 tokens : entrée, entrée cachée, écriture cache et sortie passent au niveau long. GPT-6 Sol offre une fenêtre de 1 050 000 tokens, mais la capacité n’implique pas un tarif constant.
À exactement 272 000 tokens, la condition « plus de 272K » n’est pas franchie ; à 272 001, elle l’est. Laissez une marge si une petite modification peut dépasser la limite et revérifiez la fiche actuelle avant de figer le budget.
Le curseur de raisonnement : la même grille facture 0,13 $ à 1,06 $ par tâche
Le seuil de 272K re-tarife une requête ; le réglage de raisonnement (reasoning effort) re-tarife le modèle. Artificial Analysis suit GPT-6 Sol en six entrées — une par niveau — et leur coût mesuré par tâche de l’Indice d’Intelligence, relevé au 23-09-2026, donne ceci :
| Réglage de raisonnement | Indice d’intelligence | Coût par tâche | Vitesse de sortie |
|---|---|---|---|
| low | 34 | 0,13 $ | 129 t/s |
| medium (défaut) | 40 | 0,25 $ | 114 t/s |
| non-reasoning | 28 | 0,33 $ | 109 t/s |
| high | 43 | 0,37 $ | 119 t/s |
| xhigh | 44 | 0,53 $ | 128 t/s |
| max | 48 | 1,06 $ | 115 t/s |
Lisez les deux colonnes extrêmes ensemble : à prix par token identique, max coûte environ 8× plus que low par tâche, pour 14 points d’indice. Le même relevé situe GPT-5.6 Sol (max) à 1,99 $ par tâche : le successeur divise par deux le coût mesuré au niveau le plus haut, mais le curseur entre 0,13 $ et 1,06 $ reste le vôtre, et le défaut est medium, pas max. Les chiffres d’OpenAI vont dans le même sens : sur son AutomationBench, GPT-6 Sol en xhigh obtient 33,2 % à 0,27 $ par tâche, ce que l’annonce présente comme 9 % du coût par tâche de Claude Opus 5 en max.
Voilà pourquoi les discussions de changement de modèle de la semaine de lancement commencent par le prix. « Avec le nouveau Sol et ses prix bien plus bas, je suis tenté de l’utiliser à la place d’Astra », écrit un utilisateur de Codex en demandant des retours réels ; la réponse la plus votée tient en trois mots : « Pretty good. Wayyyyyyy cheaper. » (fil r/codex)
Interpréter « 50 % moins cher »
Les 2 $/10 $ de GPT-6 Sol face aux 4 $/20 $ actuellement affichés pour GPT-5.6 Sol sont faciles à comparer, mais la référence a une durée limitée : OpenAI précise que le tarif GPT-5.6 Sol est promotionnel au moins jusqu’au 21 novembre 2026. La ligne GPT-6 Sol ne comporte pas cette note.
« La moitié du tarif affiché aujourd’hui » est exact. « La moitié du prix permanent de l’ancien modèle » ne l’est pas. Le fil le plus voté du lancement l’a dit sans détour : « Half the price of 5.6 models. Performance increase appears marginal, more emphasis on the better pricing. » Artificial Analysis lit le même arbitrage : scores d’intelligence globalement stables face à GPT-5.6 Sol, des progrès sur certaines évaluations et des reculs sur d’autres, pendant que le coût mesuré par tâche passait de 1,99 $ (GPT-5.6 Sol, max) à 1,06 $ (GPT-6 Sol, max). Dans le même fil, une réponse se plaignait que « performance is worse according to AA ». Le prix a plus bougé que la capacité ; que ce soit un problème dépend de votre tâche. (fil r/codex ; Artificial Analysis)
Pour comparer le coût réel, faites exécuter la même tâche avec le même prompt, contexte, outils, réglage de raisonnement et critère de réussite. Ajoutez les tentatives échouées, puis divisez le total par le nombre de tâches terminées. Sans ce test, le tarif par million est le chiffre vérifiable, mais incomplet.
Les coûts au-delà du tarif principal
Lecture et écriture cache sont séparées. En contexte court, l’entrée cachée coûte 0,20 $ par million et l’écriture 2,50 $. Ne comptez pas le même token comme entrée froide et comme succès cache. Mesurez chaque volume selon le comportement de l’API.
GPT-6 a aussi changé le comportement du cache, pas seulement son prix. La publication cache du jour de lancement précise que les préfixes partagés éligibles sont réutilisables dans une fenêtre de 30 minutes, que GPT-6 sert par défaut de meilleurs taux de succès, et qu’une série de contrôles pensés pour les agents qui relisent le même contexte à chaque tour est disponible : tableau de bord du cache, outil de diagnostic des échecs, points d’arrêt explicites, préchauffage, et la possibilité de changer le réglage de raisonnement ou les outils sans casser le cache. GitHub rapporte avoir réduit de plus de 50 % la part de tokens de prompt nécessitant un traitement frais sur des milliards de requêtes, et un client cité dans la même publication attribue 20 % d’économies à quelques points de taux de succès en plus. Détail plus discret : GPT-6 Luna paie désormais 0,125 $ par million d’écriture cache, une ligne que son prédécesseur n’avait pas. (publication cache d’OpenAI)
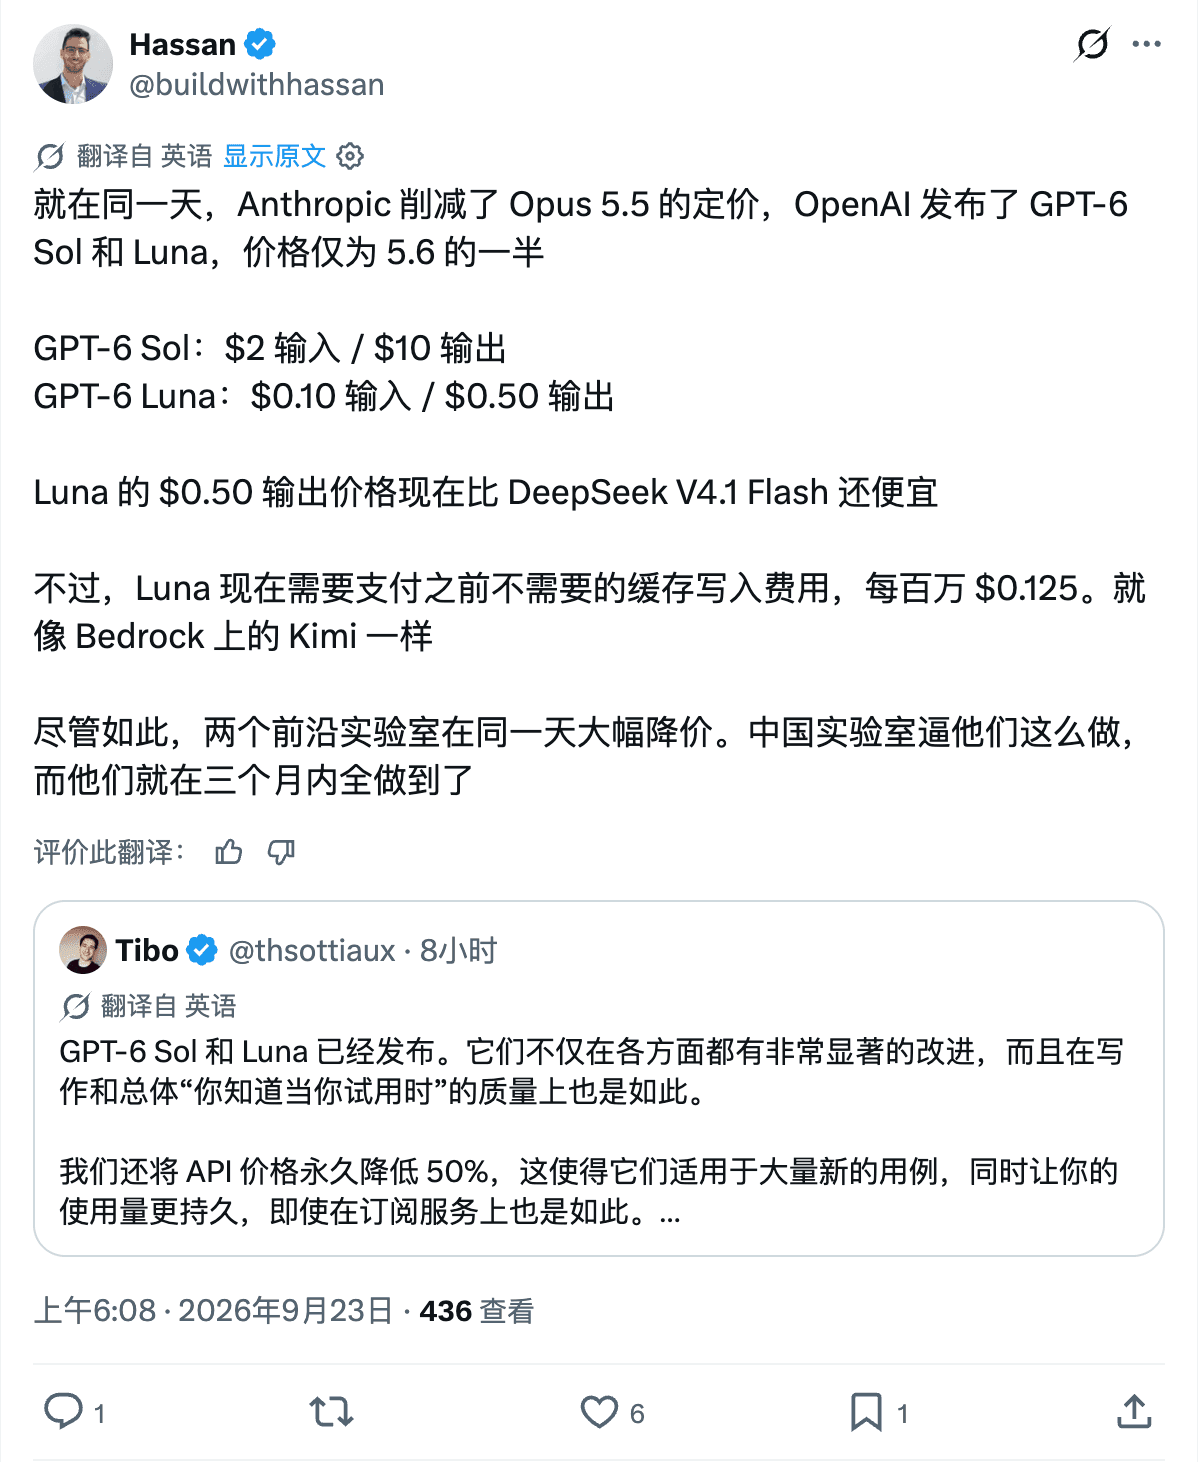
Cette publication souligne aussi le contexte concurrentiel : Anthropic a baissé le prix d’Opus 5.5 la même semaine, à quelques heures d’intervalle entre les deux laboratoires.
Batch et Flex échangent le mode de traitement contre une réduction de moitié. OpenAI les affiche à 50 % du Standard. Batch sert aux travaux asynchrones ; n’appliquez pas la remise à une requête interactive sans vérifier l’éligibilité. Fast vaut 2× le tarif applicable. L’API accepte encore priority comme alias de Fast.
Le traitement régional peut ajouter 10 %. OpenAI applique ce supplément aux endpoints régionaux admissibles pour les modèles publiés après le 5 mars 2026. La résidence des données de GPT-6 Sol dans l’UE est limitée au traitement Standard. Vérifiez l’endpoint choisi.
Outils et tentatives comptent. Les tokens des outils intégrés sont facturés au tarif du modèle ; certains outils ou services hébergés ont des frais distincts. Les échecs qui ont consommé des tokens restent dans le budget. Taxes et marges d’un fournisseur tiers ne figurent pas dans le tarif direct OpenAI.
Quel modèle GPT-6 convient ?
Au tarif Standard court, Luna coûte un vingtième de Sol en entrée et sortie ; Astra coûte cinq fois plus. Le prix le plus bas ne fait économiser que si le modèle atteint le même seuil de qualité. Vérifiez avec vos propres exemples.
L’échelle s’est aussi raidie du jour au lendemain, et le modèle mental de la communauté, ce sont désormais les noms eux-mêmes. Quand un utilisateur a trouvé le nouveau Sol « décevant », la réponse la plus votée a expliqué l’ordre : « GPT-6 Sol isn't supposed to be the frontier coding agent. Luna (Moon) < Terra (Earth) < Sol (Sun) < Astra (stars). » (fil r/codex)
| Travail | Premier choix à tester | Facteur de coût | À contrôler |
|---|---|---|---|
| Classification fréquente ou extraction simple | Essayer Luna | Nombre de tâches, longueur de sortie | Qualité sur un échantillon annoté ; les retentatives peuvent annuler l’économie |
| Code ou agents en plusieurs étapes | Sol au réglage minimal suffisant | Sortie, raisonnement, contexte et retentatives | Coût par tâche réussie, pas uniquement le tarif |
| Tâche difficile où l’échec coûte cher | Comparer Sol et Astra sur le même jeu | Taux d’achèvement et tokens consommés | Un tarif supérieur peut être compensé par moins d’essais |
| Évaluation en arrière-plan | Vérifier Batch/Flex | Tarif réduit de moitié | File d’attente et délai |
| Prompt proche de 272K | Réduire le contexte ou budgéter le niveau long | Changement global de la requête | Au-delà du seuil, tous les tokens changent de niveau |
Ce que le tarif API ne couvre pas
Le tarif API ne calcule pas un abonnement ChatGPT. ChatGPT et Codex ont leurs propres accès et limites ; une baisse du tarif API ne garantit pas plus d’usage inclus. Une publication du jour du lancement a rendu l’inquiétude concrète : elle affirme que les quotas de messages sont passés « from 25-200 messages to 15-150 while it is a cheaper model » et qualifie le nouveau Sol de « post-trained Terra ». Son auteur l’étiquette lui-même comme spéculation ; la page d’usage de votre forfait reste le seul arbitre. (Post critique)
Le prix ne prouve pas non plus que GPT-6 Sol coûte moins pour chaque tâche. Un critique affirme qu’il « uses more reasoning tokens compared to the previous model », sans fournir de trace comparable. Nous ne le traitons pas comme un fait établi. Mesurez plutôt les tokens, tentatives et corrections humaines de vos tâches. (Post critique)
Disponibilité : paliers API et offres ChatGPT
Côté API, le palier gratuit est fermé : le tableau de limites marque gpt-6-sol « Not supported » en Free ; l’accès payant commence au Tier 1.
| Palier API | RPM | TPM | Limite de file Batch |
|---|---|---|---|
| Free | Non pris en charge | — | — |
| Tier 1 | 500 | 500 000 | 1,5 M de tokens |
| Tier 2 | 5 000 | 1 000 000 | 3 M de tokens |
| Tier 3 | 5 000 | 2 000 000 | 100 M de tokens |
| Tier 4 | 10 000 | 4 000 000 | 200 M de tokens |
| Tier 5 | 15 000 | 40 000 000 | 15 000 M de tokens |
Source : fiche gpt-6-sol d’OpenAI, consultée le 23-09-2026.
Côté grand public, l’annonce place GPT-6 Sol et Luna dans ChatGPT Work et Codex dès le premier jour pour les offres Plus, Pro, Business, Enterprise et Edu ; Free et Go n’ont GPT-6 Luna que dans l’app de bureau, et aucun des deux modèles n’était encore dans Chat au lancement, avec un déploiement progressif dans la journée. La liste de modèles de la page tarifs de ChatGPT inclut déjà GPT-6 Sol, et les prix des offres évoluent indépendamment de l’API — Pro s’affichait « à partir de 100 $ » lors de la vérification des 22–23 septembre 2026. Sur r/OpenAI, l’enthousiasme a été immédiat : une publication à 135 votes célébrait « Intelligence Too Cheap To Meter finally being true » et sa réponse la plus votée prédisait que « 2027 sera l’année où l’intelligence sera assez économique pour la plupart des usages ». (annonce ; tarifs ChatGPT ; fil r/OpenAI)
Deux budgets API
Calculs Standard, hors supplément régional, outils, retentatives, taxes et frais tiers. Ce sont des exemples arithmétiques, pas des mesures.
Requête courte : 10 000 tokens d’entrée non cachés et 2 000 en sortie :
(10 000 × 2 $ + 2 000 × 10 $) / 1 000 000 = 0,04 $Contexte long : 300 000 tokens d’entrée non cachés et 8 000 de sortie. Le seuil étant dépassé, le tarif long s’applique à tout :
(300 000 × 4 $ + 8 000 × 15 $) / 1 000 000 = 1,32 $Boucle chaude : le même prompt de 300 000 tokens, mais 90 % servis depuis le cache — écrit une fois, réutilisé dans la fenêtre de 30 minutes — avec 8 000 tokens de sortie (tarifs longs toujours applicables, car l’entrée dépasse 272K) :
(270 000 × 0,40 $ + 30 000 × 4 $ + 8 000 × 15 $) / 1 000 000 = 0,35 $ + l’écriture uniqueLa discipline de cache a fait passer une requête de 1,32 $ à environ 0,35 $ plus les écritures : exactement la forme de travail visée par les améliorations de cache du lancement.
Pour le mois, multipliez par le nombre de tâches. En production, ajoutez les tentatives échouées au coût total et divisez par les tâches réussies.
Calcul local
Estimer le coût API de GPT-6 Sol
Tarifs officiels en USD vérifiés le 23/09/2026. Les valeurs restent dans ce navigateur.
Hors outils, nouvelles tentatives, taxes et traitement régional. Écritures et lectures du cache sont facturées séparément. Vérifier les tarifs actuels
Le calculateur fonctionne dans le navigateur et n’envoie pas les valeurs saisies. Il estime entrée, taux de cache, écritures, sortie, volume et niveau de service. Il exclut frais régionaux, outils, taxes, marges, retentatives et quotas d’abonnement. Au-delà de 272K d’entrée, il bascule automatiquement au tarif long.
Tester le flux dans Tabbit une fois le budget établi
Si votre but est d’utiliser GPT-6 Sol sur des pages ou fichiers plutôt que d’intégrer l’API, Tabbit Browser permet de choisir un modèle dans le navigateur. La page du modèle GPT-6 Sol (English), ses prompts (English) et ses évaluations (English) rassemblent des références.
La disponibilité dépend du sélecteur réel de votre compte et de votre édition. Tabbit est un client : il ne modifie pas les tarifs API OpenAI. Cet article ne mesure ni facture Tabbit, ni taux de réussite, ni latence.
 Tabbit Browser
Pour la recherche et l’automatisation dans le navigateur, voir le guide du navigateur IA, la vue des navigateurs agentiques et qu’est-ce qu’un navigateur agentique ?. La facturation API reste basée sur le tarif OpenAI.
Choisir selon son besoin
| Priorité | Point de départ | À inclure dans le budget |
|---|---|---|
| Dépenses API prévisibles | Standard sur un jeu de tâches fixe | Écritures cache, sortie, tentatives, outils |
| Tarif réduit pour un travail hors ligne | Batch/Flex si admissible | Tarif à 50 %, file et délai |
| Traitement API plus rapide | Fast si la latence le justifie | 2× les tarifs concernés |
| Préfixe long réutilisé | Mesurer lecture et écriture séparément | La lecture est moins chère ; écriture distincte |
| Entrée proche ou au-delà de 272K | Réduire le contexte ou budgéter le niveau long | Toute la requête change de tarif |
| Usage ChatGPT/Codex | Examiner le forfait concerné | Ses limites propres, pas le prix API |
Verdict
Au tarif court officiel vérifié en septembre 2026, GPT-6 Sol coûte 2 $ en entrée et 10 $ en sortie par million de tokens, soit la moitié du tarif actuellement affiché pour GPT-5.6 Sol. C’est une raison de le tester pour le code et les agents, mais le seuil global de 272K, les écritures cache à 2,50 $, les sorties, retentatives et niveaux de service déterminent la facture ; et le seul curseur de raisonnement fait varier la même grille de 0,13 $ à 1,06 $ par tâche mesurée — réglez-le consciemment plutôt que de laisser le défaut. Faites vos calculs depuis des traces réelles, comparez les abonnements selon leurs quotas publiés et choisissez Batch/Flex seulement si leur traitement convient.
Les premières discussions apprécient la baisse mais s’interrogent aussi sur les limites d’usage. La page OpenAI est la source du prix API actuel ; revérifiez-la avant de fixer un budget durable.
Sources
Fiche OpenAI GPT-6 Sol, tarifs et contexte ; consultée le 23-09-2026.
Tarifs API OpenAI, prix de la famille et note promotionnelle GPT-5.6 Sol ; consultée le 23-09-2026.
Annonce OpenAI GPT-6 Sol et Luna : cadrage de la baisse de 50 %, benchmarks du fournisseur, disponibilité.
OpenAI : un meilleur cache de prompt pour GPT-6 : fenêtre de 30 minutes, contrôles de cache, résultats GitHub et clients.
Artificial Analysis : GPT-6 Sol : intelligence, vitesse et coût par tâche par niveau, relevé du 23-09-2026.
OpenRouter : GPT-6 Sol : tarifs et latence par fournisseur, relevé du 23-09-2026.
Registres communautaires avec captures et conditions dans le texte : r/codex 1wngvak, r/codex 1wnh5j8, r/codex 1wnhbb2, r/codex 1wnocd6, r/OpenAI 1wnh4gr, post X sur la guerre des prix du même jour, post X d’Artificial Analysis.
Reddit : GPT-6 pricing actually has me optimistic about Codex usage again.
Reddit : GPT-6 Sol is actually a nerf to usage (speculation).

Questions fréquentes
Combien coûte GPT-6 Sol par million de tokens ?
Les tarifs API Standard à contexte court sont de 2 $ par million de tokens d’entrée, 0,20 $ pour l’entrée en cache, 2,50 $ pour les écritures cache et 10 $ pour la sortie. Au-delà de 272 000 tokens d’entrée, toute la requête passe aux tarifs de contexte long : 4 $, 0,40 $, 5 $ et 15 $.
Que se passe-t-il au-delà de 272K tokens avec GPT-6 Sol ?
Lorsque l’entrée dépasse 272 000 tokens, OpenAI applique le tarif de contexte long à toute la requête, pas uniquement au dépassement. L’entrée et le cache coûtent deux fois plus cher, et la sortie 1,5 fois le tarif court.
Combien coûte le cache de prompt GPT-6 Sol ?
En contexte court, l’entrée en cache coûte 0,20 $ par million de tokens et les écritures 2,50 $. Ce sont deux lignes de facturation distinctes, à estimer séparément.
Batch et Flex réduisent-ils le prix de GPT-6 Sol ?
OpenAI affiche Batch et Flex à 50 % du tarif Standard. Ces options conviennent aux tâches compatibles avec leur traitement et leur délai ; n’appliquez pas la remise à toutes les requêtes interactives.
Le tarif API équivaut-il à un abonnement ChatGPT ou Codex ?
Non. L’API facture les tokens, tandis que ChatGPT et Codex ont leurs propres limites d’usage et conditions tarifaires. Ne convertissez pas un abonnement en tokens API sans quota et méthode publiés.
GPT-6 Sol coûte-t-il deux fois moins cher que GPT-5.6 Sol ?
Au 23 septembre 2026, les tarifs Standard courts de GPT-6 Sol sont de 2 $ et 10 $ par million en entrée et sortie, soit la moitié des 4 $ et 20 $ affichés pour GPT-5.6 Sol. OpenAI indique que le tarif promotionnel de GPT-5.6 Sol dure au moins jusqu’au 21 novembre 2026 ; la référence peut donc évoluer.