
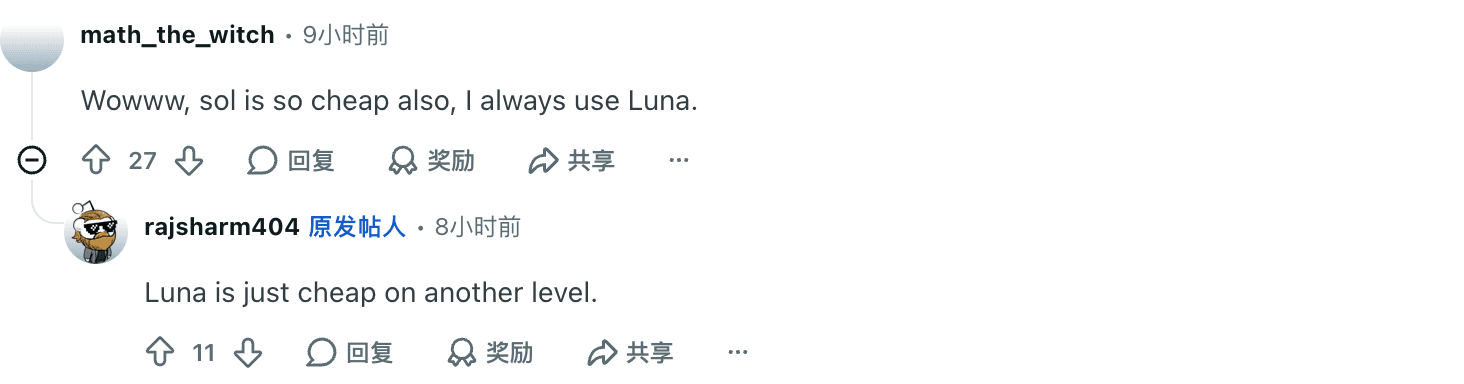
GPT-6 Sol 的 OpenAI 标准 API 费率为输入每百万 token $2、输出 $10,这是 2026 年 9 月 23 日核对的价格。缓存读取是 $0.20,缓存写入是 $2.50。预算里最容易漏掉的数字是 272,000 个输入 token:超过后,整笔请求都会转到更高的长上下文费率。发布当天的 r/codex 反应帖《GPT 6 Sol and Luna Prices! WTF!?》几小时内拿到 371 赞,最高赞评论一句话说破了结构:“Sol 接手了 Terra 的价位,Luna 半价,Terra 退场。”价格冲击其实是一道算术题:GPT-6 Sol 当前费率 $2/$10;而作为对照的 GPT-5.6 Sol 价格明确标注为促销价,至少持续到 11 月 21 日。(Reddit 讨论,OpenAI 价格表)
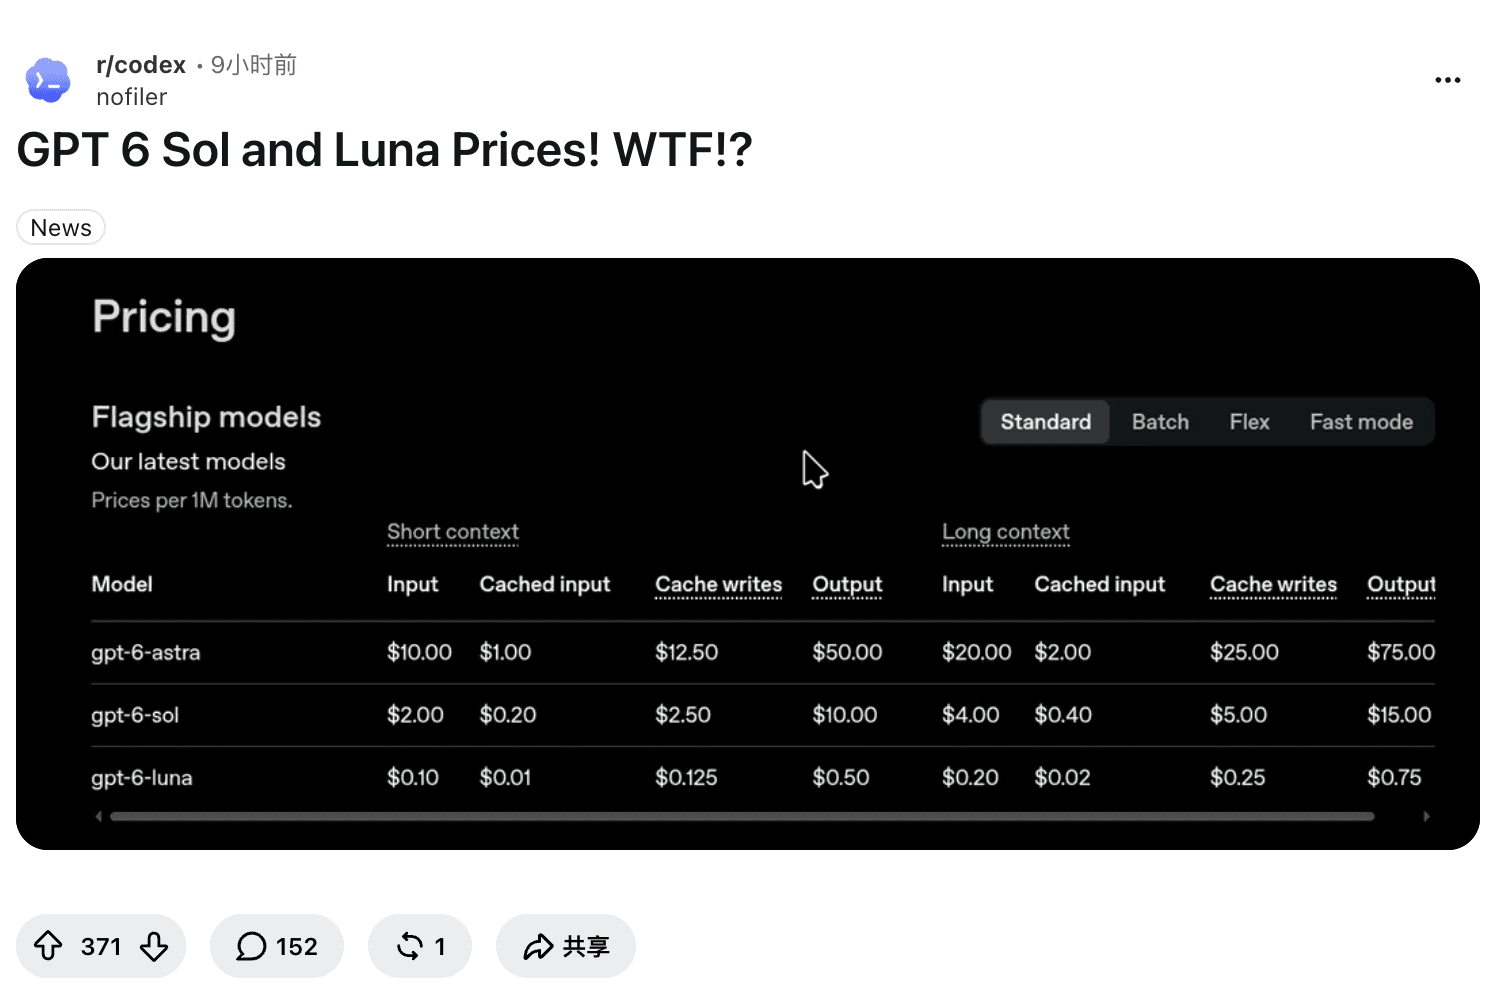
本文拆开 API 账单、ChatGPT/Codex 订阅和单次任务成本,给出费率表与可复算预算。若你想在网页或文件工作流里使用模型,Tabbit Browser 可以作为客户端选项;账号模型选择器里是否可用以实际显示为准,Tabbit 不改变 OpenAI 计费。
重点结论
标准短上下文费率:输入 $2、缓存输入 $0.20、缓存写入 $2.50、输出 $10 / 百万 token。
输入超过 272K 后,整笔请求使用长上下文费率:$4 / $0.40 / $5 / $15。
Batch 和 Flex 是标准费率的五折;Fast 是对应费率的两倍。先确认任务和 API 端点适用,再计算折扣或加价。
GPT-5.6 Sol 的当前费率是促销价,官方称至少到 2026 年 11 月 21 日。
token 单价无法说明订阅额度或每个成功任务的成本;输出、缓存写入、工具和重试都要分开估算。
GPT-6 Sol API 价格速查
下表为每百万 token 的美元价格。OpenAI 模型卡和价格表核对日期为 2026 年 9 月 23 日。输入超过 272,000 token 时采用长上下文档位。
| 服务档位 | 输入上下文 | 输入 | 缓存输入 | 缓存写入 | 输出 |
|---|---|---|---|---|---|
| Standard | ≤272K | $2.00 | $0.20 | $2.50 | $10.00 |
| Standard | >272K | $4.00 | $0.40 | $5.00 | $15.00 |
| Batch / Flex | ≤272K | $1.00 | $0.10 | $1.25 | $5.00 |
| Batch / Flex | >272K | $2.00 | $0.20 | $2.50 | $7.50 |
| Fast | ≤272K | $4.00 | $0.40 | $5.00 | $20.00 |
| Fast | >272K | $8.00 | $0.80 | $10.00 | $30.00 |
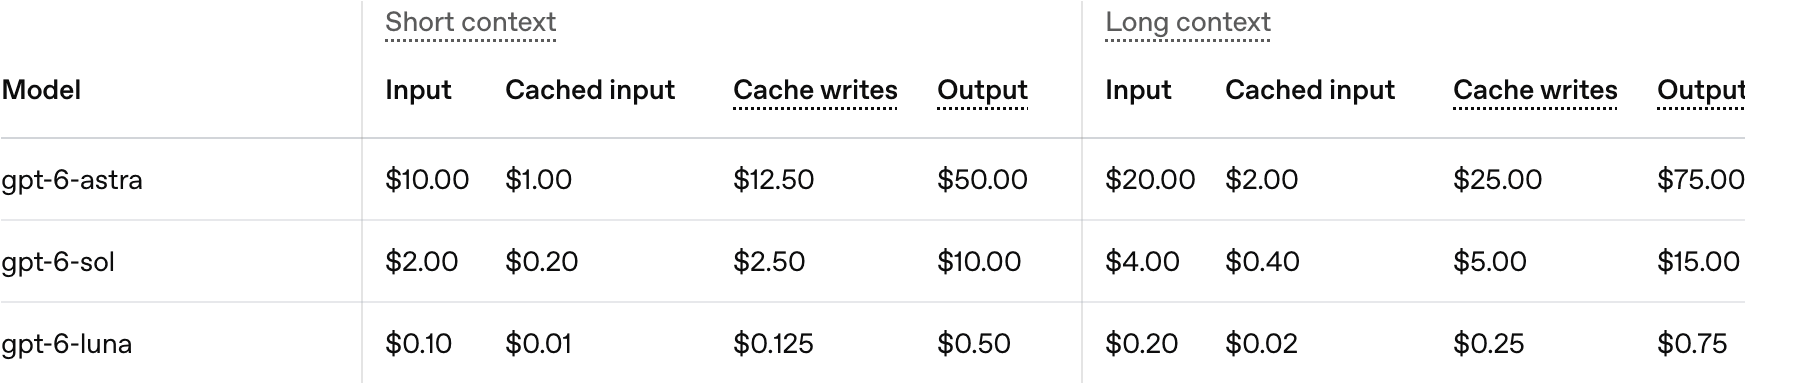
费率卡写的是 token 价格,不是完成一个任务的总成本。GPT-5.6 Sol 当前列出输入 $4、输出 $20,OpenAI 称该促销价至少持续到 2026 年 11 月 21 日。今天看,GPT-6 Sol 的短上下文输入和输出价格正好是其一半,但这不能保证实际任务账单也减半:推理档位、重试、输出长度、缓存和上下文大小都会影响结果。
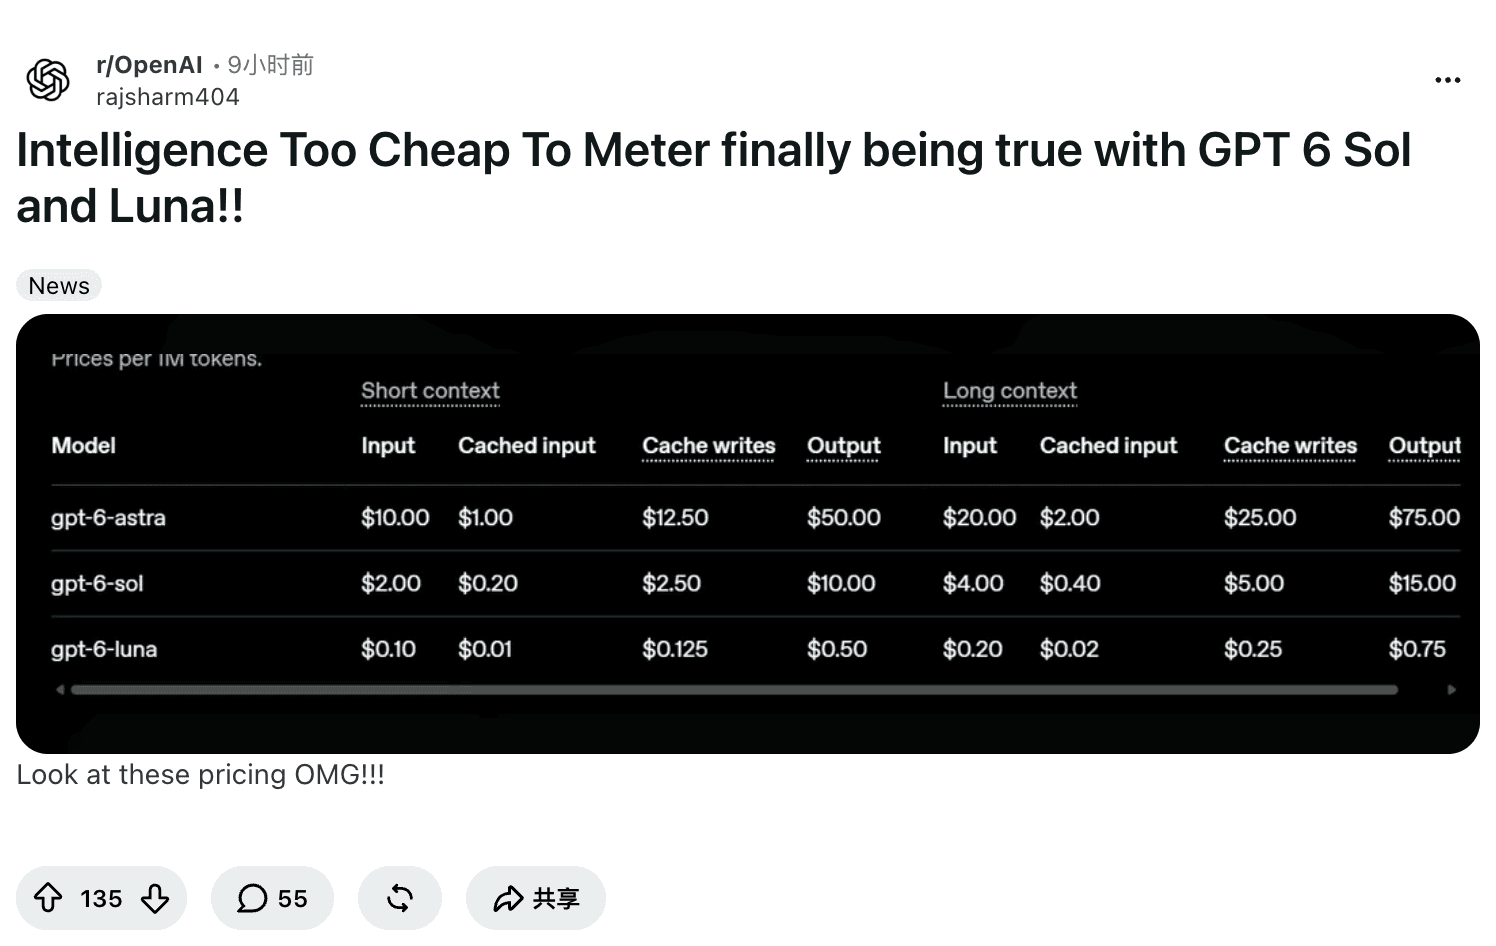
| 模型 | 输入 | 缓存输入 | 缓存写入 | 输出 | 适合怎样评估 |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | 高流量或成本敏感任务;先验证质量 |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 | OpenAI 定位的中档编码与 Agent 工作流 |
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 | 更高成本的旗舰方案 |
这是同一官方表格中的标准短上下文费率,不代表基准测试排名。同一页面还有一个结构性变化:9 月 23 日快照里,GPT-5.6 Terra 和 GPT-5.6 Luna 的行已从价格表上消失,而 gpt-5.6-sol 仍在 Daybreak“Cyber models”分区维持促销价 $4/$20。可继续看 GPT-6 Astra 定价分析及 GPT-5.6 Sol 成本说明。
272K:会改变整笔请求价格的数字
模型卡写明:输入超过 272K 时,输入与缓存费率变为两倍,输出变为 1.5 倍,而且整笔请求使用新费率。它不是只给超出门槛的 token 加价。
这对大代码库分析、长文档审核,以及不断携带对话历史的 Agent 循环尤其重要。输入 273,000 token 的请求不会让前 272,000 个 token 继续按短上下文价格计费。输入、缓存输入、缓存写入和输出都切到长上下文一档。GPT-6 Sol 的上下文窗口为 1,050,000 token,所以“放得进上下文”不代表“仍是同一个单价”。
恰好 272,000 尚未满足“超过 272K”;到 272,001 就跨过门槛。若提示词容易因小改动变长,应预留余量或重组上下文。上线前复核当前模型卡,不要把阈值写死后就不再检查。
推理档位旋钮:同一张卡,每任务 $0.13 到 $1.06
272K 门槛重新定价一笔请求;推理档位(reasoning effort)重新定价这个模型。Artificial Analysis把 GPT-6 Sol 拆成六个条目追踪(每个档位一条),其测量的每个智能指数任务成本,2026 年 9 月 23 日快照如下:
| 推理档位 | 智能指数 | 每任务成本 | 输出速度 |
|---|---|---|---|
| low | 34 | $0.13 | 129 t/s |
| medium(默认) | 40 | $0.25 | 114 t/s |
| non-reasoning | 28 | $0.33 | 109 t/s |
| high | 43 | $0.37 | 119 t/s |
| xhigh | 44 | $0.53 | 128 t/s |
| max | 48 | $1.06 | 115 t/s |
把两端放在一起读:在完全相同的 token 单价上,max 档每任务成本约为 low 档的 8 倍,换来 14 个指数点。同一快照里 GPT-5.6 Sol (max) 每任务 $1.99,即新一代把顶档实测任务成本砍半;但 $0.13 到 $1.06 之间的旋钮仍握在你手里,而且默认值是 medium,不是 max。OpenAI 自己的数字方向一致:在其 AutomationBench 上,GPT-6 Sol xhigh 档以每任务 $0.27 拿到 33.2% 分数,官方将此表述为 Claude Opus 5 max 档每任务成本的 9%。
这也是发布周换档讨论价格优先的原因。一位 Codex 用户写道:“新 Sol 便宜了这么多,我倾向于用它替代 Astra”,并征集真实使用反馈;最高赞回复只有三个词:“Pretty good. Wayyyyyyy cheaper.”(好得很,便宜太多了。)(r/codex 帖)
如何理解“便宜 50%”
GPT-6 Sol 的 $2/$10 与 GPT-5.6 Sol 当前列出的 $4/$20 一对比很直观,但基准有时效:OpenAI 明确把 GPT-5.6 Sol 的价格标为促销,并注明至少持续到 2026 年 11 月 21 日。GPT-6 Sol 当前费率没有同样的促销标注。
因此,“当前列价的一半”是准确说法;“比上一代永久价格低一半”则缺少依据。最高赞发布帖说得直白:“价格是 5.6 的一半。性能提升看起来有限,重点放在了降价上。”Artificial Analysis 的读法相同:智能分数与 GPT-5.6 Sol 大体持平,部分评测进步、部分退步;但实测每任务成本从 $1.99(GPT-5.6 Sol,max)降到 $1.06(GPT-6 Sol,max)。同帖一条回复则抱怨“按 AA 的数据性能反而更差”。价格比能力动得多;这是不是问题取决于你的任务。(r/codex 帖,Artificial Analysis 发布页)
想比较每项任务的成本,需要固定提示词、上下文、工具、推理设置和成功标准,在两个模型上跑同一任务,并把重试消耗计入账单。没有这类对照时,token 单价是最能核实的指标,但不是完整答案。
费率卡之外的成本
缓存读取和写入分开计费。 短上下文缓存输入每百万 $0.20,缓存写入每百万 $2.50。不要把一个 token 同时当作普通输入和缓存命中。若工作流只在首次写入长前缀、之后重复读取,就按真实 API 行为分别记录写入和读取量。
GPT-6 改变的不只是缓存的价,还有缓存的行为。OpenAI 发布日的缓存公告写明:可复用的共享前缀在 30 分钟窗口内有效;GPT-6 默认提供更高缓存命中率;并新增了一整套面向 Agent 每轮重读同一上下文这一场景的控制项:缓存面板、缓存未命中诊断工具、显式缓存断点、预热,以及调整推理档位或工具可用性而不破坏缓存的能力。GitHub 报告在数十亿次请求中把需要新鲜处理的提示词 token 份额降低超过 50%;同帖一位客户把 20% 的成本下降归因于几个百分点的命中率提升。同一波发布还有一个更安静的细节:GPT-6 Luna 现在要付每百万 $0.125 的缓存写入费,前一代没有这项费用。(OpenAI 缓存公告)
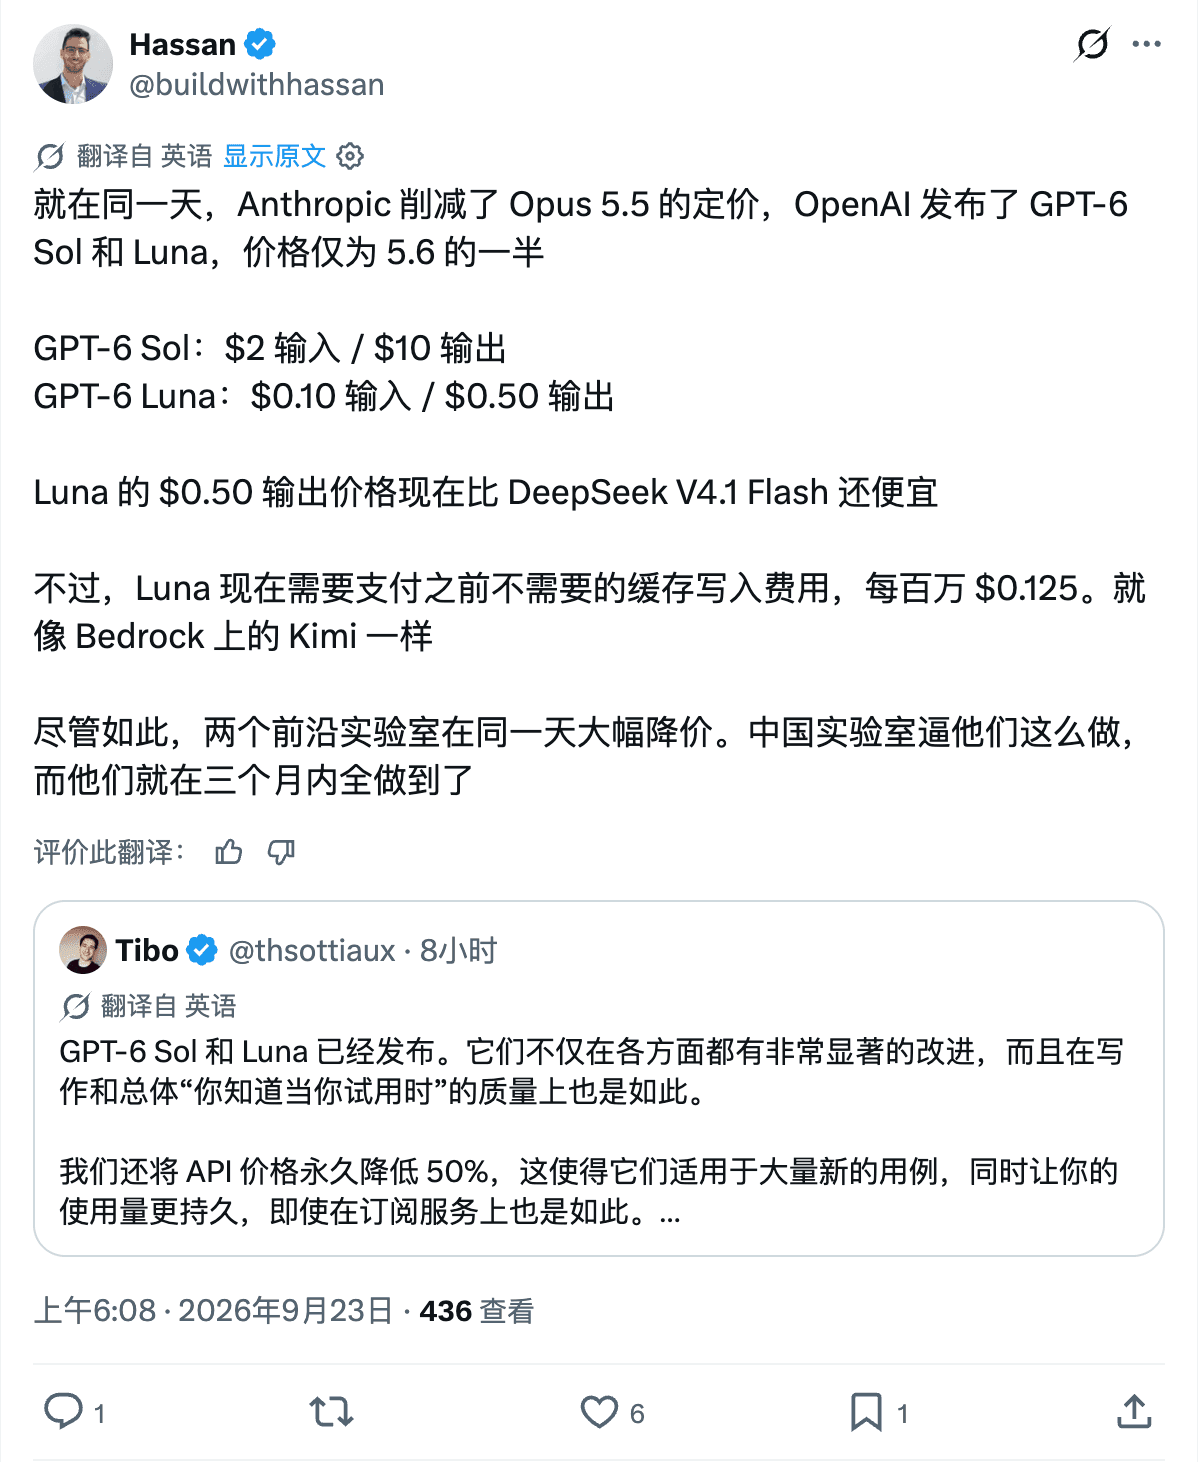
上面这条帖子还点出了竞争背景:Anthropic 同一周下调了 Opus 5.5 价格,两大前沿实验室的价格变动只隔了几小时。
Batch 与 Flex 用服务方式换取五折价格。 官方列价为 Standard 的 50%。Batch 面向异步任务;除非你的集成确实使用适用档位,否则不要把折扣套到交互请求。Fast 是对应费率的两倍。API 页面说明,priority 仍可作为 Fast 的兼容名称。
区域处理可能加价 10%。 OpenAI 说明,符合条件且于 2026 年 3 月 5 日之后发布的模型使用区域处理端点时加价 10%。GPT-6 Sol 的欧盟数据驻留仅支持 Standard 处理。根据实际端点和服务档位判断是否计入。
工具和重试也会影响成本。 内置工具使用的 token 按所选模型费率计费;部分工具或托管会话还可能另收费用。失败尝试若已经消耗 token,也要计入预算。税费和外部渠道加价不在 OpenAI 直连费率内。
GPT-6 家族里该选哪档?
同一短上下文价格表里,Luna 的输入和输出费率是 Sol 的二十分之一,Astra 是 Sol 的五倍。更低价只有在达到同等验收标准时才有价值。把模型选择当作需要用自有样本验证的路由假设。
这个阶梯一夜之间变陡了,社区对它的心智模型现在就是命名本身。当一位用户说新 Sol“不及预期”时,最高赞回复解释了排序:“GPT-6 Sol 本来就不是旗舰编码模型。Luna(月)< Terra(地)< Sol(日)< Astra(星)。”(r/codex 帖)
| 工作负载 | 起步方式 | 主要成本项 | 选择前检查 |
|---|---|---|---|
| 高频分类或简单抽取 | 先测 Luna | 任务量、输出长度 | 标注样本上的质量;重试可能吃掉节省 |
| 编码或多步 Agent 任务 | 从满足质量要求的最低档 Sol 开始 | 输出、推理设置、重试和上下文 | 看成功任务成本,不只看 token 单价 |
| 失败代价很高的难题 | 在固定样本上比较 Sol 与 Astra | 完成率和完成任务所需 token | 更高单价可能被更少重试抵消 |
| 可后台处理的评估或数据整理 | 确认 Batch/Flex 是否适用 | 服务档位五折 | 排队与时延要求 |
| 接近 272K 的长提示 | 适当缩短或总结上下文 | 整笔请求长上下文加价 | 跨过门槛后按高档估算全量 token |
API 价格表没有告诉你的事
API 价格不能用来算 ChatGPT 订阅。ChatGPT 与 Codex 套餐各自规定功能权限和用量限制;API 费率下降不等于套餐额度必然增加。一条发布日帖子把担忧说得很具体:声称消息额度“从 25-200 条变成 15-150 条,而模型还更便宜了”,并称新 Sol 是“post-trained Terra”。作者自己标注了这是推测;以你套餐的实时用量页面为准。(Reddit 质疑帖)
费率也不能证明 GPT-6 Sol 对所有任务都更划算。一位批评者说它“相比前代用了更多推理 token”,但评论没有提供可比的 token 记录,因此不能把这句话当成已核实的模型属性。它提示了一个实际问题:自己的任务到底用了多少 token、重试几次、需要多少人工修正?(Reddit 负面讨论)
API 预算还应覆盖工具费、重试及必要审核。订阅则单独按公开的用量和重置规则判断,两者是不同的采购方式。
套餐可得性:API 分层与 ChatGPT 套餐
API 侧免费档是关着的:模型页的限流表将 gpt-6-sol 标为 Free 档“不支持”,付费从 Tier 1 起。
| API 层级 | RPM | TPM | Batch 队列上限 |
|---|---|---|---|
| Free | 不支持 | — | — |
| Tier 1 | 500 | 500,000 | 150 万 token |
| Tier 2 | 5,000 | 1,000,000 | 300 万 token |
| Tier 3 | 5,000 | 2,000,000 | 1 亿 token |
| Tier 4 | 10,000 | 4,000,000 | 2 亿 token |
| Tier 5 | 15,000 | 40,000,000 | 150 亿 token |
来源:OpenAI gpt-6-sol 模型页,核对于 2026-09-23。
消费端方面,官方公告宣布 GPT-6 Sol 和 Luna 发布首日即进入 ChatGPT Work 和 Codex,面向 Plus、Pro、Business、Enterprise 和 Edu 用户;Free 和 Go 套餐仅在桌面端提供 GPT-6 Luna;发布时两款新模型尚未进入 Chat,当天逐步放量。ChatGPT 定价页的模型列表已包含 GPT-6 Sol;套餐价格独立于 API 费率变动,2026 年 9 月 22—23 日核对时 Pro 显示“100 美元起”。r/OpenAI 上的兴奋同样直接:一条 135 赞帖子庆祝“智能终于便宜到不计量”,最高赞回复预言“2027 年会是智能便宜到大多数地方都用得起的一年”。(发布公告,ChatGPT 定价,r/OpenAI 帖)
两笔 GPT-6 Sol API 预算
以下均按 Standard 费率计算,不含区域加价、工具、重试、税费或外部渠道费。这是算术示例,不是实测结果。
短请求:输入 10,000、输出 2,000,且无缓存:
(10,000 × $2 + 2,000 × $10) / 1,000,000 = $0.04长上下文:输入 300,000、输出 8,000。因输入超过 272K,全部按长上下文费率:
(300,000 × $4 + 8,000 × $15) / 1,000,000 = $1.32暖循环:同一笔 300,000 token 提示词,90% 由缓存供给(一次写入,在 30 分钟窗口内重复命中),输出 8,000(输入仍超过 272K,长上下文档率不变):
(270,000 × $0.40 + 30,000 × $4 + 8,000 × $15) / 1,000,000 = $0.35 + 一次性写入缓存纪律把一笔 $1.32 的请求降到约 $0.35 加写入费,这正是发布日那批缓存改进所服务的形状。
月估算等于单次成本乘以任务数量。生产系统还应把失败尝试放进总费用,只把成功任务计入分母,计算每个成功任务的有效成本。
本地计算器
估算 GPT-6 Sol API 成本
使用 2026-09-23 核对的官方美元费率。输入值仅在此浏览器处理。
不含工具、重试、税费和区域处理费用。缓存写入与缓存读取分开计费。 查看当前费率
计算器完全在浏览器中运行,不会发送你输入的数值。它根据输入 token、缓存比例、缓存写入、输出、任务数和服务档位估算 token 费用。它不含区域处理、工具费、税费、渠道加价、重试或订阅额度。输入超过 272K 后会自动切换至长上下文价格。
算清预算后,用 Tabbit 试跑工作流
如果你要在网页和文件上使用 GPT-6 Sol,而不是接入 API,Tabbit Browser 提供了在浏览器页面旁选择模型的工作流。GPT-6 Sol 模型页以及提示词资料、评测资料收录了相关参考信息。
模型是否可用取决于账号与版本的实时选择器。Tabbit 是客户端,不会改变 OpenAI API 单价,也不会把 token 估算变成订阅价格。本文没有测量 Tabbit 账单、任务成功率或响应时延。
 Tabbit Browser
浏览器研究与自动化可继续看 AI 浏览器指南、Agentic Browser 总览和什么是 Agentic Browser。它们介绍客户端工作流;token 计费仍以 OpenAI 价格表为准。
GPT-6 Sol 定价选择表
| 优先目标 | 起步选项 | 预算时记得计入 |
|---|---|---|
| 让 API 支出可预测 | 固定任务集,按 Standard 估算 | 缓存写入、输出、重试、工具费 |
| 离线任务争取更低单价 | 确认适用后选择 Batch/Flex | 五折费率、排队与时延限制 |
| API 请求需要更快处理 | 只在时延关键时选 Fast | 所有适用 token 费率翻倍 |
| 重复使用长提示前缀 | 明确记录缓存写入与读取 | 缓存读取便宜,写入单独收费 |
| 输入接近或超过 272K | 缩短上下文或按长上下文预算 | 超过门槛时整笔请求切换费率 |
| ChatGPT/Codex 消费端使用 | 查看对应订阅套餐 | 产品自己的用量限制,不是 API 价格 |
结论
按 2026 年 9 月的官方短上下文标价,GPT-6 Sol 的 $2 输入、$10 输出每百万 token 确实是当前 GPT-5.6 Sol 费率的一半,适合纳入编码和 Agent 工作负载的候选清单。但真正决定账单的还有 272K 整笔请求门槛、$2.50 缓存写入、输出量、重试和服务档位;而且推理档位这一个旋钮就能把同一张卡在实测任务成本上从 $0.13 拉到 $1.06,要刻意设置而不是任由默认。用自己的任务记录做预算;订阅则只按其公开额度比较;只有处理方式合适时才采用 Batch/Flex。
关于 GPT-6 Sol 的社区讨论刚开始,既有对降价的欢迎,也有人质疑价格和用量上限的关系。API 单价以 OpenAI 实时费率页为准,确定长期预算前应再次核对。
来源
OpenAI GPT-6 Sol 模型卡,费率与上下文规则,核对于 2026-09-23。
OpenAI API 价格表,家族费率与 GPT-5.6 Sol 促销说明,核对于 2026-09-23。
OpenAI GPT-6 Sol 与 Luna 发布说明:50% 降价的表述、厂商基准、可得性。
OpenAI:GPT-6 更好的提示词缓存:30 分钟窗口、缓存控制项、GitHub 与客户结果。
Artificial Analysis GPT-6 Sol 发布页:各档位智能、速度与每任务成本快照,2026-09-23。
OpenRouter GPT-6 Sol:渠道费率与时延快照,2026-09-23。
正文内嵌截图与条件的社区记录:r/codex 1wngvak、r/codex 1wnh5j8、r/codex 1wnhbb2、r/codex 1wnocd6、r/OpenAI 1wnh4gr、同日价格战 X 帖、Artificial Analysis X 帖。

常见问题
GPT-6 Sol 每百万 token 收费多少?
OpenAI 标准短上下文 API 费率为输入 $2、缓存输入 $0.20、缓存写入 $2.50、输出 $10,单位均为每百万 token。输入超过 272,000 token 后,整笔请求按 $4、$0.40、$5、$15 的长上下文费率计费。
GPT-6 Sol 输入超过 272K 后如何计费?
当输入超过 272,000 token,OpenAI 对整笔请求使用长上下文费率,而非只对超出的部分加价。输入和缓存费率为短上下文的两倍,输出费率为 1.5 倍。
GPT-6 Sol 的提示词缓存怎么收费?
短上下文的缓存输入为每百万 $0.20,缓存写入为每百万 $2.50。两者是独立计费项,估算时应把写入量单独列出。
Batch 和 Flex 会让 GPT-6 Sol 更便宜吗?
OpenAI 标价为标准费率的 50%。它们适用于能够接受对应处理方式和时延的任务;不能把折扣默认套用到所有交互请求。
GPT-6 Sol API 价格等同于 ChatGPT 或 Codex 订阅吗?
不等同。API 按 token 计费,ChatGPT 和 Codex 套餐有各自的功能权限与使用上限。除非套餐公开了额度及换算方式,否则不要把订阅费折算成 API token。
GPT-6 Sol 比 GPT-5.6 Sol 便宜一半吗?
截至 2026 年 9 月 23 日,GPT-6 Sol 标准短上下文输入和输出分别为每百万 $2、$10,是 GPT-5.6 Sol 当前列出的 $4、$20 的一半。OpenAI 标注后者促销价至少持续至 2026 年 11 月 21 日,因此比较基准可能变化。