
GPT-6 Astra coûte 10 dollars par million de tokens d'entrée et 50 dollars par million de tokens de sortie sur le palier standard de l'API, avec l'entrée en cache à 1 dollar, l'écriture de cache à 12,50, et chaque tarif vérifié sur les pages d'OpenAI le 22 septembre 2026. Voilà la grille tarifaire. La facture est autre chose : sur la même grille, Artificial Analysis mesure le coût d'une tâche de référence à 0,82 dollar en effort de raisonnement low et 3,26 dollars en max — un écart d'environ 4x sans toucher à un seul prix.
L'écart entre ces deux nombres est la raison d'être de cet article. Un développeur Reddit l'a résumé au lancement : « GPT-5.6 Sol : 4 $/M en entrée, 20 $/M en sortie. GPT-6 Astra : 10 $/M en entrée, 50 $/M en sortie. C'est littéralement une hausse de 2,5x sur l'entrée comme la sortie. » (fil r/codex, 456 votes). L'arithmétique est juste. La conclusion — cher ou bon marché — ne se tranche pas par arithmétique, car le niveau d'effort, le palier de service, la longueur du contexte et le taux de hits en cache déplacent la facture davantage que le choix du modèle lui-même. Plus loin, Tabbit Browser apparaît comme un endroit pratique pour comparer des routes de modèles une fois le budget clair ; d'abord, les chiffres.
À retenir
Tarifs standard : 10 $ d'entrée, 1 $ d'entrée en cache, 12,50 $ d'écriture de cache, 50 $ de sortie par million de tokens ; au-delà de 272K d'entrée, toute la requête passe à 20/2/25/75 $.
La même grille facture à 4x près. Batch et Flex divisent chaque tarif par deux ; Fast mode le double. Artificial Analysis mesure la même tâche entre 0,82 $ (effort low) et 3,26 $ (max) à prix de tokens identiques.
La prime de 2,5x se mesure contre une base promotionnelle. Les 4/20 $ de Sol figurent comme tarif promotionnel « au moins jusqu'au 21 novembre 2026 » ; l'entrée de la GPT-5.5 précédente était à 5 $.
Les abonnements sont une autre économie. ChatGPT Plus est à 20 $/mois avec Astra limité ; Pro s'affiche à partir de 100 $/mois. Des mesures communautaires situent le coût effectif d'Astra en abonnement autour de 1,9x son prix API, avec une rétention de cache rapportée à environ 30 minutes.
Budgétez par forme de tâche, pas par prix au token. Les réponses courtes sont dominées par la sortie ; les boucles agentiques avec cache, par les lectures de cache ; tout ce qui dépasse 272K d'entrée paie la prime de contexte long sur la requête entière.
Le prix de GPT-6 Astra en un coup d'œil
La grille standard complète, relevée sur la page de tarifs de l'API d'OpenAI le 22 septembre 2026. La présentation de GPT-6 Astra couvre ce qu'est le modèle ; ce tableau couvre l'argent.
| Modèle | Entrée / 1M | Entrée en cache / 1M | Écriture cache / 1M | Sortie / 1M |
|---|---|---|---|---|
| gpt-6-astra | $10,00 | $1,00 | $12,50 | $50,00 |
| gpt-5.6-sol | $4,00 | $0,40 | $5,00 | $20,00 |
| gpt-5.6-terra | $2,00 | $0,20 | $2,50 | $12,00 |
| gpt-5.6-luna | $0,20 | $0,02 | $0,25 | $1,20 |
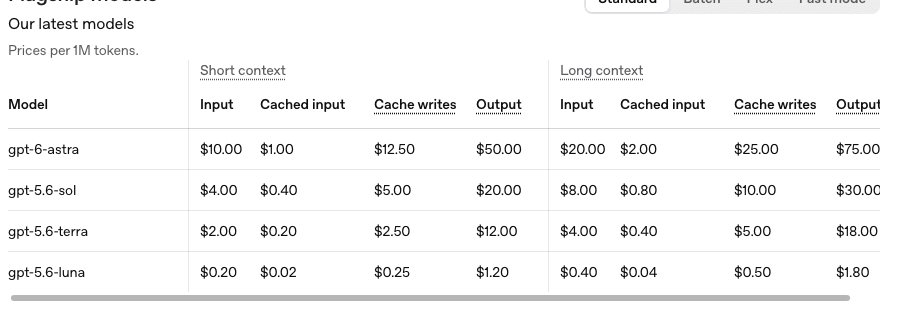
Trois choses dans ce tableau font les dégâts, et aucune n'est le 10 du titre :
La sortie coûte 5x l'entrée. Astra est un modèle de raisonnement ; il pense en tokens de sortie facturables. Un prompt modeste suivi d'une longue chaîne de pensée, c'est une facture de sortie déguisée en entrée.
Écrire en cache coûte plus cher que l'entrée. Les 12,50 $ font 1,25x le tarif sans cache — la page de prix énonce la règle 1,25x explicitement. Le cache ne rentabilise que si le préfixe est vraiment réutilisé.
La marche de 272K s'applique à la requête entière. Au-delà de 272 000 tokens d'entrée, la requête complète — pas seulement l'excédent — est facturée à 20 $ d'entrée, 2 $ de cache, 25 $ d'écriture, 75 $ de sortie. Une fenêtre de contexte de 1,05M n'est pas un budget de 1,05M au tarif standard.
Le chiffre qui compte : la même grille facture de 0,82 à 3,26 dollars par tâche
Si vous ne retenez qu'un nombre de cet article, retenez l'amplitude, pas le tarif. Artificial Analysis suit GPT-6 Astra en cinq entrées — une par effort de raisonnement — et son coût mesuré par tâche d'indice d'intelligence (instantané du 22 septembre 2026) donne :
| Effort de raisonnement | Indice d'intelligence | Coût par tâche | Vitesse de sortie |
|---|---|---|---|
| low | 46 | $0,82 | 55 t/s |
| medium | 50 | $1,54 | 52 t/s |
| high | 51 | $1,73 | 59 t/s |
| xhigh | 52 | $2,31 | 55 t/s |
| max | 53 | $3,26 | 67 t/s |
Lisez ensemble les deux colonnes extrêmes : max coûte 3,98x le coût de low par tâche, pour 7 points d'indice mesurés. Dans le même instantané, low affiche aussi le temps jusqu'au premier token le plus court (2,46 s). Le réglage cher n'est pas automatiquement le prudent ; c'est celui qui pense plus longtemps en tokens facturables.
Cela compte doublement pour le travail agentique. Le meilleur résultat public d'Astra — environ 40 minutes par tâche OSWorld 2.0 dans la simulation d'OpenAI, contre 75 pour Sol — décrit précisément la charge où effort et tentatives se composent : chaque tour de boucle relit le contexte, chaque étape émet des tokens de raisonnement, et un modèle qui « tourne sans fin » facture aussi sans fin. Un utilisateur de Hacker News rapporte avoir épuisé une fenêtre de cinq heures de ChatGPT en 15 messages (discussion HN) ; la même forme sur la facturation API, c'est pourquoi le guide du raisonnement agentique exige des critères d'acceptation avant les longues boucles. Budgétez par tâche terminée, tentatives ratées incluses, pas par première tentative.
Traduire la prime de 2,5x sur GPT-5.6 Sol
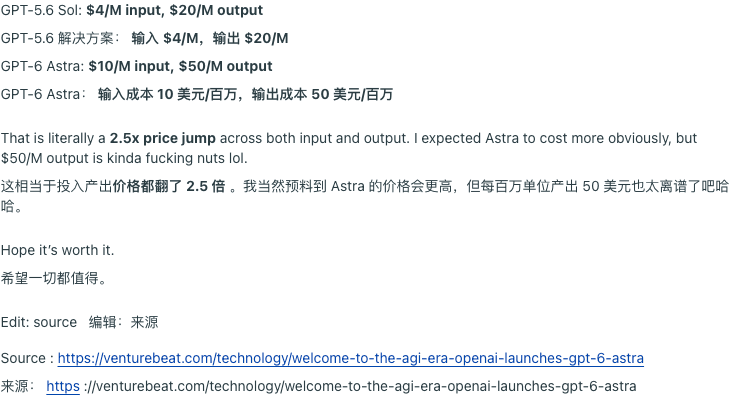
Le chiffre de 2,5x est une arithmétique honnête, mais deux réserves doivent l'accompagner avant tout budget.
Réserve un : la base est promotionnelle. La page de Sol note que « le prix promotionnel de GPT-5.6 Sol est disponible au moins jusqu'au 21 novembre 2026 », et sa colonne de comparaison rapide affiche l'entrée de la GPT-5.5 précédente à 5,00 $. La baisse de Sol est tombée le 30 juillet 2026, quand Sam Altman a annoncé Luna à -80% (à 0,20/1,20 $), Terra à -20% (à 2/12 $) et Fast mode pour Sol à 2x le prix pour jusqu'à 2,5x la vitesse (@sama). Si la promo de Sol expire, la « prime de 2,5x » se réduit toute seule sans qu'Astra baisse d'un centime. L'analyse du contexte de GPT-5.6 Sol suit cette famille à part.
Réserve deux : le coût par tâche peut converger. Le fil ci-dessus, c'est le choc de la grille. Mais les 0,82 $ par tâche en low mesurés par Artificial Analysis montrent jusqu'où la facture peut passer sous le prix affiché, et la direction s'inverse totalement quand la capacité économise des tentatives : un travail que Sol rate deux fois et qu'Astra termine du premier coup revient moins cher sur Astra même à tarifs de 2,5x. Savoir si cela décrit vos tâches est une question empirique — elle se répond avec les exemples chiffrés ci-dessous, pas avec la grille.
Les lignes de facturation hors du titre
Quatre lignes décident la plupart des factures réelles, et la couverture de lancement n'a mentionné que la première.
Batch et Flex : le levier des 50%. Les deux sont facturés à moitié du standard — 5 $ d'entrée, 0,50 $ de cache, 6,25 $ d'écriture, 25 $ de sortie. Batch est pour le travail qui peut attendre des heures (l'API expose v1/batch, avec des limites de file de 1,5M de tokens au Tier 1 jusqu'à 15B au Tier 5) ; Flex est un autre mode de capacité à bas coût avec ses propres compromis de disponibilité. Pour les évaluations par lots, l'enrichissement hors ligne et tout ce qu'un utilisateur ne voit pas, ce seul interrupteur économise plus que n'importe quelle optimisation de prompt. Les remises ne se cumulent pas : un mode à la fois.
Fast mode : l'accélérateur 2x. Facturé au double des tarifs applicables — 20/100 $ en standard, et notez « applicables » : Fast sur un travail Batch double les tarifs Batch, il ne revient pas au standard avant de doubler. Priority processing a été renommé Fast mode le 30 juillet 2026, et service_tier: "priority" comme "fast" fonctionnent toujours — important si vous avez du code ancien.
Traitement régional : +10%. Les endpoints de résidence des données portent une majoration de 10% pour les modèles publiés à partir du 5 mars 2026 éligibles — Astra l'est par sa date de sortie. Les régions pilotées par la conformité paient la prime sur chaque ligne.
La marche de 272K et l'horloge de cache. Au-delà de 272K d'entrée, la ligne contexte long (20/2/25/75 $) s'applique à la requête entière — aucun calcul « seulement l'excédent ». Et le cache qui devrait amortir les relectures a une horloge rapportée par la communauté : des utilisateurs de Codex ont observé une rétention d'environ 30 minutes sur Astra contre 24 heures sur Sol et les précédents.
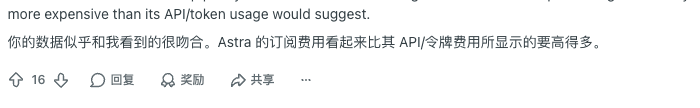
OpenAI ne publie pas de tableau de TTL, donc traitez les 30 minutes comme un comportement rapporté avec deux sources indépendantes (fil, commentaire), pas une garantie. Si votre boucle dort plus longtemps entre deux étapes, la lecture à 1 $ peut silencieusement redevenir une lecture froide à 10 $ plus une écriture à 12,50 $.
Les appels d'outils restent en dehors de tout ça : OpenAI indique que les modèles à outils facturent à l'appel des choses comme la recherche web, donc un agent qui cherche 40 fois a un second compteur qui tourne.
L'échelle de la famille : quelle ligne est la vôtre
La ligne contre-intuitive de l'échelle, c'est Luna : 50 fois moins chère à l'entrée qu'Astra, et elle existe bel et bien. Le catalogue officiel décrit Luna pour les charges sensibles au coût et à fort volume, et les propres conseils de sélection d'OpenAI recommandent Terra ou Luna par défaut, sauf travail assez difficile pour justifier le flagship. La ligne bon marché n'est pas un jouet ; c'est une destination de routage, et chaque token routé là plutôt que vers Astra économise 50x à l'entrée.
La deuxième découverte contre-intuitive vient de l'extérieur de la famille. Astra et la Fable 5.1 d'Anthropic s'affichent au même 10/50 — et coûtent des montants opposés en pratique :
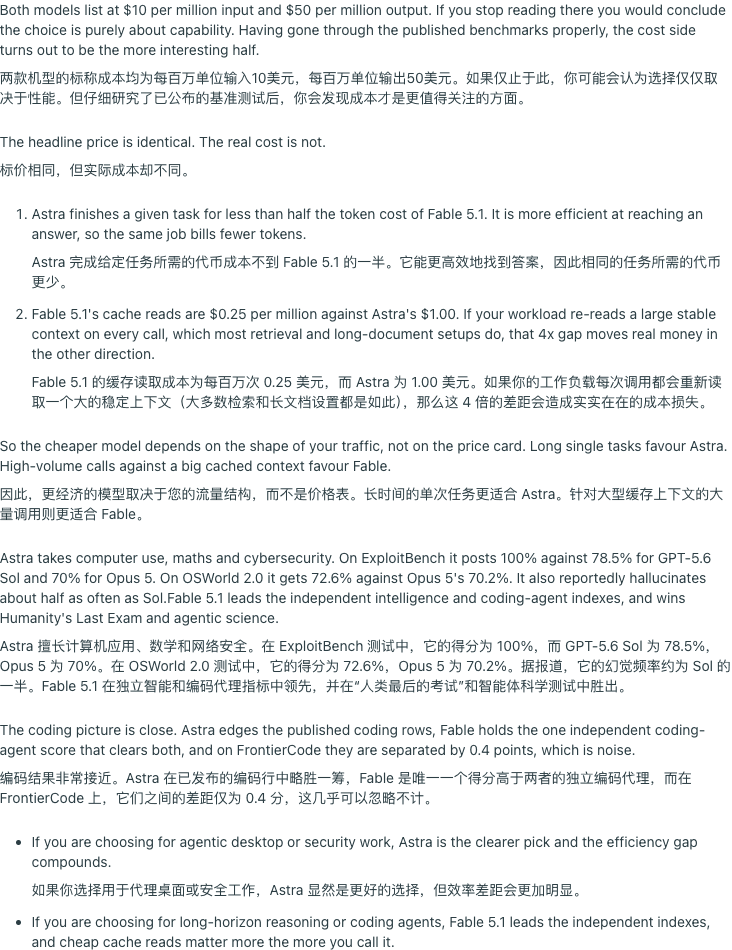
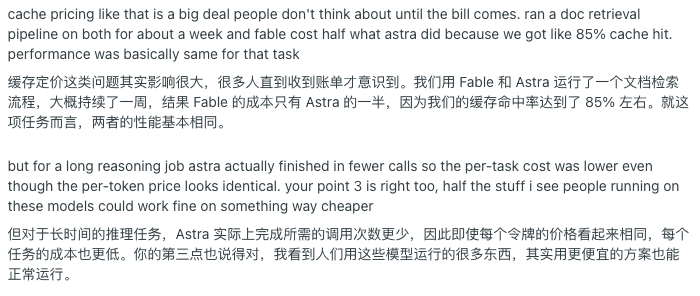
Les comptes de l'auteur : Astra termine une tâche avec moins de tokens (« moins de la moitié du coût en tokens de Fable 5.1 » sur ses tâches uniques longues), tandis que les lectures de cache de Fable à 0,25 $ le million creusent un écart de 4x face au 1,00 $ d'Astra — donc le trafic à fort volume contre un grand contexte en cache favorise Fable, et les tâches uniques longues favorisent Astra. Un commentateur a fait tourner une semaine durant un pipeline de recherche documentaire sur les deux et a payé environ moitié moins sur Fable avec 85% de hits de cache, « les performances étaient fondamentalement les mêmes pour cette tâche » :
La leçon transférable n'exige de choisir aucun laboratoire : la grille tarifaire est la plus petite entrée de la fonction de coût. La forme du trafic — longueur de tâche, ratio de hits de cache, volume de sortie — domine. La collection d'avis communautaires (English) conserve d'autres rapports de ce type avec leurs conditions.
Ce que la grille ne couvre pas
Un abonnement n'est pas du crédit API. Les offres ChatGPT donnent de l'usage, valorisé en allocations et fenêtres — la section suivante montre que ces allocations sont une économie propre. Ne divisez jamais une offre à 20 $ par des prix au token.
Les tentatives ratées peuvent facturer. Dans une exécution Codex de 33 minutes documentée durant la semaine de lancement, deux tentatives expirées ont consommé du budget avant la réussite (r/ChatGPT). Les tentatives sont une ligne de coût, pas du gratuit.
Le palier gratuit API est fermé. Le tableau de limites marque Astra « non pris en charge » en Free ; le payant commence au Tier 1 avec 500 requêtes par minute et 500K tokens par minute.
Taxes, outils et marges de fournisseurs à part. La page OpenRouter montre Azure et OpenAI affichant tous deux 10/50/1 $ pour Astra avec des profils de latence différents (P50 jusqu'au premier token de 4,80 s contre 6,92 s dans l'instantané du jour) — mêmes tarifs, routage différent. Les régions commerciales d'Amazon Bedrock sont annoncées à l'identique du prix direct OpenAI.
Disponibilité des offres : paliers API et offres ChatGPT
| Palier API | RPM | TPM | Limite de file Batch |
|---|---|---|---|
| Free | Non pris en charge | — | — |
| Tier 1 | 500 | 500 000 | 1,5M de tokens |
| Tier 2 | 5 000 | 1 000 000 | 3M de tokens |
| Tier 3 | 5 000 | 2 000 000 | 100M de tokens |
| Tier 4 | 10 000 | 4 000 000 | 200M de tokens |
| Tier 5 | 15 000 | 40 000 000 | 15Md de tokens |
Source : page du modèle gpt-6-astra d'OpenAI, vérifiée le 22 septembre 2026. Les paliers montent avec la dépense : le plafond de la semaine de lancement n'est pas permanent.
Côté grand public, la page des tarifs ChatGPT affiche actuellement quatre offres : Free à 0 $ (texte illimité avec GPT-5.6 Luna — pas d'Astra), Go à 8 $/mois, Plus à 20 $/mois avec « des modèles de raisonnement avancés avec GPT-6 Astra et GPT-5.6 » (la matrice comparative marque Astra comme limité), et Pro affiché « à partir de 100 $/mois » avec 5x d'usage et « raisonnement Pro propulsé par GPT-6 Astra ». La communauté mentionne toujours un Pro à 200 $, et les descriptions YouTube listent « 100 et 200 $ » ensemble — la page en ligne est seule juge, et elle affiche un prix « à partir de ».
L'économie des abonnements mérite sa propre étiquette d'avertissement, parce que trois mesures communautaires indépendantes pointent dans la même direction :
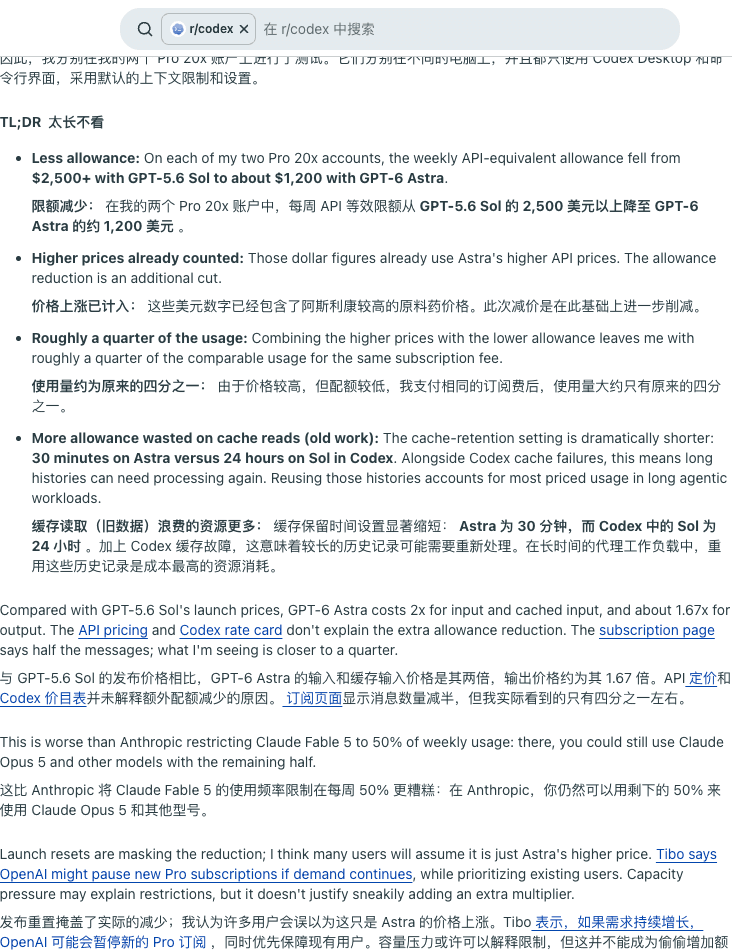
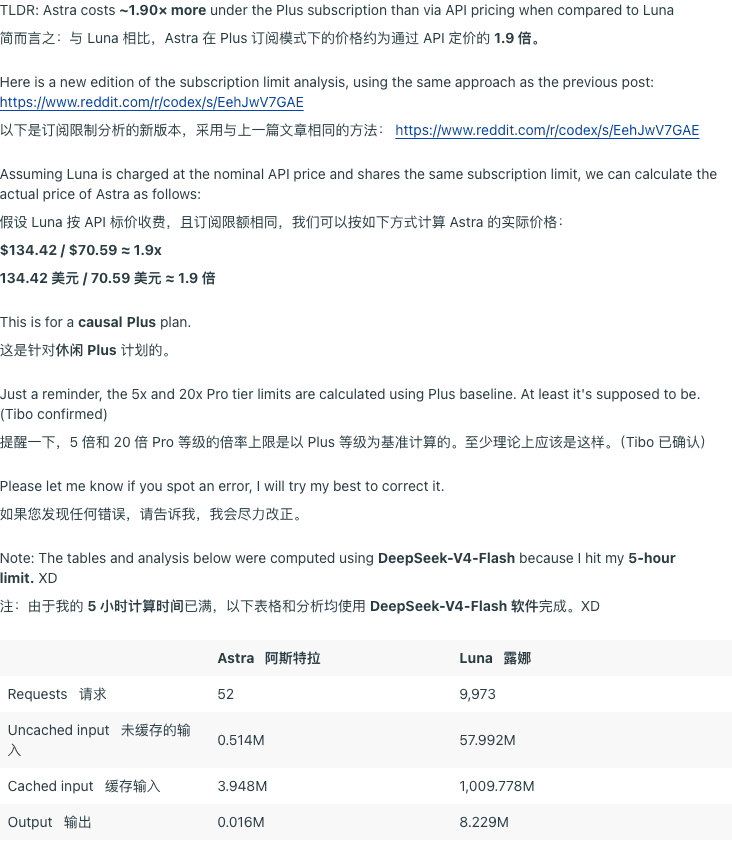
D'abord, les maths d'allocation : sur deux comptes Pro, l'allocation hebdomadaire équivalente API est tombée de plus de 2 500 $ avec Sol à environ 1 200 $ avec Astra — prix plus élevés déjà comptés — laissant « environ un quart de l'usage comparable pour le même abonnement ». Ensuite, le taux effectif : un abonné Plus a dérivé Astra à ~1,90x son prix API face à Luna à allocation égale (134,42 $ contre 70,59 $ d'usage mesuré). Enfin, l'expérience de la combustion :
« Astra est vraiment bon, mais pour tout usage sérieux, l'abonnement à 200 $ par mois ne donne tout simplement pas assez de tokens » — c'est le résumé d'un développeur de jeux, la capacité et la frustration dans la même phrase. Si votre usage d'Astra est occasionnel et supervisé, Plus peut suffire ; si c'est le moteur d'un pipeline quotidien, l'API avec Batch est la route prévisible, et l'abonnement la route d'interaction premium.
Deux budgets chiffrés, hypothèses toutes visibles
Tarifs standard contexte court, sans tentatives, outils ni taxes. Arithmétique illustrative, pas des prédictions.
Une question courte, une longue réflexion. 10 000 tokens d'entrée, 2 000 de sortie :
(10 000 × $10 + 2 000 × $50) / 1 000 000 = $0,20Une boucle agentique à froid qui franchit la marche. 300 000 tokens d'entrée — déjà au-delà de 272K, donc tarifs contexte long sur tout — avec 8 000 de sortie :
(300 000 × $20 + 8 000 × $75) / 1 000 000 = $6,60La même boucle sous 272K (disons 260 000 tokens) coûterait 4,00 $. Franchir le seuil a renchéri cette forme de 65%. Maintenant la version tiède : même contexte de 300 000 tokens, 90% en cache, écriture une fois par heure, 8 000 de sortie :
(270 000 × $2 + 30 000 × $20 + 8 000 × $75) / 1 000 000 = $1,68 + écrituresCalcul local
Estimez le coût en tokens de l’API GPT-6 Astra
Utilise les tarifs officiels en USD vérifiés le 22-09-2026. Les valeurs restent dans ce navigateur.
L’écriture en cache est facturée à 1,25x le tarif d’entrée. L’estimation exclut les nouvelles tentatives, outils, taxes, la majoration régionale de 10% et les marges des fournisseurs. Au-delà de 272K en entrée, toutes les lignes passent automatiquement aux tarifs contexte long. Vérifier les tarifs actuels
Le calculateur tourne entièrement dans cette page — rien n'est envoyé nulle part. Il applique automatiquement le passage en contexte long au-delà de 272K, tarife le palier de service choisi et sépare les écritures de cache des hits. Ce qu'il ne modélise volontairement pas : les tentatives, les frais d'outils, les 10% régionaux et l'horloge de cache — laissez-les dans votre marge. Revérifiez la grille officielle avant d'engager un budget ; ces chiffres datent du 22 septembre 2026.
Une option pratique : lancer la comparaison dans Tabbit
Après le budget vient la partie ennuyeuse : faire tourner du travail façonné pour Astra demande un endroit où pages, fichiers et appels au modèle vivent ensemble. C'est la place de Tabbit Browser — un navigateur à IA où le sélecteur de modèles, la page en direct et le fichier local partagent une surface, et « essayer Astra en medium, retomber sur Luna si ça échoue » est une sélection, pas un projet d'orchestration.
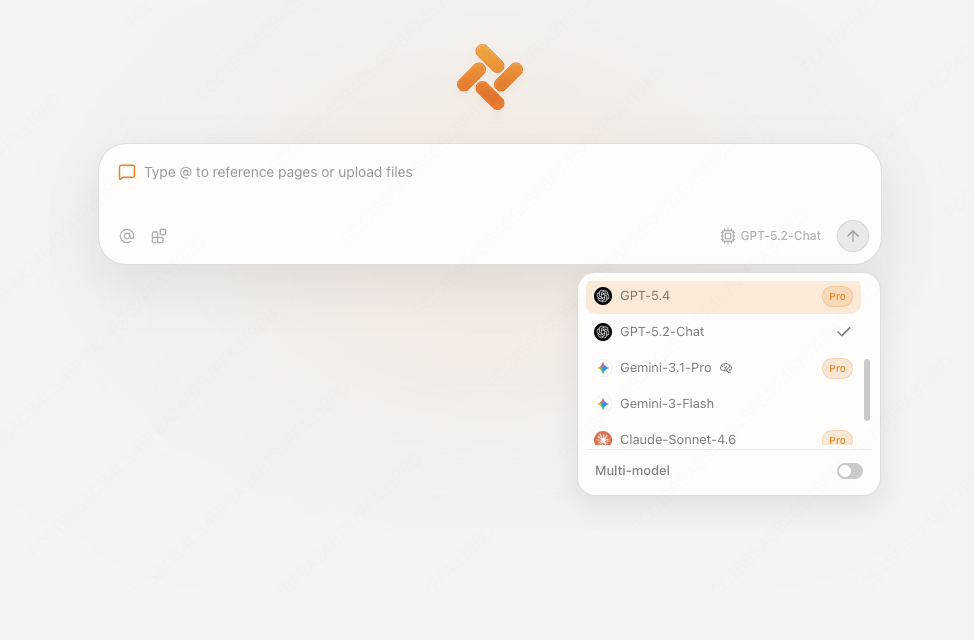
Les limites, dites sans détour : Tabbit est un client, pas une couche de facturation OpenAI. La disponibilité des modèles dépend de votre compte et de votre édition, et rien dans le navigateur ne change ce qu'OpenAI facture — la grille ci-dessus s'applique partout où Astra tourne. Ce que le navigateur change, c'est le coût de montage : la page de ressources GPT-6 Astra (English) et sa collection de prompts (English) décrivent des tâches reproductibles à lancer contre le sélecteur avant d'écrire le moindre code d'orchestration — la façon la moins chère de savoir quel niveau d'effort votre charge exige réellement.
 Tabbit Browser
Si le travail est l'automatisation au niveau navigateur plutôt que la conversation, la vue d'ensemble des navigateurs agentiques, ce qu'est un navigateur agentique et le guide d'automatisation de navigateur couvrent ce flux ; le guide des navigateurs à IA est le point de départ général.
Table de décision du prix de GPT-6 Astra
| Votre charge | Moteur de coût | Meilleure route de départ | À surveiller |
|---|---|---|---|
| Chat interactif, réponses courtes | Tokens de sortie | API en effort low/medium, ou Plus | La sortie à $50/M domine ; 5x l'entrée |
| Évaluations ou enrichissements nocturnes | Volume | Batch à 50% | Limites de file par palier ; résultats en heures |
| Longues boucles agentiques sous 272K | Lectures et écritures de cache | Standard avec préfixes stables en cache | Rétention de cache rapportée à ~30 minutes |
| Contextes au-delà de 272K | La marche | Restructurer pour rester sous, ou budgéter 20/75 | Toute la requête est retarifée, pas juste l'excédent |
| Production sensible à la latence | Fast mode | Fast (2x) sur l'effort minimum suffisant | Le choix d'effort déplace le coût plus que le palier |
| Usage intensif quotidien grand public | Allocation d'abonnement | Pro (dès 100 $) ou API+Batch | Quota brûlé ~4x plus vite que Sol selon les rapports |
Verdict final
GPT-6 Astra est tarifé comme un ingrédient pour travail difficile, et il facture comme tel. Achetez-le quand la tâche est longue, gourmande en outils et coûteuse à superviser — puis achetez-le soigneusement : Batch pour tout ce qui peut attendre, effort low jusqu'à ce qu'un test d'acceptance dise le contraire, contextes conçus sous 272K et préfixes favorables au cache mesurés contre une horloge de 30 minutes. Laissez à Luna ou Terra le volume qui n'a pas besoin du flagship ; l'échelle familiale existe précisément pour que le flagship soit une décision de routage, pas un défaut.
Si Astra est votre moteur quotidien sur API, budgétez par tâche terminée (tentatives et frais d'outils inclus) et revérifiez chaque mois la page officielle des prix — la base promotionnelle de Sol porte une date du 21 novembre et toute l'échelle peut bouger. La comparaison dédiée des alternatives reste en préparation ; en attendant, les ressources du modèle (English), la présentation et les registres communautaires liés plus haut sont la piste des sources.
Sources
Tarifs de l'API OpenAI et page du modèle gpt-6-astra — grilles, règles de paliers et limites, vérifiés le 22 septembre 2026
Tarifs ChatGPT — affichages Free/Go/Plus/Pro, vérifiés le 22 septembre 2026
Sam Altman, 30 juillet 2026 — annonces de baisses Luna/Terra et Fast mode de Sol
Page de sortie GPT-6 Astra d'Artificial Analysis — instantané intelligence, vitesse et coût par tâche selon l'effort, 22 septembre 2026
OpenRouter GPT-6 Astra — instantané tarifs et latence par fournisseur, 22 septembre 2026
Registres communautaires avec captures et conditions dans le texte : r/codex 1w6hvo9, r/codex 1wciwc1, r/codex 1w8r103, r/LLMDevs 1w9z8nb, r/ChatGPT 1w9nya5, Ask HN

Questions fréquentes
Combien coûte GPT-6 Astra ?
Le tarif standard de l'API, vérifié sur les pages d'OpenAI le 22 septembre 2026, est de 10 dollars par million de tokens d'entrée, 1 dollar par million d'entrée en cache, 12,50 dollars par million d'écriture de cache et 50 dollars par million de sortie. Les prompts de plus de 272K tokens d'entrée sont facturés aux tarifs contexte long supérieurs (20 dollars d'entrée, 2 en cache, 25 d'écriture, 75 de sortie) pour la requête entière. Batch et Flex sont à 50% du standard, Fast mode au double, et les endpoints régionaux de résidence des données ajoutent 10%.
GPT-6 Astra est-il disponible gratuitement ?
Pas sur le palier gratuit de l'API. Le tableau de limites d'OpenAI marque le niveau Free de gpt-6-astra comme non pris en charge, l'accès payant commençant au Tier 1. Côté grand public, l'offre gratuite de ChatGPT donne du texte illimité avec GPT-5.6 Luna mais pas d'Astra ; Plus inclut un accès limité à Astra, et Pro est présenté comme propulsé par GPT-6 Astra.
Pourquoi GPT-6 Astra coûte-t-il 2,5 fois plus que GPT-5.6 Sol ?
OpenAI positionne Astra pour le travail de bout en bout le plus difficile (raisonnement, code, computer use, recherche) et le tarife à 10/50 dollars contre 4/20 pour Sol. À noter : les tarifs actuels de Sol sont promotionnels, disponibles au moins jusqu'au 21 novembre 2026, donc la base de comparaison elle-même peut bouger. Quand Astra finit en moins de tentatives, le coût par tâche converge vers Sol.
ChatGPT Pro vaut-il le coup juste pour GPT-6 Astra ?
Cela dépend de la forme de votre charge. Pro s'affiche à partir de 100 dollars par mois avec 5x d'usage et le raisonnement Astra, mais des mesures communautaires décrivent une allocation hebdomadaire équivalente API passant d'environ 2 500 dollars avec Sol à environ 1 200 avec Astra, une rétention de cache d'environ 30 minutes et des utilisateurs intensifs épuisant vite leurs quotas. Si vos tâches sont longues et agentiques, budgétez soigneusement ou passez par l'API avec Batch quand la latence le permet.
Quelle est la façon la moins chère d'utiliser GPT-6 Astra ?
Combinez les leviers : envoyez le travail non urgent via Batch ou Flex à 50% du tarif standard ; commencez à un effort de raisonnement low ou medium et n'augmentez que si les tests d'acceptation échouent ; gardez les prompts sous 272K tokens d'entrée pour éviter la marche du contexte long ; et mettez en cache des préfixes stables pour que les relectures soient facturées 1 dollar au lieu de 10 par million.
Les prix de l'API GPT-6 Astra incluent-ils les appels d'outils ?
Non. Les tarifs publiés ne couvrent que l'entrée et la sortie de texte. OpenAI indique que les modèles à outils, comme la recherche web ou computer use, sont facturés à l'appel, séparément du prix au token ; un agent qui cherche 40 fois a donc un second compteur qui tourne.