
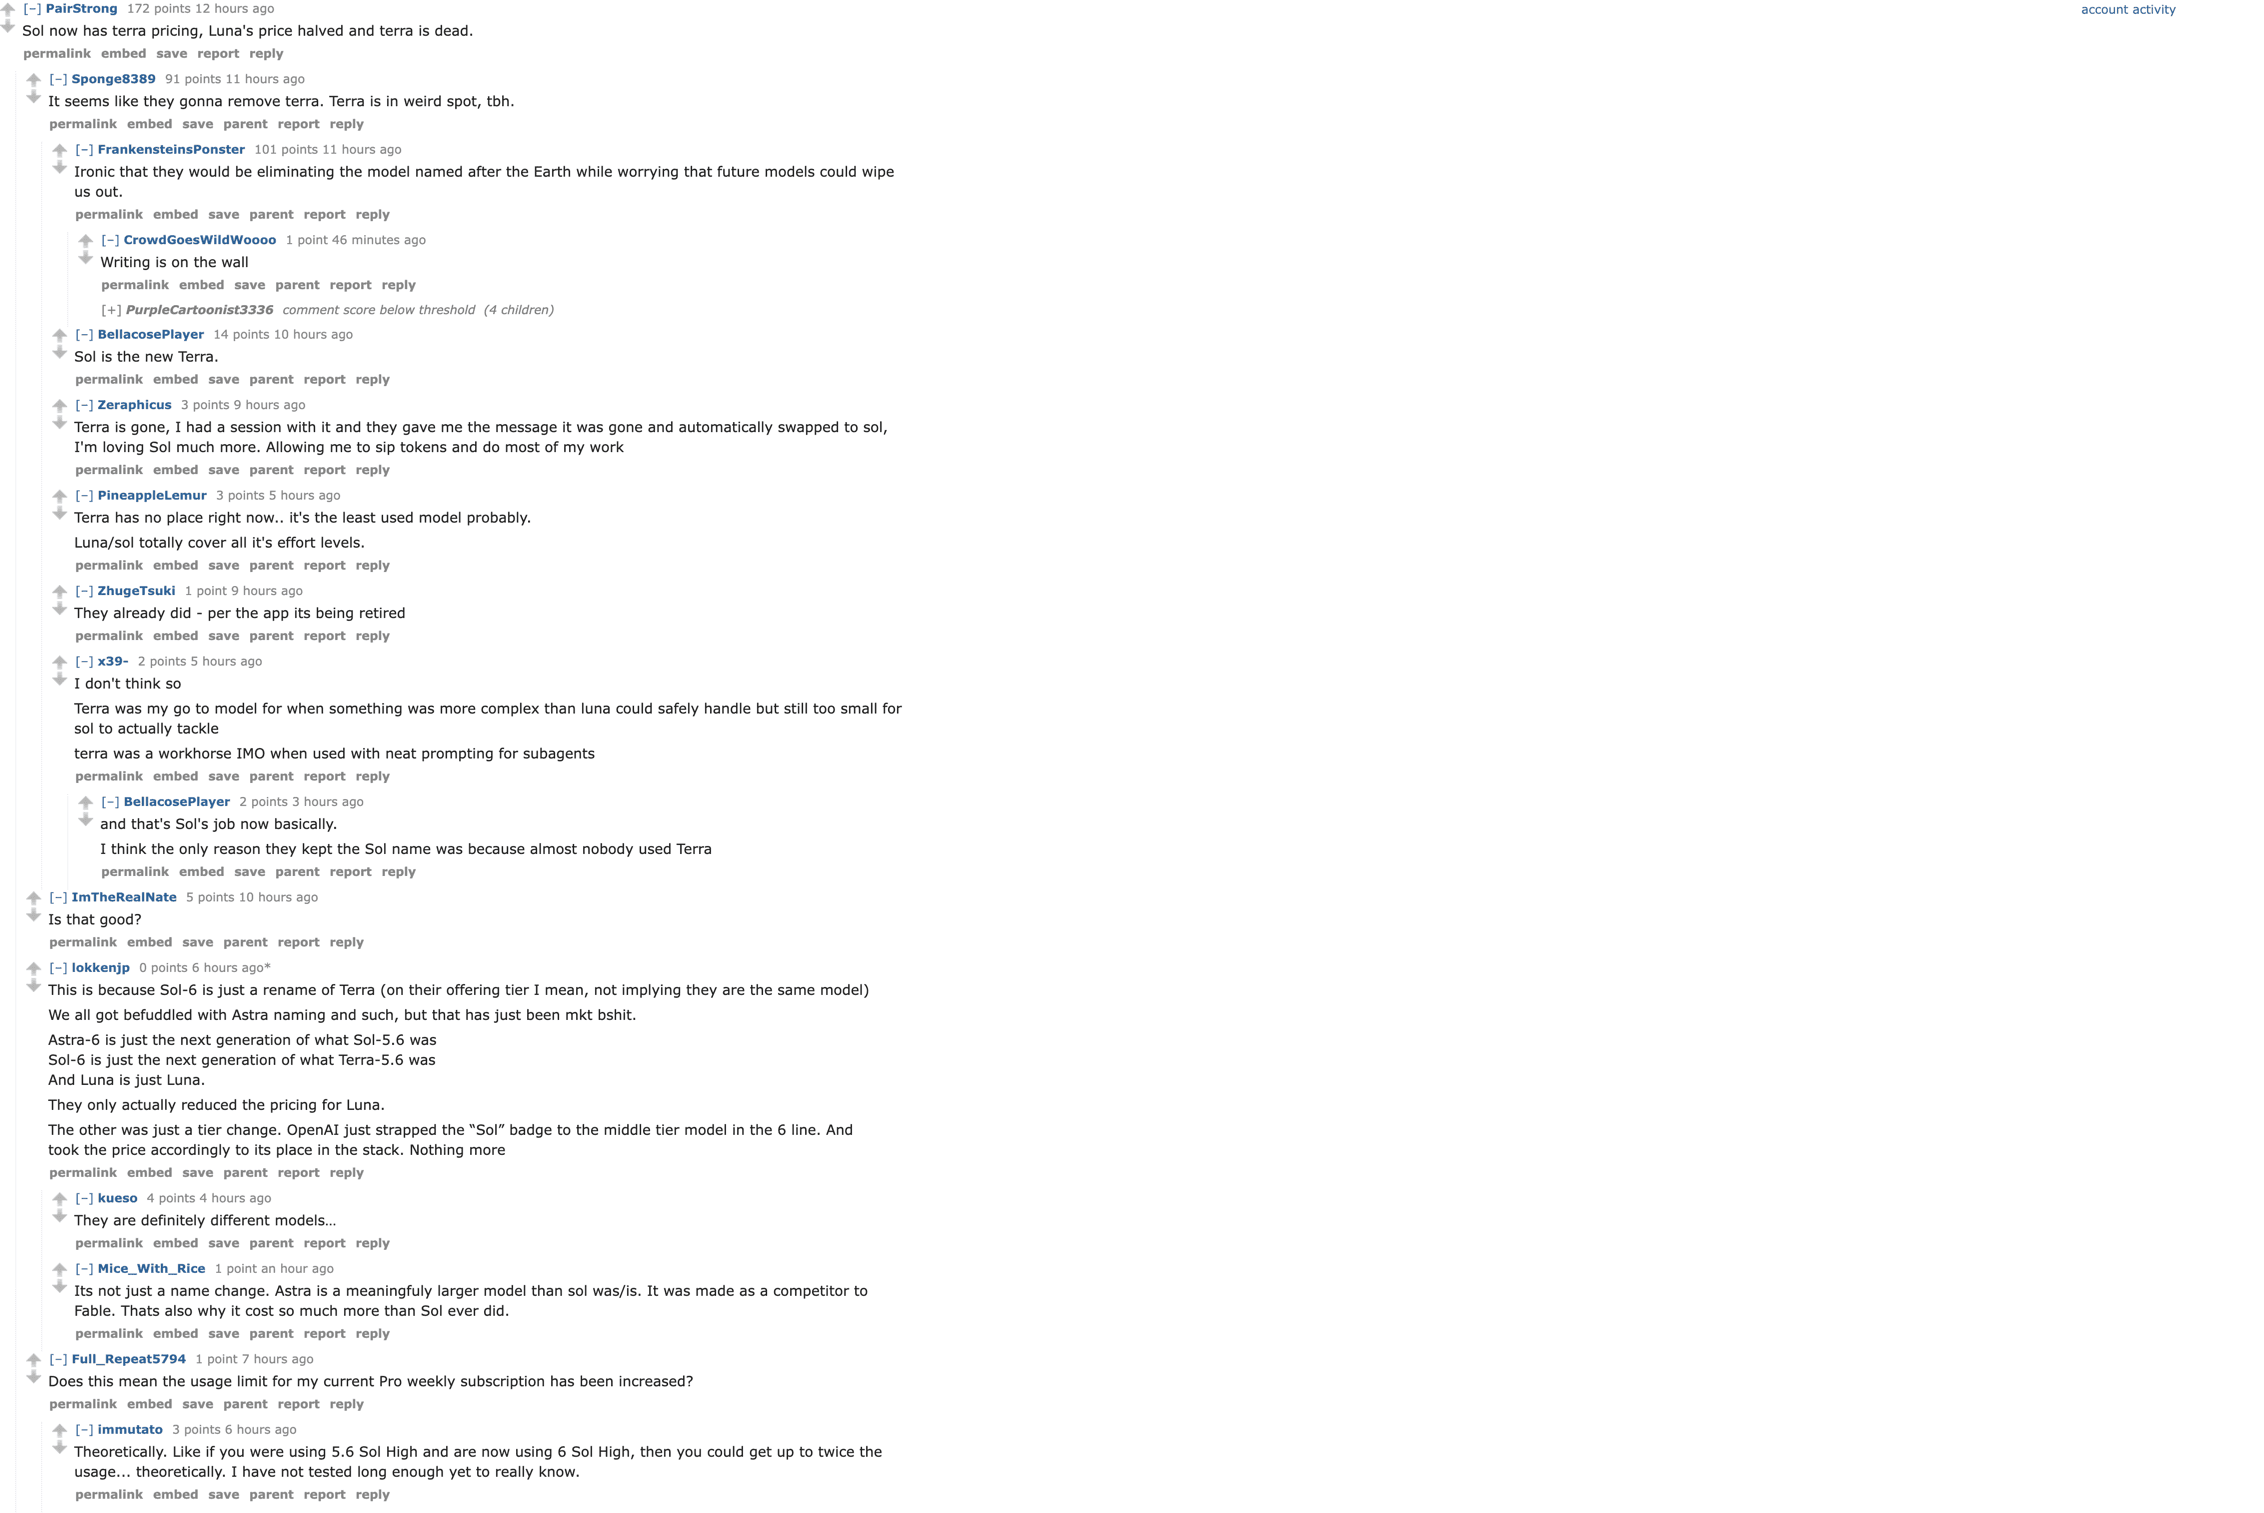
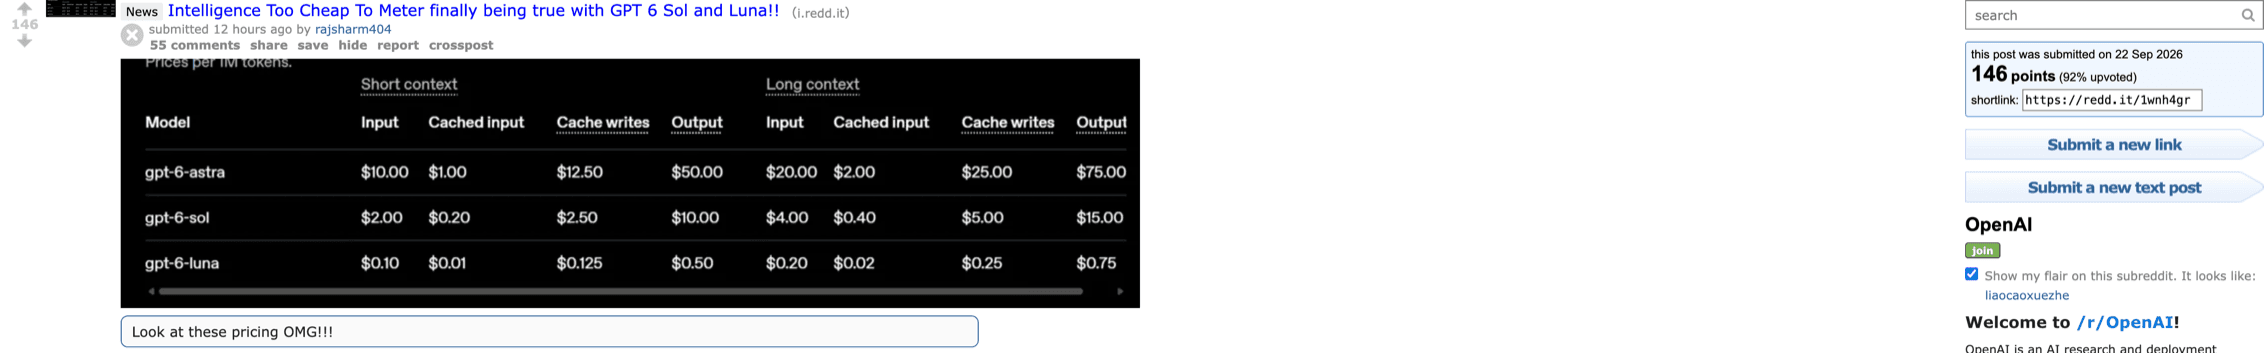
GPT-6 Luna coûte $0.10 par million de tokens d'entrée et $0.50 par million de tokens de sortie sur la grille tarifaire standard de l'API OpenAI, vérifié le 23 septembre 2026. L'entrée en cache est à $0.01, les écritures de cache à $0.125, et les prompts de plus de 272K tokens d'entrée re-pricent toute la requête aux tarifs de contexte long. La réaction du jour de lancement sur r/codex a résumé la grille en une ligne : "Sol now has terra pricing, Luna's price halved and terra is dead." Face aux tarifs GPT-5.6 Luna affichés dans l'annonce ($0.20/$1.20), l'entrée a baissé de 50% et la sortie de 58%. (fil r/codex ; tarifs OpenAI)
Mais le prix affiché est le chiffre le moins intéressant de cette grille. À $0.10/$0.50, le tarif apparaît à peine sur la plupart des factures — ce qui décide de votre dépense, c'est le niveau d'effort de raisonnement utilisé (un écart de 15x à prix de token identique), votre taux de succès de cache, et le franchissement ou non des 272K tokens par un prompt. Cette page sépare la grille tarifaire API des abonnements ChatGPT et Codex, présente le tableau complet avec sources et dates, et se termine par des budgets chiffrés et un calculateur qui tourne dans votre navigateur. Si votre prochaine étape après le budget est de faire tourner Luna sur des pages web et des fichiers, Tabbit Browser est une option de client ; il ne change pas la facturation d'OpenAI.
Points clés
Le contexte court standard de GPT-6 Luna coûte $0.10 en entrée, $0.01 en entrée en cache, $0.125 en écritures de cache et $0.50 en sortie par million de tokens ; un porte-parole d'OpenAI a confirmé à VentureBeat qu'il s'agit de tarifs permanents, non promotionnels.
Le réglage d'effort domine la facture : Artificial Analysis mesure la même grille entre $0.0045 par tâche Index (low) et $0.07 (max) — 15x — et le défaut de l'API est medium, pas max.
Au-delà de 272K tokens d'entrée, chaque token de la requête passe aux tarifs de contexte long ($0.20 / $0.02 / $0.25 / $0.75 par million).
Batch et Flex sont listés à la moitié du Standard ; Fast est à 2x ; le traitement régional ajoute 10% là où il s'applique, et la résidence de données UE de Luna n'existe qu'en Standard.
Un tarif de token n'est ni un quota d'abonnement ni un prix par tâche : le volume de sortie (+24% vs le prédécesseur sur les tâches Index d'AA), les tentatives ratées et les régressions de qualité reviennent tous dans le budget.
Tarifs API de GPT-6 Luna en un coup d'œil
Tous les prix sont en USD par million de tokens, issus de la page de tarifs OpenAI et de la page du modèle gpt-6-luna, vérifiés le 23 septembre 2026. Les lignes de contexte long s'appliquent quand l'entrée dépasse plus de 272 000 tokens.
| Niveau de service GPT-6 Luna | Contexte | Entrée | Entrée en cache | Écritures de cache | Sortie |
|---|---|---|---|---|---|
| Standard | entrée ≤272K | $0.10 | $0.01 | $0.125 | $0.50 |
| Standard | entrée >272K | $0.20 | $0.02 | $0.25 | $0.75 |
| Batch / Flex | entrée ≤272K | $0.05 | $0.005 | $0.0625 | $0.25 |
| Batch / Flex | entrée >272K | $0.10 | $0.01 | $0.125 | $0.375 |
| Fast | entrée ≤272K | $0.20 | $0.02 | $0.25 | $1.00 |
| Fast | entrée >272K | $0.40 | $0.04 | $0.50 | $1.50 |
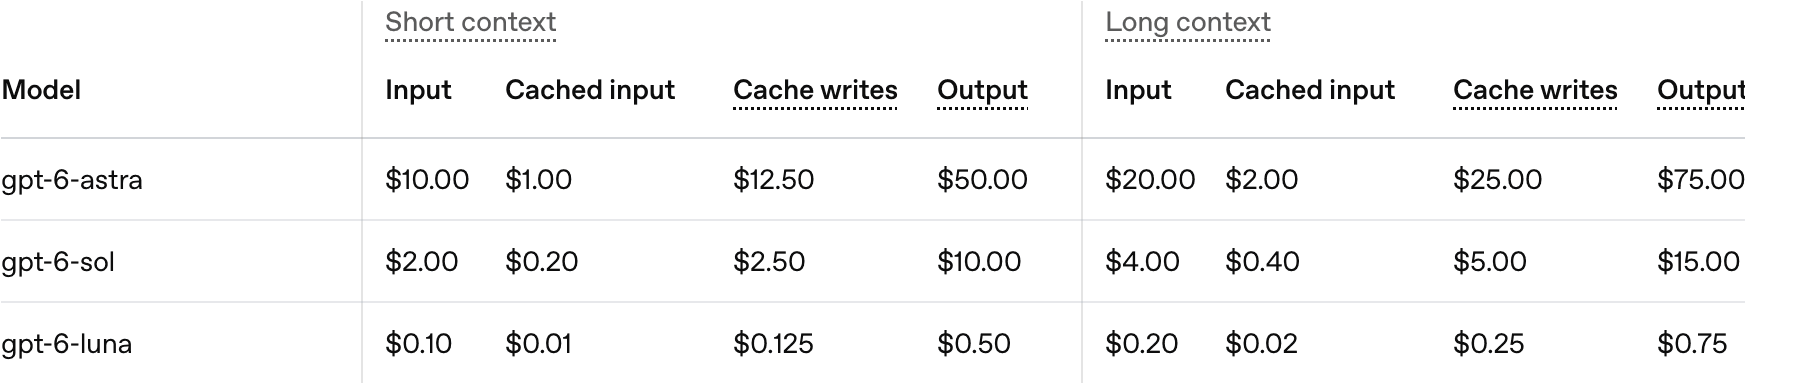
Cette grille s'inscrit dans un escalier familial. Voici les tarifs Standard à contexte court du même tableau :
| Modèle | Entrée | Entrée en cache | Écritures de cache | Sortie | Utilité de la ligne |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | Travail à fort volume et périmètre serré — le positionnement de l'annonce elle-même |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 | Charges de code et d'agents complexes et répétées |
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 | Le palier phare pour les tâches les plus dures |
| GPT-5.6 Sol (prédécesseur, promo) | $4.00 | $0.40 | $5.00 | $20.00 | La base de comparaison encore listée par OpenAI, promo au moins jusqu'au 21 nov. |
Luna est vingt fois moins chère que Sol en entrée et sortie, et cent fois moins chère que Astra. Pour l'économie des paliers frères, lisez le décryptage des prix de GPT-6 Sol et celui des prix de GPT-6 Astra ; pour ce que le palier bon marché achète réellement en capacité — et où il recule — lisez le test de GPT-6 Luna. L'historique des prix du prédécesseur est dans le guide de coûts GPT-5.6 Sol.
Le chiffre qui décide de votre facture : le réglage d'effort
gpt-6-luna accepte des valeurs reasoning_effort de none, low, medium (défaut), high, xhigh et max. Les prix par token ne changent pas entre eux — ce qui change, c'est le nombre de tokens de raisonnement et de sortie. Artificial Analysis suit Luna en six entrées, une par niveau, et son économie mesurée (instantané du 23 septembre 2026) est la suivante :
| Niveau d'effort | Intelligence Index | Coût par tâche Index AA | Vitesse de sortie |
|---|---|---|---|
| low | 21 | $0.0045 | 175 t/s |
Non-reasoning (none) | 18 | $0.01 | 141 t/s |
| medium (défaut) | 29 | $0.02 | 143 t/s |
| high | 32 | $0.03 | 149 t/s |
| xhigh | 34 | $0.04 | 153 t/s |
| max | 37 | $0.07 | 157 t/s |
Deux détails de ce tableau comptent plus que les tarifs ci-dessus :
L'écart est de 15x. La grille qui ressemble à « $0.10/$0.50 » facture entre un demi-cent et sept cents par tâche Index AA selon un simple paramètre de requête. Le défaut est medium ($0.02, Index 29). L'intelligence des communiqués (Index 37) n'existe qu'en max ($0.07). Si vous recopiez les chiffres de benchmark du fournisseur dans un dossier d'affaires, budgétez le niveau auquel le benchmark a tourné.
L'effort low est moins cher que l'absence de raisonnement. À $0.0045,
lowbatnoneà $0.01 sur la charge d'AA, car les exécutions sans raisonnement ont émis plus de tokens de sortie par tâche. « Couper la réflexion pour économiser » n'est pas automatiquement le réglage le moins cher sur ce modèle — c'est une hypothèse à tester sur vos propres traces.
Les chiffres de lancement d'OpenAI vont dans le même sens. Sur AutomationBench — un test de flux métier couvrant 47 outils — GPT-6 Luna en effort high améliore son prédécesseur de 5.4 points de pourcentage à 58% de coût par tâche en moins ; sur la facticité interne, « at higher effort levels it matches GPT-5.6 Sol at about a hundredth its cost ». Lisez cela comme des affirmations conditionnées à l'effort : le palier bon marché les atteint quand vous payez la réflexion.
Un utilisateur du jour de lancement a décrit ainsi l'effet du réglage sur la forme des réponses : "5.6 Luna yapped a lot about unnecessary stuff, while 6 Luna is much more to the point… 6 Luna just gives you the solution and stops talking." La concision fait partie de l'histoire des coûts — mais les inspecteurs d'AA ont aussi relié les régressions de travail de connaissance (rubriques omises, livrables plus minces) à cette même pingrerie de tokens, donc traitez la sortie laconique comme un arbitrage, pas comme un gain gratuit. (commentaire r/codex)

Traduire l'argument « 50% moins cher »
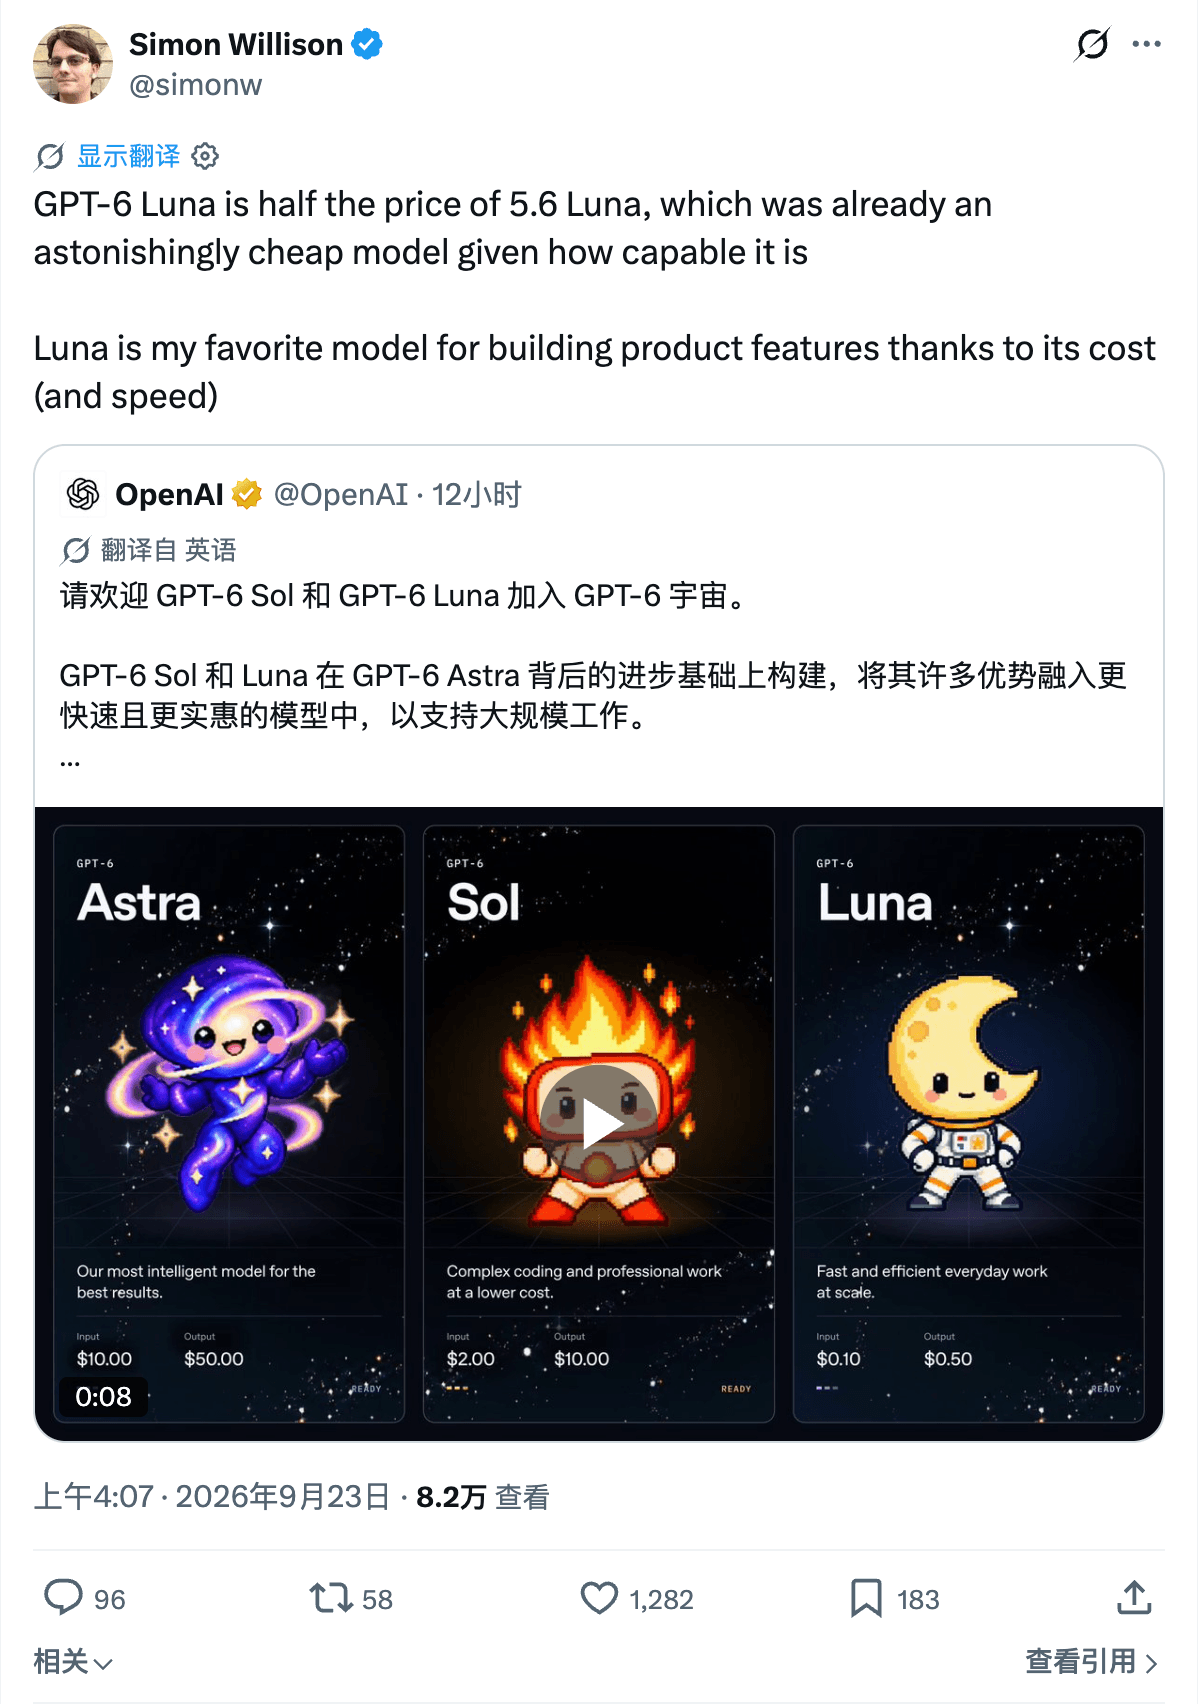
La carte de prix de l'annonce montre Luna passant de $0.20 → $0.10 en entrée et $1.20 → $0.50 en sortie, les deux étiquetées « 50% cheaper ». L'arithmétique donne −58.3% sur la sortie ; le cadrage d'OpenAI compte des paliers de prix en dollars entiers. Aucune lecture n'est fausse, mais la base compte : ces chiffres GPT-5.6 étaient eux-mêmes des tarifs promotionnels, et VentureBeat rapporte qu'un porte-parole a confirmé que les nouveaux prix GPT-6 Sol et Luna sont permanents, non promotionnels. (annonce ; VentureBeat)
La mesure indépendante va dans le même sens et apporte les petites lignes. Artificial Analysis a mesuré Luna (max) à $0.07 par tâche Index contre $0.18 pour GPT-5.6 Luna (max) — environ 60% de moins — alors que le nouveau modèle a utilisé plus de tokens de sortie par tâche (51k contre 41k). C'est la baisse de prix qui a porté l'économie, pas l'efficacité de tokens. Les lecteurs des graphiques de lancement ont lu la même forme : "it really looks like luna 6.0 is just as smart as luna 5.6 at less than half the cost." (fil benchmarks r/codex)

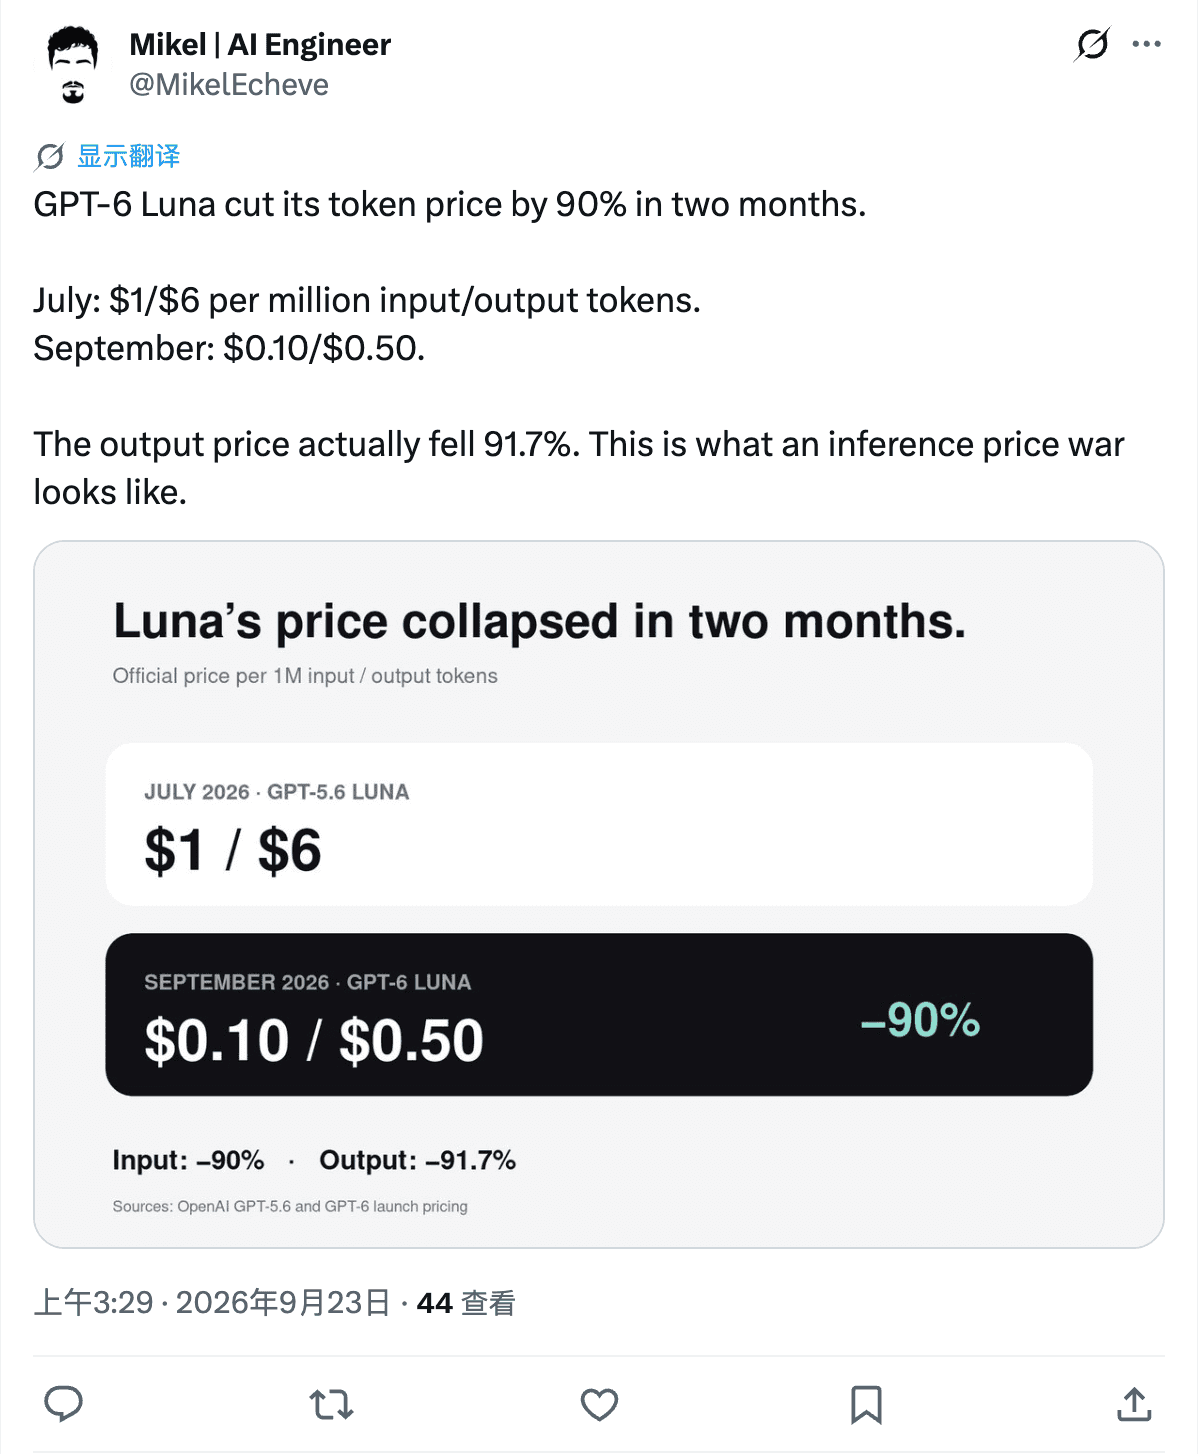
Le cadrage plus large employé par certains praticiens est celui de la guerre des prix. "GPT-6 Luna cut its token price by 90% in two months. July: $1/$6 per million input/output tokens. September: $0.10/$0.50… This is what an inference price war looks like", a publié un ingénieur IA. Le chiffre de juillet — le tarif standard antérieur de GPT-5.6 Luna, avant sa propre promo — est une affirmation de l'auteur, désormais invérifiable sur les pages actuelles d'OpenAI : traitez-le comme contexte communautaire, pas comme historiel officiel. (post X)
L'économie du cache : lectures à $0.01, écritures à $0.125
Pour les boucles d'agents qui renvoient le même contexte, les lignes de cache comptent plus que les tarifs phares. L'entrée en cache de Luna est à $0.01 par million — un dixième de l'entrée neuve, la remise maximale de 90% qu'OpenAI annonce pour le cache GPT-6 — tandis que les écritures de cache sont à $0.125, une prime de 25% sur le tarif d'entrée. Deux règles comptables en découlent : les volumes d'écriture sont une ligne distincte des lectures, et un token se compte une fois — en écriture quand le préfixe est stocké, au tarif de cache sur les tours qui le réutilisent dans la fenêtre d'éligibilité de 30 minutes décrite par OpenAI. (post sur le cache ; page tarifs)
GPT-6 a aussi changé le comportement du cache, pas seulement son prix : les taux de succès sont plus élevés par défaut, et de nouveaux contrôles existent précisément parce que les agents relisent le contexte à chaque tour — un tableau de bord de cache, un diagnostic des échecs, des points d'arrêt explicites, le préchauffage, et la possibilité de changer l'effort de raisonnement entre réponses sans casser le cache (utile quand vous voulez max sur le tour difficile et low sur le suivi routinier). Le post d'OpenAI crédite GitHub d'une réduction de plus de 50% de la part de tokens de prompt nécessitant un traitement neuf sur des milliards de requêtes, et un client d'une baisse de coûts de 20% pour quelques points de succès en plus.
Les praticiens ont remarqué l'économie immédiatement. "Luna is my favorite model for building product features thanks to its cost (and speed)", a écrit Simon Willison le jour du lancement — le motif de routage qui fait des lectures en cache à $0.01 et d'une génération à 141–175 t/s la combinaison de travail pour les surfaces produit. (post X)
La falaise de contexte long à 272K
La phrase de la page du modèle est courte : les prompts de plus de 272K tokens d'entrée sont facturés à 2x sur l'entrée et le cache et 1.5x sur la sortie pour la totalité de la requête. C'est un seuil au niveau de la requête, pas une surtaxe sur les tokens excédentaires. Un prompt de 273 000 tokens ne paie pas le tarif de contexte court sur ses premiers 272K — toutes les catégories facturées, sortie comprise, utilisent la ligne de contexte long.
La fenêtre elle-même est de 1 050 000 tokens avec 128 000 de sortie maximale. « Tient dans le contexte » et « même prix par token » sont deux propositions distinctes. Si vos prompts frôlent le seuil, gardez une marge : un document ajouté peut re-pricer la requête entière. C'est la même structure de falaise que Sol — le guide des prix GPT-6 Sol la détaille, et la même discipline s'applique ici au dixième de l'échelle.
Les lignes au-delà du tarif phare
Batch et Flex divisent la grille par deux ; Fast la double. OpenAI liste Batch et Flex à 50% des tarifs Standard — le levier unitaire le plus fort pour le travail tolérant à la latence. Le mode Fast (Priority a été renommé Fast le 30 juillet 2026) est à 2x. Vérifiez que votre endpoint utilise réellement le palier avant d'inscrire l'un ou l'autre multiplicateur au budget.
Le traitement régional ajoute 10%. Les endpoints de résidence de données éligibles pour les modèles sortis après le 5 mars 2026 portent une majoration de 10%, et la résidence de données UE de GPT-6 Luna n'est disponible qu'avec le traitement Standard.
Les tokens d'outils se facturent au tarif du modèle. Les tokens consommés par les outils intégrés sont facturés aux tarifs de token du modèle choisi ; certains outils et sessions hébergées ont des frais distincts. Les tentatives ratées ayant consommé des tokens appartiennent aussi au budget.
Une variante « Pro » existe chez les routeurs. OpenRouter liste « GPT-6 Luna Pro » — le même modèle sous-jacent, "served with reasoning.mode set to pro for higher-quality responses on complex tasks" — au même prix de base de $0.10/$0.50. C'est une configuration de service côté fournisseur, pas une ligne supplémentaire de la grille OpenAI ; traitez-la comme une option de routage à évaluer, pas comme un modèle différent. (OpenRouter)
Limites : le palier gratuit est fermé. La page du modèle marque gpt-6-luna « non pris en charge » en Free, avec un accès payant dès le Tier 1 (500 RPM / 500K TPM / 5M de tokens de file Batch) jusqu'au Tier 5 (30 000 RPM / 180M TPM). Fait notable : OpenAI publie des limites de tokens par minute plus élevées pour Luna que pour Sol à paliers payants égaux — 2M TPM en Tier 2 pour Luna contre 1M pour Sol — ce qui se lit comme une invitation à utiliser le modèle bon marché en volume. (page du modèle)
| Palier API | RPM | TPM | Limite de file Batch |
|---|---|---|---|
| Free | Non pris en charge | — | — |
| Tier 1 | 500 | 500 000 | 5M tokens |
| Tier 2 | 5 000 | 2 000 000 | 20M tokens |
| Tier 3 | 5 000 | 4 000 000 | 40M tokens |
Source : page du modèle gpt-6-luna d'OpenAI, vérifiée le 23 septembre 2026.
L'escalier familial et le marché ouvert
Dans l'escalier d'OpenAI, la logique de routage est directe : essayez Luna d'abord pour les étapes à fort volume et périmètre serré ; montez vers Sol quand une tentative ratée coûte cher ; gardez Astra pour le travail le plus dur. L'annonce positionne elle-même Luna pour « des tâches plus étroitement définies comme la synthèse, l'extraction et la réponse à des questions directes ».
La découverte contre-intuitive : Luna n'est pas l'API capable la moins chère du marché ouvert. Le tableau comparatif du jour de lancement de VentureBeat liste le Muse Spark 1.2/1.3 Contributor de Meta à $0.10/$0.20 et le MiMo-V2.6-Flash de Xiaomi à $0.14/$0.28 — tous deux avec des taux entrée+sortie inférieurs aux $0.60 de Luna — et le V4.1 Flash de DeepSeek à $0.15/$0.60 hors pointe. Ce que Luna achète avec sa prime, c'est l'écosystème OpenAI : une fenêtre de 1.05M de tokens, la pile d'outils et de cache GPT-6, et une marge de niveaux d'effort depuis des tâches à $0.0045 vers le haut. Si le seul critère est le prix plancher, le marché ouvert fait mieux. (tableau VentureBeat)
| Modèle économique | Entrée / Sortie par 1M | Combiné | Contrainte notable |
|---|---|---|---|
| Muse Spark 1.2/1.3 (Contributor) | $0.10 / $0.20 | $0.30 | Disponibilité du palier Contributor |
| MiMo-V2.6-Flash | $0.14 / $0.28 | $0.42 | Écosystème plus petit |
| GPT-6 Luna | $0.10 / $0.50 | $0.60 | Palier API gratuit fermé ; arbitrages de format (voir le test) |
| DeepSeek-V4.1-Flash (hors pointe) | $0.15 / $0.60 | $0.75 | Tarifs de pointe doublés ; texte seul |
La lecture communautaire de la trajectoire est expansionniste : "I feel 2027 will be the year when intelligence will be economical enough to use at most of the places", a prédit la réponse la plus votée du fil de lancement sur r/OpenAI. Direction utile, invérifiable en tant que prophétie. (fil r/OpenAI)
Ce que la grille tarifaire ne dit pas
Ce n'est pas une calculatrice d'abonnement. Les offres ChatGPT et Codex fixent leurs propres limites d'usage ; une baisse de 50% du prix du token ne double mathématiquement l'allocation d'aucune offre. Au lancement, GPT-6 Luna est arrivé dans ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Business, Enterprise et Edu, tandis que les offres Free et Go ne l'ont obtenu que dans l'app de bureau. L'expérience côté abonnement a suscité ses propres plaintes : "it's faster on xhigh and my usage is barely going down", a rapporté un utilisateur de Codex, et dans un fil tarifs le résumé lapidaire fut "Reduced pricing and reduced limits." L'arithmétique API et les quotas d'offre sont deux achats différents — consultez la page d'usage en direct de votre offre. (commentaire d'usage ; fil tarifs)

Ce n'est pas non plus un prix par tâche. AA a mesuré Luna utilisant 24% de tokens de sortie en plus par tâche Index que son prédécesseur, et ses inspecteurs ont attribué les régressions de travail de connaissance (~75 Elo sur GDPval-AA, ~45 sur AA-Briefcase) à la présentation éludée et aux rubriques omises. Une tâche que Luna rate ou tronque est retentée — sur un modèle plus cher si vous escaladez — et les tentatives sont facturées. Le test de GPT-6 Luna couvre les preuves de qualité ; la conséquence budgétaire est que le chiffre à suivre est le coût par tâche réussie, pas le coût par token : la dépense totale échecs compris, divisée par les tâches réellement livrées.
Une option pratique : Tabbit Browser
Si la question du budget est réglée et que la suivante est où faire tourner Luna sur du vrai travail — pages ouvertes, fichiers, tâches de recherche —, Tabbit Browser est une réponse qui ne demande pas de câbler une intégration API. Son sélecteur de modèles permet de choisir des modèles comme GPT-6 Luna à côté de vos onglets ouverts, et le hub du modèle GPT-6 Luna (English) rassemble les références côté navigateur : notes de prompts (English) pour des requêtes en forme de tâches et notes de tests (English) sur ce que les utilisateurs ont rapporté.
La limite honnête : Tabbit est un client. Il ne change pas les tarifs d'OpenAI, et une estimation de tokens API sur cette page ne prédit l'usage d'aucun abonnement ni client. La disponibilité du modèle dépend du sélecteur en direct de votre compte et édition. Cet article n'a ni facture mesurée Tabbit, ni taux de succès de tâches, ni résultat de latence pour Luna — si vous avez besoin de ces chiffres, exécutez votre propre jeu de tâches fixe et gardez les reçus.
 Tabbit Browser
Pour le contexte de flux — pourquoi un navigateur IA ou un navigateur agentique change l'endroit où un modèle ouvrier bon marché est utile — ces guides couvrent le côté client ; la grille tarifaire ci-dessus reste la source pour la facturation des tokens.
Deux exemples de budget
Les exemples utilisent les tarifs Standard à contexte court, sans majoration régionale, frais d'outils, tentatives ni taxes. Ce sont des illustrations arithmétiques, pas des charges mesurées.
Requête courte. 10 000 tokens d'entrée non mis en cache et 2 000 tokens de sortie :
(10 000 × $0.10 + 2 000 × $0.50) / 1 000 000 = $0.002Boucle d'agent chaude. Une exécution de 40 tours qui renvoie un prompt de 250 000 tokens à chaque tour, avec 90% servi depuis le cache (écrit une fois, réutilisé dans la fenêtre de 30 minutes) et 3 000 tokens de sortie par tour. Par tour :
(225 000 × $0.01 + 25 000 × $0.10 + 3 000 × $0.50) / 1 000 000 = $0.00625 par tour...plus l'écriture unique du préfixe stocké de 225K tokens à $0.125 par million (environ $0.03). Sur 40 tours, la boucle avec cache facture environ $0.28, là où relire le même prompt à froid à chaque tour coûterait environ $1.06 — près d'un écart de 4x à prix de tokens identiques, décidé entièrement par la part de succès de cache. À l'échelle de Luna, ce sont des centimes ; multiplié par un million de tours mensuels, le motif avec cache facture environ $7 000 (écritures comprises) contre environ $26 500 à froid. C'est la forme de charge pour laquelle la ligne d'entrée en cache à $0.01 de Luna, et non son prix phare, est la vraie nouvelle.
Pour planifier : estimation mensuelle = coût moyen par tâche × tâches mensuelles ; coût par tâche réussie = dépense totale tentatives comprises ÷ tâches réussies. Les quotas d'abonnement et d'éventuels frais client ne se déduisent pas de ces formules.
Calcul local
Estimer le coût API de GPT-6 Luna
Tarifs officiels en USD vérifiés le 23/09/2026. Les valeurs restent dans ce navigateur.
Hors outils, nouvelles tentatives, taxes et traitement régional. Écritures et lectures du cache sont facturées séparément. Vérifier les tarifs actuels
Le calculateur tourne dans votre navigateur et n'envoie rien nulle part. Il estime les charges de tokens à partir de votre volume d'entrée, de la part de cache, des écritures de cache, de la sortie, du nombre d'exécutions et du niveau de service ; il bascule aux tarifs de contexte long au-delà de 272K d'entrée. Il n'inclut pas le traitement régional, les frais d'outils, les taxes, les marges de fournisseurs, les tentatives ni les limites d'abonnement.
Prix de GPT-6 Luna : quelle option choisir ?
| Si votre priorité est… | Commencez par… | À garder dans l'estimation |
|---|---|---|
| Volume maximal, tâches au périmètre serré | Luna en effort low ou medium | L'écart de 15x entre niveaux, la hausse des tokens de sortie, les tentatives |
| Raisonnement profond mais bon marché sur les étapes dures | Luna en high/xhigh, préfixe en cache | Fenêtre de 30 minutes ; changer d'effort préserve le cache |
| Pipelines par lots ou hors ligne | Batch ou Flex si éligibles | Tarif de 50% du palier ; contraintes de file et de latence |
| Prompts proches de 272K | Réduire le contexte ou budgéter la ligne longue | Re-pricing de toute la requête au-delà du seuil |
| Latence interactive | Effort low ou none ; Fast seulement si nécessaire | Fast double les tarifs ; le TTFT varie par niveau |
| Usage ChatGPT/Codex grand public | Les limites propres à l'offre concernée | Les quotas d'offre ne sont pas de l'arithmétique de tokens API |
Verdict
La grille de GPT-6 Luna est la moins chère à laquelle OpenAI ait jamais vendu un modèle de classe GPT-6 : $0.10/$0.50 par million, permanent selon le porte-parole de l'entreprise, avec l'entrée en cache au dixième. Le budget honnête traite l'étiquette comme le plancher, pas comme la facture. Le seul réglage d'effort déplace le coût mesuré par tâche de 15x entre low et max ; le volume de sortie a augmenté face au prédécesseur ; la falaise de 272K re-price des requêtes entières ; et les régressions de qualité se convertissent en coûts de tentative exactement sur les charges où vous célébreriez le prix. Réglez l'effort délibérément, exploitez le cache agressivement, surveillez le coût par tâche réussie — et comparez les abonnements sur leurs allocations publiées, jamais par arithmétique de tokens.
Les réactions du jour de lancement sont directionnelles, pas arrêtées : enthousiasme pour l'« intelligence trop bon marché pour être mesurée », prudence car "the consequence of its work will not be seen or measured… until a few days". La page de prix d'OpenAI est la source en direct ; revérifiez-la avant d'engager un budget.
Sources
Tarifs API OpenAI — lignes Luna, Sol, Astra et GPT-5.6 Sol ; notes régionales et Fast ; vérifié le 23 septembre 2026.
Page du modèle gpt-6-luna d'OpenAI — contexte, sortie, valeurs d'effort, clause 272K, limites ; vérifiée le 23 septembre 2026.
OpenAI : Introducing GPT-6 Sol and Luna — carte des changements de prix, affirmations AutomationBench et facticité, disponibilité.
OpenAI : Better prompt caching for GPT-6 — remise de 90%, fenêtre de 30 minutes, contrôles de cache, résultats GitHub et clients.
Artificial Analysis : tableau de bord de lancement GPT-6 Luna — instantané Index, coût par tâche et vitesse par niveaux, 23 septembre 2026.
Artificial Analysis : GPT-6 Sol and Luna push the cost efficiency frontier — coût par tâche de $0.18 → $0.07, hausse des tokens de sortie, attributions des régressions.
VentureBeat : OpenAI releases GPT-6 Sol and Luna — confirmation de permanence ; tableau de prix inter-fournisseurs, 22 septembre 2026.
OpenRouter : GPT-6 Luna et GPT-6 Luna Pro (batch) — listes de fournisseurs et la variante de service Luna Pro, 23 septembre 2026.
Registres communautaires avec captures et conditions dans le texte : r/codex 1wngvak, r/codex 1wnhyh0, r/codex 1wnmhnq, r/codex 1wnhuru, r/OpenAI 1wnh4gr, X : Simon Willison, X : Mikel Echeve.

Questions fréquentes
Combien coûte GPT-6 Luna par million de tokens ?
Les tarifs API standard à contexte court d'OpenAI sont de $0.10 par million de tokens d'entrée, $0.01 par million d'entrée en cache, $0.125 par million d'écritures de cache et $0.50 par million de tokens de sortie. Au-delà de 272 000 tokens d'entrée, toute la requête passe aux tarifs de contexte long : $0.20, $0.02, $0.25 et $0.75 respectivement.
Le tarif API de GPT-6 Luna est-il permanent ou promotionnel ?
L'annonce de lancement présente les nouveaux tarifs comme inférieurs de 50% aux prix promotionnels GPT-5.6, et un porte-parole de l'entreprise a confirmé à VentureBeat que les tarifs de GPT-6 Sol et Luna sont des prix permanents, ni promotionnels ni d'introduction. Le tarif de comparaison GPT-5.6 Sol reste étiqueté promotionnel au moins jusqu'au 21 novembre 2026.
Quelle est la façon la moins chère d'utiliser GPT-6 Luna ?
Trois leviers dominent la facture : le niveau de raisonnement, le cache et le niveau de service. Artificial Analysis mesure la même grille entre $0.0045 par tâche Index en effort low et $0.07 en max, la lecture en cache coûte un dixième de l'entrée neuve, et Batch ou Flex sont listés à 50% des tarifs Standard pour les travaux qui tolèrent leurs délais.
GPT-6 Luna a-t-il une tarification de contexte long ?
Oui. Les prompts de plus de 272 000 tokens d'entrée sont facturés à 2x sur les tarifs d'entrée et de cache et 1.5x sur la sortie pour la totalité de la requête, pas seulement pour les tokens au-delà du seuil. La fenêtre de contexte est de 1 050 000 tokens : tenir dans le contexte ne signifie pas payer le tarif de contexte court.
Le tarif API de GPT-6 Luna équivaut-il à l'usage ChatGPT ou Codex ?
Non. L'API facture des tokens ; les offres ChatGPT et Codex définissent leurs propres limites d'usage. Au lancement, GPT-6 Luna était disponible dans ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Business, Enterprise et Edu, tandis que les offres Free et Go ne l'obtenaient que dans l'app de bureau. Une baisse du prix du token n'augmente pas automatiquement l'usage d'un abonnement.
Peut-on utiliser GPT-6 Luna sur le palier API gratuit ?
Non. Le tableau de limites de la page du modèle marque gpt-6-luna « non pris en charge » sur le palier Free, avec un accès payant à partir du Tier 1 (500 requêtes par minute, 500 000 tokens par minute). OpenAI publie aussi des limites de tokens par minute plus élevées pour Luna que pour Sol à paliers payants égaux.