
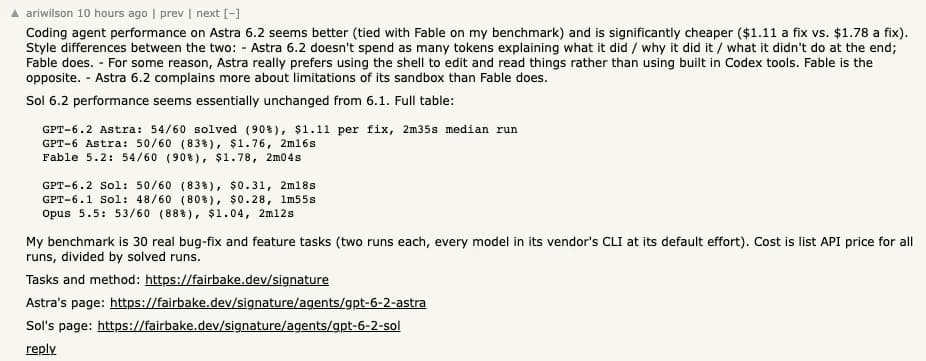
Prueba GPT-6.2 Sol para cambios rutinarios en Codex, escritura con fuentes conocidas y automatizaciones con controles claros. Si tienes que encontrar una pista en un repositorio o un conjunto de datos desconocido, conserva 6.1 Sol como referencia. En Hacker News, ariwilson comparó las dos versiones en 30 arreglos y cambios funcionales. La nueva versión resolvió dos ejecuciones más y tardó más en la mediana. Comparación original
El 17 de noviembre de 2026, GPT-6.2 Sol completó el examen de análisis de Plotly por 1,22 USD, frente a 2,61 USD de GPT-6.1 Sol. Acertó 40 de 43 preguntas. Su predecesor acertó las 43. Los tres fallos exigían buscar un patrón oculto. Comprueba cuánto tiempo de revisión añadiría un fallo de ese tipo en tus tareas. Informe de Plotly
Si las fuentes están repartidas en varias pestañas, puedes reunirlas y usar GPT-6.2 Sol en Tabbit Browser. El ejemplo utiliza el mismo material de entrada para cada modelo.
Puntos clave
Empieza en Medium y fija las comprobaciones antes de ejecutar la tarea.
En Plotly, la mediana bajó de 17,6 a 10,5 segundos por pregunta. Sol 6.2 encontró dos patrones ocultos de cinco y su predecesor encontró los cinco.
La API Standard conserva los precios de 6.1 Sol. Mide uso, reintentos y correcciones para calcular el ahorro.
En la prueba de agentes de programación de Artificial Analysis, el índice bajó tres puntos al máximo esfuerzo en Codex. Gran parte de la diferencia se observó en preguntas sobre repositorios.
Prueba Astra en los casos difíciles si repasar un fallo lleva mucho tiempo.
Dónde usar GPT-6.2 Sol
En la API, gpt-6.2-sol acepta texto e imágenes y devuelve texto. Su ventana es de 1.050.000 tokens, con 922.000 de entrada y 128.000 de salida como máximos. La API rechaza el esfuerzo none. La ficha de Sol (English) y los ejemplos de configuración (English) reúnen sus opciones. Ficha de OpenAI
| Acceso | Cómo empezar | Qué comprobar |
|---|---|---|
| ChatGPT Work | Selecciona Sol en un plan compatible | Enterprise y Edu requieren activación por el administrador |
| Codex | Selector de modelos o /model | Work y Codex comparten cupo. Ultrafast tiene requisitos propios |
| OpenAI API | Indica gpt-6.2-sol | Standard cuesta 2 USD de entrada, 0,10 USD en caché y 10 USD de salida por millón de tokens |
| Tabbit Browser | Usa GPT-6.2 Sol con las fuentes de tus pestañas y archivos | Conserva los extractos y enlaces para comprobar la respuesta |
Registra por separado la velocidad y el esfuerzo de razonamiento. El anuncio de OpenAI incluye Work en Plus, Pro, Business, Enterprise y Edu, con condiciones para los espacios administrados. Notas de lanzamiento
Qué muestran las pruebas de tareas
Tres preguntas con fuentes fijas en Codex
El equipo editorial hizo una ejecución de Sol 6.2 en Medium con Codex CLI. Entregó las tarifas, los resultados de Plotly y los ajustes de Work y Codex. Pidió tres respuestas que citaran su fuente.
Con 40.000 tokens de entrada, 10.000 de ellos en caché, y 4.000 de salida, la cuenta era 0,060 + 0,001 + 0,040 = 0,101 USD, sin escritura en caché ni herramientas. El modelo acertó el importe, indicó que 6.1 encontró tres patrones más y señaló que el informe omitía la latencia p95. También distinguió High de Ultrafast y citó las tres fuentes. En este ensayo los datos ya estaban en la entrada. Para ejercicios que exigen encontrarlos, consulta las evaluaciones de Sol (English).
Cuando el modelo tiene que buscar los datos
Plotly hizo una ejecución por modelo en Studio Embedded. El nuevo Sol acertó las 38 preguntas ajenas a los patrones ocultos. Las llamadas a herramientas bajaron de 258 a 158 y la salida pasó de unos 70.000 a 45.000 tokens. En las cinco preguntas de patrones, pasó de unas 16 consultas a la base de datos por pregunta a unas nueve. Plotly observó diferencias de hasta tres aciertos al repetir la prueba con otros modelos. Comprueba los fallos en tu contexto antes de atribuirles una frecuencia estable. Método y resultados
Cómo leer los resultados
| Prueba | GPT-6.2 Sol | Referencia | Alcance |
|---|---|---|---|
| Examen de Plotly | 40/43, 1,22 USD | GPT-6.1 Sol 43/43, 2,61 USD | Una ejecución por modelo |
| Patrones ocultos de Plotly | 2/5 | GPT-6.1 Sol 5/5 | Cinco preguntas del mismo examen |
| FrontierCode 2.0, según OpenAI | A menos de 0,5 puntos de Astra | Aproximadamente un quinto de su coste | Ambos en Max, con criterios propios de cada repositorio |
| Índice de agentes de Artificial Analysis | 3 puntos menos | GPT-6.1 Sol en Max | Codex en ambos casos, con menor puntuación en preguntas sobre el repositorio |
En FrontierCode, si falla una condición obligatoria, el resultado recibe un cero. Artificial Analysis observó una caída de 14 puntos en SWE-Atlas-QnA-AA y señaló omisiones de hechos clave. Encontrar todos los lugares donde se llama una función requiere una comprobación distinta de arreglar uno de ellos. Método de Cognition · Datos de OpenAI · Informe de Artificial Analysis
Tres usos para probar primero
Cambios y revisiones con una prueba fiable
Usa un fallo reproducible o un diff pequeño. Pide que cada observación indique archivo, condición y efecto. Si importa el comportamiento en una web, conserva el mismo estado inicial y los mismos pasos. Guía de navegación con Codex
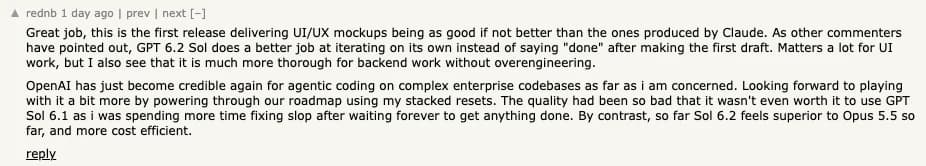
rednb cuenta que 6.2 Sol iteró más sobre sus borradores de interfaz. Es una hipótesis que merece una prueba con las interacciones de tu producto. Comentario original
Análisis recurrente con entradas conocidas
Un informe periódico con columnas, fechas y formato fijados permite comprobar si se repite la ventaja en coste. Valida los recuentos, las unidades y el origen de las cifras. Incluye reintentos y correcciones al calcular el coste por resultado aceptado.
Escritura a partir de fuentes concretas
Prueba una nota de versión o un resumen. Pide mantener nombres, cifras y enlaces, y señalar lo que no aparezca en las fuentes. Si las páginas cambian, guarda la fecha y el extracto con el método de investigación con fuentes verificables.
Dónde hace falta revisar más
Detectar la excepción
Incluye valores cuyas unidades cambian o parámetros definidos en dos sitios. Comprueba si el modelo detecta cada caso y aporta evidencia. Mantén 6.1 Sol como referencia si ya funciona. El análisis de GPT-6 Sol corresponde a una versión anterior.
Encontrar todos los archivos afectados
Una respuesta bien redactada puede omitir una llamada importante. Pide una lista de clientes de una función compartida y compruébala en el código. Sube el esfuerzo si recupera omisiones reproducibles. Prueba Astra si el diagnóstico cruza varios servicios.
Comprobar que el prototipo funciona
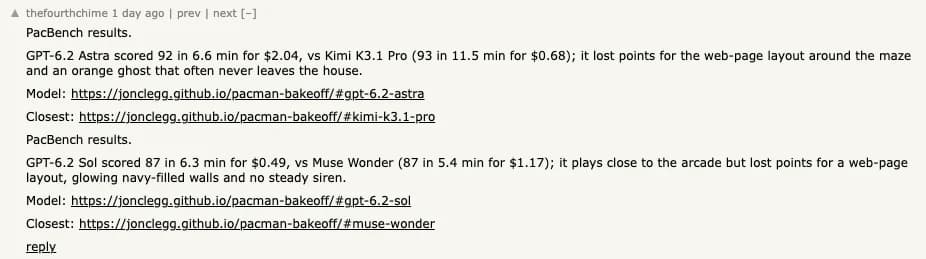
Abre la interfaz al ancho previsto y usa cada control. thefourthchime describió fallos concretos de diseño y sonido en un prototipo. Comentario original
En otro ensayo, prmoustache observó que incluso en High el dibujo dejaba las dos piernas en el mismo lado de la bicicleta. Comentario original

Reúne las mismas fuentes en Tabbit
En una sesión de solo lectura de Tabbit Browser, el equipo comprobó las tres tarifas de la API, los costes y aciertos de ambas versiones, la mediana de 10,5 segundos y los requisitos separados de Ultrafast. Tarifas de OpenAI · Informe de Plotly · Notas de Work

Usa la integración de agentes de Tabbit para reunir las páginas y guarda cifras y enlaces con el flujo de investigación multimodelo. Conserva la misma entrada para cada modelo. Si quieres medir la búsqueda, haz otra ronda con los mismos permisos y páginas iniciales. El equipo obtuvo las fuentes con TabbitDance y ejecutó el ejercicio en Codex. Puedes usar GPT-6.2 Sol con ese material directamente en Tabbit.
Qué elegir según el trabajo
| Trabajo | Punto de partida | Cuándo cambiar |
|---|---|---|
| Cambio pequeño, PR o informe fijo | GPT-6.2 Sol en Medium | Si aumentan los fallos o las correcciones |
| Encontrar pistas o excepciones | Comparar 6.1 Sol y 6.2 Sol | Si un modelo recupera casos importantes con menos revisión |
| Diagnóstico entre servicios | Probar Astra junto a Sol | Si logra más resultados aceptados en los casos difíciles |
| API de gran volumen | Probar 6.2 Sol con peticiones representativas | Según el tiempo total, los reintentos y el coste por resultado aceptado |
Usa una tarea habitual, una excepción conocida y un caso difícil. Conserva tu modelo actual como referencia. Para un punto de comparación anterior, consulta el análisis de GPT-6 Astra. Si trabajas con varias pestañas, reúne las fuentes en Tabbit y prueba Sol con ese material.
 Tabbit Browser

Preguntas frecuentes
¿Es GPT-6.2 Sol mejor que GPT-6.1 Sol?
Prueba 6.2 Sol primero en tareas rutinarias con resultados verificables. En el examen de Plotly costó menos de la mitad, pero encontró dos de cinco patrones ocultos frente a los cinco de 6.1 Sol. Compara las dos versiones en los casos difíciles antes de migrar.
¿Sirve GPT-6.2 Sol para programar en Codex?
Es un buen punto de partida para cambios acotados, revisiones de PR y tareas con pruebas fiables. Para seguir relaciones entre archivos, compáralo con tu modelo actual. Artificial Analysis obtuvo un resultado inferior en preguntas sobre repositorios con ambos modelos al máximo en Codex.
¿Cuánto cuesta GPT-6.2 Sol?
La API Standard cobra por millón de tokens 2 USD de entrada sin caché, 0,10 USD de entrada en caché y 10 USD de salida. La escritura en caché y algunas herramientas pueden sumar costes. Work y Codex comparten el cupo de la suscripción.
¿Está GPT-6.2 Sol en el chat habitual de ChatGPT?
OpenAI lo lanzó el 17 de noviembre de 2026 en ChatGPT Work, Codex y la API. En ChatGPT, la documentación remite a Work. Los administradores de Enterprise y Edu deben habilitar el acceso.
¿Cuándo conviene elegir Astra en vez de Sol?
Empieza con Sol para trabajos fáciles de comprobar. Prueba Astra en diagnósticos que implican varios servicios o cuando la revisión manual resulta cara. Usa los mismos criterios y compara los resultados aceptados y el coste total.
¿Qué esfuerzo de razonamiento conviene usar con GPT-6.2 Sol?
Empieza en Medium en las tareas acotadas y vuelve a probar en High los fallos reproducibles. Mantén Max si soluciona un problema que afecta al resultado. Ultrafast regula la velocidad y tiene sus propios requisitos.