
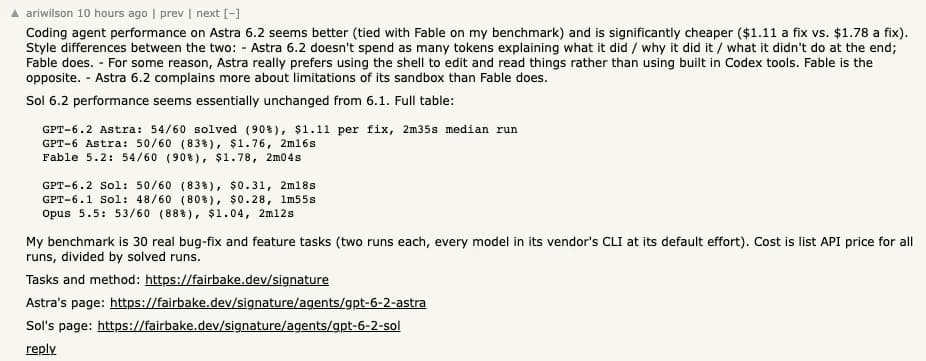
Vale testar o GPT-6.2 Sol para mudanças rotineiras no Codex, textos com fontes conhecidas e automações fáceis de verificar. Se o trabalho é encontrar uma pista em dados ou em um repositório desconhecido, mantenha o 6.1 Sol como referência. No Hacker News, ariwilson comparou as versões em 30 correções e mudanças de funcionalidade. A nova resolveu duas execuções a mais e levou mais tempo na mediana. Comparação original
Em 17 de novembro de 2026, o GPT-6.2 Sol completou as 43 questões da Plotly por US$ 1,22, contra US$ 2,61 do GPT-6.1 Sol. O modelo novo acertou 40 e o anterior acertou todas. Os três erros exigiam encontrar um padrão oculto. Se essas exceções mudam a decisão, vale contar quanto tempo alguém gastaria para localizar e corrigir a omissão. Relatório da Plotly
Quando as fontes estiverem espalhadas em abas, reúna o material e use o GPT-6.2 Sol no Tabbit Browser. O exemplo mantém as mesmas entradas para comparar modelos.
Principais conclusões
Comece em Medium quando houver um jeito claro de conferir o resultado.
A mediana da Plotly caiu de 17,6 para 10,5 segundos por questão. O 6.2 achou dois padrões ocultos de cinco e o 6.1 achou os cinco.
A API Standard conserva os preços do 6.1 Sol. O custo por tarefa depende do uso, das novas tentativas e das correções.
No Codex com esforço máximo, o índice de programação da Artificial Analysis caiu três pontos, principalmente por causa de perguntas sobre repositórios.
Experimente Astra nos casos difíceis quando as tentativas ou a revisão manual custam caro.
Onde usar o GPT-6.2 Sol
Na API, gpt-6.2-sol recebe texto e imagens e produz texto. A janela é de 1.050.000 tokens, com até 922.000 de entrada e 128.000 de saída. A API rejeita o esforço none. Consulte a ficha do Sol (English) e os exemplos de configuração (English). Especificações da OpenAI
| Onde | Como começar | O que conferir |
|---|---|---|
| ChatGPT Work | Selecione Sol em um plano compatível | Enterprise e Edu exigem ativação do administrador |
| Codex | Seletor de modelos ou /model | A cota é compartilhada com Work. Ultrafast tem requisitos próprios |
| API da OpenAI | Informe gpt-6.2-sol | US$ 2 de entrada, US$ 0,10 em cache e US$ 10 de saída por milhão de tokens na Standard |
| Tabbit Browser | Use o GPT-6.2 Sol com as fontes das suas abas e arquivos | Guarde os trechos e links para conferir a resposta |
O esforço afeta o raciocínio, enquanto Ultrafast controla a velocidade. Registre as duas opções na comparação. O lançamento do Work inclui Plus, Pro, Business, Enterprise e Edu, conforme as regras do espaço de trabalho. Notas de lançamento
O que os testes mostraram
Três perguntas com fontes fixas no Codex
A equipe editorial fez um teste com gpt-6.2-sol em Medium no Codex CLI. O material tinha preços da API, resultados da Plotly e ajustes do Work e do Codex. O modelo precisava citar a fonte em cada uma das três respostas.
Com 40.000 tokens de entrada, 10.000 em cache e 4.000 tokens de saída, a conta era 0,060 + 0,001 + 0,040 = US$ 0,101, sem gravações no cache ou ferramentas. O modelo acertou o total e os três itens, disse que a versão anterior encontrou três padrões a mais e observou que o relatório não informa a latência p95. Separou High de Ultrafast e citou as três fontes. Os números já estavam no material. Para tarefas que exigem encontrar os dados, consulte as avaliações do Sol (English).
Quando o modelo precisa buscar os dados
A Plotly rodou cada versão uma vez no Studio Embedded. O 6.2 acertou todas as 38 questões fora da categoria de padrões ocultos. As chamadas de ferramentas caíram de 258 para 158 e os tokens de saída, de cerca de 70.000 para 45.000. Nas cinco questões de padrões ocultos, a média foi de cerca de nove consultas por questão, contra 16. Repetições com outros modelos variaram em até três acertos. Coloque os tipos de erro observados no seu próprio teste. Método e resultados
Como ler os resultados dos benchmarks
| Teste | GPT-6.2 Sol | Comparação | Alcance |
|---|---|---|---|
| Exame da Plotly | 40/43 por US$ 1,22 | GPT-6.1 Sol 43/43 por US$ 2,61 | Uma execução por versão |
| Padrões ocultos da Plotly | 2/5 | GPT-6.1 Sol 5/5 | Cinco questões do mesmo exame |
| FrontierCode 2.0, citado pela OpenAI | A menos de 0,5 ponto do Astra | Cerca de um quinto do custo do Astra | Ambos em Max, com critérios por repositório |
| Índice de programação da Artificial Analysis | Três pontos abaixo | GPT-6.1 Sol em Max | Codex nas duas versões, com piora em perguntas sobre repositórios |
No FrontierCode, descumprir um requisito obrigatório zera a tarefa. A Artificial Analysis registrou uma queda de 14 pontos no SWE-Atlas-QnA-AA, com omissões de fatos importantes. Uma alteração local pode passar nos testes sem que uma busca pelos chamadores encontre todos os arquivos. Método da Cognition · Resultados da OpenAI · Relatório da Artificial Analysis
Três situações para começar com Sol
Mudanças e revisões com testes confiáveis
Use um teste que falha de forma reproduzível ou um diff pequeno. Peça arquivo, condição e efeito de cada problema apontado. Se a verificação depende de uma página, mantenha o estado inicial e os passos iguais. Guia de navegador no Codex
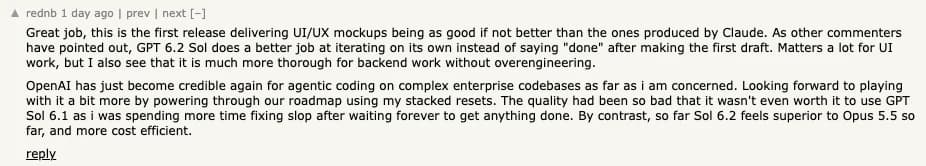
rednb comentou que o Sol 6.2 insistiu mais na revisão dos rascunhos de interface. Vale testar a observação nos fluxos do seu produto. Comentário original
Análise recorrente com entradas conhecidas
Use um relatório periódico com colunas, datas e formato fixos. Confira as contagens, unidades e a fonte dos valores. Inclua novas tentativas e correções no custo por resultado aceito.
Texto a partir de fontes conhecidas
Teste uma nota de versão ou um resumo. Peça que preserve nomes, números e links e indique o que está ausente. Salve o trecho e a data de consulta se a página puder mudar. Pesquisa com fontes verificáveis
Onde redobrar a verificação
Quando encontrar a exceção é o objetivo
Inclua um campo que muda de unidade ou uma configuração definida em dois lugares. Confira quais exceções cada versão identifica e quais evidências apresenta. Mantenha o 6.1 Sol na comparação se ele já funciona bem nesses casos. A avaliação do GPT-6 Sol cobre uma versão anterior.
Quando um chamador esquecido muda a resposta
Pergunte quais clientes usam uma função compartilhada e qual sobrescreve o valor padrão. Confira no código. Aumente o esforço quando isso recuperar falhas reproduzíveis. Teste Astra quando houver vários serviços.
Quando o protótipo precisa funcionar
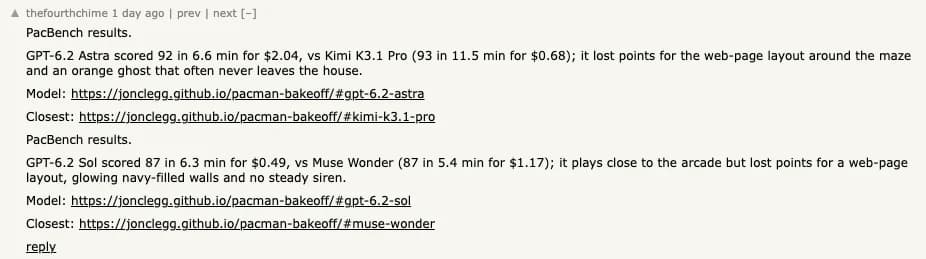
Abra no tamanho de tela previsto e use cada controle. thefourthchime relatou falhas de layout e som em um protótipo gerado. Comentário original
Em outro teste, prmoustache viu o modelo desenhar as duas pernas do mesmo lado da bicicleta mesmo em High. Comentário original

Reúna as mesmas fontes no Tabbit
Em uma sessão de leitura no Tabbit Browser, a equipe conferiu os três preços da API, custos e acertos da Plotly, a mediana de 10,5 segundos e as condições do Ultrafast. Tabela da OpenAI · Relatório da Plotly · Notas do Work

Reúna as páginas com a integração de agentes do Tabbit e salve os trechos e links com o fluxo de pesquisa multimodelo. Dê a mesma entrada a cada modelo. Para avaliar a busca, faça uma rodada separada com as mesmas páginas iniciais e permissões. A coleta foi feita com TabbitDance e o teste rodou no Codex. Você também pode usar o GPT-6.2 Sol diretamente no Tabbit com esse material.
O que escolher para cada trabalho
| Trabalho | Ponto de partida | Quando mudar |
|---|---|---|
| Alteração pequena, PR ou relatório fixo | GPT-6.2 Sol em Medium | Se as omissões ou correções aumentarem |
| Busca de pistas, chamadores ou exceções | Compare 6.1 Sol e 6.2 Sol | Veja quem traz evidências importantes com menos revisão |
| Diagnóstico entre serviços | Teste Astra junto com Sol | Compare quantos casos difíceis cada um passa |
| API em grande volume | Rode 6.2 Sol em pedidos representativos | Compare tempo total, cobrança, tentativas e custo por resultado aceito |
Comece com uma tarefa comum, uma exceção conhecida e um caso difícil. Mantenha o modelo atual na comparação e migre quando o 6.2 Sol passar pelos mesmos critérios com menos custo ou revisão. A avaliação do GPT-6 Astra traz uma referência da geração anterior. Se as fontes estiverem em várias abas, reúna tudo no Tabbit antes de testar.
 Tabbit Browser

Perguntas frequentes
O GPT-6.2 Sol é melhor que o GPT-6.1 Sol?
Experimente o 6.2 Sol primeiro em tarefas rotineiras com resultados verificáveis. O teste da Plotly custou menos da metade, mas o 6.2 encontrou dois padrões ocultos em cinco, contra cinco do 6.1 Sol. Compare os dois modelos nos seus casos mais difíceis antes de migrar.
O GPT-6.2 Sol é bom para programar no Codex?
É um bom ponto de partida para alterações pontuais, revisão de PR e tarefas com testes confiáveis. Quando a resposta exige seguir referências entre arquivos, compare com o modelo atual. No Codex com esforço máximo, a Artificial Analysis observou uma queda nas perguntas sobre repositórios.
Quanto custa o GPT-6.2 Sol?
A API Standard cobra, por milhão de tokens, US$ 2 por entrada sem cache, US$ 0,10 por entrada em cache e US$ 10 por saída. Gravação em cache e algumas ferramentas podem ter cobrança adicional. Work e Codex compartilham a cota da assinatura.
Dá para usar GPT-6.2 Sol no chat comum do ChatGPT?
A OpenAI lançou o modelo em 17 de novembro de 2026 no ChatGPT Work, no Codex e na API. Dentro do ChatGPT, as notas oficiais indicam o Work. Administradores de Enterprise e Edu precisam habilitar o acesso.
Quando escolher GPT-6.2 Astra ou Sol?
Comece com Sol quando a verificação for rápida. Teste Astra em diagnósticos que cruzam serviços ou quando retrabalho e revisão manual forem caros. Use os mesmos critérios e compare aprovações e custo total.
Qual nível de raciocínio usar no GPT-6.2 Sol?
Comece em Medium nas tarefas com escopo claro e teste High nos erros reproduzíveis. Use Max quando o ganho no seu trabalho justificar o custo. Ultrafast é uma opção de velocidade com requisitos próprios.