
Qué es GPT-6.1 Terra y si conviene cambiar
Vale la pena evaluar GPT-6.1 Terra para tareas visuales, redacción concisa a partir de material proporcionado y automatización informática acotada. Es más difícil recomendarlo como sustituto general de GPT-6.1 Sol. Sus tarifas por token son más bajas, pero el nivel de esfuerzo y la cantidad de correcciones humanas determinan si una tarea terminada realmente cuesta menos.
Esta reseña analiza evidencia pública consultada el 27 de octubre de 2026. Reúne documentación de OpenAI, evaluaciones independientes y comentarios de usuarios del día del lanzamiento. No afirma haber realizado un benchmark original de Terra ni una ejecución verificada de Terra seleccionado en Tabbit Browser. Al final encontrarás un flujo de trabajo reproducible, con esa limitación indicada con claridad.
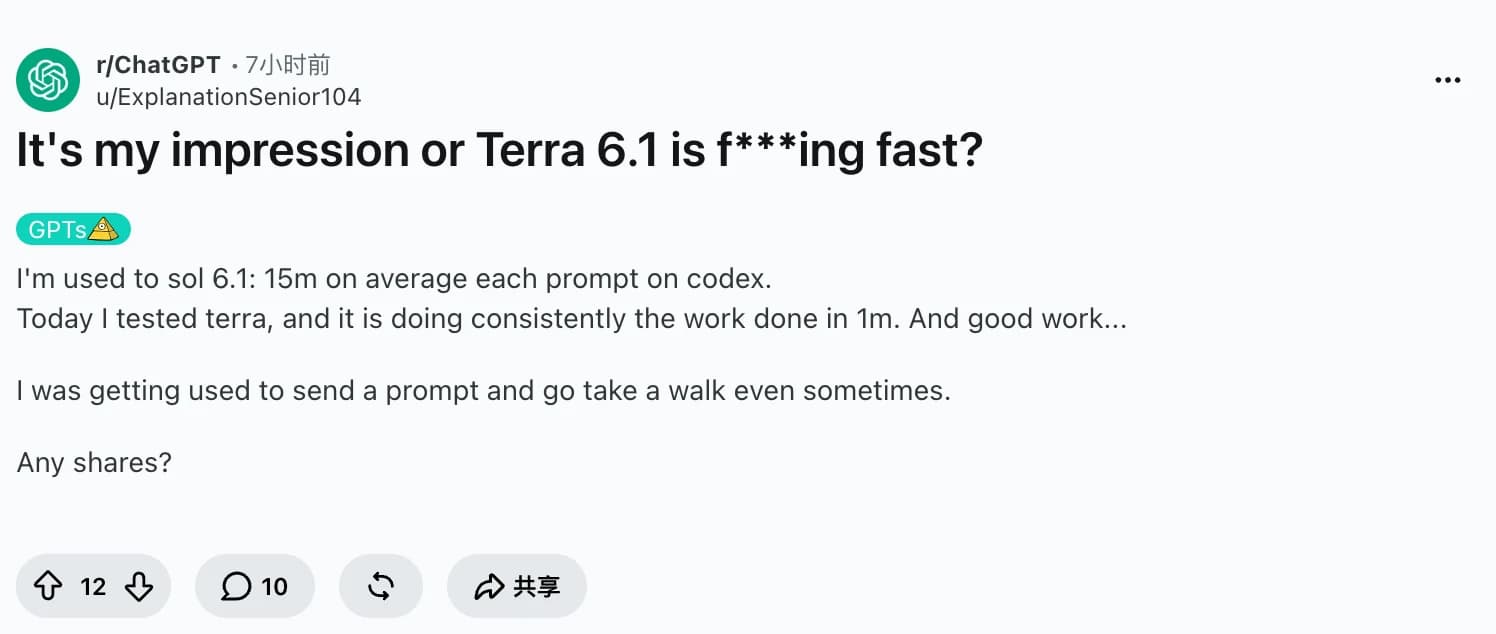
Un usuario de Codex, u/ExplanationSenior104, contó que completaba las tareas mucho más rápido que con Sol. Otros usuarios describieron tareas con documentos que se interrumpían y un consumo de cuota inesperadamente rápido. Ese desacuerdo es el motivo para evaluar el trabajo terminado, en vez de comparar eslóganes de lanzamiento.
OpenAI lanzó Terra el 26 de octubre, con énfasis en el razonamiento visual, el uso del ordenador y la escritura natural. El ID de la API es gpt-6.1-terra. Es el sucesor de GPT-5.6 Terra; no lo confundas con GPT-6 Sol, GPT-6.1 Sol ni con el modelo más pequeño GPT-6 Luna.
Puntos clave
Las tarifas estándar de la API para contextos cortos son 1 $ de entrada y 5 $ de salida por millón de tokens, la mitad de las tarifas correspondientes de Sol. La entrada en caché cuesta 0,05 $ por millón de tokens.
La mejor puntuación de Terra en el Intelligence Index según Artificial Analysis es 48, frente a 52 de GPT-6.1 Sol. Un precio más bajo no implica la misma capacidad general.
El mismo evaluador informa de una diferencia de hasta 7,4 veces en el coste por tarea entre configuraciones de Terra. Elegir el nivel de esfuerzo forma parte de elegir el modelo.
Una prueba sectorial y varios comentarios de usuarios plantean dudas sobre la consistencia y el seguimiento de instrucciones en tareas largas. Justifican hacer comprobaciones, no afirmar que siempre falla.
Antes de cambiar un flujo de trabajo, prueba un conjunto pequeño y fijo de tareas. Mantén separadas las cuotas de suscripción, la facturación de la API y la membresía de Tabbit.
La cifra clave: tokens a mitad de precio y un rango de esfuerzo de 7,4 veces
La comparación interesante no es solo Terra a 1 $/5 $ frente a Sol a 2 $/10 $. La página de lanzamiento actualizada de Artificial Analysis informa de una diferencia de 7,4 veces entre las configuraciones de Terra con menor y mayor coste medio por tarea del Index. Ambas observaciones pueden ser ciertas. Un modelo más barato puede consumir suficientes tokens adicionales, requerir bastantes reintentos o necesitar tantas correcciones que desaparezca su ventaja de precio.
En su evaluación del 26 de octubre, Artificial Analysis sitúa los niveles low y medium de Terra en la frontera de eficiencia de costes del Intelligence Index. El Coding Agent Index muestra otro resultado: allí los niveles low y xhigh están en esa frontera. Un nivel atractivo en un benchmark mixto no tiene por qué ser el adecuado para programar.
Por eso nuestra regla de selección es sencilla:
Coste por tarea aceptada = coste total de ejecuciones y reintentos / tareas que superan las comprobaciones
Coste operativo = coste del modelo + coste de revisión y corrección humana
Son fórmulas para evaluar, no resultados medidos de Terra. Si no puedes ponerle un precio, registra por separado el tiempo de revisión humana. En una reescritura basada en fuentes, más razonamiento quizá no aporte nada útil. En una reparación difícil, un razonamiento insuficiente puede convertir un trabajo en varios intentos. Usa el nivel más bajo que supere las comprobaciones de tu tarea y compáralo también con Sol en un nivel razonable.
Evidencia práctica antes de la tabla de benchmarks
DualEntry probó Terra en su propia evaluación contable de 101 tareas, con tres ejecuciones. Informa de un 78,2 % de precisión, 16,1 segundos por tarea y 0,042 $ por tarea. Más revelador aún: solo el 65,3 % de las tareas se superó en las tres ejecuciones. El modelo puede ser rápido y barato, y aun así generar mucho trabajo de verificación.
Es una evaluación sectorial realizada por un proveedor de software contable, no una clasificación general de modelos. El informe publicado no demuestra una comparación con el mismo nivel de esfuerzo para todos los modelos. No uses sus segundos o dólares para prever una sesión en el navegador. Su aportación útil es separar la precisión media de la repetibilidad.
Las comparaciones más amplias que siguen proceden de un único evaluador y especifican su alcance.
| Evaluación o medida de coste | GPT-6.1 Terra | GPT-6.1 Sol | GPT-6 Luna | Qué responde |
|---|---|---|---|---|
| AA Intelligence Index v4.3.2, mejor configuración publicada, redondeada | 48 | 52 | 38 | Capacidad general en las diez evaluaciones del Index |
| AA Coding Agent Index v2.0, comparación publicada | 48 | 54 | 31 | Capacidad para agentes de programación, un índice distinto |
| Entrada / salida estándar de la API por millón de tokens, contexto corto | 1 $ / 5 $ | 2 $ / 10 $ | 0,10 $ / 0,50 $ | Precios unitarios de tokens, sin extras |
| Coste de Terra en las configuraciones de tareas del Index | Variación de hasta 7,4× | No es una comparación entre modelos | No es una comparación entre modelos | Cuánto influye la elección de esfuerzo de Terra en el gasto medido |
Fuentes consultadas el 27 de octubre: página de lanzamiento de AA, evaluación de lanzamiento de AA y precios de OpenAI.
Los dos índices usan tareas distintas y no se pueden promediar. Las puntuaciones redondeadas de Intelligence corresponden a la mejor configuración publicada de cada modelo, no a mediciones con el mismo nivel de esfuerzo. Los precios por token no equivalen al precio por tarea. Los resultados de AA son independientes de los gráficos de lanzamiento de OpenAI, pero siguen dependiendo de las tareas, herramientas, puntuación y configuración de AA. Ninguno mide tu propia tasa de finalización.
Por separado, OpenAI informa de un 50,3 % en Terminal-Bench 4.0 con esfuerzo máximo, frente al resultado publicado del 21,5 % para GPT-5.6 Terra. Es una comparación del proveedor con su predecesor, no una prueba de que Terra iguale a Sol en ingeniería de software. La propia OpenAI recomienda Sol o Astra para las tareas de programación más complejas. Esta distinción también importa al leer nuestra reseña anterior de GPT-6 Sol, que cubre otra versión.
En qué casos parece útil Terra
Redacción clara cuando ya tienes el material de referencia
El mejor motivo para probar Terra quizá sea algo cotidiano: convertir notas proporcionadas en una explicación legible. La guía de selección de modelos de OpenAI recomienda específicamente evaluar la escritura concisa basada en fuentes. Es una afirmación más acotada y útil que llamarlo el mejor modelo de escritura.
Proporciónale las fuentes, el público, las secciones requeridas y la instrucción de no añadir hechos sin respaldo. Comprueba si conserva los matices e incluye el nivel de detalle necesario. Esto encaja con documentación de productos y resúmenes internos que un editor puede revisar. No demuestra que sea fiable con un libro extenso o un informe de investigación elaborado con muchas herramientas.
Tareas visuales con un resultado definido
OpenAI presenta Terra como una opción para interpretar dibujos, emparejar imágenes de productos y actuar en pantallas de aplicaciones. En sus evaluaciones de lanzamiento, el modelo mejora respecto a su predecesor en razonamiento visual y tareas de escritorio. Son motivos válidos para probarlo en la preparación de formularios o la interpretación de capturas.
La condición práctica es que el resultado se pueda inspeccionar. Un campo rellenado debe coincidir con el valor de la fuente; un producto seleccionado del catálogo debe corresponder a la imagen. El problema de la automatización del navegador también depende del acceso a las páginas, el comportamiento de las herramientas y la validación. La puntuación del modelo solo cubre una parte de ese flujo.
Mejor economía en tareas acotadas
El resultado de eficiencia de costes de AA respalda probar niveles de esfuerzo bajos en tareas repetidas con criterios de aceptación claros. Algunos ejemplos son extraer un conjunto fijo de campos o reescribir un párrafo sin introducir hechos nuevos. El modelo ocupa un espacio entre el bajo precio de Luna y la mayor capacidad general de Sol.
La mejora en factualidad también resulta alentadora. AA informa de que Terra adivina en el 38 % de las preguntas que no puede responder en AA-Omniscience, frente al 88 % de GPT-5.6 Terra, mientras que la precisión aumenta dos puntos. Esa tasa condicional de adivinación no significa que el 38 % de las respuestas habituales sean falsas ni que todas las demás sean correctas. Sí respalda conservar explícitamente los valores desconocidos en tareas de extracción.
Cuándo puede desaparecer el ahorro
Las tareas largas pueden exigir más supervisión de la que sugiere el precio
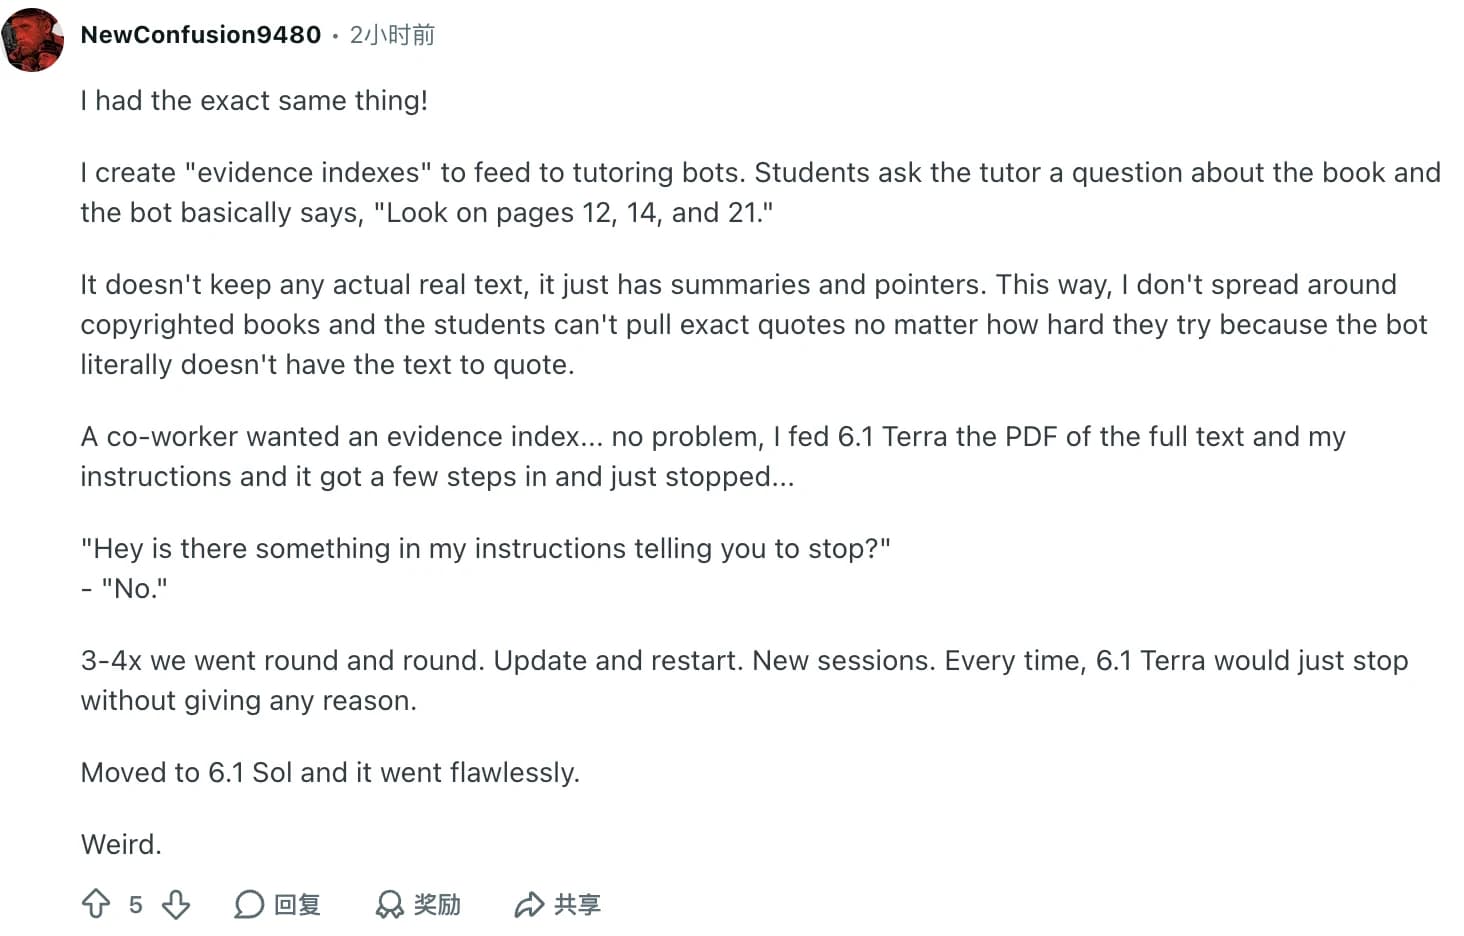
u/NewConfusion9480 describió una tarea concreta: crear un índice de evidencias en PDF para tutorías. Según su relato, Terra se detenía repetidamente y el cambio a Sol permitió completar el trabajo. La publicación original de u/Hefestion89 describe fallos al seguir instrucciones de procedimiento durante un análisis literario capítulo por capítulo en ChatGPT Work.
Son comentarios del día del lanzamiento, sin una reproducción controlada. No permiten separar el comportamiento del modelo de la orquestación o el estado de la sesión. Sí señalan una comprobación de aceptación útil: ¿terminó el agente todas las secciones requeridas sin que hubiera que insistir? Aumentar el esfuerzo no sustituye a comprobar que el trabajo esté completo.
La velocidad puede tener un coste en calidad
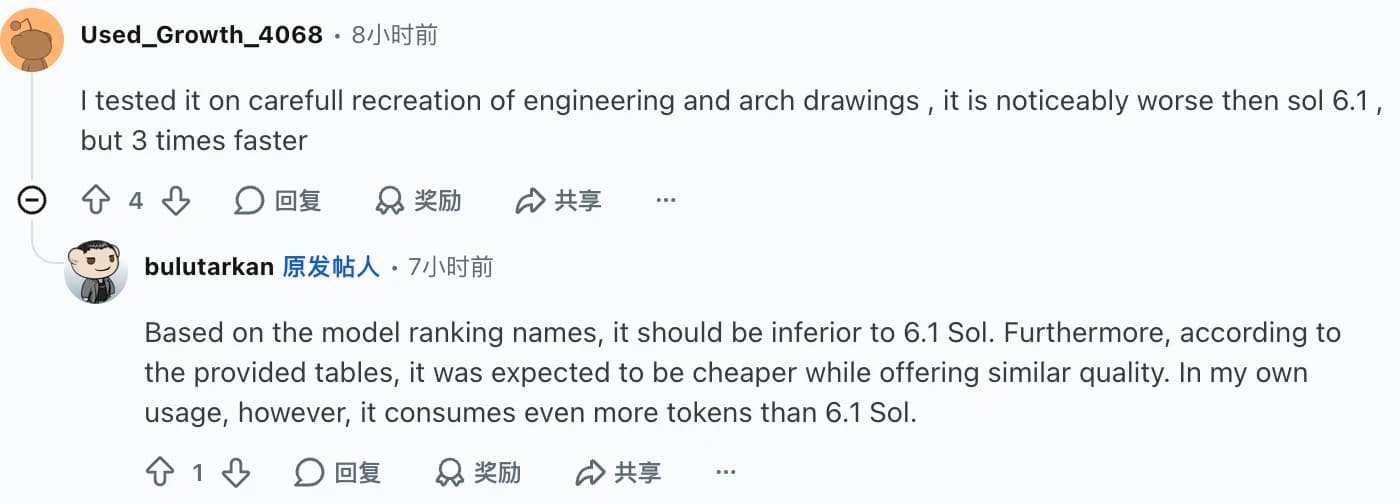
Un comentario sobre la recreación de un dibujo de u/Used_Growth_4068 describe Terra como más rápido, pero claramente peor que Sol. No hay entradas compartidas ni criterios de puntuación, así que su multiplicador de velocidad es anecdótico. Aun así, sirve para contrarrestar la idea de que el trabajo visual más rápido conserva todos los detalles.
El resultado de repetibilidad de DualEntry expresa la misma preocupación con medidas dentro de un único sector. Si tu flujo de trabajo necesita la misma respuesta cada vez, prueba varias ejecuciones en vez de elegir el mejor ejemplo. Para tareas difíciles y ambiguas, compara con una alternativa más potente como la que analizamos en nuestra reseña de GPT-6 Astra.
Los descuentos de la API no predicen las cuotas de una suscripción
La documentación del modelo de OpenAI enumera seis niveles de esfuerzo y establece medium como predeterminado. Los prompts que superan los 272K tokens de entrada activan tarifas más altas para la solicitud completa. También pueden influir las escrituras en caché y los cargos de herramientas. Una ventana de contexto de 1.050.000 tokens describe la capacidad, no una promesa de que llenarla sea barato.
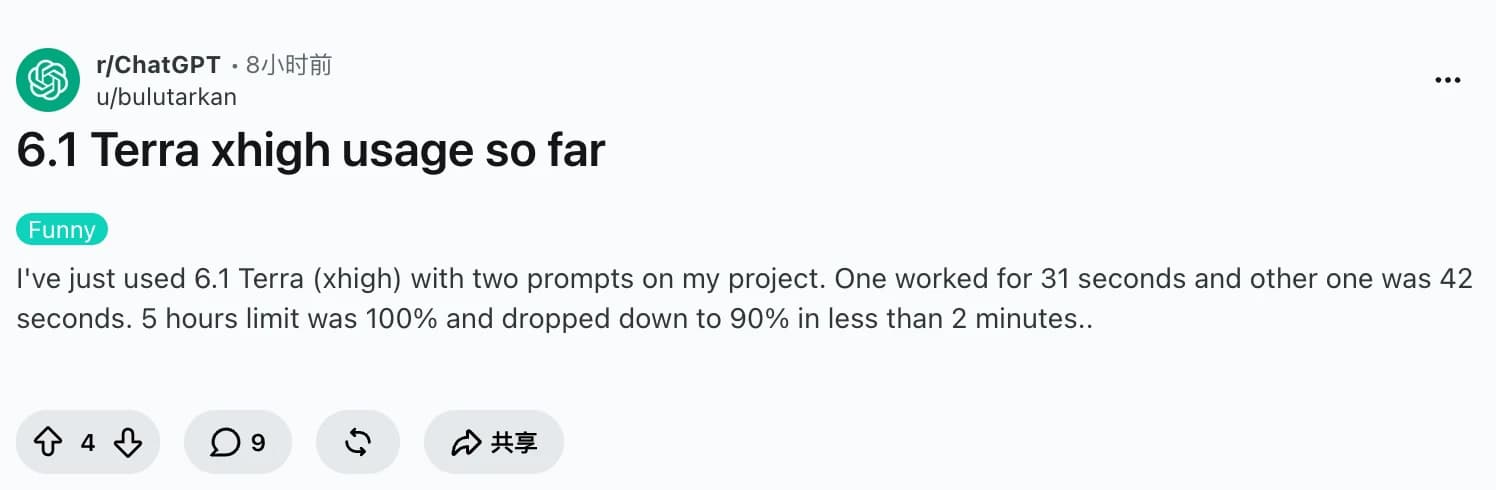
Por su parte, u/bulutarkan informó de una caída de 10 puntos en su cuota tras dos prompts xhigh. No es una factura de API ni una comparación controlada del consumo. Las cuentas, el razonamiento, el contexto y la contabilidad del producto pueden variar. Toma el comentario como motivo para revisar tu propio uso, no como fórmula para convertir tokens en porcentajes de una suscripción.
Qué dijeron los usuarios: velocidad frente a finalización
Los comentarios positivos destacan las esperas cortas. Las preocupaciones se centran en la fidelidad de los resultados, la finalización del trabajo y las cuotas. Cuatro ejemplos recopilados ilustran esas prioridades distintas; no forman una encuesta representativa. Las citas entre comillas son traducciones; las capturas conservan la redacción original.
"Hoy probé Terra y hace el trabajo de forma constante en 1 min. Y lo hace bien..."
u/ExplanationSenior104, trabajo en Codex, 26 de octubre UTC. El autor compara sus propias sesiones, sin un conjunto de tareas equivalente.
"es claramente peor que sol 6.1, pero 3 veces más rápido"
u/Used_Growth_4068, recreación de dibujos de ingeniería y arquitectura, 26 de octubre UTC. La captura conserva la redacción original en inglés; las valoraciones de velocidad y calidad son observaciones del autor.
"Cada vez, 6.1 Terra simplemente se detenía sin dar ningún motivo."
u/NewConfusion9480, indexación de evidencias en PDF, 27 de octubre UTC. El comentario dice que Sol completó el flujo de trabajo; no se ha verificado la causa de las interrupciones de Terra.
"el límite de 5 horas estaba al 100 % y bajó al 90 % en menos de 2 minutos..."
u/bulutarkan, dos prompts de proyectos con xhigh, 26 de octubre UTC. Es una observación de una suscripción, no una medición del coste de la API.
En Hacker News, wyre sostiene que Terra está dirigido a tareas informáticas, automatización y escritura técnica. Es una opinión sobre su posicionamiento, no otra prueba. Encaja con la distinción editorial útil aquí: evalúa Terra para el trabajo que necesitas, en lugar de esperar que un único modelo más barato sustituya a todos los modelos más grandes.
Veredicto según el tipo de trabajo
Vale la pena probar Terra para flujos de trabajo acotados de escritura y tareas visuales. Mantén Sol como referencia para trabajos largos y complejos. Pagar la mitad por token solo compensa cuando el resultado aceptado supera la revisión.
| Tu tipo de trabajo | Opción inicial | Qué verificar antes de cambiar |
|---|---|---|
| Reescribir notas proporcionadas en una explicación breve | Probar Terra con none o low | Fidelidad a las fuentes, secciones requeridas y adecuación al público |
| Interpretar una captura o preparar campos de un formulario | Probar Terra con low o medium | Comparar cada valor con la fuente e inspeccionar los resultados guardados |
| Corregir un defecto de código pequeño y aislado | Comparar Terra con GPT-6.1 Sol | Comprobaciones de regresión, total de reintentos y tiempo de revisión |
| Cambios grandes en un repositorio o tarea documental autónoma y larga | Empezar con Sol; considerar Astra para trabajos más difíciles | Finalización de principio a fin y conservación de todas las restricciones |
| Clasificación de gran volumen con un esquema sencillo | Comparar Luna con Terra | Coste por tarea aceptada y gestión de errores con tus propios datos |
| Trabajo repetido en el que las respuestas inconsistentes resultan caras | No elegir solo por el precio de los tokens | Repetibilidad y coste de las correcciones |
Los niveles de esta tabla son puntos de partida para probar, no valores óptimos medidos. Nuestra guía de navegadores con IA y la introducción a los navegadores agénticos tratan la capa de producto que rodea al modelo. Esa capa importa cuando una tarea abarca páginas, archivos y resultados guardados.
Prueba el flujo en Tabbit e inspecciona el resultado
Un benchmark no da acceso a tus pestañas ni verifica un registro guardado. Tabbit Browser proporciona contexto del navegador y herramientas para tareas. Su sitio oficial explica cómo referirse a páginas, capturas y archivos locales. Esas funciones lo convierten en un lugar práctico para evaluar el tipo de trabajo al que apunta Terra.
Primero comprueba si GPT-6.1 Terra aparece de verdad en el selector de modelos de tu cuenta. La página del recurso de Terra (English) reúne configuraciones y evidencia; su existencia no confirma que esté disponible en el cliente. Este artículo no ha completado una prueba de Tabbit con Terra seleccionado y no puede proporcionar una tasa de éxito, latencia, factura de tokens ni una victoria comparativa en ese entorno.
Para una primera comprobación, abre una especificación pública de un producto y pide cuatro campos: nombre del producto, precio con moneda, limitación indicada y URL de la fuente. Exige el valor unknown cuando la página no indique un dato. Repite la prueba en una segunda página y compara los resultados con los originales visibles. Una segunda tarea puede comparar ambas páginas sin incorporar afirmaciones de otras fuentes. Para un documento largo, pide respuestas por página y verifica cada cita.
Antes de empezar, define el aprobado como la presencia de todos los campos o citas solicitados, sin añadidos sin respaldo y con un informe veraz de finalización. Guarda las entradas, el nombre del modelo seleccionado, las salidas, las capturas y cualquier corrección. Repite las mismas tareas con Sol si está disponible. Mantén las mediciones del cliente separadas de los benchmarks de la API y no infieras una tasa general de éxito a partir de unos pocos ejemplos.
Si esas comprobaciones encajan con tu trabajo, descarga Tabbit y compara un conjunto pequeño de tareas. La disponibilidad del modelo y las reglas de membresía dependen del cliente y la región actuales; los precios de la API de esta reseña no son precios de Tabbit.
 Tabbit Browser

Preguntas frecuentes
¿Vale la pena usar GPT-6.1 Terra en lugar de GPT-6.1 Sol?
Vale la pena evaluar Terra para flujos de trabajo visuales, redacción basada en fuentes y automatización acotada donde importan la velocidad y el coste. Sol sigue siendo el punto de partida más sólido para programación compleja y razonamiento prolongado. Compara tareas completadas y verificadas con el nivel de esfuerzo que realmente vayas a usar.
¿Cuánto cuesta GPT-6.1 Terra mediante la API?
Las tarifas estándar para contextos cortos, consultadas el 27 de octubre de 2026, son de 1 $ por millón de tokens de entrada, 0,05 $ por millón de tokens de entrada en caché y 5 $ por millón de tokens de salida. Las escrituras en caché, las herramientas, los niveles de servicio y los ajustes para contextos largos pueden cambiar la factura. Las tarifas de la API no especifican las cuotas de las suscripciones de ChatGPT, Codex o Tabbit.
¿Debería usar siempre el máximo nivel de razonamiento con Terra?
No. Artificial Analysis informa de una diferencia de hasta 7,4 veces en el coste medio por tarea entre distintas configuraciones de Terra. Empieza con un nivel bajo para tareas acotadas y auméntalo solo si tus propias comprobaciones de aceptación muestran una mejora útil.
¿Una tasa menor de alucinaciones significa que sus respuestas son fiables?
Es una mejora en evaluaciones concretas, no una garantía. Artificial Analysis mide cuándo el modelo adivina ante preguntas que no puede responder, mientras que OpenAI informa de errores factuales en otro conjunto interno de prompts. Ninguno de esos porcentajes representa la tasa de error de tus documentos o aplicaciones.
¿GPT-6.1 Terra puede llamar a herramientas mediante Chat Completions?
OpenAI incluye Chat Completions entre los endpoints compatibles, pero para llamar a herramientas hace falta la API Responses. El modelo acepta texto e imágenes y genera texto. Un producto basado en el modelo puede añadir sus propias herramientas o gestión de archivos.
¿Puedo probar GPT-6.1 Terra en Tabbit Browser?
Comprueba el selector de modelos de tu cuenta antes de planificar un flujo de trabajo con Terra en Tabbit. Este artículo no ha verificado una ejecución de Tabbit con Terra seleccionado, y la página del recurso del modelo no demuestra que esté disponible para tu cuenta. Las reglas de membresía de Tabbit son independientes de los precios de la API de OpenAI.