
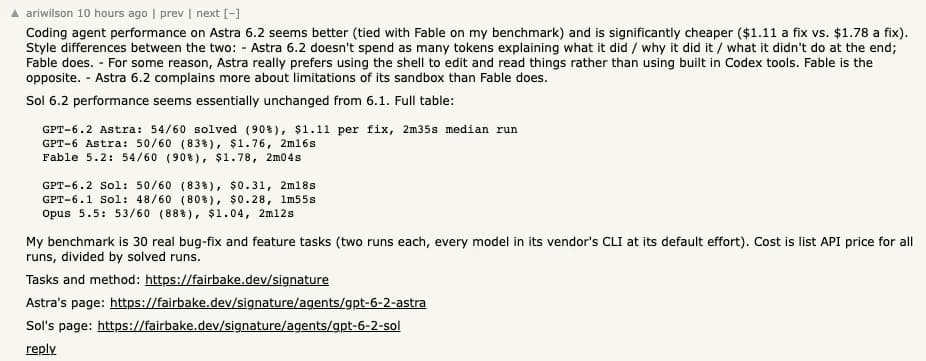
GPT-6.2 Sol 值得先用在日常代码改动、有资料可对照的写作,以及能自动验收的 API 工作流。要在陌生仓库或一批数据里找线索,建议留着 6.1 Sol 做对照。Hacker News 用户 ariwilson 用相同的 30 个修复和功能需求做了比较,新版多通过两次运行,单次用时的中位数却更长。原始对照
2026 年 11 月 17 日,Plotly 用两代 Sol 各跑了一轮 43 道分析题。6.2 Sol 花了 1.22 美元,答对 40 道。6.1 Sol 花了 2.61 美元,全部答对。 新版漏掉的三道都要求主动寻找隐藏规律。如果这些例外会影响结论,人工重查可能花掉模型省下的时间。Plotly 评测报告
下面先看真实任务,再看跑分。资料散在多个标签页时,可以在 Tabbit 浏览器里固定输入,用同一份资料运行 GPT-6.2 Sol。
先看结论
日常编码、PR 审查和格式固定的提取从 Medium 档试起。提前写下验收条件。
Plotly 测得新版单题用时中位数为 10.5 秒,前代为 17.6 秒。隐藏规律题新版对 2 道,前代对 5 道。
Standard API 单价和 6.1 Sol 相同,每百万 Token 分别收取 2 美元输入、0.10 美元缓存命中输入和 10 美元输出。比较实际费用时要计入重试。
Artificial Analysis 的 Codex 跑分中,Max 档新版综合代码代理指数低 3 分,主要差在仓库问答。
多服务排查可以试 Astra。是否值得加预算,按同一验收规则比较通过数和人工复核时间。
GPT-6.2 Sol 在哪里能用
OpenAI 在 2026 年 11 月 17 日同时推出 6.2 Sol 和 6.2 Astra。Sol 的 API ID 是 gpt-6.2-sol,接收文字和图片,输出文字。上下文为 1,050,000 Token,其中输入上限 922,000,输出上限 128,000。API 不接受 none 推理档。参数可以参考 Sol 型号资料和 API 与 Codex 配置示例。官方 API 规格
| 入口 | 怎么开始 | 要核对什么 |
|---|---|---|
| ChatGPT Work | 在支持的套餐里打开 Work 并选 Sol | Enterprise 和 Edu 需要管理员开放 |
| Codex 桌面端或 CLI | 用模型选择器或 /model | Codex 与 Work 共用用量,Ultrafast 另有条件 |
| OpenAI API | 指定 gpt-6.2-sol | 核对处理层级、缓存写入和工具费用 |
| Tabbit 浏览器 | 用 GPT-6.2 Sol 处理标签页或文件中的资料 | 保留原文摘录和链接,方便复核 |
推理档会影响模型在任务上花多少推理预算,Ultrafast 是单独的速度设置。对照试跑时两项都要记录。官方发布说明列出 Plus、Pro、Business、Enterprise 和 Edu 的 Work 入口,企业或教育工作区受管理员配置影响。ChatGPT Work 和 Codex 发布说明
先看真实任务结果
在 Codex 用固定资料做一次问答
编辑团队用 Codex CLI 的 gpt-6.2-sol Medium 档,把 API 费率、Plotly 结果和 Work/Codex 的档位说明放进同一份资料包。要求模型仅根据资料回答三题,分别给出出处。
第一题给 40,000 个输入 Token,其中 10,000 命中缓存,另有 4,000 个计费输出 Token。排除缓存写入和工具费,答案是 0.060 + 0.001 + 0.040 = 0.101 美元。Sol 算对了三个分项,指出前代多找出三条隐藏规律,报告未给新版 p95,也区分了 High 推理档和 Ultrafast。三条回答都引用了资料标签。
样本只有一次,而且关键数字已放进题目。它适合检查是否照资料作答。对陌生仓库的发现能力和 API 实际账单,需要另外验证。Sol 实测和评估资料
给模型一组需要自己查的数据
Plotly 在 Studio Embedded 里让两代 Sol 各跑一轮。新版答对全部 38 道常规题,总工具调用从 258 次降到 158 次,输出从约 70,000 Token 降到 45,000。五道隐藏规律题里,新版平均每题发起约 9 次数据库查询,前代约 16 次。原始测试方法和结果
同样的单价下,调用和用量下降可以把任务花费降下来。Plotly 也发现,其他模型复跑时分数最多相差三题。这次的三道漏题值得放进迁移抽查,实际会漏多少要用重复试验回答。
跑分怎么看
| 测试 | GPT-6.2 Sol | 对照 | 适合判断什么 |
|---|---|---|---|
| Plotly 43 道分析题 | 40/43,1.22 美元 | 6.1 Sol 为 43/43,2.61 美元 | 单轮任务用量和费用 |
| Plotly 隐藏规律题 | 2/5 | 6.1 Sol 为 5/5 | 是否需要单独检查例外 |
| OpenAI 引用的 FrontierCode 2.0 | 距 Astra 0.5 分以内 | 约为 Astra 单任务成本的五分之一 | 两者均为 Max,按仓库任务规则评分 |
| Artificial Analysis Coding Agent Index | 低 3 分 | 6.1 Sol,Max | 同用 Codex 测试环境,差异主要来自仓库问答 |
FrontierCode 按评分项加权,未过阻断性条件的提交计零。Artificial Analysis 报告的 SWE-Atlas-QnA-AA 下滑 14 分,涉及漏掉关键事实。只改一个文件和查全一个接口的调用方,考验的能力不同。Cognition 方法 · OpenAI 首发基准 · Artificial Analysis 测试
哪些任务适合先试 Sol
有测试的代码修改和 PR 审查
找一个能稳定复现的失败测试,或一份改动范围明确的 diff。做审查时,每条意见都要求给出文件、触发条件和实际影响。如果需要在网页上验证,给两次运行同样的页面初始状态和检查步骤。Codex 浏览器操作指南
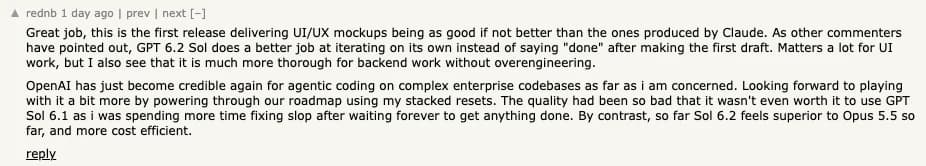
HN 用户 rednb 反馈新版做 UI 草稿时会多迭代几步。这个观察值得用自己的操作路径检验。原始评论
字段和输入已知的批量分析
定期报表有明确的列、时间过滤条件和输出格式,适合检查效率优势能不能复现。把行数、单位、日期和关键数字的出处写进验收规则。统计费用时把重试和人工校正一起计入。每个通过结果怎么算成本
根据已知资料写作
公告、项目进展和资料摘要都可以从短资料包开始。要求原样保留名称、数值和链接,找不到就明说。网页会更新,保留采集时间和原文再做模型对照。带出处的网页研究
哪些情况要多检查一步
任务本身就是找异常
设计一两个预先知道答案的难例,比如同一个参数在两处定义,或后半份报告换了单位。看哪个模型能把异常和依据说全。如果现有 6.1 Sol 做得稳定,就先留在对照组。相近的版本名容易混淆,参考早期 GPT-6 Sol 测评时注意版本。
问答听起来正确,却少了一个调用方
可以问模型哪些页面用了某个共享函数、哪个调用方修改了默认值。少看一个页面就可能改变结论。用仓库里的实际调用关系和测试校验,只有 High 或 Max 能追回关键遗漏时,才把更高档位留给这类任务。
原型看起来完成了,实际交互还有问题
网页截图能看排版,交互需要点击验证。用目标设备的宽度打开页面,逐个操作控件,检查输入、动画和声音等实际行为。
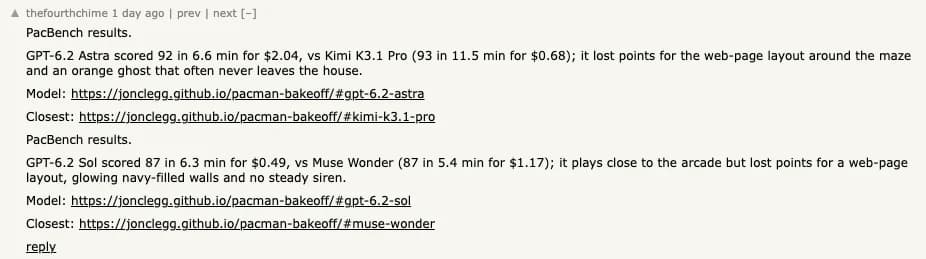
thefourthchime 在一个生成原型里发现了布局和声音问题。原始评论
prmoustache 试了不同推理档,反馈 High 下绘制的骑车图仍把双腿放在自行车同一侧。原始评论

在 Tabbit 固定对照资料
编辑团队在 Tabbit 浏览器中只读打开三份公开资料,核对 API 的三项费率、两代 Sol 的整套测试花费和通过数、10.5 秒中位数,以及 Ultrafast 的使用条件。这些就是上面 Codex 题目用到的数据。API 模型页 · Plotly 报告 · Work 发布说明

用 Tabbit 的 Agent 集成收集来源,再按多模型调研流程保存摘录与链接。为每个模型保留相同输入和问题顺序。若要比较找资料的能力,再另开一轮,从同样的起始页面和工具权限开始。上面的取证用的是 TabbitDance,固定资料题跑在 Codex。也可以把同一份资料交给 Tabbit 中的 GPT-6.2 Sol。
按实际任务选
| 任务 | 从哪里开始 | 什么时候换 |
|---|---|---|
| 小改动、PR 审查和固定报表 | 6.2 Sol Medium | 验收漏项或人工改动增加,就和原方案重比 |
| 寻找未点名的证据、异常或调用方 | 同题比较 6.1 Sol 和 6.2 Sol | 看谁找回了关键例外,以及人工要核多久 |
| 跨服务排查,重试代价高 | 并排试 6.2 Astra 和 Sol | 只有更贵的模型能实质增加通过数时才加预算 |
| 高频 API 工作流 | 选一批有代表性的请求试 6.2 Sol | 比较端到端耗时、账单、重试和每个通过结果的成本 |
从一个日常任务、一个已知例外和一个难题起步。6.2 Sol 在不降低验收标准的前提下省钱或省复核时间,就把相应任务迁过去。若还在用早期旗舰版,可以从 GPT-6 Astra 测评梳理现有基线。原始资料跨多个网页时,用 Tabbit 固定输入再跑。
 Tabbit Browser

常见问题
GPT-6.2 Sol 比 GPT-6.1 Sol 强吗?
有明确验收条件的日常工作可以先试 6.2 Sol。Plotly 的一轮分析测试费用不到前代的一半,但五道找隐蔽规律的题里,6.2 Sol 答对两道,6.1 Sol 全答对了。迁移前用手上的难题再比一次。
GPT-6.2 Sol 适合在 Codex 写代码吗?
小范围改动、PR 审查和有可靠测试的任务,可以先试它。需要跨文件梳理调用关系时,用现有模型对照。Artificial Analysis 在同一 Codex 环境的 Max 档测到新版仓库问答退步。
GPT-6.2 Sol API 怎么收费?
Standard API 每百万 Token 按未缓存输入 2 美元、缓存命中输入 0.10 美元、输出 10 美元计费。写入缓存或使用单独计费的工具可能产生额外费用。ChatGPT Work 与 Codex 共用订阅用量。
普通 ChatGPT 对话里可以用 GPT-6.2 Sol 吗?
OpenAI 于 2026 年 11 月 17 日在 ChatGPT Work、Codex 和 API 推出 Sol。使用 ChatGPT 时要进入 Work。Enterprise 和 Edu 的管理员需要先启用。
GPT-6.2 Sol 和 GPT-6.2 Astra 怎么选?
能快速验收的任务先试 Sol。跨服务排查、人工复核或重试代价较高的任务,可用同一组案例试 Astra,比较通过数和实际总成本。
GPT-6.2 Sol 应该选什么推理档?
范围清楚的任务从 Medium 起步。可复现的错误用 High 重测,只有 Max 能稳定解决重要问题时才保留。Ultrafast 是单独的速度设置,有自己的开放条件。