
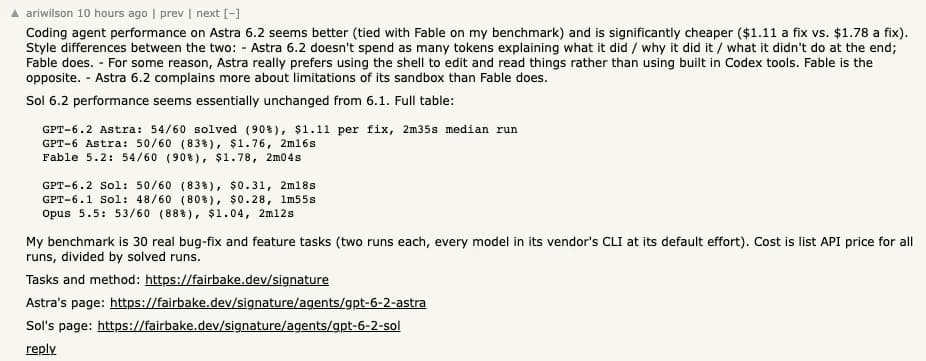
GPT-6.2 Sol mérite un essai sur les modifications courantes dans Codex, les textes appuyés sur des sources connues et les automatisations faciles à valider. Gardez 6.1 Sol comme référence si le travail consiste à chercher un indice dans des données ou un dépôt inconnu. Sur Hacker News, ariwilson a comparé les deux versions sur 30 corrections et ajouts. La nouvelle a réussi deux exécutions de plus, avec une durée médiane plus longue. Comparaison d'origine
Le 17 novembre 2026, GPT-6.2 Sol a terminé les 43 questions de Plotly pour 1,22 USD, contre 2,61 USD pour GPT-6.1 Sol. La nouvelle version a donné 40 bonnes réponses et l'ancienne 43. Les trois échecs demandaient de trouver un motif caché. Mesurez le coût de la vérification humaine quand ces exceptions changent le résultat. Rapport de Plotly
Si les sources sont réparties dans plusieurs onglets, réunissez-les et lancez GPT-6.2 Sol dans Tabbit Browser. L'exemple ci-dessous garde les données d'entrée identiques pour chaque modèle.
À retenir
Essayez Medium sur un travail dont vous pouvez définir la réussite avant de lancer le modèle.
Sur Plotly, la médiane est passée de 17,6 à 10,5 secondes par question. Sol 6.2 a trouvé deux motifs cachés sur cinq, contre cinq sur cinq pour la version précédente.
L'API Standard garde les tarifs de 6.1 Sol. Suivez la consommation, les reprises et les corrections pour calculer l'économie réelle.
L'indice de programmation d'Artificial Analysis a baissé de trois points dans Codex à l'effort maximal, principalement sur les questions de dépôt.
Essayez Astra sur les cas difficiles si les reprises ou la revue manuelle prennent du temps.
Où utiliser GPT-6.2 Sol
Dans l'API, gpt-6.2-sol accepte du texte et des images et produit du texte. Sa fenêtre est de 1 050 000 jetons, avec un maximum de 922 000 en entrée et 128 000 en sortie. L'API refuse none comme niveau d'effort. Consultez la fiche de Sol (English) et les exemples de configuration (English). Spécifications OpenAI
| Accès | Par où commencer | À vérifier |
|---|---|---|
| ChatGPT Work | Sélectionner Sol avec un abonnement compatible | Activation par un administrateur pour Enterprise et Edu |
| Codex | Sélecteur de modèles ou /model | Quota partagé avec Work. Accès distinct à Ultrafast |
| API OpenAI | Indiquer gpt-6.2-sol | Standard par million de jetons : 2 USD en entrée, 0,10 USD en cache et 10 USD en sortie |
| Tabbit Browser | Utilisez GPT-6.2 Sol avec les sources de vos onglets et fichiers | Gardez les extraits et les liens pour vérifier la réponse |
L'effort agit sur le raisonnement et Ultrafast sur la vitesse. Notez les deux réglages quand vous comparez des exécutions. Le lancement couvre Work pour Plus, Pro, Business, Enterprise et Edu, selon les règles de l'espace de travail. Notes de lancement
Ce que montrent les essais
Trois questions sur des sources fixes dans Codex
L'équipe éditoriale a lancé Sol 6.2 une fois dans Codex CLI à l'effort Medium. Le dossier contenait le tarif de l'API, le test Plotly et les réglages de Work et Codex. La consigne demandait trois réponses assorties de leur source.
Avec 40 000 jetons d'entrée dont 10 000 en cache et 4 000 jetons de sortie, le total attendu était 0,060 + 0,001 + 0,040 = 0,101 USD, hors écriture en cache et outils. Sol a trouvé le total et les trois postes. Il a relevé les trois motifs supplémentaires trouvés par 6.1, l'absence de latence p95 et la différence entre High et Ultrafast. Les trois réponses renvoyaient à leur extrait. Cet essai vérifie l'utilisation de données fournies. Les évaluations de Sol (English) couvrent aussi des tâches où le modèle doit chercher les éléments nécessaires.
Quand il faut trouver les éléments soi-même
Plotly a exécuté chaque modèle une fois dans Studio Embedded. Sol 6.2 a répondu correctement aux 38 questions hors motifs cachés. Il a fait 158 appels d'outils contre 258 et produit environ 45 000 jetons contre 70 000. Sur les cinq motifs cachés, il a lancé environ neuf requêtes par question contre seize. Plotly a observé des écarts allant jusqu'à trois réponses entre répétitions avec d'autres modèles. Reprenez les cas manqués dans votre propre essai. Méthode et résultats de Plotly
Comment lire les mesures
| Test | GPT-6.2 Sol | Comparaison | Périmètre |
|---|---|---|---|
| Examen de Plotly | 40/43 pour 1,22 USD | 6.1 Sol 43/43 pour 2,61 USD | Une exécution par modèle |
| Motifs cachés de Plotly | 2/5 | 6.1 Sol 5/5 | Cinq questions du même examen |
| FrontierCode 2.0, cité par OpenAI | À moins de 0,5 point d'Astra | Environ un cinquième du coût d'Astra | Les deux en Max, barème propre à chaque tâche de dépôt |
| Indice de programmation d'Artificial Analysis | En baisse de 3 points | GPT-6.1 Sol à l'effort Max | Même environnement Codex, écart surtout sur les questions de dépôt |
FrontierCode donne zéro si une condition obligatoire échoue. Artificial Analysis relève un recul de 14 points sur SWE-Atlas-QnA-AA, où des faits essentiels ont été omis. Une modification locale peut passer les tests alors qu'une recherche de tous les appelants oublie un fichier. Méthode Cognition · Évaluations OpenAI · Rapport Artificial Analysis
Trois tâches à essayer en priorité
Une modification ou une revue facile à vérifier
Partez d'un test qui échoue ou d'un petit diff. Demandez le fichier, la condition et l'effet de chaque problème signalé. Si la vérification se fait sur une page, gardez le même état initial et les mêmes contrôles. Guide Codex pour le navigateur
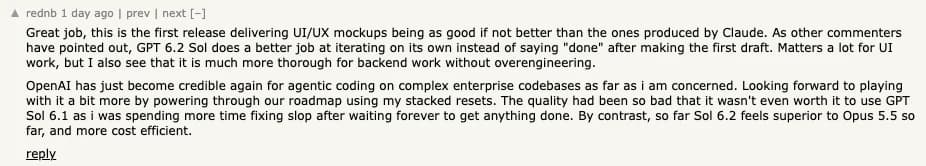
Sur Hacker News, rednb a observé que 6.2 Sol reprenait davantage ses maquettes avant de les livrer. Vérifiez cette observation sur les interactions de votre produit. Commentaire d'origine
Une analyse répétée avec des données connues
Un rapport périodique avec colonnes, dates et format stables permet de vérifier si l'économie de Plotly se reproduit. Contrôlez le nombre de lignes, les unités et la provenance des chiffres. Comptez les reprises dans le coût par résultat validé.
Un texte basé sur des sources précises
Essayez une note de version ou un résumé. Demandez de conserver les noms, les chiffres et les liens, et de signaler les informations absentes. Si les pages évoluent, conservez les extraits et leur date avec le guide de recherche avec des sources vérifiables.
Les cas qui demandent plus de vérification
Quand le but est de trouver une exception
Glissez dans l'essai des valeurs qui changent d'unité ou un réglage défini à deux endroits. Vérifiez que chaque exception s'accompagne d'une preuve. Gardez 6.1 Sol dans le test s'il traite déjà bien ces cas. Le test de GPT-6 Sol porte sur une version antérieure.
Quand un appelant oublié change la réponse
Demandez quels clients appellent une fonction et lequel change sa valeur par défaut. Comparez à la liste réelle du dépôt. Augmentez l'effort s'il récupère des omissions reproductibles. Essayez Astra sur un diagnostic qui touche plusieurs services.
Quand une belle maquette doit aussi fonctionner
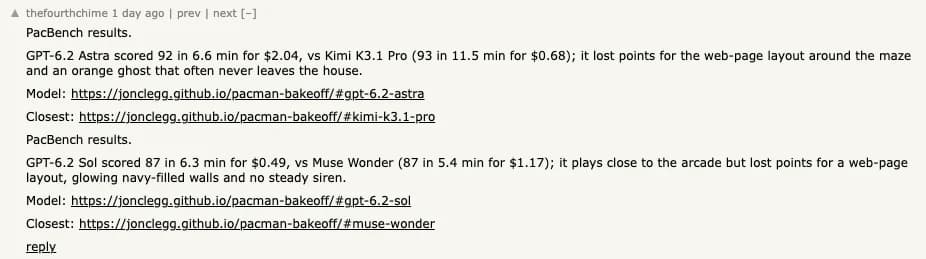
Ouvrez le prototype à la taille cible et testez ses commandes. thefourthchime a signalé des défauts de disposition et de son sur un prototype généré. Commentaire d'origine
Dans un autre essai, prmoustache a vu le dessin placer les deux jambes du même côté du vélo, même en High. Commentaire d'origine

Utiliser les mêmes sources dans Tabbit
En consultation seule dans Tabbit Browser, l'équipe a vérifié les trois tarifs, les résultats et les coûts de Plotly, sa médiane de 10,5 secondes et les conditions d'Ultrafast. Tarifs OpenAI · Rapport Plotly · Notes de Work

Rassemblez les pages avec l'intégration d'agents Tabbit, puis conservez les extraits et URL comme dans le guide de comparaison de modèles. Gardez la même entrée pour chaque essai. Mesurez ensuite la recherche dans une série distincte avec les mêmes pages initiales et droits. L'équipe a consulté les sources via TabbitDance et exécuté le test dans Codex. Vous pouvez utiliser GPT-6.2 Sol directement dans Tabbit avec ce dossier.
Choisir selon le travail
| Travail | Point de départ | Quand changer |
|---|---|---|
| Petite modification, PR ou rapport normalisé | GPT-6.2 Sol en Medium | Si les corrections ou les omissions se multiplient |
| Recherche d'indices ou d'exceptions | Comparer 6.1 Sol et 6.2 Sol | Selon les cas importants retrouvés et le temps de vérification |
| Diagnostic entre services | Tester Astra et Sol | Si Astra fait valider davantage de cas difficiles |
| API à volume élevé | Piloter 6.2 Sol sur des demandes représentatives | Selon le délai total, le coût, les reprises et les résultats validés |
Prenez une tâche courante, une exception connue et un cas difficile. Gardez votre modèle actuel en référence et adoptez 6.2 Sol quand le même contrôle passe avec moins de coût ou de revue. Le test de GPT-6 Astra donne un point de comparaison pour l'ancien modèle haut de gamme. Utilisez Tabbit pour stabiliser les sources réparties entre vos onglets.
 Tabbit Browser

Questions fréquentes
GPT-6.2 Sol est-il meilleur que GPT-6.1 Sol ?
Essayez 6.2 Sol en premier sur les tâches courantes dont vous pouvez vérifier le résultat. Il a coûté moins de la moitié sur le test de Plotly et repéré deux motifs cachés sur cinq, contre cinq pour 6.1 Sol. Comparez les deux sur vos cas difficiles avant de changer.
GPT-6.2 Sol est-il adapté au code dans Codex ?
Il convient aux modifications ciblées, aux revues de PR et aux tâches couvertes par des tests fiables. Pour les questions qui exigent de suivre plusieurs fichiers, comparez-le à votre modèle actuel. Dans Codex, Artificial Analysis a relevé un recul de 6.2 Sol sur les questions de dépôt à l'effort maximal.
Combien coûte GPT-6.2 Sol ?
L'API Standard facture 2 USD par million de jetons d'entrée hors cache, 0,10 USD en cache et 10 USD en sortie. L'écriture en cache et certains outils peuvent s'ajouter. Work et Codex partagent le quota de l'abonnement.
GPT-6.2 Sol est-il dans le chat habituel de ChatGPT ?
OpenAI l'a lancé le 17 novembre 2026 dans ChatGPT Work, Codex et l'API. Dans ChatGPT, les notes de lancement indiquent d'ouvrir Work. Un administrateur doit activer l'accès pour Enterprise et Edu.
Quand préférer GPT-6.2 Astra à Sol ?
Commencez par Sol quand la vérification est rapide. Essayez Astra pour les investigations sur plusieurs services ou les travaux dont la reprise coûte cher. Comparez le nombre de résultats validés et le coût total.
Quel effort de raisonnement choisir pour GPT-6.2 Sol ?
Commencez en Medium pour une tâche bien définie et testez High sur les échecs reproductibles. Retenez Max si le gain se mesure sur votre travail. Ultrafast règle la vitesse et a ses propres conditions d'accès.