
如果你必须下载权重并自行部署,先评估 GLM-5.3-Flash。如果主要任务是长流程编程或视觉智能体,可以试用 LongCat 2.5,再用自己的任务验证效果与成本。现有公开分数不足以证明两者在相同条件下谁更强。
这一区别关系到实际工作。一位 Reddit 用户称,在大型重构中使用 LongCat 2.5 Preview 时反复遇到工具调用失败,还改动了无关代码。这是个人对预览版的反馈,不能直接代表 11 月发布的正式版。后文也会介绍如何用 Tabbit Browser 整理对比材料,以及浏览器测试的边界。
核心结论
智谱以 MIT 许可证发布 GLM-5.3-Flash 权重。截至 2026 年 11 月 3 日,LongCat 2.5 发布页的 GitHub 和 Hugging Face 链接标注敬请期待。
两家均介绍了原生多模态能力,但客户端和服务商对图片、视频的支持可能不同。
LongCat API 文档和 GLM 权重配置均标明约 100 万 token 上下文;应用本身可能限制得更短。
两家公布的编程分数测试条件不同。分差可以作为试用线索,不能直接预测你的代码库表现。
计算实际成本时要考虑缓存、输出、重试和人工检查,而不只是输入单价。
LongCat 2.5 与 GLM-5.3-Flash 一览
| 比较项 | LongCat 2.5 | GLM-5.3-Flash |
|---|---|---|
| 开发方 | 美团 | 智谱 Z.ai |
| 参数规模 | 总参数 1.6 万亿,每 token 约激活 480 亿 | 总参数 3200 亿,每 token 约激活 180 亿 |
| 权重 | 11 月 3 日发布页标注敬请期待 | 可下载,MIT 许可证 |
| 上下文 | LongCat API 文档列出 100 万 token | 权重配置为 1,048,576 token |
| 输入 | 发布介绍称支持原生视觉与语言 | 官方模型卡称支持原生多模态 |
| 编程证据 | 厂商公布 Terminal-Bench 2.1 为 88.4 | 模型卡列出 Terminal-Bench 2.1 为 84.3 |
| API 价格 | 官方限时价格每百万输入 0.30 美元、输出 1.20 美元 | OpenRouter 上 Z.ai 路线每百万输入 0.15 美元、输出 0.50 美元 |
规格来源为美团发布介绍、智谱模型卡、LongCat API 文档和 NVIDIA 模型文档。价格是 11 月 3 日 LongCat 官方限时价格和 OpenRouter 上 Z.ai 路线的快照;这是不同线路,并非所有服务商或 Tabbit 的统一价格。
LongCat 2.5 和 LongCat 2.0 是不同版本;GLM-5.3-Flash 也不同于规模更大的 GLM-5.3。关于 Flash 预览名称的来历,可读 Ox Alpha 身份揭晓。
编程与智能体:比较完整任务
美团公布 LongCat 2.5 的 Terminal-Bench 2.1 分数为 88.4,智谱模型卡列出的 Flash 分数为 84.3。但这不是本文在同一环境下运行的实验;两家所述的工具版本和设置不同。4.1 分的差距无法预测某个仓库的修复结果,也无法告诉你重试次数或是否会改动无关文件。
一项社区小规模测试中,LongCat 2.5 Preview Free 和 GLM 5.3 Flash Free 都通过了三项检查。作者次日才补测 Flash,每项仅运行一次,并明确提示不能据此比较速度。这份记录适合参考测试设计,不足以给 LongCat 正式版排名。
比较自己的任务时,为两个模型准备相同的代码库副本,使用相同问题、工具和超时设置。避免让智能体修改测试文件,或提前保存测试文件哈希。最后运行未修改的测试,检查改动文件,并记录工具错误、重试和人工修正。多做几项任务,再据此决定是否切换模型。智能体推理指南进一步解释了工具配置与来源核对的作用。
上下文与图片:实际额度由接入方式决定
100 万 token 是上限,不代表每个应用都接受这么长的请求,也不保证模型一定能找到其中的事实。系统指令、工具结果、历史对话和生成内容都可能占用额度。可以在一份已知答案的长文档的开头、中间和结尾放入问题,测试检索准确性,并检查客户端如何截断或总结旧内容。
LongCat 文档的输出上限还有一处需要复核:11 月 3 日浏览器中显示 256K,另一份抓取版本显示 128K。设计长输出任务前,应检查最新文档和账号限制。
两家都介绍了视觉输入能力,但具体 SDK 与部署配置未必支持所有格式。例如 vLLM 部署说明区分了支持与暂不支持图片、视频的前端。比较截图生成网页时,应给两款模型相同图片和验收标准,检查实际渲染与无障碍表现。
开放权重与部署成本
GLM 模型卡提供 MIT 权重,可以按许可证自行规划部署。但模型并不小:vLLM 估算原生 FP8 权重约占 306 GiB,还不包括运行时和 KV 缓存。量化方式、并发和上下文长度都会影响所需内存,采购前应先测量。
调研时,LongCat 发布页的 GitHub 和 Hugging Face 链接显示敬请期待。这只是当日状态,不表示未来不会开放。如果必须自托管,请在决策前核对最新文件和许可证。
如何比较真实费用
使用你实际接入线路的价格计算:
费用 = 未缓存输入 token / 1,000,000 × 输入单价
     + 缓存命中 token / 1,000,000 × 缓存读取单价
     + 输出 token / 1,000,000 × 输出单价
     + 工具或平台费用
按上面的当日价格,100 万未缓存输入加 25 万输出在 LongCat 官方限时价格下约为 0.60 美元,在 OpenRouter 的 Z.ai 路线下约为 0.275 美元,尚未计入其他费用。这只是算术示例,不是账单,也不代表两款模型会消耗相同 token。还要确认推理 token 是否按输出计费、缓存写入是否收费,并比较每个合格任务的总费用。
服务稳定性也会影响费用。一位 Reddit 评论者称,通过 OpenCode 使用 LongCat 2.5 Preview 时连接不稳定且缓慢。这只是某个时间、某条线路上的个人反馈。记录服务商、错误和重试次数,才能判断问题发生在哪里。
用 Tabbit 整理一组可核对的比较
如果任务需要阅读多个网页,Tabbit Browser 可以帮助整理来源和模型回答。Tabbit 使用实践与智能体浏览器介绍说明了网页上下文的作用。下图是其他模型并列回答的通用界面,不是这两款模型的实测图。
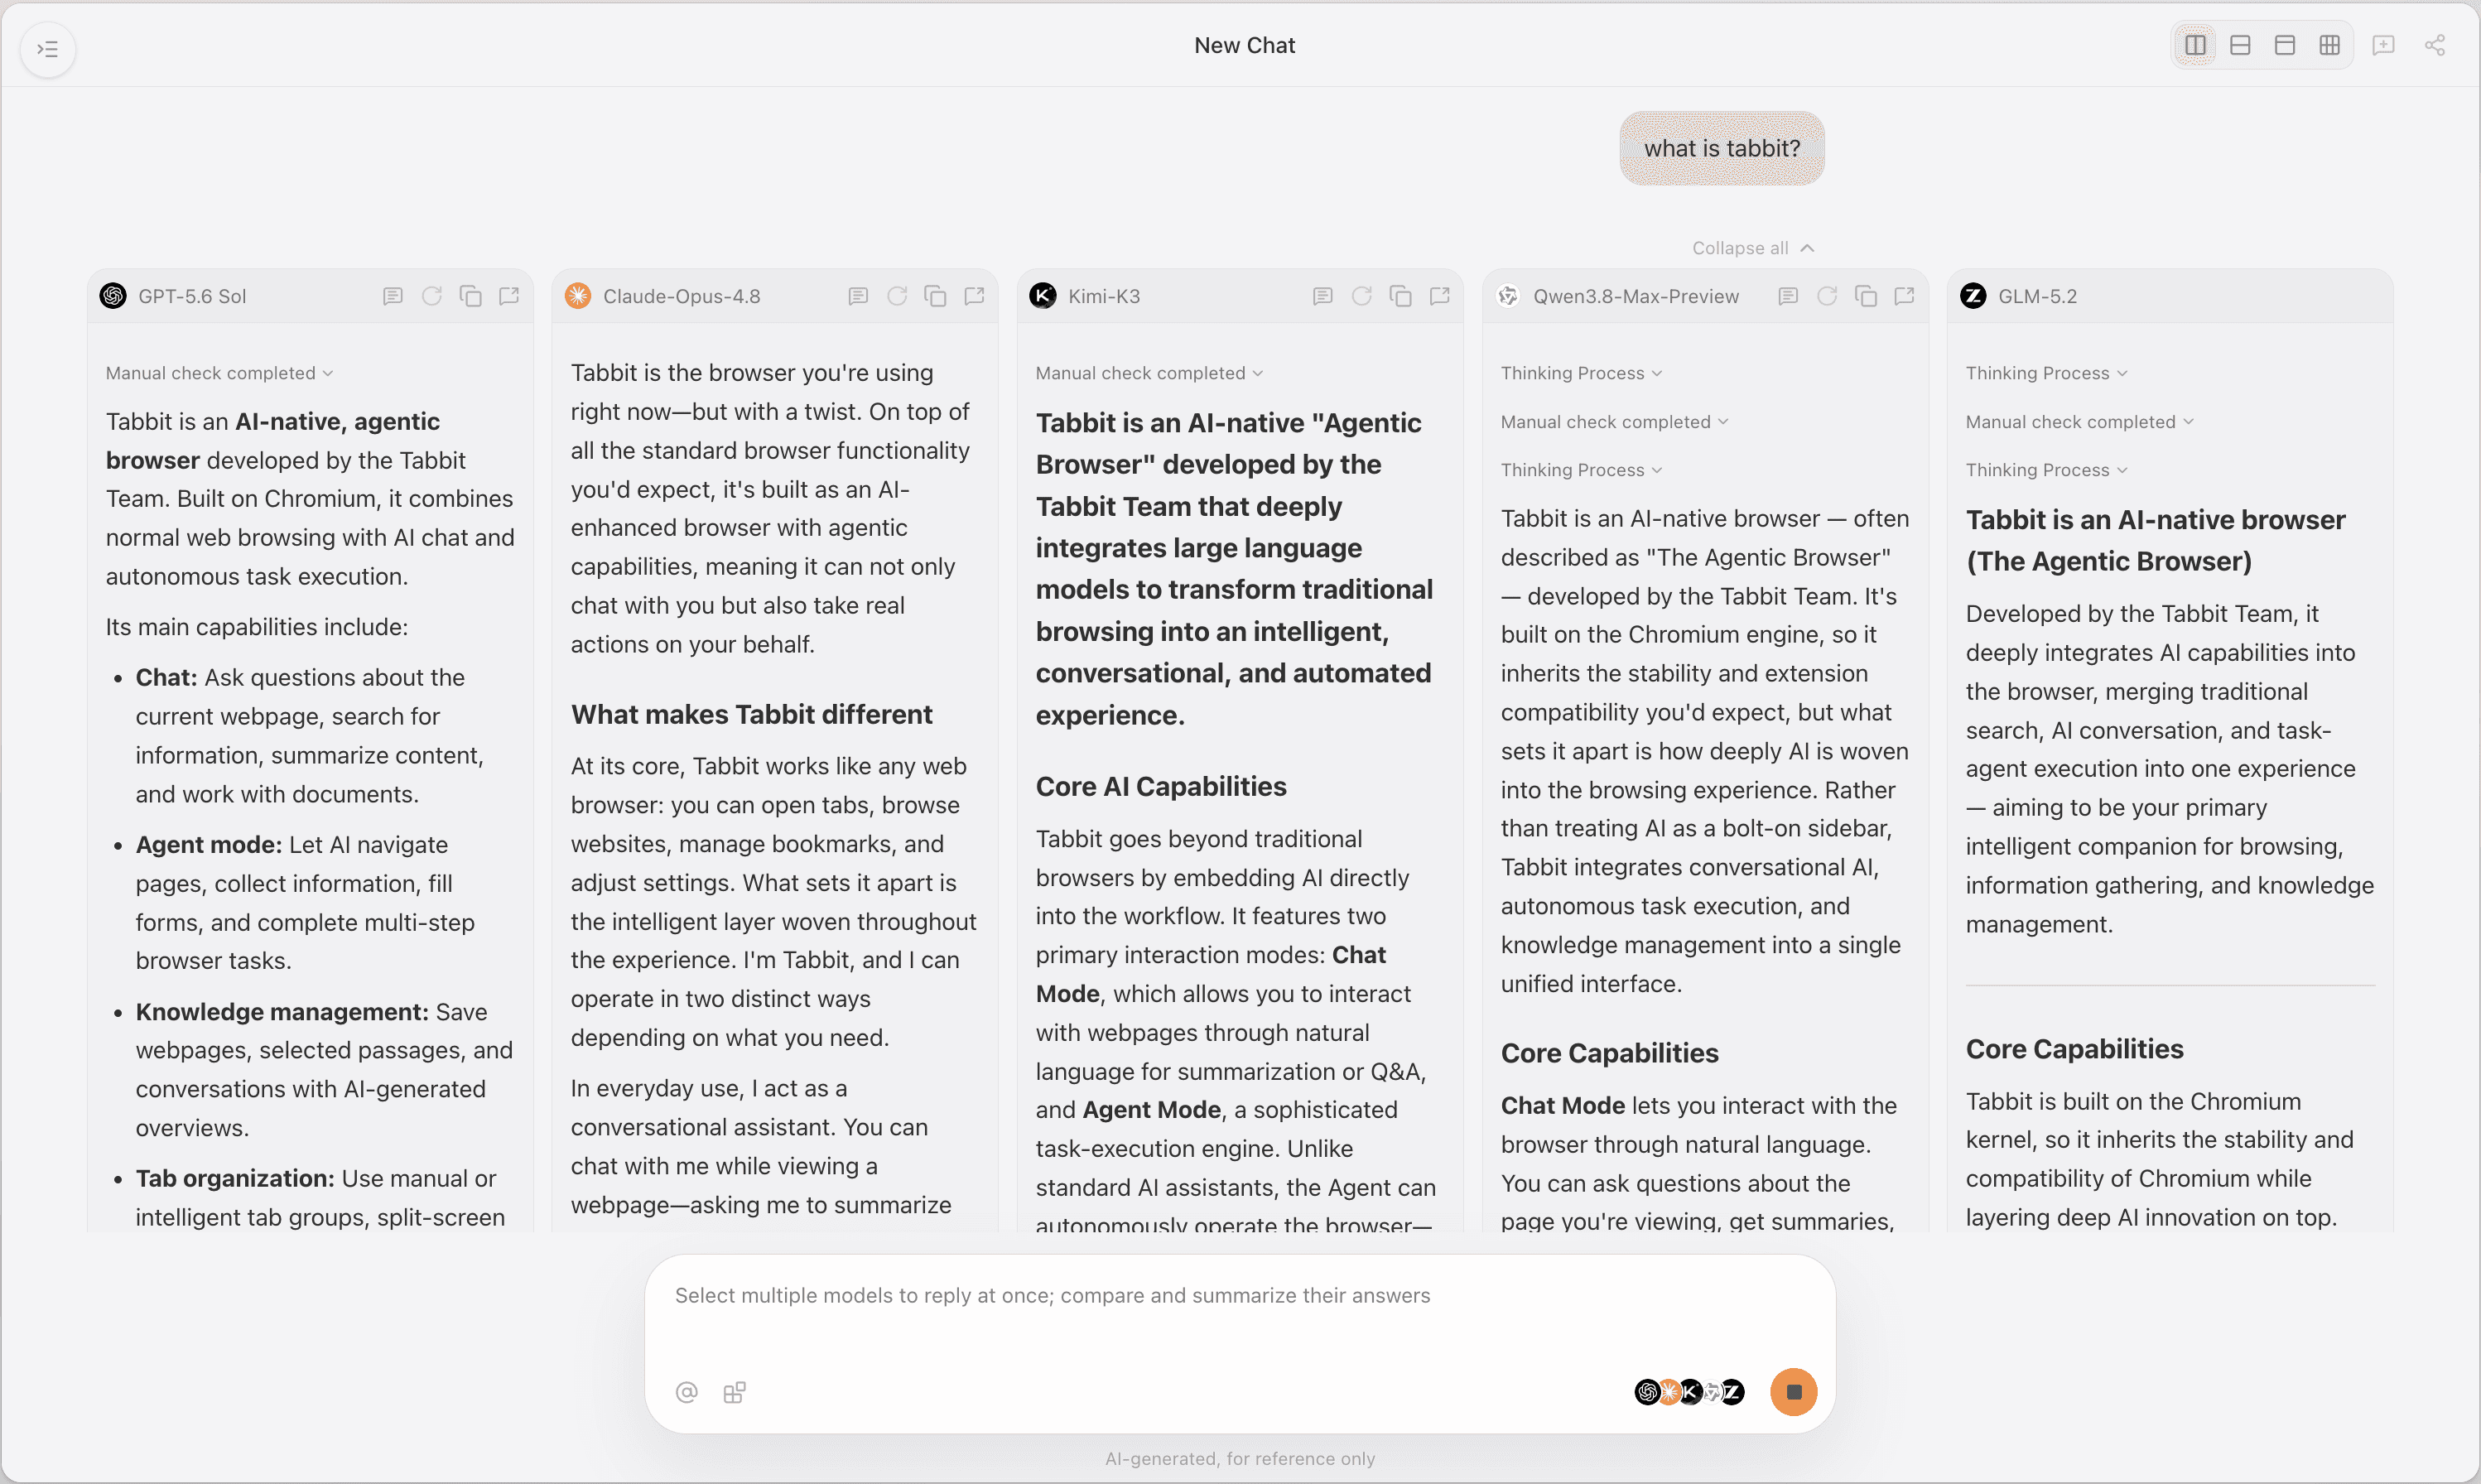
如果当前账号都能选择这两款模型,可以给它们相同的公开文档,要求生成带来源链接的事实表,再逐条打开原文核对。若某个模型不可用,不应换一个模型后仍称为这两款的对比。模型、额度、工具和价格可能变化;本文没有在已登录的 Tabbit 中运行两款模型。
涉及网页操作时,先使用可撤销或只读任务,明确哪些操作需要确认,并检查结果。浏览器自动化指南介绍了相关流程;如果想比较产品,可查看 AI 浏览器对比。测量 API 延迟和成本时,仍需要一致的测试环境。
按场景选择
| 主要需求 | 建议起点 | 决策前确认 |
|---|---|---|
| 控制模型部署 | GLM-5.3-Flash | 许可证、内存、部署框架和运维费用 |
| 长流程编程或视觉任务 | 两款都试,包括 LongCat 2.5 | 相同代码库、工具、图片和验收测试 |
| 降低 API 总费用 | 比较实际服务商报价 | 缓存价格、输出量、重试和服务条款 |
| 整理网页资料 | 模型可用时在 Tabbit 中试用工作流 | 模型选择器、额度、引用质量和账号条款 |
| 处理敏感代码或文档 | 先审查部署线路 | 数据保留、训练使用、地区和合同条款 |
目前 GLM-5.3-Flash 的自托管路径更明确。LongCat 2.5 值得在其公布的智能体和视觉任务上进行受控试用。先从可撤销任务开始,比较合格输出和完整账单,再根据模型与服务条款变化调整选择。

常见问题
哪个模型更适合编程?
本文没有在相同条件下实测两个正式版模型。建议用相同代码库、工具、测试和时间限制比较可接受的修改、失败次数和总成本。
两款模型都提供开放权重吗?
智谱以 MIT 许可证发布了 GLM-5.3-Flash 权重。2026 年 11 月 3 日,LongCat 2.5 发布页的 GitHub 和 Hugging Face 链接仍标注敬请期待,请核对后续发布状态和许可证。
哪个模型更便宜?
2026 年 11 月 3 日,LongCat 官方限时价格每百万输入和输出分别为 0.30 美元和 1.20 美元;OpenRouter 上的 Z.ai 路线分别为 0.15 美元和 0.50 美元。这是不同线路的快照,决策前应核对实时价格、缓存、输出和重试费用。
两款模型都支持长上下文吗?
LongCat API 文档列出 100 万 token 上下文,GLM-5.3-Flash 的权重配置也标明约 100 万 token。实际可用长度和输出上限取决于服务商和客户端。
两款模型可以理解图片吗?
两家厂商均介绍了原生多模态能力。具体 API 和客户端是否支持图片或视频、支持哪些格式,需要接入前确认。
可以在 Tabbit 中使用这两个模型吗?
本文没有在已登录的 Tabbit 账号中验证两款模型。请以账号当前的模型选择器和使用条款为准。