
Choisissez d'abord GLM-5.3-Flash si vous devez télécharger les poids et héberger le modèle vous-même. Essayez LongCat 2.5 pour les tâches longues de programmation ou les agents visuels, puis mesurez les résultats sur votre propre travail. Les scores publics ne désignent pas de vainqueur dans des conditions identiques.
Cette distinction compte lorsqu'un agent peut modifier un dépôt. Un utilisateur de Reddit rapporte des échecs répétés d'outils et des modifications hors sujet lors d'une refonte avec LongCat 2.5 Preview. C'est une expérience individuelle avec une ancienne version, pas une mesure de la version publiée en novembre. Nous expliquons plus loin comment organiser une comparaison dans Tabbit Browser et où s'arrêtent ses conclusions.
À retenir
Z.ai publie les poids de GLM-5.3-Flash sous MIT. Le 3 novembre, les liens GitHub et Hugging Face de LongCat étaient annoncés comme à venir.
Les deux éditeurs décrivent des modèles multimodaux. Le support des images et des vidéos dépend du client et du fournisseur.
L'API LongCat et la configuration de GLM indiquent environ un million de tokens de contexte ; une application peut limiter cette capacité.
Les scores de code publiés reposent sur des conditions différentes. Testez vos propres dépôts et outils.
La facture dépend aussi du cache, des tokens produits, des nouvelles tentatives et de la revue humaine.
LongCat 2.5 et GLM-5.3-Flash en bref
| Critère | LongCat 2.5 | GLM-5.3-Flash |
|---|---|---|
| Développeur | Meituan | Z.ai |
| Paramètres | 1 600 milliards au total, environ 48 milliards actifs par token | 320 milliards au total, environ 18 milliards actifs |
| Poids | Liens annoncés comme à venir le 3 novembre | Téléchargeables sous licence MIT |
| Contexte | Un million de tokens selon l'API | 1 048 576 tokens selon la configuration |
| Entrées | Vision et langage natifs selon l'annonce | Modèle multimodal natif selon la fiche |
| Code | 88,4 sur Terminal-Bench 2.1 selon Meituan | 84,3 sur le même benchmark selon la fiche |
| Prix par million de tokens | Offre officielle : 0,30 dollar en entrée et 1,20 en sortie | Z.ai sur OpenRouter : 0,15 dollar en entrée et 0,50 en sortie |
Les caractéristiques proviennent de l'annonce Meituan, de la fiche Z.ai, du guide API LongCat et de la documentation NVIDIA. Les tarifs sont ceux observés le 3 novembre sur l'offre officielle LongCat et la route Z.ai d'OpenRouter. Ils concernent des routes différentes, pas un abonnement Tabbit.
LongCat 2.5 est distinct de LongCat 2.0, tout comme GLM-5.3-Flash du plus grand GLM-5.3. L'article sur Ox Alpha explique le nom utilisé pendant la préversion de Flash.
Code et agents : comparez la tâche entière
Meituan annonce 88,4 pour LongCat 2.5 sur Terminal-Bench 2.1 ; la fiche Z.ai affiche 84,3 pour Flash. Les versions d'outils et les paramètres décrits par les éditeurs diffèrent. Un écart de 4,1 points ne prédit ni la réussite sur votre dépôt, ni le nombre de tentatives, ni les modifications hors périmètre.
Dans un petit test communautaire, LongCat 2.5 Preview Free et GLM 5.3 Flash Free ont chacun réussi trois vérifications. Flash a été ajouté le lendemain et chaque partie n'a été exécutée qu'une fois. L'auteur précise que les vitesses ne sont pas comparables dans des conditions contrôlées. Ce test ne classe pas la version finale de LongCat.
Préparez deux copies identiques du dépôt avec la même demande, les mêmes outils et le même délai. Empêchez l'agent de modifier les tests ou conservez leur empreinte. Exécutez les tests originaux, inspectez les fichiers et notez les erreurs, les tentatives et les corrections humaines. Répétez l'opération sur plusieurs tâches. Le guide sur le raisonnement des agents explique l'importance de l'environnement et des sources.
Contexte et images : vérifiez la route utilisée
Un million de tokens est une limite annoncée, pas la garantie que chaque application accepte cette taille ou retrouve le bon fait. Les instructions système, résultats d'outils, historiques et sorties occupent aussi le contexte. Testez un document dont vous connaissez les réponses au début, au milieu et à la fin. Vérifiez comment le client résume ou supprime les anciens messages.
Le 3 novembre, la documentation LongCat consultée dans le navigateur indiquait 256K en sortie maximale ; une autre version récupérée indiquait 128K. Vérifiez les limites actuelles de votre compte avant de prévoir une réponse longue.
Les deux éditeurs décrivent l'entrée visuelle, mais tous les SDK et configurations ne la prennent pas en charge. La recette vLLM distingue les interfaces compatibles avec les images et vidéos. Pour une tâche de capture vers code, fournissez la même image et évaluez le rendu et l'accessibilité.
Poids ouverts et hébergement
La fiche GLM propose des poids MIT. Leur hébergement demande néanmoins de l'infrastructure : vLLM estime les seuls poids FP8 natifs à environ 306 Gio, hors environnement d'exécution et cache KV. Quantification, concurrence et longueur de contexte changent les besoins en mémoire.
Lors de notre vérification, la page LongCat indiquait que ses liens GitHub et Hugging Face étaient à venir. Ce constat est daté. Si l'hébergement autonome est obligatoire, vérifiez les fichiers et leur licence avant de vous engager.
Calculer le coût réel
coût = tokens d'entrée hors cache / 1 000 000 × tarif d'entrée
     + tokens en cache / 1 000 000 × tarif de lecture
     + tokens de sortie / 1 000 000 × tarif de sortie
     + frais d'outils ou de plateforme
Avec les tarifs ci-dessus, un million de tokens d'entrée hors cache et 250 000 de sortie coûtent 0,60 dollar avec l'offre LongCat et 0,275 dollar via Z.ai sur OpenRouter, hors autres frais. C'est un exemple de calcul, pas une facture ni une estimation de consommation. Vérifiez la facturation des tokens de raisonnement et de l'écriture du cache, puis comparez le coût par tâche acceptée avec les tentatives et la revue.
Un commentaire Reddit décrit une connexion lente et instable avec LongCat 2.5 Preview sur OpenCode. Cette expérience concerne une route et une période précises. Notez le fournisseur, les erreurs et les tentatives avant d'attribuer une panne au modèle.
Organiser une comparaison dans Tabbit
Pour une recherche sur plusieurs pages, Tabbit Browser peut réunir sources et réponses. Le guide de Tabbit et la présentation des navigateurs agents expliquent l'usage du contexte web. L'image ci-dessous montre d'autres modèles ; elle ne représente pas un test des deux modèles comparés ici.
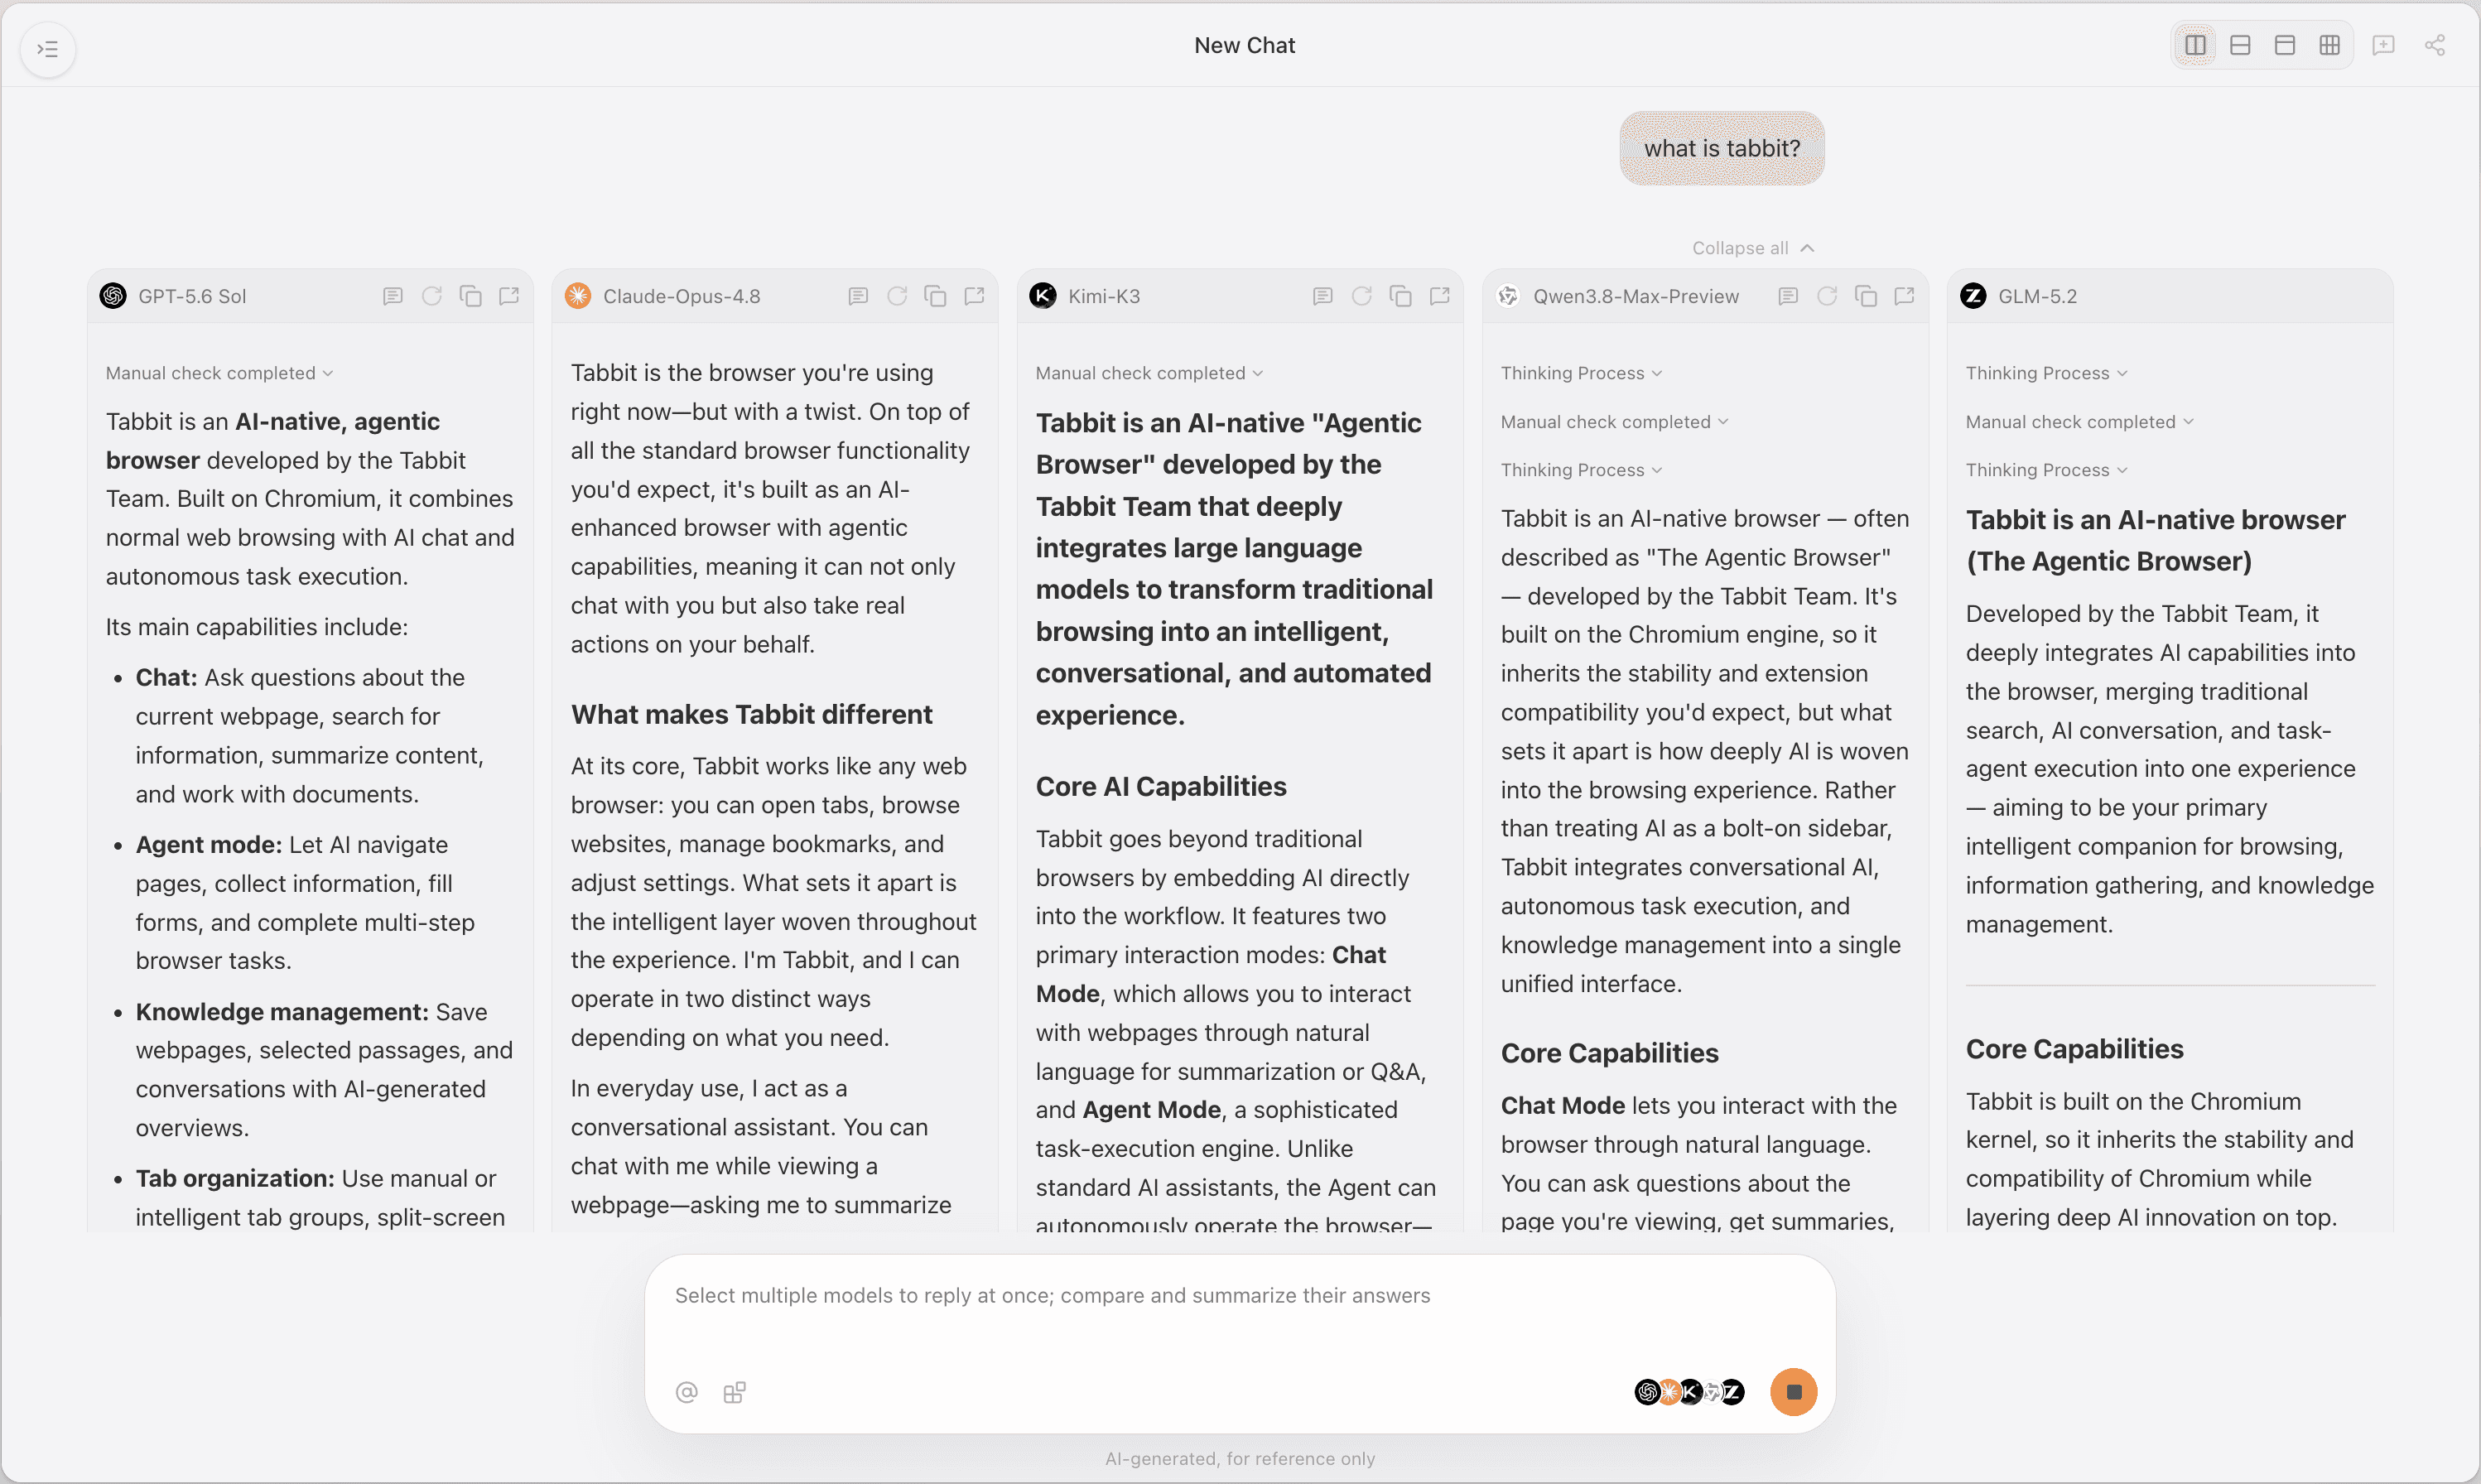
Si les deux modèles sont proposés dans votre compte, donnez-leur le même document public et demandez un tableau d'affirmations avec leurs sources. Ouvrez chaque lien et notez les erreurs. Si l'un manque, ne le remplacez pas en prétendant comparer la paire. Cet article n'a pas exécuté de test connecté avec ces modèles dans Tabbit.
Pour les actions web, commencez par une tâche réversible ou en lecture seule et inspectez le résultat avant d'autoriser des modifications. Consultez le guide d'automatisation du navigateur et la comparaison des navigateurs IA. Une session navigateur ne remplace pas un test API identique pour mesurer coût et latence.
Choisir selon votre priorité
| Besoin | Point de départ | Vérifications |
|---|---|---|
| Contrôler l'hébergement | GLM-5.3-Flash | Licence, mémoire, serveur et exploitation |
| Code long ou agent visuel | Tester les deux | Même dépôt, mêmes outils et critères |
| Réduire la facture API | Comparer les offres réelles | Cache, sortie, tentatives et conditions |
| Recherche web | Tester Tabbit si les modèles sont disponibles | Sélecteur, quotas et citations |
| Code ou documents sensibles | Examiner la route d'abord | Conservation, entraînement, région et contrat |
GLM-5.3-Flash offre aujourd'hui une voie d'hébergement autonome plus claire. LongCat 2.5 mérite un essai contrôlé sur les tâches d'agent et de vision annoncées. Commencez par une tâche réversible et comparez le résultat accepté et la facture totale.

Questions fréquentes
Quel modèle est le meilleur pour programmer ?
Cet article n'a pas testé les deux modèles dans les mêmes conditions. Utilisez les mêmes tâches de dépôt, outils, tests et délais, puis comparez les modifications acceptées, les échecs et le coût total.
Les deux modèles ont-ils des poids ouverts ?
Z.ai publie les poids de GLM-5.3-Flash sous licence MIT. Le 3 novembre 2026, la page de LongCat 2.5 indiquait que les liens GitHub et Hugging Face étaient à venir ; vérifiez leur disponibilité et la licence actuelle.
Quel modèle coûte le moins cher ?
Le 3 novembre 2026, LongCat affichait une offre limitée à 0,30 dollar par million de tokens en entrée et 1,20 dollar en sortie. La route Z.ai sur OpenRouter affichait 0,15 et 0,50 dollar ; les fournisseurs diffèrent et les tarifs peuvent changer.
Les deux modèles acceptent-ils un long contexte ?
La documentation de l'API LongCat indique un million de tokens et la configuration de GLM-5.3-Flash environ un million. Le fournisseur et le client peuvent imposer des limites d'entrée et de sortie inférieures.
Peuvent-ils comprendre les images ?
Les deux éditeurs décrivent des capacités multimodales natives. Vérifiez les formats d'image et de vidéo pris en charge ainsi que leurs limites pour votre API et votre client.
Puis-je utiliser les deux modèles dans Tabbit ?
Cet article n'a pas vérifié les deux modèles dans un compte Tabbit connecté. Consultez le sélecteur et les conditions de votre compte avant de construire un flux de travail.