
Elige GLM-5.3-Flash como punto de partida si necesitas descargar los pesos y alojar el modelo por tu cuenta. Prueba LongCat 2.5 para tareas largas de programación o agentes visuales, pero mide el resultado con tu propio trabajo antes de cambiar de proveedor. Las puntuaciones públicas no establecen un ganador en condiciones controladas.
La diferencia importa si un agente puede modificar un repositorio. Un usuario de Reddit informó de fallos repetidos de herramientas y cambios ajenos a la tarea durante una refactorización con LongCat 2.5 Preview. Es una experiencia individual con una versión anterior, no una medición de la versión de noviembre. Más adelante explicamos cómo Tabbit Browser ayuda a organizar la comparación y cuáles son los límites de esa prueba.
Ideas principales
Z.ai publica los pesos de GLM-5.3-Flash bajo MIT. El 3 de noviembre, la página de LongCat señalaba que sus enlaces de GitHub y Hugging Face estaban pendientes.
Los dos fabricantes describen modelos multimodales; el soporte de imágenes y vídeo depende de la ruta y el cliente.
LongCat documenta un contexto de un millón de tokens y la configuración de GLM indica una cifra similar. Una aplicación puede limitarlo.
Las cifras de programación publicadas se obtuvieron con condiciones distintas. Hay que probar el repositorio y las herramientas propios.
La factura depende también de la caché, los tokens de salida, los reintentos y la revisión humana.
LongCat 2.5 y GLM-5.3-Flash de un vistazo
| Aspecto | LongCat 2.5 | GLM-5.3-Flash |
|---|---|---|
| Desarrollador | Meituan | Z.ai |
| Parámetros | 1,6 billones en total; unos 48.000 millones activos por token | 320.000 millones en total; unos 18.000 millones activos |
| Pesos | Enlaces pendientes el 3 de noviembre | Descargables con licencia MIT |
| Contexto | La API documenta un millón de tokens | La configuración indica 1.048.576 tokens |
| Entrada | El anuncio describe visión y lenguaje nativos | La ficha describe un modelo multimodal nativo |
| Programación | 88,4 en Terminal-Bench 2.1, según Meituan | 84,3 en Terminal-Bench 2.1, según la ficha |
| Precio por millón de tokens | Oferta oficial: 0,30 dólares de entrada y 1,20 de salida | Z.ai en OpenRouter: 0,15 dólares de entrada y 0,50 de salida |
Las especificaciones proceden del anuncio de Meituan, la ficha de Z.ai, la guía de LongCat y la documentación de NVIDIA. Los precios son una instantánea del 3 de noviembre de la oferta oficial de LongCat y la ruta de Z.ai en OpenRouter. No son tarifas universales ni precios de Tabbit.
LongCat 2.5 no es LongCat 2.0; GLM-5.3-Flash tampoco es el modelo más grande GLM-5.3. La historia del nombre de prueba aparece en Ox Alpha.
Programación y agentes: compara la tarea completa
Meituan comunica 88,4 para LongCat y la ficha de Z.ai indica 84,3 para Flash en Terminal-Bench 2.1. Los fabricantes describen versiones y ajustes distintos de las herramientas. La diferencia de 4,1 puntos no predice si una corrección pasará tus pruebas, cuántos intentos necesitará ni si modificará archivos ajenos.
En una prueba pequeña de la comunidad, LongCat 2.5 Preview Free y GLM 5.3 Flash Free pasaron tres comprobaciones. Flash se añadió al día siguiente y cada parte se ejecutó una sola vez. El autor advirtió que no era una comparación controlada de velocidad. La prueba no clasifica la versión final de LongCat.
Prepara copias idénticas del repositorio y asigna a ambos modelos el mismo problema, herramientas y tiempo máximo. Protege las pruebas frente a modificaciones o guarda su hash. Ejecuta las pruebas originales y registra archivos cambiados, errores de herramientas, reintentos y correcciones humanas. Repite el procedimiento con varias tareas. La guía de razonamiento con agentes explica por qué importa el entorno de herramientas.
Contexto e imágenes: manda la ruta de acceso
Un millón de tokens es un límite declarado, no una garantía de que cada aplicación acepte esa cantidad o encuentre el dato correcto. Las instrucciones, los resultados de herramientas, el historial y la salida consumen contexto. Prueba un documento con respuestas conocidas al principio, en el centro y al final, y comprueba cómo el cliente resume o descarta mensajes antiguos.
El 3 de noviembre la guía de LongCat mostraba 256K como salida máxima, mientras otra versión consultada indicaba 128K. Verifica la documentación y el límite de tu cuenta antes de planificar respuestas largas.
Los fabricantes describen entrada visual, pero no todas las configuraciones la exponen. La receta de vLLM distingue interfaces compatibles e incompatibles con imágenes y vídeo. Para comparar una tarea de captura a código, usa la misma imagen y evalúa la página renderizada y su accesibilidad.
Pesos abiertos y coste de alojamiento
La ficha de GLM ofrece pesos MIT, pero alojarlos exige infraestructura. vLLM calcula unos 306 GiB para los pesos FP8, sin contar el entorno de ejecución ni la caché KV. La cuantización, la concurrencia y el contexto cambian la memoria necesaria.
La página de LongCat mostraba los enlaces de GitHub y Hugging Face como pendientes durante esta investigación. Es una observación fechada, no una afirmación sobre el futuro. Si necesitas alojamiento propio, comprueba los archivos y la licencia vigentes.
Cómo calcular el coste real
coste = tokens de entrada sin caché / 1.000.000 × tarifa de entrada
      + tokens en caché / 1.000.000 × tarifa de lectura
      + tokens de salida / 1.000.000 × tarifa de salida
      + cargos de herramientas o plataforma
Con las tarifas anteriores, un millón de tokens sin caché y 250.000 de salida cuestan 0,60 dólares con la oferta de LongCat y 0,275 en la ruta de Z.ai en OpenRouter, antes de otros cargos. Es solo un ejemplo aritmético. Comprueba el cobro de tokens de razonamiento y escrituras de caché. Después compara el coste por tarea aceptada, incluidos reintentos y revisión.
Un comentario de Reddit describió una conexión lenta e inestable con LongCat 2.5 Preview en OpenCode. Es una experiencia en una ruta concreta. Registra proveedor, errores y reintentos antes de atribuir los tiempos de espera al modelo.
Una comparación práctica en Tabbit
Tabbit Browser puede reunir fuentes y respuestas cuando la tarea comienza con varias páginas. La guía de Tabbit y la explicación de los navegadores con agentes muestran cómo se usa el contexto web. La imagen muestra otros modelos en una interfaz general; no es una prueba de los dos de este artículo.
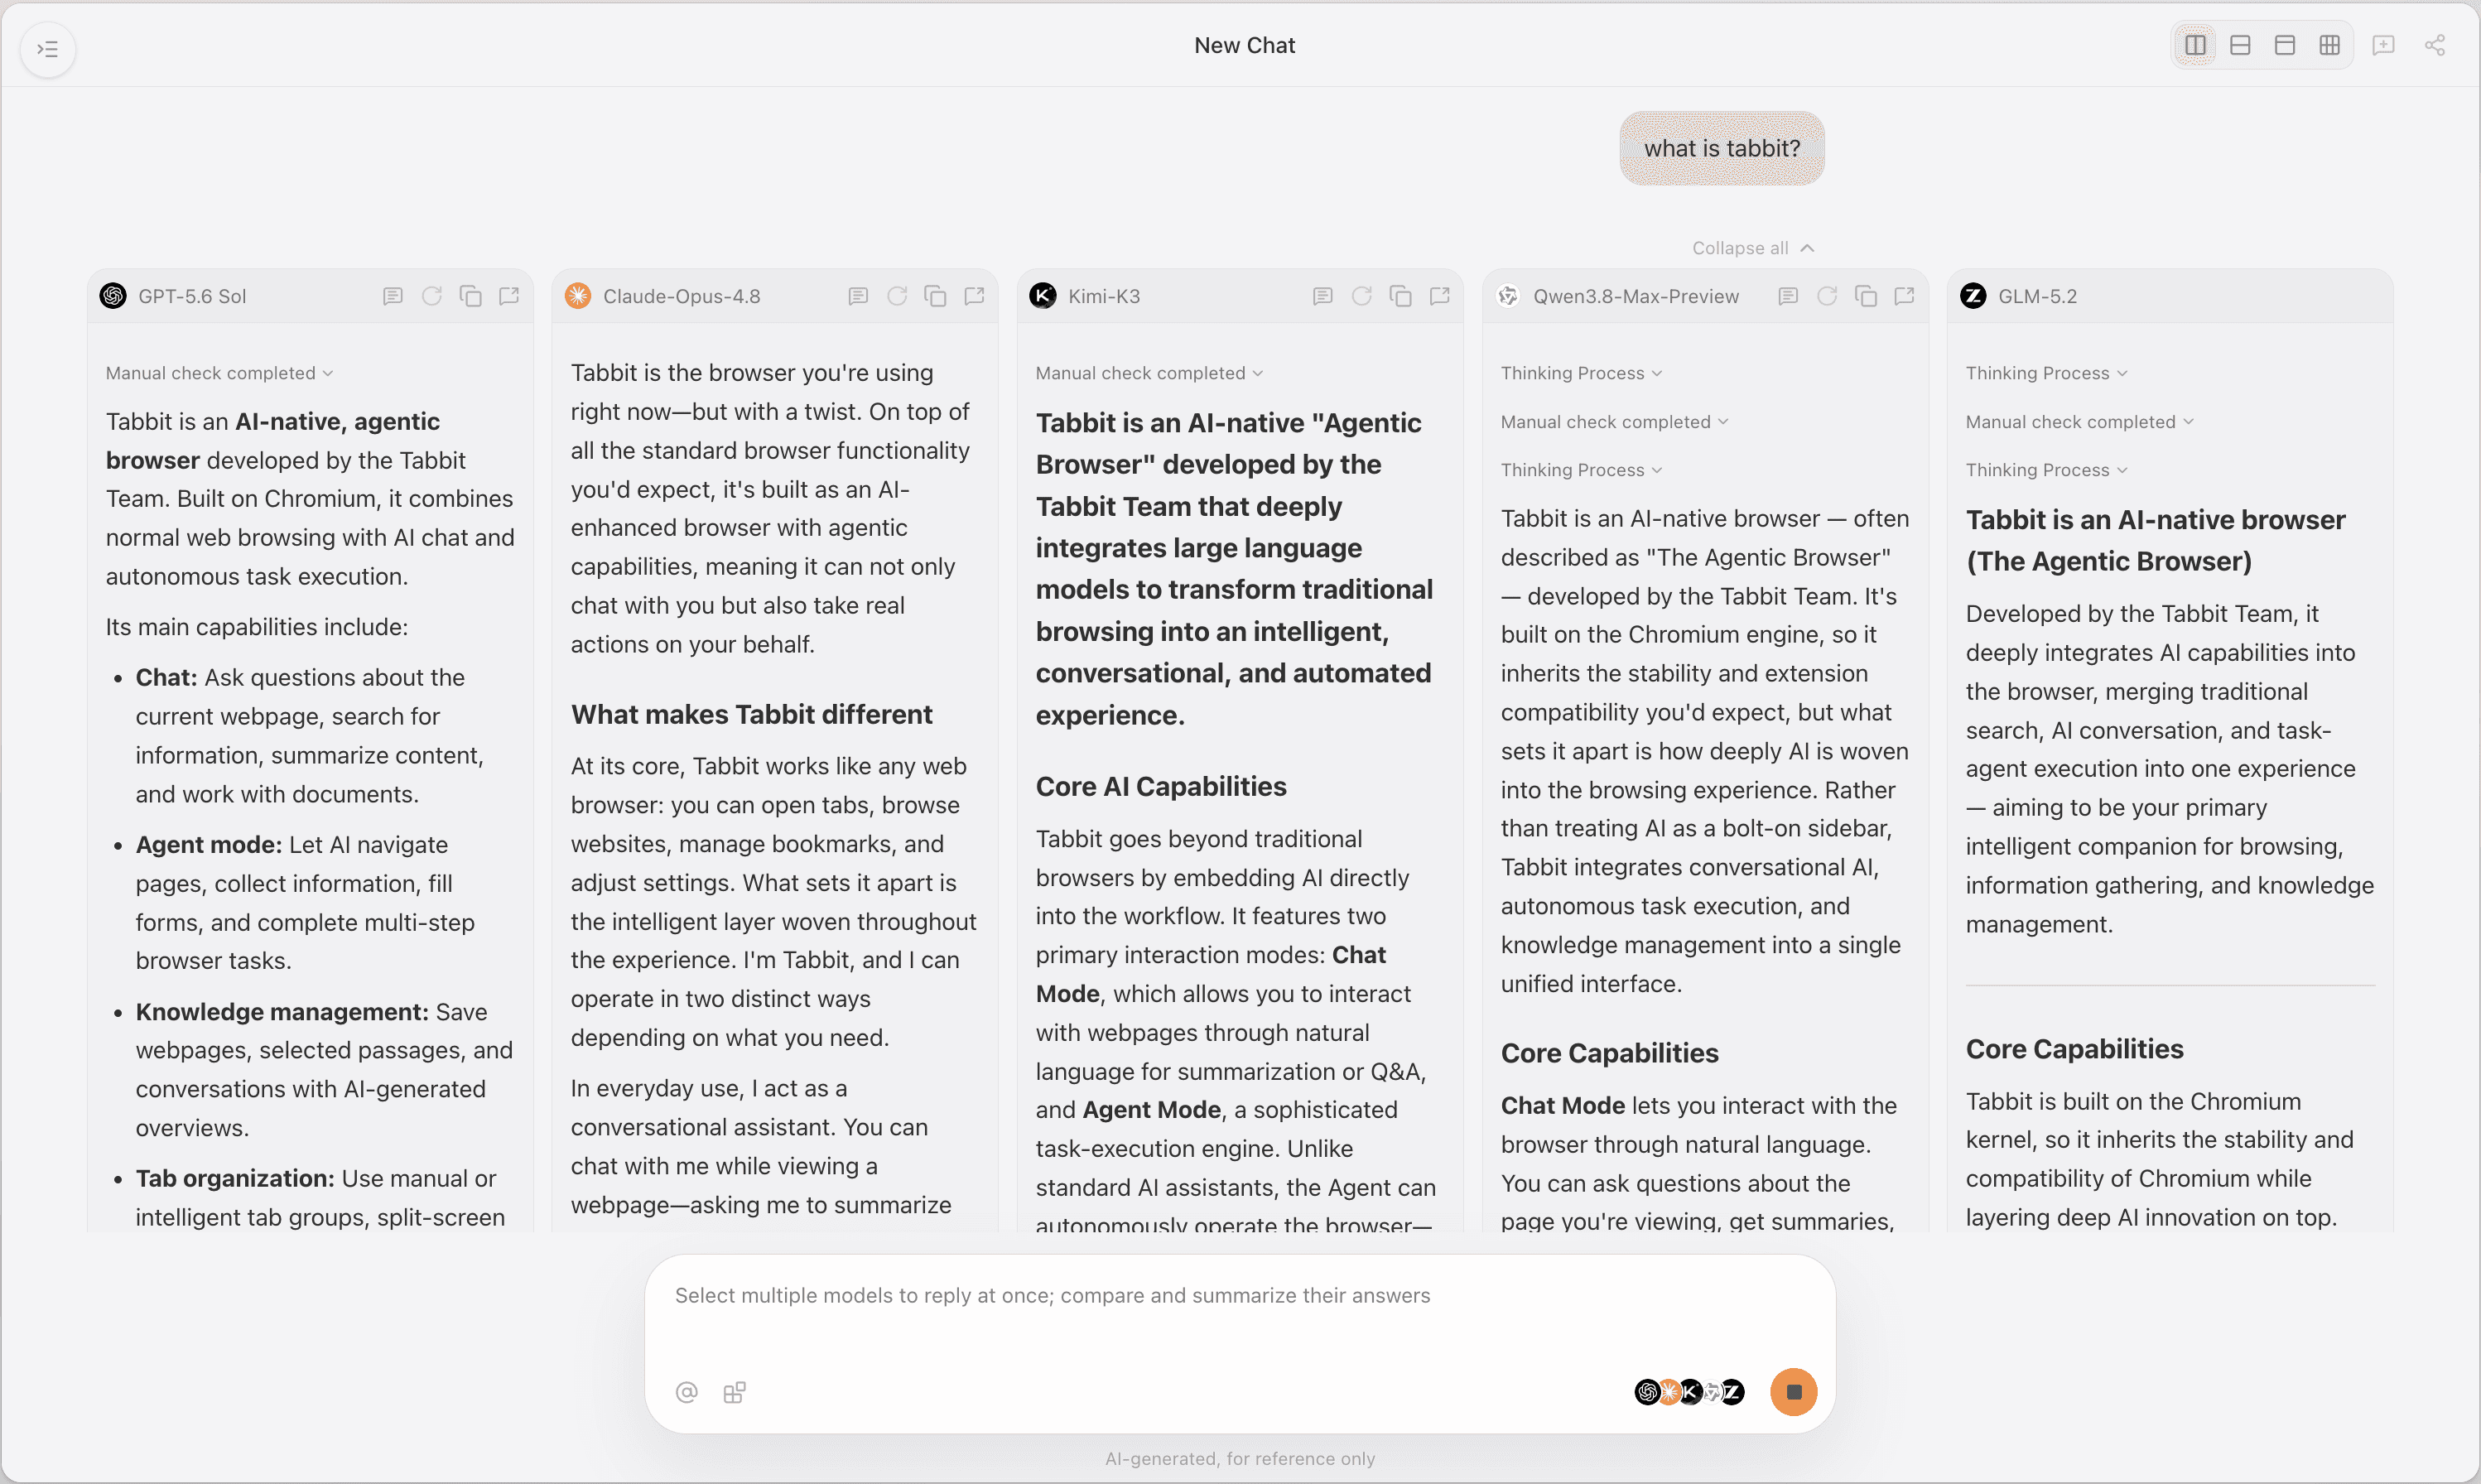
Si ambos aparecen en tu cuenta, entrega el mismo documento público a cada uno y pide una tabla de afirmaciones con enlaces. Abre las fuentes y anota errores y omisiones. Si uno no está disponible, no presentes otro modelo como sustituto en la comparación. Este artículo no ejecutó una prueba autenticada con ellos en Tabbit.
Para acciones web, empieza con una tarea reversible o de solo lectura y revisa el resultado antes de permitir cambios. La guía de automatización del navegador describe el flujo, y la comparativa de navegadores con IA ayuda a elegir producto. Una sesión del navegador no sustituye una prueba de API idéntica para medir latencia y coste.
Qué modelo elegir según la tarea
| Prioridad | Punto de partida | Qué comprobar |
|---|---|---|
| Control del alojamiento | GLM-5.3-Flash | Licencia, memoria, servidor y operación |
| Agentes visuales o programación larga | Prueba ambos | Repositorio, herramientas e indicadores de aceptación iguales |
| Menor factura de API | Compara proveedores | Caché, salida, reintentos y condiciones |
| Investigación web | Prueba Tabbit si los modelos están disponibles | Selector, cuota y calidad de las citas |
| Código o documentos sensibles | Revisa primero la ruta | Retención, entrenamiento, región y contrato |
Hoy GLM-5.3-Flash ofrece una vía más clara de alojamiento propio. LongCat 2.5 merece una prueba controlada en las tareas visuales y de agentes que describe su fabricante. Comienza con una tarea reversible y compara el resultado aceptado y la factura completa.

Preguntas frecuentes
¿Qué modelo es mejor para programar?
Este artículo no ha probado los dos modelos en igualdad de condiciones. Compara tareas del mismo repositorio con las mismas herramientas, pruebas y límites de tiempo, y revisa los cambios aceptados y el coste total.
¿Los dos modelos tienen pesos abiertos?
Z.ai publica los pesos de GLM-5.3-Flash bajo licencia MIT. El 3 de noviembre de 2026, la página de LongCat 2.5 indicaba que sus enlaces de GitHub y Hugging Face llegarían más adelante; comprueba si eso ha cambiado y revisa la licencia.
¿Cuál cuesta menos?
El 3 de noviembre de 2026, LongCat anunciaba una tarifa temporal de 0,30 dólares por millón de tokens de entrada y 1,20 de salida. La ruta de Z.ai en OpenRouter indicaba 0,15 y 0,50 dólares; son proveedores distintos y conviene revisar las tarifas actuales y la caché.
¿Ambos admiten contexto largo?
La documentación de la API de LongCat indica un millón de tokens y la configuración de GLM-5.3-Flash también especifica aproximadamente un millón. El proveedor y el cliente pueden imponer límites menores de entrada o salida.
¿Pueden entender imágenes?
Ambos fabricantes describen capacidades multimodales nativas. Comprueba en la ruta y el cliente concretos los formatos de imagen y vídeo admitidos y sus límites.
¿Puedo usar los dos modelos en Tabbit?
Este artículo no comprobó ambos modelos en una cuenta de Tabbit con sesión iniciada. Consulta el selector de tu cuenta y las condiciones vigentes antes de depender de ellos.