
GPT-6.1 Terra coûte 1 $ par million de tokens d’entrée, 0,05 $ par million de tokens d’entrée en cache et 5 $ par million de tokens de sortie selon la grille API Standard d’OpenAI pour un contexte court, vérifiée le 27 octobre 2026. Les écritures dans le cache constituent des catégories de facturation distinctes : 1,25 $ pour 30 minutes ou 2,50 $ pour 12 heures. Ce sont des tarifs API, pas le prix d’un abonnement ChatGPT ou Tabbit. (Tarifs OpenAI)
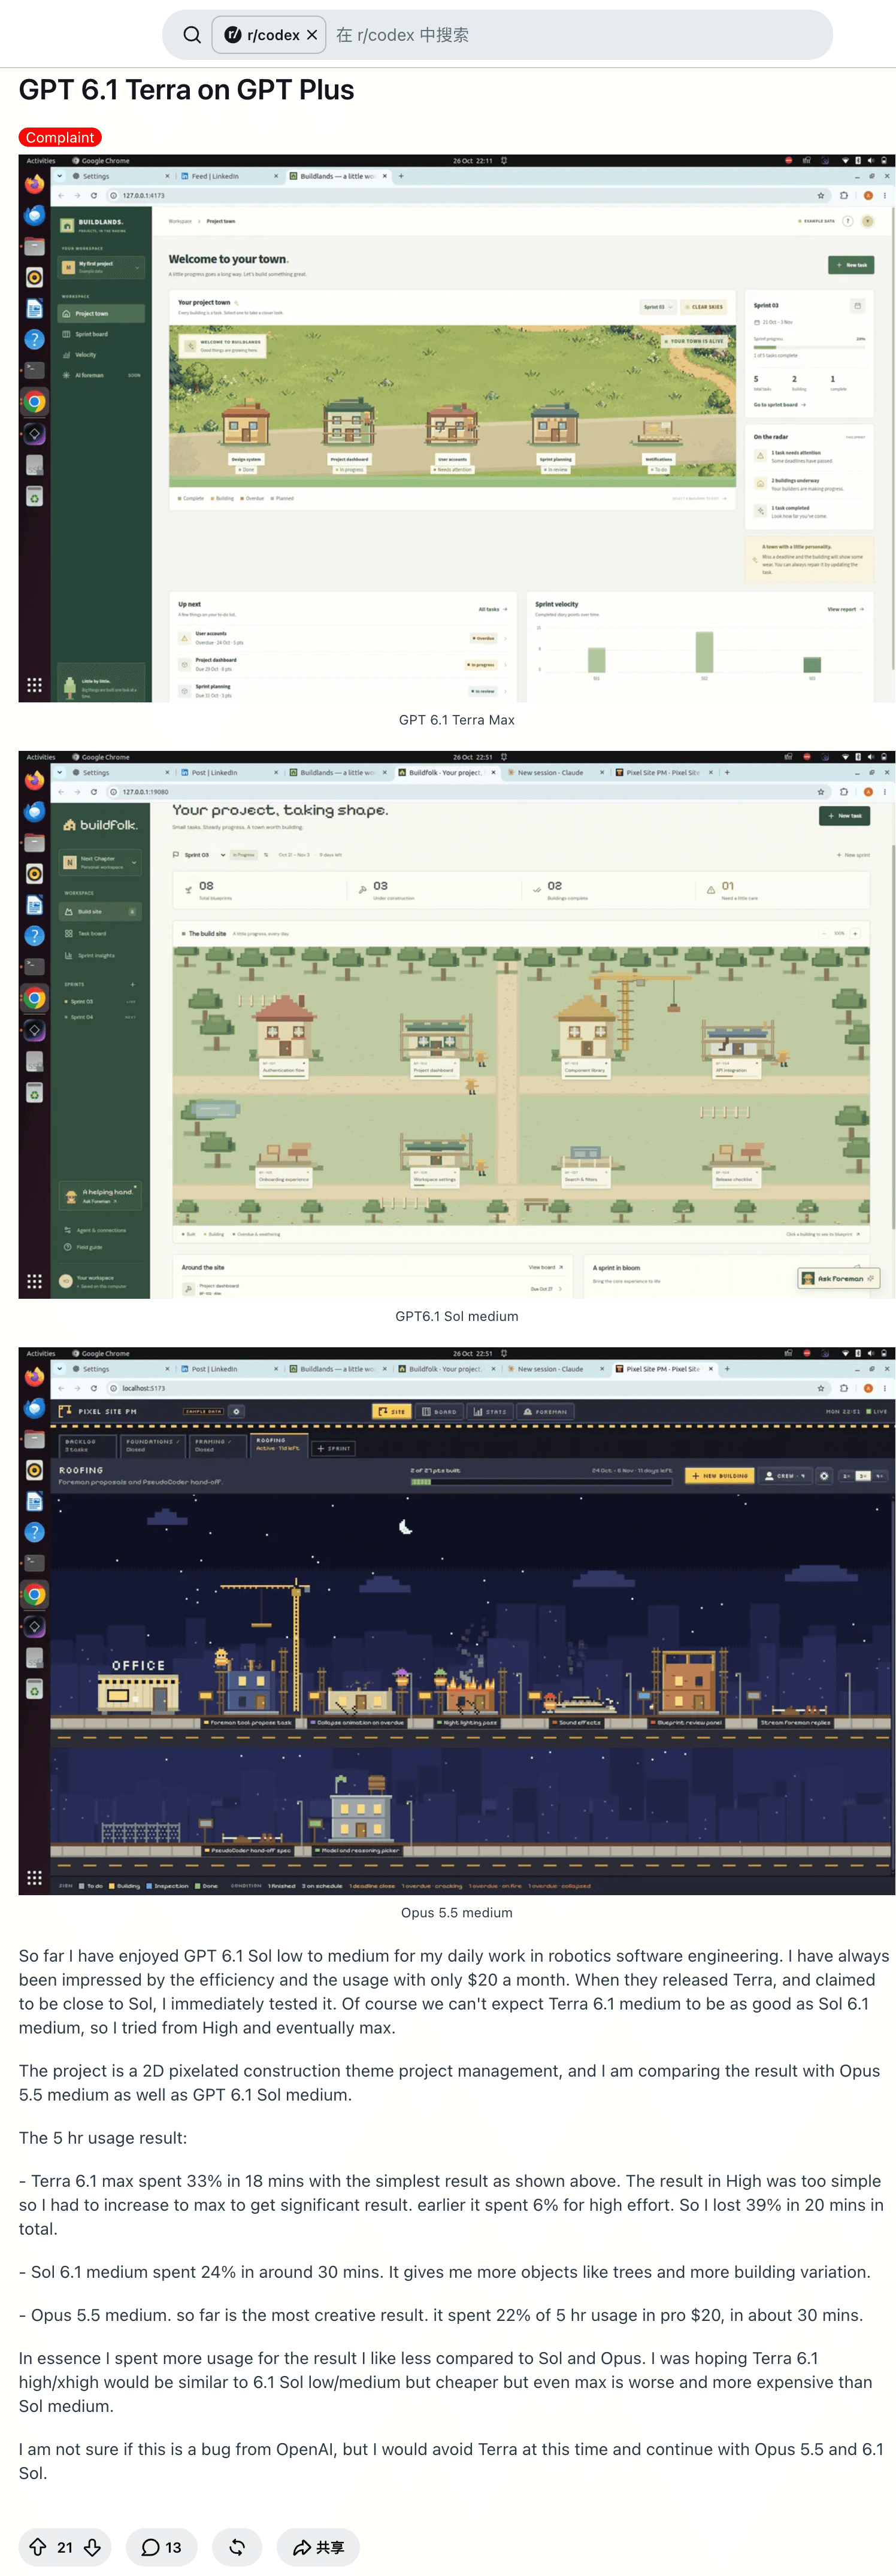
Le chiffre à surveiller est 95 % : une lecture en cache coûte 95 % de moins qu’une entrée ordinaire. Cela peut compter davantage que le tarif d’entrée mis en avant lorsqu’un agent relit les mêmes consignes et documents. Cela ne garantit pas pour autant qu’une tâche terminée coûtera moins cher. Dans un témoignage Reddit publié le jour du lancement, ayudha90 a indiqué avoir consommé davantage de son quota d’abonnement et moins apprécié le résultat après avoir augmenté l’effort de Terra. C’est l’expérience d’une personne, pas une facture API ni une comparaison contrôlée.
Vous trouverez ci-dessous la grille en vigueur, les conditions des réductions, deux budgets reproductibles et un calculateur local. La section Tabbit Browser vérifie le sélecteur de modèles avant de suggérer un flux de travail client.
Tarifs API de GPT-6.1 Terra en bref
Prix en USD par million de tokens, vérifiés le 27 octobre 2026. Les deux colonnes correspondent au traitement Standard sans supplément régional. La colonne de l’ancien modèle provient de la fiche actuelle de GPT-5.6 Terra et de la grille tarifaire, et non d’un prix historique supposé.
| Catégorie de facturation, contexte court | GPT-5.6 Terra | GPT-6.1 Terra | Évolution |
|---|---|---|---|
| Entrée non mise en cache | $2.00 | $1.00 | −50% |
| Lecture de l’entrée en cache | $0.20 | $0.05 | −75% |
| Écriture dans le cache, 30 minutes | $2.50 | $1.25 | −50% |
| Écriture dans le cache, 12 heures | $5.00 | $2.50 | −50% |
| Sortie, raisonnement inclus | $12.00 | $5.00 | environ −58.3% |
Il s’agit de GPT-6.1 Terra, ID API gpt-6.1-terra, un modèle qui accepte du texte et des images en entrée et produit du texte. OpenAI le destine au raisonnement visuel, au contrôle de l’ordinateur et à la rédaction. Sa fenêtre de contexte de 1 050 000 tokens indique une capacité ; le palier tarifaire le moins cher s’arrête bien plus tôt. L’aperçu de Terra précédent présente le modèle antérieur ; la fiche actuelle fait foi pour les spécifications du jour.
À retenir
La lecture d’une entrée en cache coûte 0,05 $ par million de tokens, soit 5 % du tarif d’entrée ordinaire de Terra à 1 $. Les écritures coûtent plus cher et doivent être budgétées séparément.
L’entrée, les lectures en cache et les écritures en cache sont des catégories de tokens mutuellement exclusives. Ajouter un tarif d’écriture à l’entrée ordinaire pour les mêmes tokens surestime la facture.
Au-delà de 272K tokens d’entrée, les tarifs supérieurs s’appliquent à toute la requête. Le fait de pouvoir placer davantage de contexte en mémoire ne maintient pas le tarif du palier court.
Batch et Flex divisent par deux les tarifs Standard correspondants ; Fast les double. Chaque mode a ses conditions : choisissez le traitement avant d’estimer le coût.
Comparez le coût par résultat accepté avec un niveau d’effort adapté. Les dépenses API en dollars, le quota d’abonnement et l’accès depuis un client répondent à des questions différentes.
La réduction de 95 % ne concerne que les lectures en cache
À 0,05 $, le tarif de lecture en cache de Terra représente un vingtième de son tarif d’entrée sans cache. Par rapport au tarif de lecture en cache de 0,20 $ de GPT-5.6 Terra, il est inférieur de 75 %. Ces pourcentages ont des dénominateurs différents. Aucun ne signifie que la facture totale baisse de 95 % ou de 75 %.
Un préfixe réutilisé peut contenir des consignes, des outils et un contexte documentaire stable. La réutilisation du cache exige des préfixes identiques et au moins 1 024 tokens pour ces modèles. Si le préfixe change ou si la durée de conservation n’est pas respectée, un accès attendu au cache peut devenir une écriture ou une entrée ordinaire. Mesurez l’usage renvoyé au lieu de supposer que chaque requête répétée utilise le cache. Le guide du prompt caching explique les règles de correspondance et de conservation.
Pour les tokens d’entrée qui ne sont pas en cours d’écriture dans le cache, un taux d’accès h donne le coût suivant par million de tokens d’entrée total en contexte court :
coût d’entrée = (1 − h) × $1 + h × $0.05
h = 80% → coût d’entrée = $0.24
Ces 0,24 $ n’incluent ni la sortie ni les écritures dans le cache. La première requête qui crée un préfixe n’est pas équivalente à une requête ultérieure qui le lit. C’est important dans les boucles de recherche agentique, où le contexte réutilisé peut représenter une grande partie du volume d’entrée.
Traduire la baisse affichée en budget par tâche
La comparaison tarifaire est favorable : l’entrée est divisée par deux, la sortie baisse d’environ 58,3 % et les lectures baissent de 75 % par rapport au prédécesseur actuellement indiqué. Les tableaux officiels établissent ces différences. Ils n’indiquent ni le nombre de tokens nécessaire à votre tâche, ni sa fréquence de réussite, ni la capacité d’un autre modèle à la résoudre avec moins de tentatives.
Dans le même témoignage Reddit, ayudha90 a comparé entre plusieurs modèles et niveaux d’effort une application de gestion de projet en pixel art. La personne a déclaré avoir utilisé 39 % d’un quota de cinq heures en environ 20 minutes avec Terra en modes high et max. Les différences de niveau d’effort, les préférences subjectives et le compteur d’abonnement ne permettent pas de tirer une conclusion nette sur le coût API. L’avertissement pratique reste utile : évaluez le résultat que vous acceptez, pas le tarif de token le plus bas.
Une métrique d’achat utile est :
coût par résultat accepté = dépenses totales pour toutes les tentatives / résultats acceptésUtilisez les mêmes entrées représentatives, définissez les critères d’acceptation avant le test et conservez aussi l’usage des tentatives infructueuses. Le guide des cas d’usage de recherche IA aide à distinguer une extraction circonscrite d’une longue mission de recherche ; elles nécessitent des budgets différents.
Autres frais et seuil de 272K
La fiche de Terra indique que les requêtes contenant plus de 272 000 tokens d’entrée sont facturées à 2× les tarifs d’entrée et de cache et à 1,5× le tarif de sortie. Cela concerne toute la requête, y compris ses premiers 272K tokens.
| Mode de traitement Terra | Contexte d’entrée | Entrée | Lecture en cache | Écriture 30m | Écriture 12h | Sortie |
|---|---|---|---|---|---|---|
| Standard | ≤272K | $1 | $0.05 | $1.25 | $2.50 | $5 |
| Standard | >272K | $2 | $0.10 | $2.50 | $5 | $7.50 |
| Batch / Flex | ≤272K | $0.50 | $0.025 | $0.625 | $1.25 | $2.50 |
| Batch / Flex | >272K | $1 | $0.05 | $1.25 | $2.50 | $3.75 |
| Fast | ≤272K | $2 | $0.10 | $2.50 | $5 | $10 |
| Fast | >272K | $4 | $0.20 | $5 | $10 | $15 |
À exactement 272K, utilisez la ligne de contexte court. À 272 001, la ligne de contexte long s’applique à l’ensemble. Par exemple, 300K d’entrée ordinaire et 10K de sortie coûtent $0.6 + $0.075 = $0.675 en Standard, hors frais supplémentaires. Il serait incorrect de facturer seulement les 28K supplémentaires au tarif supérieur.
Batch est asynchrone, tandis que Flex offre une disponibilité de traitement et une latence différentes. Vérifiez que Batch ou Flex convient à l’application avant de compter sur la réduction. La grille API actuelle ne liste pas Terra sous Ultrafast ; l’option Sol ou Astra ne constitue pas un tarif Terra.
Le traitement régional ajoute 10 % lorsqu’il est disponible. Les outils hébergés peuvent entraîner leurs propres frais. Par exemple, Web search est facturé 10 $ pour 1 000 appels, auxquels s’ajoutent les tokens de contenu de recherche au tarif du modèle. Les conteneurs et le stockage File search ont aussi des tarifs distincts. La grille citée ne précise aucune date d’expiration promotionnelle pour Terra ; la mention du 21 novembre concerne GPT-5.6 Sol, un autre modèle.
Quel niveau de la famille choisir ?
Voici les tarifs Standard actuels pour un contexte court dans le même tableau officiel ; il ne s’agit pas d’un classement de qualité.
| Modèle | Entrée | Lecture en cache | Écriture 30m | Écriture 12h | Sortie | Point de départ |
|---|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.25 | $0.50 | Tâches ciblées et répétables, après vérification de la qualité |
| GPT-6.1 Terra | $1 | $0.05 | $1.25 | $2.50 | $5 | Flux de travail visuels, documentaires et de contrôle de l’ordinateur |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $5 | $10 | Programmation plus exigeante et raisonnement prolongé |
| GPT-6 Astra | $10 | $1 | $12.50 | $25 | $50 | Tâches difficiles où les capacités supplémentaires justifient le coût |
Les tarifs d’entrée et de sortie de Terra sont dix fois ceux de Luna, mais les lectures en cache ne sont que cinq fois plus chères. La proportion en cache compte donc avant même les tests de qualité. Les guides de tarifs de Luna, de coût de Sol et de tarifs d’Astra couvrent des options voisines ; les anciens articles conservent leurs dates de vérification, utilisez donc le tableau officiel du jour pour les tarifs actuels.
Terra accepte les niveaux d’effort none, low, medium, high, xhigh et max ; medium est la valeur par défaut. Commencez à ce niveau pour une tâche représentative, réduisez l’effort si le résultat reste acceptable, et augmentez-le uniquement si le travail supplémentaire est utile. Les tokens de raisonnement sont facturés comme des tokens de sortie. Un tarif d’entrée plus bas ne compense pas indéfiniment un raisonnement plus long ou des tentatives répétées. (Guide du raisonnement)
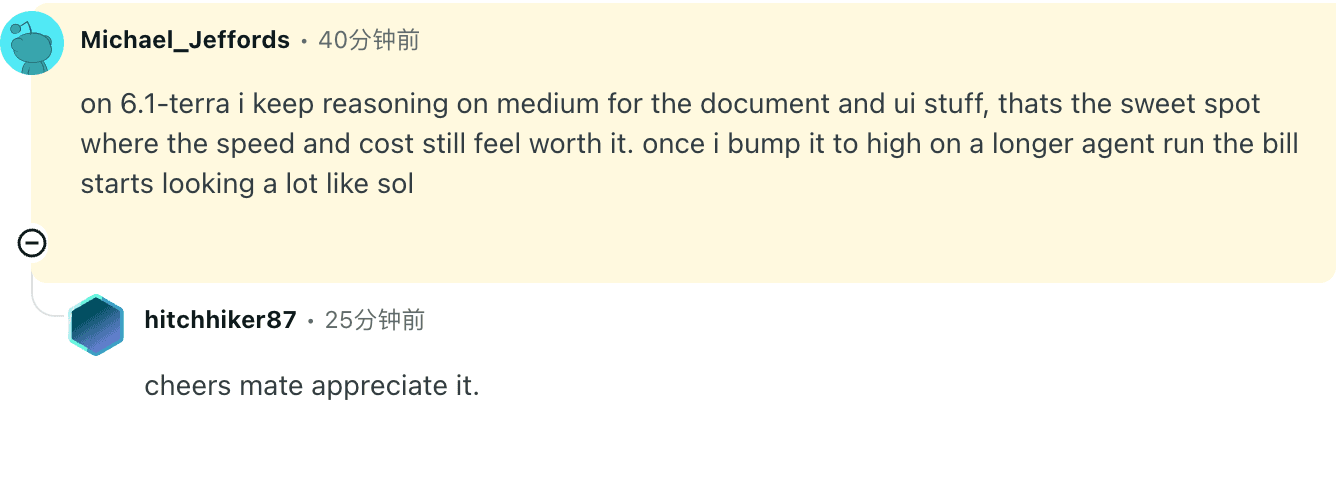
Michael_Jeffords explique garder Terra en mode medium pour les tâches sur des documents et interfaces, tandis que les longues sessions en mode high lui semblent se rapprocher du coût de Sol. Aucun reçu ni échantillon contrôlé n’accompagne ce commentaire. Considérez ce réglage comme une piste à tester.
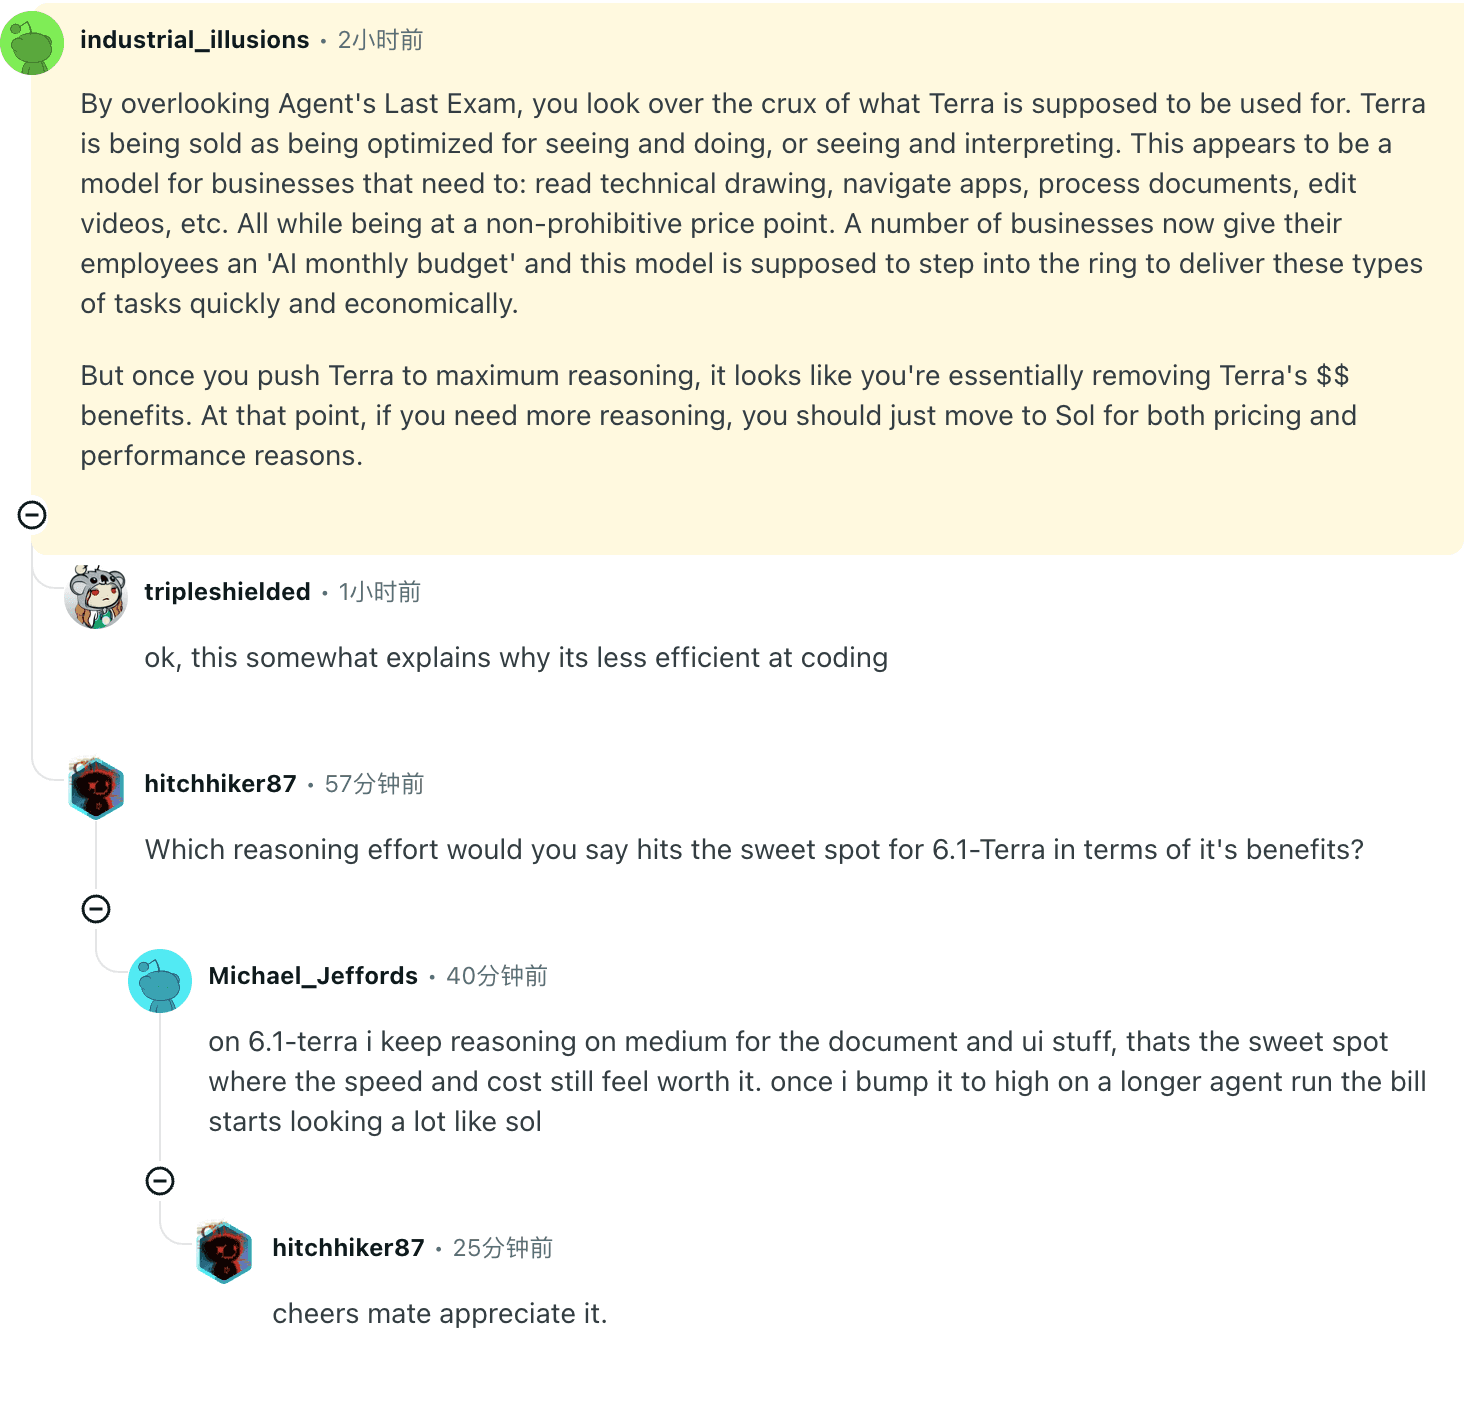
industrial_illusions avance un argument similaire pour traiter des documents et naviguer dans des applications à grande échelle, tout en questionnant l’intérêt du raisonnement maximal. Il s’agit d’un argument lié à une charge de travail, pas d’une validation indépendante des benchmarks d’OpenAI.
Pour la rédaction, la publication ToneBench de Louis-François Bouchard recommande un effort faible pour produire des premiers jets en série et s’interroge sur les gains d’un effort plus élevé dans cette évaluation. Sa conclusion repose sur une tâche d’écriture et un protocole de jugement particuliers ; ce n’est pas un classement général de la qualité.
Ce qui n’a pas de frais distincts et ce qui n’est pas gratuit
OpenAI n’ajoute pas de frais d’endpoint Responses API ou Chat Completions API aux coûts des tokens du modèle. Un effort accru n’est pas non plus présenté comme un supplément fixe ; son effet sur le coût passe par l’usage. Une lecture en cache n’entraîne pas aussi un frais d’écriture pour le même token au cours de la même requête.
Cela ne rend pas les tâches infructueuses gratuites. Le guide du raisonnement précise qu’une réponse incomplète peut consommer des tokens d’entrée et de raisonnement sans produire de réponse finale visible. Les pages citées ne garantissent ni gratuité des refus ni crédit automatique en cas d’échec. Consultez l’usage de la réponse et les relevés de facturation au lieu de supposer qu’une réponse inutilisable ne coûte rien.
Les estimations ci-dessous excluent les appels d’outils, les tokens de contenu de recherche pas encore comptabilisés, le stockage, les nouvelles tentatives, les taxes, les frais régionaux applicables et les marges du fournisseur. Les images suivent les règles de tokenisation du modèle ; compter les captures d’écran ne suffit pas à estimer les tokens.
Les abonnements ChatGPT et l’accès API sont des achats distincts
OpenAI indique que GPT-6.1 Terra est disponible dans ChatGPT Work et Codex avec Plus, Pro, Business, Enterprise et Edu, sous réserve des contrôles de l’espace de travail. Il n’est pas indiqué pour l’interface Chat standard. La fiche API ne répertorie pas de prise en charge du niveau gratuit. (Tarifs Work et Codex ; fiche Terra)
La page Work/Codex indique actuellement Plus à 20 $ par mois et Pro à partir de 100 $ par mois. Elle estime de 35 à 285 messages locaux Terra toutes les cinq heures pour Plus et Business Standard, mais précise qu’il ne s’agit pas d’une limite fixe garantie. Le choix du modèle, le contexte, le raisonnement et les outils font varier la consommation. Vérifiez les tarifs régionaux au moment de l’achat et le tableau de bord d’usage de votre compte.
Les crédits achetés ont leur propre grille tarifaire, et Codex ne leur applique pas de frais d’écriture de cache distincts comme ceux de l’API. L’usage par clé API suit la facturation API. Ni le prix de Plus ni un pourcentage d’usage inclus ne garantissent donc un nombre de tâches API.
Deux budgets reproductibles
Ce sont des exemples de calcul, pas des exécutions mesurées du modèle. Les deux utilisent les tarifs Standard pour contexte court et supposent 1 000 requêtes de 100K tokens d’entrée totale et 2K tokens de sortie totale chacune. La sortie inclut déjà le raisonnement.
| Répartition de l’entrée par requête | Entrée ordinaire | Lectures en cache | Écritures de cache 30m | Sortie | Par requête | 1 000 requêtes |
|---|---|---|---|---|---|---|
| Préfixe froid, première écriture | 20K | 0 | 80K | 2K | $0.130 | $130 |
| Préfixe chaud, lecture ultérieure | 20K | 80K | 0 | 2K | $0.034 | $34 |
Le calcul à froid est 0.02 × $1 + 0.08 × $1.25 + 0.002 × $5 = $0.13. À chaud, il est de 0.02 × $1 + 0.08 × $0.05 + 0.002 × $5 = $0.034. Les mêmes 100K tokens d’entrée sont répartis entre trois catégories exclusives ; on ne compte jamais 100K en entrée ordinaire auxquels s’ajouteraient 80K d’écriture.
Une première requête à froid suivie de 999 lectures à chaud coûte $0.13 + 999 × $0.034 = $34.096. Le calcul suppose le même préfixe admissible au cache, un cache conservé et aucune nouvelle tentative. La réécriture ou l’expiration du préfixe change la répartition. Une écriture à froid avec conservation de 12 heures coûte 0,23 $ ; cette conservation plus longue n’est avantageuse que si les lectures ultérieures justifient le coût.
Estimez votre budget de tokens localement
Indiquez l’entrée totale, la part lue dans le cache, les tokens écrits, la sortie avec raisonnement et le nombre de requêtes. Le calculateur soustrait les lectures et écritures de l’entrée totale, applique le seuil de contexte à toute la requête et compare Terra, Sol et Luna pour les mêmes volumes de tokens. Un volume identique ne signifie pas une qualité ou un taux de réussite identique.
Calcul local
Comparer les coûts API de Terra, Sol et Luna
Tarifs API officiels en USD vérifiés le 27/10/2026. Les valeurs et le calcul restent dans ce navigateur.
Hors outils, nouvelles tentatives, taxes, traitement régional et frais du fournisseur ou de l’application. Les tokens de raisonnement sont inclus dans les tokens de sortie. Les crédits d’abonnement et l’usage de ChatGPT ne sont pas estimés. Voir les tarifs API officiels
Les valeurs de calcul restent dans votre navigateur. La page enregistre un événement générique de modification du calculateur sans inclure les valeurs saisies. Elle ne les envoie ni à un modèle ni à un service de tarification. Les résultats excluent les autres frais indiqués plus haut et utilisent le tarif du 27 octobre.
Vérifiez le sélecteur Tabbit avant de choisir un client
Si votre travail porte sur des pages web et des documents, le flux de travail Tabbit Browser peut être pertinent une fois le modèle choisi. Les tarifs d’un modèle et la disponibilité d’un client sont deux éléments distincts de la décision.
La vérification réelle a été effectuée le 27 octobre 2026 dans Tabbit, sur web.tabbit.ai/newtab. Le sélecteur chargé contenait 16 options, dont Kimi-K3.1-Pro et Claude-Sonnet-5.5, mais pas GPT-6.1 Terra. L’échantillon se limite à un compte international ; aucune inférence Terra n’a été envoyée, aucune réponse Terra marquée par un outil n’a été observée et aucun coût ni délai n’a été mesuré. Le test prévu portait sur l’extraction d’un tableau dont la réponse était connue ; l’absence du modèle l’a empêché.
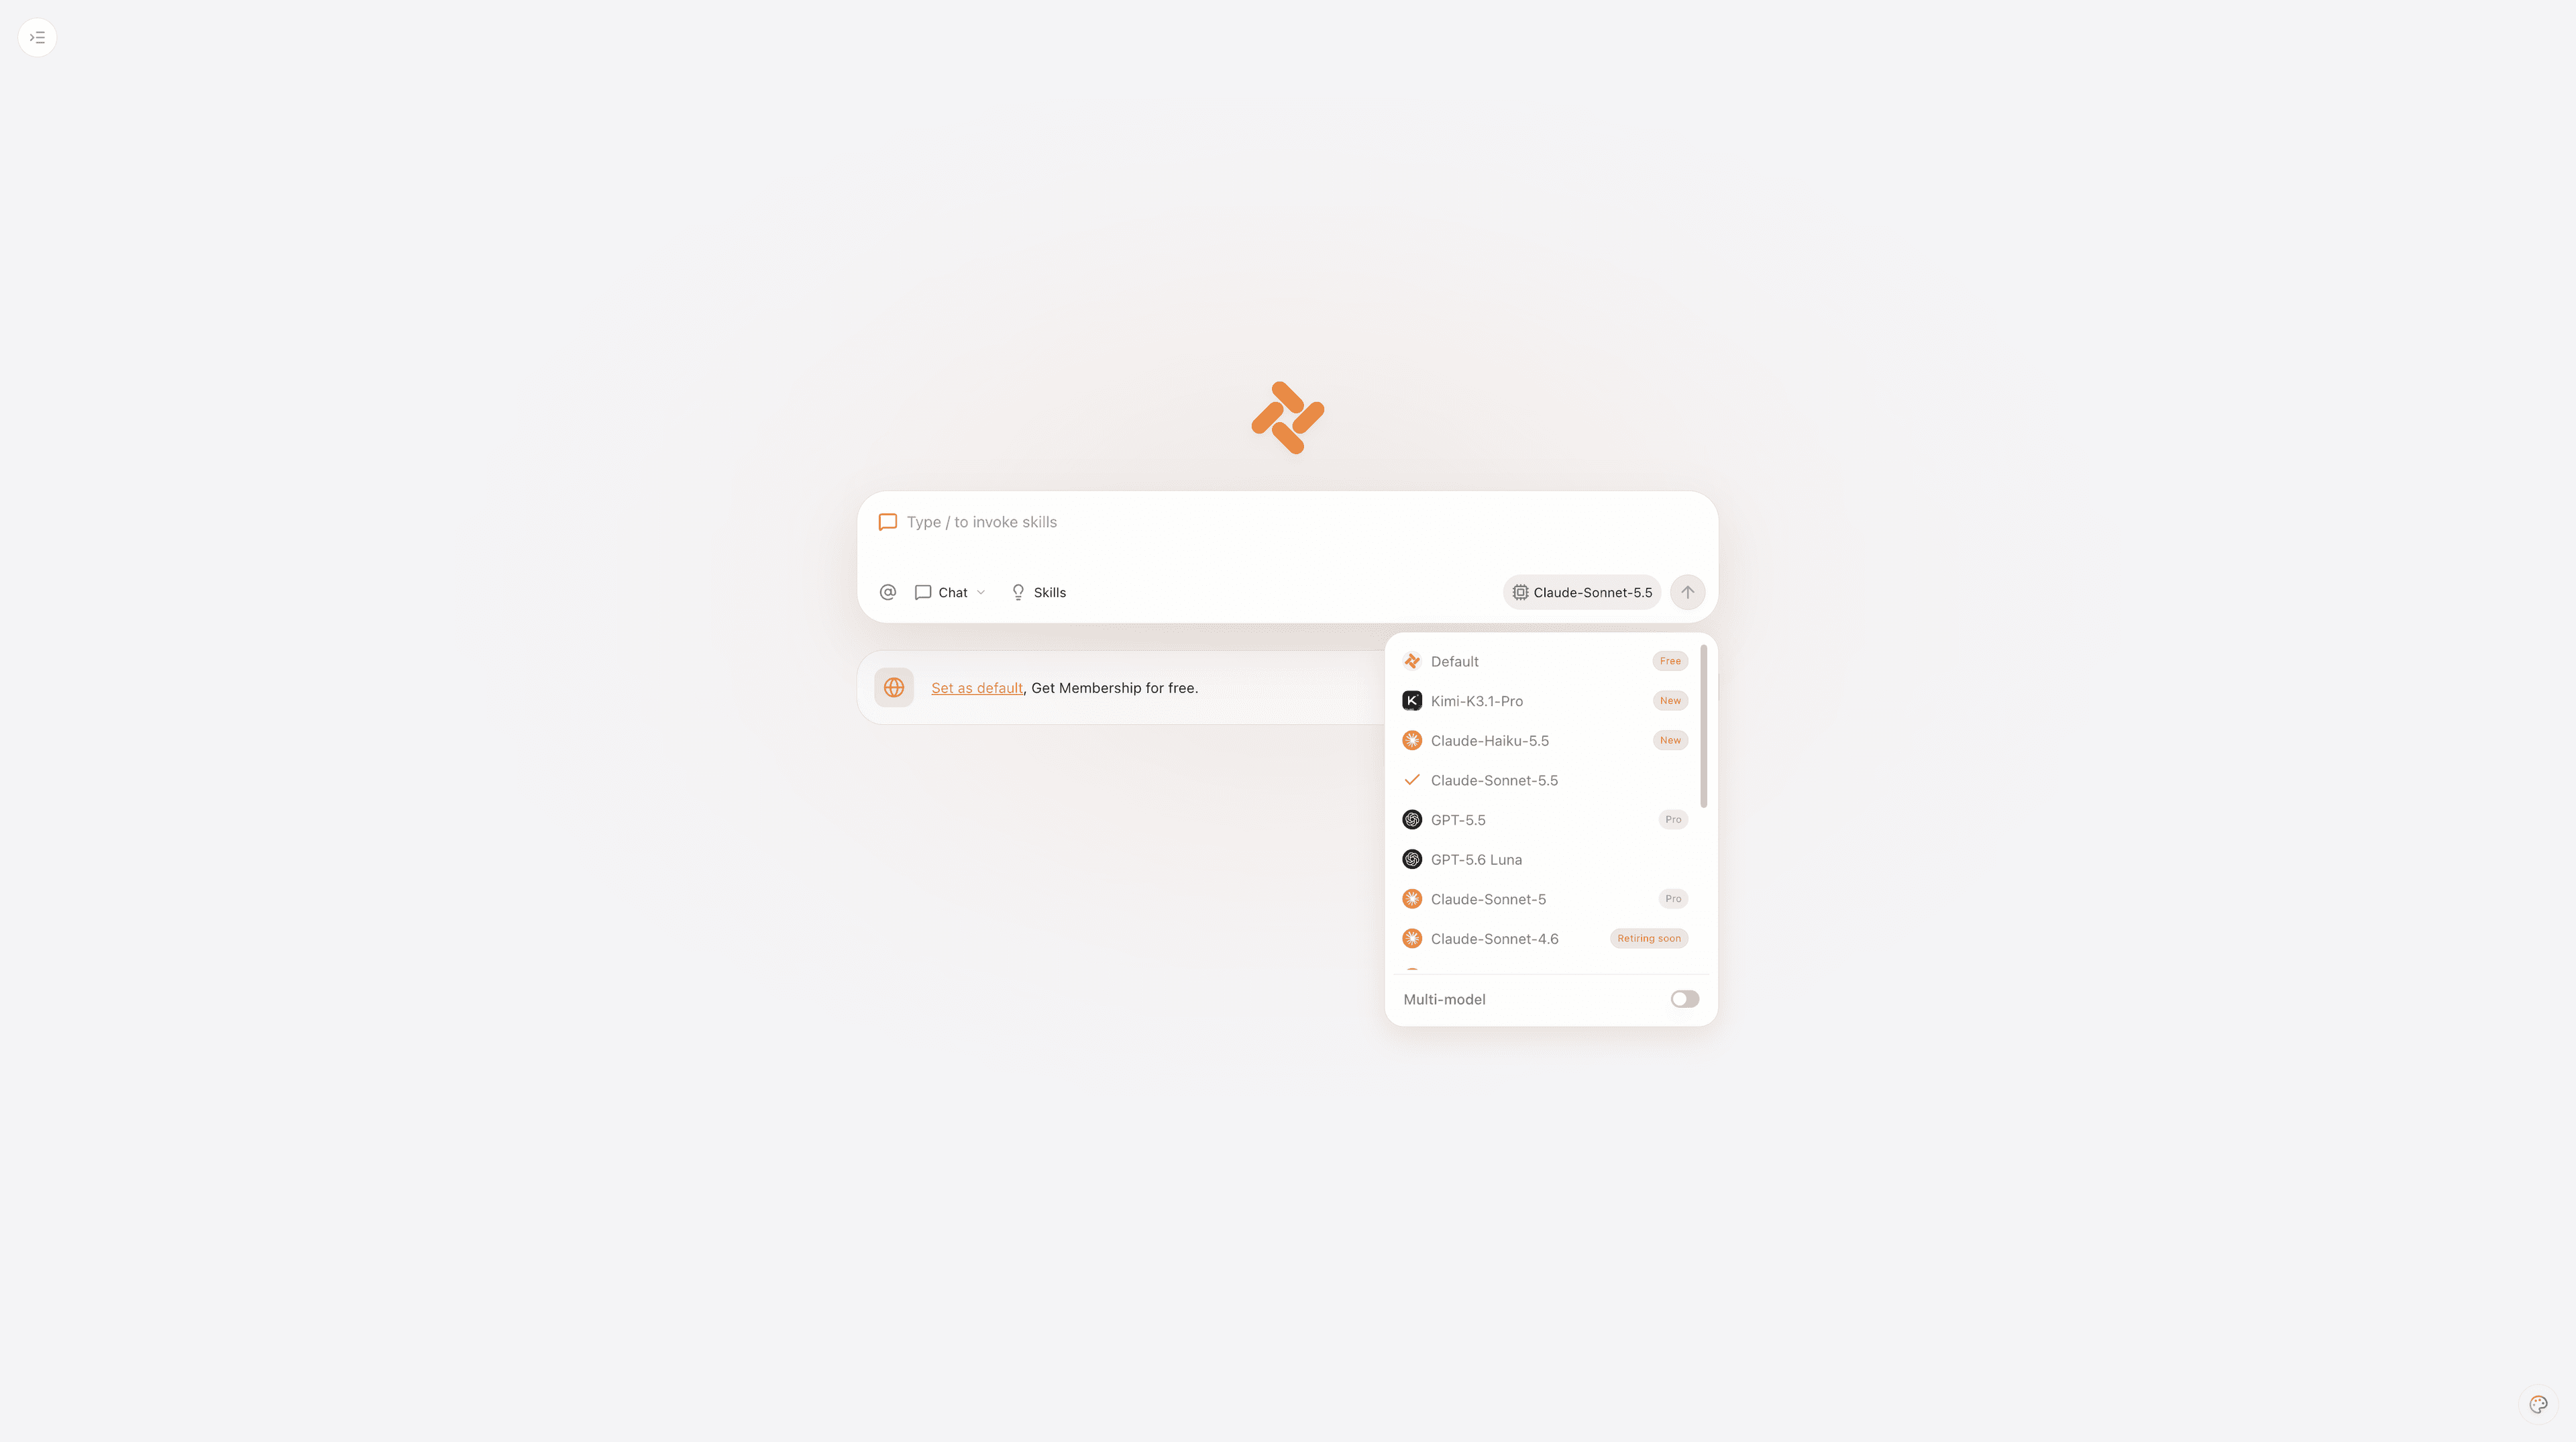
Si Terra apparaît plus tard dans votre compte, utilisez le même tableau de référence et la même réponse attendue pour tous les modèles, notez le nom affiché, les indicateurs d’outils et le résultat, puis vérifiez l’abonnement client actuel. D’ici là, choisissez un client dont l’accès à Terra est confirmé. Le guide de bonnes pratiques Tabbit et l’explication du navigateur agentique décrivent des flux de travail navigateur, sans prouver la disponibilité de Terra.
Verdict : choisissez l’adéquation à la tâche, puis le tarif
| Votre contrainte | Prochaine étape raisonnable | Points à vérifier |
|---|---|---|
| Tâches visuelles ou documentaires répétées | Tester Terra en mode medium, puis réduire l’effort | Résultats acceptés, sortie de raisonnement et accès au cache |
| Premiers jets en série avec relecture humaine | Comparer Terra à faible effort avec des alternatives | Ton, temps de révision et coût total de la tâche |
| Raisonnement prolongé ou programmation exigeante | Comparer Sol avec un niveau d’effort adapté | Si la réduction des tokens ou des tentatives compense les tarifs |
| Traitement hors ligne | Évaluer Batch ou Flex | Comportement du service et délai d’achèvement |
| Entrée proche de 272K | Réduire le contexte ou prévoir la ligne longue | Toute l’entrée, y compris les tokens lus et écrits en cache |
| Abonnement Work/Codex | Comparer le quota réel et les crédits | Tableau de bord du compte, pas uniquement le tarif API |
La grille de Terra à 1 $/5 $ est un prix de départ utile pour les tâches visuelles et documentaires. La réduction de 95 % sur les lectures n’est utile que si les requêtes réutilisent réellement une entrée en cache ; le niveau d’effort et la réussite de la tâche déterminent si le travail complet est économique. Testez votre charge de travail, consultez l’usage, puis choisissez l’abonnement ou le niveau de service API.
Pour les tâches dans le navigateur, vérifiez l’accès actuel à Tabbit avant de compter sur un modèle précis. Télécharger le client ne donne pas accès à GPT-6.1 Terra et ne remplace pas les règles de facturation d’OpenAI.
 Tabbit Browser

Questions fréquentes
Combien coûte GPT-6.1 Terra par million de tokens ?
Vérifiés le 27 octobre 2026, les tarifs API Standard jusqu’à 272 000 tokens d’entrée sont de 1 $ par million de tokens d’entrée non mis en cache, 0,05 $ pour l’entrée en cache et 5 $ pour les tokens de sortie. L’écriture dans le cache coûte 1,25 $ pour une conservation de 30 minutes ou 2,50 $ pour 12 heures. Chaque token d’entrée relève d’une seule catégorie de facturation : l’écriture ne s’ajoute donc pas au tarif d’entrée normal pour ces mêmes tokens.
GPT-6.1 Terra est-il moins cher que GPT-5.6 Terra ?
Les tarifs Standard actuels pour un contexte court passent de 2 $ à 1 $ pour l’entrée, de 12 $ à 5 $ pour la sortie et de 0,20 $ à 0,05 $ par million de tokens lus depuis le cache. Les baisses sont respectivement de 50 %, environ 58,3 % et 75 %. Le coût de votre tâche dépend aussi des tokens de raisonnement générés, des accès au cache, des nouvelles tentatives et de la qualité de sortie que vous acceptez.
GPT-6.1 Terra applique-t-il un supplément pour le contexte long ?
Oui. Au-delà de 272 000 tokens d’entrée, toute la requête est facturée aux tarifs de contexte long : les tarifs d’entrée et de cache doublent, tandis que la sortie coûte 1,5 fois plus. À exactement 272 000 tokens d’entrée, le tarif de contexte court s’applique encore.
Les tokens de raisonnement et les refus sont-ils gratuits ?
Les tokens de raisonnement sont facturés comme des tokens de sortie, même si aucune réponse finale n’est visible. Les pages officielles citées ne garantissent pas que les refus soient gratuits. Consultez l’usage de la réponse et la facturation au lieu de supposer qu’un résultat inutilisable ne coûte rien.
Puis-je utiliser GPT-6.1 Terra avec un abonnement ChatGPT ?
OpenAI indique que Terra est disponible dans ChatGPT Work et Codex avec les abonnements Plus, Pro, Business, Enterprise et Edu, sous réserve des droits d’accès et des contrôles de l’espace de travail. Il n’est pas indiqué pour l’interface Chat standard. L’usage inclus et les crédits achetés sont distincts de la facturation par clé API.
GPT-6.1 Terra est-il disponible dans Tabbit Browser ?
Le compte international Tabbit inspecté le 27 octobre 2026 ne proposait pas GPT-6.1 Terra parmi ses 16 modèles chargés. Cet article ne prétend donc ni avoir testé une inférence Terra dans Tabbit ni garantir l’accès au modèle. Vérifiez votre sélecteur et votre abonnement actuels avant de choisir un client pour ce modèle.