
GPT-6.1 Terra cuesta $1 por millón de tokens de entrada, $0,05 por millón de tokens de entrada en caché y $5 por millón de tokens de salida según la tarifa Standard de la API de OpenAI para contexto corto, comprobada el 27 de octubre de 2026. Las escrituras en caché son categorías de facturación independientes: $1,25 por 30 minutos o $2,50 por 12 horas. Son precios de API, no de una suscripción a ChatGPT o Tabbit. (Precios de OpenAI)
La cifra que conviene vigilar es 95%: una lectura desde la caché cuesta un 95% menos que la entrada normal. Esto puede importar más que el precio de entrada destacado cuando un agente vuelve a leer las mismas instrucciones y documentos. Aun así, no garantiza que una tarea completada salga más barata. En un comentario de Reddit del día del lanzamiento, ayudha90 contó que consumió más de su cuota de suscripción y prefirió menos el resultado después de subir el nivel de esfuerzo de Terra. Es la experiencia de una persona, no una factura de API ni una comparación controlada.
A continuación encontrarás la tarifa vigente, las condiciones de los descuentos, dos presupuestos reproducibles y una calculadora local. La sección de Tabbit Browser comprueba el selector de modelos antes de sugerir un flujo de trabajo con un cliente.
Precios de la API de GPT-6.1 Terra de un vistazo
Precios en USD por millón de tokens, verificados el 27 de octubre de 2026. Ambas columnas corresponden al procesamiento Standard sin recargo regional. La columna del modelo anterior procede de la ficha actual de GPT-5.6 Terra y de la tabla de precios, no de una cifra histórica supuesta.
| Categoría de facturación, contexto corto | GPT-5.6 Terra | GPT-6.1 Terra | Cambio |
|---|---|---|---|
| Entrada sin caché | $2.00 | $1.00 | −50% |
| Lectura de entrada en caché | $0.20 | $0.05 | −75% |
| Escritura en caché, 30 minutos | $2.50 | $1.25 | −50% |
| Escritura en caché, 12 horas | $5.00 | $2.50 | −50% |
| Salida, incluido el razonamiento | $12.00 | $5.00 | aproximadamente −58.3% |
Este artículo trata de GPT-6.1 Terra, ID de API gpt-6.1-terra, un modelo que recibe texto e imágenes y genera texto. OpenAI lo orienta al razonamiento visual, el uso del ordenador y la escritura. Su ventana de contexto de 1.050.000 tokens es una especificación de capacidad; el tramo de precio más bajo termina mucho antes. La descripción general de Terra anterior ofrece contexto sobre el predecesor; las especificaciones actuales se rigen por la ficha vigente del modelo.
Conclusiones clave
La lectura de entrada en caché cuesta $0,05 por millón de tokens, el 5% de la tarifa normal de entrada de Terra, que es $1. Las escrituras en caché cuestan más y deben presupuestarse aparte.
La entrada, las lecturas desde caché y las escrituras en caché son categorías de tokens mutuamente excluyentes. Sumar una tarifa de escritura a la entrada normal de los mismos tokens exagera la factura.
Por encima de 272K tokens de entrada, se aplican tarifas más altas a toda la solicitud. Que quepa más contexto en memoria no mantiene el precio del tramo corto.
Batch y Flex reducen a la mitad las tarifas Standard correspondientes; Fast las duplica. Cada modo tiene sus propias condiciones, así que elige el procesamiento antes de estimar el coste.
Compara el coste por resultado aceptado con un nivel de esfuerzo adecuado. El gasto en dólares de la API, la cuota de suscripción y el acceso desde un cliente responden a preguntas distintas.
El descuento del 95% solo se aplica a las lecturas de caché
A $0,05, la tarifa de lectura de Terra equivale a una vigésima parte de la entrada sin caché. Frente a la tarifa de lectura en caché de $0,20 de GPT-5.6 Terra, es un 75% menor. Los porcentajes tienen denominadores distintos. Ninguno significa que toda la factura baje un 95% o un 75%.
Un prefijo que se repite puede incluir instrucciones, herramientas y contexto documental estable. Para reutilizar la caché hacen falta prefijos coincidentes y al menos 1.024 tokens en estos modelos. Si cambia el prefijo o no se cumple el periodo de retención, un acierto previsto puede convertirse en una escritura o en entrada normal. Conviene medir el uso que devuelve la API, no suponer que cada solicitud repetida encuentra la caché. La guía de prompt caching explica las reglas de coincidencia y retención.
Para los tokens de entrada que no se están escribiendo en caché, una tasa de aciertos h da este coste de entrada por millón de tokens de entrada total en contexto corto:
coste de entrada = (1 − h) × $1 + h × $0.05
h = 80% → coste de entrada = $0.24
Los $0,24 no incluyen la salida ni las escrituras en caché. La primera solicitud que crea un prefijo no es igual que una posterior que lo lee. Esto importa en los ciclos de investigación de agentes, donde el contexto repetido puede representar gran parte del volumen de entrada.
Convierte el ahorro anunciado en un presupuesto por tarea
La comparación de tarifas es favorable: la entrada se reduce a la mitad, la salida baja aproximadamente un 58,3% y las lecturas caen un 75% respecto al predecesor que aparece actualmente en la tabla. Las tablas oficiales confirman esas diferencias. No indican cuántos tokens necesitará tu tarea, con qué frecuencia tendrá éxito ni si otro modelo la resolverá con menos intentos.
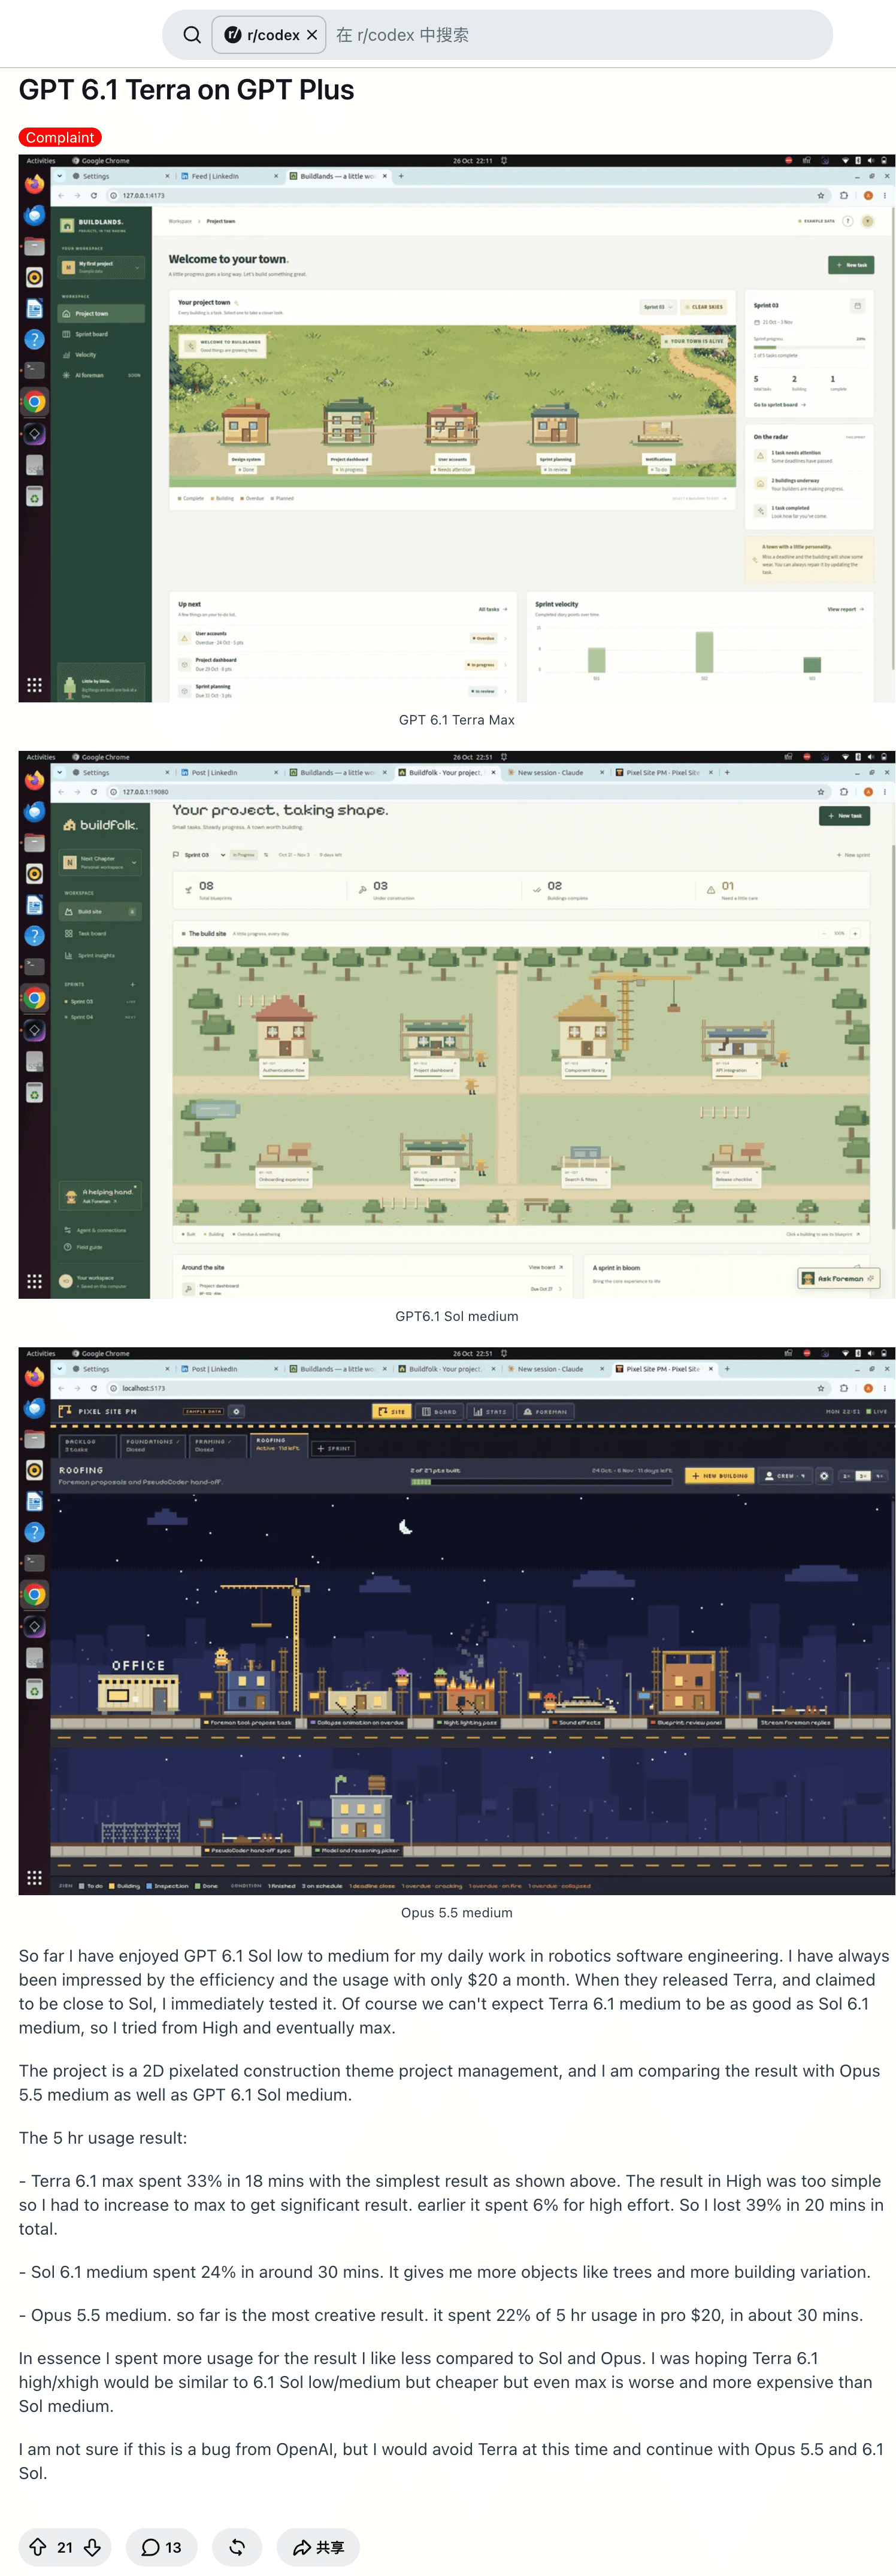
En el mismo comentario de Reddit, ayudha90 comparó entre modelos y niveles de esfuerzo una aplicación de gestión de proyectos con arte pixelado. Dijo haber consumido el 39% de una cuota de cinco horas en unos 20 minutos usando Terra en los niveles alto y máximo. La diferencia entre niveles de esfuerzo, las preferencias subjetivas por el resultado y la medición de una suscripción impiden sacar una conclusión clara sobre el coste de la API. La advertencia práctica sigue siendo útil: comprueba qué resultado aceptas, no solo la tarifa de tokens más baja.
Una métrica útil para comprar es:
coste por resultado aceptado = gasto total en intentos / resultados aceptadosEjecuta las mismas entradas representativas, define de antemano qué resultado es aceptable e incluye también el uso de los intentos fallidos. La guía de casos de uso de investigación con IA ayuda a diferenciar una tarea acotada de extracción de un encargo de investigación extenso; requieren presupuestos distintos.
Otros conceptos y el límite de 272K
La ficha de Terra establece que las solicitudes con más de 272.000 tokens de entrada se cobran a 2× las tarifas de entrada y caché y a 1,5× la tarifa de salida. Se aplica a toda la solicitud, incluidos los primeros 272K tokens.
| Modo de procesamiento de Terra | Contexto de entrada | Entrada | Lectura en caché | Escritura 30m | Escritura 12h | Salida |
|---|---|---|---|---|---|---|
| Standard | ≤272K | $1 | $0.05 | $1.25 | $2.50 | $5 |
| Standard | >272K | $2 | $0.10 | $2.50 | $5 | $7.50 |
| Batch / Flex | ≤272K | $0.50 | $0.025 | $0.625 | $1.25 | $2.50 |
| Batch / Flex | >272K | $1 | $0.05 | $1.25 | $2.50 | $3.75 |
| Fast | ≤272K | $2 | $0.10 | $2.50 | $5 | $10 |
| Fast | >272K | $4 | $0.20 | $5 | $10 | $15 |
Con exactamente 272K se usa la fila de contexto corto. Con 272.001, la fila larga se aplica a todo. Por ejemplo, 300K de entrada normal y 10K de salida cuestan $0.6 + $0.075 = $0.675 con Standard, antes de otros cargos. Sería incorrecto cobrar solo los 28K adicionales a la tarifa superior.
Batch es asíncrono, y Flex ofrece distinta disponibilidad de procesamiento y latencia. Comprueba que Batch o Flex encaje con la aplicación antes de contar con el descuento. La tabla de API actual no incluye Terra en Ultrafast; la opción de Sol o Astra no es una tarifa de Terra.
El procesamiento regional añade un 10% cuando está disponible. Las herramientas alojadas pueden generar otros cargos. Por ejemplo, Web search cuesta $10 por cada 1.000 llamadas más los tokens del contenido de búsqueda, cobrados a las tarifas del modelo. Los contenedores y el almacenamiento de File search también tienen conceptos separados. La tarifa citada no especifica el fin de ninguna promoción de Terra; la nota promocional del 21 de noviembre corresponde a GPT-5.6 Sol, otro modelo.
¿Qué nivel de la familia encaja con el trabajo?
Estas son las tarifas actuales Standard para contexto corto de la misma tabla oficial; no constituyen una clasificación de calidad.
| Modelo | Entrada | Lectura en caché | Escritura 30m | Escritura 12h | Salida | Punto de partida |
|---|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.25 | $0.50 | Tareas acotadas y repetibles, después de revisar la calidad |
| GPT-6.1 Terra | $1 | $0.05 | $1.25 | $2.50 | $5 | Flujos de trabajo visuales, documentales y de uso del ordenador |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $5 | $10 | Programación más exigente y razonamiento prolongado |
| GPT-6 Astra | $10 | $1 | $12.50 | $25 | $50 | Tareas difíciles donde la capacidad adicional compensa el coste |
La entrada y la salida de Terra cuestan diez veces lo de Luna, pero sus lecturas en caché solo cinco veces más. Por eso la proporción de caché importa incluso antes de evaluar la calidad. Las guías de precios de Luna, costes de Sol y precios de Astra cubren opciones cercanas; los artículos anteriores conservan sus propias fechas de verificación, así que usa la tabla oficial de hoy para los precios vigentes.
Terra admite los niveles de esfuerzo none, low, medium, high, xhigh y max; medium es el valor predeterminado. Empieza ahí con una tarea representativa, baja el nivel si el resultado sigue siendo aceptable y súbelo solo si el trabajo adicional ayuda. El razonamiento se cobra como salida. Una tarifa de entrada más baja no compensa de forma indefinida un razonamiento más largo o más reintentos. (Guía de razonamiento)
Michael_Jeffords cuenta que mantiene Terra en nivel medio para trabajar con documentos e interfaces, mientras que las sesiones largas con mucho esfuerzo le parecen más cercanas al coste de Sol. El comentario no incluye factura ni muestra controlada. Tómalo como un nivel que merece la pena probar.
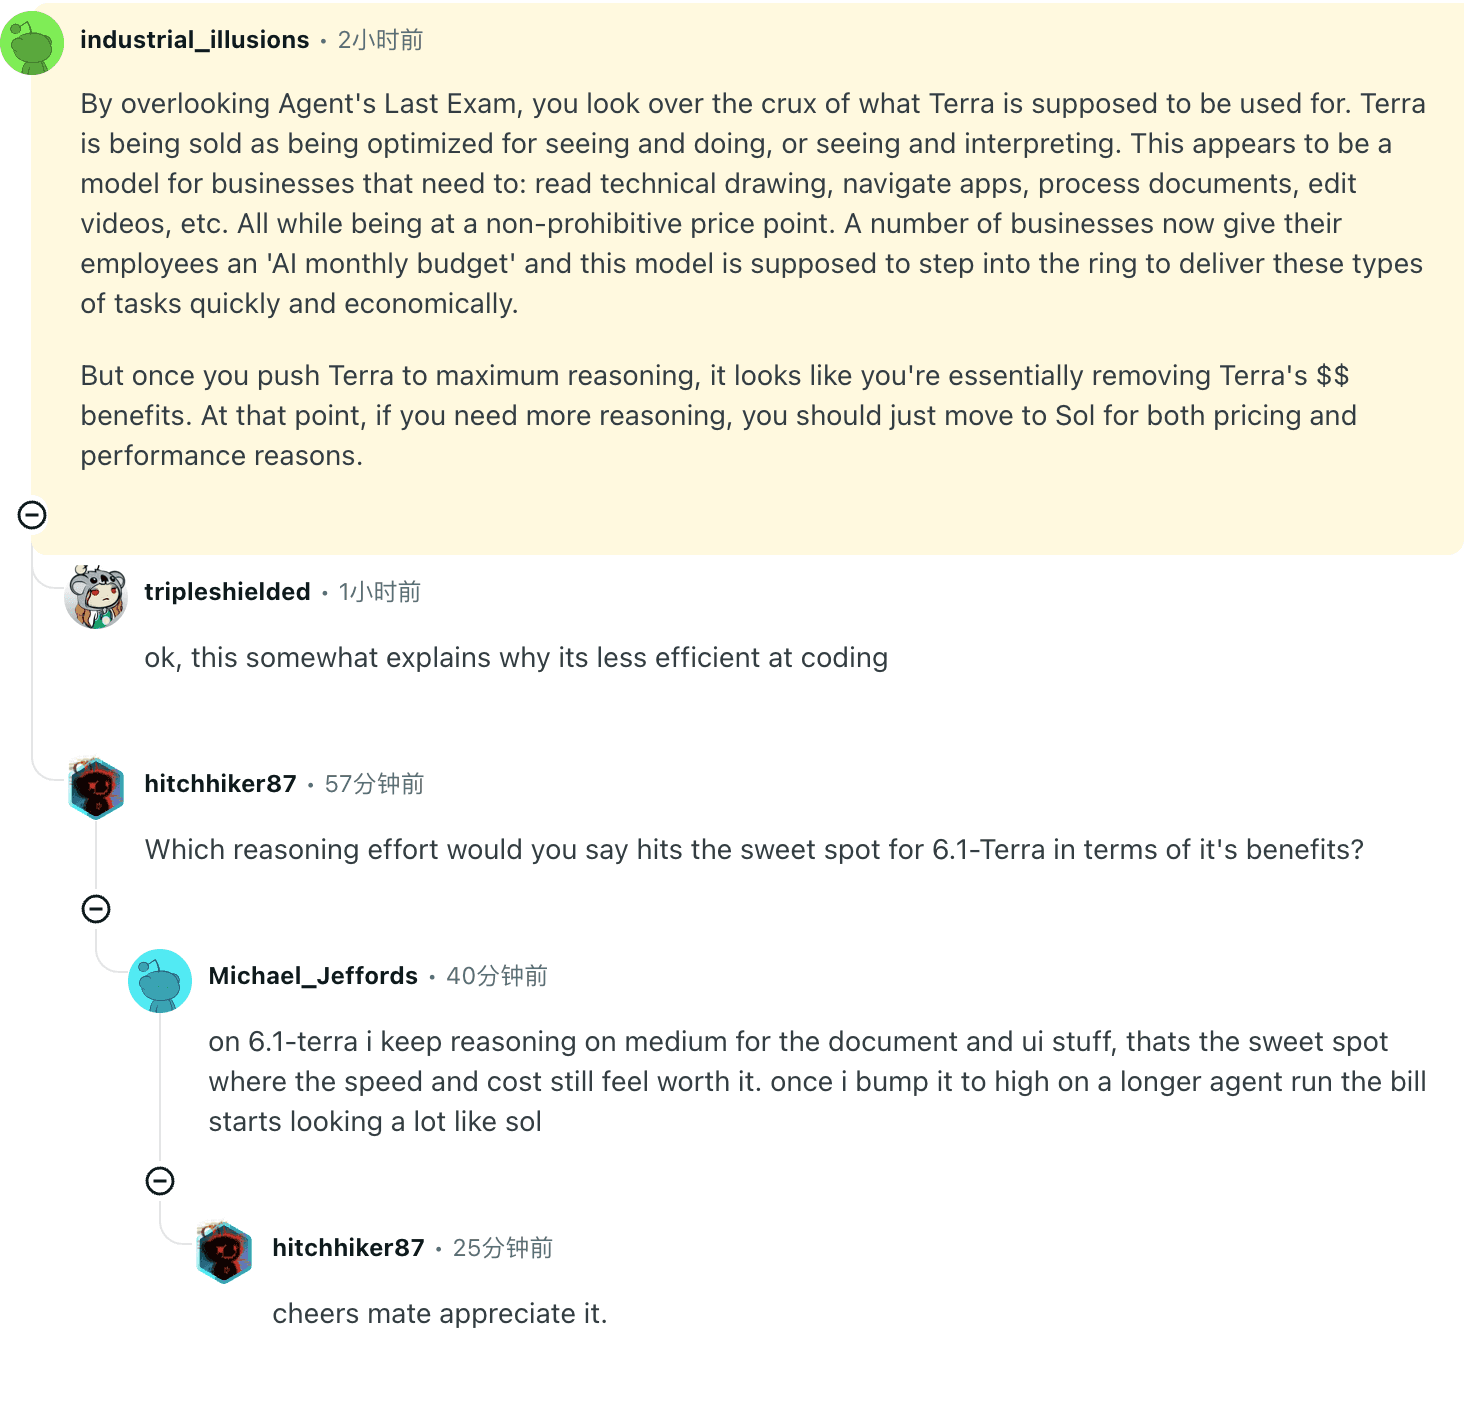
industrial_illusions presenta un argumento relacionado para procesar documentos y navegar aplicaciones a escala, y cuestiona el beneficio del razonamiento máximo. Es un argumento sobre cargas de trabajo, no una validación independiente de las pruebas de OpenAI.
En escritura, la publicación de Louis-François Bouchard en ToneBench favorece los borradores masivos con esfuerzo bajo y cuestiona las mejoras de esfuerzo más alto en esa evaluación. Su conclusión depende de una tarea de escritura y un método de valoración concretos; no es una clasificación universal de calidad.
Qué no tiene una tarifa separada y qué no es gratis
OpenAI no añade una tarifa independiente por usar los endpoints Responses API o Chat Completions API a estos cargos por tokens del modelo. Tampoco indica un recargo fijo por aumentar el nivel de esfuerzo: su efecto en el coste viene del uso. Una lectura de caché no lleva además un cargo de escritura por ese mismo token en la misma solicitud.
Eso no significa que el trabajo fallido sea gratis. La guía de razonamiento dice que una respuesta incompleta puede consumir tokens de entrada y de razonamiento sin producir una respuesta final visible. Las páginas citadas no prometen una exención de pago por rechazo ni un crédito automático por una respuesta fallida. Consulta el uso de la respuesta y los registros de facturación; que no haya una respuesta útil no implica que no haya cargos.
Las estimaciones siguientes excluyen llamadas a herramientas, tokens de búsqueda que aún no estén contabilizados, almacenamiento, reintentos, impuestos, cargos regionales aplicables y márgenes del proveedor. Las imágenes siguen las reglas de tokenización del modelo; contar capturas de pantalla no basta para estimar tokens.
Los planes de ChatGPT y el acceso a la API son compras distintas
OpenAI ofrece GPT-6.1 Terra en ChatGPT Work y Codex para Plus, Pro, Business, Enterprise y Edu, sujeto a los controles del espacio de trabajo. No aparece para la interfaz normal de Chat. La ficha de la API no incluye soporte para el plan gratuito. (Precios de Work y Codex; ficha de Terra)
La página de Work/Codex muestra Plus a $20 al mes y Pro desde $100 al mes. Estima entre 35 y 285 mensajes locales de Terra cada cinco horas para Plus y Business Standard, pero aclara que no es un límite fijo garantizado. El modelo, el contexto, el razonamiento y las herramientas cambian el consumo. Antes de comprar, consulta el precio regional actual y el panel de uso de tu cuenta.
Los créditos comprados tienen su propia tarifa, y Codex no aplica a esos créditos un cargo de escritura de caché separado como el de la API. El uso con clave de API sigue la facturación de API. Por tanto, ni el precio de Plus ni un porcentaje de uso incluido se pueden convertir en una cantidad garantizada de tareas de API.
Dos presupuestos que puedes reproducir
Son ejemplos aritméticos, no ejecuciones medidas del modelo. Ambos usan precios Standard para contexto corto y suponen 1.000 solicitudes, cada una con 100K de entrada total y 2K de salida total. La salida ya incluye los tokens de razonamiento.
| Mezcla de entrada por solicitud | Entrada normal | Lecturas en caché | Escrituras en caché de 30m | Salida | Por solicitud | 1.000 solicitudes |
|---|---|---|---|---|---|---|
| Prefijo frío, primera escritura | 20K | 0 | 80K | 2K | $0.130 | $130 |
| Prefijo caliente, lectura posterior | 20K | 80K | 0 | 2K | $0.034 | $34 |
El cálculo en frío es 0.02 × $1 + 0.08 × $1.25 + 0.002 × $5 = $0.13. En caliente es 0.02 × $1 + 0.08 × $0.05 + 0.002 × $5 = $0.034. Los mismos 100K de entrada se distribuyen en tres categorías excluyentes; nunca se cuentan 100K como entrada normal y además otros 80K como escritura.
Una solicitud inicial en frío seguida de 999 lecturas en caliente cuesta $0.13 + 999 × $0.034 = $34.096. El cálculo supone el mismo prefijo susceptible de caché, caché retenida y ningún reintento. Si se vuelve a escribir el prefijo o caduca, cambia la mezcla. Una escritura en frío con retención de 12 horas cuesta $0.23; esa retención más larga solo compensa si las lecturas posteriores justifican el coste.
Estima tu presupuesto de tokens en local
Indica la entrada total, la proporción leída desde la caché, los tokens escritos en caché, la salida (incluido el razonamiento) y el número de solicitudes. La calculadora resta las lecturas y escrituras de la entrada total, aplica el límite de contexto a toda la solicitud y compara Terra, Sol y Luna con los mismos volúmenes de tokens. El mismo volumen no implica igual calidad ni igual éxito en la tarea.
Calculadora local
Compara los costes API de Terra, Sol y Luna
Tarifas oficiales de la API en USD verificadas el 27-10-2026. Los valores y el cálculo permanecen en este navegador.
No incluye herramientas, reintentos, impuestos, procesamiento regional ni tarifas del proveedor o la aplicación. Los tokens de razonamiento ya están incluidos en los tokens de salida. No estima créditos de suscripción ni uso de ChatGPT. Ver tarifas oficiales de la API
Los valores de cálculo permanecen en tu navegador. La página registra un evento genérico de cambio en la calculadora sin incluir los valores introducidos. No los envía a un modelo ni a un servicio de precios. Los resultados excluyen los otros cargos indicados arriba y usan la tarifa del 27 de octubre.
Comprueba el selector de Tabbit antes de elegir un cliente
Si trabajas con páginas web y documentos, el flujo de trabajo de Tabbit Browser puede ser relevante una vez que hayas decidido qué modelo necesitas. Las tarifas del modelo y disponer de un cliente que lo admita son partes distintas de esa decisión.
La comprobación real se hizo el 27 de octubre de 2026 en web.tabbit.ai/newtab, dentro de Tabbit. El selector cargado mostraba 16 opciones, incluidas Kimi-K3.1-Pro y Claude-Sonnet-5.5, y no incluía GPT-6.1 Terra. La muestra fue una cuenta internacional; no se envió ninguna inferencia a Terra, no se observó una respuesta de Terra con herramientas y no se midieron coste ni velocidad. La prueba prevista era extraer datos en una tabla con respuesta conocida; la falta del modelo lo impidió.
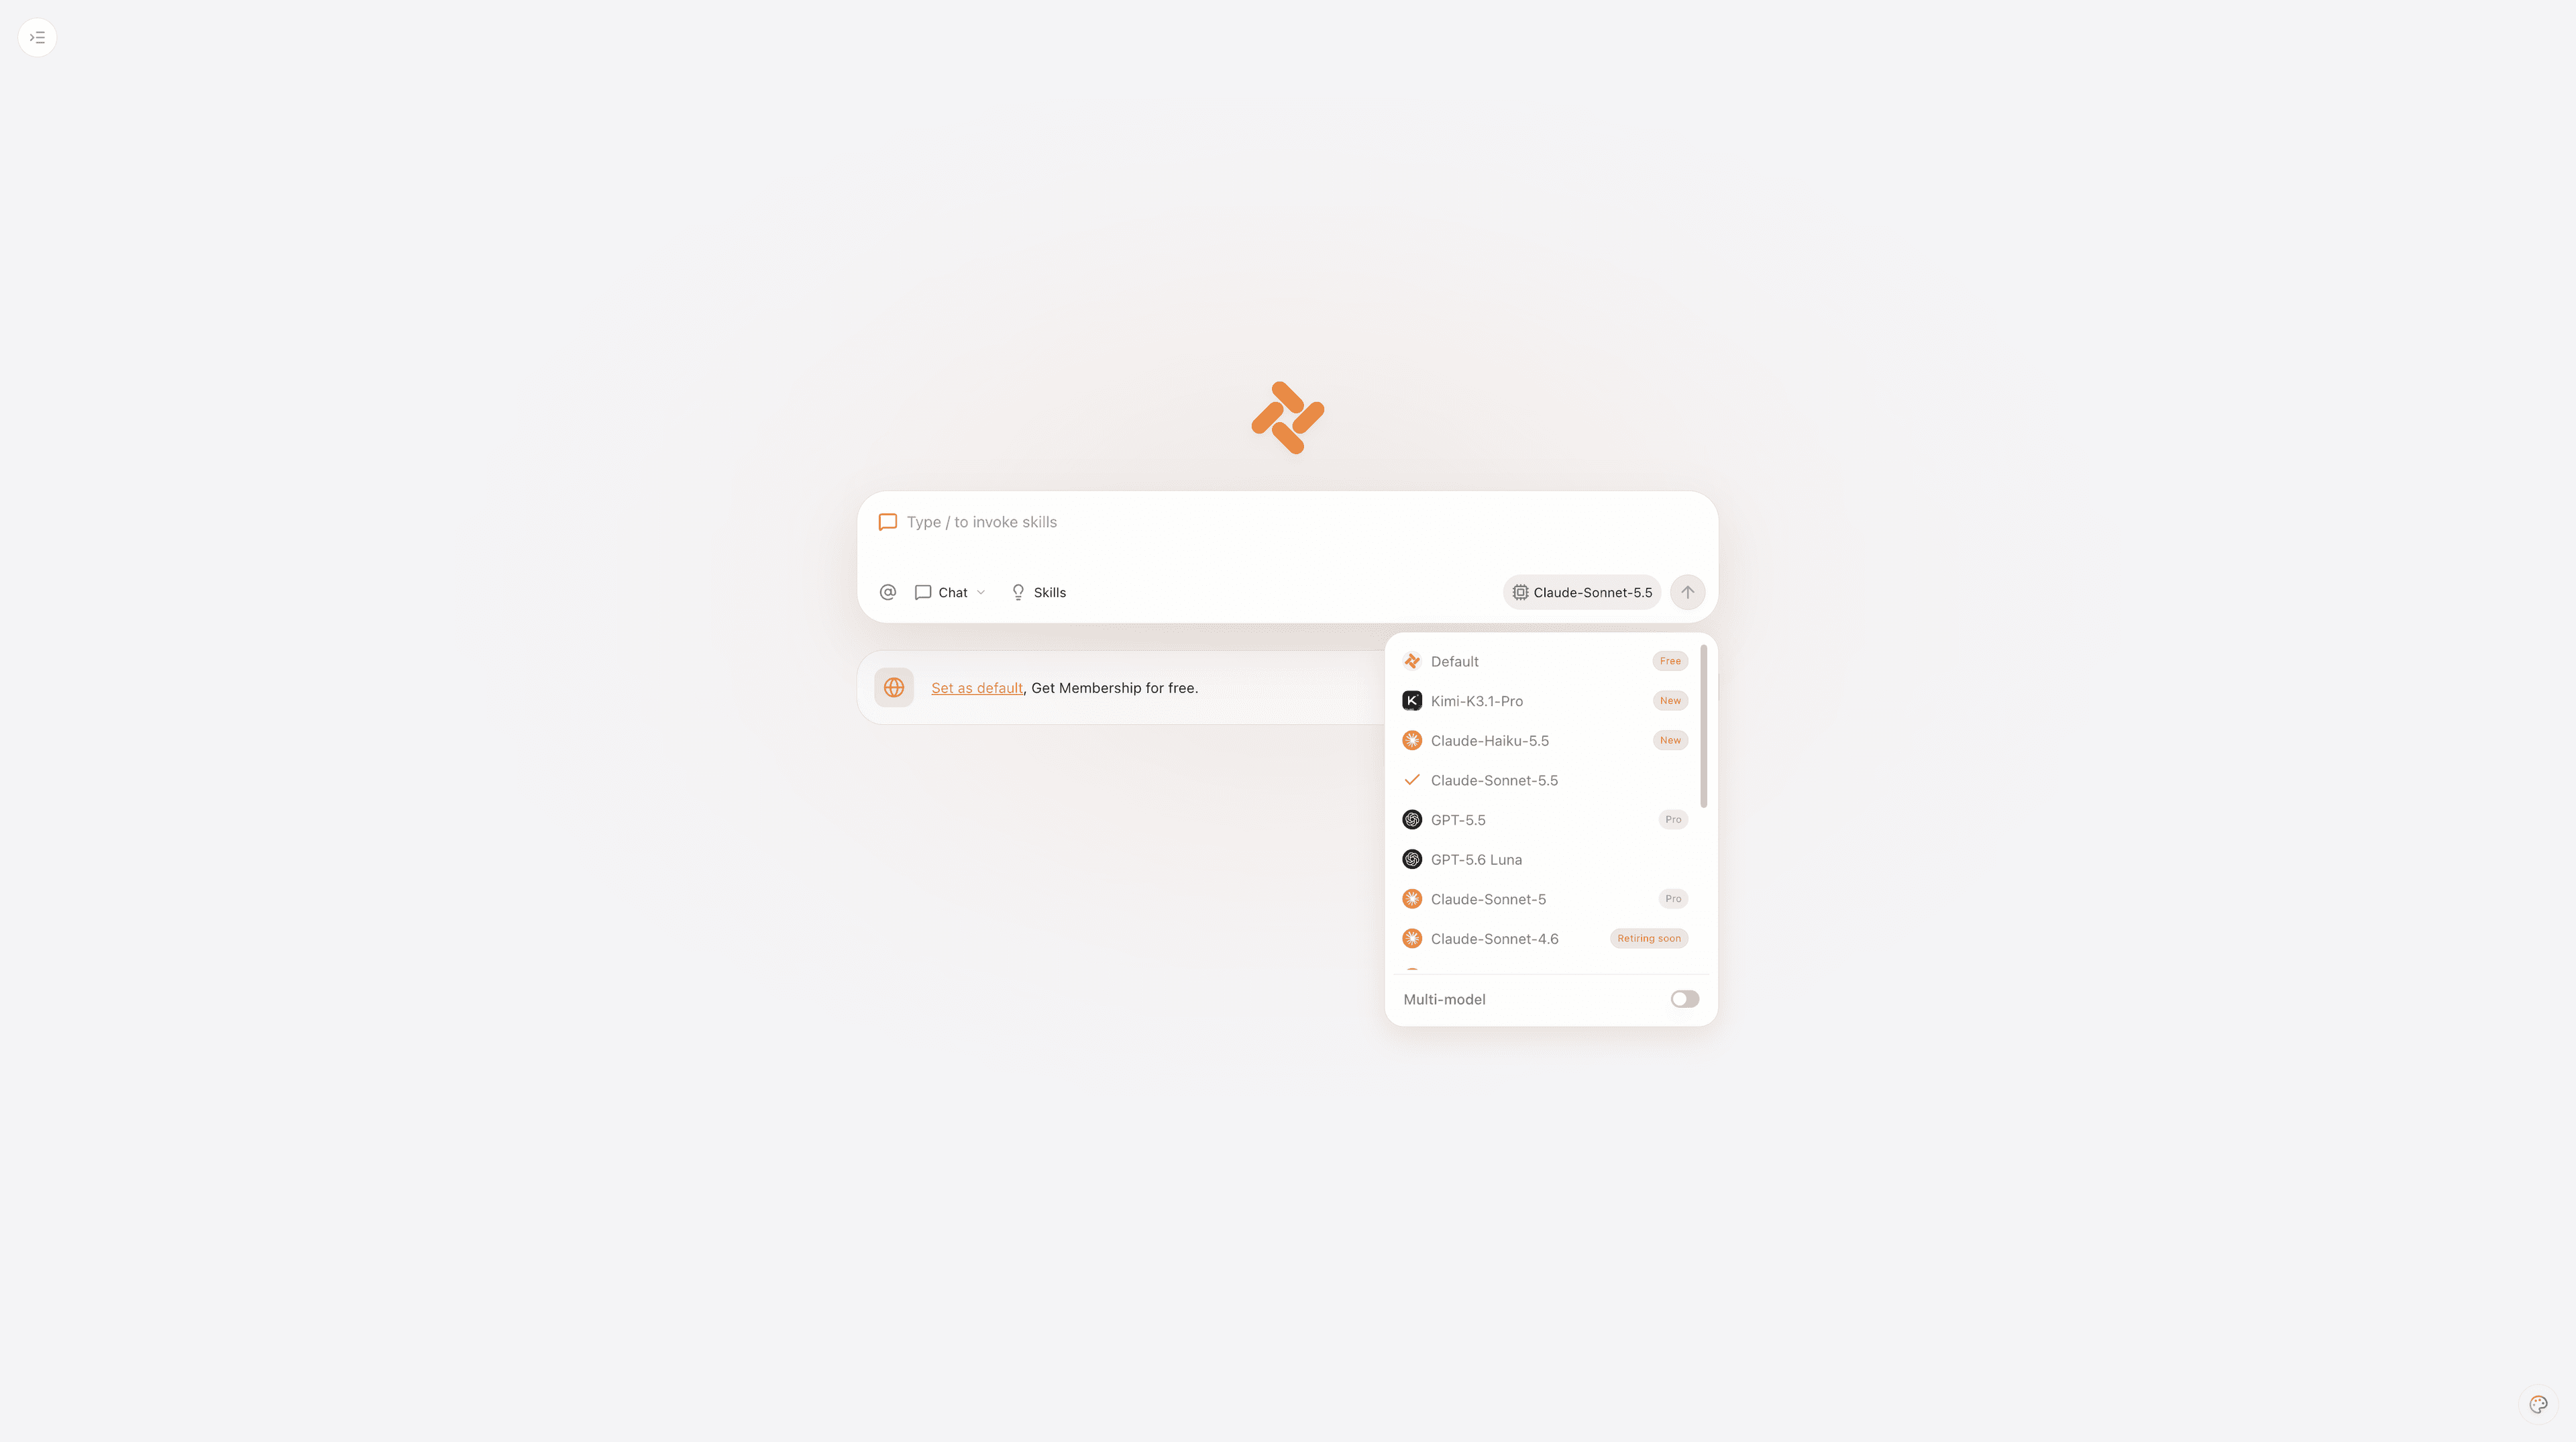
Si Terra aparece más adelante en tu cuenta, usa la misma tabla de referencia y la misma respuesta esperada entre modelos, registra el nombre visible, los indicadores de herramientas y el resultado, y comprueba el plan actual del cliente. Hasta entonces, usa un cliente con acceso a Terra confirmado. La guía práctica de Tabbit y la explicación del navegador agéntico describen flujos de trabajo de navegador, pero no demuestran que Terra esté disponible.
Veredicto: elige la carga de trabajo adecuada y después la tarifa
| Tu condición | Siguiente paso razonable | Qué comprobar |
|---|---|---|
| Tareas visuales o documentales repetidas | Prueba Terra en nivel medio y luego baja el esfuerzo | Resultados aceptados, salida de razonamiento y aciertos de caché |
| Borradores masivos con revisión humana | Compara Terra con esfuerzo bajo frente a alternativas | Tono, tiempo de edición y coste total de la tarea |
| Razonamiento prolongado o programación exigente | Compara Sol con un nivel de esfuerzo apropiado | Si menos tokens o reintentos compensan sus tarifas |
| Procesamiento sin urgencia | Evalúa Batch o Flex | Comportamiento del servicio y plazo de finalización |
| Entrada cercana a 272K | Reduce el contexto o presupuesta la fila larga | Toda la entrada, incluidos tokens leídos y escritos en caché |
| Suscripción Work/Codex | Compara la cuota y los créditos reales | Panel de la cuenta, no solo el precio de API |
La tarifa de Terra de $1/$5 es un precio inicial útil para tareas visuales y documentales. El descuento del 95% en lecturas solo aporta valor si las solicitudes reutilizan de verdad la entrada en caché; el nivel de esfuerzo y completar la tarea con éxito determinan si el trabajo completo sale a cuenta. Prueba tu flujo de trabajo, revisa el uso y elige después el plan o el nivel de servicio de API.
Para trabajar con el navegador, comprueba primero el acceso actual en Tabbit antes de depender de un modelo concreto. Descargar el cliente no concede acceso a GPT-6.1 Terra ni sustituye las reglas de facturación de OpenAI.
 Tabbit Browser

Preguntas frecuentes
¿Cuánto cuesta GPT-6.1 Terra por millón de tokens?
Según la comprobación del 27 de octubre de 2026, la tarifa Standard de la API para hasta 272.000 tokens de entrada es de $1 por millón de tokens de entrada sin caché, $0,05 por millón de tokens de entrada en caché y $5 por millón de tokens de salida. Las escrituras en caché cuestan $1,25 con retención de 30 minutos o $2,50 con retención de 12 horas. Cada token pertenece a una sola categoría de facturación de entrada, por lo que una escritura no se suma al cargo de entrada normal por esos mismos tokens.
¿GPT-6.1 Terra es más barato que GPT-5.6 Terra?
La tarifa actual Standard para contexto corto baja de $2 a $1 para la entrada, de $12 a $5 para la salida y de $0,20 a $0,05 por millón de tokens leídos desde la caché. Las reducciones son del 50%, aproximadamente del 58,3% y del 75%, respectivamente. El coste de tu tarea también depende de los tokens de razonamiento generados, los aciertos de caché, los reintentos y la calidad de salida que aceptes.
¿GPT-6.1 Terra cobra un recargo por contexto largo?
Sí. Por encima de 272.000 tokens de entrada, toda la solicitud usa las tarifas de contexto largo: se duplican las tarifas de entrada y caché, y la salida cuesta 1,5 veces más. Con exactamente 272.000 tokens de entrada sigue aplicándose el tramo de contexto corto.
¿Los tokens de razonamiento y las respuestas de rechazo son gratis?
Los tokens de razonamiento se contabilizan como tokens de salida facturables, incluso si no llega a mostrarse una respuesta final. Las páginas oficiales citadas no prometen que los rechazos sean gratis. Consulta el uso de la respuesta y la facturación; no des por hecho que un resultado fallido no cuesta nada.
¿Puedo usar GPT-6.1 Terra con una suscripción de ChatGPT?
OpenAI incluye Terra en ChatGPT Work y Codex para los planes Plus, Pro, Business, Enterprise y Edu, sujeto a los controles de acceso y del espacio de trabajo. No aparece para la interfaz normal de Chat. El uso incluido y los créditos comprados son independientes de la facturación por clave de API.
¿GPT-6.1 Terra está disponible en Tabbit Browser?
La cuenta internacional de Tabbit inspeccionada el 27 de octubre de 2026 no incluía GPT-6.1 Terra entre los 16 modelos cargados. Por eso este artículo no afirma que se haya probado una inferencia de Terra en Tabbit ni garantiza acceso al modelo. Comprueba el selector y tu plan actuales antes de elegir un cliente para este modelo.