
Gemini 4 Carbon은 어렵고 긴 작업에 제한적으로 시험해 볼 후보지만 공개 자료만으로 여러분의 업무에 최선이라고 단정할 수 없습니다. Google은 가장 어려운 작업에 Carbon을 제시하고 대부분의 소프트웨어 엔지니어링과 지식 업무에는 Argon이 적합하다고 설명합니다. 모델 카드에는 과제와 평가 환경이 다른 결과가 함께 있으므로 이를 일반적인 성공률 하나로 합치지 말고 각각 해석해야 합니다.
사용자 보고
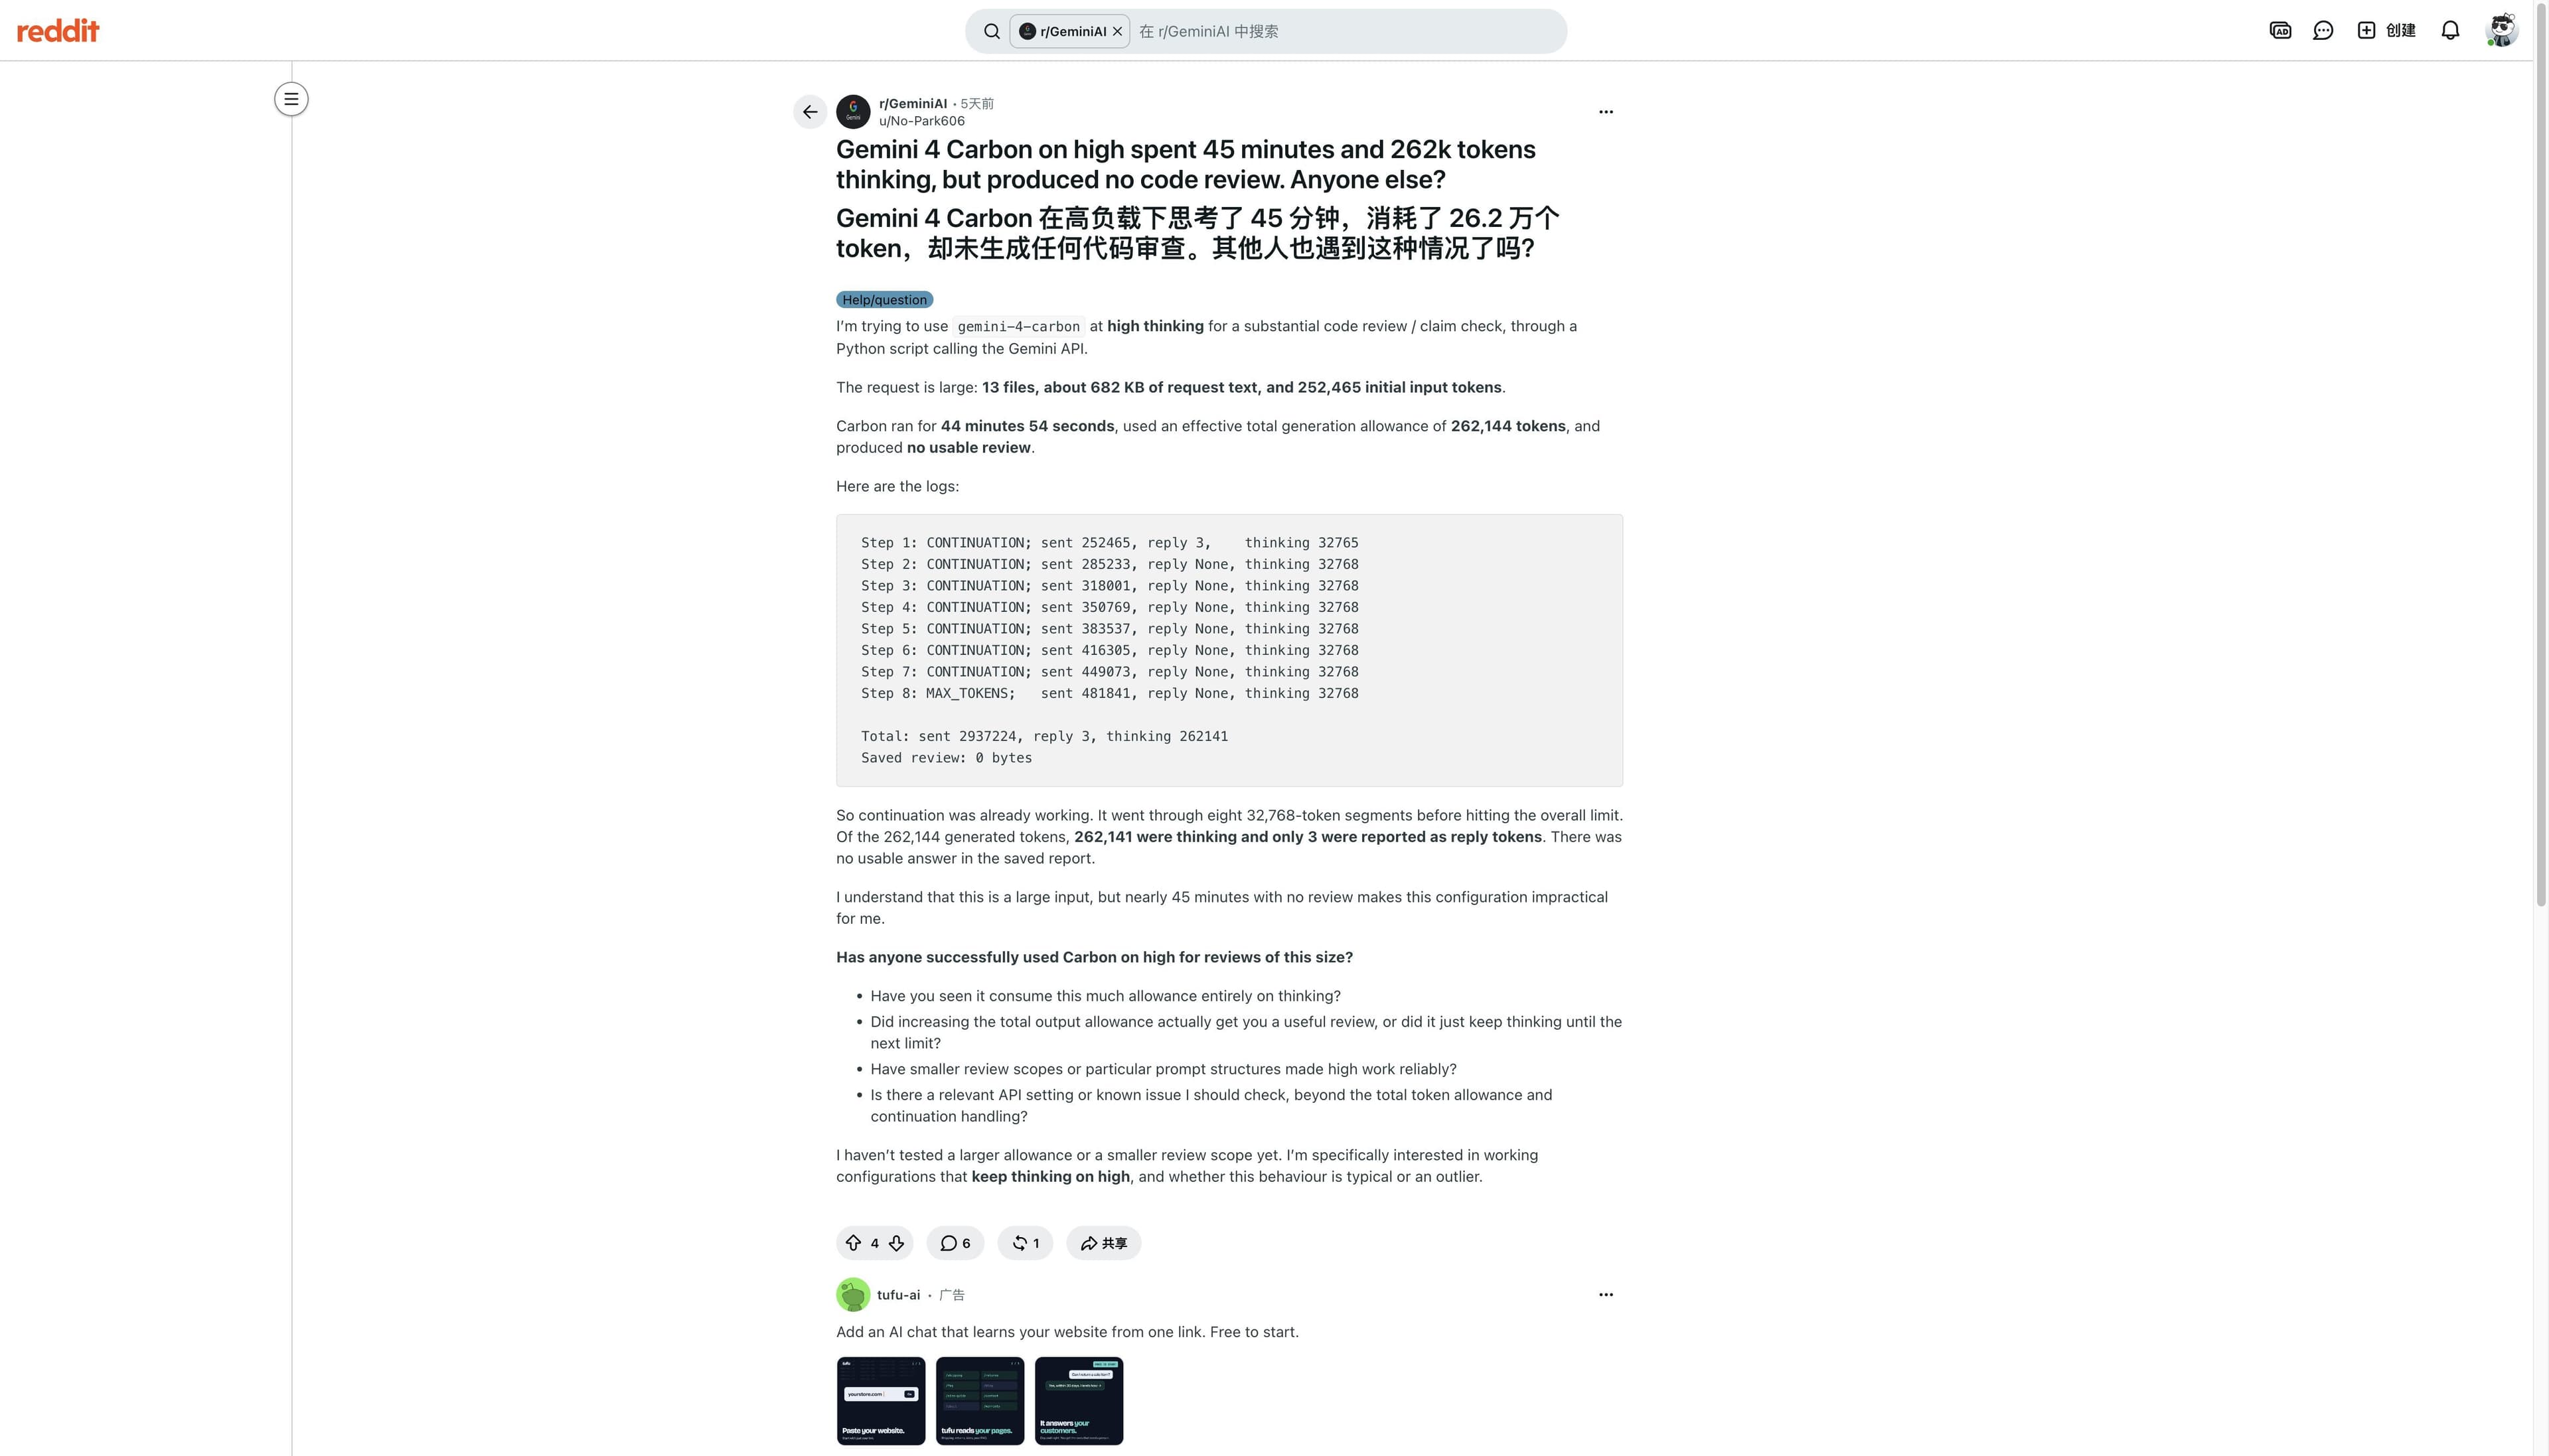
한 Reddit 사용자는 높은 추론 설정으로 파일 13개를 검토하는 데 약 45분과 추론 토큰 262,141개를 썼지만 쓸 만한 리뷰를 받지 못했다고 보고했습니다. 특정 설정의 한 번 실패이지 일반 신뢰도 비율은 아닙니다. 스크린샷에는 작업 설명과 표시된 실행 정보가 담겨 있습니다. 게시물 보기.
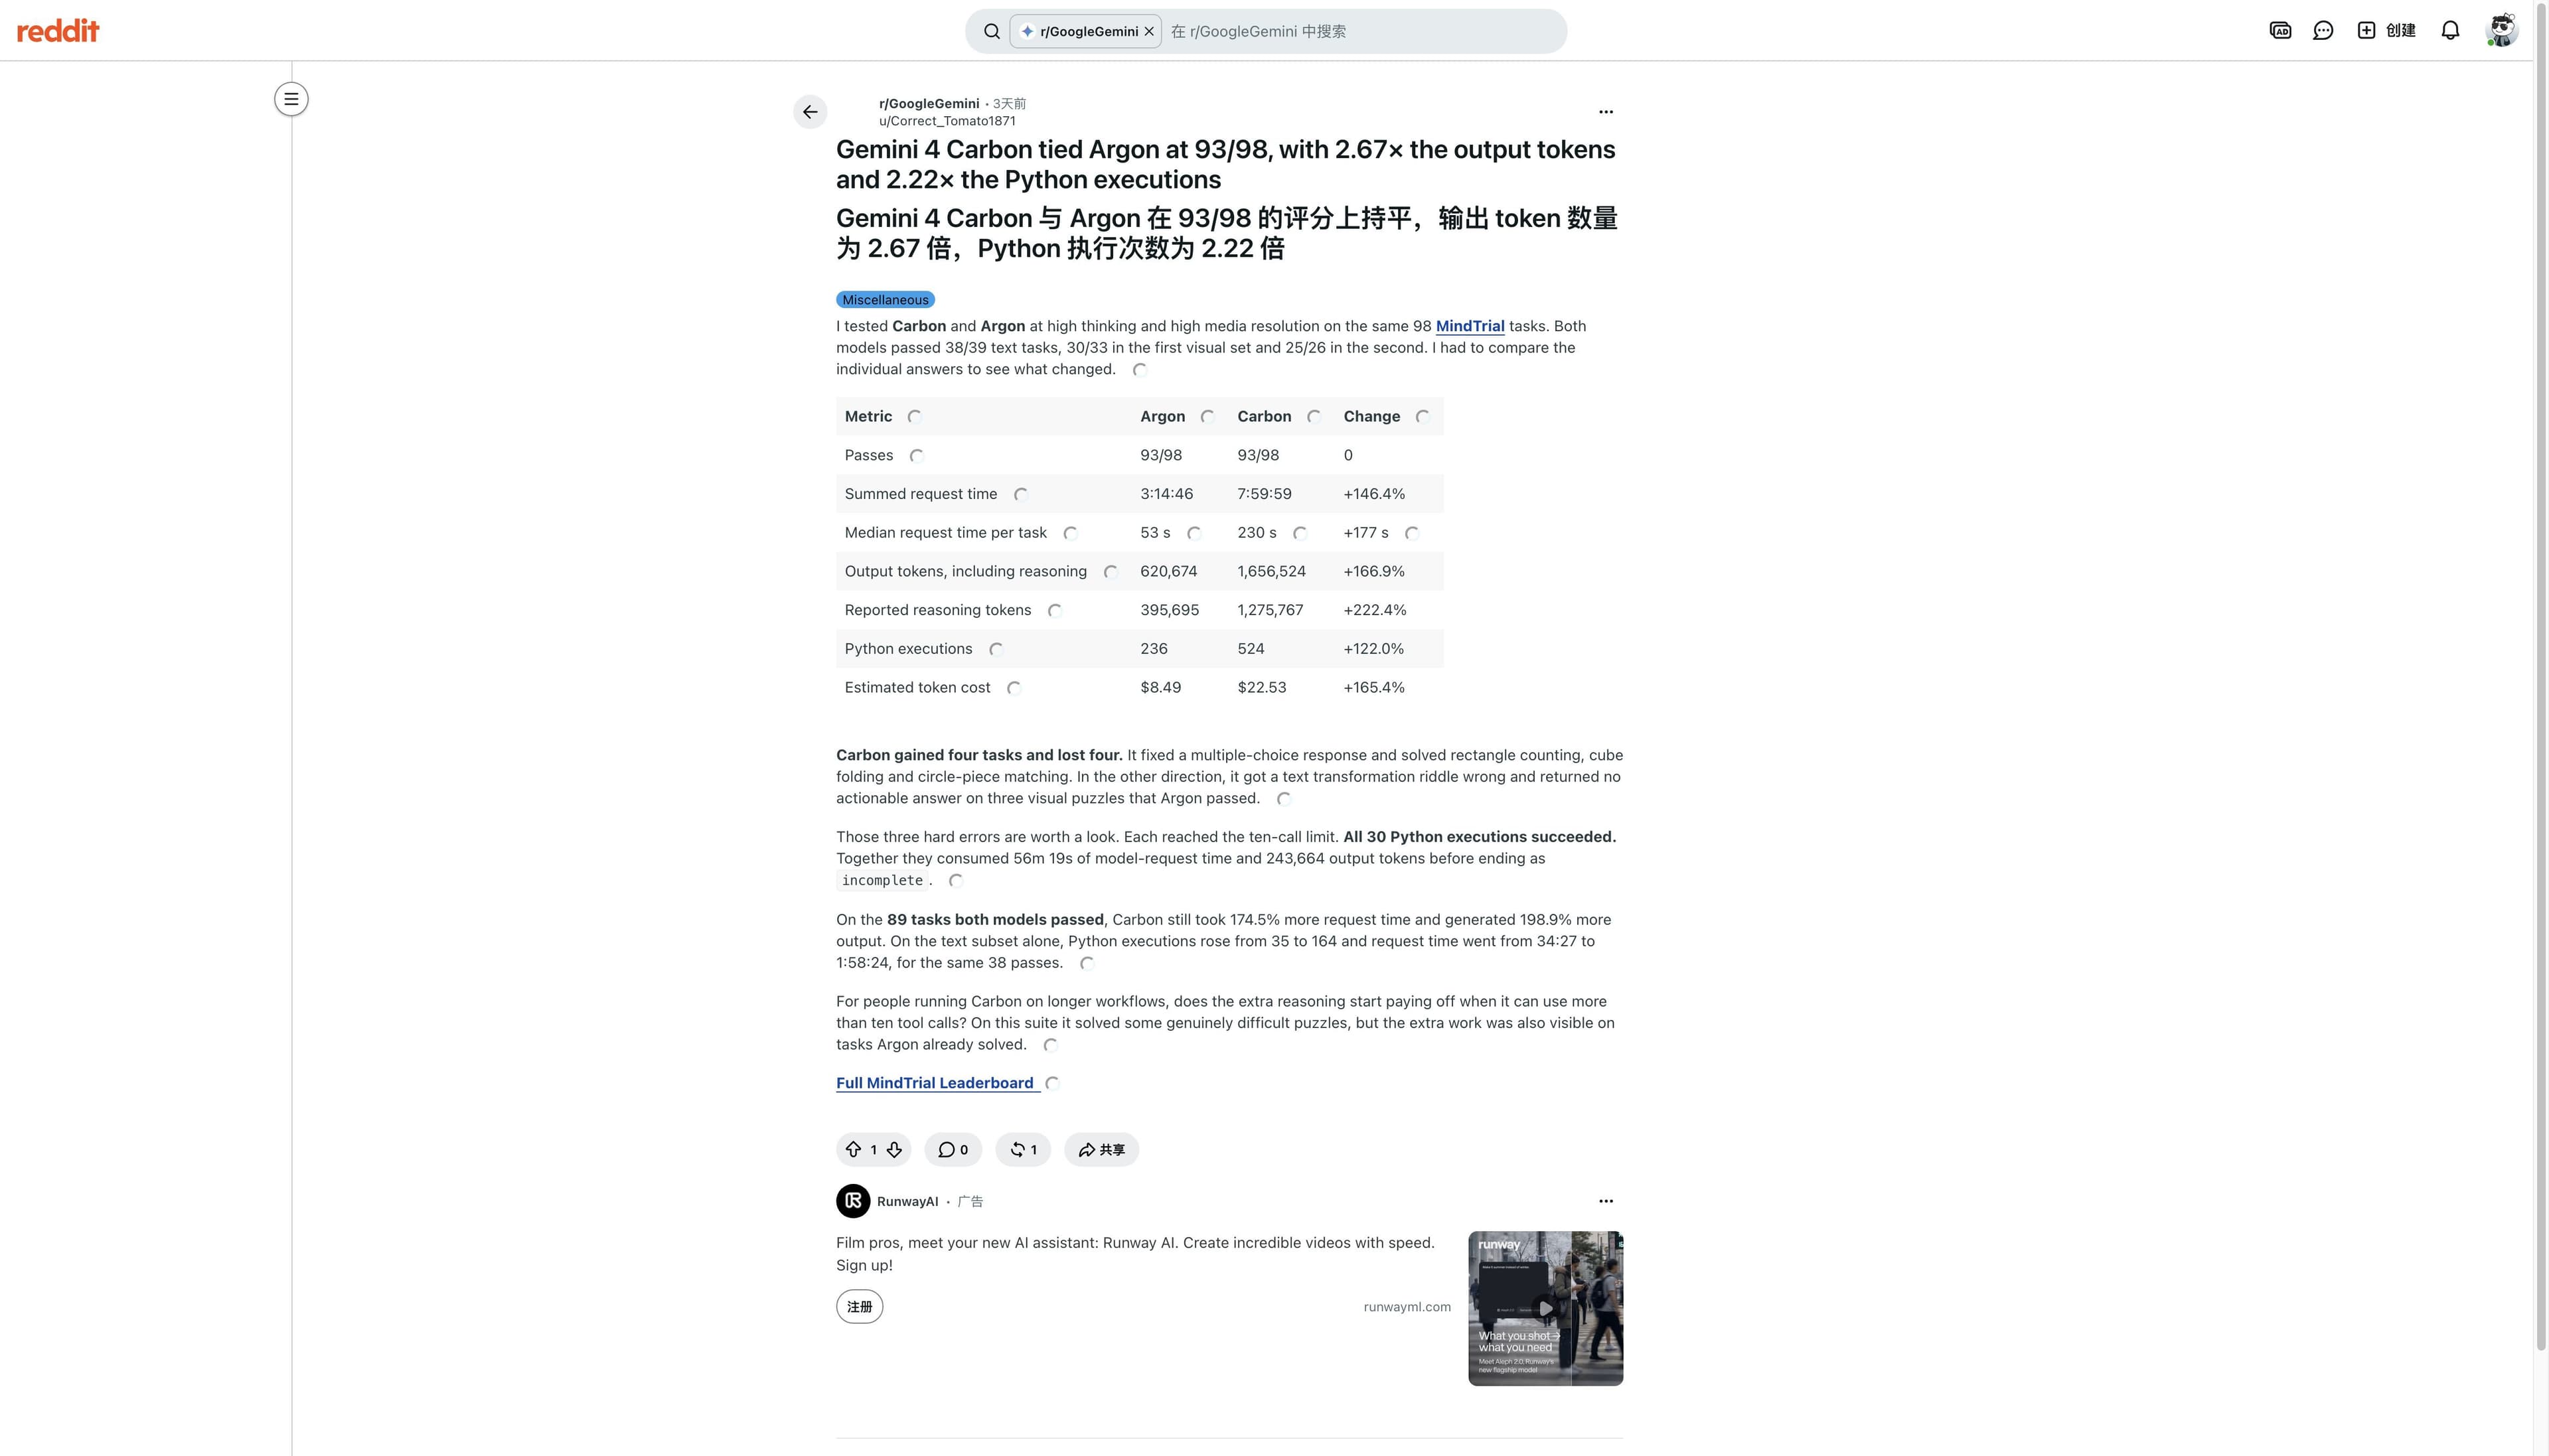
다른 Reddit 사용자는 MindTrial 98개에서 Carbon과 Argon 모두 93/98, Carbon은 출력 토큰 2.67배·시간 2.46배, 작성자 추정 비용은 $22.53 대 $8.49였다고 보고했습니다. 자체 보고라 승인 작업당 비용 테스트 설계에는 참고가 되지만 재현된 점수는 아닙니다. 원문 보기.
리뷰 결론
Google은 Carbon을 가장 어려운 장기 작업용으로 설명합니다. 파일럿 근거이지 독립적인 추천은 아닙니다.
모델 카드의 벤치마크는 서로 다른 평가입니다. 단일 대표 점수보다 버전, 도구, 작업 조건을 확인해야 합니다.
Google은 높은 추론 설정에서 토큰이 늘고 지연·시간 초과·환각이 있을 수 있다고 밝히지만 일반적인 성공률은 제시하지 않습니다.
사용자 보고는 작업별 편차를 보여주지만 Tabbit Carbon 실측이나 반복 통제 시험은 확인되지 않았습니다.
실무 판단표
| 작업 | 자료가 뒷받침하는 내용 | 입증되지 않은 점 | 다음 확인 |
|---|---|---|---|
| Vendor benchmarks | Model card names task, harness and score | General reliability on your workload | Reproduce a benign task |
| User reports | Individual Reddit/X experiences | Population-level result | Keep prompts and settings attached |
| High-thinking work | Vendor notes higher token use and possible latency/timeouts | Fixed quality-per-dollar advantage | Measure tokens and accepted output |
주장을 작업 테스트로 바꾸기
파일럿 전에 합격 답변 기준을 정하세요. 읽기 전용 입력과 안전한 출력을 사용하고 같은 맥락과 평가표로 반복합니다. 정확도, 누락, 시간, 입출력 토큰, 비용을 기록하세요. 오류가 나면 모델, 프롬프트, 자료 중 원인을 구분하고 실행마다 작업을 바꾸지 마세요.
Google Carbon 모델 카드에는 Terminal-Bench 4.0 (AA) 65.2%, Agents’ Last Exam v1.1 77.4, 지정된 256k–1M BFS 설정의 GraphWalks F1 96.2% 등이 있습니다. 서로 다른 평가 결과입니다. Artificial Analysis는 현재 v5.0.1, Google 카드 스냅샷은 v5.0으로 표시하므로 59와 “최대 60”을 단순한 전후 향상으로 보면 안 됩니다.
| Evidence | What it can tell you | What it cannot tell you |
|---|---|---|
| Vendor benchmark | Performance on named task and harness | Your production success rate |
| Community task report | A person’s experience under their own setup | Independent replication or average cost |
| Your pilot | Fit for the chosen task and rubric | All future prompts or account configurations |
공개 발표가 되었어도 제품과 계정에 따라 접근이 달라집니다. Google은 개발자·기업용 Gemini API와 AI Studio, 소비자용 Ultra Gemini 앱을 안내합니다. 실제 사용할 제품의 모델 선택기와 청구 화면을 확인하세요.
반복 가능한 근거 수집에는 다중 모델 조사 기록, 출처 기반 브라우저 조사, 심층 조사 방법, 성공당 비용 기준을 참고하세요.
Tabbit이 맡는 역할
Tabbit은 브라우저·워크플로 계층이며 Carbon 자체가 로그인된 브라우저를 제어한다는 증거가 아닙니다. 기존 Carbon 브라우저 사용 안내는 모델 접근과 로컬 브라우저 실행을 구분합니다. 이 글은 Tabbit Carbon 벤치마크나 실행 결과를 보고하지 않습니다. 위 내용은 결과가 아닌 테스트 절차입니다.
브라우저 워크플로에서 Carbon을 시험할 때는 Tabbit CLI 안내, 기존 브라우저 연결, 첫 작업 체크리스트, 로컬 자동화, 에이전트 브라우저 설명으로 모델 접근과 로컬 실행을 구분하세요.
벤치마크 점수는 설정과 함께 읽기
모델 카드는 점수와 함께 작업명, 버전, 평가 도구, 입력 조건을 볼 때 가장 유용합니다. 긴 컨텍스트 그래프 과제의 높은 점수가 기업 계정을 정확히 탐색한다는 뜻은 아니며, 코딩 벤치마크는 인용 품질을 측정하지 않습니다. 공급자 평가는 파일럿 후보를 고르는 데 도움이 되고 사용자 글은 토큰 사용과 시간 초과 같은 질문을 보여주지만, 반복된 자체 평가를 대신하지 않습니다. 질문은 ‘Carbon이 좋은가?’가 아니라 ‘이 특정 작업을 감당 가능한 비용과 지연으로 우리 기준에 맞게 끝내는가?’입니다.
공개된 근거는 내 업무 결과를 보장하지 않으며 검증의 출발점입니다. 민감한 데이터를 보내거나 반복 비용을 약정하기 전에 현재 모델, 계정 조건, 측정 결과를 확인하세요.

자주 묻는 질문
Gemini 4 Carbon을 시험해 볼 만한가요?
계정에서 모델을 선택할 수 있다면 어려운 작업 하나를 제한된 범위에서 시험할 수 있습니다. 공개 근거가 모든 업무에 적합함을 증명하지는 않습니다.
벤치마크 점수가 내 결과를 예측하나요?
아닙니다. 작업, 평가 도구, 모델 버전, 설정에 따라 달라집니다. 테스트 질문을 만드는 참고로 삼고 직접 측정하세요.
모델 카드에 한계가 나와 있나요?
그렇습니다. 높은 추론 설정의 토큰 증가, 지연, 시간 초과, 환각을 언급하지만 일반적인 실패율은 제공하지 않습니다.
Carbon이 로그인한 페이지를 탐색할 수 있나요?
모델 자체가 브라우저를 제어하지 않습니다. 별도의 로컬 호스트, 커넥터, 계정, 승인된 세션이 필요합니다.
파일럿 결과는 어떻게 검토하나요?
안전한 작업과 고정 입력·평가표로 여러 번 실행하고 사실, 누락, 시간, 토큰, 비용을 확인한 뒤 사용 범위를 넓히세요.