
Gemini 4 Carbon pode merecer um piloto controlado em tarefas difíceis e longas, mas os dados públicos não provam que seja o melhor para sua carga de trabalho. O Google o posiciona para os desafios mais complexos e afirma que Argon atende à maioria da engenharia de software e do trabalho de conhecimento. A ficha reúne testes diferentes; cada resultado depende da tarefa e do ambiente e não representa uma taxa geral de sucesso.
Relatos de usuários
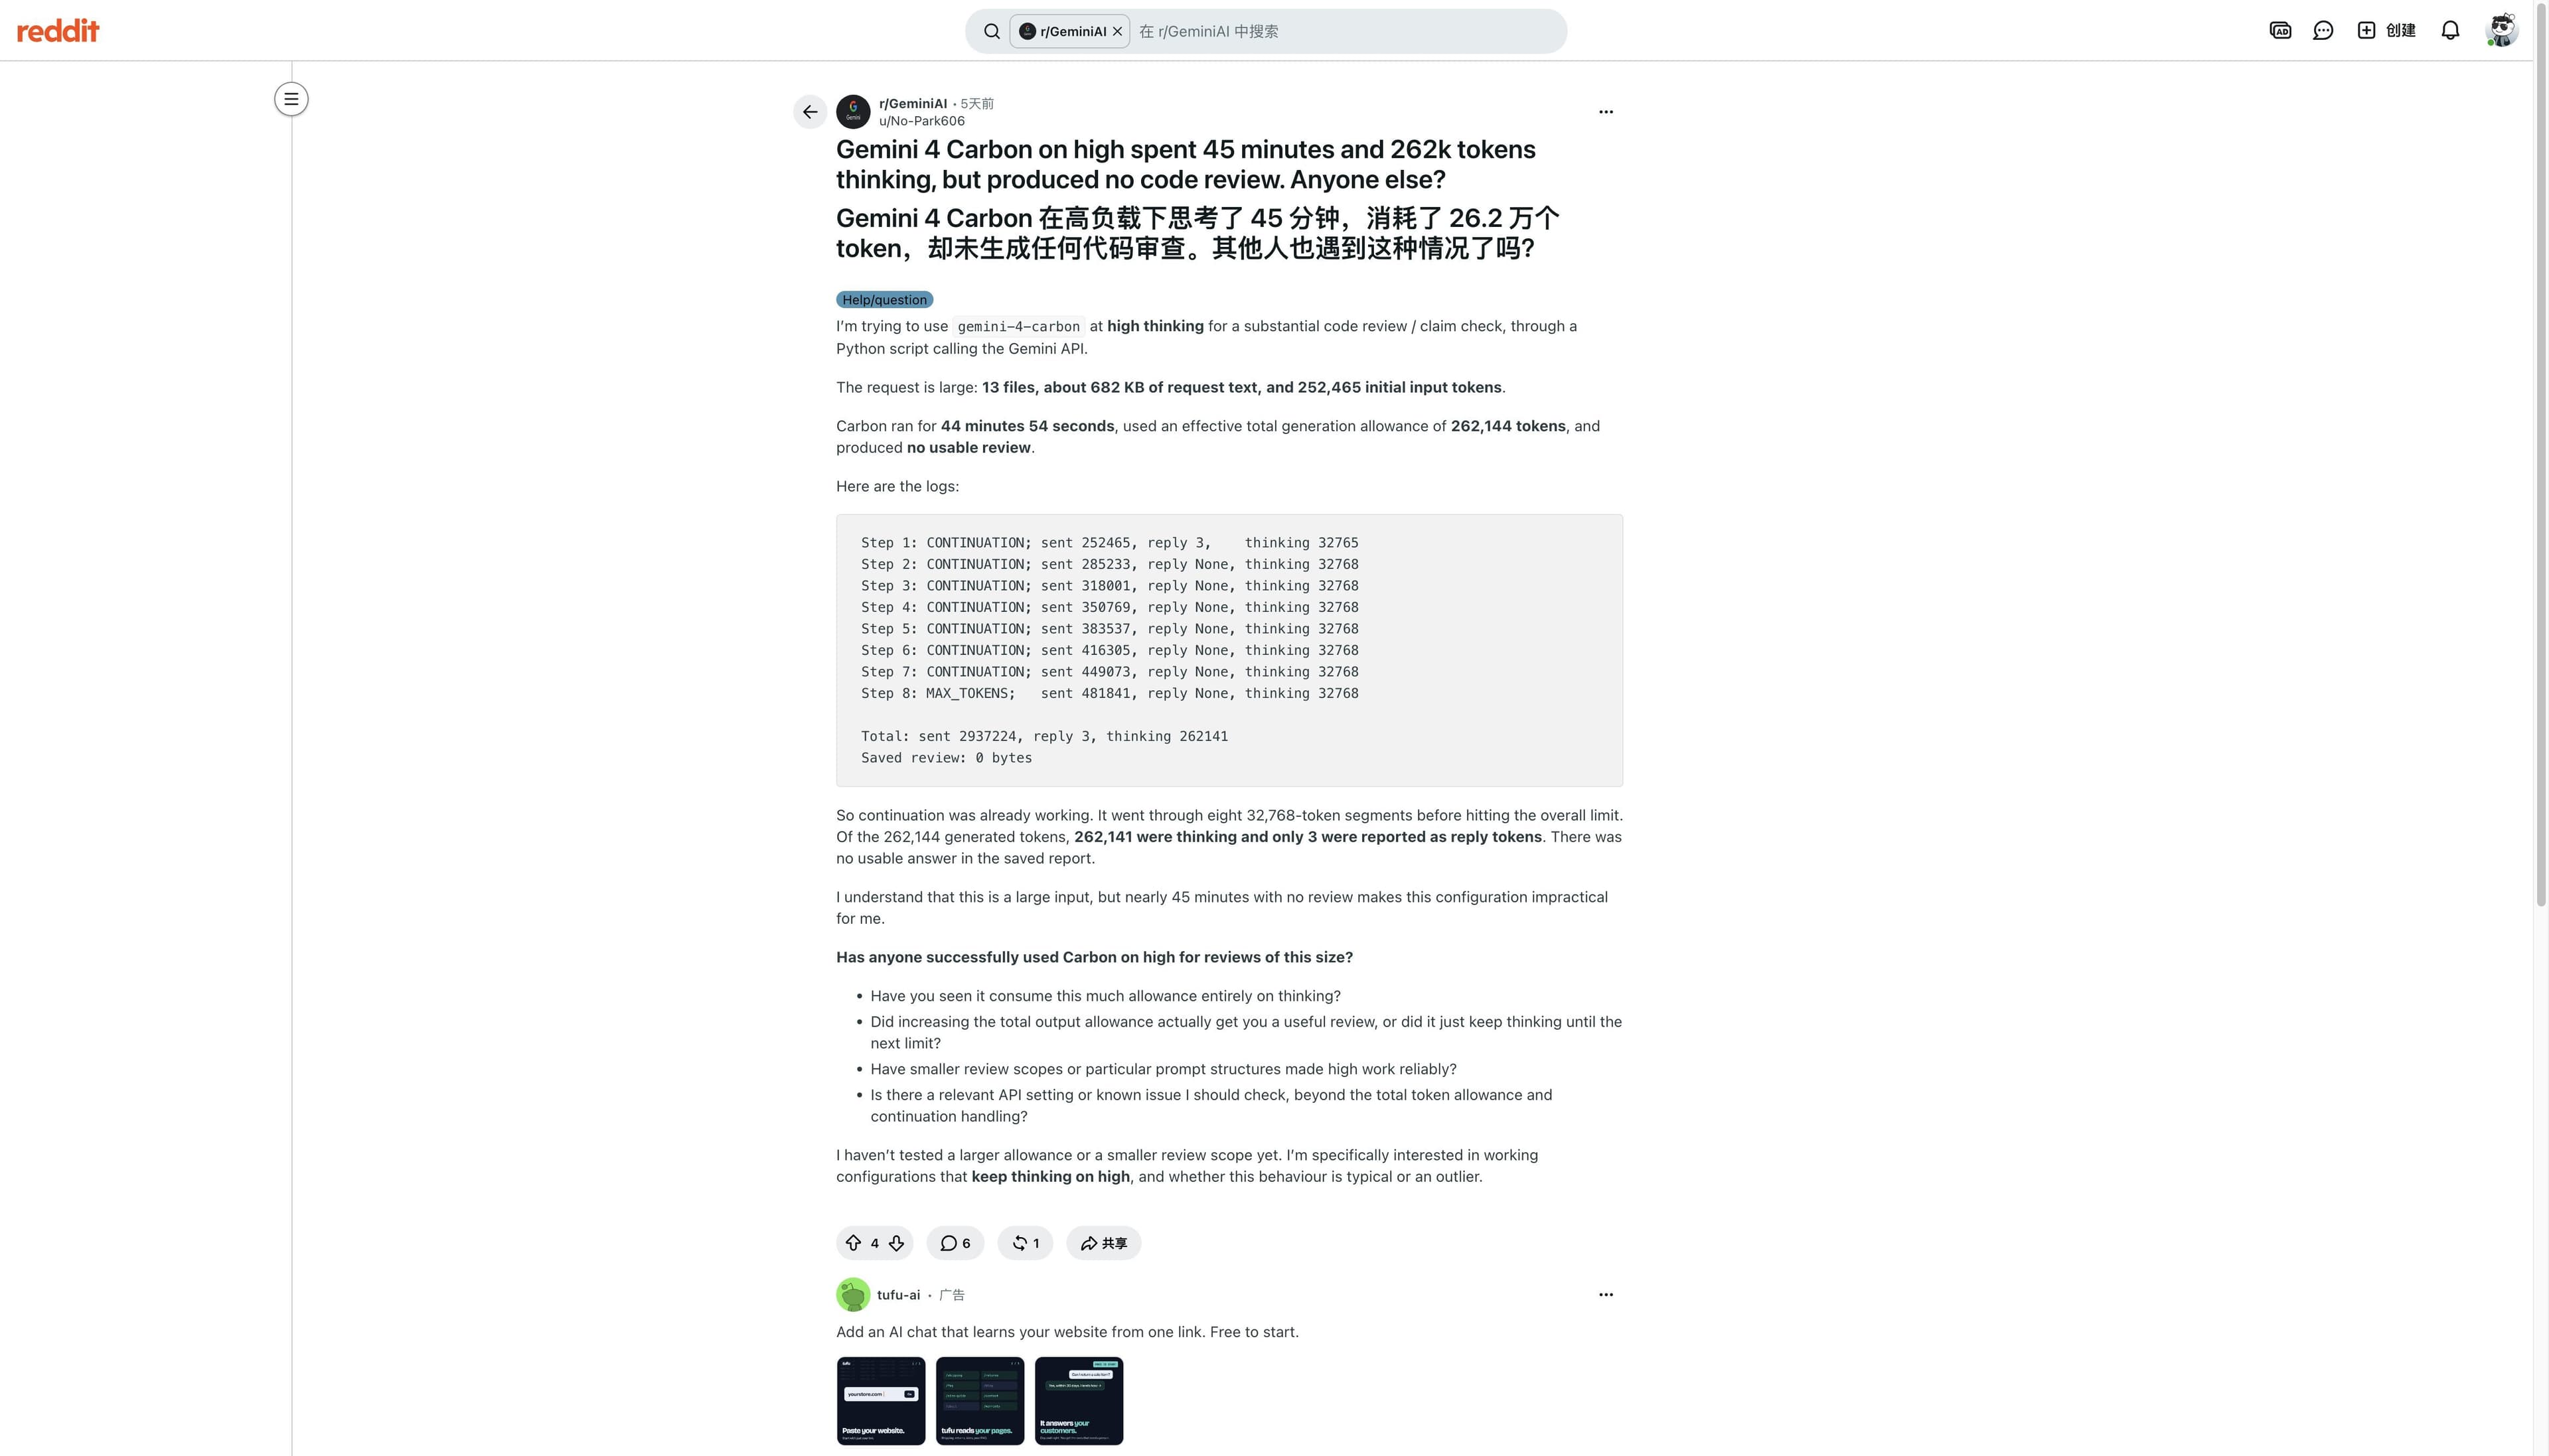
Uma pessoa no Reddit relata que uma revisão de 13 arquivos com raciocínio alto levou cerca de 45 minutos, consumiu 262.141 tokens de raciocínio e não gerou uma revisão útil. É uma falha em uma configuração, não uma taxa geral de confiabilidade. A captura preserva a descrição e os dados exibidos. Leia o post.
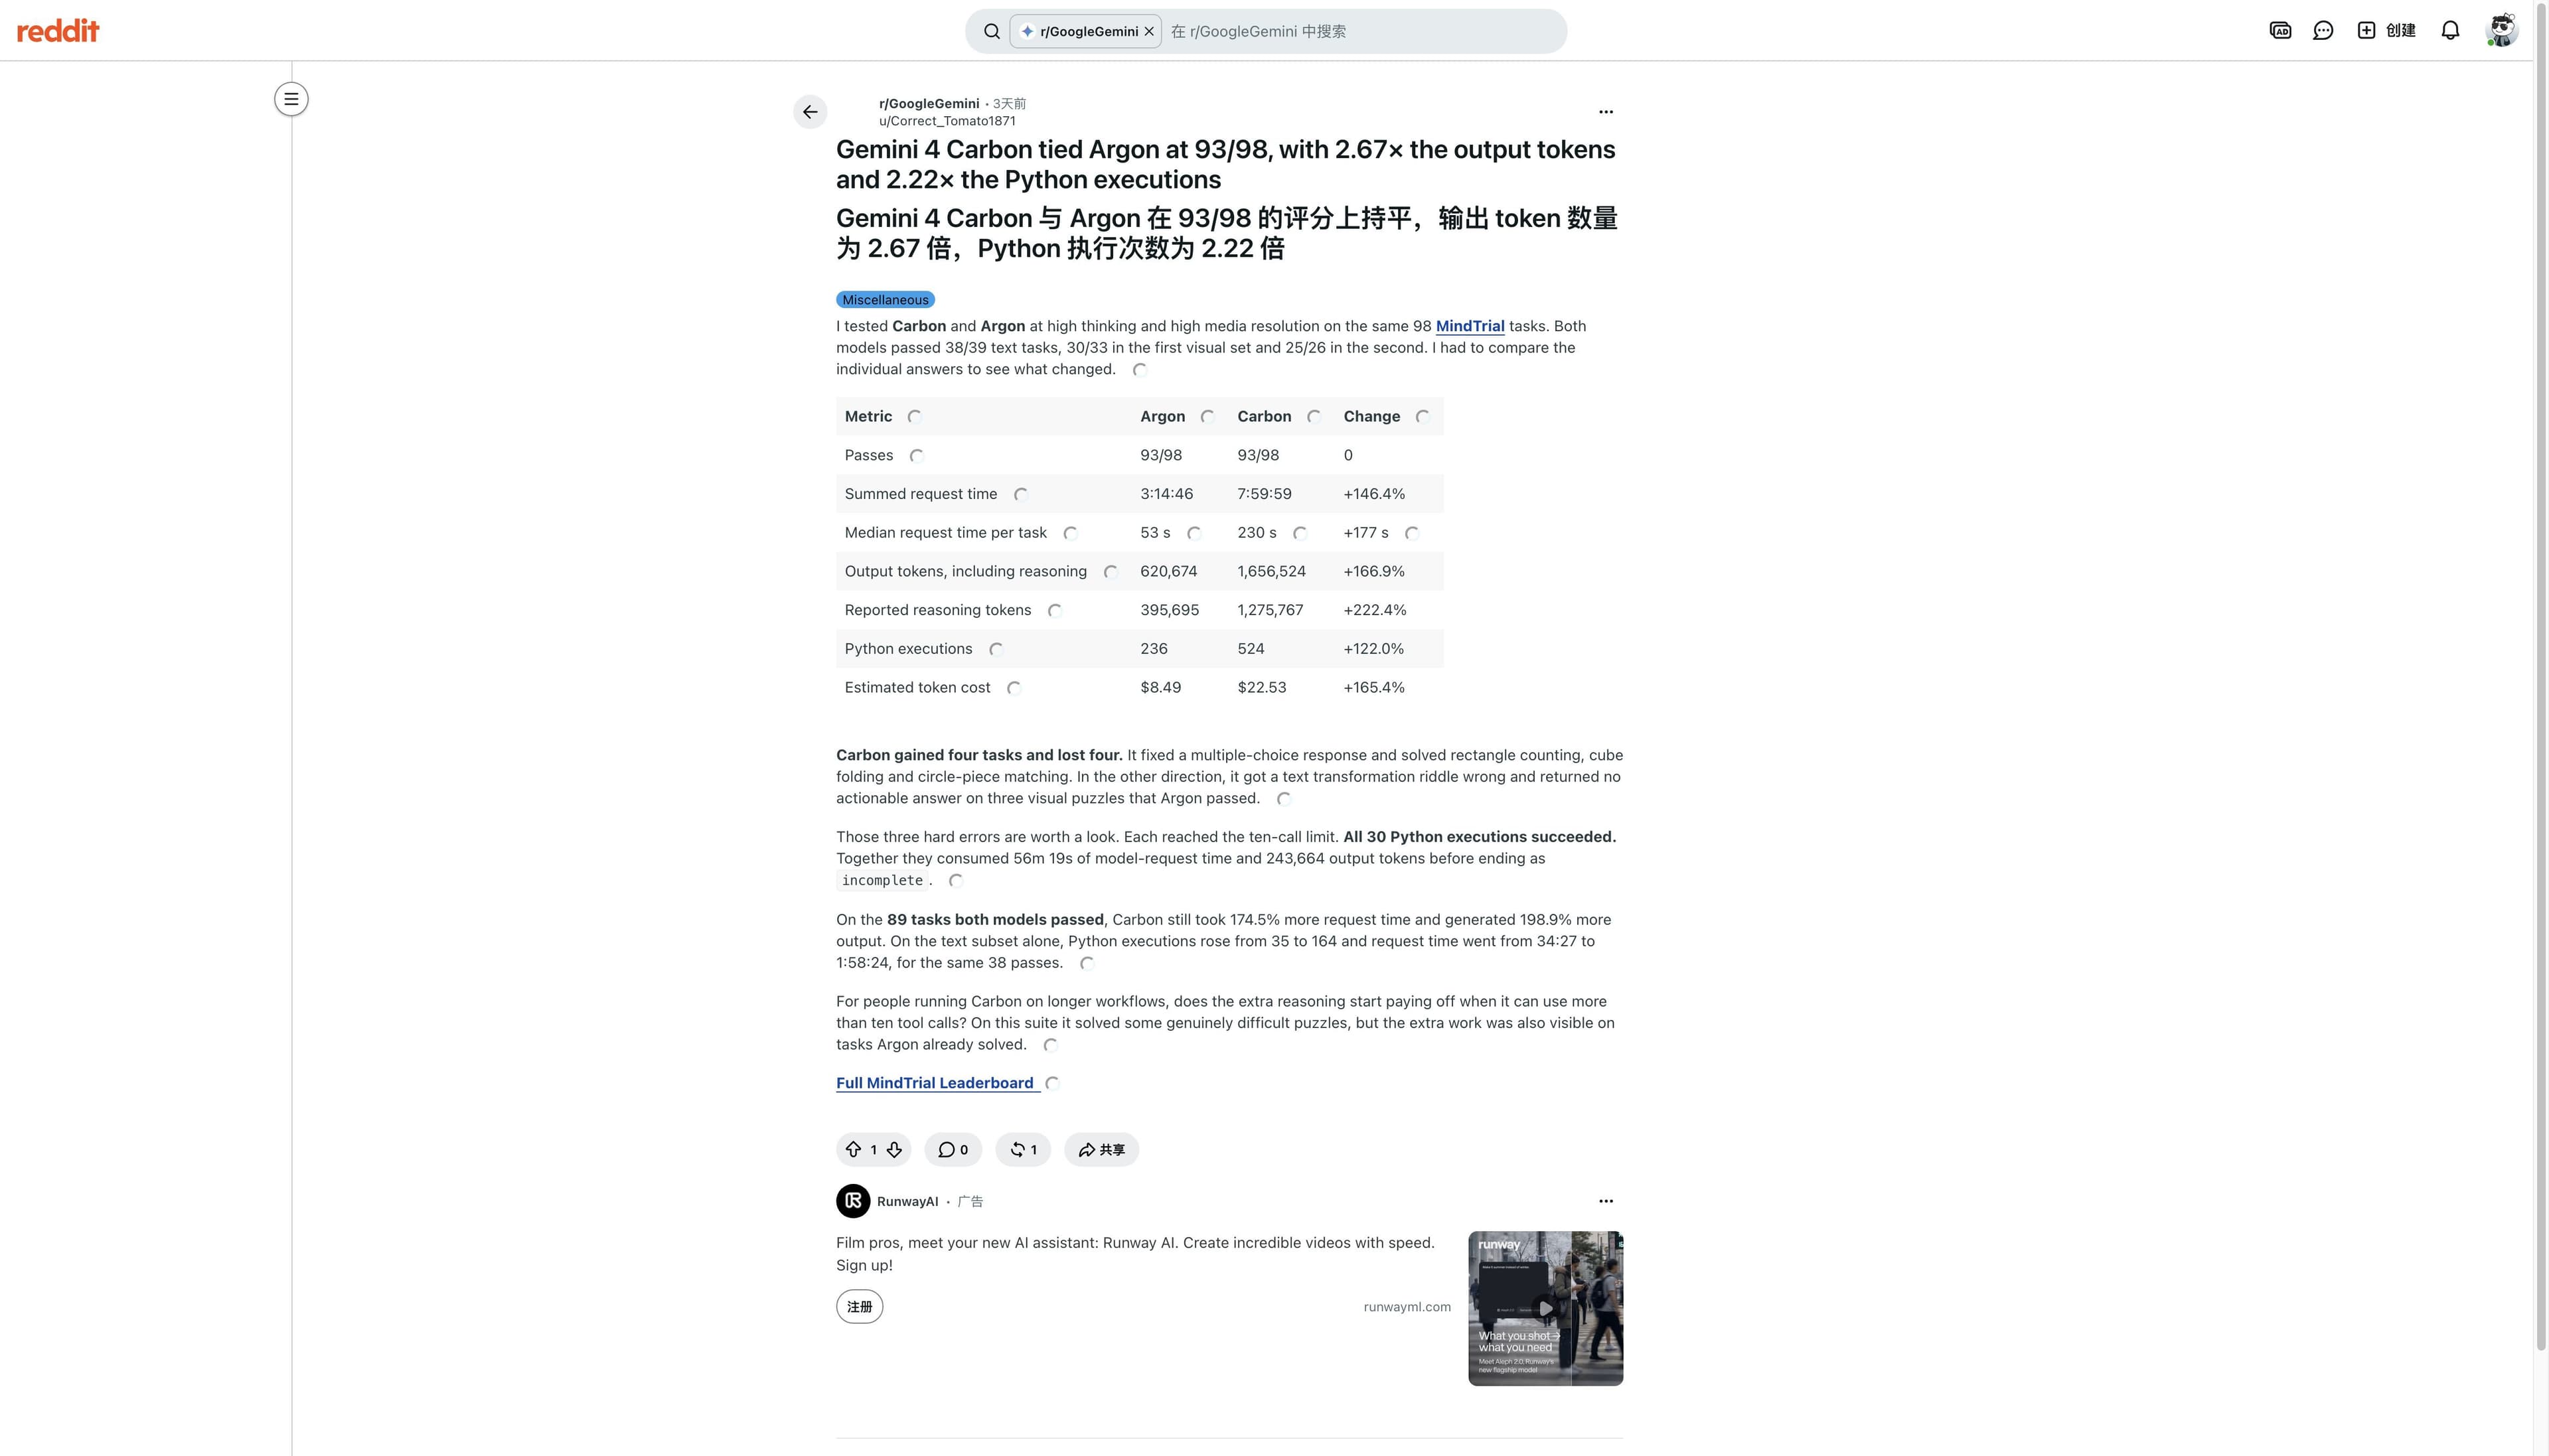
Outra pessoa comparou Carbon e Argon em 98 tarefas MindTrial: ambos 93/98; Carbon usou 2,67 vezes os tokens de saída e levou 2,46 vezes mais tempo, com custo estimado pelo autor de US$ 22,53 contra US$ 8,49. É um relato útil para planejar custo por tarefa aprovada, mas não uma pontuação reproduzida. Leia o original.
Conclusões da avaliação
O Google posiciona Carbon para tarefas difíceis e longas; isso justifica um piloto, não uma recomendação independente.
A ficha reúne benchmarks diferentes; versão, ferramenta e tarefa importam mais que uma pontuação isolada.
O Google cita mais tokens em raciocínio alto, latência, tempos limite e alucinações; não publica uma taxa geral de sucesso.
Relatos mostram variação por tarefa, mas não há teste Carbon no Tabbit nem ensaio controlado repetido verificado aqui.
Tabela prática de decisão
| Tarefa | O que as fontes sustentam | O que não foi comprovado | Próxima verificação |
|---|---|---|---|
| Vendor benchmarks | Model card names task, harness and score | General reliability on your workload | Reproduce a benign task |
| User reports | Individual Reddit/X experiences | Population-level result | Keep prompts and settings attached |
| High-thinking work | Vendor notes higher token use and possible latency/timeouts | Fixed quality-per-dollar advantage | Measure tokens and accepted output |
Transforme a afirmação em um teste
Antes do piloto, defina a resposta aceitável. Use entradas somente para leitura e uma saída segura; repita com o mesmo contexto e critérios. Registre acertos, omissões, tempo, tokens de entrada/saída e custo. Se houver erro, diferencie modelo, instrução e fontes; não altere a tarefa entre execuções.
O cartão do Carbon no Google informa, entre outros resultados, 65,2% no Terminal-Bench 4.0 (AA), 77,4 no Agents’ Last Exam v1.1 e F1 de 96,2% no GraphWalks com configuração BFS declarada de 256k–1M. São avaliações distintas. A Artificial Analysis mostra atualmente o índice v5.0.1; a captura do Google informa v5.0. Não interprete 59 versus “até 60” como melhora direta.
| Evidence | What it can tell you | What it cannot tell you |
|---|---|---|
| Vendor benchmark | Performance on named task and harness | Your production success rate |
| Community task report | A person’s experience under their own setup | Independent replication or average cost |
| Your pilot | Fit for the chosen task and rubric | All future prompts or account configurations |
O lançamento é público, mas o acesso varia por produto e conta. O Google cita Gemini API e AI Studio para desenvolvedores e empresas e o app Gemini Ultra para consumidores. Confira o seletor e a cobrança do produto que pretende usar.
Onde o Tabbit se encaixa
O Tabbit é uma camada de navegador e fluxo de trabalho; isso não prova que o Carbon controle sozinho um navegador autenticado. O guia de navegador com Carbon explica a diferença entre acesso ao modelo e execução local. Este artigo não relata benchmark ou execução do Carbon no Tabbit; o método acima é um protocolo, não um resultado.
Para reunir evidências repetíveis, veja os registros de pesquisa multimodelo, a pesquisa no navegador com fontes, os métodos de pesquisa profunda e o custo por sucesso.
Ao testar Carbon em um fluxo no navegador, separe acesso ao modelo e execução local com o guia Tabbit CLI, a conexão ao navegador existente, a lista da primeira tarefa, a automação local e o guia de navegador agêntico.
Leia cada benchmark junto com sua configuração
A ficha do modelo é mais útil quando a pontuação vem acompanhada do nome da tarefa, versão, ferramenta e condições de entrada. Um bom resultado em grafos com contexto longo não prova que o Carbon navegue corretamente uma conta empresarial; um teste de código não mede qualidade de citações. Avaliações do fornecedor ajudam a escolher um piloto e relatos apontam questões como tokens e tempos limite, mas nenhum substitui testes repetidos com resultados aceitos por você. A pergunta útil não é ‘Carbon é bom?’, e sim ‘ele conclui esta tarefa definida dentro do custo e prazo que aceitamos?’
Use as evidências publicadas como ponto de partida, não como promessa para seu trabalho. Antes de enviar dados sensíveis ou assumir gastos recorrentes, confirme o modelo, as condições da conta e os resultados medidos.

Perguntas frequentes
Vale a pena testar o Gemini 4 Carbon?
Faça um piloto limitado em uma tarefa difícil se sua conta oferecer o modelo. As evidências públicas não provam que ele seja adequado a todo trabalho.
Os benchmarks preveem meu resultado?
Não. Dependem da tarefa, ferramenta, versão e configurações. Use-os para formular um teste e meça seu próprio caso.
A ficha do modelo informa limitações?
Sim. Ela menciona mais tokens em raciocínio alto e aponta latência, tempos limite e alucinações, sem apresentar uma taxa geral de falha.
Carbon navega páginas com minha sessão ativa?
O modelo não controla o navegador sozinho. É necessário um host local, conector, conta e sessão autorizada separados.
Como avaliar um piloto?
Repita uma tarefa segura com entrada e critérios fixos. Confira fatos, omissões, tempo, tokens e custo antes de ampliar o uso.