
Gemini 4 Carbon puede merecer una prueba controlada en tareas difíciles y de larga duración, pero la información pública no demuestra que sea el mejor para tu trabajo. Google lo orienta a los retos más complejos y dice que Argon sigue siendo adecuado para la mayoría de la ingeniería de software y el trabajo de conocimiento. La ficha reúne pruebas distintas; cada resultado depende de su tarea y entorno, y no equivale a una tasa general de éxito.
Lo que cuentan los usuarios
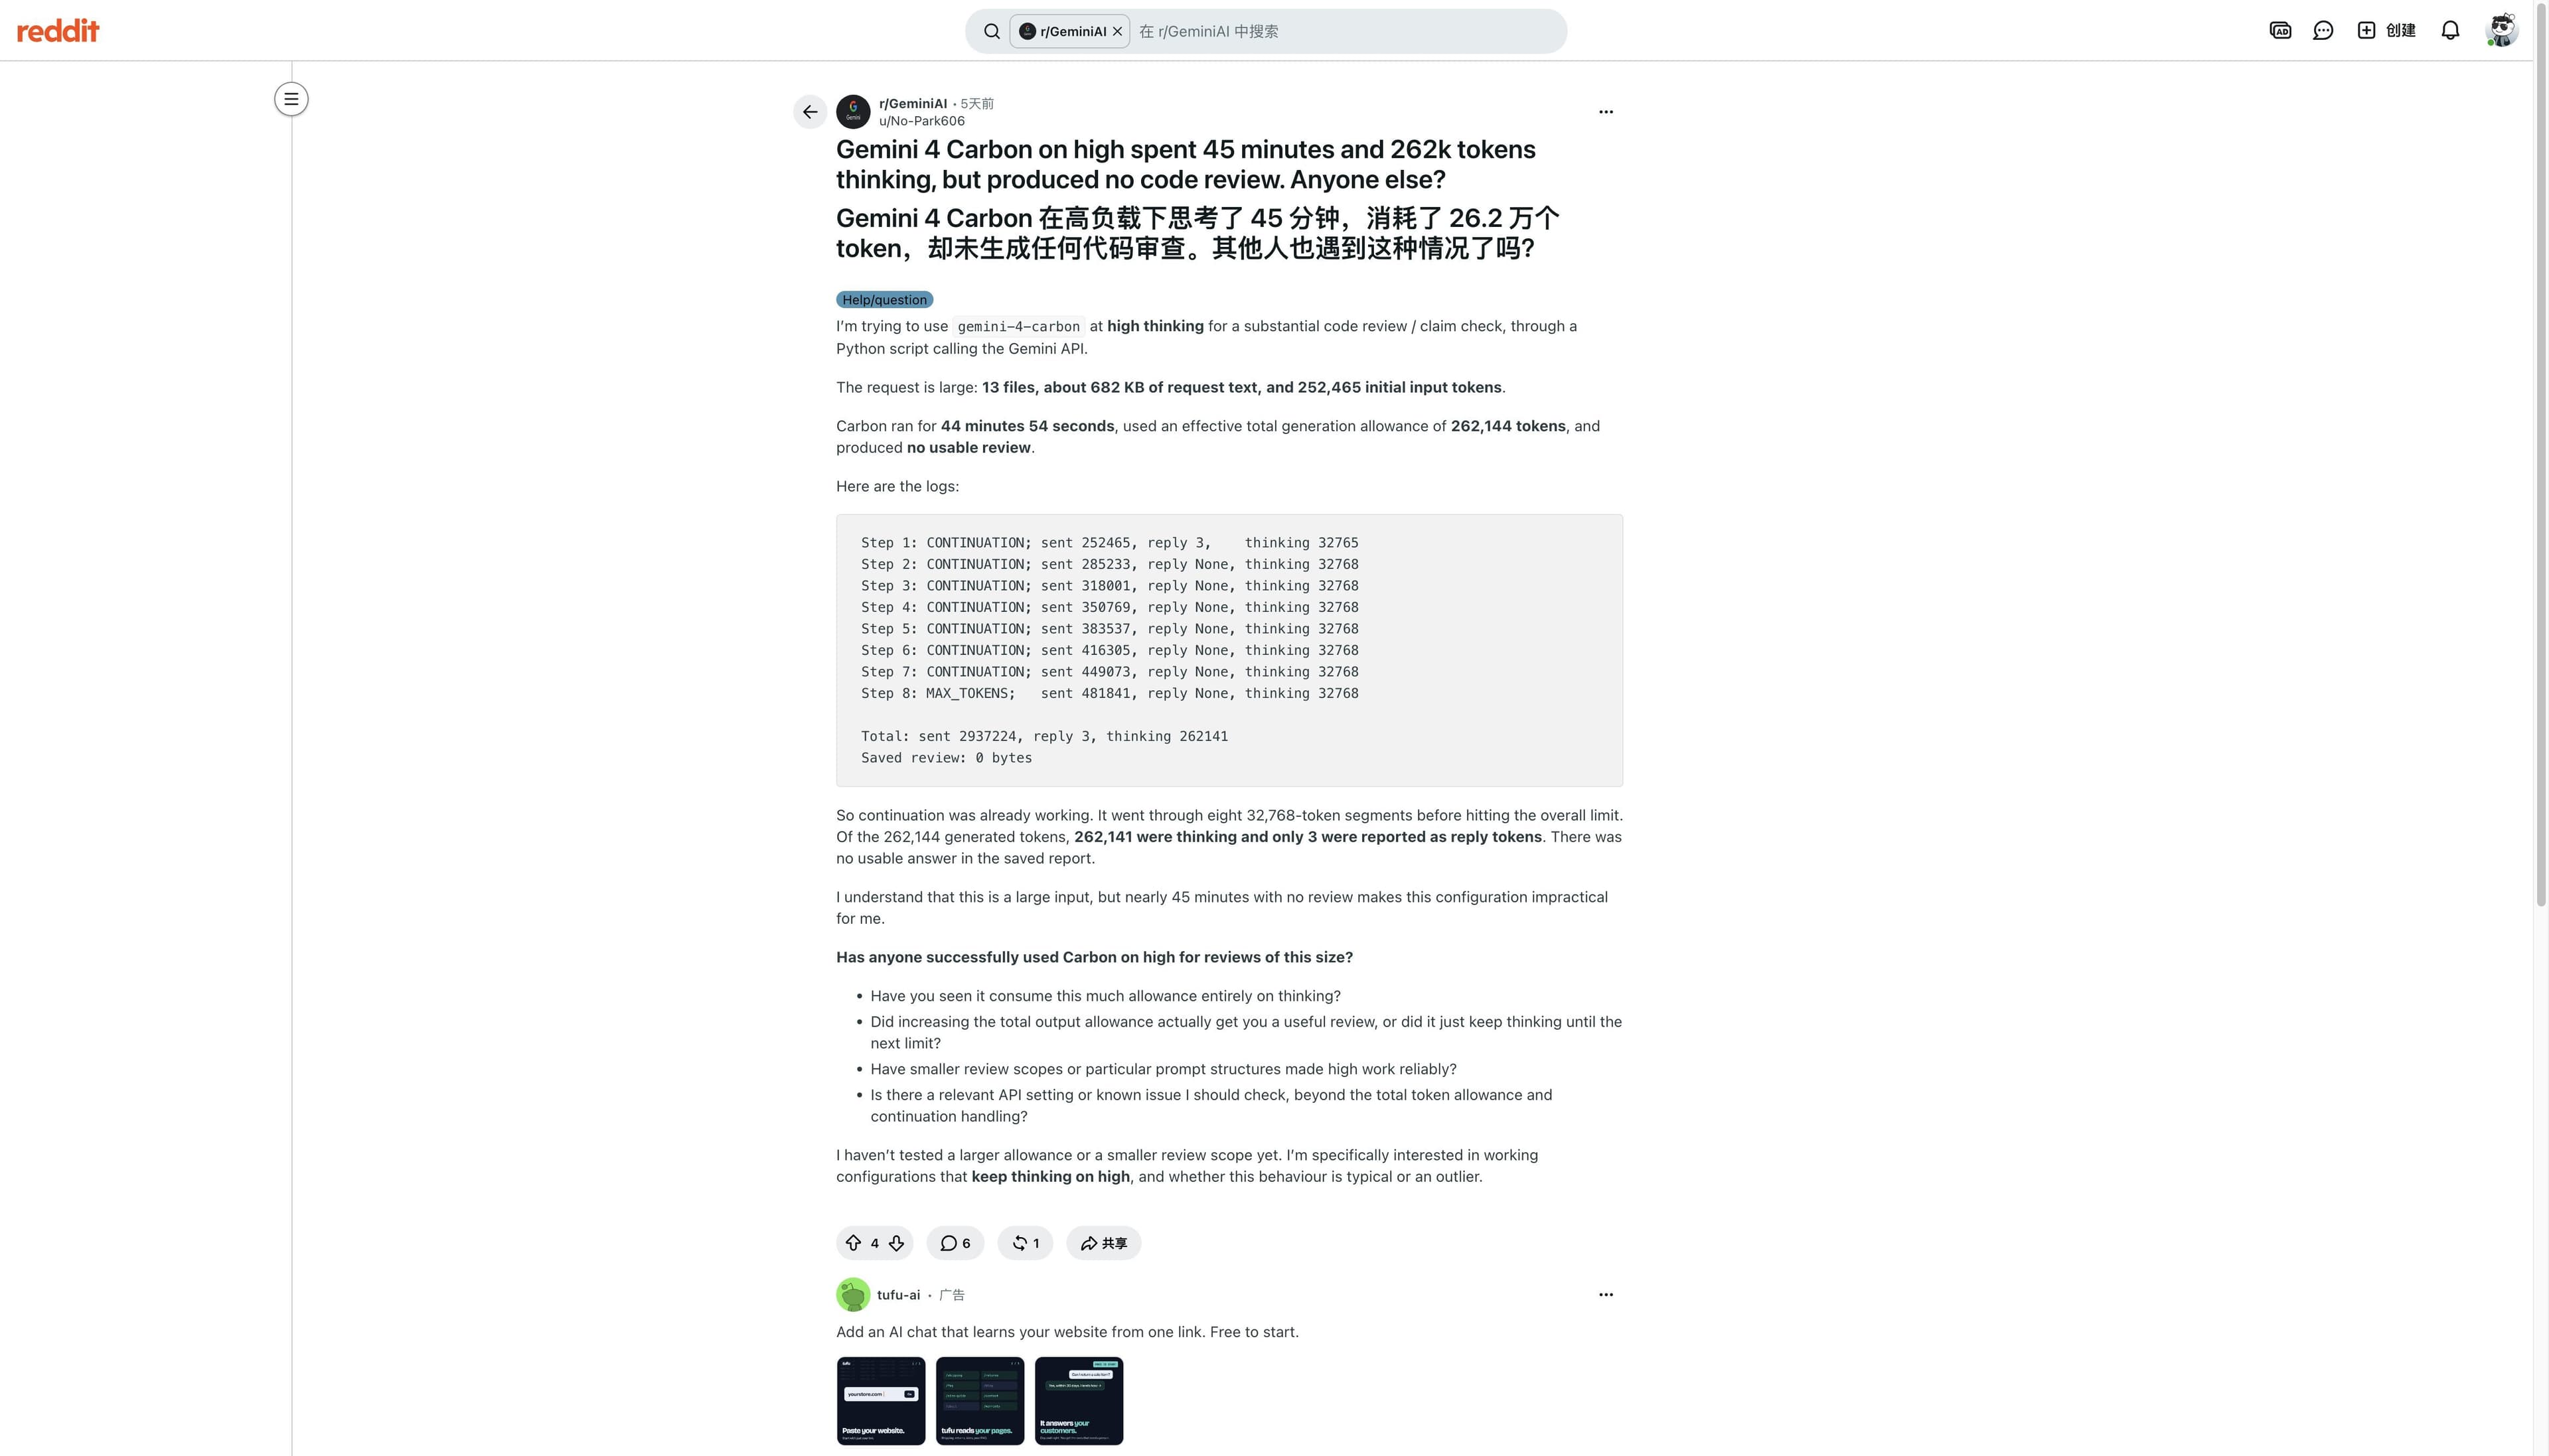
Un usuario de Reddit afirma que una revisión de 13 archivos con razonamiento alto tardó unos 45 minutos, consumió 262.141 tokens de razonamiento y no produjo un informe útil. Es un único fallo con una configuración concreta, no una tasa general de fiabilidad. La captura conserva la descripción y los datos visibles. Lee el post.
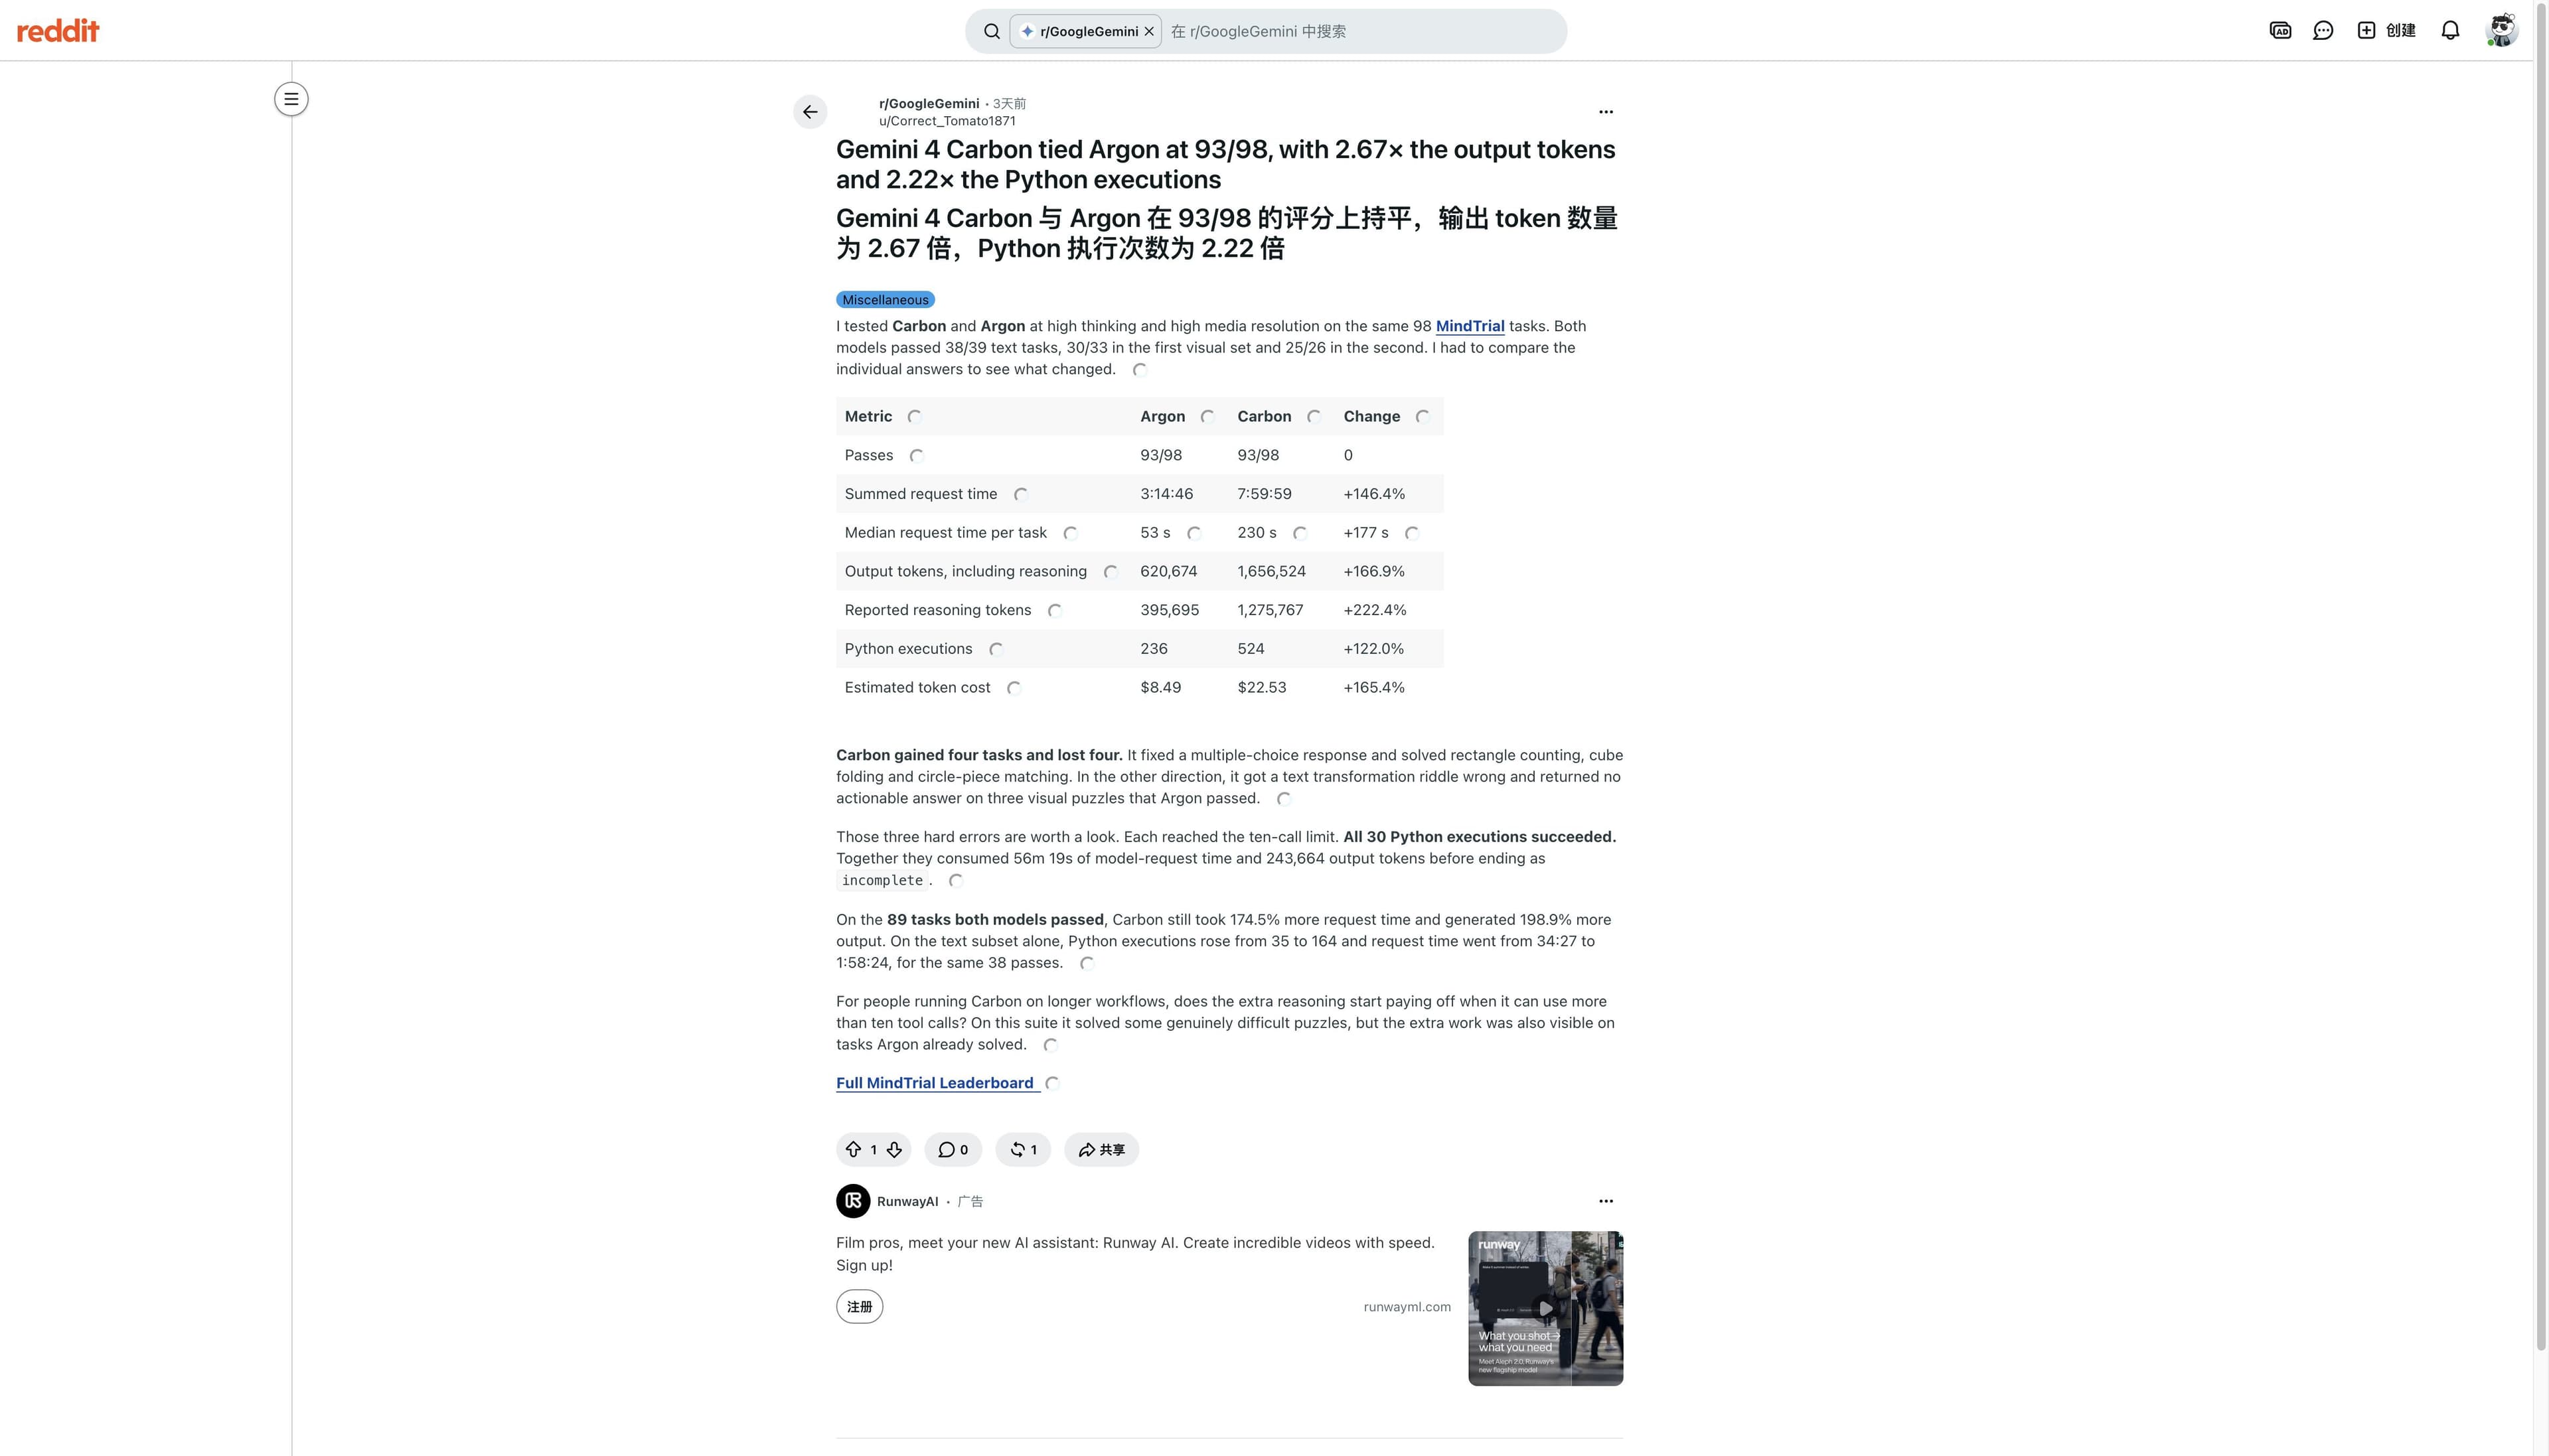
Otro usuario comparó Carbon y Argon en 98 tareas MindTrial: ambos obtuvieron 93/98; Carbon usó 2,67 veces los tokens de salida y tardó 2,46 veces más, con costos estimados por el autor de $22,53 y $8,49. Es un autoinforme útil para diseñar una prueba de costo por tarea aprobada, no una puntuación replicada. Lee el original.
Conclusiones de la reseña
Google orienta Carbon a sus tareas más difíciles y largas; eso justifica un piloto, no una recomendación independiente.
La ficha reúne benchmarks distintos; versión, entorno y tarea importan más que una sola puntuación destacada.
Google advierte más tokens con razonamiento alto y menciona latencia, esperas y alucinaciones; no publica una tasa general de éxito.
Los relatos muestran variación por tarea, pero aquí no hay una prueba Carbon en Tabbit ni un ensayo controlado repetido.
Tabla práctica para decidir
| Tarea | Qué respaldan las fuentes | Qué no está probado | Siguiente comprobación |
|---|---|---|---|
| Vendor benchmarks | Model card names task, harness and score | General reliability on your workload | Reproduce a benign task |
| User reports | Individual Reddit/X experiences | Population-level result | Keep prompts and settings attached |
| High-thinking work | Vendor notes higher token use and possible latency/timeouts | Fixed quality-per-dollar advantage | Measure tokens and accepted output |
Convierte la afirmación en una prueba
Antes del piloto, define qué respuesta será aceptable. Usa entradas de solo lectura y una salida inocua; repite con el mismo contexto y rúbrica. Anota aciertos, omisiones, tiempo, tokens de entrada/salida y costo. Si hay un error, separa lo atribuible al modelo, al prompt o a las fuentes; no cambies la tarea entre ejecuciones.
La ficha de Carbon de Google informa, entre otros, 65,2 % en Terminal-Bench 4.0 (AA), 77,4 en Agents’ Last Exam v1.1 y F1 de 96,2 % en GraphWalks con una configuración BFS indicada de 256k–1M. Son pruebas diferentes. Artificial Analysis muestra ahora el índice v5.0.1 y la captura de Google dice v5.0; 59 frente a «hasta 60» no prueba una mejora temporal.
| Evidence | What it can tell you | What it cannot tell you |
|---|---|---|
| Vendor benchmark | Performance on named task and harness | Your production success rate |
| Community task report | A person’s experience under their own setup | Independent replication or average cost |
| Your pilot | Fit for the chosen task and rubric | All future prompts or account configurations |
El modelo ya se anunció públicamente, pero el acceso depende del producto y la cuenta. Google menciona Gemini API y AI Studio para desarrolladores y empresas, y la app Gemini Ultra para consumidores. Comprueba el selector y la pantalla de facturación que usarás.
Dónde encaja Tabbit
Tabbit pertenece a la capa de navegador y flujo de trabajo; no demuestra que Carbon controle por sí solo un navegador con sesión. La guía de navegador con Carbon explica la diferencia entre acceso al modelo y ejecución local. Este artículo no presenta una prueba de Carbon en Tabbit: el método anterior es una propuesta, no un resultado.
Para reunir evidencia repetible, consulta las notas de investigación multimodelo, la investigación web con fuentes, los métodos de deep research y el costo por éxito.
Si pruebas Carbon en un flujo web, separa acceso al modelo y ejecución local con la guía de Tabbit CLI, la conexión a navegador existente, la lista de primera tarea, la automatización local y la guía de navegadores agentivos.
Lee los benchmarks junto con su configuración
Una ficha sirve más cuando cada puntuación conserva el nombre de la tarea, la versión, el entorno y las condiciones de entrada. Un buen resultado en grafos con contexto largo no demuestra que Carbon navegue con precisión una cuenta empresarial; una prueba de código no mide la calidad de las citas. Las pruebas del proveedor ayudan a escoger un piloto y los mensajes de usuarios plantean cuestiones prácticas como tokens o esperas, pero ninguno sustituye pruebas repetidas con resultados aceptables propios. La pregunta útil es si Carbon completa esta tarea concreta con el estándar, costo y demora que puedes aceptar.
Toma la evidencia publicada como punto de partida, no como promesa para tu trabajo. Antes de enviar datos sensibles o fijar un gasto recurrente, verifica el modelo, las condiciones de la cuenta y el resultado medido.

Preguntas frecuentes
¿Merece la pena probar Gemini 4 Carbon?
Haz un piloto acotado para una tarea difícil si tu cuenta ofrece el modelo. La evidencia pública no demuestra que sea adecuado para todos los trabajos.
¿Los benchmarks predicen mi resultado?
No. Dependen de la tarea, el entorno, la versión y los ajustes. Úsalos para plantear una pregunta y mide tu propio caso.
¿La ficha del modelo reconoce límites?
Sí. Menciona más tokens con razonamiento alto y señala latencia, tiempos de espera y alucinaciones, sin dar una tasa universal de fallos.
¿Carbon puede navegar mis páginas con sesión iniciada?
El modelo no controla por sí solo un navegador. Hace falta un host local, conector, cuenta y sesión autorizada por separado.
¿Cómo evalúo un piloto?
Usa una tarea segura, entrada y rúbrica fijas y varias ejecuciones. Comprueba hechos, omisiones, tiempo, tokens y costo antes de ampliar el uso.