
Gemini 4 Carbon 可以作为高难度、长流程任务的受控试用候选,但公开资料无法证明它适合所有工作,也没有证明它对你的任务最好。Google 将 Carbon 定位为处理最难任务的模型,并表示 Argon 仍适合大多数软件工程和知识工作。模型卡的基准涉及不同任务与测试环境,应逐项看待,不能换算成通用成功率。
用户实测分享
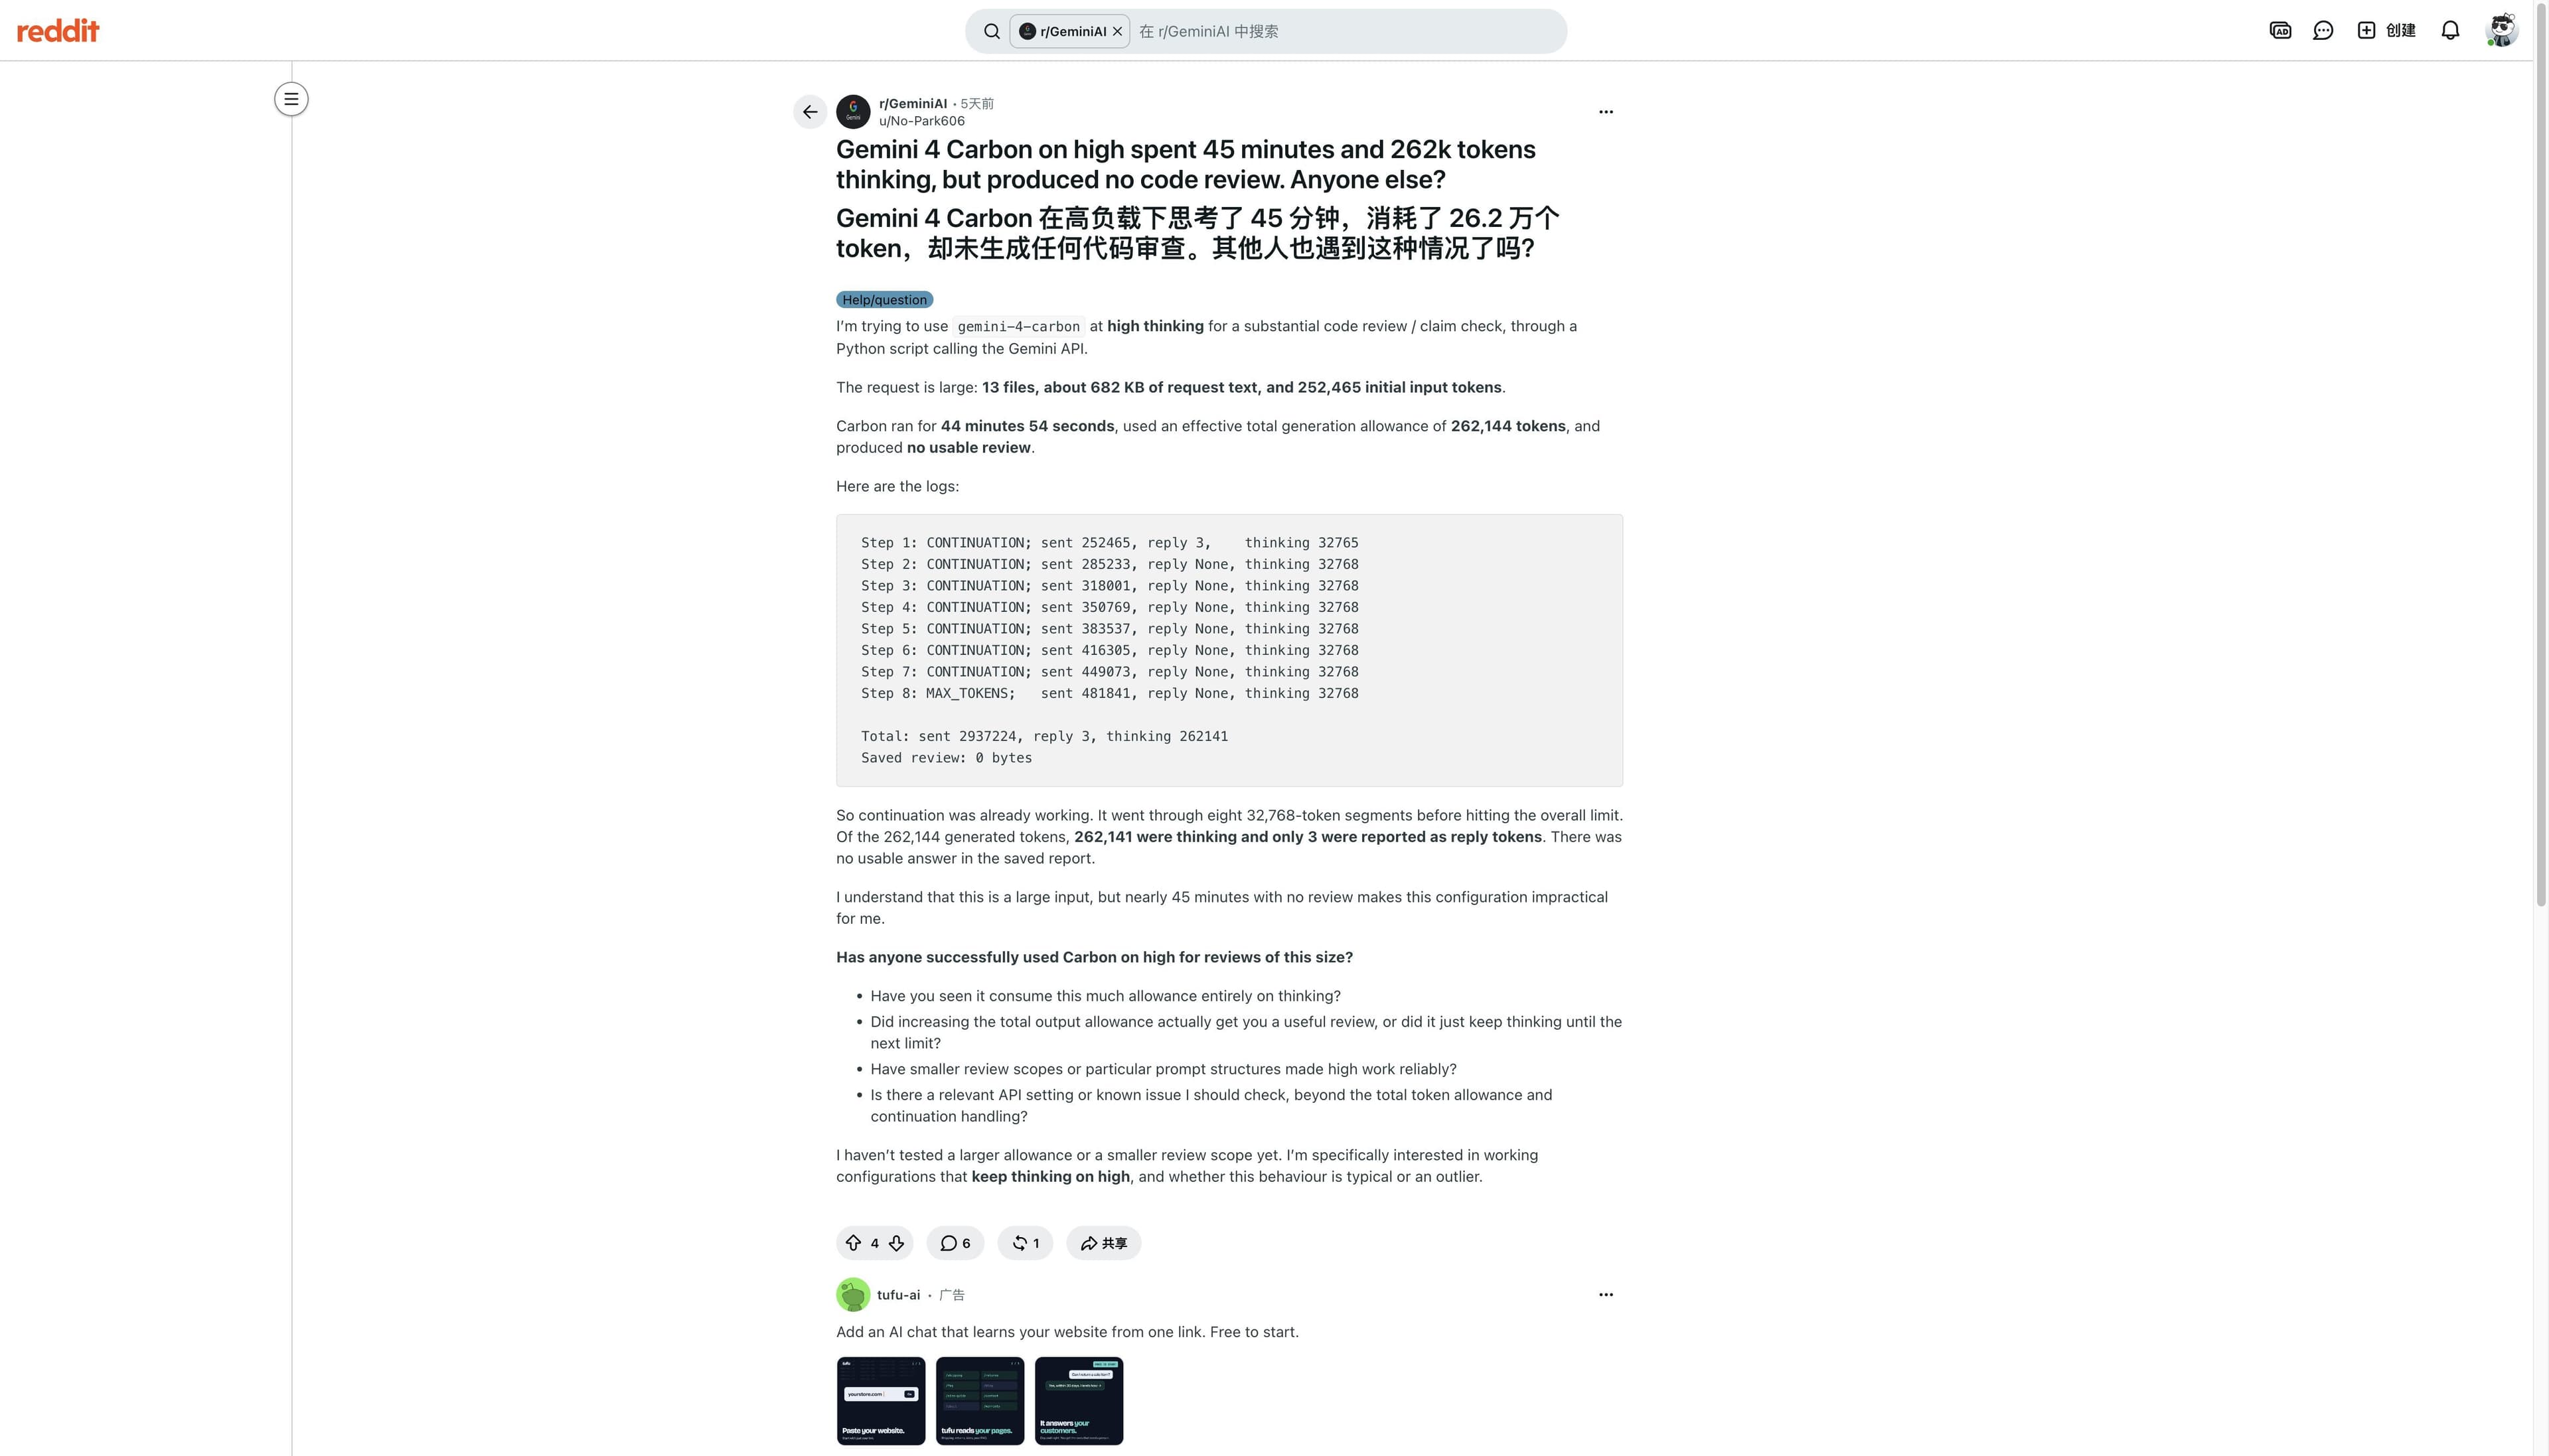
一位 Reddit 用户称,Carbon 在高思考设置下审阅 13 个文件约 45 分钟,消耗 262,141 个思考 token,却没有生成可用审阅。这是一个配置下的一次失败,不代表普遍可靠性。截图保留了作者任务描述与页面显示的数据。查看原帖。
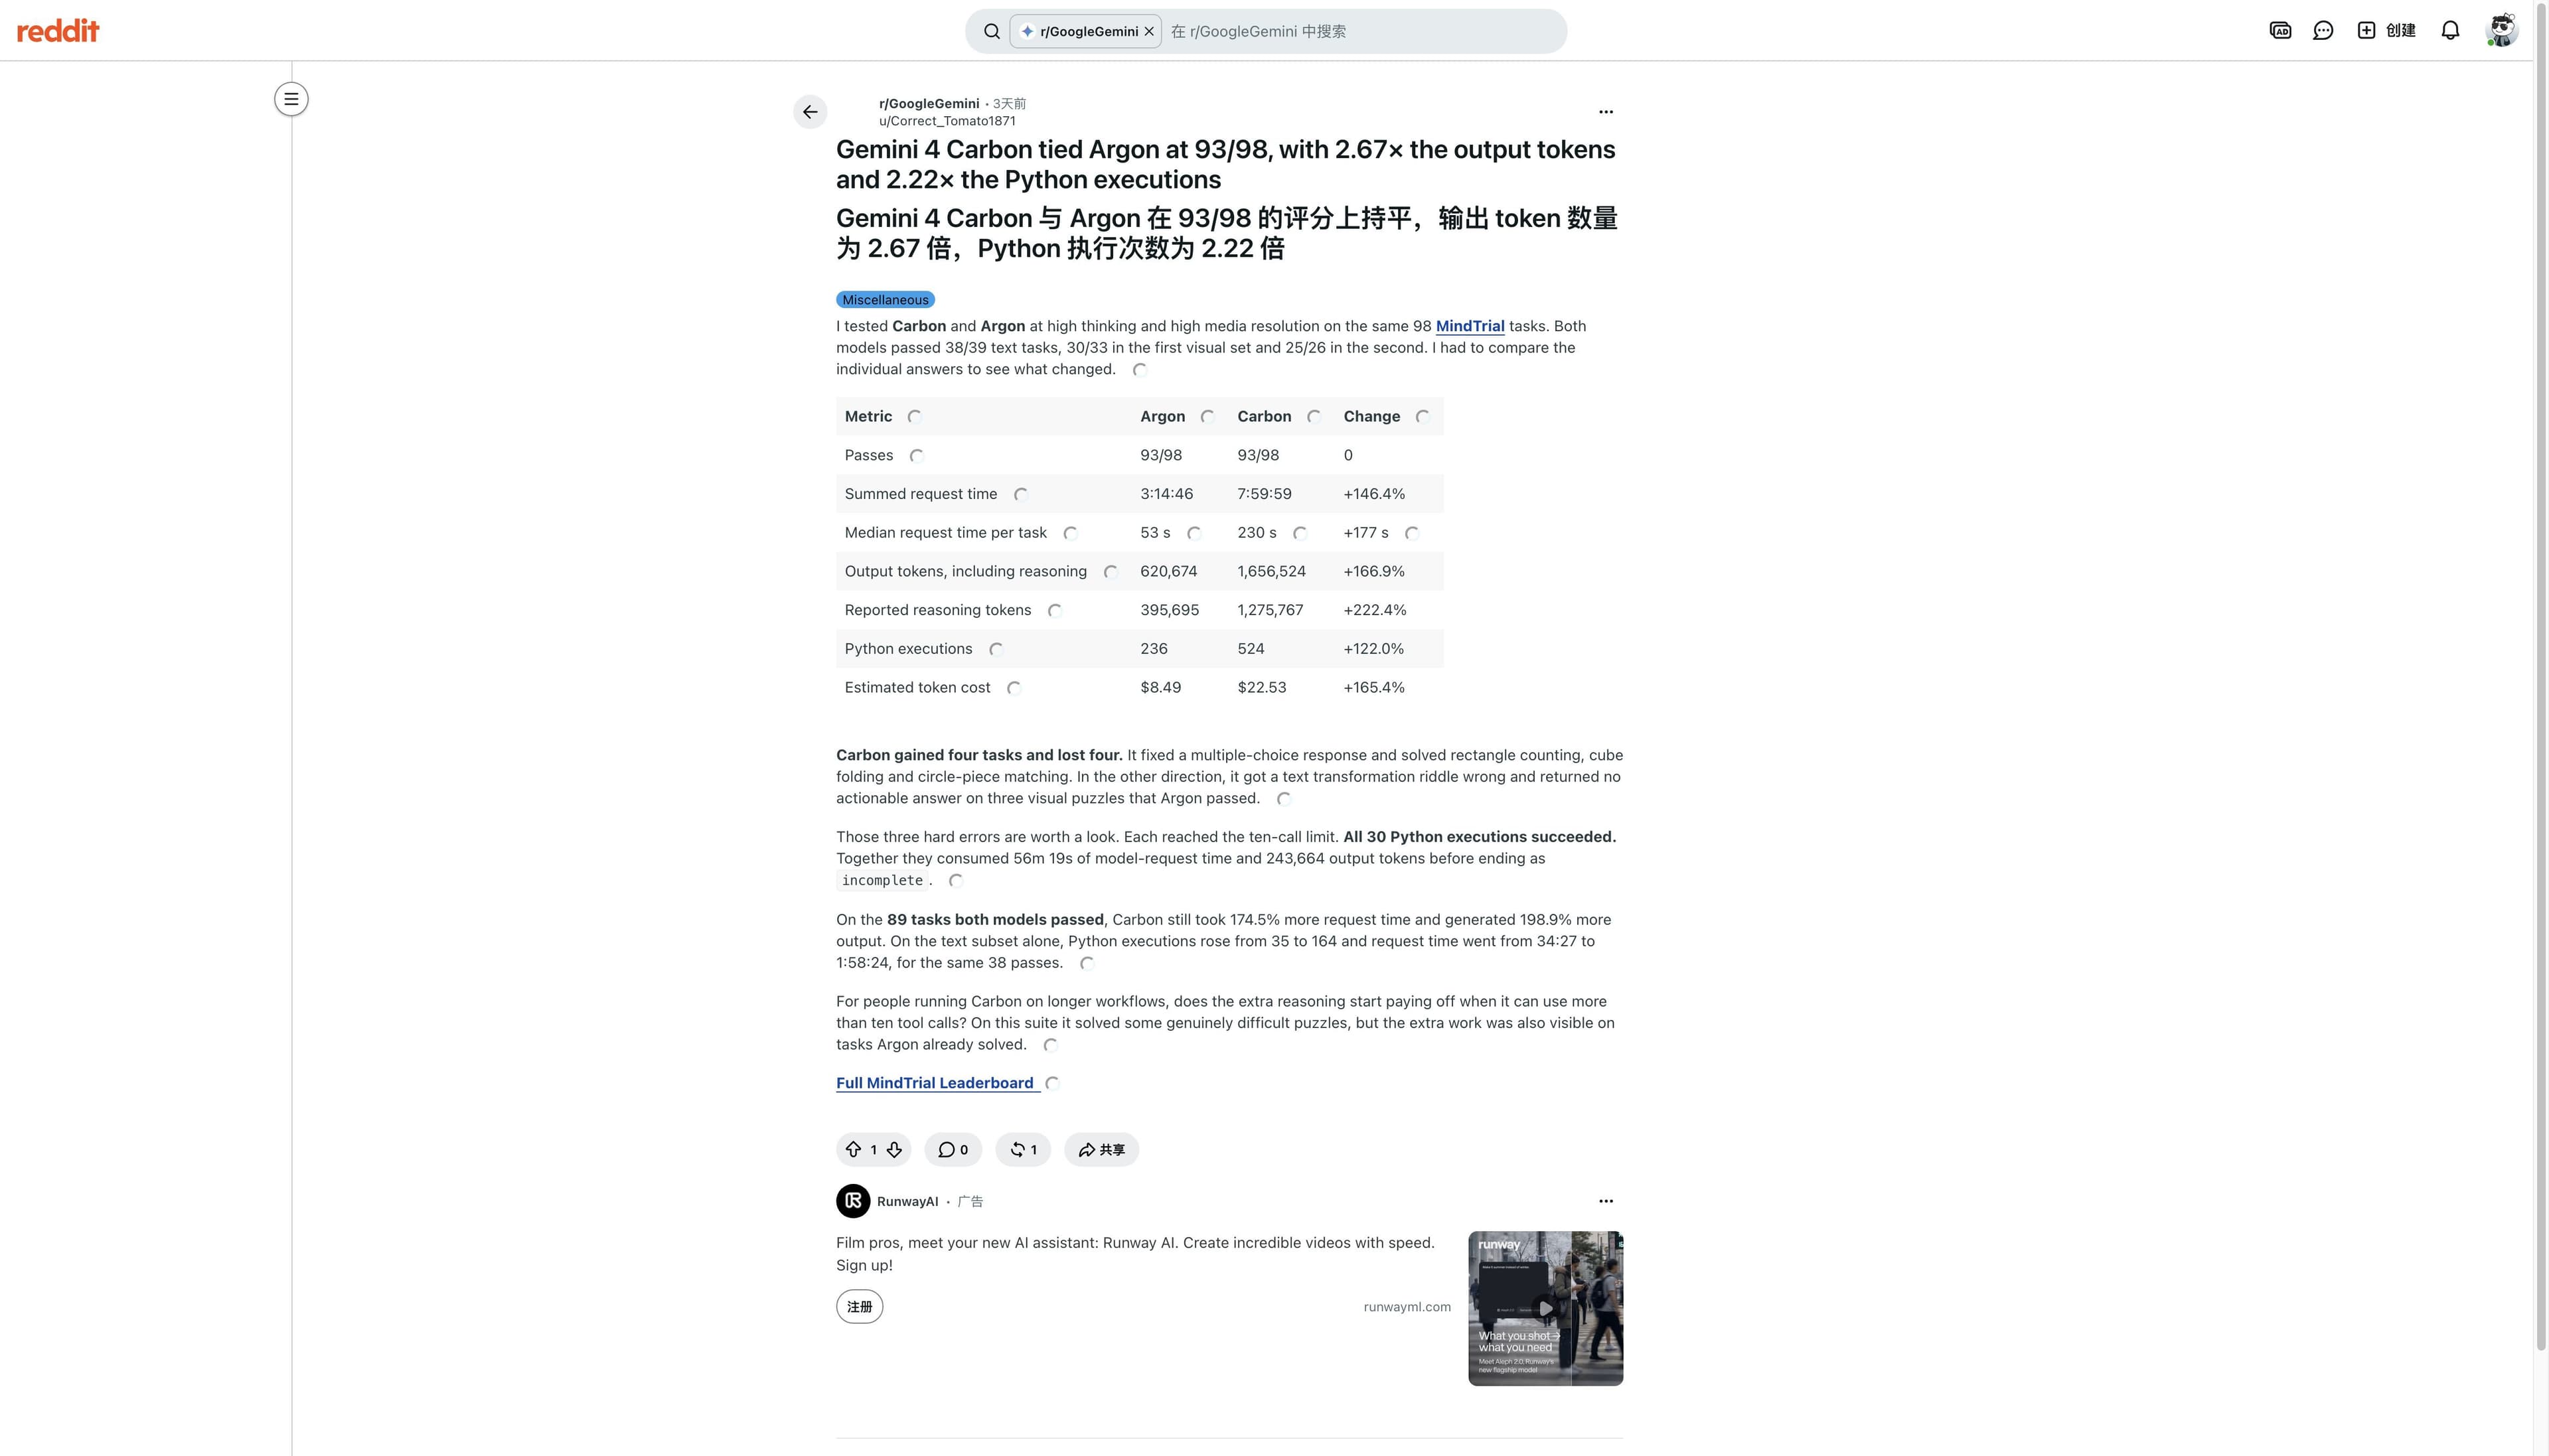
另一位 Reddit 用户在 98 道 MindTrial 任务中比较 Carbon 和 Argon,报告两者均为 93/98;Carbon 输出 token 多 2.67 倍、耗时 2.46 倍,作者估算成本分别为 $22.53 与 $8.49。这是自述结果,可用于设计每个通过任务的成本测试,不能视为复现分数。查看原帖。
评测结论
Google 将 Carbon 定位为最难、长流程任务的模型;这说明可考虑试用,不是独立推荐。
模型卡报告的是不同基准结果;版本、测试工具和任务范围比单一标题分数更重要。
Google 提到高思考设置会增加 token 用量,并披露延迟、超时和幻觉风险;没有通用成功率。
用户报告显示不同任务差异很大;本文没有经核实的 Tabbit Carbon 实测或重复对照试验。
实际决策表
| 任务 | 资料支持什么 | 尚未证明什么 | 下一步检查 |
|---|---|---|---|
| Vendor benchmarks | Model card names task, harness and score | General reliability on your workload | Reproduce a benign task |
| User reports | Individual Reddit/X experiences | Population-level result | Keep prompts and settings attached |
| High-thinking work | Vendor notes higher token use and possible latency/timeouts | Fixed quality-per-dollar advantage | Measure tokens and accepted output |
把结论转成任务测试
试用前先写明合格答案的标准。使用只读输入和无害输出,以相同上下文和评分规则重复任务。记录正确性、遗漏、耗时、输入/输出 token 与费用。出现错误时,区分模型、提示和来源材料的问题,不要在不同模型间暗中改变任务。
Google 的 Carbon 模型卡列出多项结果,包括 Terminal-Bench 4.0 (AA) 65.2%、Agents’ Last Exam v1.1 为 77.4,以及特定 256k–1M BFS 设置下 GraphWalks F1 为 96.2%。这些分属不同评测。Artificial Analysis 当前标注的指数版本为 v5.0.1,Google 卡片的快照为 v5.0;不能把 59 与“最高 60”当成前后提升。
| Evidence | What it can tell you | What it cannot tell you |
|---|---|---|
| Vendor benchmark | Performance on named task and harness | Your production success rate |
| Community task report | A person’s experience under their own setup | Independent replication or average cost |
| Your pilot | Fit for the chosen task and rubric | All future prompts or account configurations |
Carbon 已公开发布,但具体可用性取决于产品和账户。Google 公告列出开发者和企业可通过 Gemini API、AI Studio 使用,消费者可在 Ultra 版 Gemini 应用中使用。请检查你实际要用的产品选择器和计费页面。
Tabbit 适合放在哪一层
Tabbit 属于浏览器与工作流层,不能证明 Carbon 本身可控制已登录的浏览器。现有 Carbon 浏览器使用指南说明了模型访问和本地浏览器执行的区别。本文没有报告 Tabbit 上的 Carbon 基准或实测;上面的测试只是方案,不是结果。
开展可复现的证据工作,可看多模型研究记录、带来源的浏览器研究、深度研究方法和成功任务成本框架。
若要把 Carbon 放进浏览器工作流测试,请通过Tabbit CLI 指南、连接现有浏览器步骤、首个任务清单、本地自动化指南和智能体浏览器说明区分模型访问与本地执行。
基准分数必须连同测试设置一起看
模型卡只有把分数与任务名称、版本、测试工具和输入条件放在一起时才有参考价值。长上下文图任务的高分不能说明 Carbon 能准确浏览企业账户;代码基准也不测引用质量。厂商测试可帮助挑选试用场景,社区帖子会提出 token 用量、超时等实际问题,但两者都不能代替对验收结果的重复测试。更有用的问题不是“Carbon 好不好”,而是“Carbon 能否按我们的标准完成这个明确任务,且成本和延迟可接受?”
把公开证据当作测试起点,而不是对你任务结果的保证。投入敏感数据或固定预算前,先核对当前模型、账户条款和实测结果。

常见问题
Gemini 4 Carbon 值得试用吗?
如果账户能选择该模型,可针对一个困难任务做有边界的试用。公开证据不能证明它适合所有工作。
基准分数能预测我的结果吗?
不能。分数取决于任务、测试工具、模型版本和设置。可用它提出测试问题,再测自己的任务。
模型卡是否披露限制?
有。它提到高思考设置下 token 用量较高,也指出延迟、超时和幻觉问题,但没有给出通用失败率。
Carbon 能浏览我的登录页面吗?
模型本身不会控制浏览器。浏览能力取决于独立的本地宿主、连接器、账户和获授权的网站会话。
如何评估试用结果?
用无害任务、固定输入、评分标准并重复运行。扩展使用前检查事实、遗漏、时间、token 和成本。