
Muse Spark Open 是 Meta 在 Muse 家族中第一個開放權重模型:總參數 8,160 億,每 token 啟動 420 億,上下文視窗 100 萬 token,原生接受文字、圖像、音訊、影片輸入。Meta 於 2026 年 10 月 15 日將權重放上 Hugging Face,並在 7 家託管平台同步上線 API,官方稱之為「迄今最強的美國開放權重模型」。但大多數人第一個問題不在跑分上。正如 Hacker News 上一位評論者所寫,Meta 建議的組態是「a pair of Mac Studios w/ M5 Ultra chips and 512 GB of RAM. A single Mac Studio w/ M5 Ultra and half that RAM (256 GB) is around $11k, and the 512 GB option isn't even available yet. So.... yeah.」(HN 討論)
本文算清硬體帳、逐條解讀 Muse Model License、核對首日 API 定價與獨立基準,並把它與 GLM 5.3、Kimi K3 放在同一把尺上對比。後半部分還會講「第三條路」:不自建機房,而是透過產品使用這樣的模型。
Key takeaways
Muse Spark Open 是 Meta Muse Spark 的開放權重版:816B 總參 / 42B 啟動的稀疏 MoE,上下文 1,048,576 token,多模態輸入、文字輸出,面向程式設計與 agentic 工作負載。
關鍵數字:每個 token 只動用 42B 參數,但服務時必須載入全部 816B——BF16 約 1.65TB,NVFP4 約 537GB,外加快取開銷。
本地執行意味著兩台 512GB 的 M5 Ultra Mac Studio 跑 MLX,或一台 4-GPU Blackwell 節點跑 NVFP4。一般桌上型電腦無緣;單台 256GB Mac Studio 也要約 1.1 萬美元。
Muse Model License 允許商用但不是開源:產品必須展示 “Built with Muse Spark Open” 標示;模型即服務且 12 個月營收超過 2,000 萬美元需與 Meta 另簽協議。
獨立視角(Artificial Analysis,2026-10-19):Intelligence Index 39,輸出 142 token/秒,單任務約 0.84 美元——快而簡潔,但在同級開放權重模型中偏貴,Index 排名落後 GLM 5.3(45)與 Kimi K3(44)。
首日託管定價約 $1.25/M 輸入、$4.25/M 輸出、快取讀取約 $0.15/M,提供商包括 Together AI、Fireworks、Baseten、Modal、OpenRouter 等。
Muse Spark Open 一覽
| 項目 | 內容 | 來源 |
|---|---|---|
| 發布 | 2026 年 10 月 15 日,Meta Superintelligence Labs | Meta 研究部落格 |
| 參數 | 816B 總參,每 token 啟動 42B;稀疏 MoE,每層 256 個 expert、每 token 選 8 個(模型卡口徑) | Meta 開發者文件 |
| 上下文 | 1,048,576 token | Meta 開發者文件 |
| 輸入 / 輸出 | 文字、圖像、音訊、影片輸入;文字輸出 | Meta 開發者文件 |
| 權重規格 | BF16 ≈ 1.65TB(8 張 GPU,如 8×B300);NVFP4 ≈ 537GB(單台 4-GPU Blackwell 節點) | Meta 開發者文件 |
| 本地執行 | 兩台 M5 Ultra Mac Studio(各 512GB 統一記憶體)+ MLX;BF16 含 KV 快取約需 2TB 顯示記憶體 | Meta 研究部落格、開發者文件 |
| 託管 API | Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI | Meta 研究部落格 |
| 權重管道 | Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Models | Meta 研究部落格 |
| 授權 | Muse Model License(自訂,附條件商用)+ Acceptable Use Policy | Meta 開發者文件 |
| 定位 | 程式設計、長程 agentic 任務、多步推理;「迄今最強的美國開放權重模型」 | Meta 研究部落格 |
關鍵數字:42B 是新聞,816B 是帳單
所有標題都在講 8,160 億參數。真正決定你能不能用的,是另一個數字:420 億啟動參數。Muse Spark Open 是稀疏混合專家模型——每個 token 被路由到每層 256 個 expert 中的 8 個——因此每 token 的計算量只跟著 42B 啟動參數走。這就是它的延遲和單任務成本好看的原因。
但稀疏化並不縮小你必須承載的模型。Meta 開發者文件說得很直白:「serving still loads the full 816B weights into VRAM, which sets the hardware footprint.」BF16 權重約 1.65TB,加上 KV 快取、啟動值和執行時期開銷,Meta 文件建議按約 2TB 顯示記憶體預算——也就是 8 張 B300 級別的資料中心 GPU。NVFP4 檢查點把大部分權重量化到 4 位元,降到約 537GB,可放入單台 4-GPU NVIDIA Blackwell 節點。
桌面端是這次發布的主角。Apple 的統一記憶體架構讓 M5 Ultra Mac Studio 最高可尋址 512GB,兩台透過 Thunderbolt 串聯後,用 Meta 的話說「像一台擁有 1TB 統一記憶體的超級電腦」,1.2TB/s 的頻寬足以餵飽每個 token 所需的那一小片參數。Meta 示範了完全在裝置上執行的 agentic 流程——用 Muse Code 給開源 Mastodon 客戶端 Ice Cubes 提交真實改動,逐幀驅動 DaVinci Resolve 剪輯。
兩點需要保持誠實。第一,硬體還沒完全開賣:截至 2026 年 10 月 19 日,512GB 的 M5 Ultra Mac Studio 尚未上市、價格未公布;HN 評論者給單台 256GB 的估價約 1.1 萬美元,TechRepublic 測算四台 256GB 陣列超過 3.8 萬美元。第二,一位轉述 Apple Research MLX 文章的評論者稱,四台 Mac Studio 叢集「over 36 tokens per second」——agentic 工作可用,但遠談不上資料中心速度。(HN:硬體成本、HN:MLX 吞吐量)
社群對本地執行的結論很直白:「I was mistaken in my thinking that open models are able to be quantized to run on average consumer hardware, I think they have outgrown that concept.」(HN)如果你的機器是 32 或 64GB 記憶體,這個模型不是「下載就能跑」的。託管 API 才是現實入口。
它是什麼,不是什麼
Muse 的命名確實混亂,社群第一天就指出了:「The naming is a bit confusing, but there are two things called Muse... There are the models, such as Muse Spark, Muse Wonder, and this Muse Open. There there is 'Muse' itself which is a cloud based 'personal agent'.」(HN)
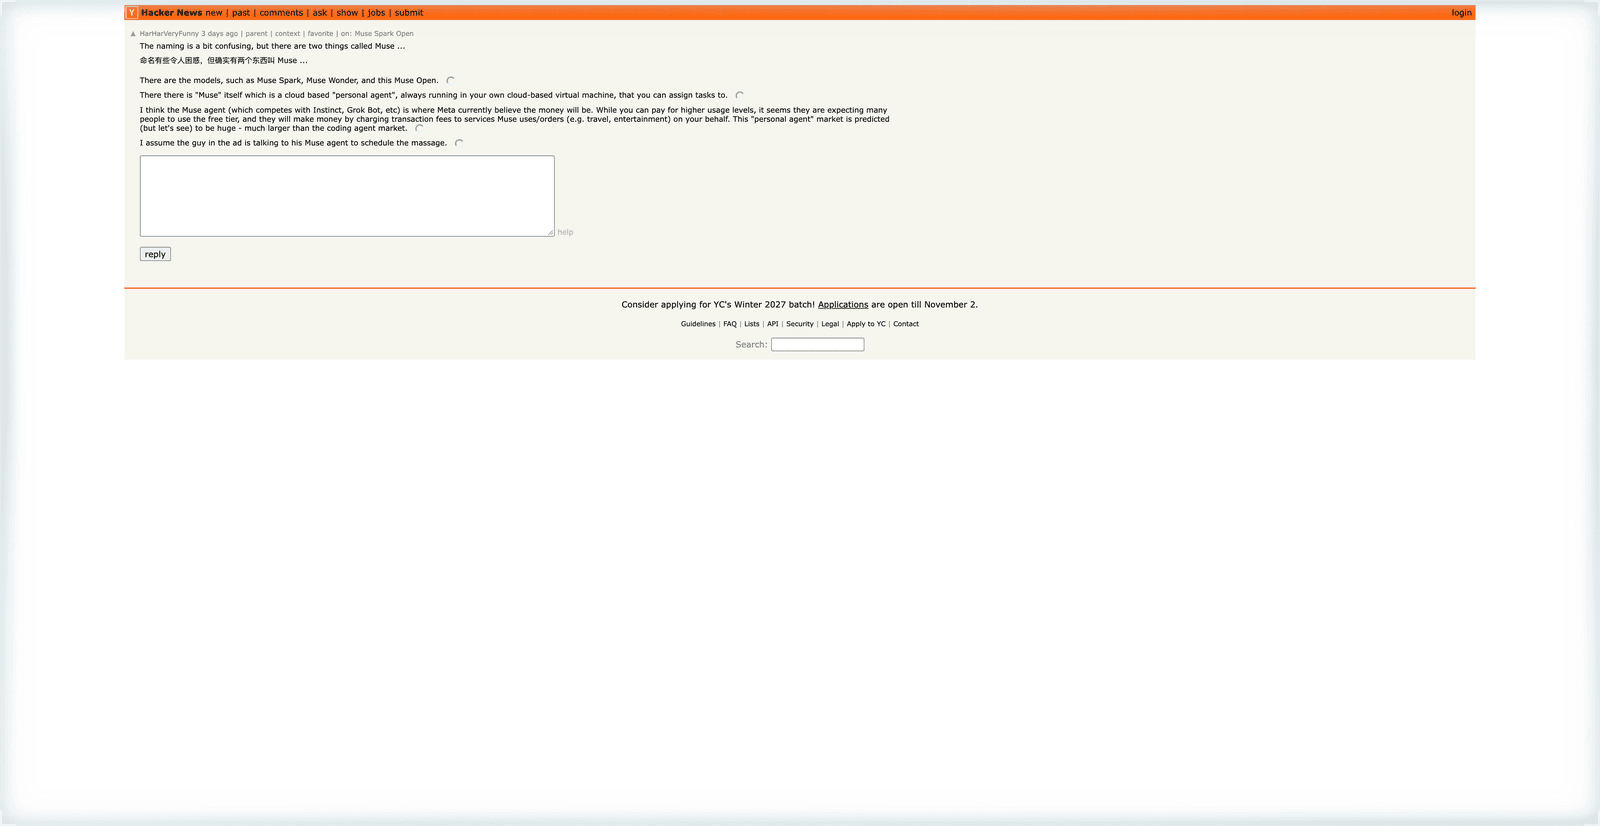
釐清版本:
Muse Spark 是 2026 年 4 月 8 日首發的託管模型線——Llama 時代之後 Meta 第一個專有模型家族。1.1(7 月)、1.2、1.3(9 月)各版本始終保持封閉,透過 Meta API 和 Muse Code 以 $1.25/M 輸入、$4.25/M 輸出提供服務。
Muse Wonder 於 2026 年 10 月 12 日發布,是位於 Spark 之上的封閉旗艦,標價 $4/M 輸入、$20/M 輸出。Meta 自己也沒有聲稱 Spark Open 勝過 Wonder。
Muse Spark Open 就是本文主角:Spark 系列的開放權重兄弟版本,同樣有 1M 上下文和多模態輸入,按自訂授權發布。
Muse 應用是面向消費者的代理產品,與權重無關。
基準:快、簡潔,在開放權重中偏貴
Artificial Analysis 的 Muse Spark Open(xhigh 推理檔)獨立頁面,核對於 2026 年 10 月 19 日:
| 指標 | Muse Spark Open | 解讀 |
|---|---|---|
| Intelligence Index | 39(開放權重同級約第 10/120;類別中位數 19) | 高於類別中位,落後領先的中國開放模型 |
| 輸出速度 | 142.2 token/秒(跨提供商中位) | 同類中明顯更快(類別中位約 78) |
| 首 token 延遲 | 0.81 秒 | 有競爭力 |
| 標價 | $1.25/M 輸入、$4.25/M 輸出,快取折扣 88% | 在開放權重中「偏高」 |
| 單 Intelligence Index 任務成本 | 約 $0.84 | 靠簡潔輸出勝出 |
| 冗長度 | 整個 Index 消耗 110M 輸出 token | 較簡潔(類別中位約 130M) |
AA 自己的總結值得引用:「amongst the leading models in intelligence, but particularly expensive when comparing to other open weight models of similar size. It's also notably fast and fairly concise.」兩點校準:第一,Index(v4.3.2)混合了十項評測(含 agentic 與長上下文套件),39 不是單科分數;第二,價格數字是提供商中位價,不是 Meta 官方標價——Meta 自家 API 並不託管這個開放權重變體。如果你正在為 agentic 瀏覽和程式工作流選模型,請把這個數字與我們的 agentic 瀏覽指南 合併閱讀,而不是只看一個榜單名次。
授權不是開源
「開放權重」在標題中承擔了很多重量。你可以下載 Muse Spark Open、微調它、蒸餾它、把它裝進商業產品。但 Muse Model License 是自訂授權,不是 Apache 2.0 或 MIT,條件更嚴:
必須署名。任何使用本模型或其衍生品的產品,都必須在介面、文件、網站或設定中展示 “Built with Muse Spark Open”。這條沒有營收門檻。
模型即服務門檻。如果你與關聯方在任意連續 12 個月內總營收超過 2,000 萬美元,並透過 API 或類似介面向第三方提供本模型,必須提前通知 Meta 並另行簽署書面協議。內部使用、研究、嵌入自有產品功能明確豁免。
可接受使用政策。授權附帶 AUP,禁止武器開發、惡意軟體、操作關鍵基礎設施、詐欺、虛假訊息和冒用身份;模型不面向 18 歲以下使用者。
輸出權利。Meta 不主張對模型生成內容的權利——這一條比經典開源還乾淨。
下載摩擦。從 Hugging Face 下載權重需填實法定姓名、出生日期、企業資訊——是註冊門檻,不是點個同意。
如果你想要這個級別真正寬鬆的開放權重模型,GLM 5.3 的 MIT 風格授權是對照組,下文對比部分會展開。
如何取得
託管 API(零硬體):Baseten、Fireworks AI、Groq、Modal、Nebius、Together AI 直接提供;OpenRouter 以閘道路由列出。首日各提供商定價約為 $1.25/M 輸入、$4.25/M 輸出、快取讀取約 $0.15/M——與託管版 Muse Spark 1.2 同價,推測是 Meta 定了錨點、各家跟齊。
GPU 自託管:BF16(約 1.65TB)面向 8 卡節點;NVFP4(約 537GB)可上單台 4-GPU Blackwell 節點。Meta 在 SGLang 中提供可自動調校的 Helion 核心,官方稱 NVIDIA 與 AMD 上核心級加速 1.03–3.95 倍,AMD MI350 端到端再快 3%。vLLM、TensorRT-LLM、llama.cpp、Unsloth 首日全部支援。
Mac 自託管:兩台各 512GB 的 M5 Ultra Mac Studio 透過 MLX 執行,權重直接從 Hugging Face 拉取。Apple Research 另文件化了一個超過 36 token/秒的四機叢集。
雲端目錄:Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Models 提供權重,適合想要託管基礎設施的團隊。
這種部署廣度對開放權重發布來說確實少見,社群也注意到了:「They did the actual work of testing and documenting deployments on several platforms. It's a bit of upping the standard for open weights instead of just posting the blob and letting the community figure it out.」(HN)
與 GLM 5.3、Kimi K3 的同口徑對比
「美國開放權重冠軍」的說法,只有放到統治了這個榜單一整年的中國開放模型旁邊才有意義。同口徑資料(Artificial Analysis 資料,2026 年 10 月 16 日彙編;編列預算前請複核):
| 維度 | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| 廠商 | Meta(美國) | Z.ai(中國) | Moonshot AI(中國) |
| 參數 | 816B 總 / 42B 啟動 | 753B / 40B | 2.8T / 104B |
| 輸入 | 文字、圖像、音訊、影片 | 文字 | 文字、圖像 |
| Intelligence Index | 39 | 45 | 44 |
| 輸出速度 | 142 token/秒 | 67 token/秒 | 43 token/秒 |
| 單 Index 任務成本 | $0.84 | $2.01 | $2.00 |
| API 價($/M 輸入/輸出) | $1.25 / $4.25 | $1.40 / $4.40 | $3.00 / $15.00 |
| 授權 | Muse Model License(強制標示 + $20M MaaS 門檻) | MIT 風格(約 $10B 規模才有條件) | 自訂(類似 $20M MaaS 門檻) |
| 主要限制 | 自託管需 TB 級記憶體;強制標示 | 僅文字輸入 | 三者中標價最高 |
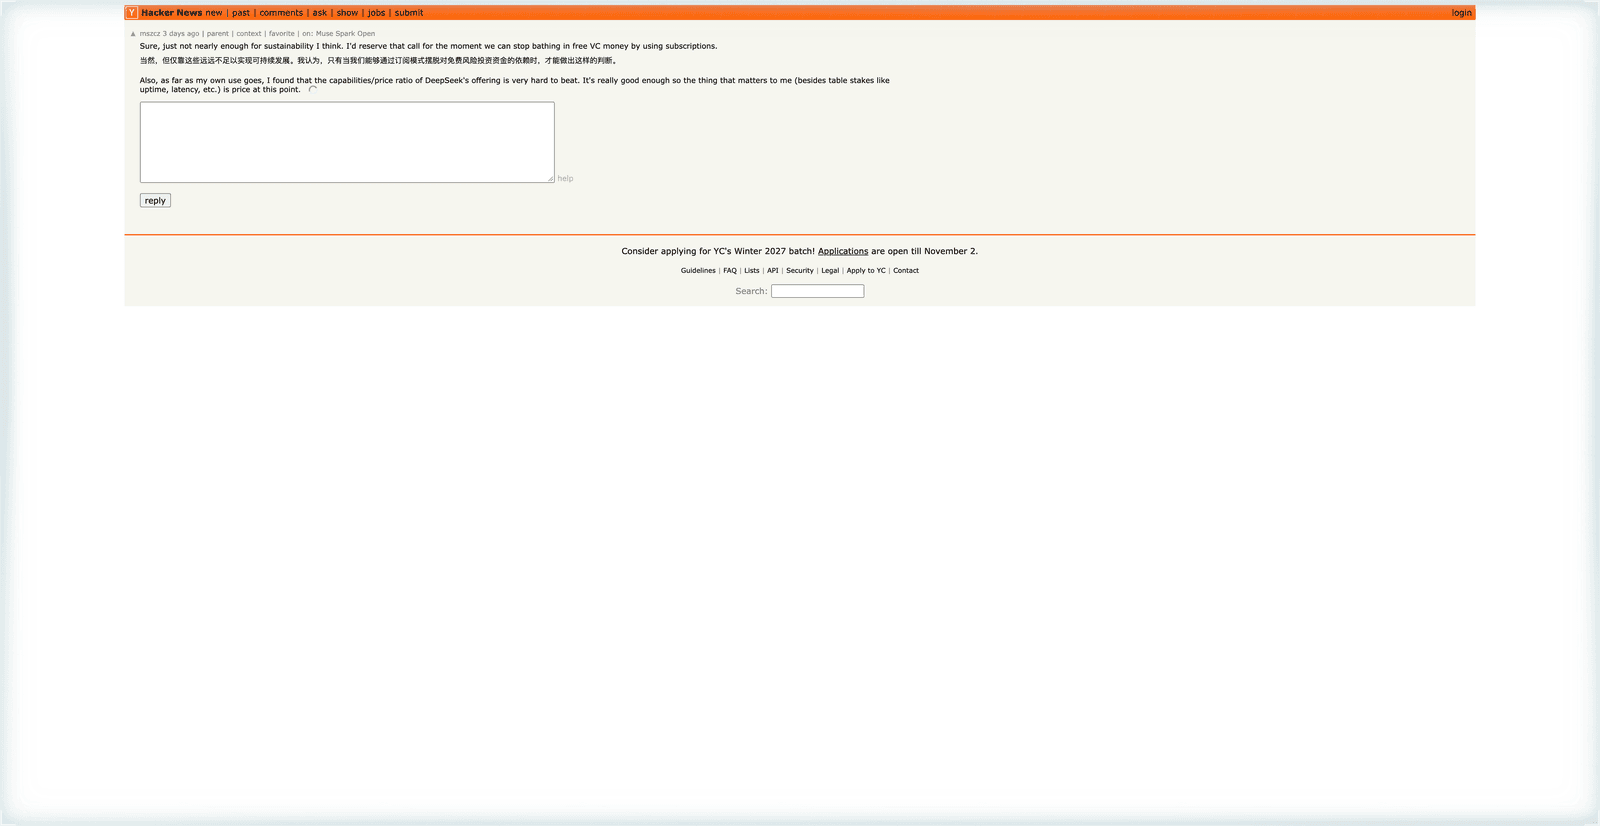
取舍很清楚。Muse Spark Open 在 Intelligence Index 上落後兩個對手,但把單任務成本大幅壓低——它用更少的輸出完成任務——而且是三者中唯一原生支援音訊和影片輸入的。一位 HN 評論者的說法與資料吻合:「the capabilities/price ratio of DeepSeek's offering is very hard to beat... the thing that matters to me (besides table stakes like uptime, latency, etc.) is price at this point.」(HN)
如果你的標準是絕對 Index 排名,它不是領頭羊;如果標準是帶多模態輸入的單個合格任務成本,它有競爭力。
關於模型選擇如何與工具層互動,可延伸閱讀我們對 Qwen3.8 Max、MiniMax M3 和 LongCat 2.0 的解讀——它們在同一個開放權重賽道裡做了不同的取捨。
使用者在說什麼
Hacker News 發布串的討論(截至 10 月 19 日約 917 分、約 478 則留言)兼有待興奮與硬體懷疑:
"I love seeing major ai labs release open-weight models. really hope we'll see more of this from openai and eventually anthropic too." —— shinokami
"I was mistaken in my thinking that open models are able to be quantized to run on average consumer hardware, I think they have outgrown that concept." —— twitexplore
"Anyone who has tried a smaller/quantized version locally on apple silicon? Would love to know your experience, also tk/s on what hardware specs?" —— nico。截至本文寫作,討論中提問多於一手本地實測報告——任何不附硬體細節的性能說法都應視為未驗證。
Reddit 的 r/LocalLLaMA 在幾天內開始補上這個缺口。一位在單台 Mac Studio 上執行模型的使用者回報解碼速度達到 18 t/s——「This is text only. Output is coherent and toolcalls solid.」(r/LocalLLaMA)同一週另一個跨模型討論串則直言:「'Runs locally' now officially means 'runs on a computer that costs more than a car.'」(r/LocalLLaMA)
第三條路:透過產品使用,而不是自建機房
這才是大多數讀者真正面對的決策。你的桌面上沒有 2.2 萬到 4 萬美元的 Mac Studio,也不想養 8 張資料中心 GPU。但你的工作——研究、程式設計、瀏覽器任務——確實需要一個前沿級開放模型和 1M 上下文。這個缺口,正是託管 API 和 AI 原生客戶端要填的。
Tabbit Browser 這樣的瀏覽器就處在這個位置。對 Muse Spark Open 這類模型,務實的用法不是自託管,而是在一個已經握有你上下文的客戶端裡選它(或同級的 agentic 模型)——眼前的網頁、分頁組、檔案——然後透過 agentic 瀏覽 或 瀏覽器自動化 讓它開始工作,而不是在獨立聊天視窗裡重建每個任務。
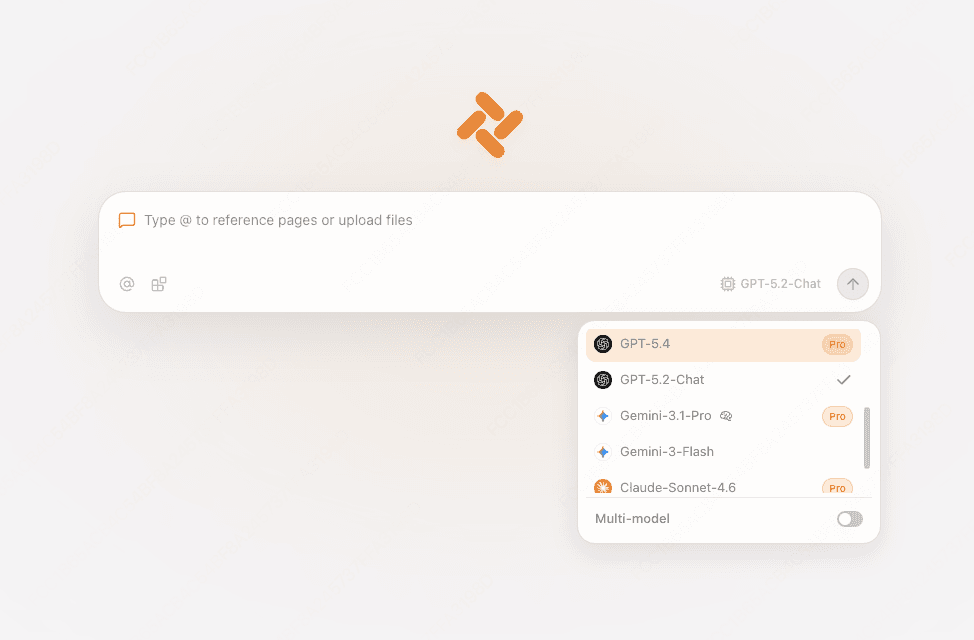
兩條誠實的邊界。第一,我們尚未確認 Muse Spark Open 已進 Tabbit 的即時模型選擇器;這個模型才發布三天,可用性變化很快,計畫之前請先查看選擇器。想看已經跑通的工作流範例,GLM-5.2 路線 和多模態的 GLM-5.3-Flash 案例 是同一模式的實例。第二,自託管在資料可控性和足夠規模下的單位成本上仍然勝出——第三條路用這兩點換來了零硬體、零維運。想看客戶端全景,參考我們的 AI 瀏覽器對比。
 Tabbit Browser
Verdict
Muse Spark Open 是一次可信且工程扎實的開放權重發布,只是標題隱藏了一個二元決策。如果你買得起那 1TB,你得到的是一個快速、簡潔、多模態的 agentic 模型,附 MLX、SGLang、vLLM 的文件化執行方案,授權對除大型 MaaS 轉售商之外的所有人來說都算友好。如果你買不起——目前幾乎沒有人能——誠實的答案是走 $1.25/$4.25 的託管路線,在那裡它靠的是單任務成本而不是絕對 Index 排名與 GLM 5.3、Kimi K3 競爭。
| 你的情況 | 第一步 |
|---|---|
| 個人開發者,沒有大硬體 | 用 $1.25/$4.25 的託管價,在一個固定的程式或研究任務上試用;與 GLM 5.3 對比合格輸出後再遷移 |
| 需要資料可控的團隊 | 按真實用量算一筆帳:4-GPU Blackwell NVFP4 節點或 Mac Studio 組合 vs 一年 API 花費 |
| 產品構建者 | 從第一天就把 “Built with Muse Spark Open” 標示排進計畫;若會觸及 $20M MaaS 門檻,儘早與 Meta 接觸 |
| 瀏覽器/agent 工作流使用者 | 透過已經握住網頁上下文的客戶端使用它(或同級模型)——見上文第三條路 |
| 榜單追逐者 | 等待更廣泛的獨立復現;一份 AA 快照加一週 HN 討論不構成共識 |
一個值得記住的數字:420 億啟動參數是這個模型「快且每任務便宜」的原因;8,160 億總參數是它放不上你桌面的原因。
來源
Meta 研究部落格:Introducing Muse Spark Open(2026-10-15)
Meta 開發者文件:Muse Spark Open(核對於 2026-10-19)
Artificial Analysis:Muse Spark Open (Xhigh)(核對於 2026-10-19)
Hacker News 發布串 及相關留言頁(核對於 2026-10-19)
TechRepublic:Meta unveils Muse Spark Open(2026-10-16)
TrendingTopics:Meta's Muse Spark Open comes with strings attached(2026-10-16)
Flavio Copes:what you can run, and what it takes(2026-10-16)
Muse Spark Open vs GLM 5.3 vs Kimi K3 對比(2026-10-16,AA 資料彙編)

常見問題
Muse Spark Open 是什麼?
Muse Spark Open 是 Meta 於 2026 年 10 月 15 日由 Meta Superintelligence Labs 發布的 Muse Spark 開放權重版本。它是稀疏混合專家模型,總參數 816B、每 token 啟動 42B,上下文視窗 1,048,576 token,原生支援文字、圖像、音訊、影片輸入並輸出文字。Meta 將其定位為程式設計與 agentic 工作負載,並稱其為迄今最強的美國開放權重模型。
Muse Spark Open 是開源的嗎?
不是。權重可以下載,但採用 Meta 自訂的 Muse Model License,而非 OSI 認可的開源授權。授權允許商用、微調與再散布,但產品必須展示「Built with Muse Spark Open」標示;若以模型即服務對外提供且任意連續 12 個月總營收超過 2,000 萬美元,須提前通知 Meta 並另行簽署書面協議。
本地執行 Muse Spark Open 需要什麼硬體?
完整模型大約需要 1TB 級記憶體。Meta 與 Apple 針對兩台各 512GB 統一記憶體的 M5 Ultra Mac Studio(執行 MLX)做了最佳化;BF16 權重約 1.65TB,需 8 張資料中心 GPU 承載,537GB 的 NVFP4 權重可放入單台 4-GPU NVIDIA Blackwell 節點。計入 KV 快取後,BF16 服務建議預算約 2TB 顯示記憶體。
Muse Spark Open 的 API 價格是多少?
發布首日,Together AI、Fireworks、Baseten、Modal、OpenRouter 等託管商的定價約為每百萬 token 輸入 1.25 美元、輸出 4.25 美元,快取讀取約 0.15 美元。截至 2026 年 10 月 19 日,Artificial Analysis 測得跨提供商中位輸出速度 142 token/秒,單個 Intelligence Index 任務成本約 0.84 美元。
Muse Spark Open 與 GLM 5.3、Kimi K3 相比如何?
按 Artificial Analysis 資料,Muse Spark Open 的 Intelligence Index 為 39,低於 GLM 5.3 的 45 和 Kimi K3 的 44;但它的輸出更快,且完成同一 Index 的任務成本約 0.84 美元,低於兩個對手約 2.00 美元。代價是授權更嚴格(強制產品標示、下載需註冊)、自託管記憶體門檻也是三者中最高。
Muse Spark Open 和 Muse Wonder、Muse 應用是同一個東西嗎?
不是。Muse Wonder 是 Meta 更強的封閉模型,2026 年 10 月 12 日發布,標價每百萬 token 輸入 4 美元、輸出 20 美元;Muse 應用是另一款雲端個人代理產品。Muse Spark Open 是 2026 年 4 月首發的託管 Muse Spark 系列的開放權重兄弟版本。