
Muse Spark Open 是 Meta 在 Muse 家族中第一个开放权重模型:总参数 8,160 亿,每 token 激活 420 亿,上下文窗口 100 万 token,原生接受文本、图像、音频、视频输入。Meta 于 2026 年 10 月 15 日将其权重放上 Hugging Face,并在 7 家托管平台同步上线 API,官方称之为"迄今最强的美国开放权重模型"。但大多数人第一个问题不在跑分上。正如 Hacker News 上一位评论者所写,Meta 建议的配置是"a pair of Mac Studios w/ M5 Ultra chips and 512 GB of RAM. A single Mac Studio w/ M5 Ultra and half that RAM (256 GB) is around $11k, and the 512 GB option isn't even available yet. So.... yeah."(HN 讨论)
本文算清硬件账、逐条解读 Muse Model License、核对首日 API 定价与独立基准,并把它与 GLM 5.3、Kimi K3 放在同一把尺上对比。后半部分还会讲"第三条路":不自建机房,而是通过产品使用这样的模型。
Key takeaways
Muse Spark Open 是 Meta Muse Spark 的开放权重版:816B 总参 / 42B 激活的稀疏 MoE,上下文 1,048,576 token,多模态输入、文本输出,面向编程与 agentic 工作负载。
关键数字:每个 token 只动用 42B 参数,但服务时必须加载全部 816B——BF16 约 1.65TB,NVFP4 约 537GB,外加缓存开销。
本地运行意味着两台 512GB 的 M5 Ultra Mac Studio 跑 MLX,或一台 4-GPU Blackwell 节点跑 NVFP4。普通台式机无缘;单台 256GB Mac Studio 也要约 1.1 万美元。
Muse Model License 允许商用但不是开源:产品必须展示 "Built with Muse Spark Open" 标识;模型即服务且 12 个月营收超过 2,000 万美元需与 Meta 另签协议。
独立视角(Artificial Analysis,2026-10-19):Intelligence Index 39,输出 142 token/秒,单任务约 0.84 美元——快而简洁,但在同级开放权重模型中偏贵,Index 排名落后 GLM 5.3(45)与 Kimi K3(44)。
首日托管定价约 $1.25/M 输入、$4.25/M 输出、缓存读取约 $0.15/M,提供商包括 Together AI、Fireworks、Baseten、Modal、OpenRouter 等。
Muse Spark Open 一览
| 项目 | 内容 | 来源 |
|---|---|---|
| 发布 | 2026 年 10 月 15 日,Meta Superintelligence Labs | Meta 研究博客 |
| 参数 | 816B 总参,每 token 激活 42B;稀疏 MoE,每层 256 个 expert、每 token 选 8 个(模型卡口径) | Meta 开发者文档 |
| 上下文 | 1,048,576 token | Meta 开发者文档 |
| 输入 / 输出 | 文本、图像、音频、视频输入;文本输出 | Meta 开发者文档 |
| 权重规格 | BF16 ≈ 1.65TB(8 张 GPU,如 8×B300);NVFP4 ≈ 537GB(单台 4-GPU Blackwell 节点) | Meta 开发者文档 |
| 本地运行 | 两台 M5 Ultra Mac Studio(各 512GB 统一内存)+ MLX;BF16 含 KV 缓存约需 2TB 显存 | Meta 研究博客、开发者文档 |
| 托管 API | Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI | Meta 研究博客 |
| 权重渠道 | Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Models | Meta 研究博客 |
| 许可 | Muse Model License(自定义,附条件商用)+ Acceptable Use Policy | Meta 开发者文档 |
| 定位 | 编程、长程 agentic 任务、多步推理;"迄今最强的美国开放权重模型" | Meta 研究博客 |
关键数字:42B 是新闻,816B 是账单
所有标题都在讲 8,160 亿参数。真正决定你能不能用的,是另一个数字:420 亿激活参数。Muse Spark Open 是稀疏混合专家模型——每个 token 被路由到每层 256 个 expert 中的 8 个——因此每 token 的计算量只跟着 42B 激活参数走。这就是它的延迟和单任务成本好看的原因。
但稀疏化并不缩小你必须承载的模型。Meta 开发者文档说得很直白:"serving still loads the full 816B weights into VRAM, which sets the hardware footprint." BF16 权重约 1.65TB,加上 KV 缓存、激活和运行时开销,Meta 文档建议按约 2TB 显存预算——也就是 8 张 B300 级别的数据中心 GPU。NVFP4 检查点把大部分权重量化到 4 位,降到约 537GB,可放入单台 4-GPU NVIDIA Blackwell 节点。
桌面端是这次发布的主角。Apple 的统一内存架构让 M5 Ultra Mac Studio 最高可寻址 512GB,两台通过 Thunderbolt 串联后,用 Meta 的话说"像一台拥有 1TB 统一内存的超级计算机",1.2TB/s 的带宽足以喂饱每个 token 所需的那一小片参数。Meta 演示了完全在设备上运行的 agentic 流程——用 Muse Code 给开源 Mastodon 客户端 Ice Cubes 提交真实改动,逐帧驱动 DaVinci Resolve 剪辑。
两点需要保持诚实。第一,硬件还没完全开卖:截至 2026 年 10 月 19 日,512GB 的 M5 Ultra Mac Studio 尚未上市、价格未公布;HN 评论者给单台 256GB 的估价约 1.1 万美元,TechRepublic 测算四台 256GB 阵列超过 3.8 万美元。第二,一位转述 Apple Research MLX 帖子的评论者称,四台 Mac Studio 集群"over 36 tokens per second"——agentic 工作可用,但远谈不上数据中心速度。(HN:硬件成本、HN:MLX 吞吐)
社区对本地运行的结论很直白:"I was mistaken in my thinking that open models are able to be quantized to run on average consumer hardware, I think they have outgrown that concept."(HN)如果你的机器是 32 或 64GB 内存,这个模型不是"下载就能跑"的。托管 API 才是现实入口。
它是什么,不是什么
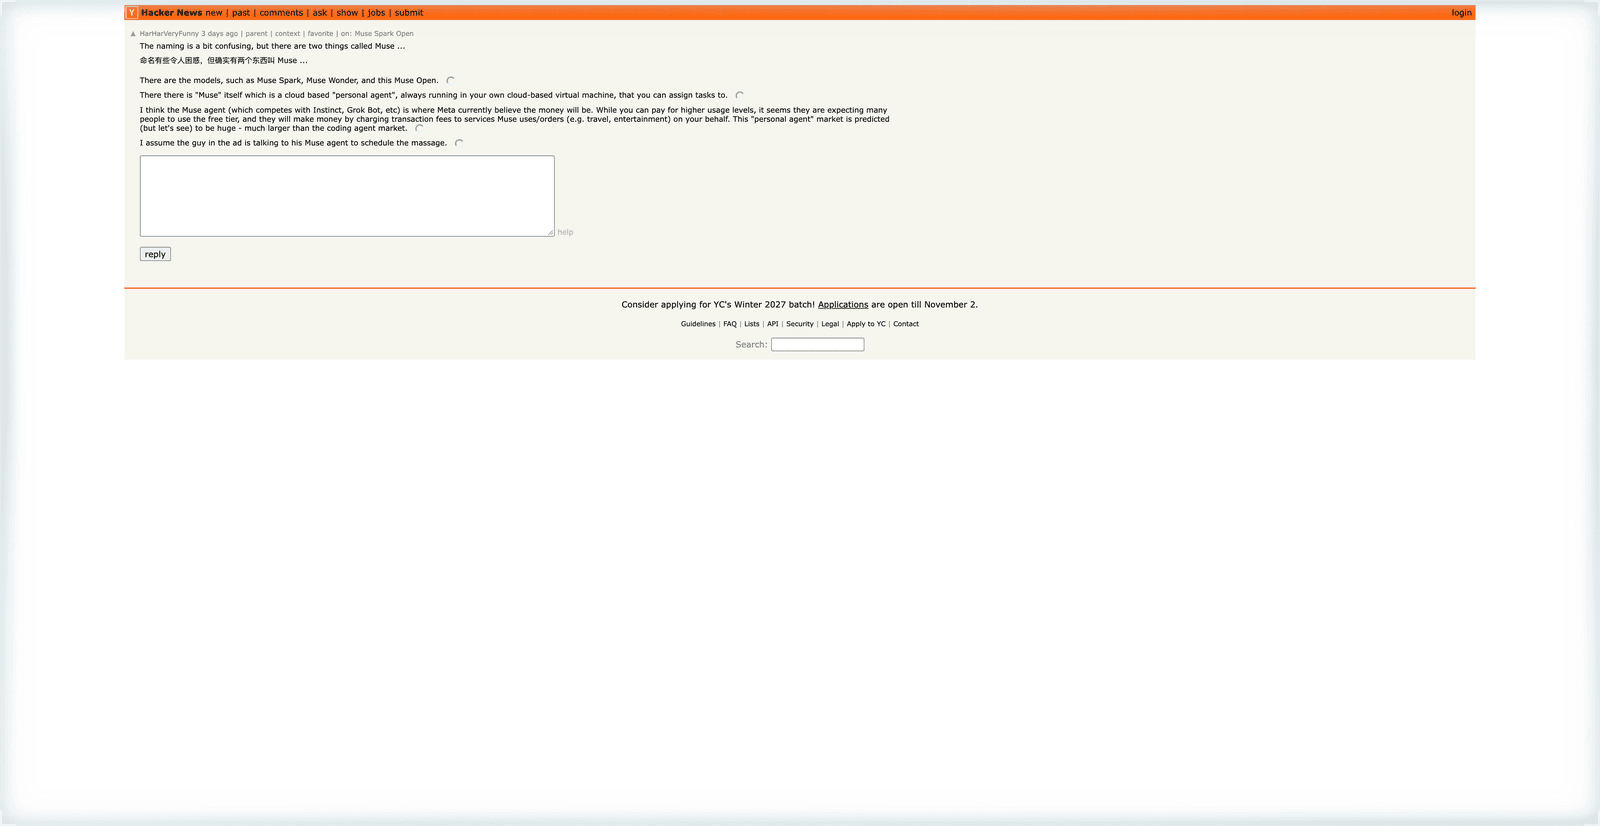
Muse 的命名确实混乱,社区第一天就指出了:"The naming is a bit confusing, but there are two things called Muse... There are the models, such as Muse Spark, Muse Wonder, and this Muse Open. There there is 'Muse' itself which is a cloud based 'personal agent'."(HN)
厘清版本:
Muse Spark 是 2026 年 4 月 8 日首发的托管模型线——Llama 时代之后 Meta 第一个专有模型家族。1.1(7 月)、1.2、1.3(9 月)各版本始终保持封闭,通过 Meta API 和 Muse Code 以 $1.25/M 输入、$4.25/M 输出提供服务。
Muse Wonder 于 2026 年 10 月 12 日发布,是位于 Spark 之上的封闭旗舰,标价 $4/M 输入、$20/M 输出。Meta 自己也没有声称 Spark Open 胜过 Wonder。
Muse Spark Open 就是本文主角:Spark 系列的开放权重兄弟版本,同样有 1M 上下文和多模态输入,按自定义许可发布。
Muse 应用是面向消费者的代理产品,与权重无关。
基准:快、简洁,在开放权重里偏贵
Artificial Analysis 的 Muse Spark Open(xhigh 推理档)独立页面,核对于 2026 年 10 月 19 日:
| 指标 | Muse Spark Open | 解读 |
|---|---|---|
| Intelligence Index | 39(开放权重同级约第 10/120;类别中位数 19) | 高于类别中位,落后领先的中国开放模型 |
| 输出速度 | 142.2 token/秒(跨提供商中位) | 同类中明显更快(类别中位约 78) |
| 首 token 延迟 | 0.81 秒 | 有竞争力 |
| 标价 | $1.25/M 输入、$4.25/M 输出,缓存折扣 88% | 在开放权重中"偏高" |
| 单 Intelligence Index 任务成本 | 约 $0.84 | 靠简洁输出胜出 |
| 冗长度 | 整个 Index 消耗 110M 输出 token | 较简洁(类别中位约 130M) |
AA 自己的总结值得引用:"amongst the leading models in intelligence, but particularly expensive when comparing to other open weight models of similar size. It's also notably fast and fairly concise." 两点校准:第一,Index(v4.3.2)混合了十项评测(含 agentic 与长上下文套件),39 不是单科分数;第二,价格数字是提供商中位价,不是 Meta 官方标价——Meta 自家 API 并不托管这个开放权重变体。如果你在为 agentic 浏览和编程工作流选模型,把这个数字和我们的 agentic 浏览指南 结合起来看,而不是只看一个榜单名次。
许可不是开源
"开放权重"在标题里承担了很多重量。你可以下载 Muse Spark Open、微调它、蒸馏它、把它装进商业产品。但 Muse Model License 是自定义许可,不是 Apache 2.0 或 MIT,条件更严:
必须署名。任何使用本模型或其衍生物的产品,都必须在界面、文档、网站或设置中展示 "Built with Muse Spark Open"。这条没有营收门槛。
模型即服务门槛。如果你与关联方在任意连续 12 个月内总营收超过 2,000 万美元,并通过 API 或类似接口向第三方提供本模型,必须提前通知 Meta 并另行签署书面协议。内部使用、研究、嵌入自有产品功能明确豁免。
可接受使用政策。许可附带 AUP,禁止武器开发、恶意软件、操作关键基础设施、欺诈、虚假信息和冒用身份;模型不面向 18 岁以下用户。
输出权利。Meta 不主张对模型生成内容的权利——这一条比经典开源还干净。
下载摩擦。从 Hugging Face 下载权重需填写法定姓名、出生日期、企业信息——是注册门槛,不是点个同意。
如果你想要这个级别真正宽松的开放权重模型,GLM 5.3 的 MIT 风格许可是对照组,下文对比部分会展开。
如何获取
托管 API(零硬件):Baseten、Fireworks AI、Groq、Modal、Nebius、Together AI 直接提供;OpenRouter 以网关路由列出。首日各提供商定价约为 $1.25/M 输入、$4.25/M 输出、缓存读取约 $0.15/M——与托管版 Muse Spark 1.2 同价,推测是 Meta 定了锚点、各家跟齐。
GPU 自托管:BF16(约 1.65TB)面向 8 卡节点;NVFP4(约 537GB)可上单台 4-GPU Blackwell 节点。Meta 在 SGLang 中提供可自动调优的 Helion 内核,官方称 NVIDIA 与 AMD 上内核级加速 1.03–3.95 倍,AMD MI350 端到端再快 3%。vLLM、TensorRT-LLM、llama.cpp、Unsloth 首日全部支持。
Mac 自托管:两台各 512GB 的 M5 Ultra Mac Studio 通过 MLX 运行,权重直接从 Hugging Face 拉取。Apple Research 另文档化了一个超过 36 token/秒的四机集群。
云目录:Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Models 提供权重,适合想要托管基础设施的团队。
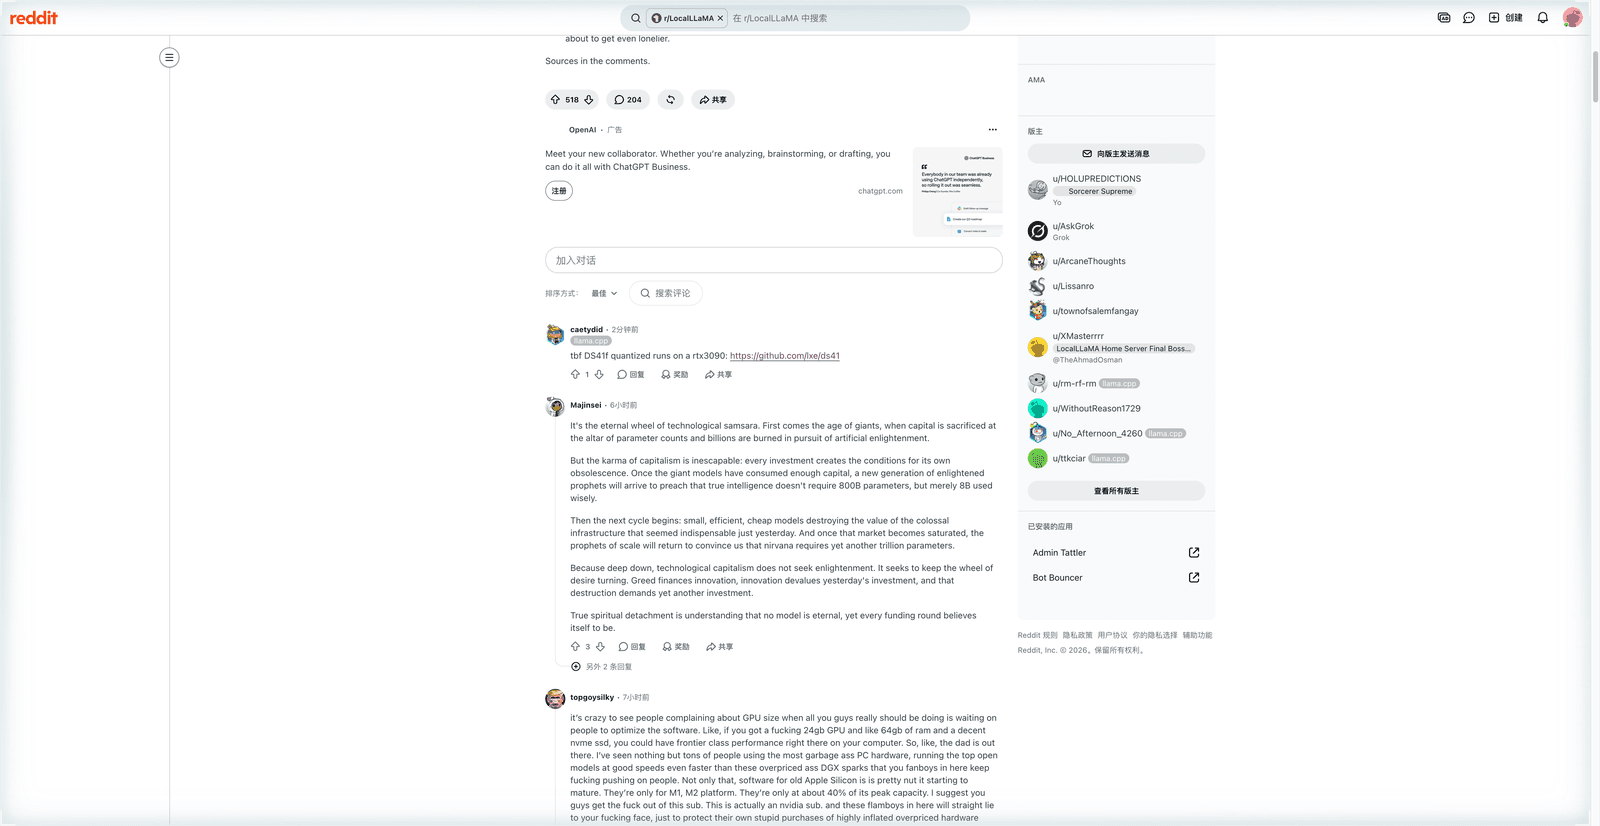
这种部署广度对开放权重发布来说确实少见,社区也注意到了:"They did the actual work of testing and documenting deployments on several platforms. It's a bit of upping the standard for open weights instead of just posting the blob and letting the community figure it out."(HN)
与 GLM 5.3、Kimi K3 的同口径对比
"美国开放权重冠军"的说法,只有放到统治了这个榜单一整年的中国开放模型旁边才有意义。同口径数据(Artificial Analysis 数据,2026 年 10 月 16 日汇编;预算前请复核):
| 维度 | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| 厂商 | Meta(美国) | Z.ai(中国) | Moonshot AI(中国) |
| 参数 | 816B 总 / 42B 激活 | 753B / 40B | 2.8T / 104B |
| 输入 | 文本、图像、音频、视频 | 文本 | 文本、图像 |
| Intelligence Index | 39 | 45 | 44 |
| 输出速度 | 142 token/秒 | 67 token/秒 | 43 token/秒 |
| 单 Index 任务成本 | $0.84 | $2.01 | $2.00 |
| API 价($/M 输入/输出) | $1.25 / $4.25 | $1.40 / $4.40 | $3.00 / $15.00 |
| 许可 | Muse Model License(强制标注 + $20M MaaS 门槛) | MIT 风格(约 $10B 规模才有条件) | 自定义(类似 $20M MaaS 门槛) |
| 主要限制 | 自托管需 TB 级内存;强制标注 | 仅文本输入 | 三者中标价最高 |
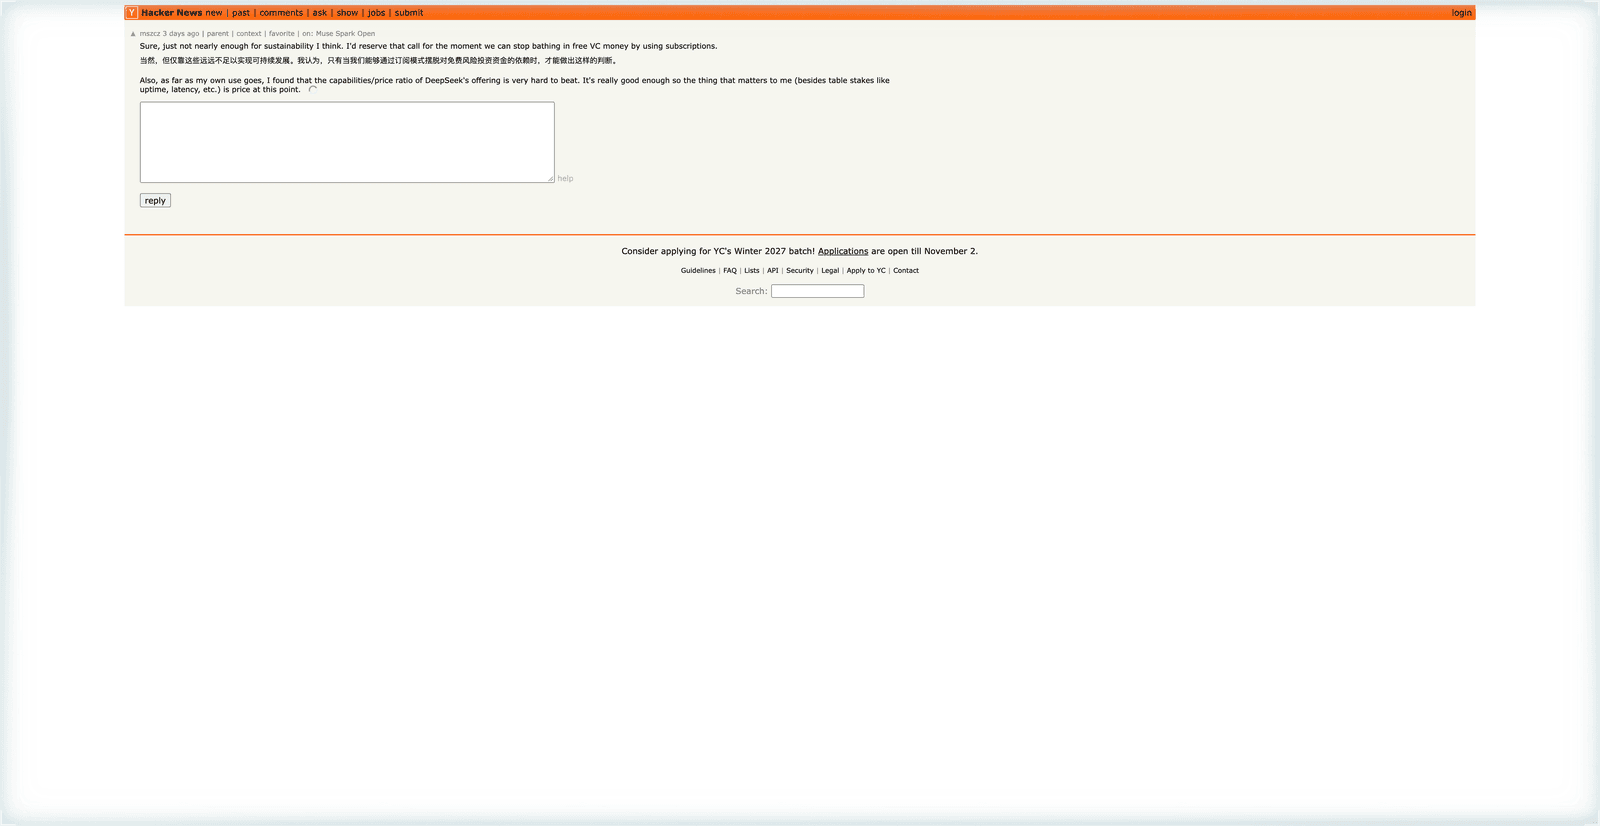
取舍很清楚。Muse Spark Open 在 Intelligence Index 上落后两个对手,但把单任务成本大幅压低——它用更少的输出完成任务——而且是三者中唯一原生支持音频和视频输入的。一位 HN 评论者的说法与数据吻合:"the capabilities/price ratio of DeepSeek's offering is very hard to beat... the thing that matters to me (besides table stakes like uptime, latency, etc.) is price at this point."(HN)
如果标准是绝对 Index 排名,它不是领头羊;如果标准是带多模态输入的单个合格任务成本,它有竞争力。
关于模型选择如何与工具层互动,可延伸阅读我们对 Qwen3.8 Max、MiniMax M3 和 LongCat 2.0 的解读——它们在同一个开放权重赛道里做了不同的取舍。
用户在说什么
Hacker News 发布帖的讨论串(截至 10 月 19 日约 917 分、约 478 条评论)兼有待兴奋与硬件怀疑:
"I love seeing major ai labs release open-weight models. really hope we'll see more of this from openai and eventually anthropic too." —— shinokami
"I was mistaken in my thinking that open models are able to be quantized to run on average consumer hardware, I think they have outgrown that concept." —— twitexplore
"Anyone who has tried a smaller/quantized version locally on apple silicon? Would love to know your experience, also tk/s on what hardware specs?" —— nico。截至本文写作,讨论里提问多于一手本地实测报告——任何不带硬件细节的性能说法都应视为未验证。
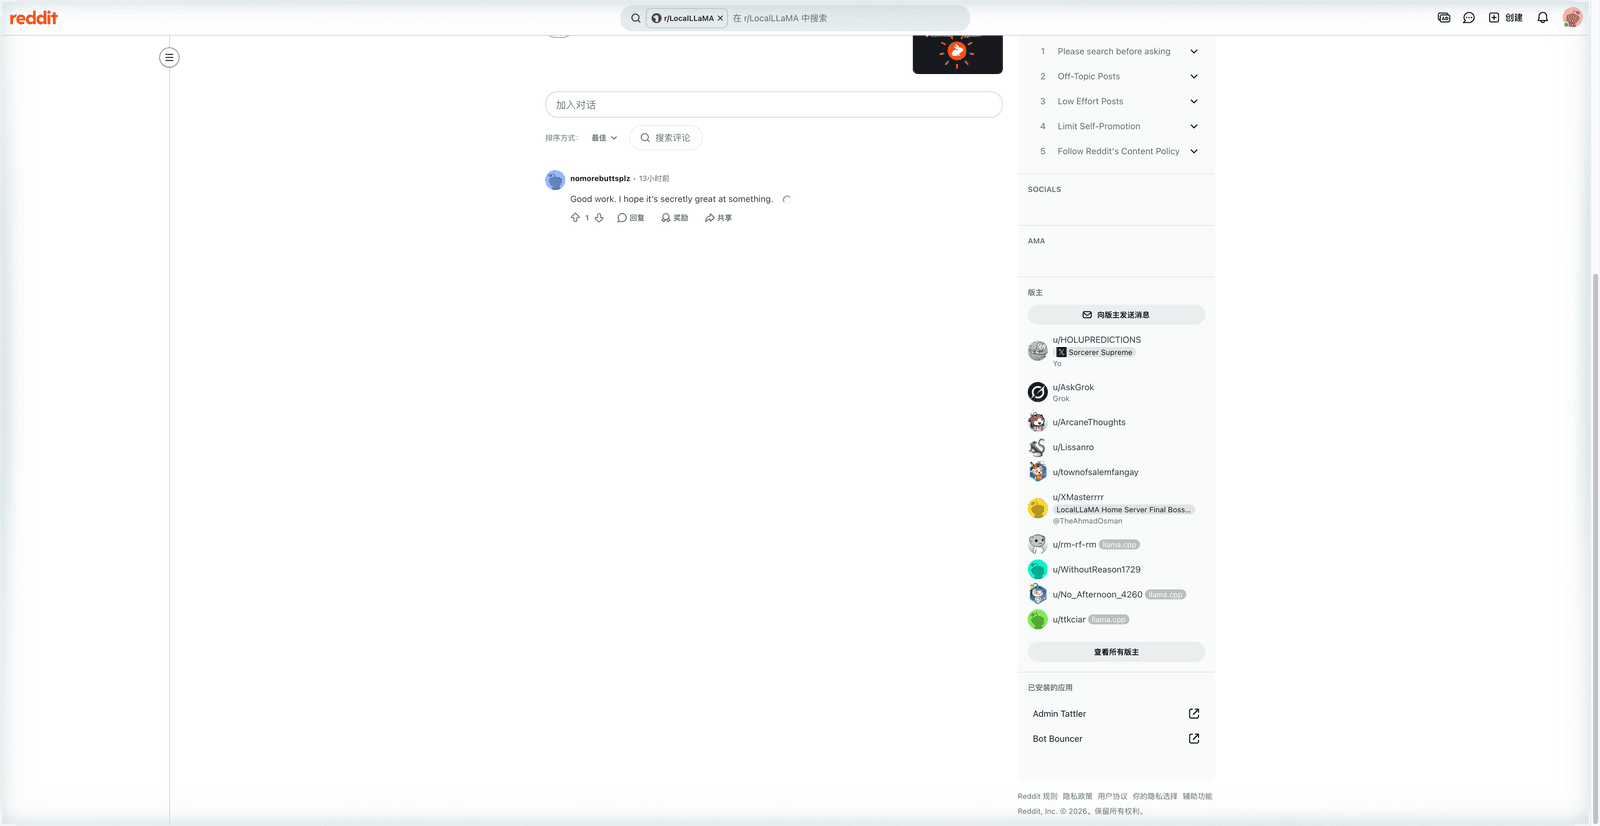
Reddit 的 r/LocalLLaMA 在几天内开始补上这个缺口。一位在单台 Mac Studio 上运行模型的用户报告解码速度达到 18 t/s——「This is text only. Output is coherent and toolcalls solid.」(r/LocalLLaMA)同一周另一个跨模型讨论帖则直言:「'Runs locally' now officially means 'runs on a computer that costs more than a car.'」(r/LocalLLaMA)
第三条路:通过产品使用,而不是自建机房
这才是大多数读者真正面对的决策。你的桌面上没有 2.2 万到 4 万美元的 Mac Studio,也不想养 8 张数据中心 GPU。但你的工作——研究、编程、浏览器任务——确实需要一个前沿级开放模型和 1M 上下文。这个缺口,正是托管 API 和 AI 原生客户端要填的。
Tabbit Browser 这样的浏览器就处在这个位置。对 Muse Spark Open 这类模型,务实的用法不是自托管,而是在一个已经握有你上下文的客户端里选它(或同级的 agentic 模型)——眼前的网页、标签组、文件——然后通过 agentic 浏览 或 浏览器自动化 让它开始工作,而不是在独立聊天窗口里重建每个任务。
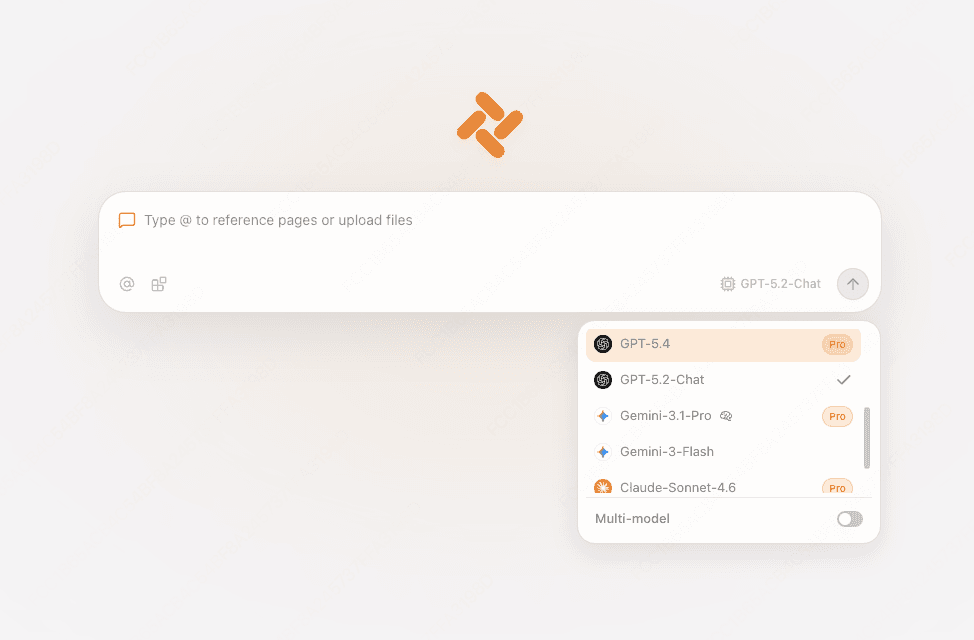
两条诚实的边界。第一,我们尚未确认 Muse Spark Open 已进 Tabbit 的实时模型选择器;这个模型才发布三天,可用性变化很快,计划之前请先查看选择器。想看已经跑通的工作流样例,GLM-5.2 路线 和多模态的 GLM-5.3-Flash 案例 是同一模式的实例。第二,自托管在数据可控性和足够规模下的单位成本上仍然胜出——第三条路用这两点换来了零硬件、零运维。想看客户端全景,参考我们的 AI 浏览器对比。
 Tabbit Browser
Verdict
Muse Spark Open 是一次可信且工程扎实的开放权重发布,只是标题隐藏了一个二元决策。如果你买得起那 1TB,你得到的是一个快速、简洁、多模态的 agentic 模型,附 MLX、SGLang、vLLM 的文档化运行方案,许可对除大型 MaaS 转售商之外的所有人都算友好。如果你买不起——目前几乎没有人能——诚实的答案是走 $1.25/$4.25 的托管路线,在那里它靠的是单任务成本而不是绝对 Index 排名与 GLM 5.3、Kimi K3 竞争。
| 你的情况 | 第一步 |
|---|---|
| 个人开发者,没有大硬件 | 用 $1.25/$4.25 的托管价,在一个固定的编程或研究任务上试用;与 GLM 5.3 对比合格输出后再迁移 |
| 需要数据可控的团队 | 按真实用量算一笔账:4-GPU Blackwell NVFP4 节点或 Mac Studio 组合 vs 一年 API 花费 |
| 产品构建者 | 从第一天就把 "Built with Muse Spark Open" 标注排进计划;若会触及 $20M MaaS 门槛,尽早与 Meta 接触 |
| 浏览器/agent 工作流用户 | 通过已经握住网页上下文的客户端使用它(或同级模型)——见上文第三条路 |
| 榜单追逐者 | 等待更广泛的独立复现;一份 AA 快照加一周 HN 讨论不构成共识 |
一个值得记住的数字:420 亿激活参数是这个模型"快且每任务便宜"的原因;8,160 亿总参数是它放不上你桌面的原因。
来源
Meta 研究博客:Introducing Muse Spark Open(2026-10-15)
Meta 开发者文档:Muse Spark Open(核对于 2026-10-19)
Artificial Analysis:Muse Spark Open (Xhigh)(核对于 2026-10-19)
Hacker News 发布帖 及相关评论页(核对于 2026-10-19)
TechRepublic:Meta unveils Muse Spark Open(2026-10-16)
TrendingTopics:Meta's Muse Spark Open comes with strings attached(2026-10-16)
Flavio Copes:what you can run, and what it takes(2026-10-16)
Muse Spark Open vs GLM 5.3 vs Kimi K3 对比(2026-10-16,AA 数据汇编)

常见问题
Muse Spark Open 是什么?
Muse Spark Open 是 Meta 于 2026 年 10 月 15 日由 Meta Superintelligence Labs 发布的 Muse Spark 开放权重版本。它是稀疏混合专家模型,总参数 816B、每 token 激活 42B,上下文窗口 1,048,576 token,原生支持文本、图像、音频、视频输入并输出文本。Meta 将其定位为编程与 agentic 工作负载,并称其为迄今最强的美国开放权重模型。
Muse Spark Open 是开源的吗?
不是。权重可以下载,但采用 Meta 自订的 Muse Model License,而非 OSI 认可的开源许可。许可允许商用、微调和再分发,但产品必须展示“Built with Muse Spark Open”标识;若以模型即服务对外提供且任意连续 12 个月总营收超过 2,000 万美元,须提前通知 Meta 并另行签署书面协议。
本地运行 Muse Spark Open 需要什么硬件?
完整模型大约需要 1TB 级内存。Meta 与 Apple 针对两台各 512GB 统一内存的 M5 Ultra Mac Studio(运行 MLX)做了优化;BF16 权重约 1.65TB,需 8 张数据中心 GPU 承载,537GB 的 NVFP4 权重可放入单台 4-GPU NVIDIA Blackwell 节点。计入 KV 缓存后,BF16 服务建议预算约 2TB 显存。
Muse Spark Open 的 API 价格是多少?
发布首日,Together AI、Fireworks、Baseten、Modal、OpenRouter 等托管商的定价约为每百万 token 输入 1.25 美元、输出 4.25 美元,缓存读取约 0.15 美元。截至 2026 年 10 月 19 日,Artificial Analysis 测得跨提供商中位输出速度 142 token/秒,单个 Intelligence Index 任务成本约 0.84 美元。
Muse Spark Open 与 GLM 5.3、Kimi K3 相比如何?
按 Artificial Analysis 数据,Muse Spark Open 的 Intelligence Index 为 39,低于 GLM 5.3 的 45 和 Kimi K3 的 44;但它的输出更快,且完成同一 Index 的任务成本约 0.84 美元,低于两个对手约 2.00 美元。代价是许可更严格(强制产品标注、下载需注册)、自托管内存门槛也是三者中最高。
Muse Spark Open 和 Muse Wonder、Muse 应用是同一个东西吗?
不是。Muse Wonder 是 Meta 更强的封闭模型,2026 年 10 月 12 日发布,标价每百万 token 输入 4 美元、输出 20 美元;Muse 应用是另一款云端个人代理产品。Muse Spark Open 是 2026 年 4 月首发的托管 Muse Spark 系列的开放权重兄弟版本。